注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
リソース配分と最適化
組織は日々、リソースをどのように配分するかを決定しています。たとえば、どの製品を生産するかの決定、投資収益率を最大化するための EV 充電ステーション群の配置、輸送コストを削減するための貨物の集約などです。
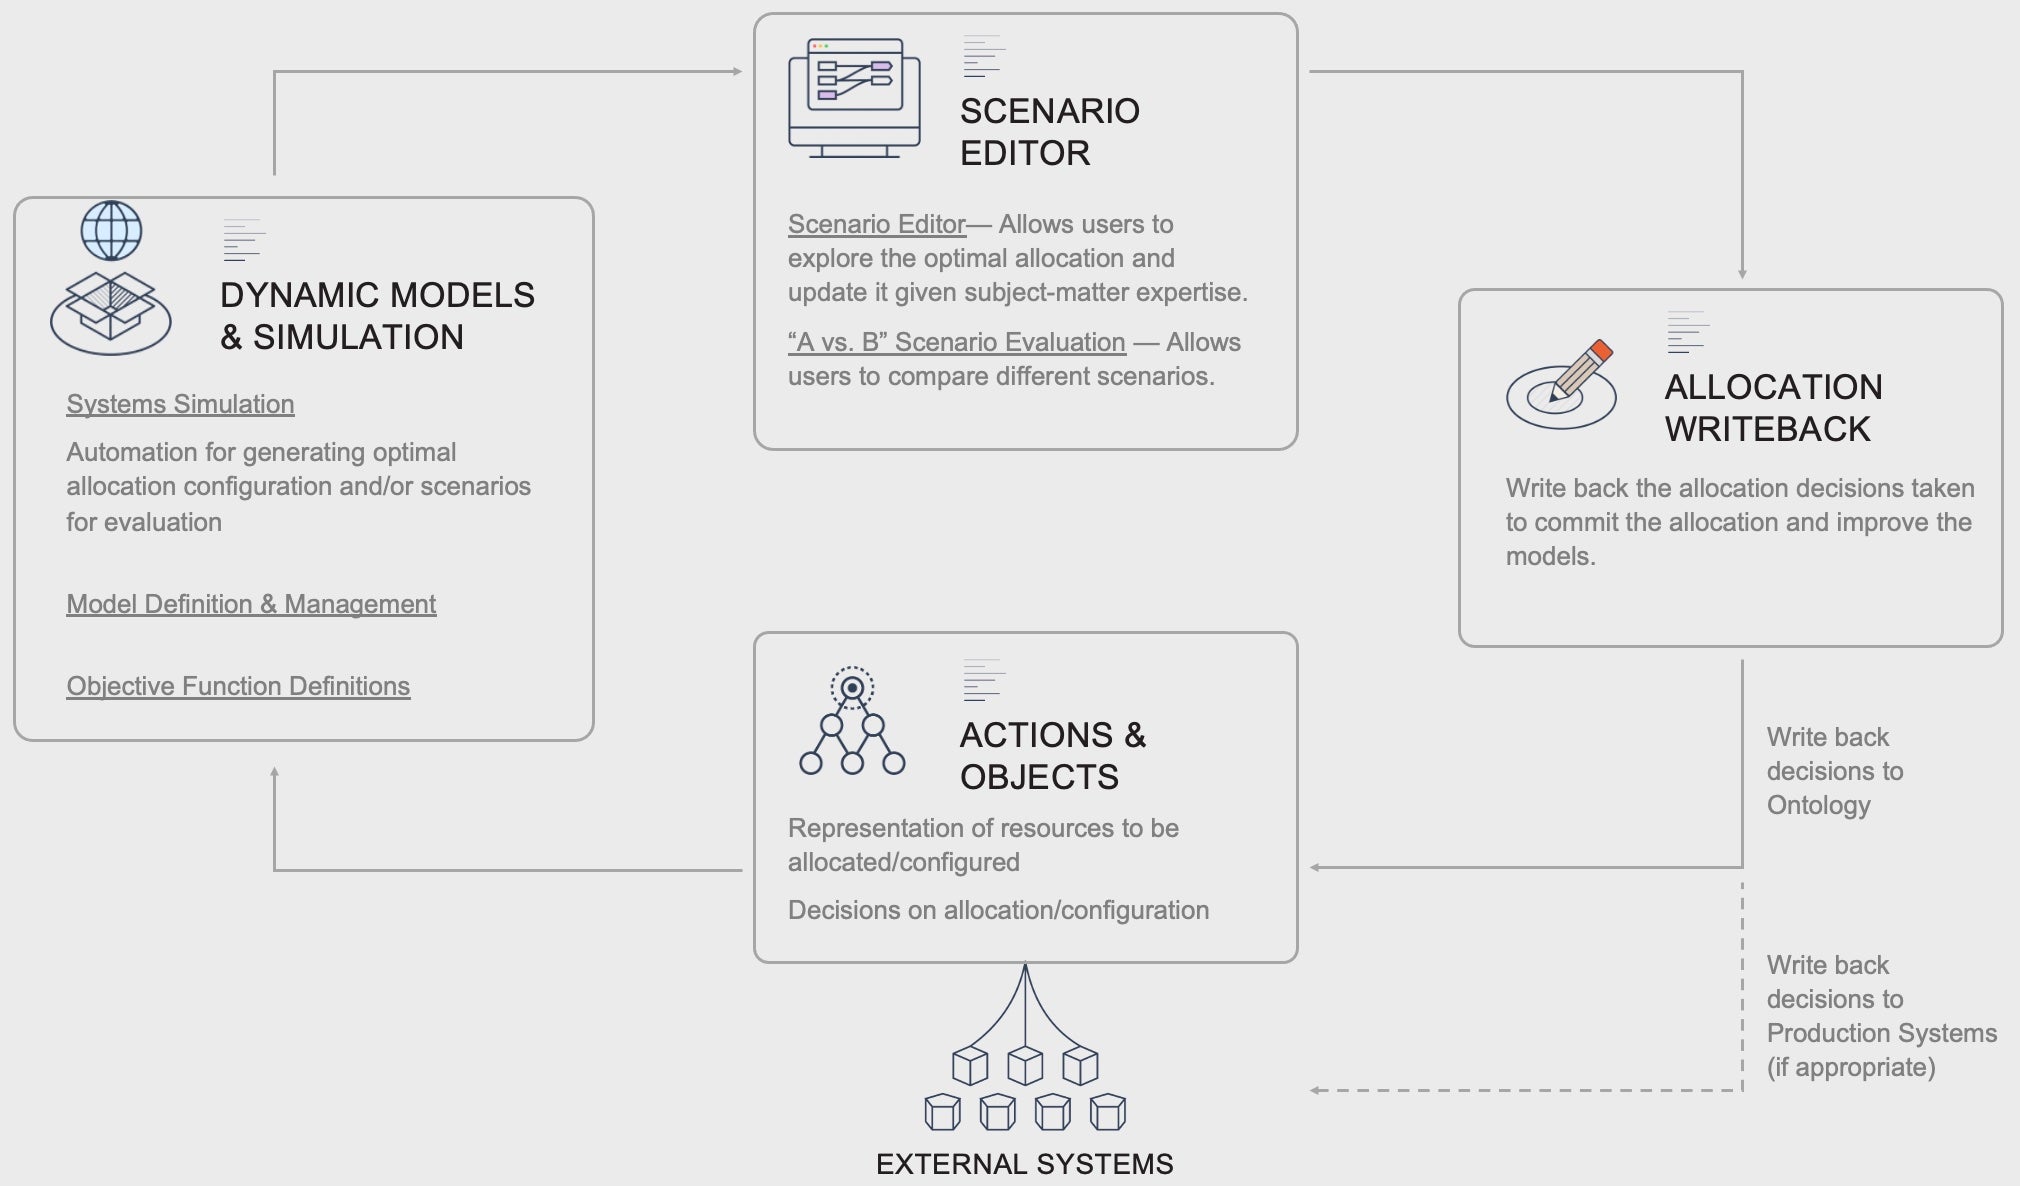
Foundry は、組織の実際の業務を反映したデジタルツインを作成し、この組織のデジタル表現を活用して、リソース配分の意思決定を支援し、最適化します。
ソリューション
リソース配分と最適化とは、制約のもとで特定の目的を最大化または最小化するように、利用可能なリソースを活用することです。組織は、このような配分と最適化のさまざまな課題に直面しています。
リソース配分と最適化のワークフローでは、最適な配分を決定できるように、関連データを収集し、クレンジング、加工、モデル化する必要があります。これは多くの場合、単一のデータソース上で動作し、新たな現実や組織の変化に適応できない専用ソフトウェアを使用するか、多数のスプレッドシートやデータベースにまたがる多くのデータソースを手間をかけて集約することで行われます。その結果、次のような問題が生じます。
- 配分の決定が場当たり的で、決定までに長い時間がかかり、状況に迅速に対応できません
- 不完全なデータに基づいて、最適ではない決定が行われます
- オープンループ型の意思決定となり、時間の経過とともに改善されません。
- 決定の効果が測定されず、その後のフォローアップも行われません
- モデル化の前提が検証されず、改善も行われません
Foundry を使用すると、組織はクローズドループ型の配分最適化ワークフローを作成できます。これにより、データの全体像を活用しながら、再現性があり、適時な意思決定が可能になります。また、組織の環境の変化に応じて、継続的に適応し、改善できます。
主要な要素
アイデアの創出と探索
まず、分野の専門家が、最大化または最小化すべき目的関数と関連する動態を特定し、システムとその制約を定義します。また、ソースシステムから収集して統合する必要がある関連データを特定します。これは多くの場合、Contour や Quiver を使用してデータを掘り下げ、何が実現可能かを把握する反復的なプロセスです。
関連製品:
動態のモデル化とシミュレーション
システムの動態、目的関数、制約は、Functions on Objects を通じてコード化するか、ML モデルを使用して観測から学習します。これらの ML モデルは、Code Workbook で開発し、Foundry ML で管理できます。Foundry ML スイートは、機械学習、人工知能、統計、数学のモデルを Foundry エコシステムの主要なコンポーネントと統合し、モデルを業務に導入して、そのパフォーマンスを継続的に監視できるようにします。
EV 充電ステーションの配置のユースケースでは、地理データ、財務データ、充電ステーション候補群の特徴をまとめ、スコアを付けます。
顧客は、Data Connection を介して接続することで、サードパーティーのシミュレーションおよび最適化ツールも活用できます。
関連製品:
シナリオ評価と最適化探索のアプリケーション
シミュレーションによる最適な配分、シナリオ候補、または「What-If」シナリオは、自動化されたトランスフォームによって生成されます。最適な配分や代替シナリオは、Workshop または Slate アプリケーションで構築したノーコードからローコードのアプリケーションで探索し、評価できます。
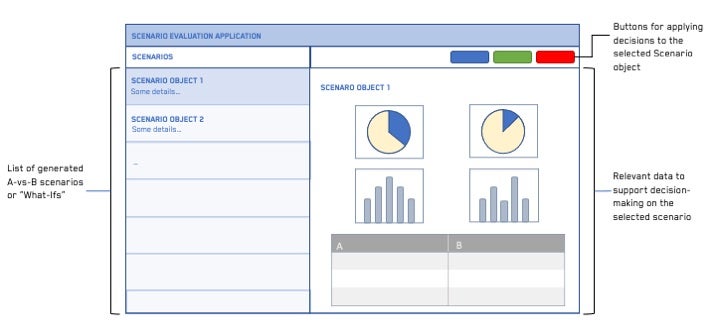
たとえば、積載率の改善のユースケースでは、輸送コストを削減するために、貨物(トラックの積荷)を集約できる機会がユーザーに提示されます。積載計画担当者は、機会ダッシュボードを確認し、担当する貨物を含む集約候補について、関係者(プラント、顧客、運送業者など)に通知します。これらの機会では、追加の停車地点、集荷・配送予約の変更、プラントや顧客の制約が考慮されます。その後、積載計画担当者は、その機会を承認、拒否、集約、または再割り当てします。
配分の決定を、それぞれの決定が行われたときのコンテキストとともにライトバックすることで、予測した結果と実際の結果を継続的に比較し、評価できます。観測データを使った新しいモデルのトレーニングや、コード化した動態の更新によってモデルの精度を高めることで、意思決定が改善されます。
関連製品:
要件
使用するパターンにかかわらず、基盤となるデータ基盤は、パイプラインと外部ソースシステムへの同期から構築されます。
データ統合パイプライン
SQL、Python、Java などのさまざまな言語で記述されたデータ統合パイプラインを使用して、データソースを対象分野のオントロジーに統合します。
Foundry は、FTP、JDBC、REST API、S3 など、幅広いソースからデータを同期できます。さまざまなソースからデータを同期し、可能な限り完全な信頼できる唯一の情報源を構築することが、最も価値の高い意思決定を可能にする鍵となります。
このパターンを実装するユースケース
- 統合された立地最適化による EV 充電拠点の収益性向上
- サプライチェーン全体の ERP データによる生産の最適化
- インテリジェントな保守優先順位付けによる鉄道の運行障害の削減
- コンテナの積載率を最適化して輸送するコンテナ数を削減する
このユースケースパターンについて詳しく知りたいですか?同様の仕組みの実装を検討していますか?Palantir ではじめる。↗