注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
お知らせ
リマインダー: Foundry ニュースレターに登録すると、プラットフォーム全体の新しい製品、機能、改善点の概要を受信トレイで直接受け取れます。登録方法の詳細については、Foundry ニュースレターと製品フィードバックチャネルのお知らせを参照してください。
これらのお知らせについてのご意見を Developer Community フォーラム ↗ でお聞かせください。
新しい Workflow Lineage ランディングページから最も関連性の高い Workshop モジュールに直接アクセスする
公開日:2025-06-26
Workflow Lineage で新しいグラフや空のグラフを作成する際の操作性が向上しました。Workshop モジュール、関数リポジトリ、または新たに対応したオントロジーオブジェクトから、キーボードショートカット Cmd + i(macOS)または Ctrl + i(Windows)を使って Workflow Lineage に移動する方法に加え、アプリケーションから最も関連性の高い Workshop モジュールを直接選択できる便利な方法が追加されました。Workflow Lineage のランディングページで、最近使用した Workshop モジュールや最も閲覧された Workshop モジュールの一覧を確認できるようになりました。
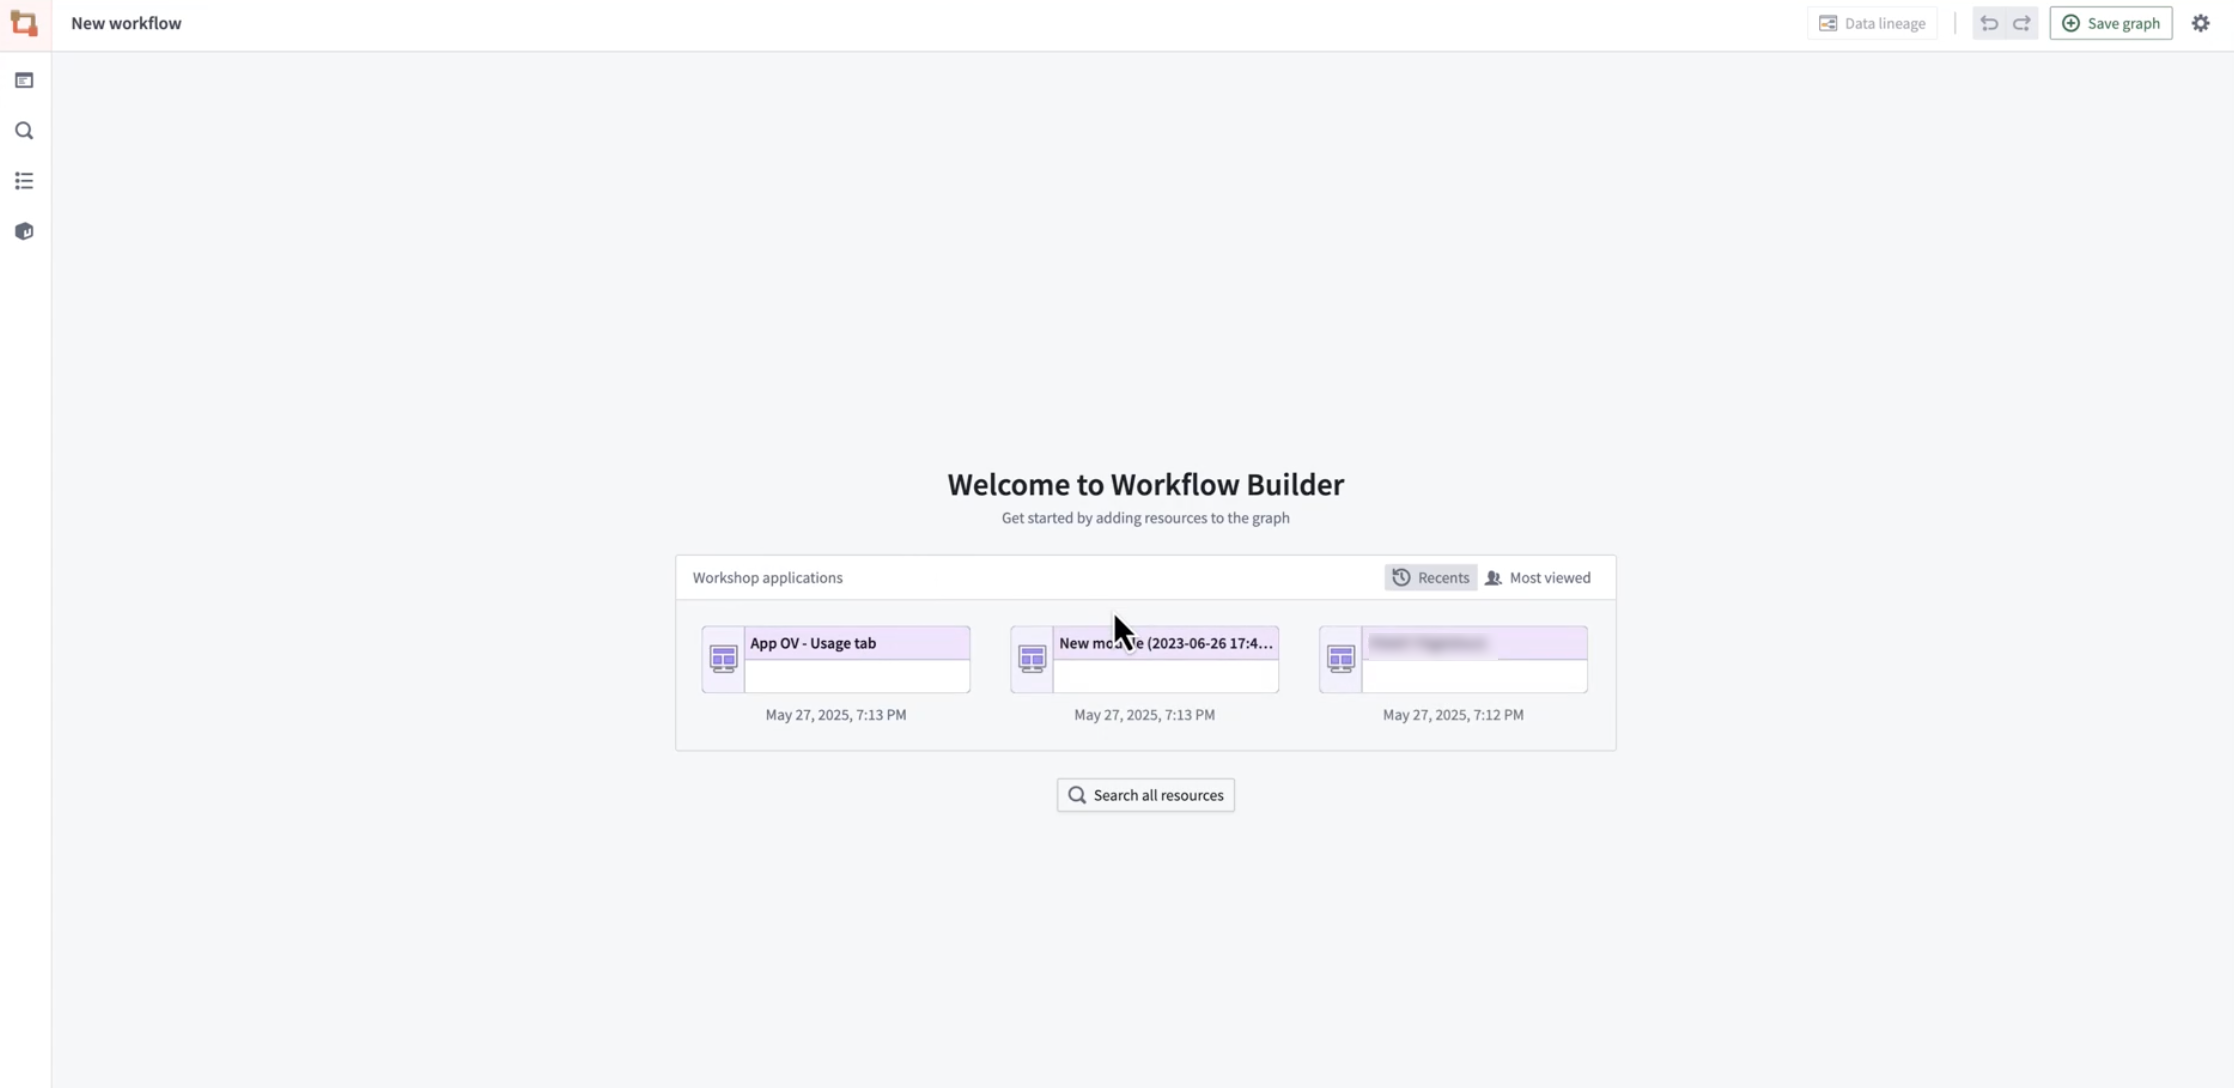
新しい Workflow Lineage ランディングページから最も関連性の高い Workshop モジュールに直接アクセスできるようになりました。
新機能は何ですか?
新しいグラフや空のグラフを開くと、次の内容が表示されるようになりました。
- 最近使用した Workshop アプリケーション: ワークスペースで最近開いた Workshop アプリケーションにすばやくアクセスできます。
- 最も閲覧された Workshop アプリケーション: チームが使用している、人気が高く影響力のあるワークフローをすぐに見つけられます。この選択肢では、過去30日間にすべてのユーザーによって最も閲覧された Workshop アプリケーションが表示されます。
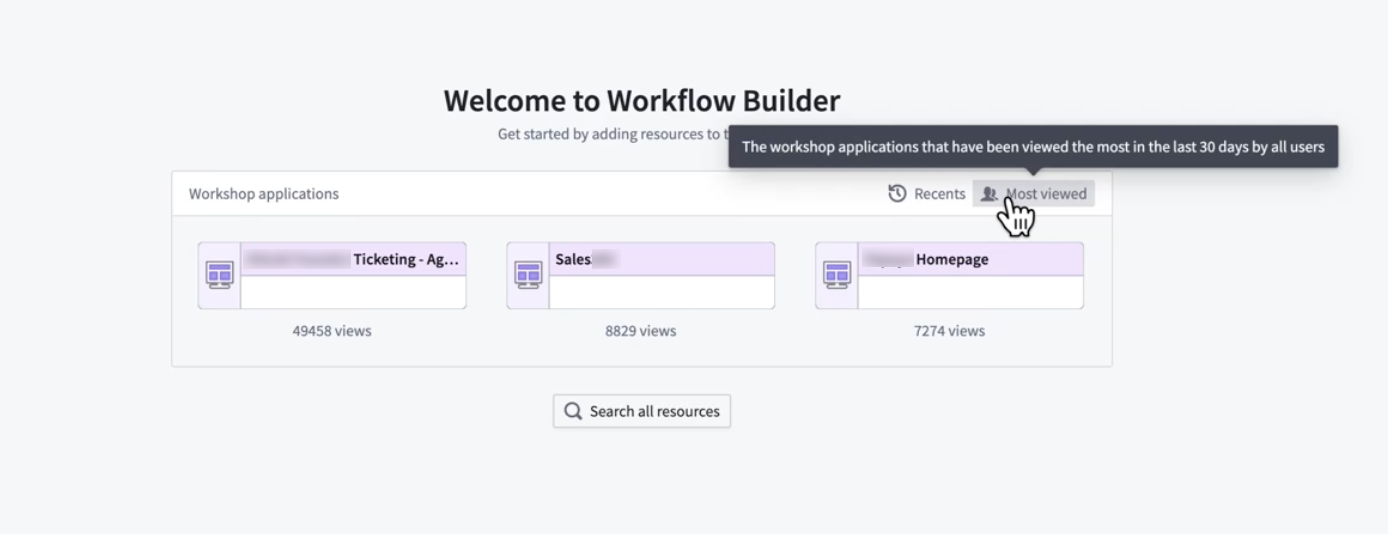
最も閲覧された Workshop モジュールから選択します。
Workshop アプリケーションを選択すると、Workflow Lineage のグラフに、そのアプリケーションの元となるリソースが自動的に追加されます。これは、Workshop モジュールから Cmd + i キーボードショートカットを直接使用したときにグラフが生成される仕組みと同様です。
この更新により、これまで以上に簡単にはじめられます。最も重要なワークフローにすぐにアクセスして、探索、学習、構築を進められます。
Workflow Lineage の機能について詳しくはこちらのドキュメントをご覧ください。
ご意見をお聞かせください
Palantir サポートまたは Developer Community ↗ を通じて、フィードバックをお寄せください。
関数のバージョン範囲依存関係
公開日:2025-06-26
これまで、Foundry アプリケーションが依存できる関数のバージョンは、固定されたバージョンに限られていました。関数のバージョン範囲依存関係の導入により、Workshop、Actions、Automate などのアプリケーションで、関数への依存関係をバージョン範囲で指定できるようになりました。これにより、実行時の自動アップグレードが可能になり、開発サイクルの時間を節約できるとともに、デプロイ済みの関数をダウンタイムなしでアップグレードできます。
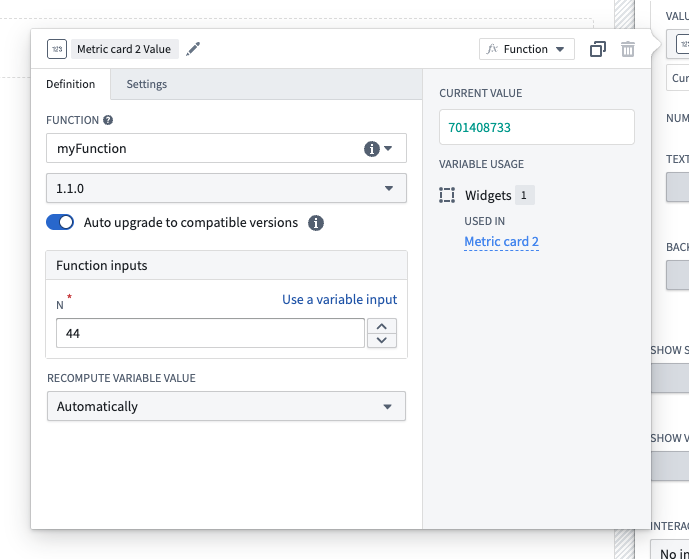
新しい自動アップグレード切り替えを使って、Workshop の関数ベースのウィジェットにバージョン範囲依存関係を設定します。
機能の動作と考慮事項を理解するには、バージョン範囲依存関係のドキュメントを参照してください。
関数のバージョンを管理する
バージョン範囲依存関係の導入により、適切なリリースバージョン管理がこれまで以上に重要になります。このプロセスを支援するため、関数にタグを付ける際に新しい下位互換性チェックを利用できるようになりました。
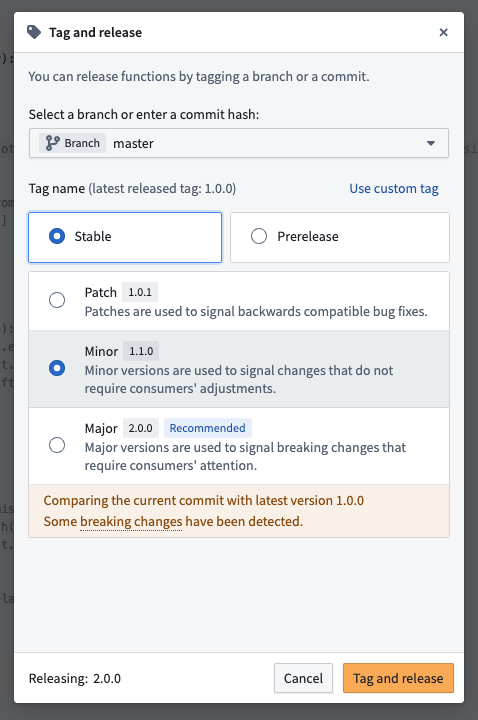
Code Repositories で関数の新しいバージョンにタグを付けると、下位互換性チェックが自動的に実行されます。
関数の利用者に安定した信頼性の高い利用体験を提供できるよう、関数のバージョンを適切に管理する方法を確認してください。
フィードバックをお寄せください
関数を使用した体験について、ぜひフィードバックをお寄せください。Palantir サポートのチャネル、または Developer Community ↗ で functions タグ ↗を使用して、ご意見をお聞かせください。
Code Repositories と VS Code Workspaces で Python 3.12 サポートが利用可能に
公開日:2025-06-26
Code Repositories と VS Code Workspaces で、すべてのエンロールメントにおいて Python 3.12 サポートが利用可能になりました。Python の起動時間の改善、内包表記の最適化、メモリー使用量の削減など、新しい機能が追加されています。このバージョンは、Python トランスフォームのプレビュー、チェック、ビルド時を含め、すべての Python 環境で利用可能です。
Python 3.12 の主な改善点は次のとおりです。
- 起動の高速化: インタープリターの初期化時間を短縮(すべての Python プロセスの起動時間が10~15%改善)
- メモリーの最適化: 全体的なメモリー使用量を削減
- マルチスレッドの改善: サブインタープリターによるパフォーマンスの向上
- 内包表記のインライン化: Python の内包表記を大幅に高速化
最新のパフォーマンス改善と重要なセキュリティ修正を利用するには、リポジトリをアップグレードし、Python 環境を推奨バージョンに設定するか、Python 3.12 を明示的に選択します。
オントロジー SDK を使って高度な To-do アプリケーションを構築する:VS Code Workspaces で利用可能に
公開日: 2025-06-24
VS Code Workspaces で利用できる高度な To-do アプリケーションは、実用的な例として To-do アプリケーションを構築することで、オントロジー SDK とプラットフォーム SDK の高度な機能の使い方を示します。次の機能をはじめ、オントロジー SDK の多くの機能について学べます。
- オントロジーインターフェース: オントロジーインターフェースを使用して、バックエンドサービスとシームレスにやり取りします。
- メディアセットによるメディアコンテンツの処理: To-do アプリケーション内でメディアコンテンツを効率的に処理します。
- 実行時派生プロパティ: 実行時派生プロパティを活用して、動的なデータ処理とリアルタイムの更新を行います。
- プラットフォーム SDK: プラットフォーム SDK と統合して、アプリケーションの機能を強化します。
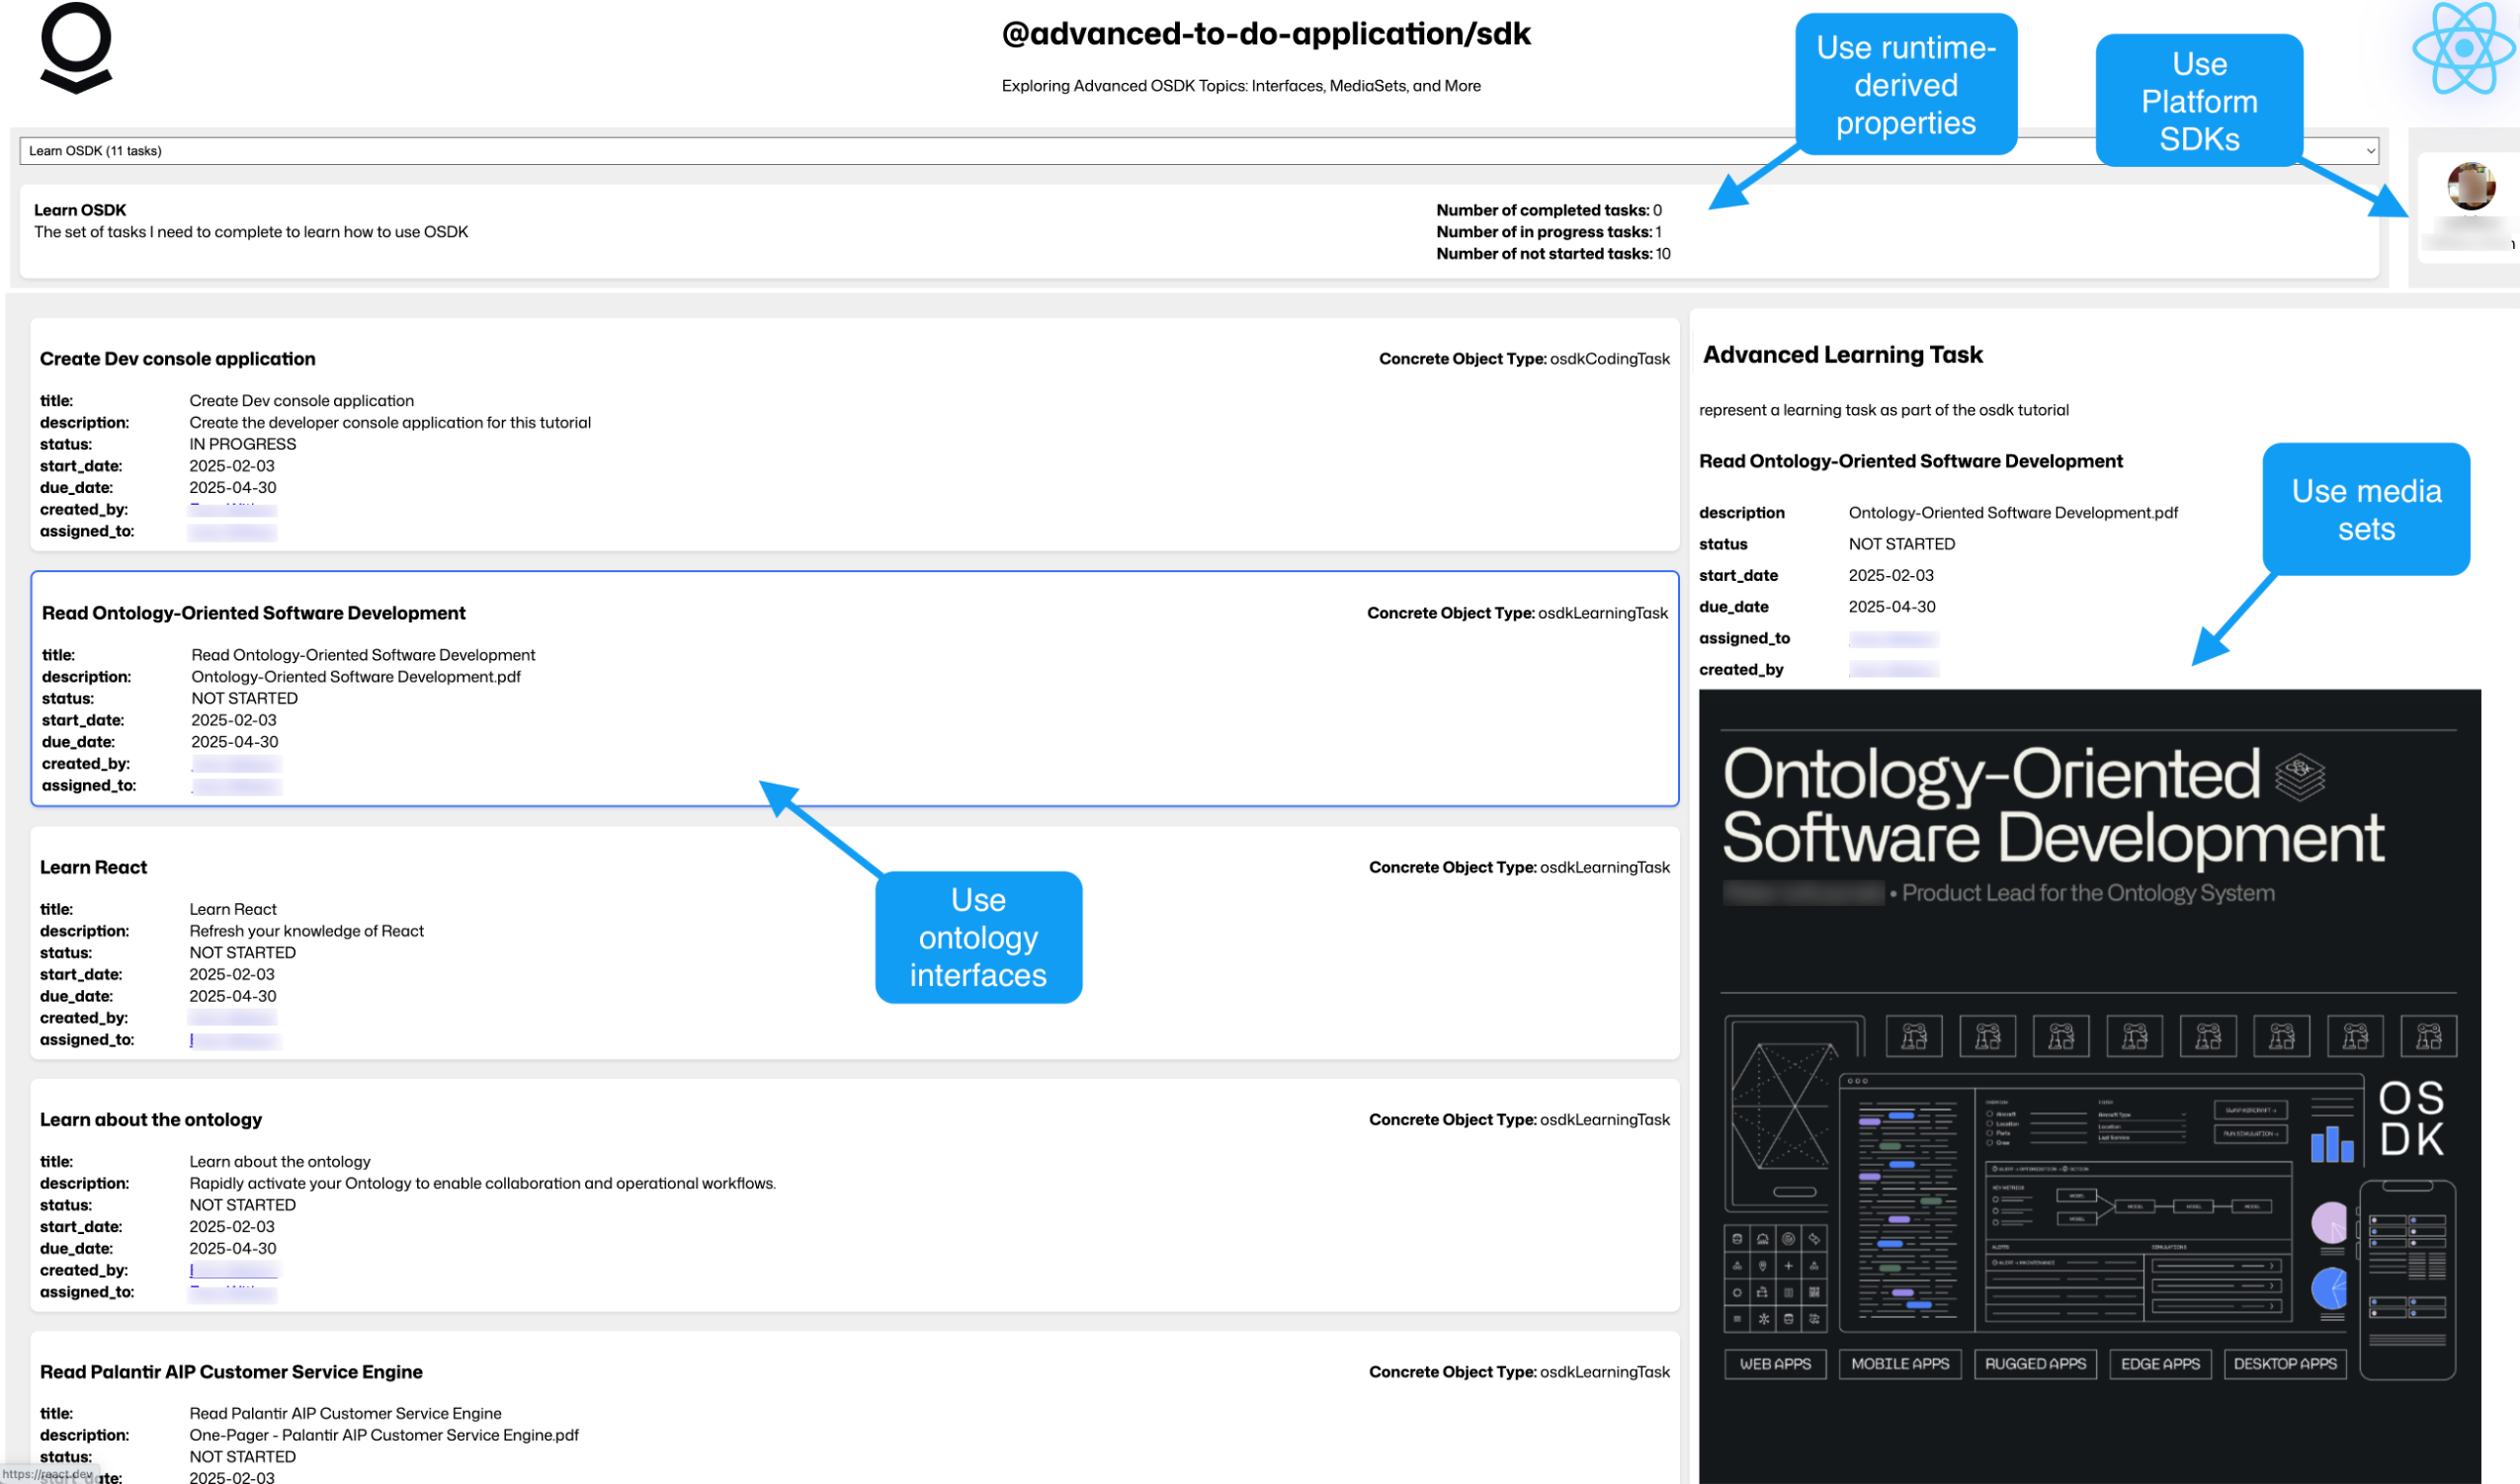
高度な To-do アプリケーション。オントロジー SDK の高度な機能が使用されている箇所に注釈が付いています。
はじめに
高度な To-do アプリケーションの例にアクセスしてインストールするには、Code Workspaces アプリケーションを開き、+ 新規ワークスペースの作成を選択します。次に、VSコード > アプリケーションを選択し、厳選された例の一覧からアプリケーションを探します。
プラットフォームの Examples (Build with AIP) でアプリケーションを検索することも、Developer Console のオントロジー SDK 参照の例で検索することもできます。
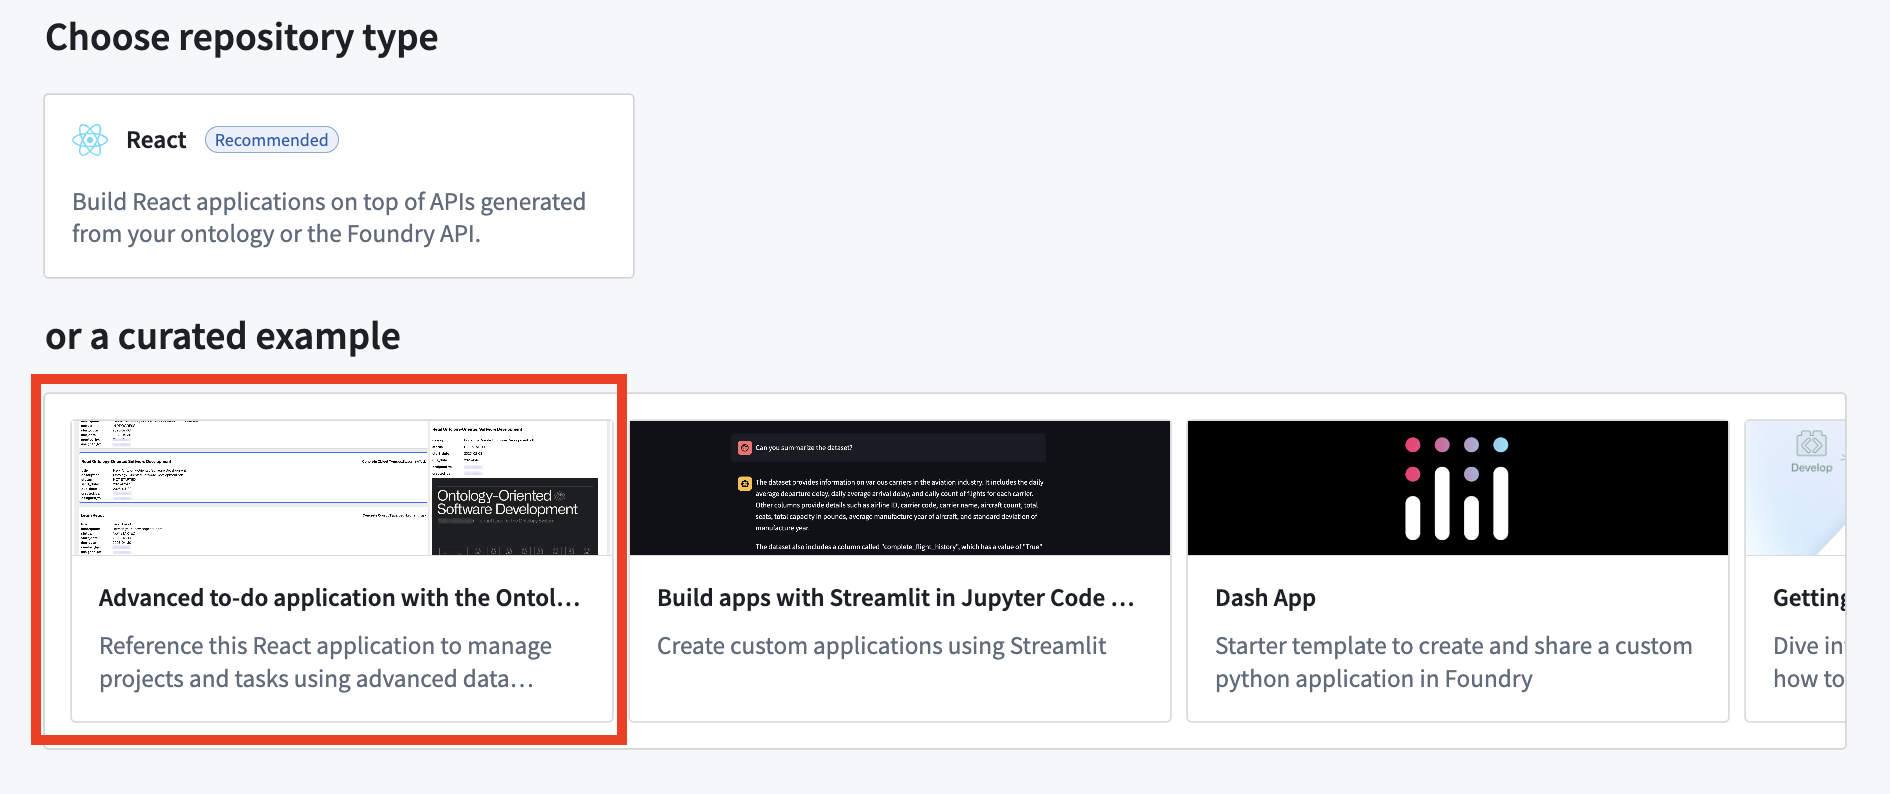
VS Code ワークスペースでアプリケーションを作成し、高度な To-do アプリケーションの例を選択します。
その後、Marketplace を通じて高度な To-do アプリケーションがインストールされます。
この例には何が含まれていますか?
この例を初めてインストールすると、高度な To-do アプリケーションのオントロジーが含まれます。これは、API名の一意性と不変性を維持するため、各スペースに1回だけインストールできるオントロジーです。インストール後、アプリケーションを実行する前に、すべてのオブジェクトがオントロジーに同期されていることを確認してください。Object Explorer で高度な To-do オブジェクトタイプを開くと、確認できます。同期後は、この例を開くとオントロジーのデータが自動的に表示されるはずです。
インストールされた例はコードリポジトリを開き、Visual Studio Code 用の Palantir 拡張機能を使用して、VS Code ワークスペースでアプリケーションを実行します。付属の Markdown ドキュメントを確認すると、プロジェクトの詳細やデータサービスの詳しい説明を読むことができます。また、公開ドキュメントを探索して、アプリケーションのアーキテクチャと設定、および使用されているカスタム React フックについて詳しく知ることもできます。
今後の予定は?
現在、オントロジーインターフェースを使った書き込み操作や、その他の高度な絞り込みパターンなど、オントロジー SDK で利用できるほかの機能を示す例の追加に取り組んでいます。追加してほしい例やチュートリアルのアイデアがある場合は、Palantir サポート、または Developer Community で ontology-sdk タグを使用して ↗、フィードバックをお寄せください。
AIP Evals のメトリクス目標のご紹介
公開日: 2025-06-19
AIP Evals でメトリクス目標が利用可能になり、評価結果の測定方法や解釈方法をより細かく制御できるようになりました。これまでは、テストケースごとにメトリクスの生の値を確認できました。しかし、特に複数のメトリクスや大規模なスイートを扱う場合、モデルの出力が期待を実際に満たしているかどうかを一目で判断するのは困難でした。
メトリクス目標を使うと、評価スイートのメトリクスごとに、成功とみなす条件を定義できるようになります。ブールメトリクスでは、true と false のどちらを合格とするかを選択できます。数値メトリクスでは、値が高いほうがよいか、低いほうがよいかを選択でき、必要に応じて合格のしきい値を設定できます。これにより、基準の適用や、モデルの性能低下または改善の迅速な特定が容易になります。

ブールメトリクスと数値メトリクスに設定された合否の設定。
評価スイートを実行すると、設定された目標に基づいて、AIP Evals がメトリクスとテストケースごとの合否ステータスを自動的に判定して表示します。実行結果ダイアログでは、設定した基準に従ってどのメトリクスとテストケースが合格または不合格になったかが明確に可視化されるようになり、品質の追跡や結果の共有が容易になります。

実行結果ダイアログに表示されるメトリクスとテストケースの合否ステータス。
AIP Evals のメトリクス目標について詳しくはこちら。
AIP Evals のメトリクス目標についてさらにサポートが必要な場合は、Palantir サポートにお問い合わせいただくか、コミュニティフォーラム ↗をご覧ください。
AIP エージェントの複数種類の取得コンテキスト対応を紹介
公開日: 2025-06-19
注記:2026年4月27日の週から、AIP Agent Studio は AIP Chatbot Studio に名称変更されました。既存の機能はすべて変更なく利用できます。
AIP エージェントが取得コンテキスト内で複数の種類に対応するようになりました。これにより、オブジェクトセット、関数、ドキュメントを同時に取得コンテキストとして指定できます。新しいユーザーメッセージごとに、エージェントに種類が追加された順序で、各コンテキストが文字列のプロンプトに解決されます。同じ種類のコンテキストを複数指定することにも対応しているため、同じ取得コンテキストのプロンプト内で、あるドキュメントコレクションにはセマンティック検索を、別のコレクションには全文抽出を使用できます。

複数の種類を使用して、エージェントに追加の取得コンテキストを指定できるようになりました。
複数のコンテキストの種類に対応するため、エージェントの引用設定が一元化されました。以前は、引用設定は、ドキュメント、オントロジー、関数 RAG といった個々の取得コンテキスト設定内にネストされていました。既存の引用設定はすべて新しい一元化された引用設定に移行されているため、複数種類の取得コンテキストを利用するためにユーザーが追加の操作を行う必要はありません。

AIP Agent Studio のサイドバーで、オブジェクトタイプごとにカスタムの引用動作を設定します。
さらに、すべての取得コンテキストに対して引用を一括で有効または無効にできるようになりました。引用設定ではオントロジーの引用に対するオーバーライドを設定でき、各オブジェクトタイプをそれぞれ専用の引用オーバーライドにマッピングできます。たとえば、オブジェクトタイプ A からの引用では外部リンクを開き、オブジェクトタイプ B からの引用ではメディアアイテムを開くように設定できます。


引用を有効にすると、ユーザーが AIP エージェントの使用した情報ソースを確認できるようになります。
複数種類の取得コンテキストへの対応については、取得コンテキストのドキュメントをご覧ください。
フィードバックを共有する
ご利用の感想やフィードバックをお待ちしています。Palantir サポートのチャネル、または Developer Community ↗ で、aip-agent-studio ↗ タグを使用してご意見をお寄せください。
use_sidecar の紹介:Python トランスフォーム内の専用コンテナでモデルを実行
公開日: 2025-06-12
palantir_models バージョン 0.1673.0 以降、ModelInput クラスで、Python トランスフォーム内で使用できる use_sidecar パラメーターが公開されています。use_sidecar を True に設定すると、Spark トランスフォーム自体を実行するマシン上にプロビジョニングされた別のコンテナでモデルが実行されます。これにより、プラットフォーム全体で、モデルを簡単かつ移植性と信頼性を備えた形で本番利用できます。この機能は、別のリポジトリやコードワークスペースで構築したモデルを推論のために Python トランスフォームにインポートする際に発生しうる依存関係の競合を防ぎます。さらに、モデルが構築時とまったく同じ依存関係で動作することを保証し、予期しない動作や実行時の障害からユーザーを保護します。
use_sidecar は軽量トランスフォームでは利用できず、サイドカーの ModelInput を使用するトランスフォームのプレビューも利用できないことに注意してください。
主な機能とメリット
- 依存関係の分離:
use_sidecarは、元の依存関係を備えた管理された環境でモデルが実行されることを保証し、トランスフォームのライブラリとの競合を防ぎます。 - 再現性の保証:モデルの学習および検証時と同一のライブラリバージョンが使用されることが保証されるため、一貫性と信頼性を確保してモデルを実行できます。
- リポジトリをまたぐ利用と複数モデルの利用の簡素化:別のリポジトリや Code Workspace で構築されたモデルを使用する場合、
use_sidecarが正しいモデルアダプターコードの読み込みを自動的に管理します。これにより、新しいモデルバージョンでアダプターコードや依存関係が変更された場合に、トランスフォームのリポジトリ内の依存関係を手動で更新して確認する必要がなくなり、競合を心配することなく同じリポジトリに複数のモデルをインポートできます。 - カスタマイズ可能なリソース:
sidecar_resourcesパラメーターを使用して、サイドカーコンテナの CPU、メモリー、GPU リソースを指定できます。
使用方法
コンテナ内にモデルを読み込むには、use_sidecar=True を設定するだけです。ほかにコードを変更する必要はありません。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20from transforms.api import Input, Output, transform, TransformInput, TransformOutput from palantir_models.transforms import ModelInput, ModelAdapter @transform( out=Output('path/to/output'), model_input=ModelInput( "path/to/my/model", use_sidecar=True, sidecar_resources={ "cpus": 2.0, "memory_gb": 4.0, "gpus": 1 } ), data_in=Input("path/to/input") ) def my_transform(out: TransformOutput, model_input: ModelAdapter, data_in: TransformInput) -> None: inference_outputs = model_input.transform(data_in) out.write_pandas(inference_outputs.output_df)
詳しくは、ModelInput クラスのリファレンスドキュメントをご覧ください。
Control Panel でカスタムのエンロールメントロールを設定する
公開日: 2025-06-10
Control Panel のエンロールメント権限ページからカスタムロールを作成し、エンロールメントレベルのワークフローに対して細かく権限を付与できるようになりました。
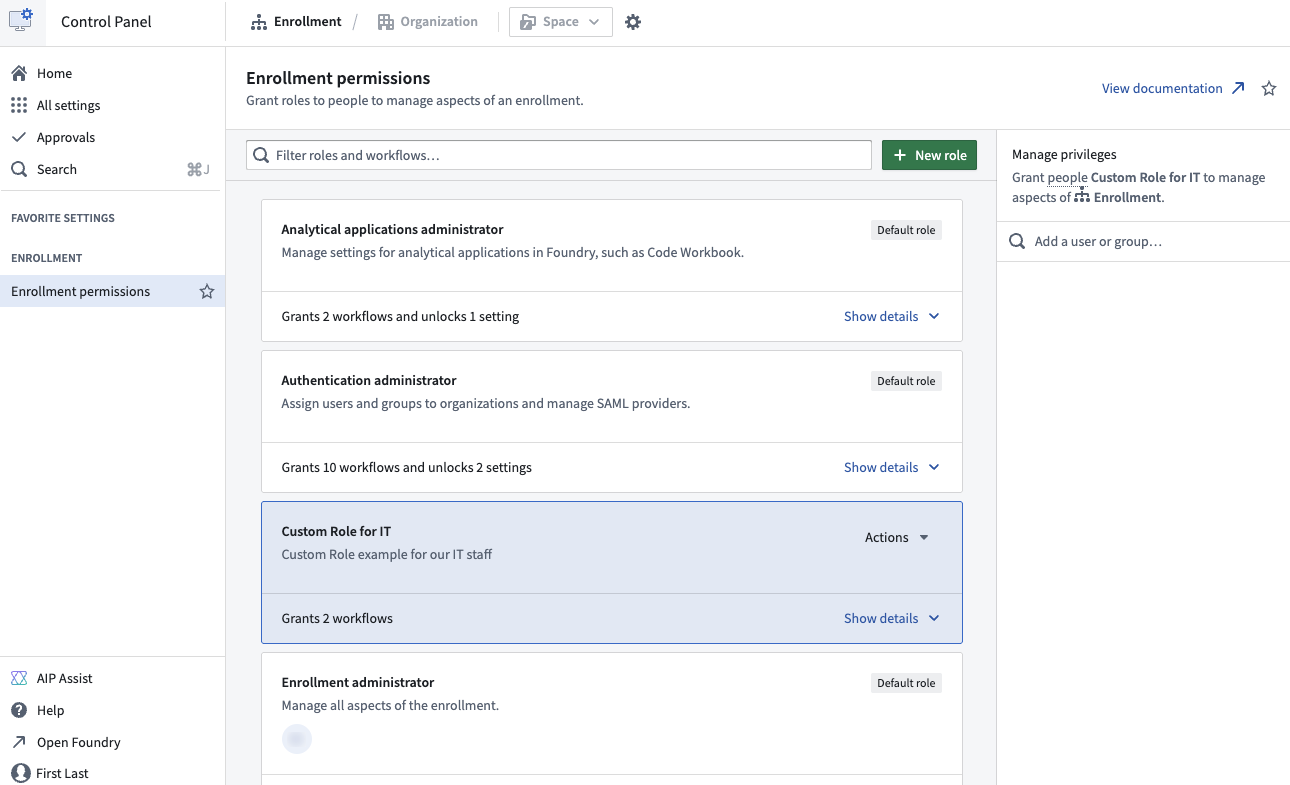
Control Panel のエンロールメント権限設定ページで、エンロールメントのカスタムロールを設定します。
カスタムロールは、ユーザーやグループが、既存のデフォルトロールに合致しない特定のワークフローの権限を必要とする場合に便利です。たとえば、カスタムの IT グループを作成することで、イングレスやエグレスの設定を変更する権限を付与せずに、そのグループにドメインを追加または変更する権限を付与できます。
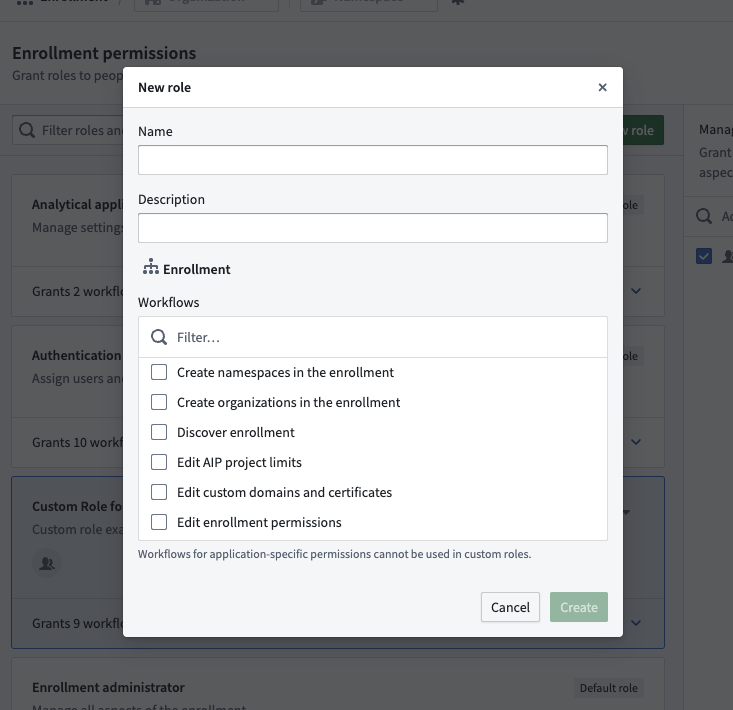
新しいカスタムロールのメンバーに権限を付与するワークフローを個別に選択します。
カスタムロールの作成をはじめるには、Control Panel でエンロールメント権限の設定に移動します。詳しくは、公開ドキュメントをご覧ください。
カスタムロールについてさらに支援が必要な場合は、Palantir サポートにお問い合わせいただくか、Community Forum ↗ をご利用ください。
プロセスの構築、自動化、最適化を実現する Machinery のご紹介
公開日: 2025-06-05
Machinery は、医療処置、保険査定、政府業務などの実世界のイベントをプロセスとしてモデル化するアプリケーションです。ニーズに合わせたカスタム AI 搭載アプリケーションを通じて、そのプロセスをリアルタイムで探索できます。6月の第1週より、Machinery はすべてのエンロールメントで一般提供されています。
Machinery を使用してプロセスをマイニングまたは実装し、望ましくない振る舞いを特定して、望ましい結果の達成に向けて進捗を測定しながら進められます。また、人による介入を促すことで、非効率性を減らし、プロセスのパフォーマンスを継続的に改善できます。

Machinery でプロセスをゼロから実装し、レビューして最適化します。
Machinery の一般的なワークフローには、次のようなものがあります。
- AIP と自動化を活用してプロセスの非効率性を解消する
- 複数の AI エージェントをオーケストレーションし、AIP のユースケースをエンドツーエンドで管理する
- 人によるリアルタイムの介入で AIP ワークフローを監督する業務アプリケーションを構築する
- 外部のイベントログから進行中のプロセスをマイニングし、既存のプロセスを可視化する
- パフォーマンスのメトリクスとデータが満たすべき条件を定義および監視し、プロセスのボトルネックを特定する
自動化と AIP でプロセスを最適化する
Palantir プラットフォームでプロセスを実装するには、オブジェクトタイプ、アクション、自動化など、多くの個別リソースを使用します。Machinery は、これらすべてのコンポーネントを包括的に表示し、自動化と手動アクションの順序立てられたフローを定義できるようになりました。状態を中心とした独自の視点により、組織のエッジケースに対処して解決しながら、望ましい結果に向けて段階的に進められます。さらに、Value Type と実行条件によって、適合性を保証する仕組みを追加できます。

自動化ノードを Machinery グラフに組み込めます。
Machinery は、カスタムレイアウトアルゴリズムを備えています。自動レイアウト機能により、手動で操作しなくても見やすいグラフを作成できます。この機能を無効にして要素を自由に移動し、個人の好みに合わせて調整することもできます。
単一の Machinery グラフでの複数オブジェクトタイプのモデル化
サブプロセスと並列プロセスを作成することで、ワークフローの柔軟性と制御性を高められます。サブプロセスでは、メインの Machinery プロセス内にネストされたプロセスを作成できます。これにより、複雑なタスクを構造化して管理し、より大きなワークフローにシームレスに統合できます。このモジュール化されたアプローチは並列プロセスにも対応しており、複数のプロセスを同時に実行できるため、効率の向上とボトルネックの削減につながります。
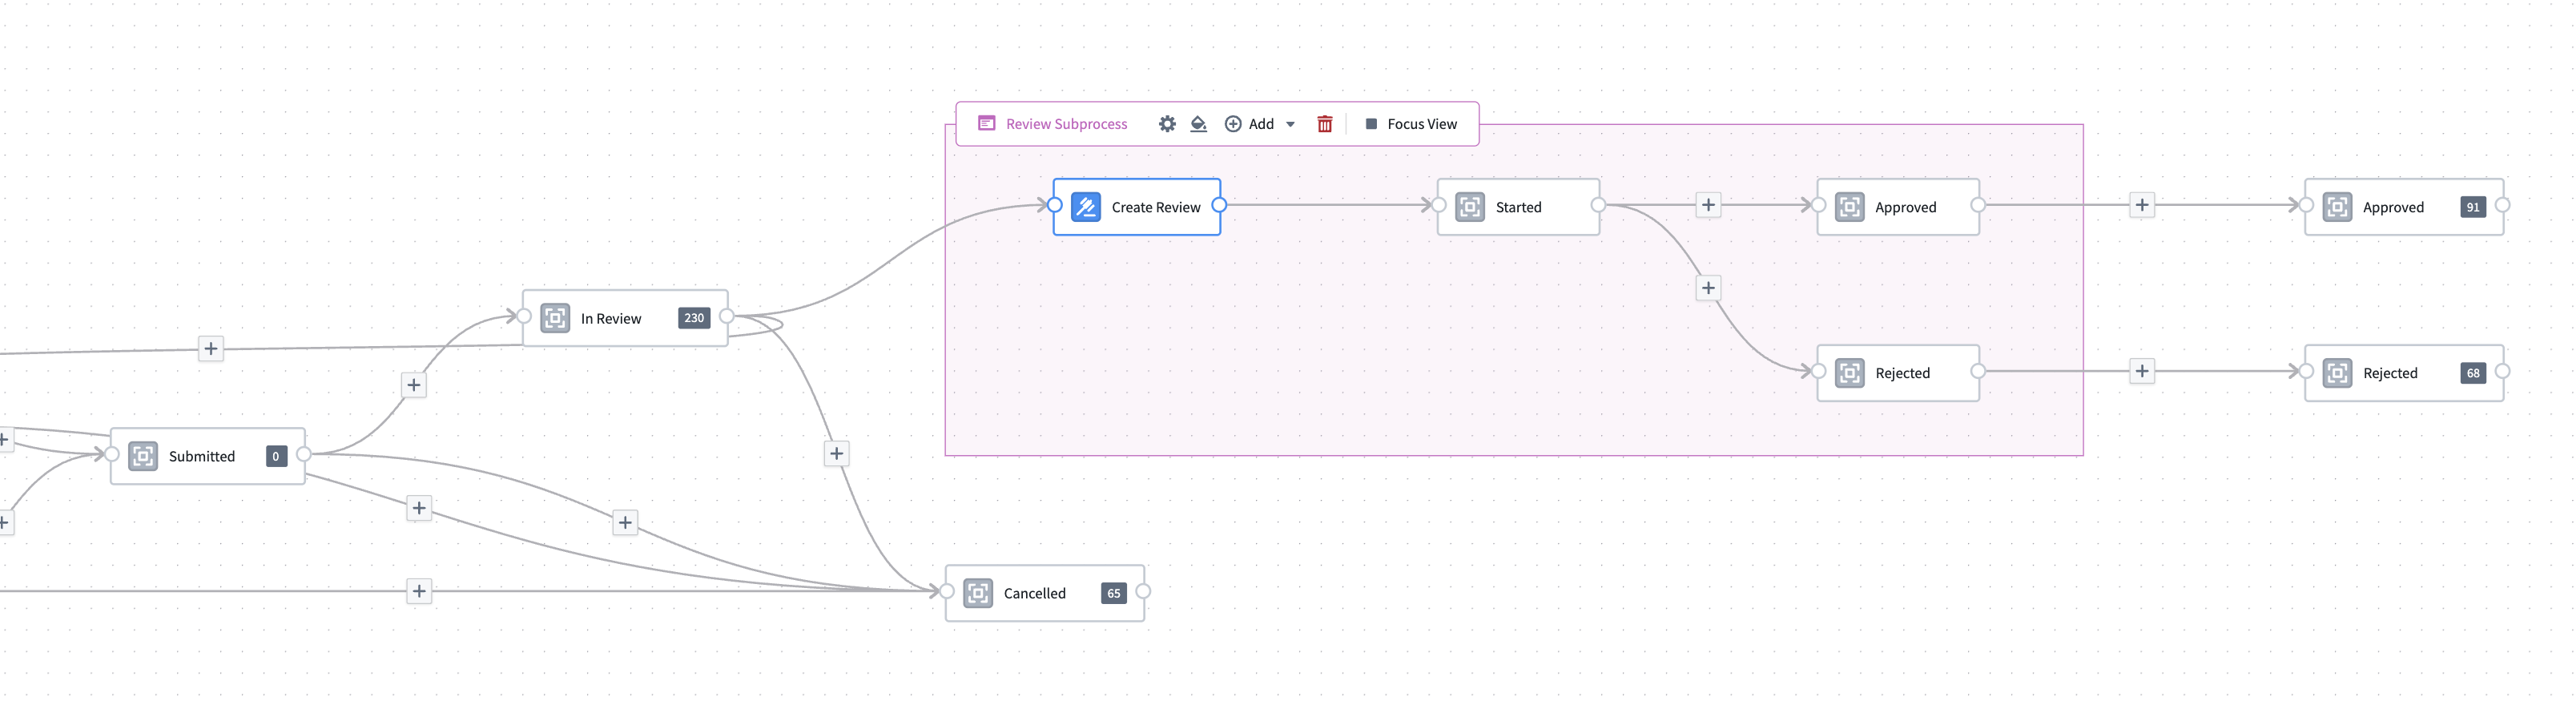
Machinery でリンクされた複数のプロセスを構築し、組織全体にわたって動作するプロセスをモデル化できるようになりました。
フォーカス表示機能では、特定のサブプロセスを拡大して詳細を表示できるため、複雑なワークフローのナビゲーションと管理が容易になり、ユーザー体験がさらに向上します。これらの機能により、組織全体の複雑さを管理してプロセスの自動化をより高度に進められ、最終的に生産性の向上と業務の効率化につながります。
マイニングモード
ログオントロジーを設定すると、マイニングモードに移行できます。このモードでは、既存の状態と編集候補の両方をセピア色で強調表示する専用のグラフが表示されます。特定の状態をマイニングから除外することで、ノイズを効果的に減らし、関連するデータに集中できます。遷移頻度スライダーを使用して重要度の低いノードを絞り込み、整理された自動レイアウトのグラフを活用しながら、最も重要な遷移のみを強調表示できます。
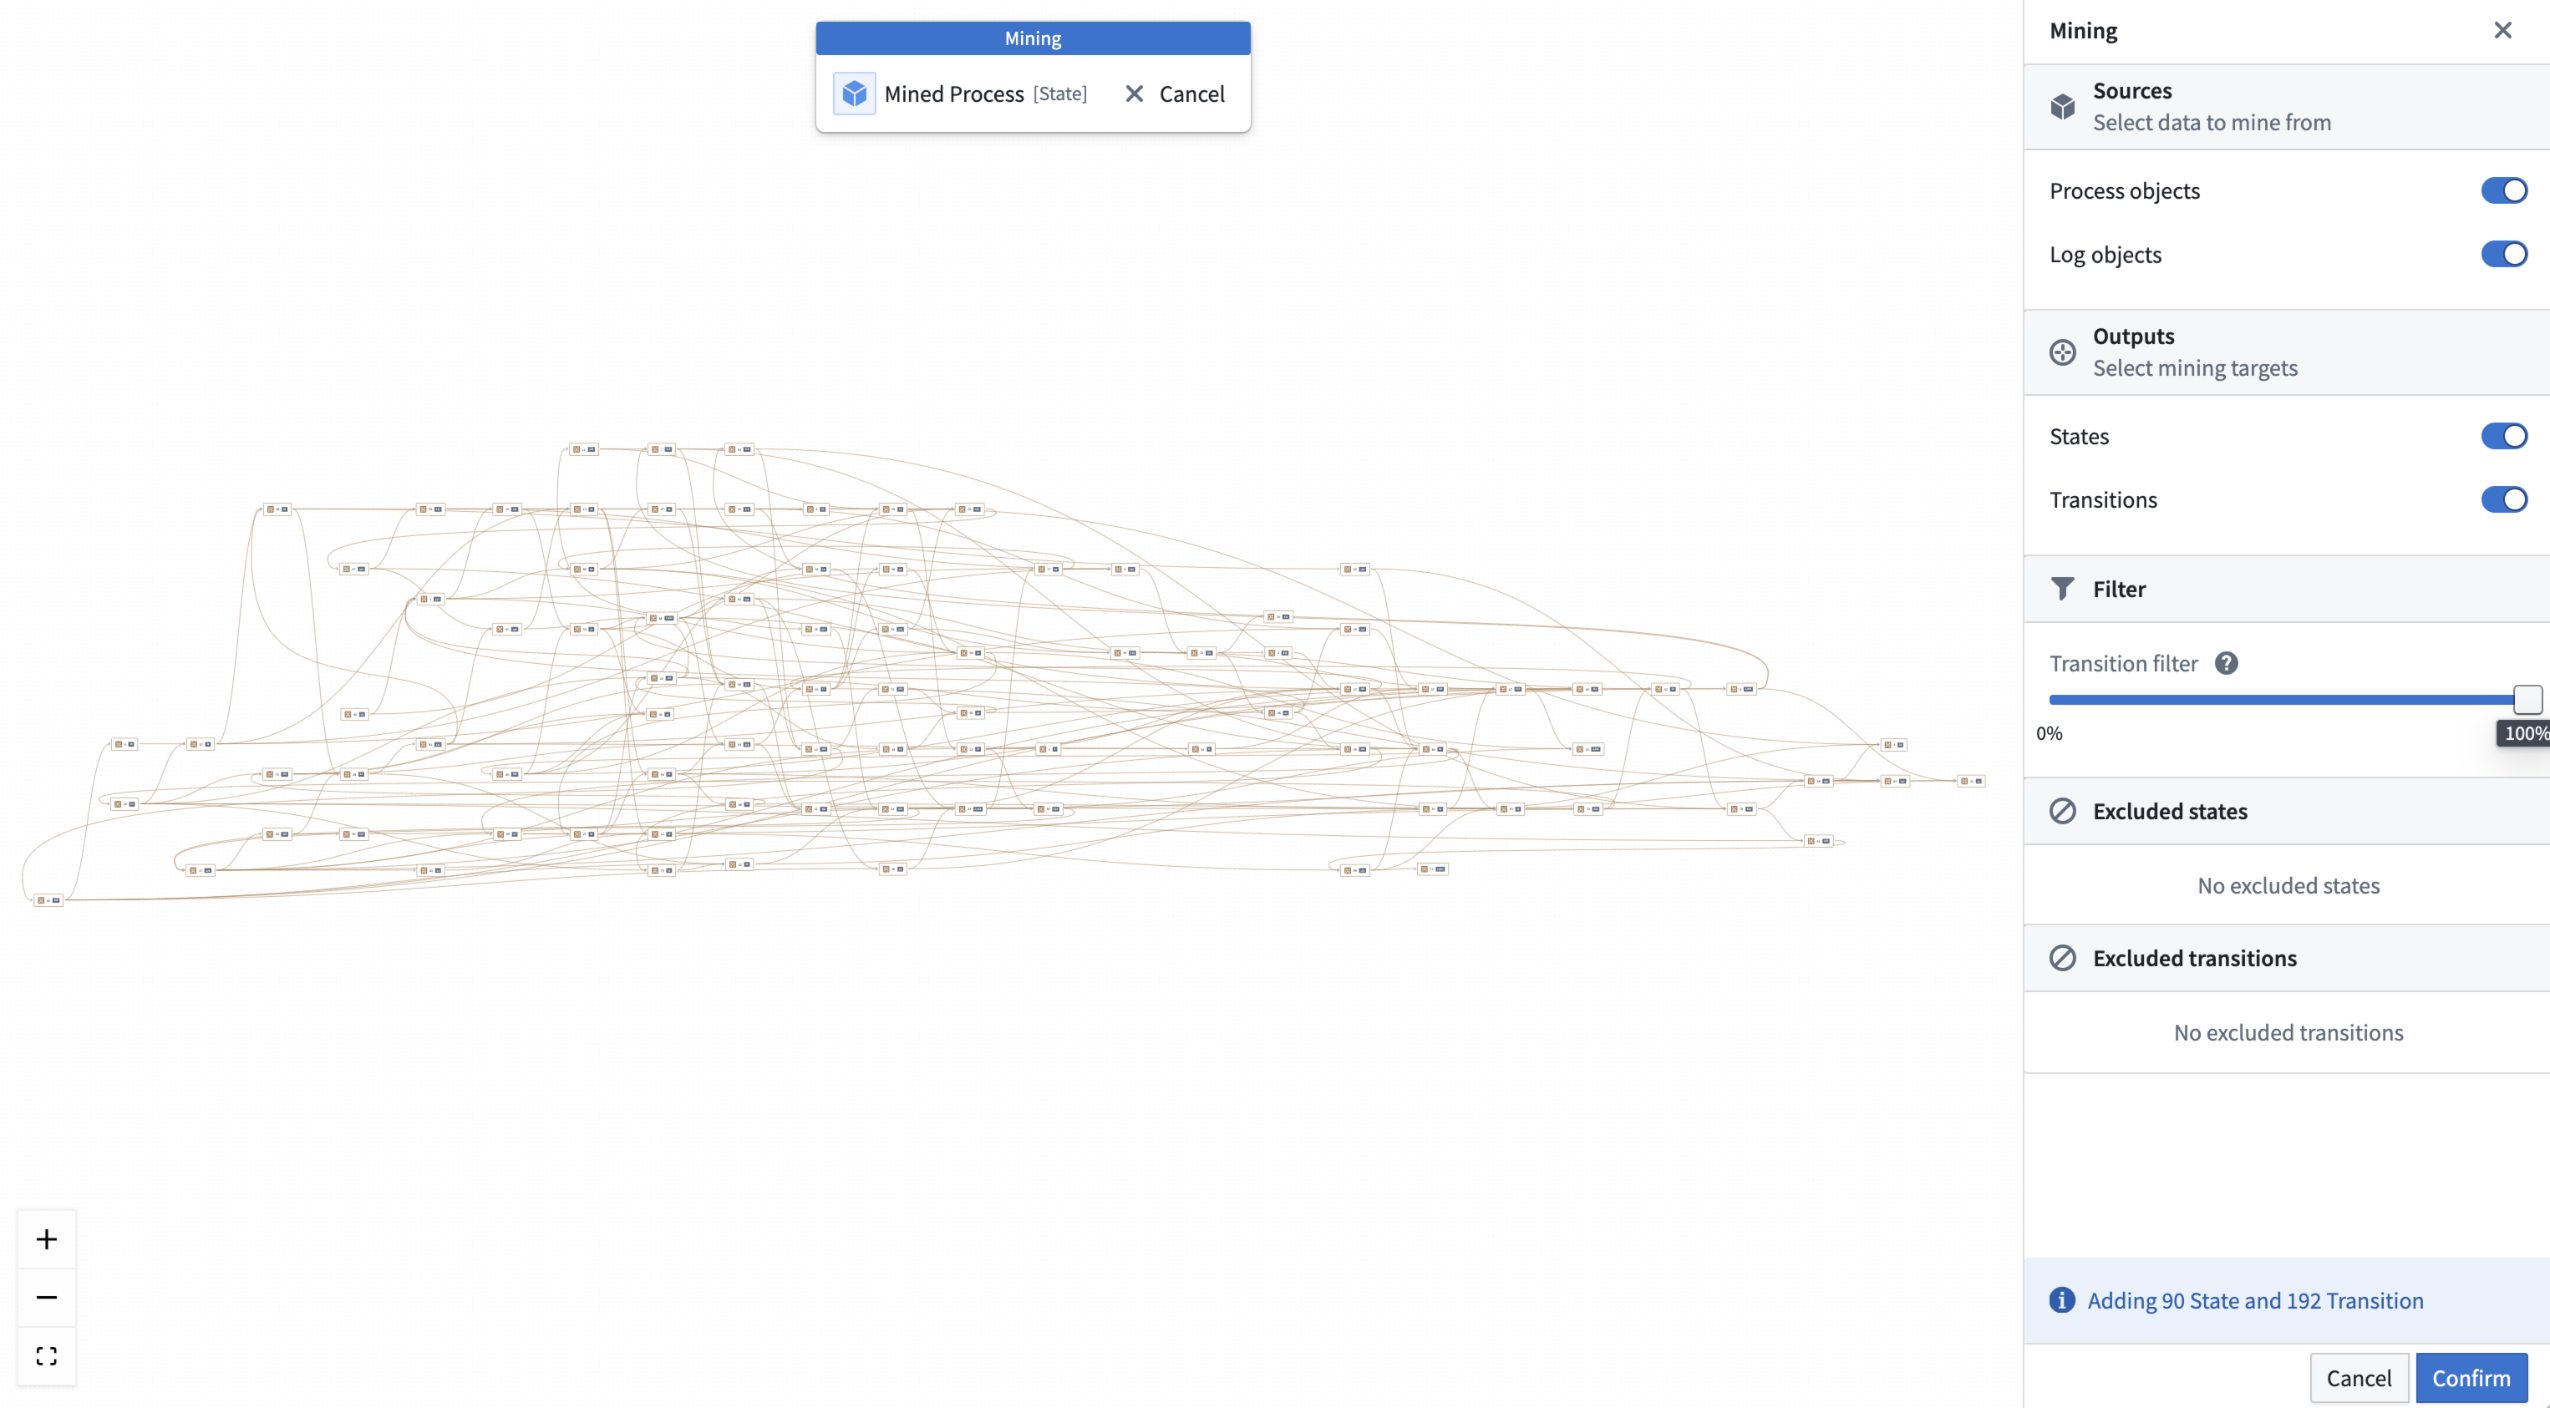
Machinery のマイニングモードでプロセス全体をマイニングします。

通過するオブジェクトが71.5%未満のノードを除外する遷移フィルターを使用した Machinery のマイニングモード。
Workshop モジュールを生成して開発をセットアップする
Palantir プラットフォームでプロセスを業務に活用するには、ワンクリックで Workshop モジュール(「Machinery Express アプリケーション」)をすばやくセットアップし、アプリケーション開発を開始できます。Express アプリケーションは、分析を行い、エージェント型ワークフローにリアルタイムで介入できる動的な実験環境として機能します。その後、Machinery に戻り、アクション、自動化、AIP ロジック関数を使用してプロセスを改良、更新、最適化できます。
Machinery Express をすぐに使える分析ツールとして使用する場合でも、独自のアプリケーションを構築する基盤として使用する場合でも、プロセスの探索と改良を円滑に行き来できます。また、Machinery Express アプリケーションを使用すると、このプロセスを業務ユーザーとすぐに共有でき、システムをリアルタイムで効果的に活用するために必要なコンテキストを提供できます。
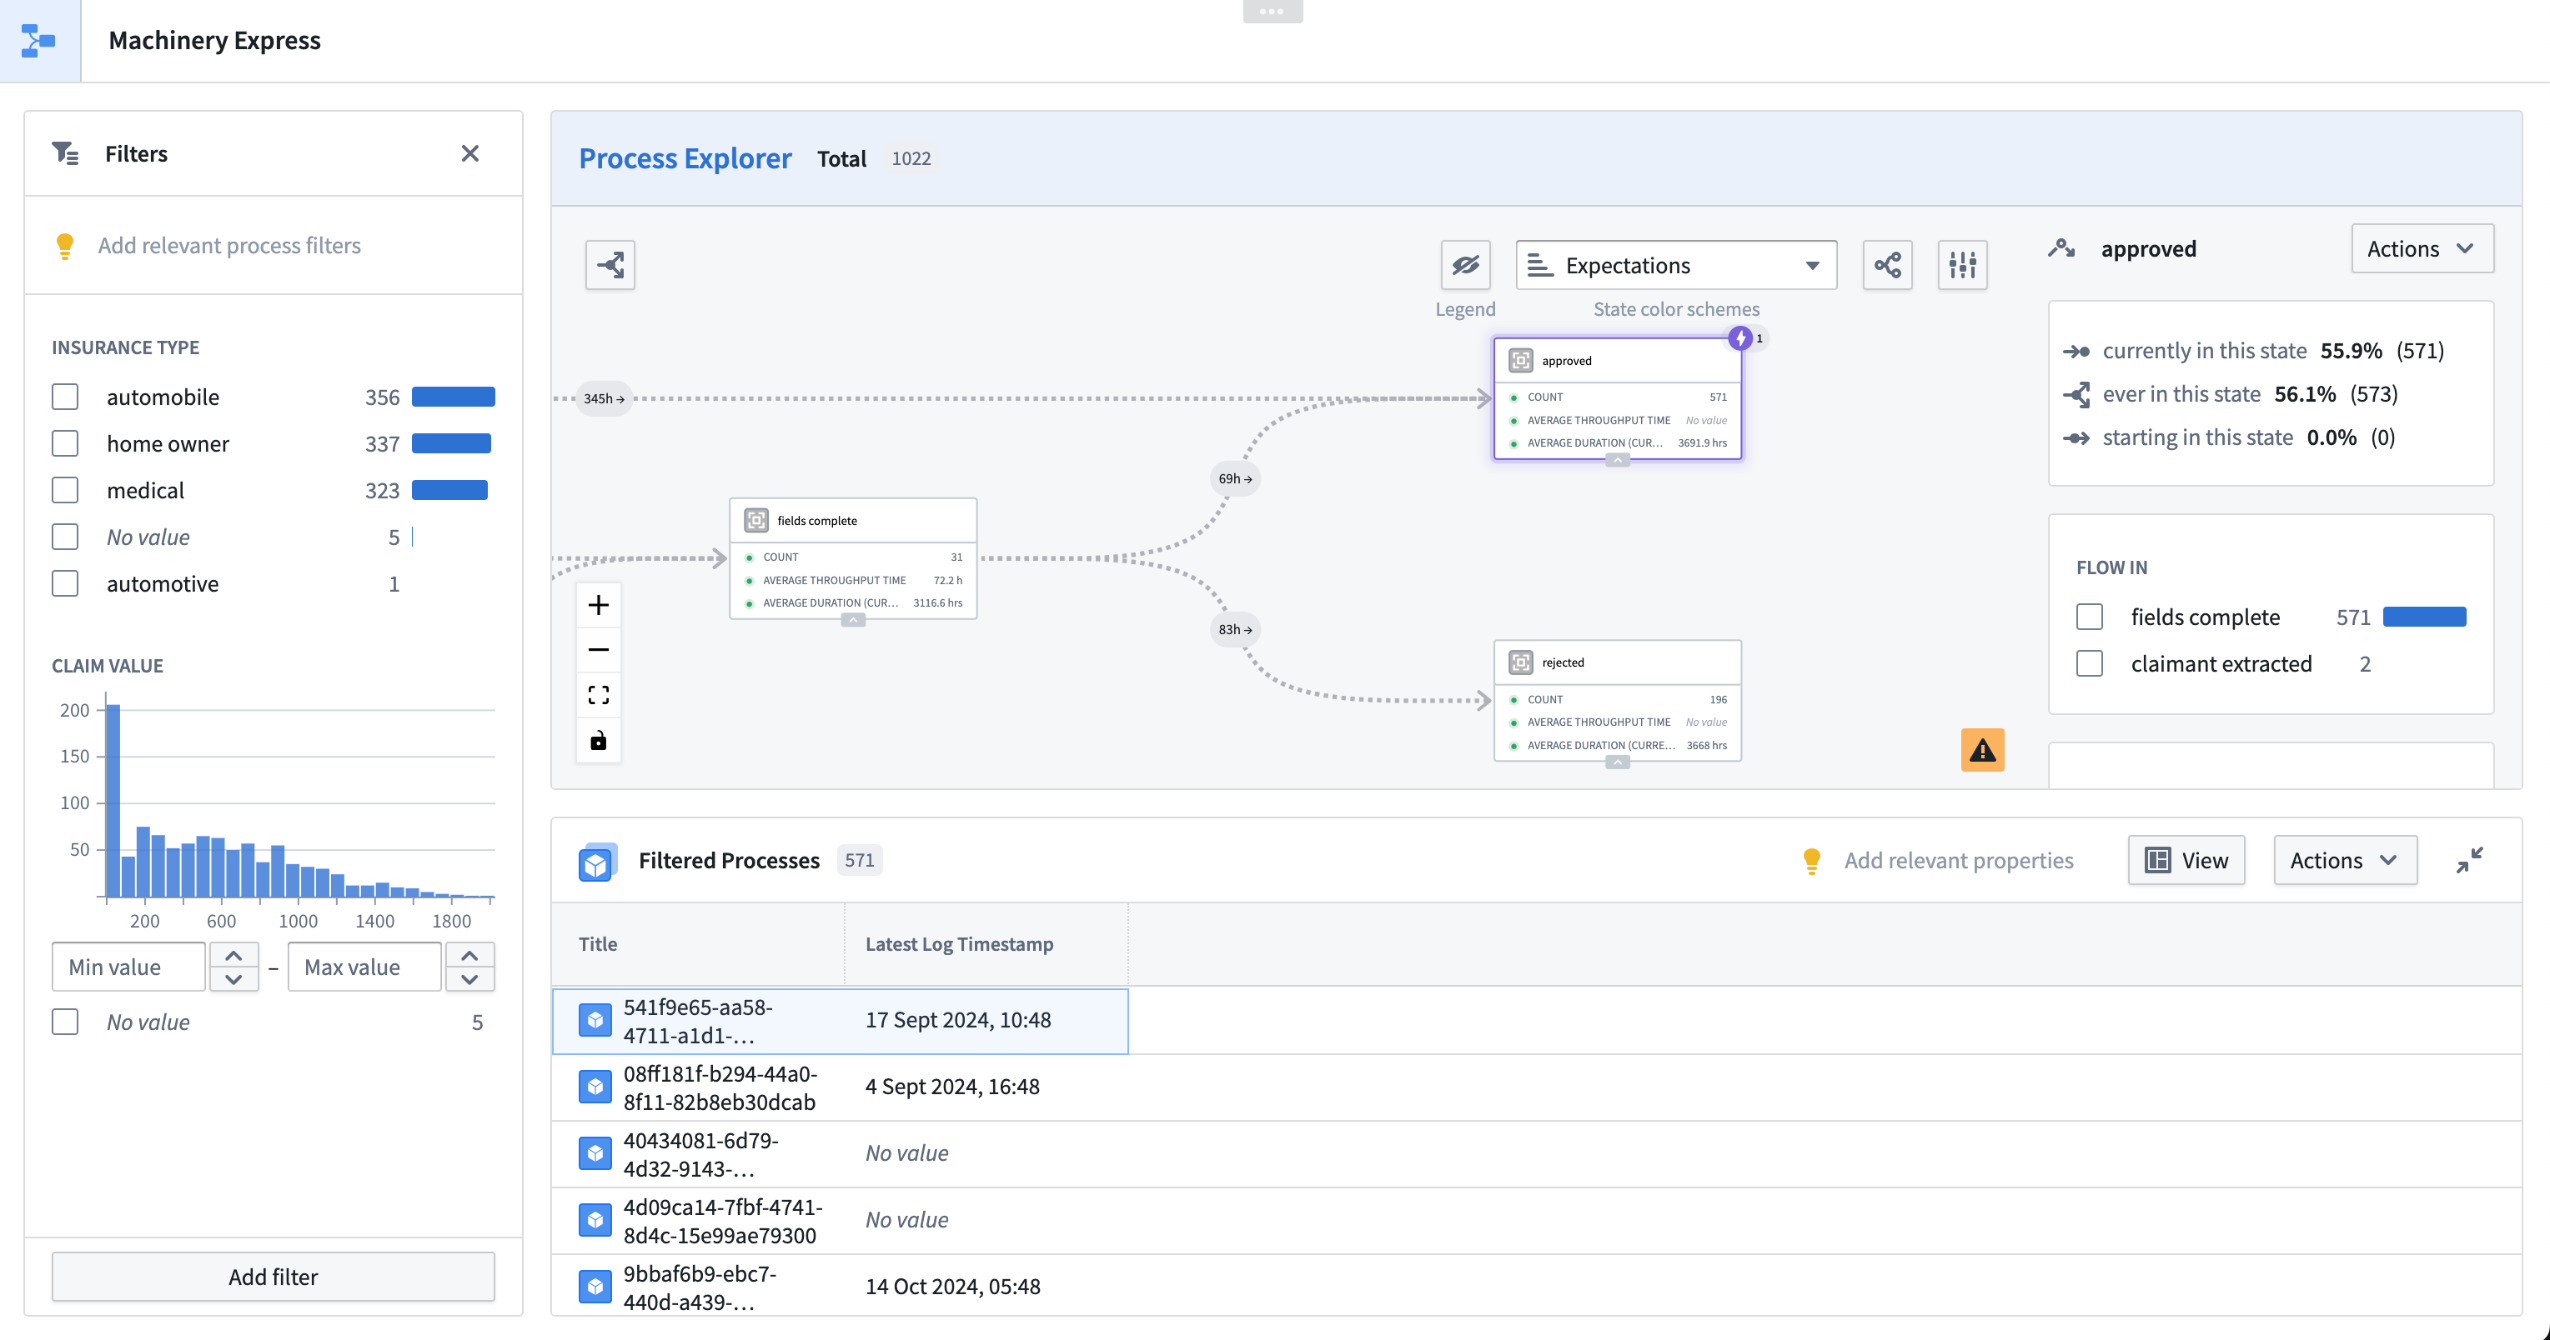
Machinery Express アプリケーションを生成し、Workshop でのアプリケーション開発を開始しやすくします。
新しいアプリケーションをゼロから構築する場合や、既存の Workshop モジュールに Machinery を追加する場合は、Workshop に Machinery プロセス概要ウィジェットを追加できます。
Machinery の詳細については、ドキュメントをご覧ください。
ご意見をお聞かせください
利用体験やフィードバックをぜひお寄せください。Palantir サポートのチャネル、または Developer Community ↗ で、machinery ↗ タグを使用してご意見を共有してください。
Databricks の強化された接続機能とコンピュートプッシュダウンが利用可能に
公開日: 2025-06-05

Palantir の Databricks とのパートナーシップ ↗の一環として、強化された接続オプションにより、データ、コンピュート、モデルを活用するさまざまな機能が提供され、Palantir と Databricks のプラットフォームをよりシームレスに統合できるようになりました。特に、仮想テーブル、コンピュートプッシュダウン、外部モデルが一般提供されるようになりました。
| 機能 | ステータス |
|---|---|
| 探索 | 🟢 一般提供 |
| 一括インポート | 🟢 一般提供 |
| インクリメンタル(差分連携) | 🟢 一般提供 |
| 仮想テーブル | 🟢 一般提供 |
| コンピュートプッシュダウン | 🟢 一般提供 |
| 外部モデル | 🟢 一般提供 |
詳細なガイドについては、Palantir の更新された Databricks ドキュメントを参照してください。
仮想テーブル
Palantir は、Databricks のデータを活用する強化された仮想テーブル機能を提供するようになりました。これには次の機能が含まれます。
- 単一の統合コネクターによる Spark および JDBC ベースの接続
- 強化された機能により、Delta Lake と Apache Iceberg の機能を利用できます
- Palantir は Unity REST API と Iceberg REST カタログを使用してテーブルにアクセスし、Unity Catalog から払い出された資格情報を使用して、基盤となるストレージの場所にあるデータを読み書きできるようになりました
- 仮想テーブルの一括登録と自動登録
- Contour、Code Repositories、Pipeline Builder での仮想テーブル入力
- Code Repositories と Pipeline Builder での仮想テーブル出力
- インクリメンタル(差分処理)パイプライン
Databricks の仮想テーブルの登録と使用について詳しくは、Databricks 仮想テーブルのドキュメントを参照してください。
コンピュートプッシュダウン
コンピュートを Databricks にプッシュダウンする機能が利用可能になりました。同じ Databricks ソースに登録された仮想テーブルをパイプラインの入力と出力として使用する場合、コンピュートを完全に Databricks に委譲できます。この機能は Databricks Connect ↗ を活用しており、現在は Python トランスフォームで利用可能です。
構文の詳細とクイックスタートの例については、Databricks コンピュートプッシュダウンのドキュメントを参照してください。
外部モデル
Unity Catalog に登録された Databricks モデルは、外部ホストモデルと外部トランスフォームを介して Palantir プラットフォームに統合できます。これにより、Palantir のユーザー、パイプライン、ワークフローアプリケーションで Databricks モデルを業務に活用できます。
詳しくは、Databricks 外部モデルのドキュメントを参照してください。
フィードバックを共有する
Palantir の Databricks 統合に関するフィードバックは、Palantir サポートチームにお問い合わせいただくか、Developer Community ↗ で databricks タグ ↗を使用してお寄せください。
データ変換における仮想テーブル出力のご紹介
公開日: 2025-06-05
Pipeline Builder と Code Repositories で、仮想テーブル出力がベータ機能としてサポートされるようになりました。仮想テーブルは、Palantir プラットフォーム外のソースシステムにあるテーブルへのポインターとして機能し、データを取り込まずにプラットフォーム内で使用できるようにします。これまで仮想テーブルは Foundry のデータ変換への入力としてのみ利用可能であり、出力データセットはすべて Foundry に保存されていました。今回の変更により、Foundry で作成したロジックと、外部に保存したデータを使用して、パイプライン全体をオーケストレーションできるようになりました。
仮想テーブル出力は、ほかの Pipeline Builder 出力と同じように追加できます。ノードを選択し、新しい仮想テーブル出力タイプを選択します。
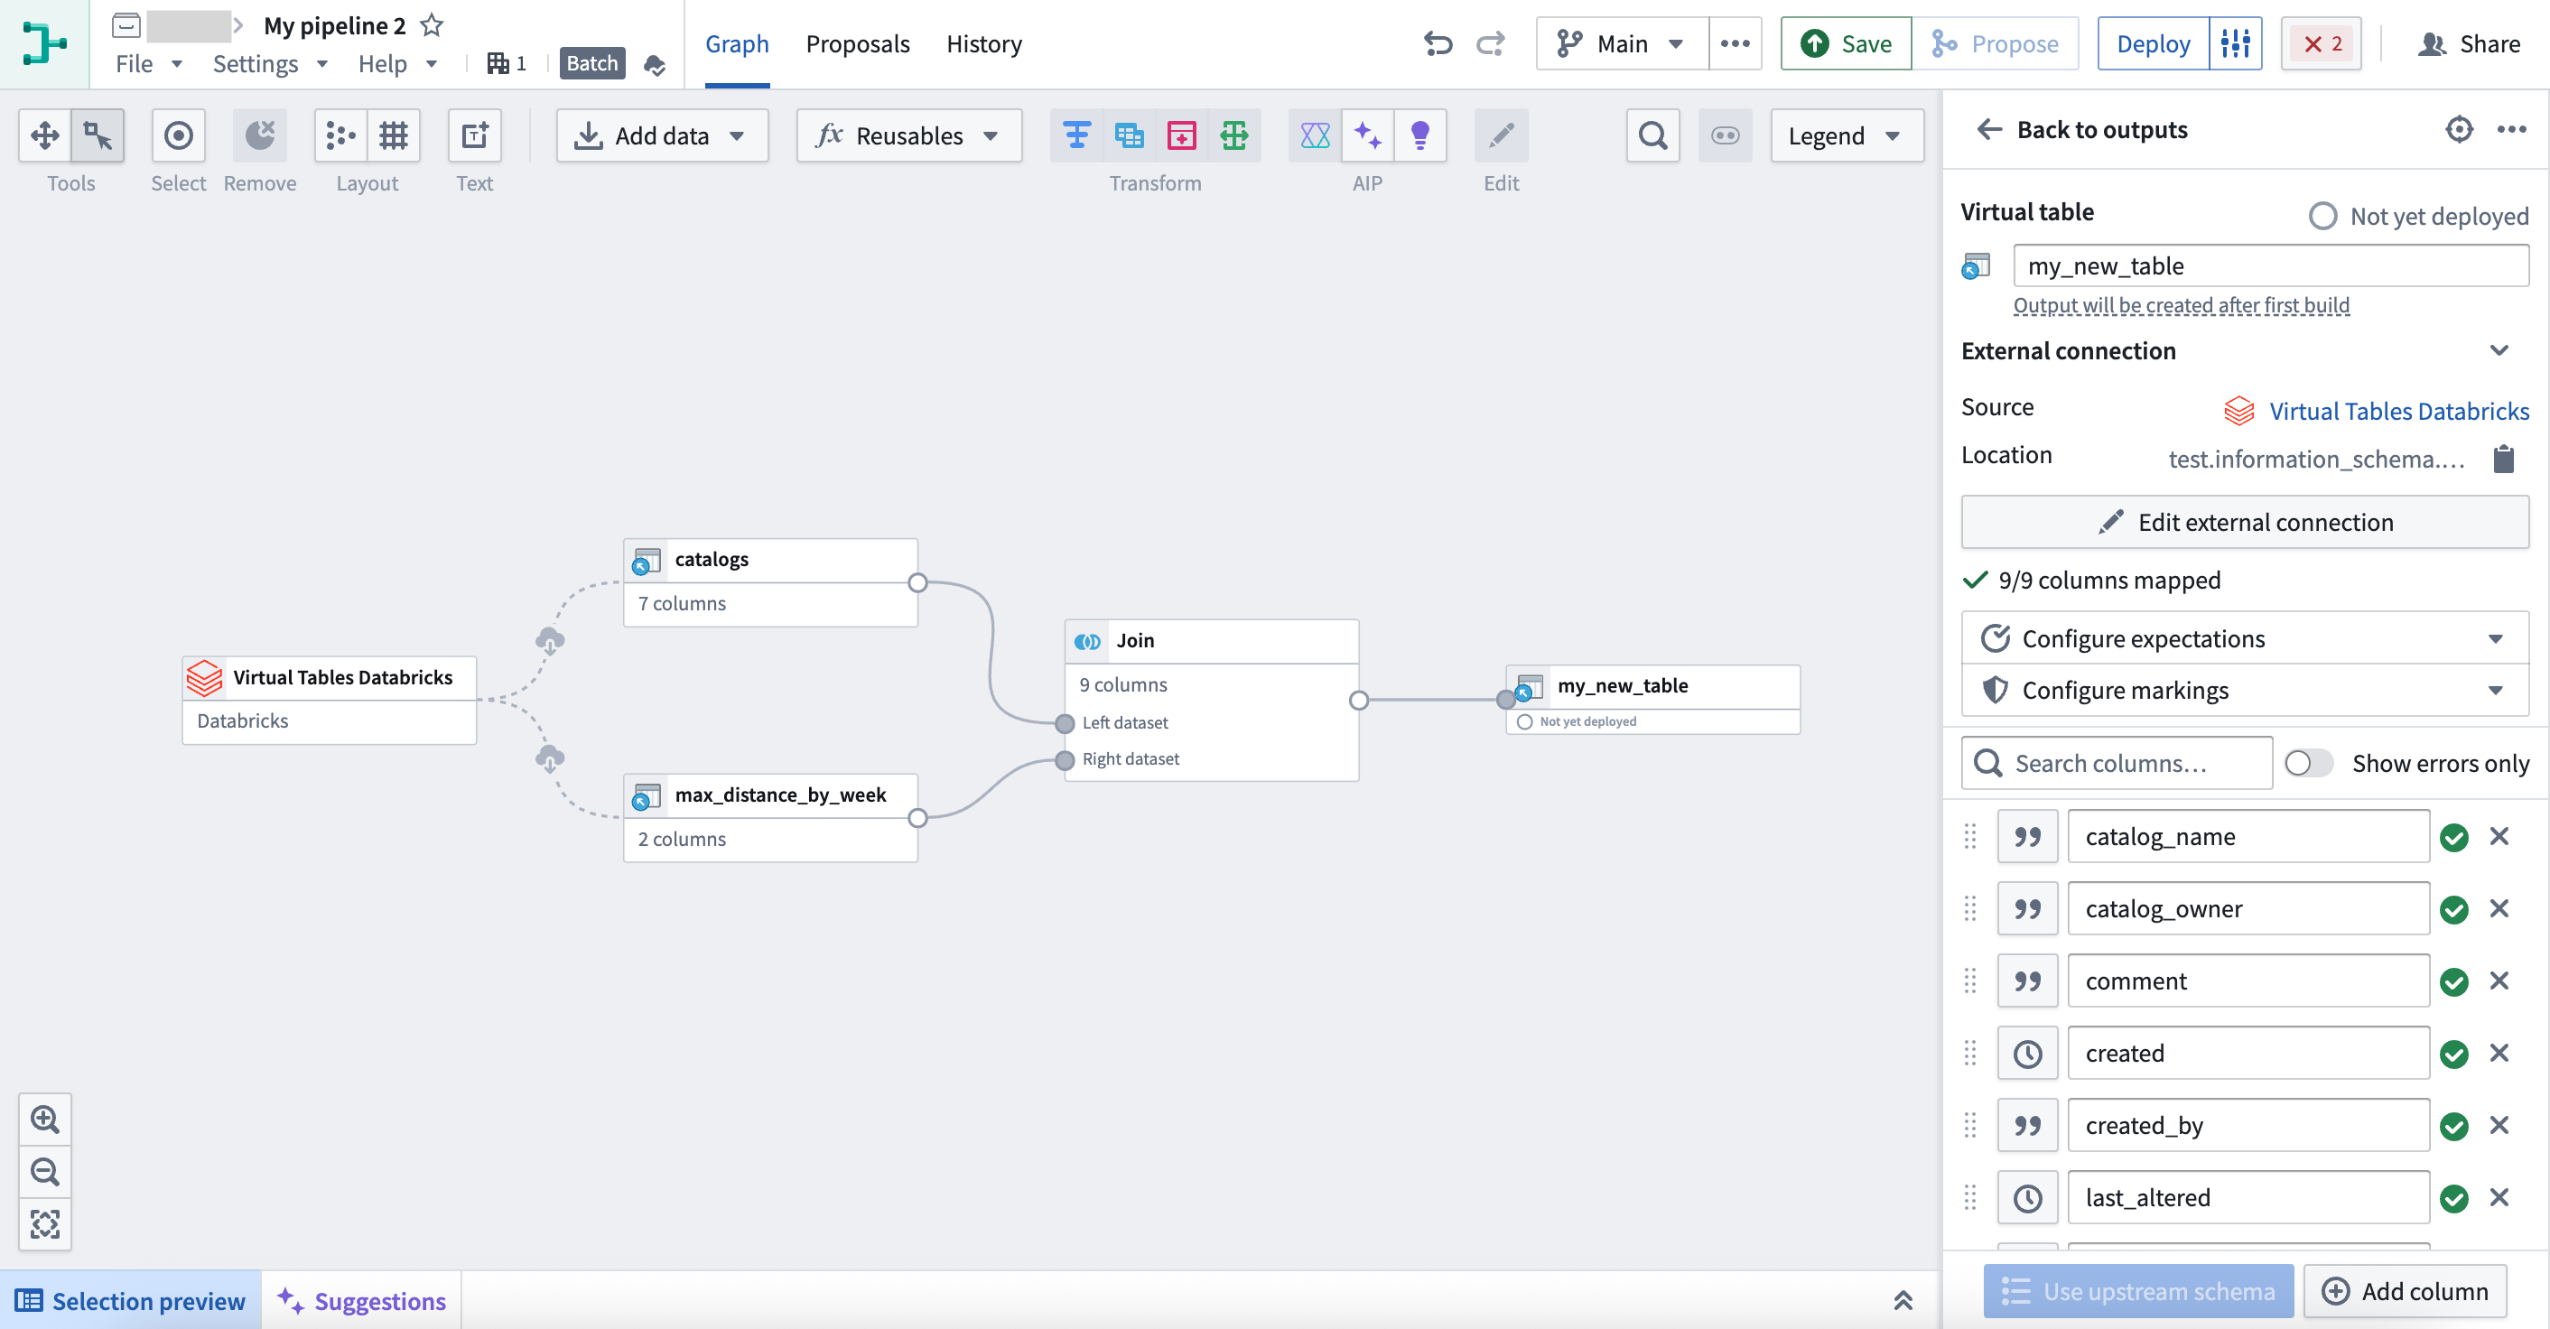
Pipeline Builder の仮想テーブル出力。
Code Repositories で出力を設定する際は、新しい仮想テーブルタイプを選択します。すると、出力ソースを設定するための入力画面が表示されます。
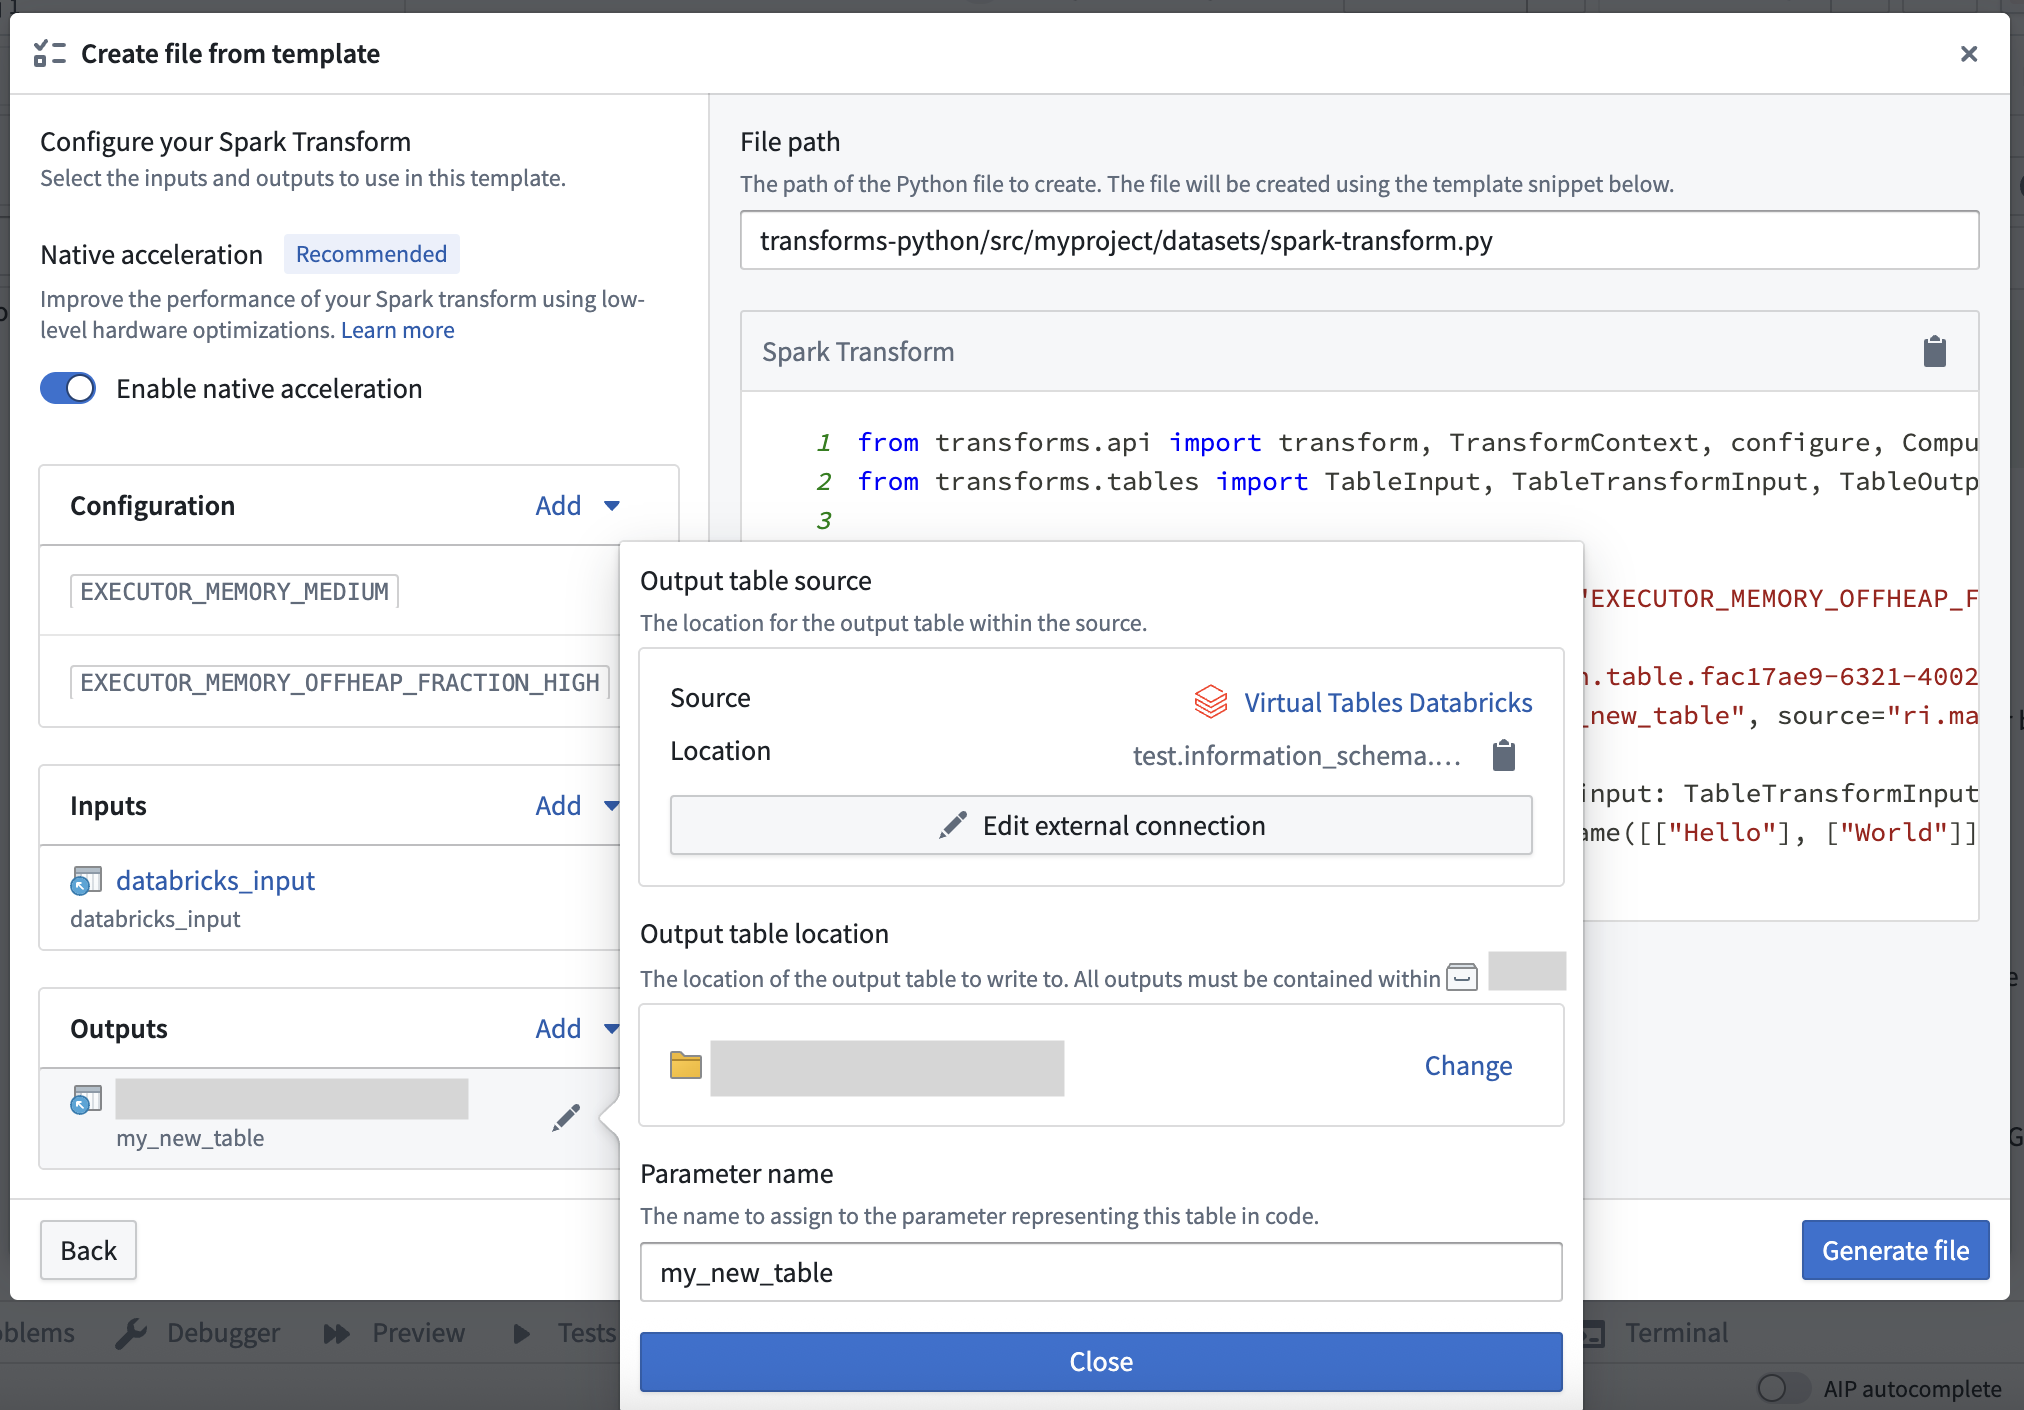
Code Repositories のファイルテンプレートで仮想テーブル出力を設定する様子。
次の場合、クエリのコンピュートが Foundry とソースシステムに分割されることがある点に注意してください。
- Pipeline Builder のすべてのクエリ
- コンピュートプッシュダウンを明示的に使用しない Code Repositories の変換。軽量トランスフォーム以外では、完全なコンピュートプッシュダウンはまだ利用できません。
今後の予定
Palantir プラットフォーム全体でテーブルのサポートを改善しています。今後は次の対応を予定しています。
- Code Workspaces での仮想テーブル。
- 入力と出力としての Foundry ネイティブの Iceberg テーブルのサポート。
フィードバックを共有する
仮想テーブル出力に関するフィードバックは、Palantir サポートチームにお問い合わせいただくか、Developer Community ↗ で virtual-tables タグ ↗を使用してお寄せください。
仮想テーブルの一括登録が利用可能に
公開日: 2025-06-05
Databricks、BigQuery、Snowflake などの表形式のソースタイプで、仮想テーブルを一括作成できるようになりました。仮想テーブルを作成を選択すると、サポート対象のソースに対して1個以上の仮想テーブルを一度に作成できます。

新しい仮想テーブルを作成する様子。
Data Connection で仮想テーブルを一括登録するには、左側のパネルで外部テーブルを選択し、右側のパネルで新しい仮想テーブルの Foundry 内の保存先を選択します。
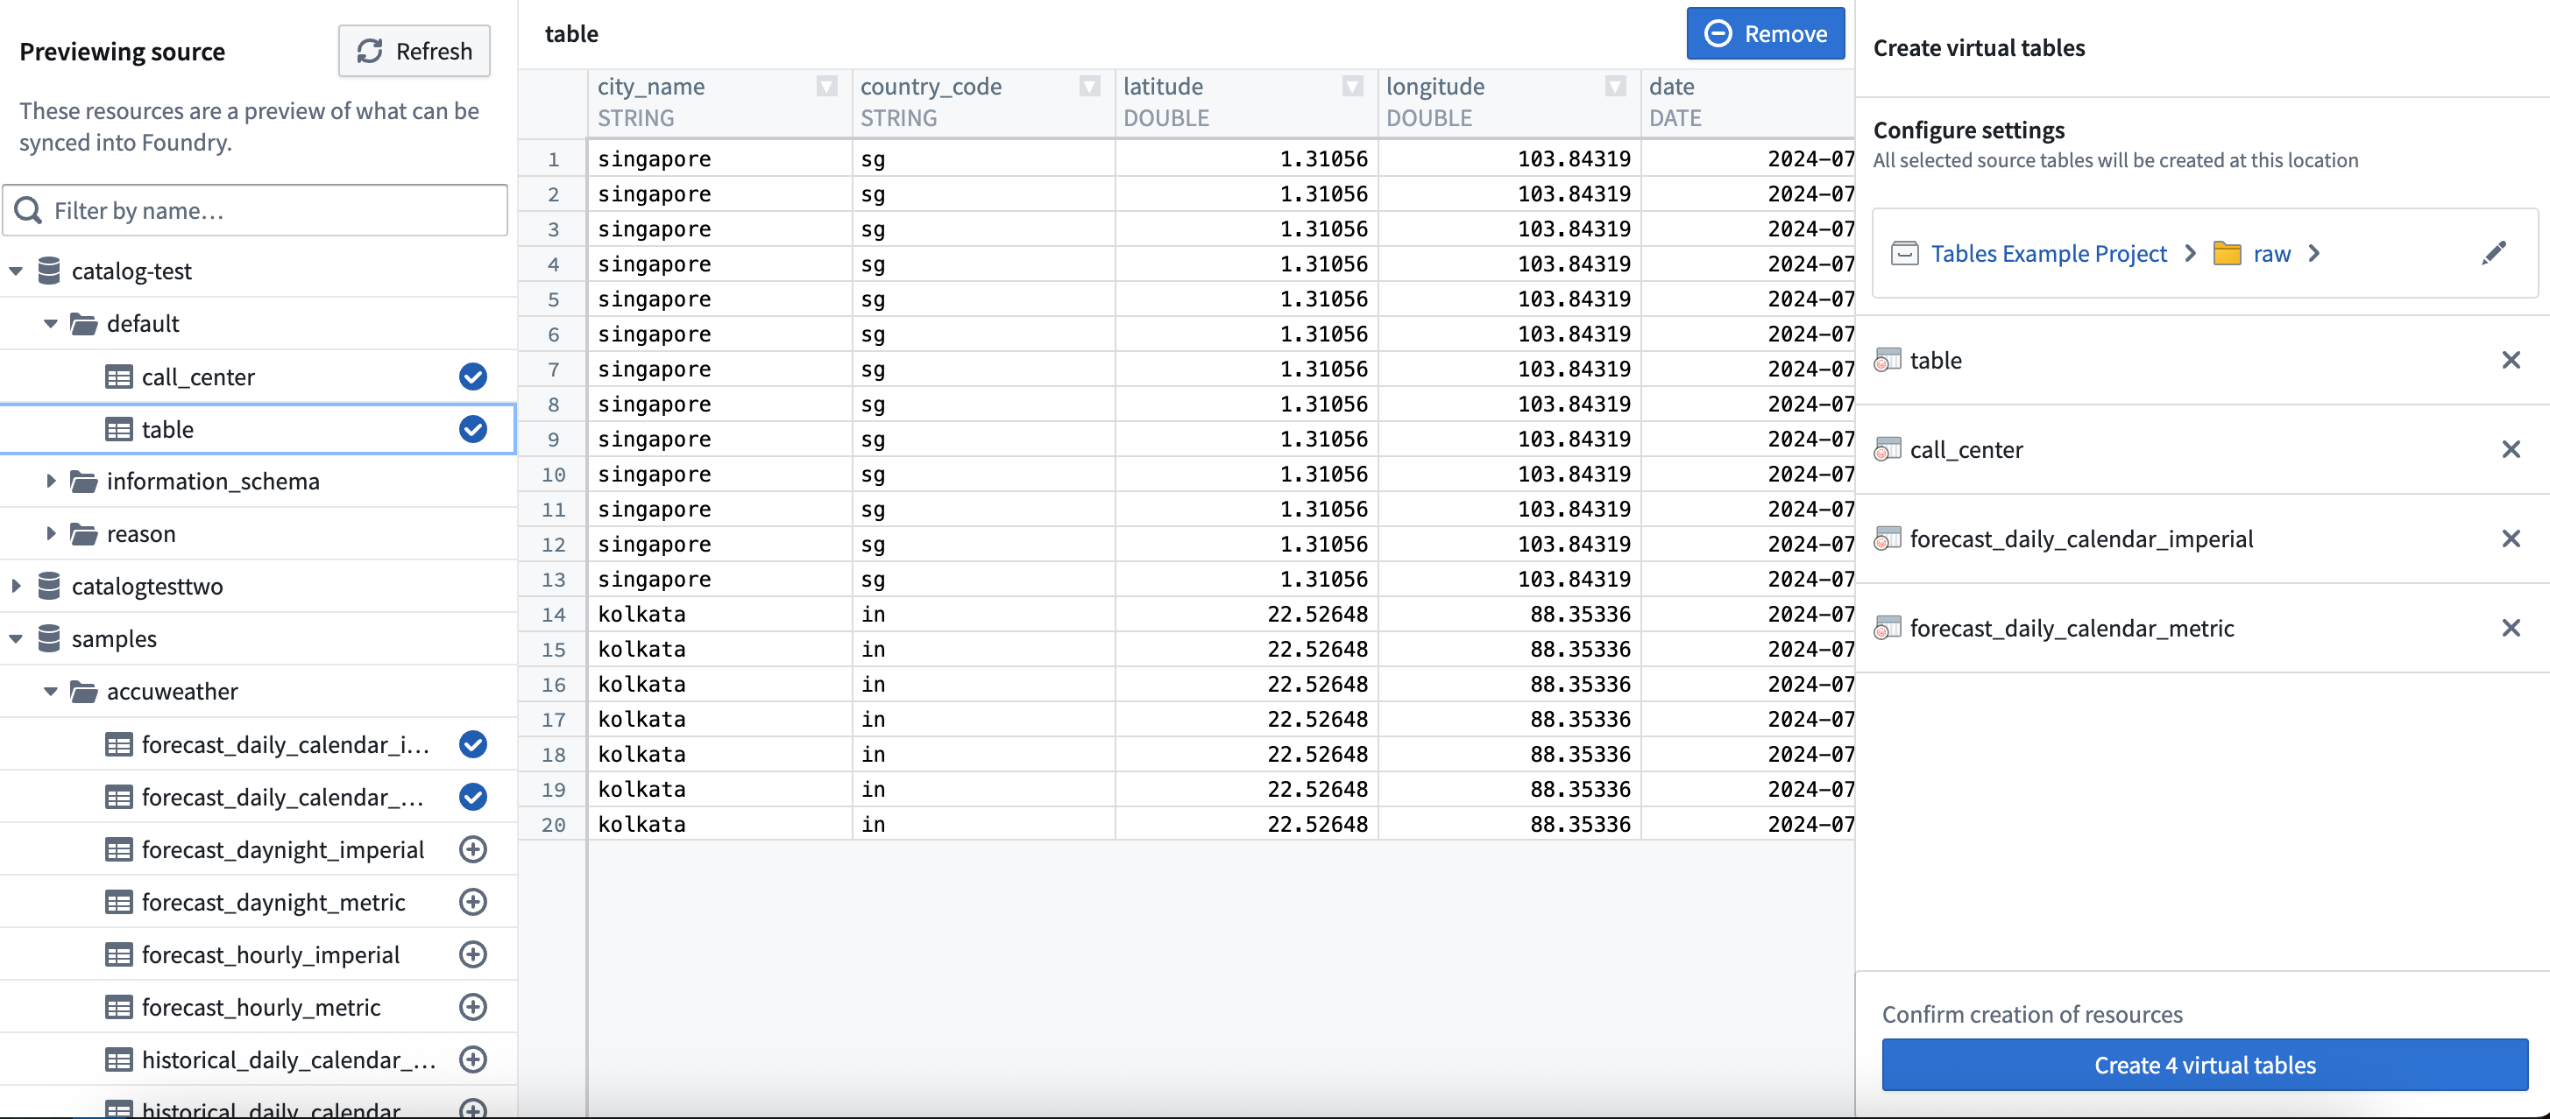
Data Connection での仮想テーブルの一括登録の例。
フィードバックを共有する
仮想テーブル出力に関するフィードバックは、Palantir サポートにお問い合わせいただくか、Developer Community ↗ で virtual-tables タグ ↗を使用してお寄せください。
新しいトランスフォーム入力タイプで Vision LLM ベースの PDF 抽出を効率化する
公開日: 2025-06-03
Vision LLM ベースの抽出ワークフロー向けのトランスフォームを簡単に作成できるように、新しいトランスフォーム入力タイプが利用可能になりました。これらのトランスフォーム入力タイプは共通のロジックを抽象化し、ユーザーが希望するカスタマイズのレベルを選択できるようにします。PDF コンテンツを Markdown に変換するトランスフォームをより効率的に記述できるようになり、ワークフローをカスタマイズしたいユーザー向けの柔軟性も維持されています。
Vision LLM ベースの抽出とは
Vision LLM は、テーブル、図、グラフなどのコンテンツが混在する複雑なドキュメントから、高い精度で情報を抽出できます。これらの Vision LLM ベースのワークフローを実装するには、PDF ドキュメントを含むメディアセットに適用するトランスフォームに、カスタムロジックを記述する必要があります。以前は、画像の変換やエンコードなど、複数の複雑なステップを実装する必要がありました。このプロセスを簡素化し、迅速に進められるトランスフォーム入力タイプが提供されるようになりました。
現在、次のトランスフォーム入力タイプが利用可能です。
VisionLLMDocumentsExtractorInput: PDF メディアセットの各メディアアイテムを個々のページに分割して処理します。これらのページは画像に変換され、Vision LLM に送信されます。このオプションは、カスタム画像処理が不要で、プロセスのすべてのステップを処理するソリューションが望ましい場合に推奨されます。VisionLLMDocumentPageExtractorInput: PDF ドキュメントの個々のページを処理します。このオプションは、抽出プロセスの柔軟性を高め、より細かく制御したい場合に推奨されます。たとえば、カスタム画像処理を適用したり、カスタムロジックで PDF のページ分割を処理したりできます。
これらの新しいトランスフォーム入力は、画像の変換、サイズ変更、エンコード、ドキュメント抽出向けに入念に調整されたデフォルトのプロンプトなど、共通のドキュメント抽出ロジックを抽象化します。簡素化されたインターフェースに加えて、カスタムプロンプトを指定するオプションがあり、VisionLLMDocumentPageExtractorInput タイプを使用して、必要に応じて画像処理をカスタマイズできます。
以下の実装サンプルは、大幅に短く簡素化された Python トランスフォームを示しています。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19from transforms.api import Output, transform from transforms.mediasets import MediaSetInput from palantir_models.transforms import VisionLLMDocumentsExtractorInput @transform( output=Output("ri.foundry.main.dataset.abc"), input=MediaSetInput("ri.mio.main.media-set.abc"), extractor=VisionLLMDocumentsExtractorInput( "ri.language-model-service.language-model.anthropic-claude-3-7-sonnet") ) def compute(ctx, input, output, extractor): extracted_data = extractor.create_extraction(input, with_ocr=False) output.write_dataframe( extracted_data, column_typeclasses={ "mediaReference": [{"kind": "reference", "name": "media_reference"}] }, )
新しい VisionLLMDocumentsExtractorInput を使用した Python トランスフォームの実装。
Vision LLM ベースのドキュメント抽出とパースは、Foundry で最も広く利用されているワークフローの1つになっており、これらのワークフロー向けのトランスフォームをこれまで以上に効率的に作成できるようになりました。詳しくは、Vision LLM ベースの抽出のドキュメントを参照してください。
皆様のフィードバックが重要です
トランスフォームの使用体験について、ぜひお聞かせください。フィードバックを歓迎します。Palantir サポートのチャネル、または Developer Community ↗ で、transforms-python ↗ タグと language-model-service ↗ タグを使用して、ご意見をお寄せください。
Developer Console でプラットフォーム SDK のアクセスを管理する
公開日: 2025-06-03
Developer Console でプラットフォームSDKリソースページが利用可能になり、開発者がアプリケーションの Foundry リソースへのアクセスを管理できるようになりました。開発者は、アプリケーションのプロジェクトへのアクセスを設定し、クライアントに許可する操作を定義し、指定した API 名前空間へのアクセスを制御できるようになりました。プラットフォームSDKリソースページには、統合を組織のポリシーに準拠させるための包括的なセキュリティおよびコンプライアンス設定が用意されており、Foundry リソースとの安全でシームレスなインタラクションも促進します。
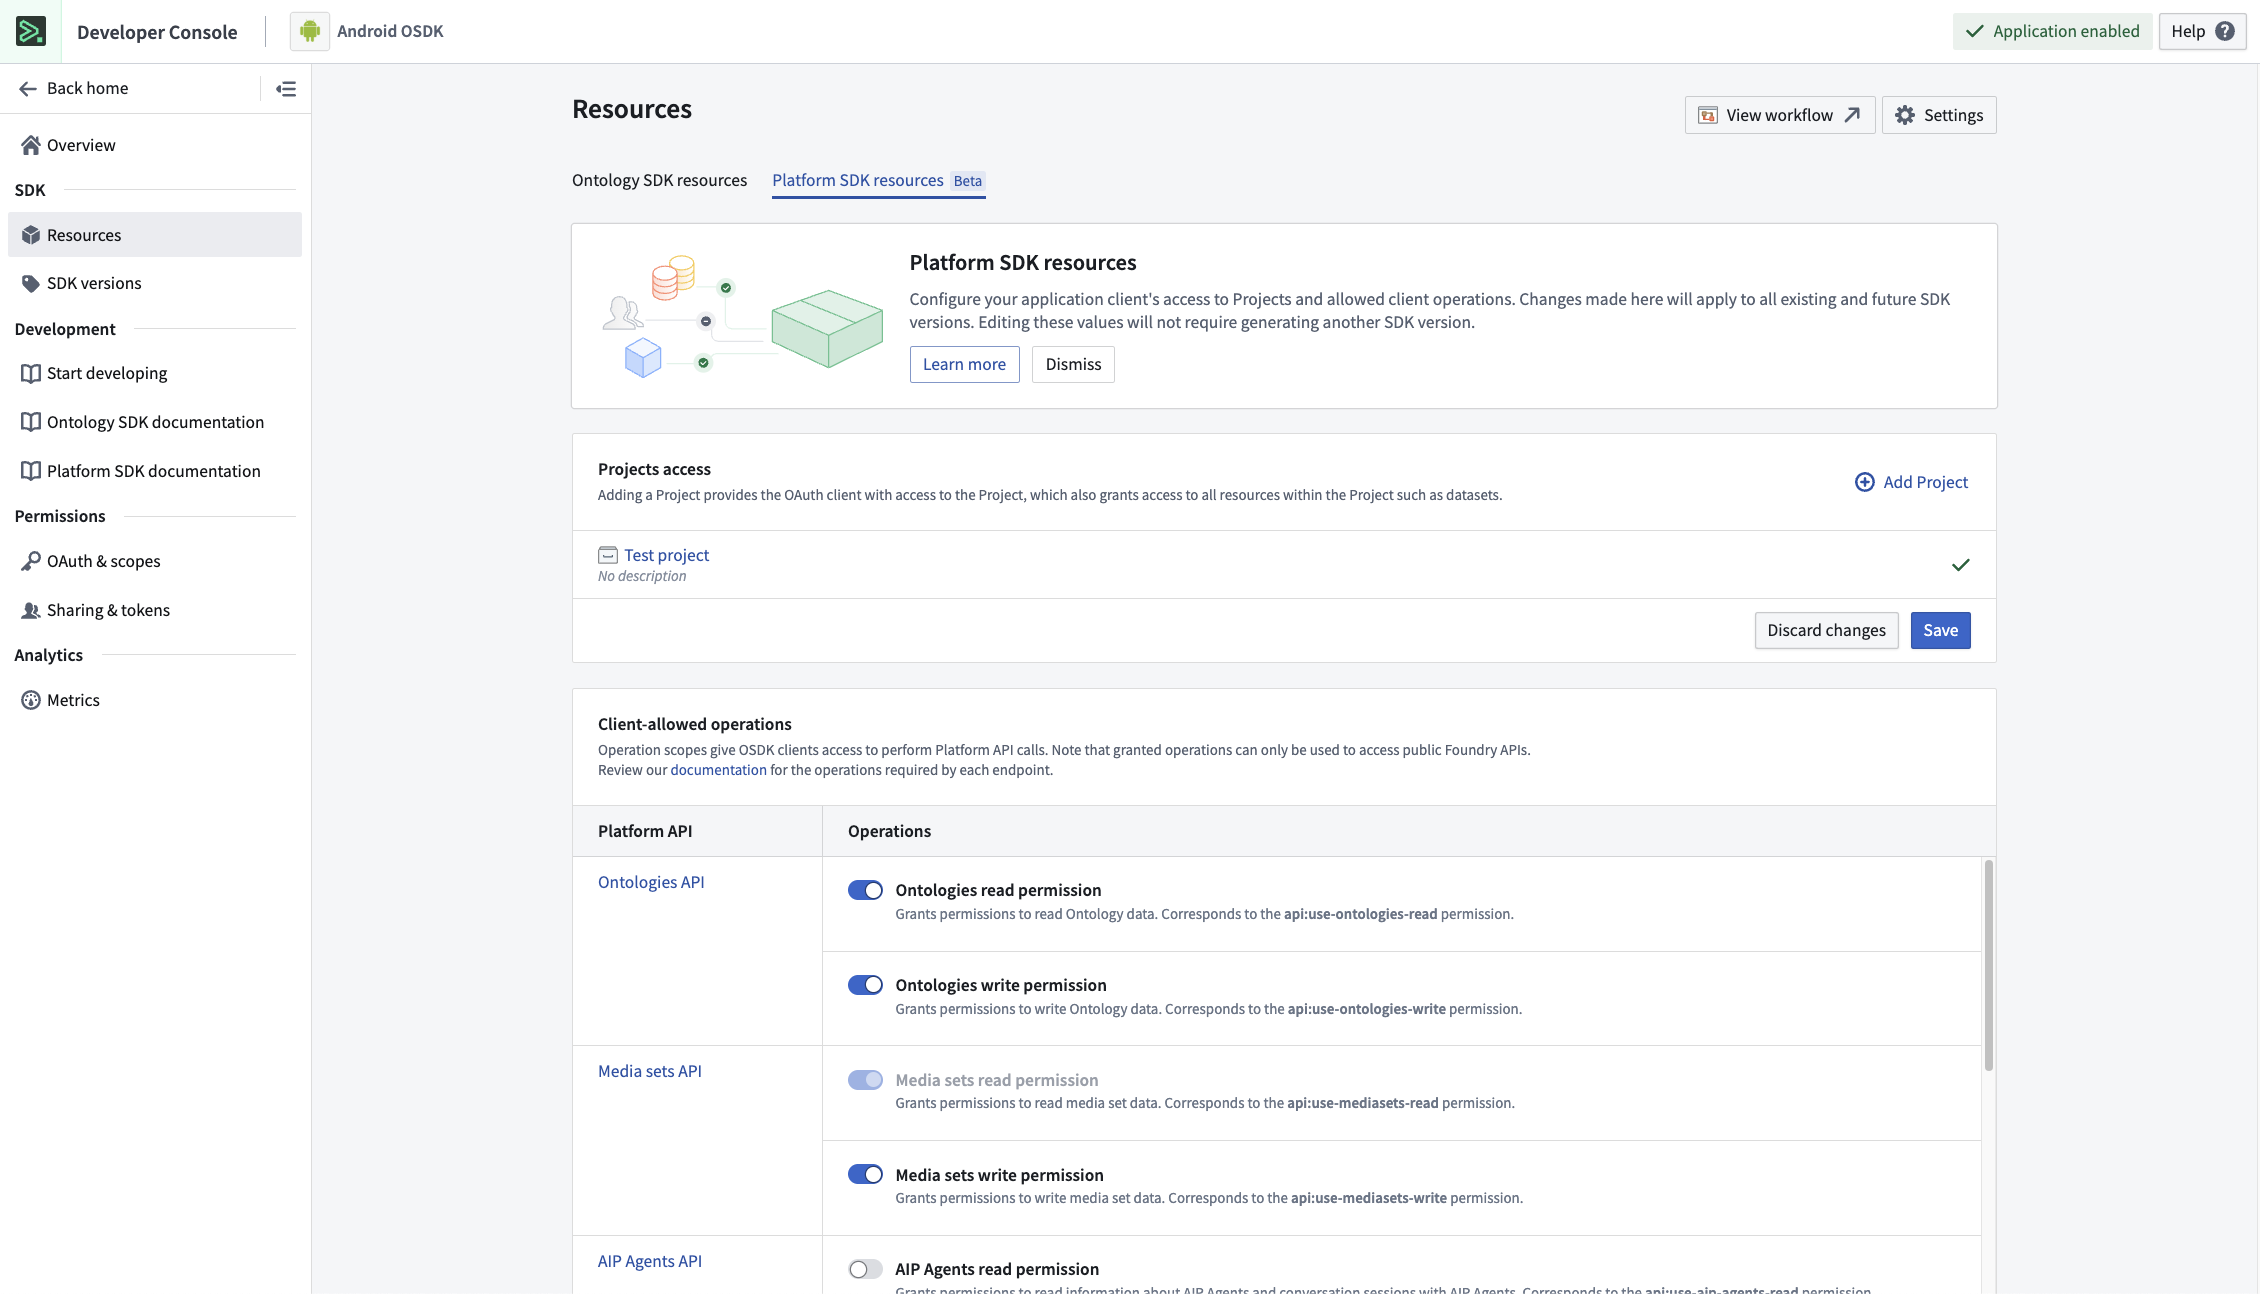
プロジェクトへのアクセスとクライアントが許可された操作のセクションを表示する、新しいプラットフォームSDKリソースページ。
上の例では、プロジェクトへのアクセスセクションで、アプリケーションがインタラクションできるプロジェクトを開発者が選択できます。一方、クライアントが許可された操作セクションでは、選択したプロジェクトとのインタラクションに使用できるメソッドを選択できます。
クライアントに許可された操作に対する API レベルのセキュリティ
2025年春以降、新しい Developer Console アプリケーションでは、制限を設定したアプリケーションに対して API レベルのセキュリティが適用されます。これにより、これらのアプリケーションが呼び出すすべてのエンドポイントを、プラットフォームSDKリソースページでクライアントに許可された操作に明示的に追加する必要があります。
この新しいレベルのセキュリティでは、API 名前空間に対してのみアクセスが許可されるため、アプリケーション管理者は、組織内でアプリケーションが実行するアクションを制御できます。これらの変更以前は、API 名前空間のスコープを付与すると、その名前空間のエンドポイントに加えて、ほかの名前空間にある_依存先のエンドポイント_へのアクセスも許可されていました。新しい、より安全な API スコープは分離されており、クライアントが許可された操作セクションに表示されるエンドポイントにのみアクセスを許可します。
この新しいレベルのセキュリティは、すべての新しい Developer Console アプリケーションに適用されます。これらの新しいセキュリティ機能を利用するには、ステップごとのガイドに沿ってアプリケーションを移行してください。
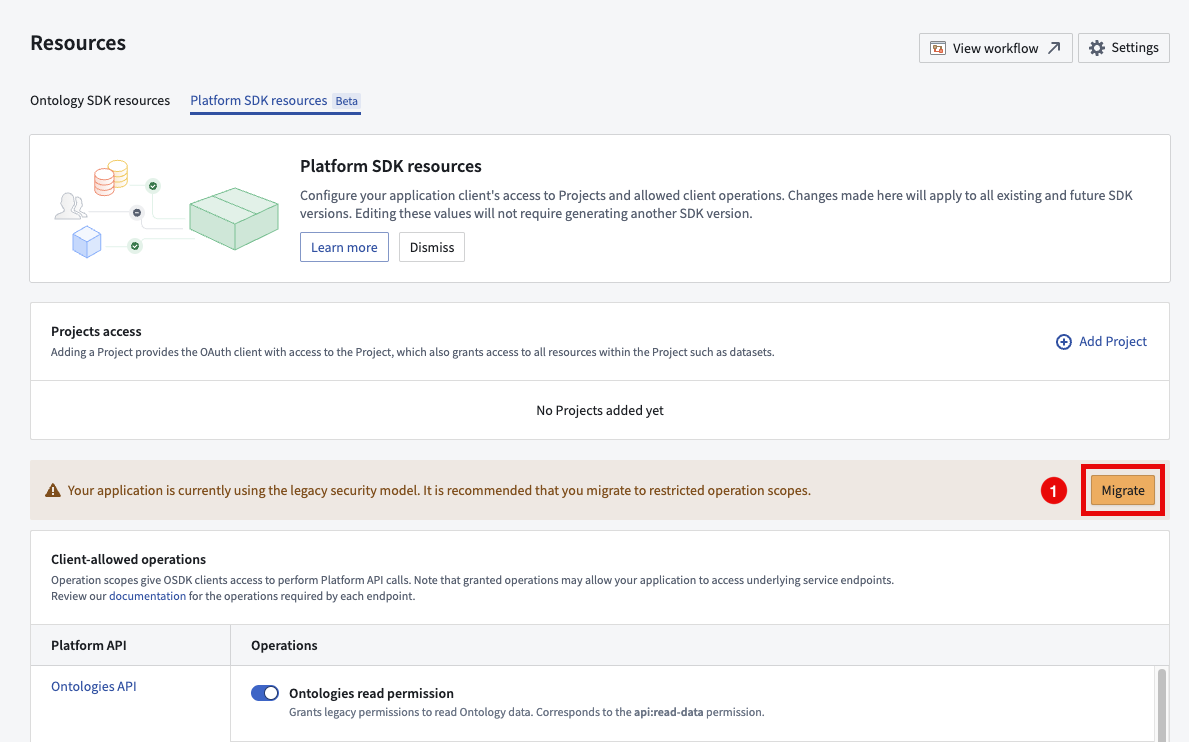
レガシーの Developer Console アプリケーション向けの移行コールアウト。
はじめに
プラットフォームSDKリソースページの使用をはじめるには、Developer Console アプリケーションの SDK セクションに移動し、リソース > プラットフォームSDKリソースを選択します。
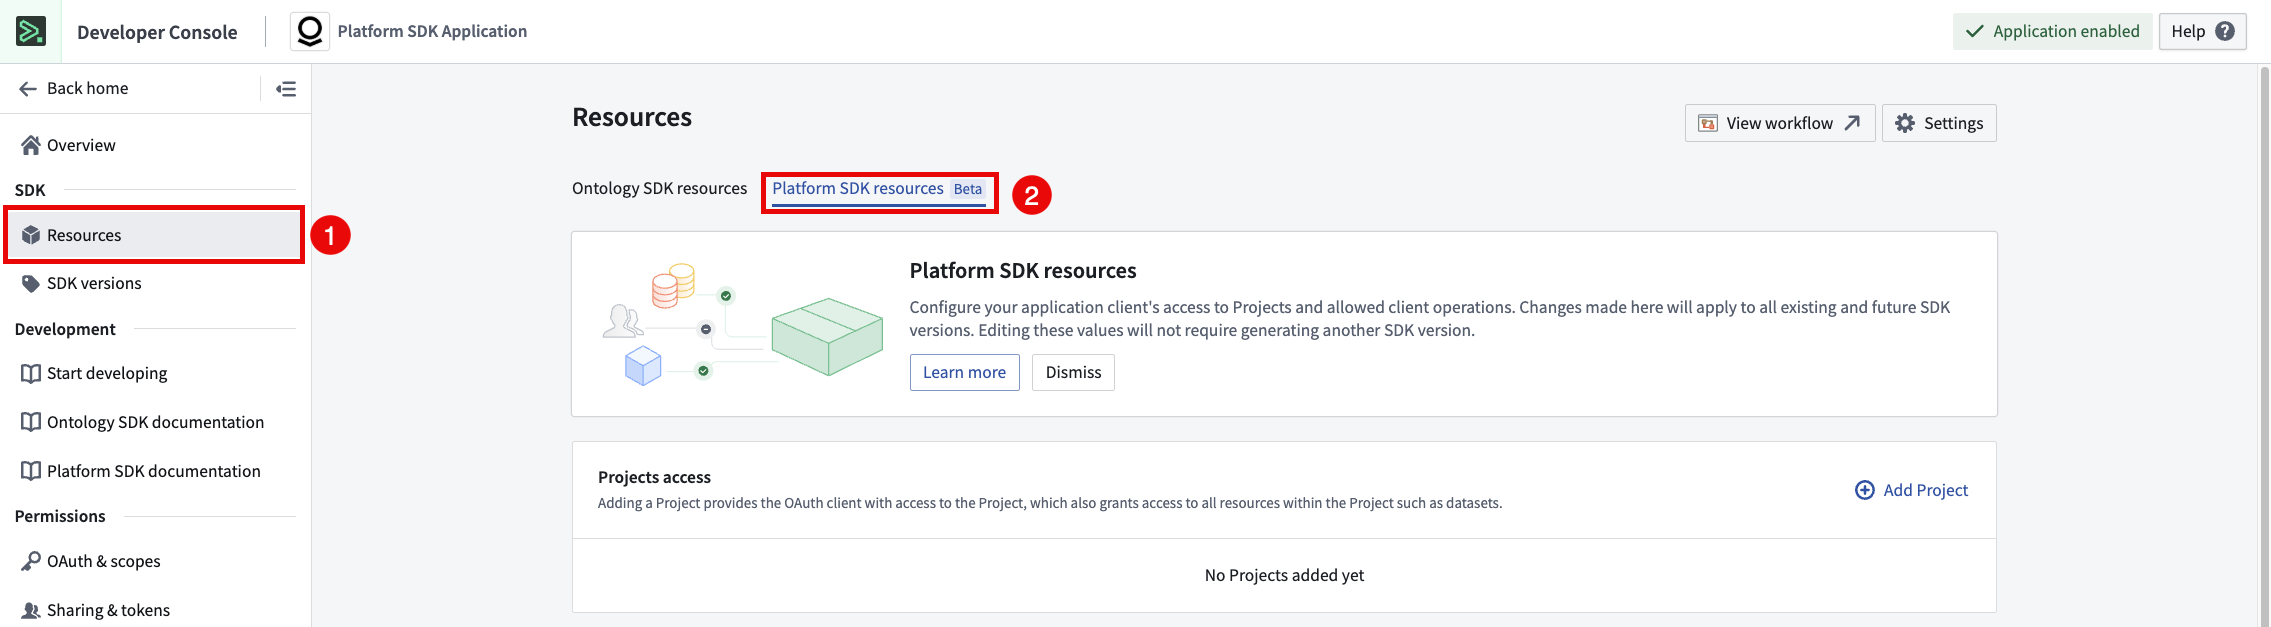
Developer Console でプラットフォームSDKリソースページに移動する。
プラットフォームSDKリソースページでは、アプリケーションクライアントがアクセスできるリソースと操作を管理できます。クライアントにリソースを追加するには、プロジェクトを追加を選択し、クライアントのアクセス対象に追加するプロジェクトを選択します。保存すると、アプリケーションはそのプロジェクト内のリソースにアクセスできるようになります。
クライアントが実行できる操作を変更するには、クライアントが許可された操作セクションに移動し、トグルを使用してアプリケーションがアクセスできる操作を定義します。このセクションで変更を行うと、新しい SDK を生成することなく、既存のすべての SDK バージョンに変更が適用されます。
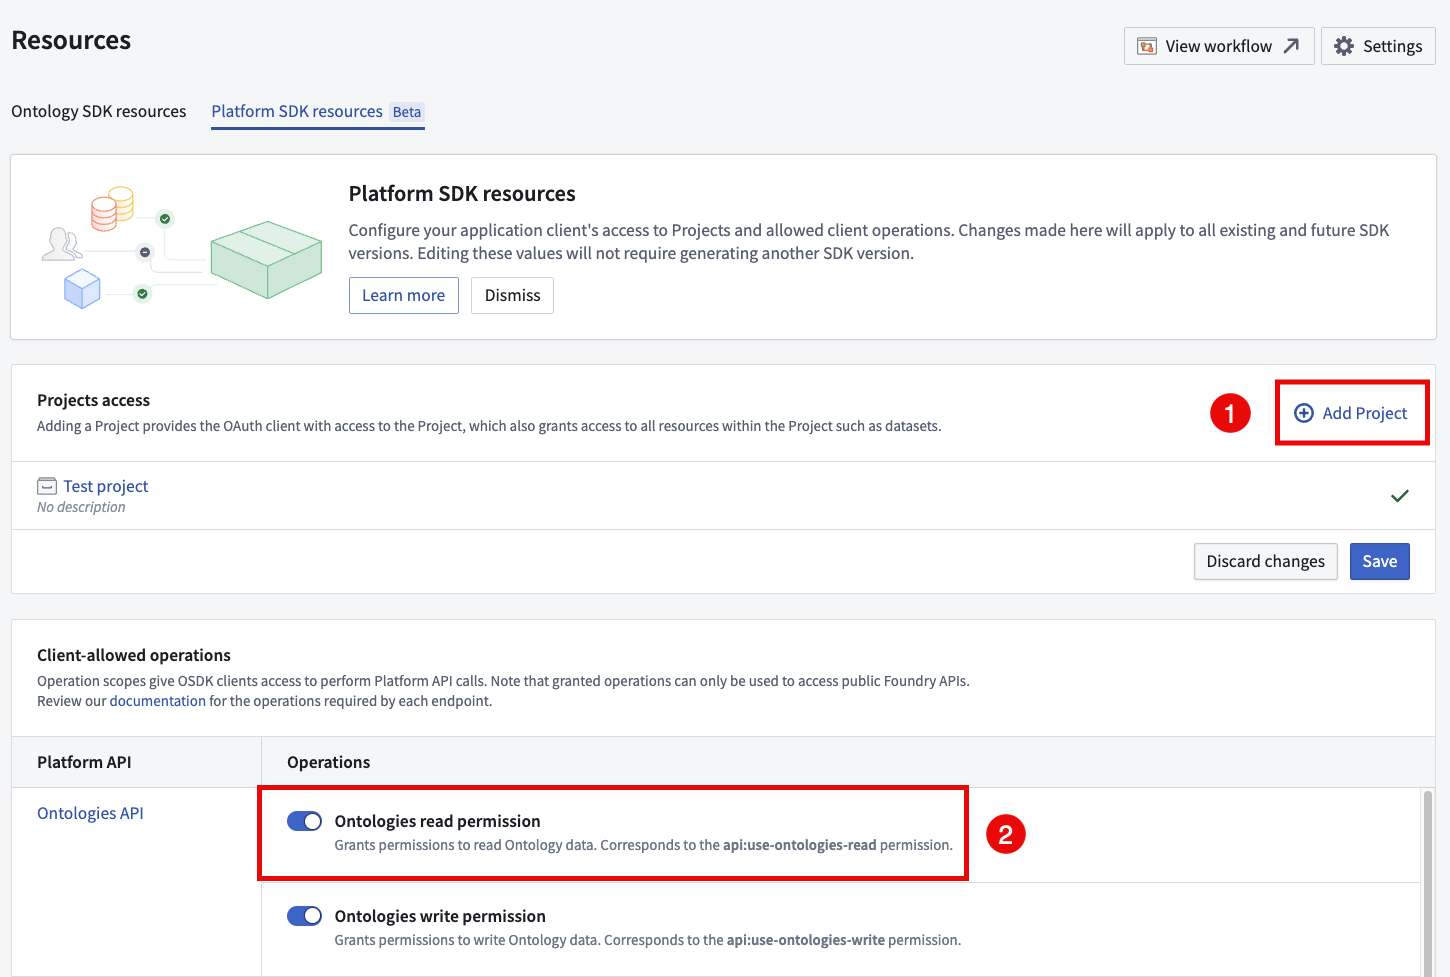
プラットフォームSDKリソースページを使用して、アプリケーションクライアントが利用可能なリソースと操作を変更する。
今後の予定は?
現在、TypeScript、Python、Java のプラットフォーム SDK のドキュメントを作成するとともに、開発者体験を向上させるため、アプリケーションクライアントの作成フローを改善しています。
サポートが必要ですか?
Developer Community ↗ では、皆様との交流をいつでも歓迎しています。オントロジー SDK と Developer Console に関するご意見やご質問は、Palantir サポートのチャネル、または Developer Community で ontology-sdk ↗ タグを使用してお寄せください。
詳細については、操作制限および API セキュリティと移行のドキュメントを参照してください。