注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
お知らせ
リマインダー: Foundry ニュースレターに登録すると、プラットフォーム全体の新しい製品、機能、改善点の概要を受信トレイで直接受け取れるようになりました。登録方法については、Foundry ニュースレターと製品フィードバックチャネルのお知らせを参照してください。
Build with AIP[ベータ版]のご紹介、5月上旬に提供開始予定
公開日: 2024-04-30
Build with AIP が5月上旬にベータ版として利用可能になることをお知らせします。Build with AIP アプリケーションでは、構築済みの製品群を提供します。これらは、参考例、チュートリアル、またはニーズに合わせて調整できる開発者向けスターターパックとして使用できます。
アプリケーションでキーワード、ユースケース、機能を検索するだけで、ワークフローの構築を加速できる製品を見つけられます。製品で扱うワークフローには、次のようなものがあります。
- エンドツーエンドのセマンティック検索の実装
- Pipeline Builder のカスタムボード用ユーザー定義関数(UDF)の開発
- Workshop でユーザーがデータを入力するためのガイド付きフォームの作成
- PySpark 変換のパフォーマンスを最適化するコードサンプル
- LLM を使用した非構造化データの構造化カテゴリーへの分類
- イベント発生時のユーザーへの通知など、業務プロセスを自動化するルール
このほかにも多くのワークフローがあります。新しい AIP 製品の開発も積極的に進めており、準備が整い次第リリースします。
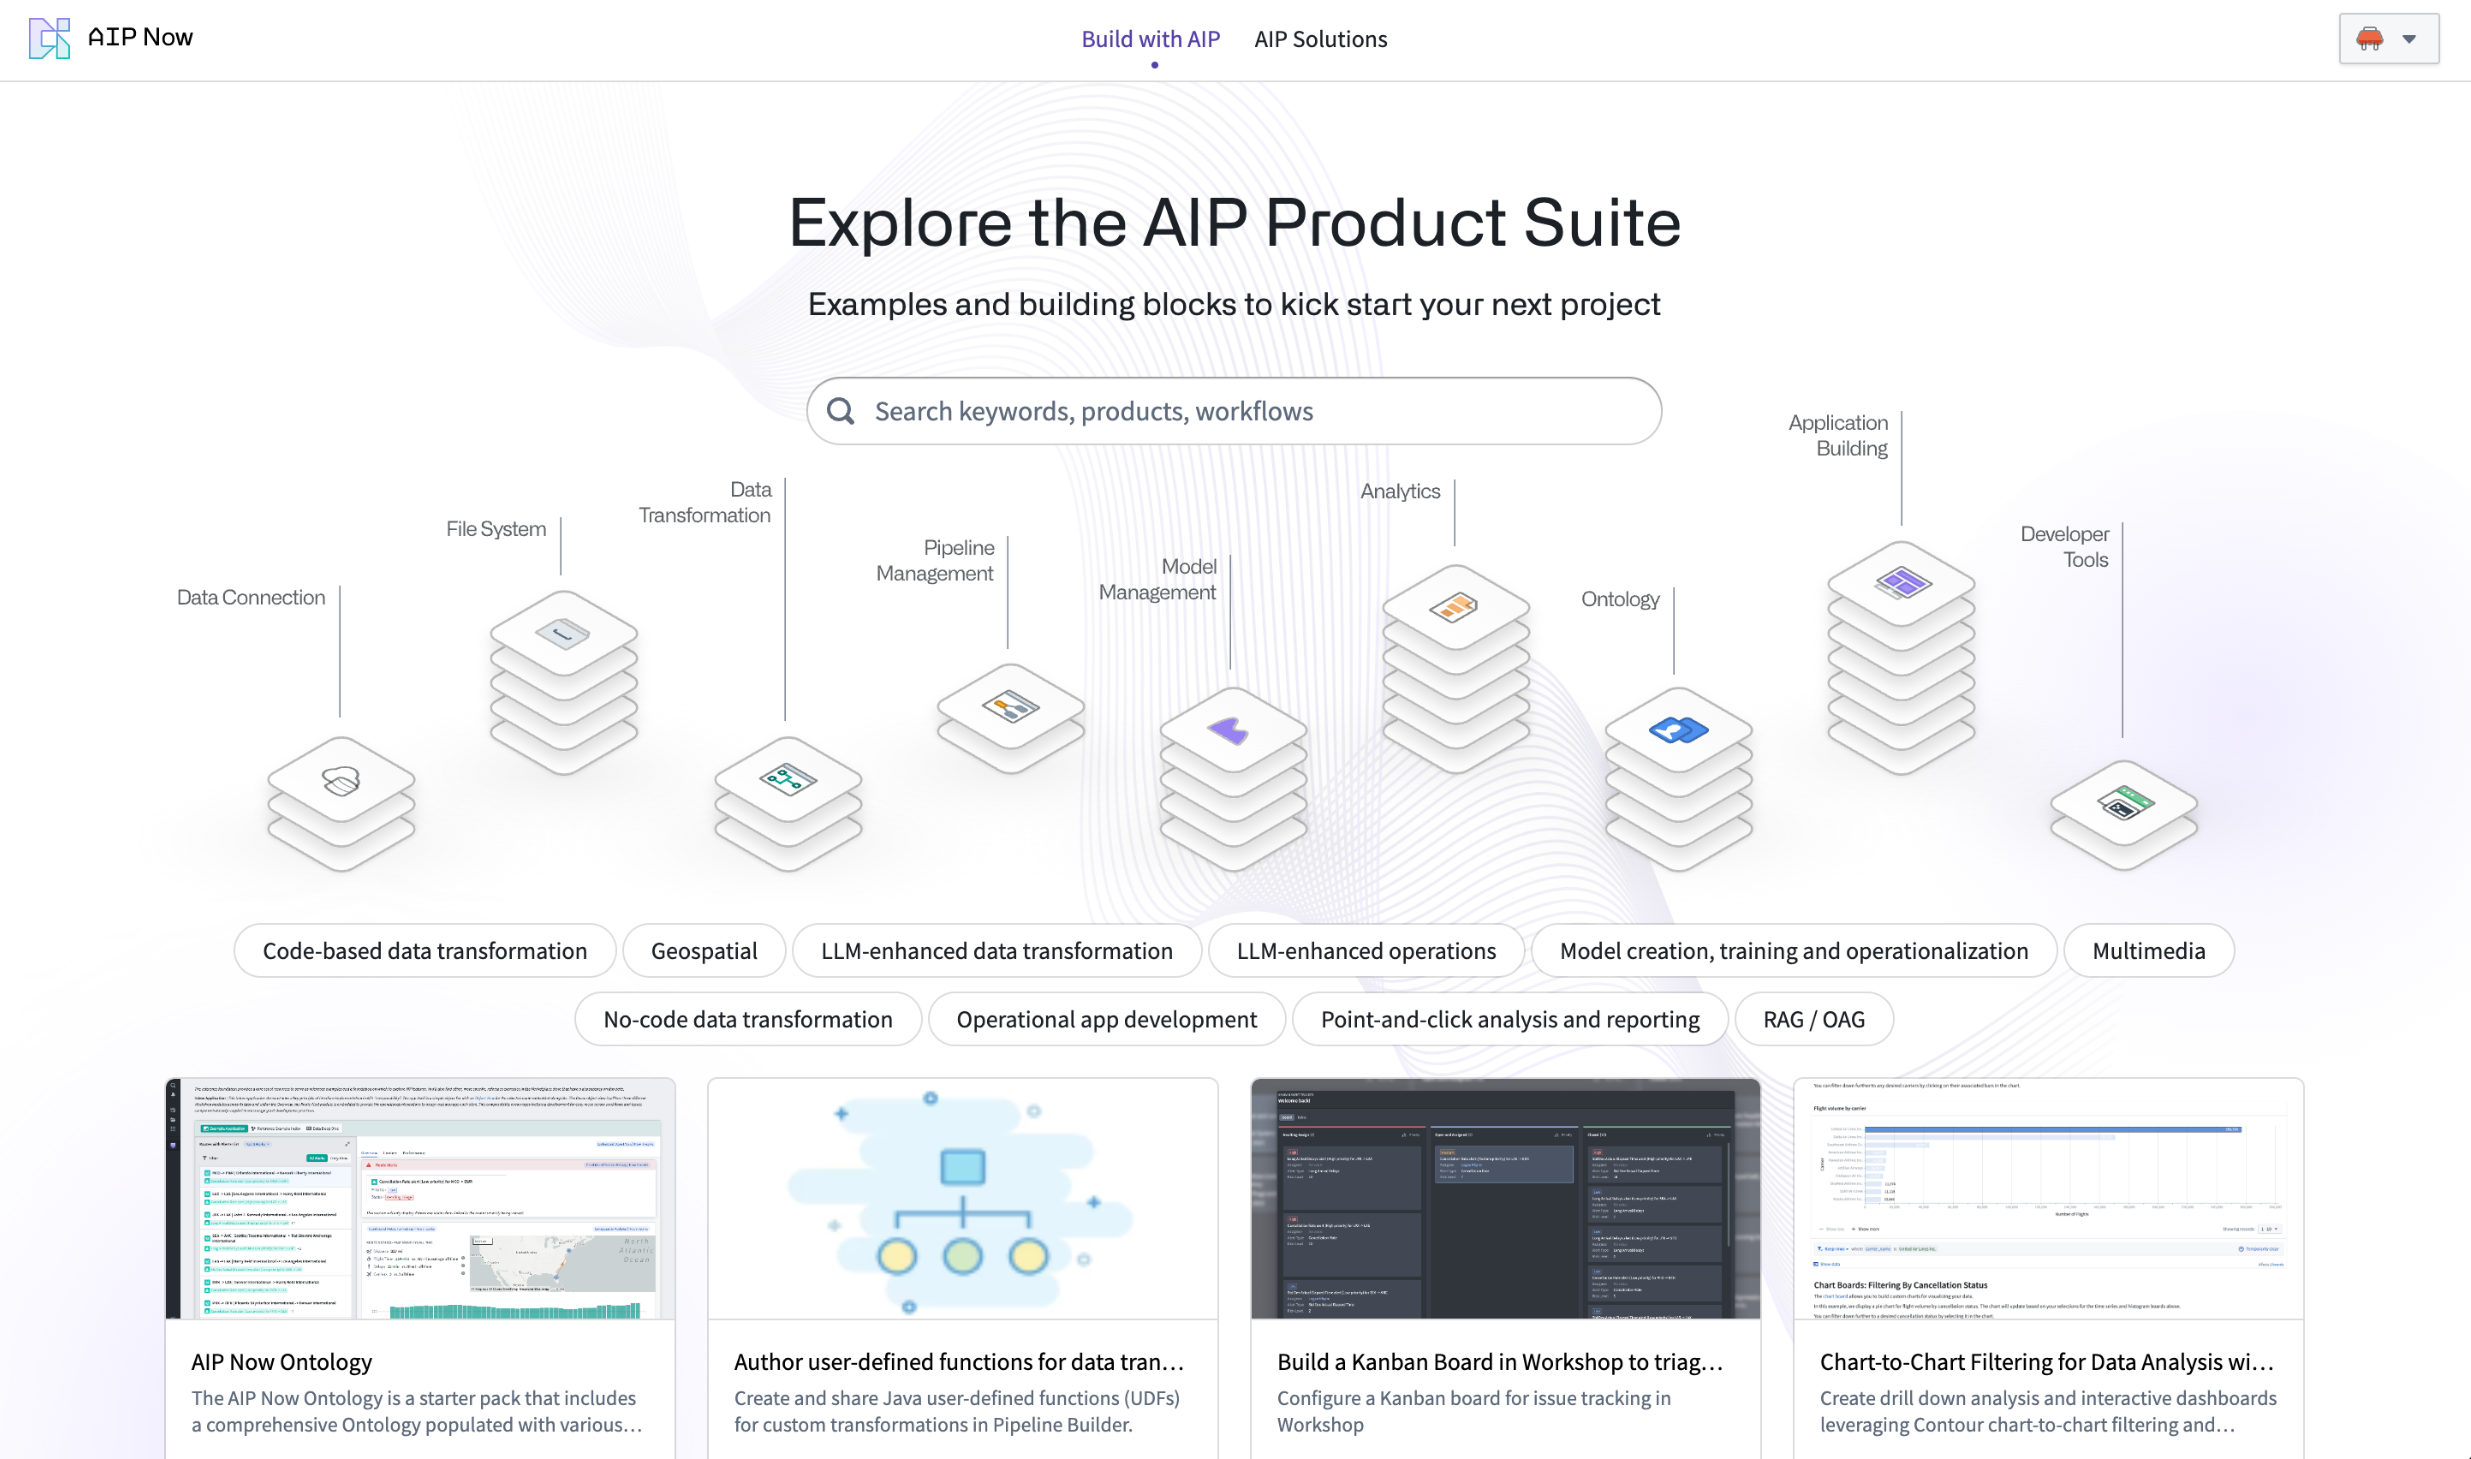
Build with AIP アプリケーションを探索する。
製品の詳細を確認するには、製品を選択します。製品の価値、実装設計、含まれる個々のリソースの内訳について詳しい説明が表示されます。ユーザーは任意の製品を希望する保存先のプロジェクトにインストールし、インストールの進行状況を監視できます。以前インストールした製品には、Build with AIP 内からいつでもアクセスできます。
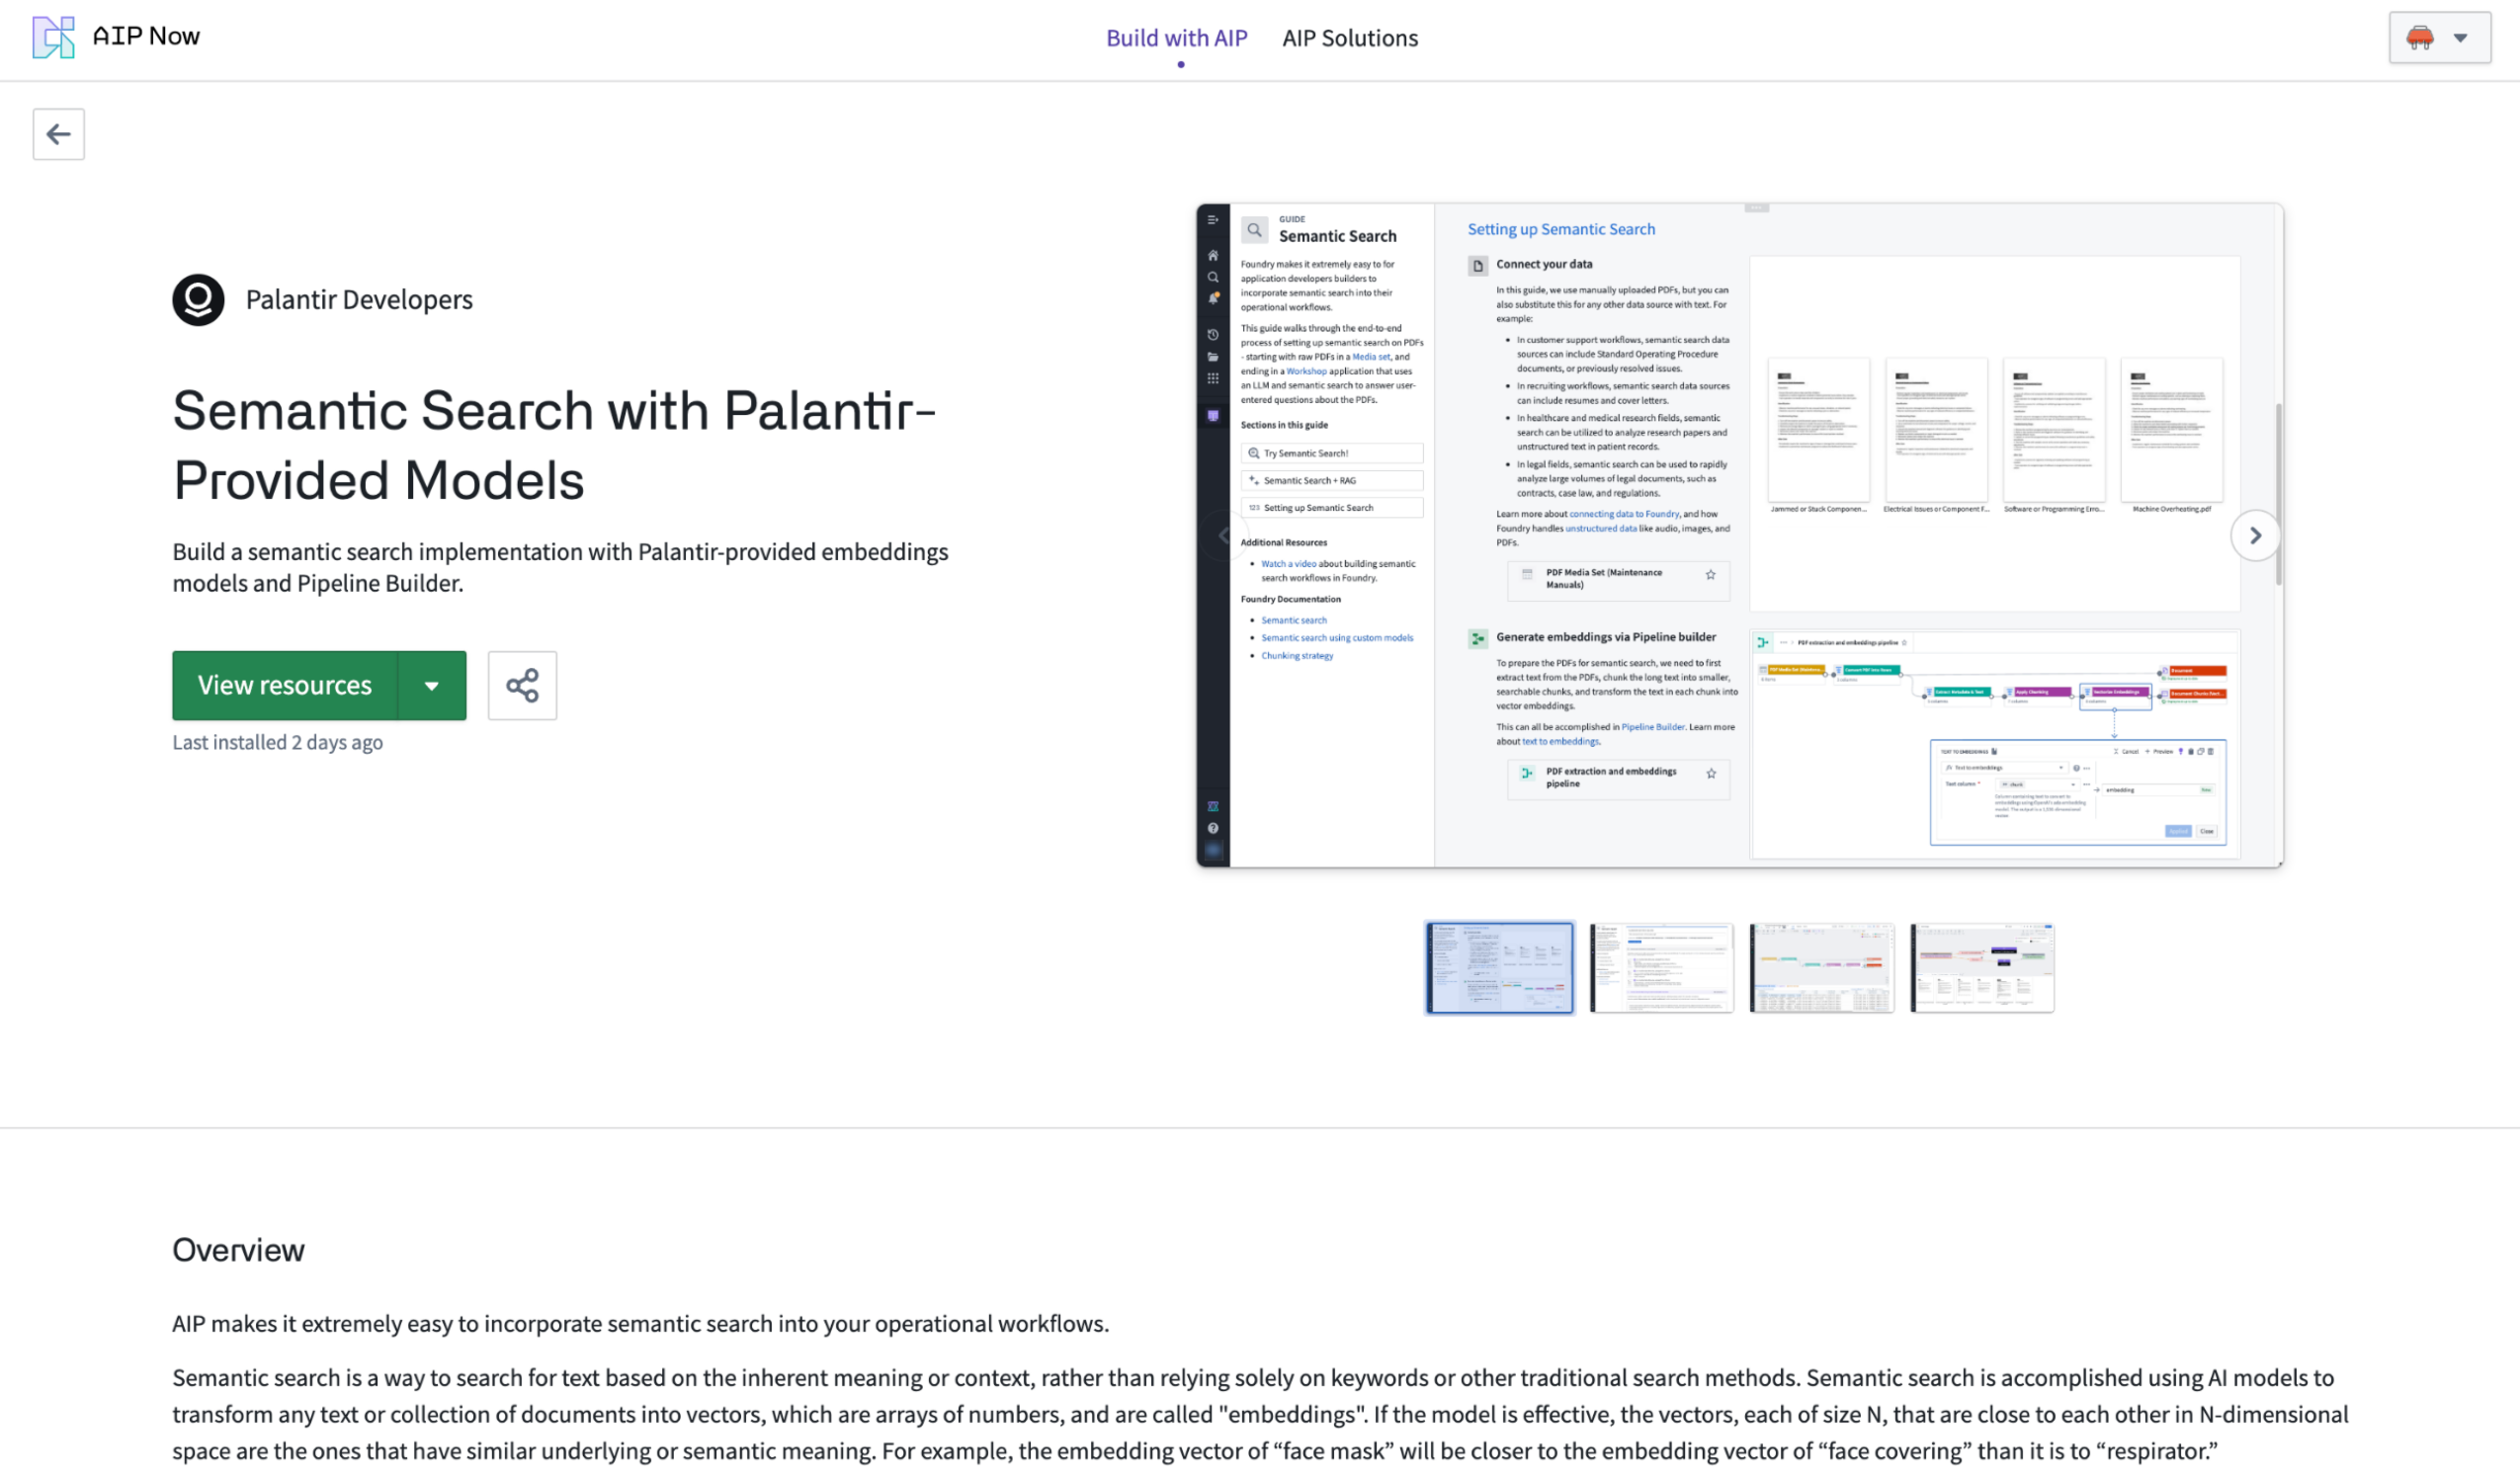
AIP 製品ショーケースの内部。
推奨される実装パターンやリクエストされた実装パターンに基づいて、製品を継続的に追加していきます。
Build with AIP アプリケーションはリリースを加速しており、まもなく既存のすべての顧客が利用できるようになります。この機能へのアクセスを制限する場合、プラットフォーム管理者は Control Panel のアプリケーションへのアクセス設定で制限できます。
すべての製品は Foundry Marketplace を元にしています。詳細については、ドキュメントを参照してください。
HyperAuto V2 が利用可能に[一般提供]
公開日: 2024-04-30
HyperAuto は、ERP および CRM システムを統合するための Palantir Foundry の自動化スイートです。ポイントアンドクリックのワークフローにより、ソースの生データから価値があり利用可能な出力(データセットまたはオントロジー)を動的に生成します。この機能は、今週からすべてのエンロールメントで利用可能になりました。
この新しいメジャーバージョンでは、ユーザーエクスペリエンスが大幅に更新されるとともに、SAP 関連の自動取り込みおよびデータ変換ワークフローのパフォーマンスと安定性が向上しています。
最初の HyperAuto パイプラインを作成するには、はじめにを参照してください。
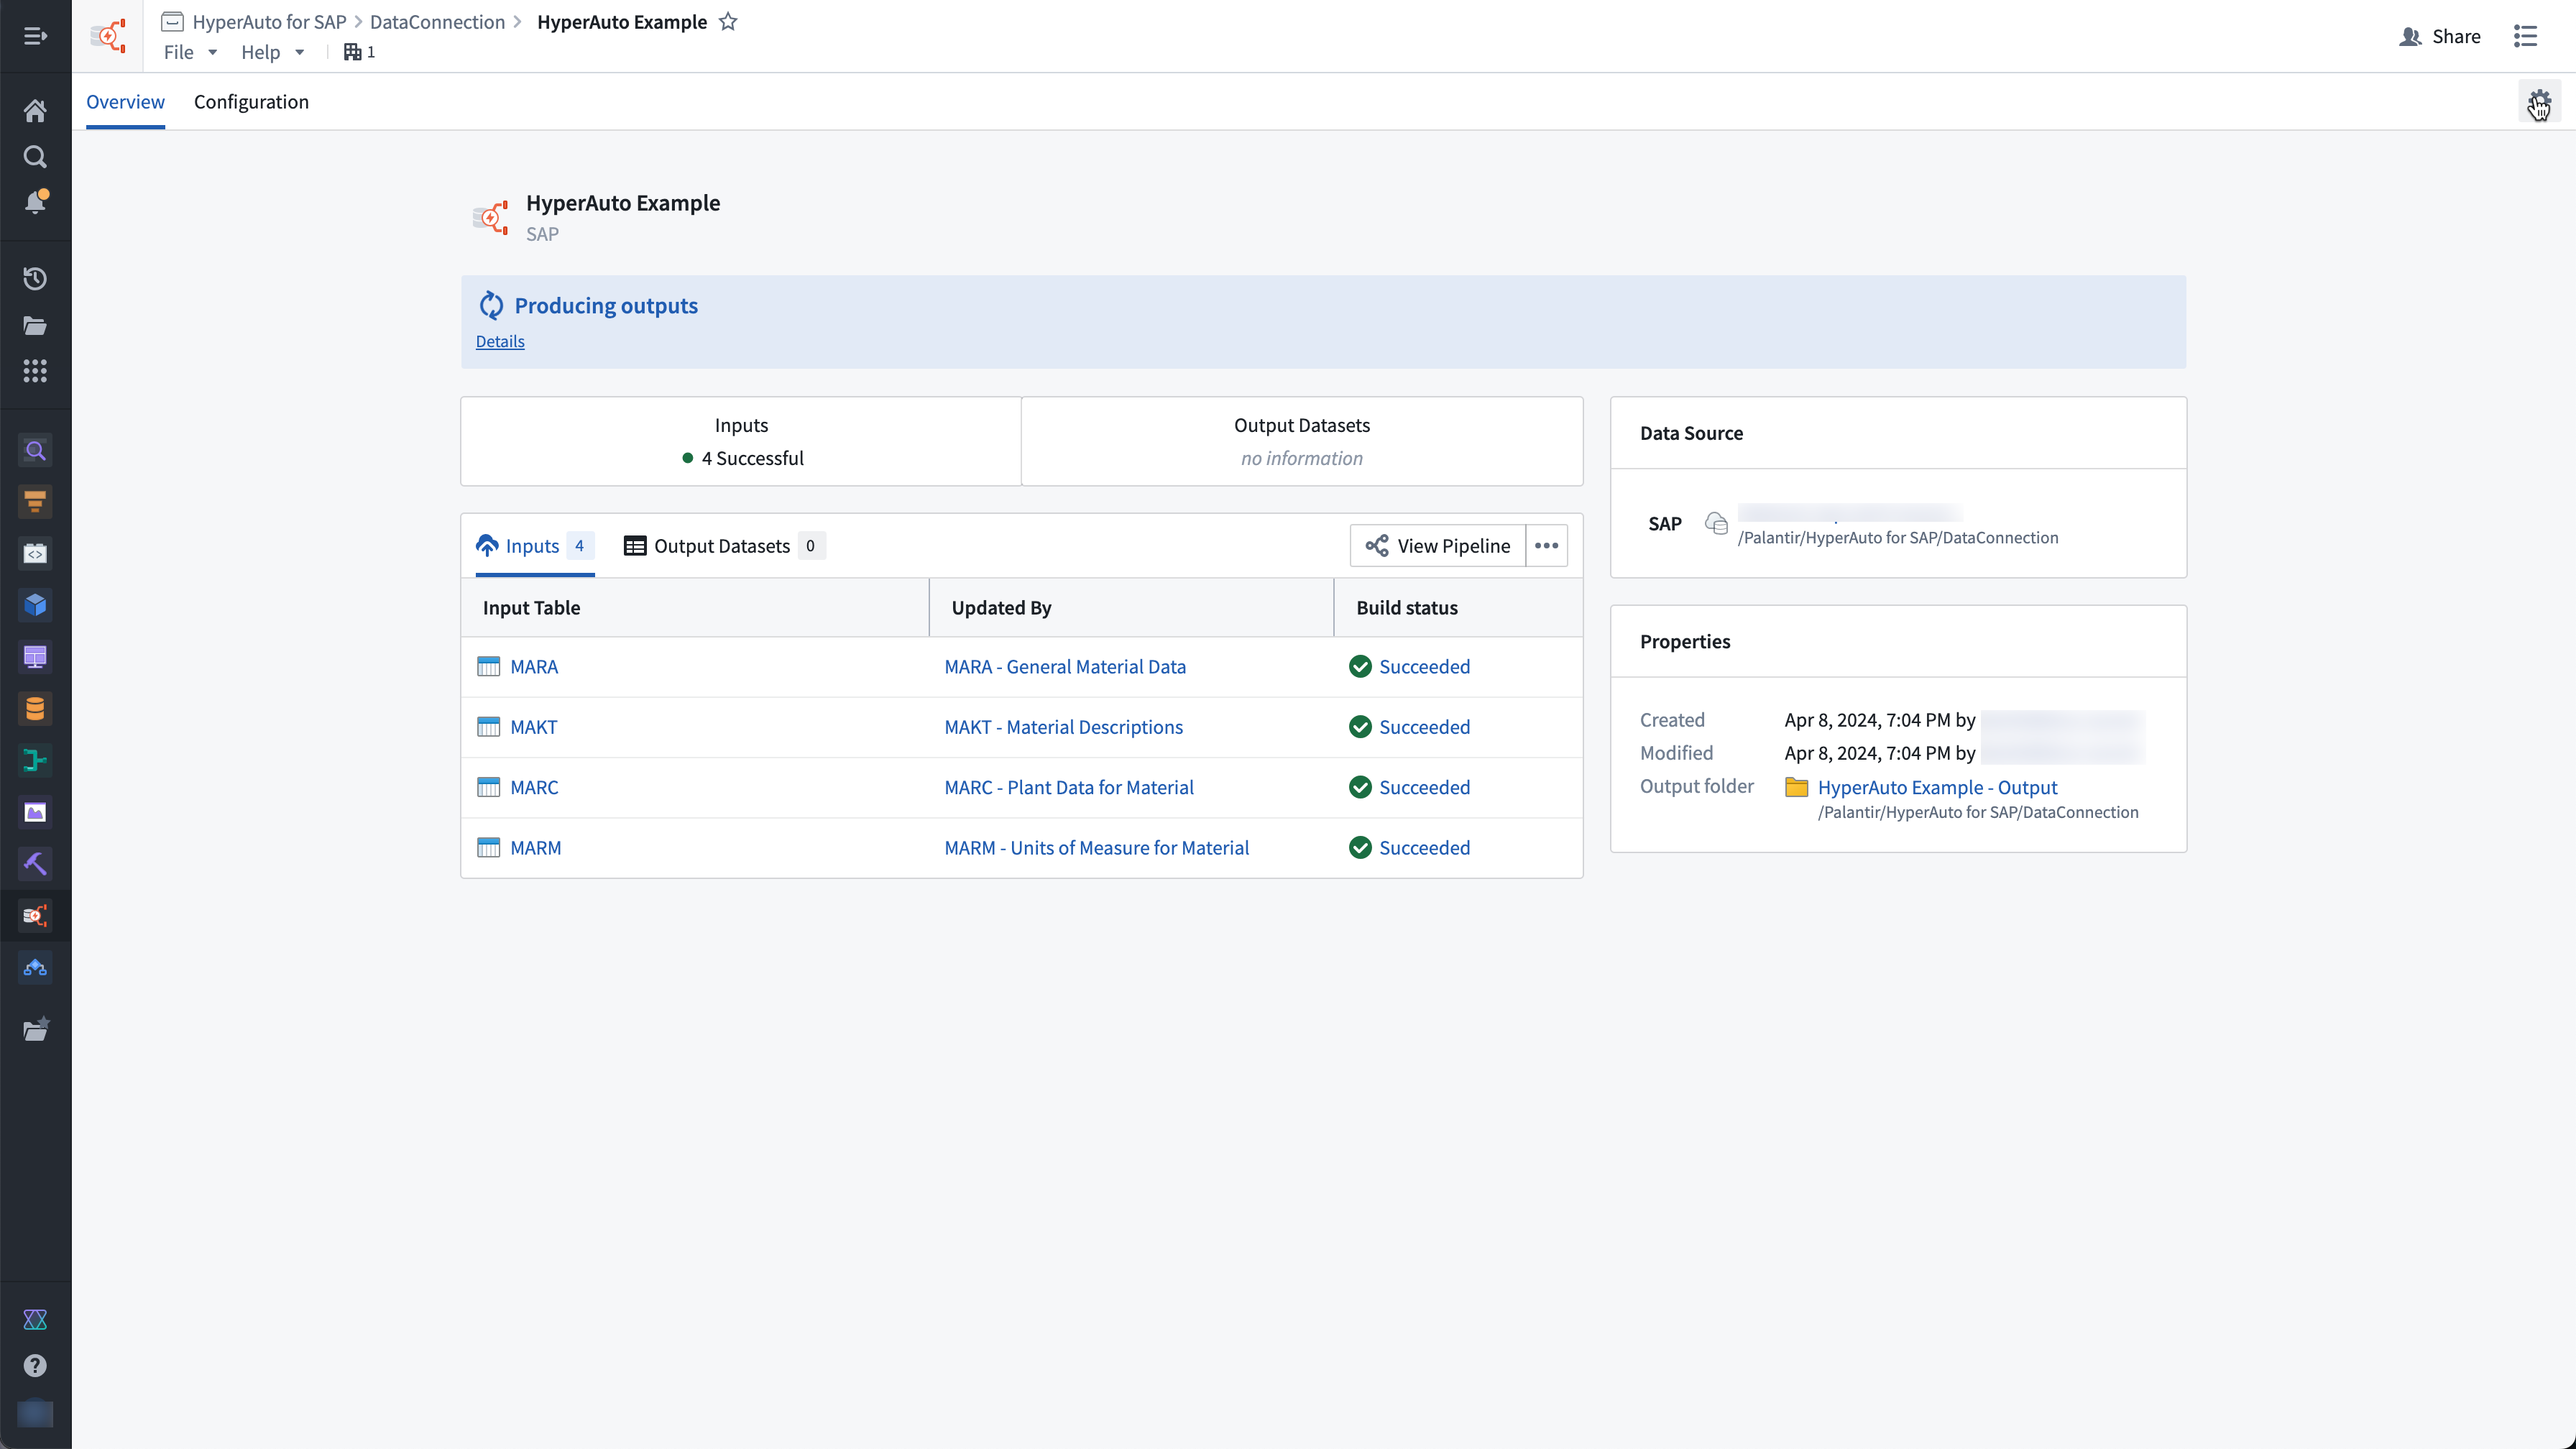
稼働中の HyperAuto パイプラインの概要。
SAP データの動的な統合と管理
以前のベータ版のお知らせに続き、次の機能が一般提供されるようになりました。
- 簡単な設定: HyperAuto は、使いやすいポイントアンドクリックのウィザード、迅速なセットアップに適したデフォルト値、上級ユーザー向けのカスタマイズ可能な設定を提供し、データの名前変更、クリーニング、非正規化、重複排除などのタスクを自動化します。
- Pipeline Builder との統合: HyperAuto は Pipeline Builder パイプラインを動的に生成し、透明性の高い UI を提供します。また、パイプラインの設定変更を更新およびデプロイするための変更管理ワークフローを備えています。
- リアルタイムの SAP データ処理: HyperAuto は SAP ソースからのリアルタイムデータストリーミングをサポートし(SLT Replication Server が必要)、ソースからオントロジーへ数秒でデータを送信できます。
- SAP データの静的スナップショットのサポート: この新しいリリースでは、SAP ソースへのライブ接続ができない場合に、アップロードしたデータセットを使用して作業できるようになりました。
HyperAuto V2 の詳細については、ドキュメントを参照してください。
Developer Console の静的アプリケーション向け Web サイトホスティングが一般提供に
公開日: 2024-04-30
Developer Console で静的 Web サイトをホストできるようになりました。この追加機能により、開発者は外部の Web ホスティングインフラストラクチャを必要とせずに、Foundry を使用して Web サイトをホストし、配信できます。静的 Web サイトは固定のファイル群(HTML、CSS、JavaScript)で構成され、ユーザーのブラウザーにダウンロードされてクライアント側で表示されます。React など、多くの Web アプリケーション開発フレームワークを使用して静的 Web サイトを作成できます。
静的 Web サイトのサポートは、Palantir が管理するドメイン上のエンロールメントで利用可能です(例:enrollment.palantirfoundry.com または地域に対応する同等のドメイン)。顧客が管理するドメイン上のエンロールメントに対する機能サポートは、現在積極的に開発を進めています。
Foundry でサイトをホストする
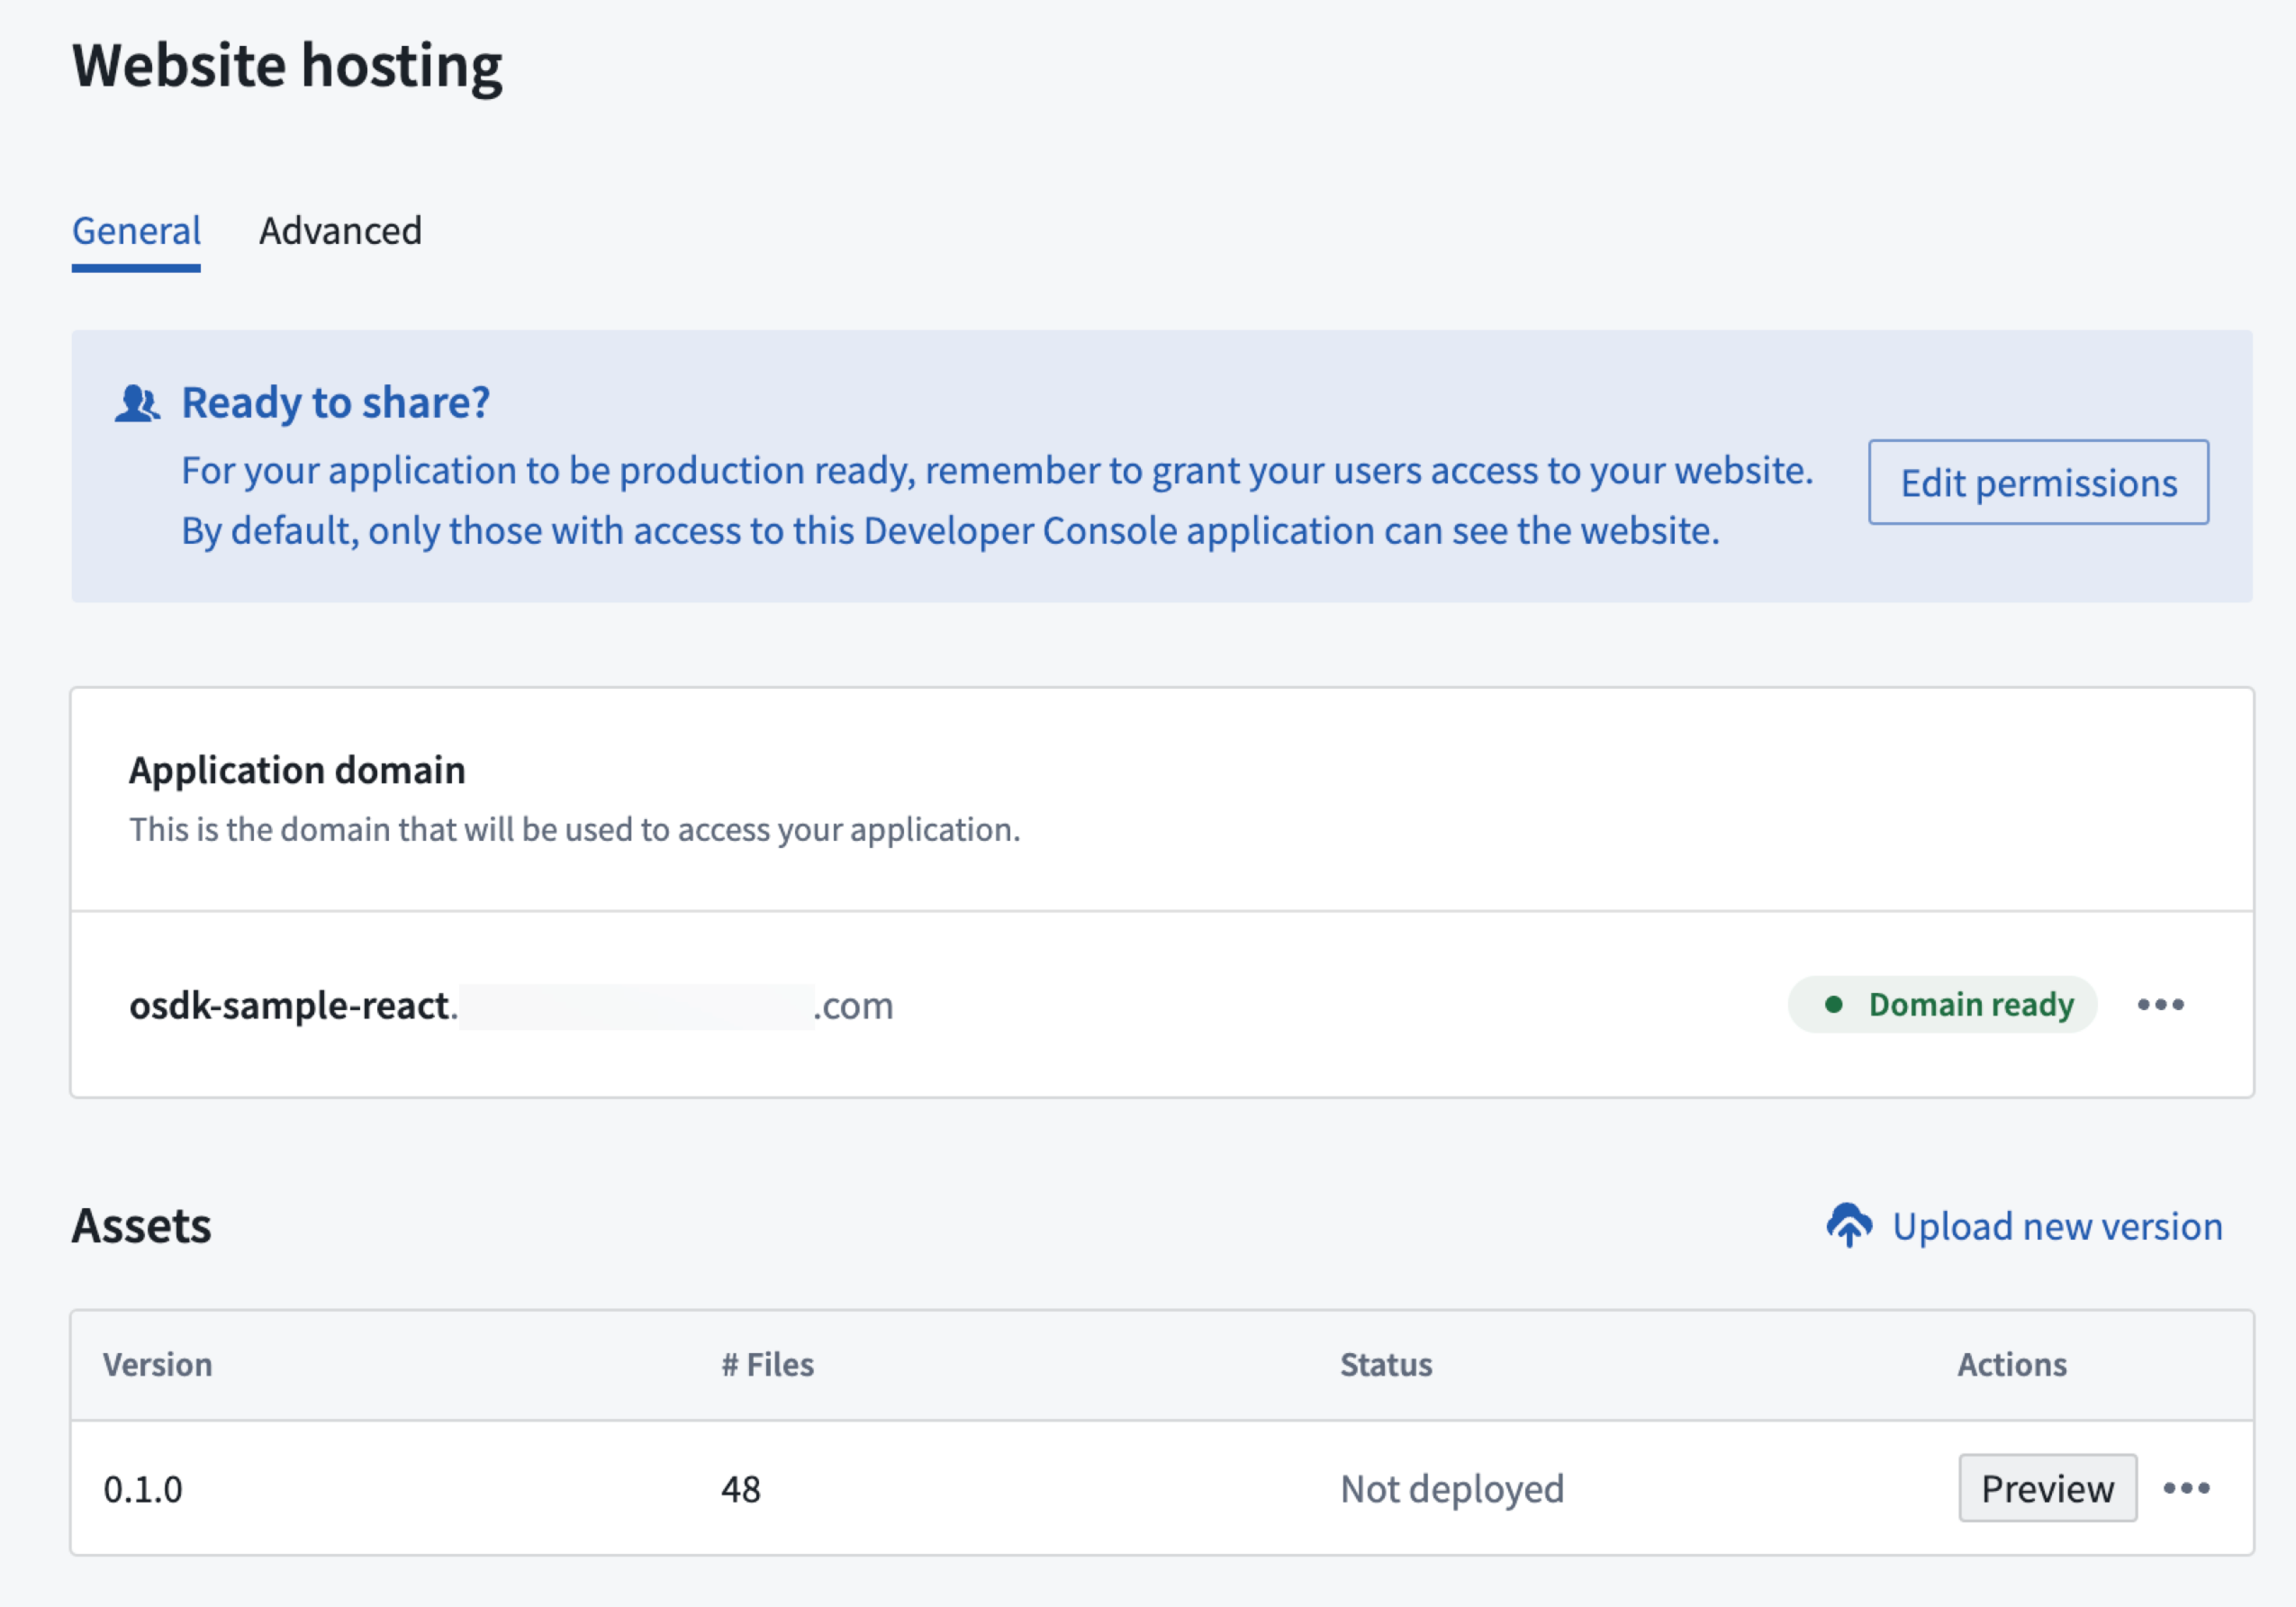
Web サイトホスティングメニュー。
Web サイトホスティングをセットアップして設定するには、次の操作が必要です。
- サイトのアプリケーションサブドメインを設定し、ユーザーがサイトへのアクセスに使用する URL を決めます。
- サイトを含むアセットを Foundry にアップロードし、結果をプレビューして、サイトを公開します。
Web サイトへのアクセスを設定したり、サイトのコンテンツセキュリティポリシー(CSP)の詳細設定を行ったりすることもできます。
Web サイトホスティングを設定できるのは誰ですか?
Developer Console の編集者または所有者ロールを持つユーザーは、Web ホスティングを設定できます。Web ホスティングのセットアップにはサブドメインの作成が含まれ、エンロールメント情報管理者による承認が必要です。
Web サイトホスティングのコマンドラインツール
コマンドラインツールの使用や既存の CI/CD ツールとの統合により、静的 Web サイトのデプロイプロセスを自動化します。詳細については、オントロジー SDK アプリケーション内の API ドキュメントを参照してください。
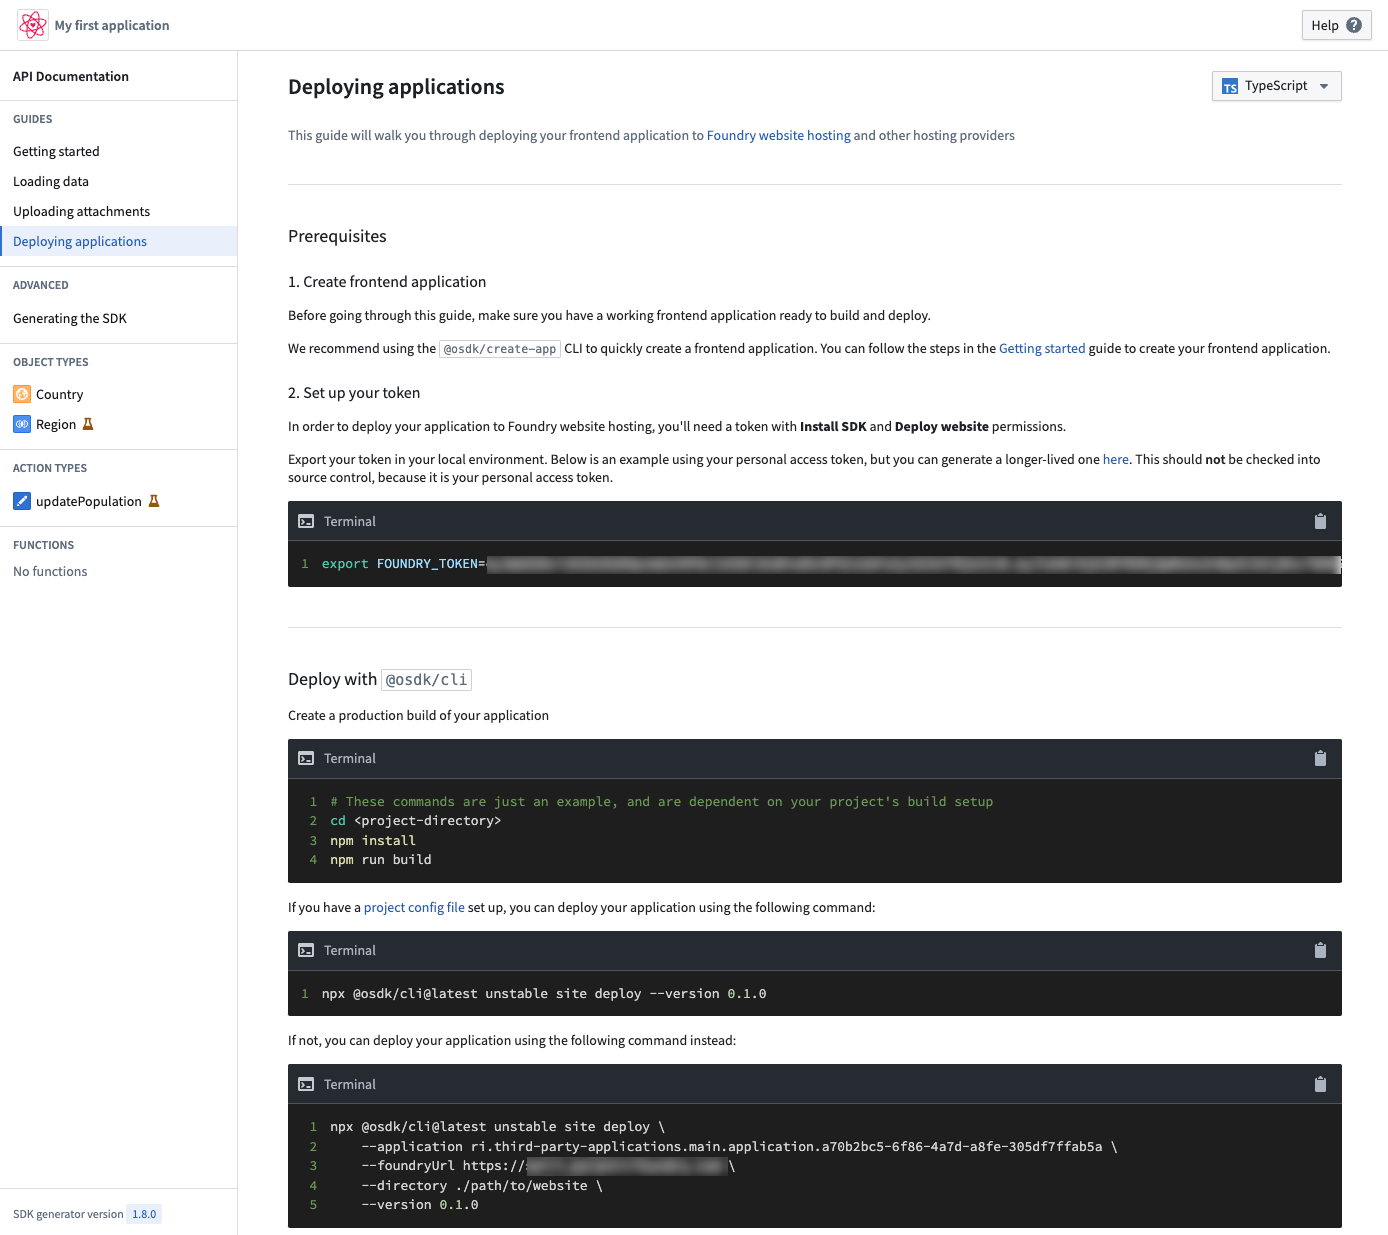
オントロジー SDK アプリケーションのドキュメント内にある、アプリケーションのデプロイチュートリアル。
今後の予定は何ですか?
顧客所有のドメインでの Web サイトホスティングのサポートを積極的に開発しています。また、Foundry でコードをホストし、Palantir Foundry 内から直接 CI/CD を実行できるようにするサポートも追加しています。
Web サイトホスティングの設定については、ドキュメントを参照してください。
Pipeline Builder で出力のマーキングを削除する
公開日: 2024-04-30
すべてのスタックで、Pipeline Builder 内から直接、出力のマーキングを削除できるようになりました。Pipeline Builder 内で、次の操作が可能になりました。
- 出力から、継承されたマーキングを1個または複数個削除します。
- 今後データセットに付与される可能性がある、継承されていないマーキングを事前に削除します。
- 指定したパイプライン内で、出力に以前適用したマーキングの削除を元に戻します。
マーキングの削除機能を使用するには、次の前提条件を満たしていることを確認してください。
- 対象のマーキングに対するマーキングを削除権限があること
- パイプラインでブランチ保護が有効になっていること
- パイプラインでコード承認が必須になっていること
マーキングを削除するには、マーキングを削除したい出力に移動し、マーキングを設定を選択します。
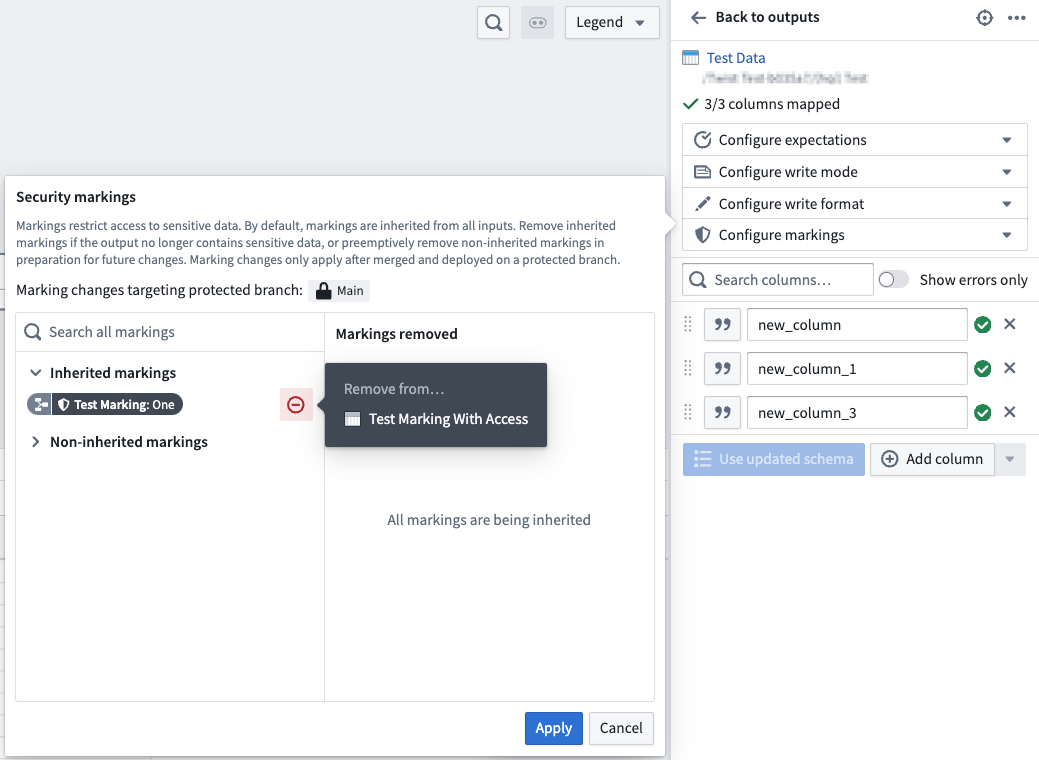
- 削除元アイコンにカーソルを合わせたマーキングのオプションパネル。*
削除するマーキングを選択すると、マーキングが削除されましたセクションにそれらのマーキングが表示されます。
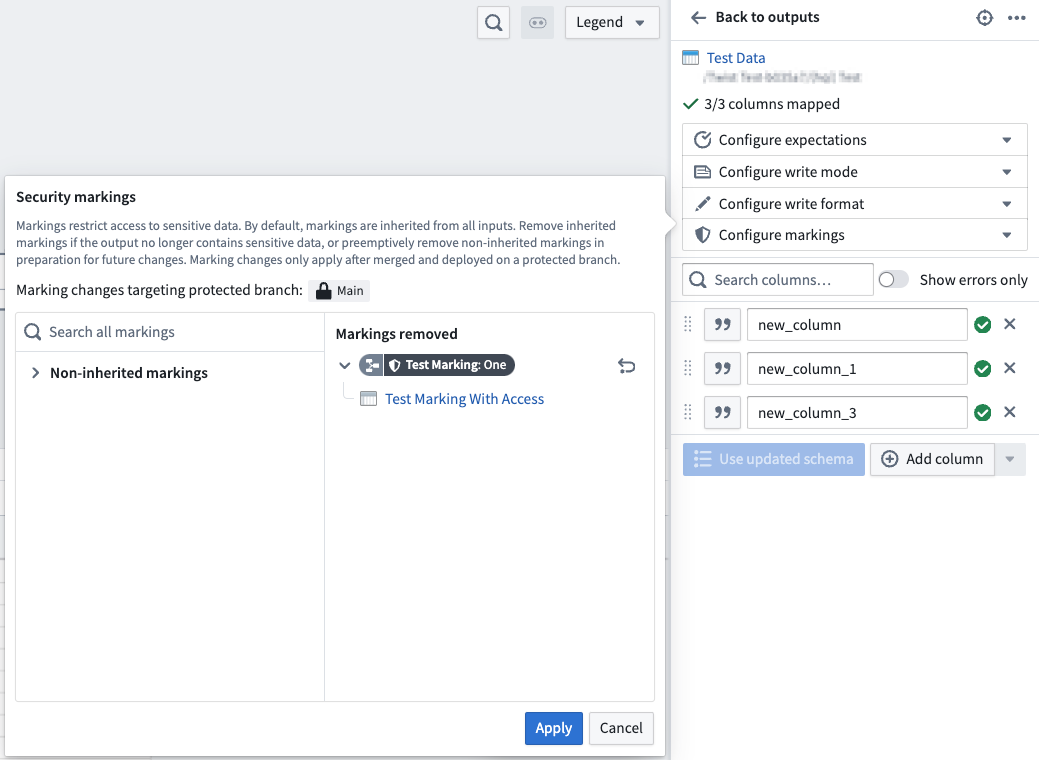
削除が適用された後、このブランチが master にマージされ、ビルドされると、そのマーキングは出力に表示されなくなります。
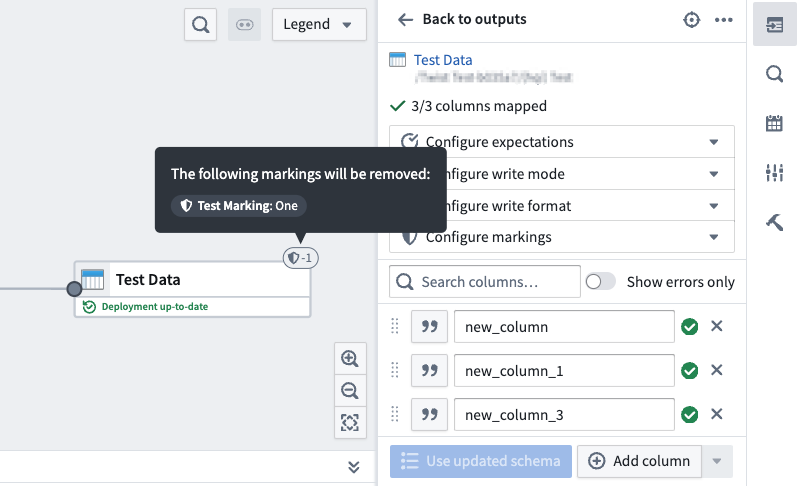
Pipeline Builder 内から直接マーキングを削除する方法については、ドキュメントを参照してください。
Jupyter® ノートブックでのモデル開発が一般提供に
公開日: 2024-04-30
本日より、既存の Code Workspaces と JupyterLab® の統合を最大限に活用し、プラットフォーム全体で利用するモデルのトレーニング、テスト、公開を行えるようになりました。Code Workspaces は、データサイエンティストにとってより使い慣れた対話型の環境を提供し、Code Repositories の既存のモデルトレーニングフローに代わる選択肢となります。
Code Workspaces を通じて公開されたモデルは、Workshop、Slate、Python トランスフォームなどの下流のアプリケーションですぐに利用可能になります。
Code Workspaces 内でモデルを作成する
Code Workspaces 内から直接モデルを公開できるようになりました。モデルタブに移動し、モデルを作成を選択します。モデルの場所を選択すると、モデルのエイリアスを定義するよう求められます。エイリアスは、人が読みやすい識別子であり、Palantir Foundry がモデルの識別に使用するリソース識別子に対応付けられます。
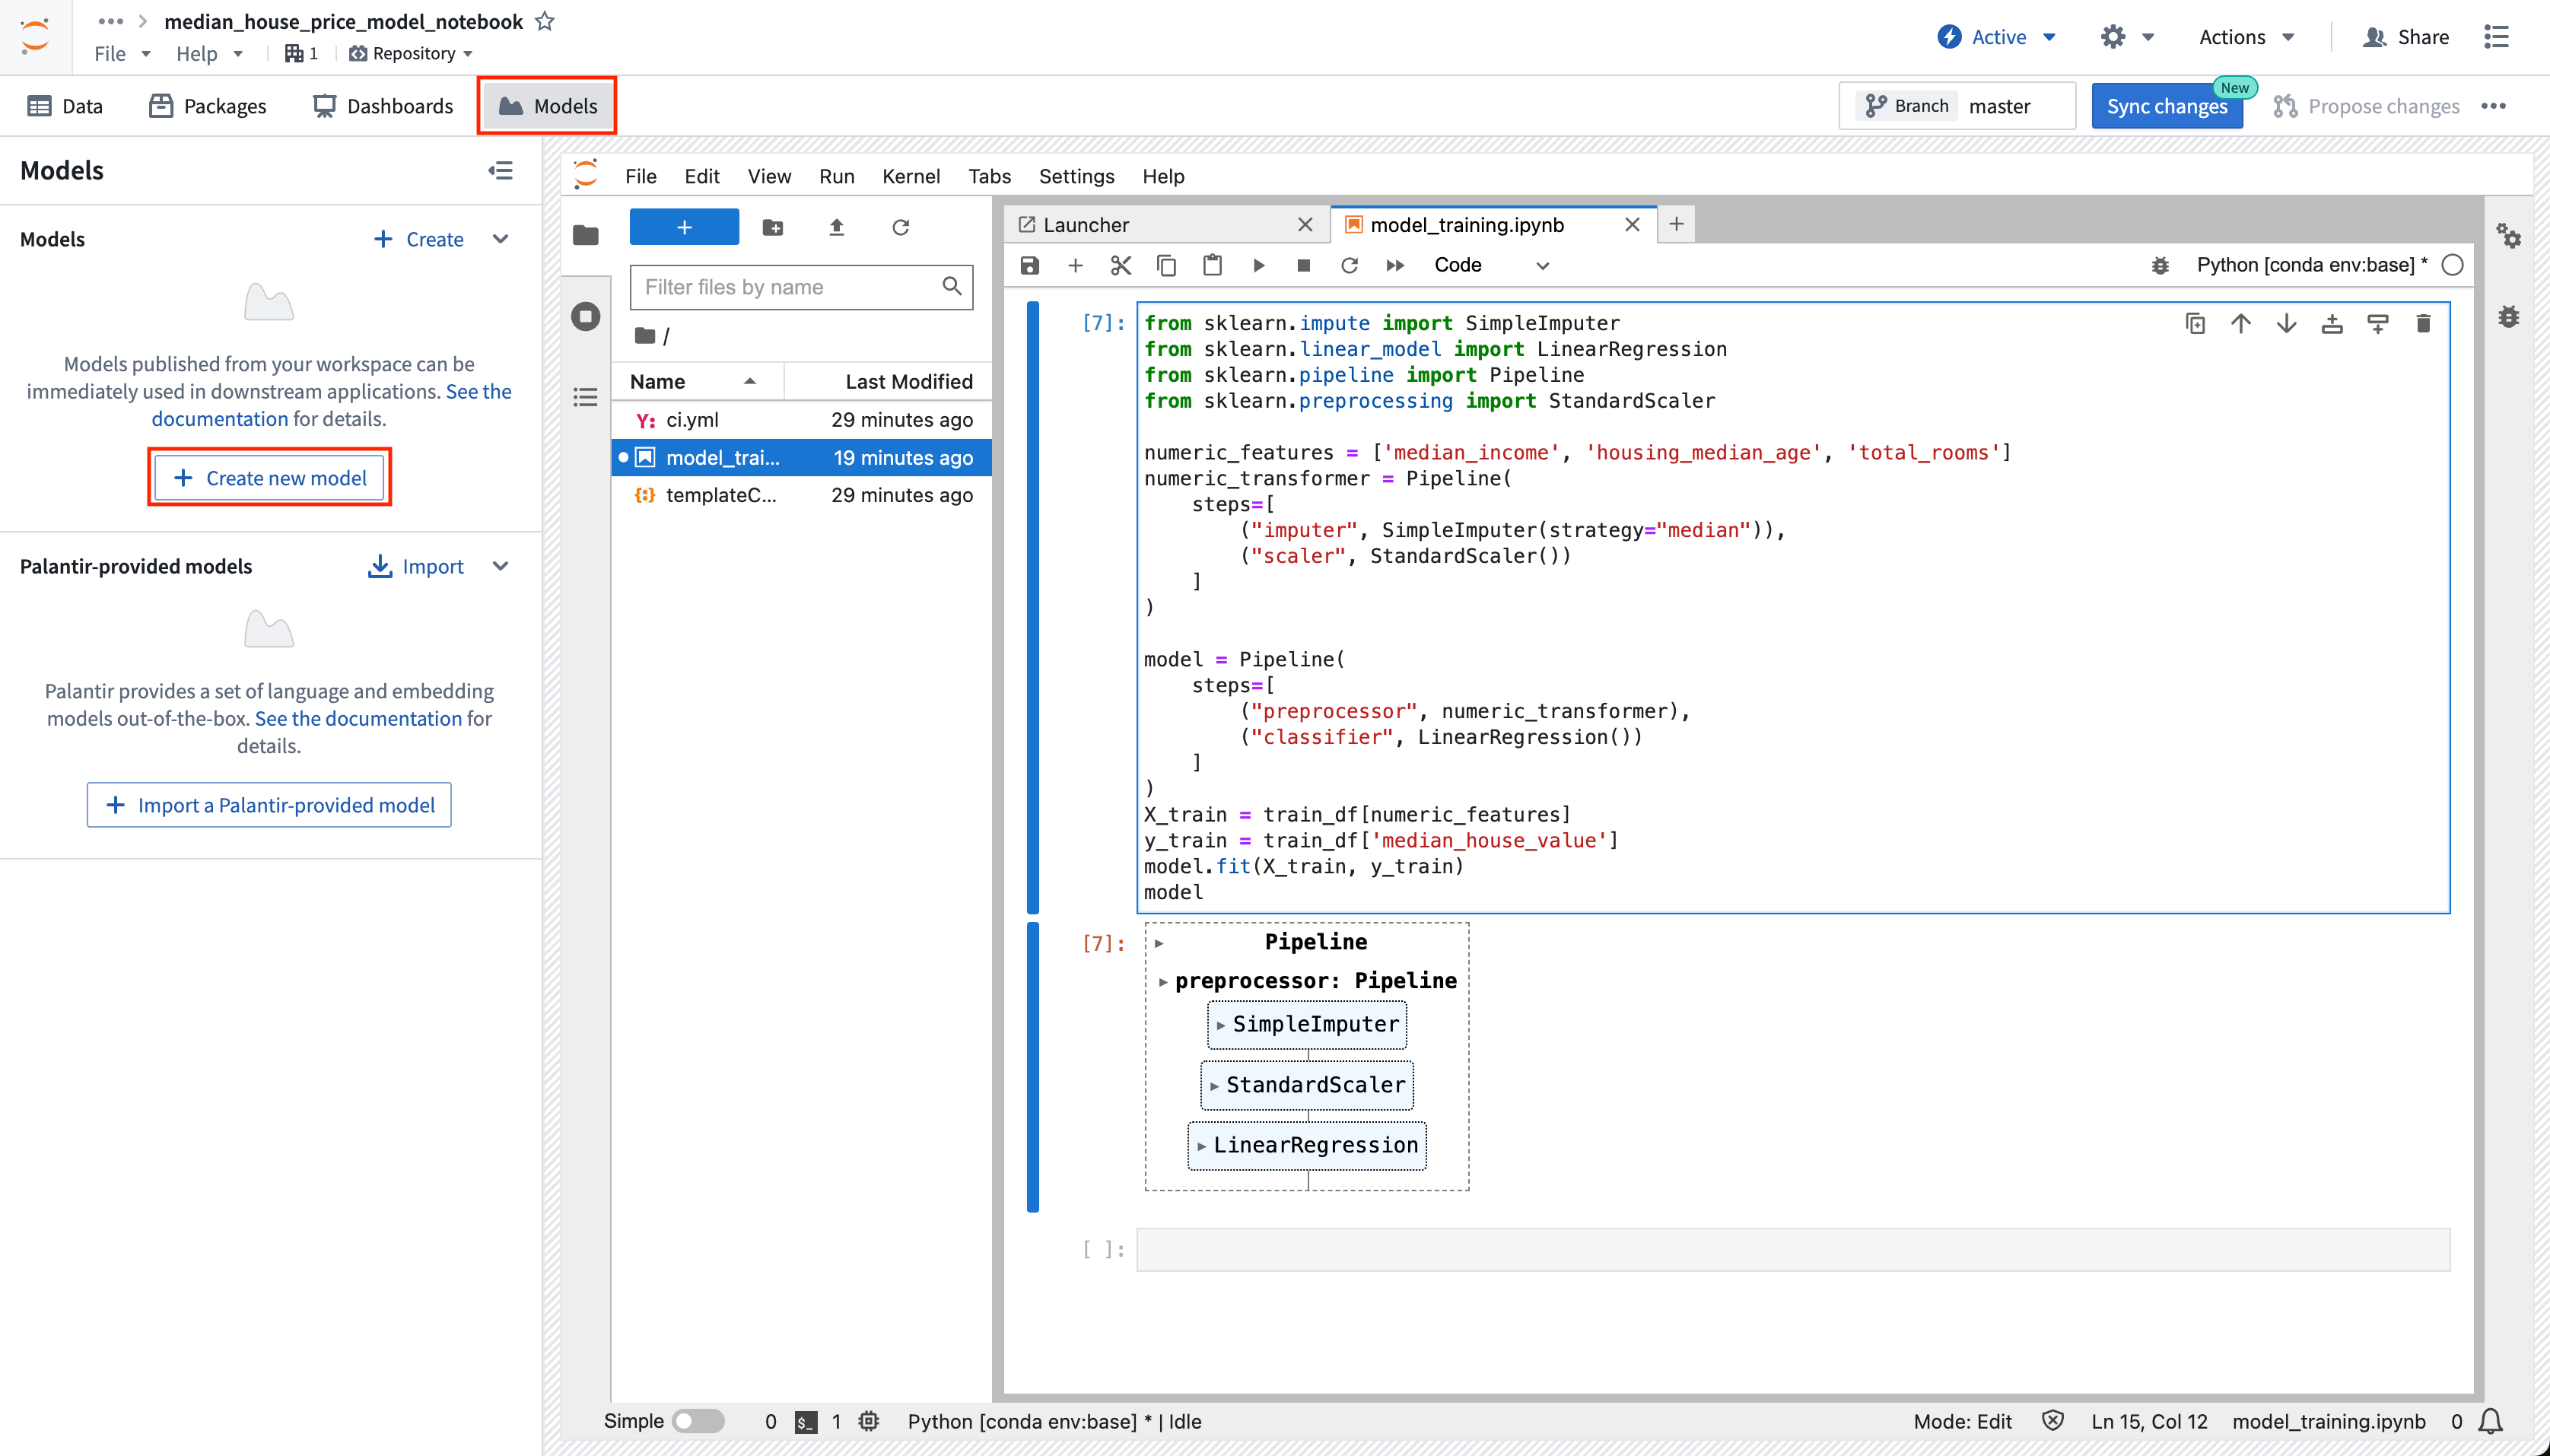
Code Workspaces 内の新規モデル作成オプション。
モデルを Foundry に直接公開する
モデルのエイリアスを定義したら、ビューの左側にあるステップバイステップガイドに沿ってモデルを Foundry に公開します。必要なパッケージのインストール、モデルアダプターの定義、最後にモデルを公開する手順の詳細を確認します。
モデルを初めて作成すると、[MODEL_ALIAS]_adapter.py という名前でアダプターファイルのひな形が生成されます。モデルアダプターの定義方法については、モデルアダプターのシリアル化に関するドキュメントおよびモデルアダプター API のドキュメントを参照してください。
アダプターを作成したら、用意されているモデル公開用スニペットを使用して、モデルを Foundry に公開できます。スニペットを選択してコピーし、ノートブックのセルに貼り付けて実行します。
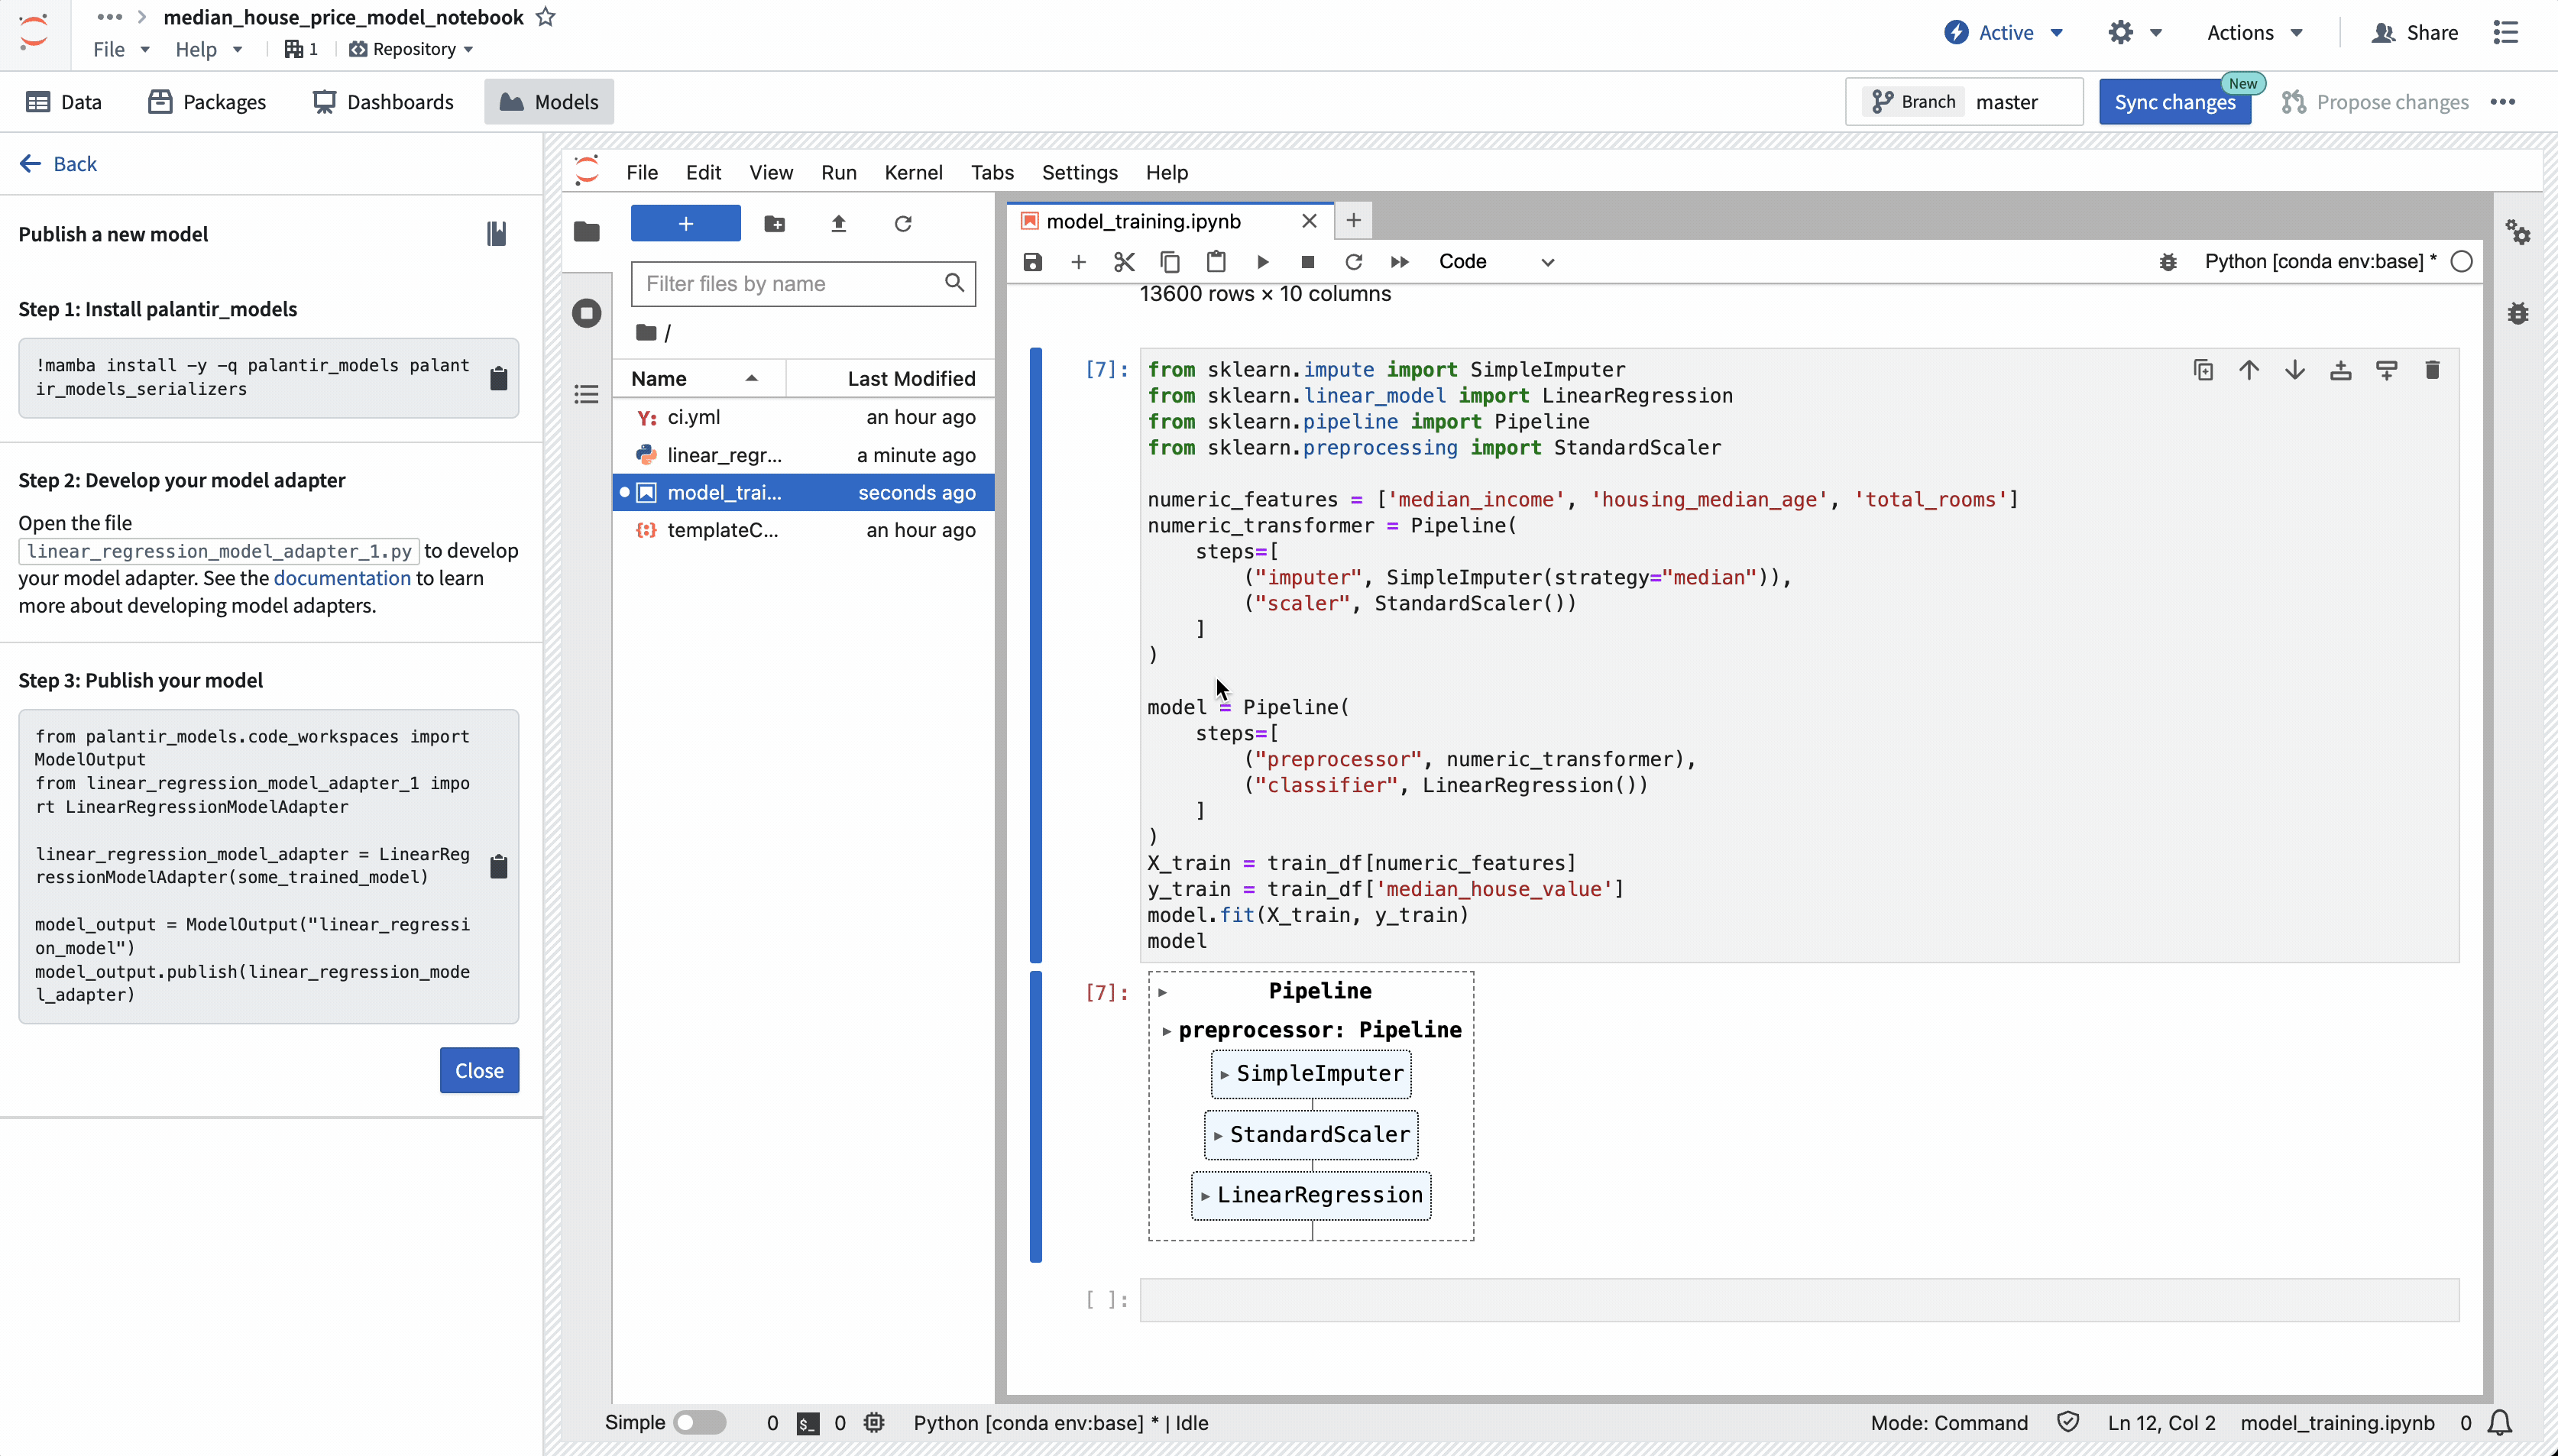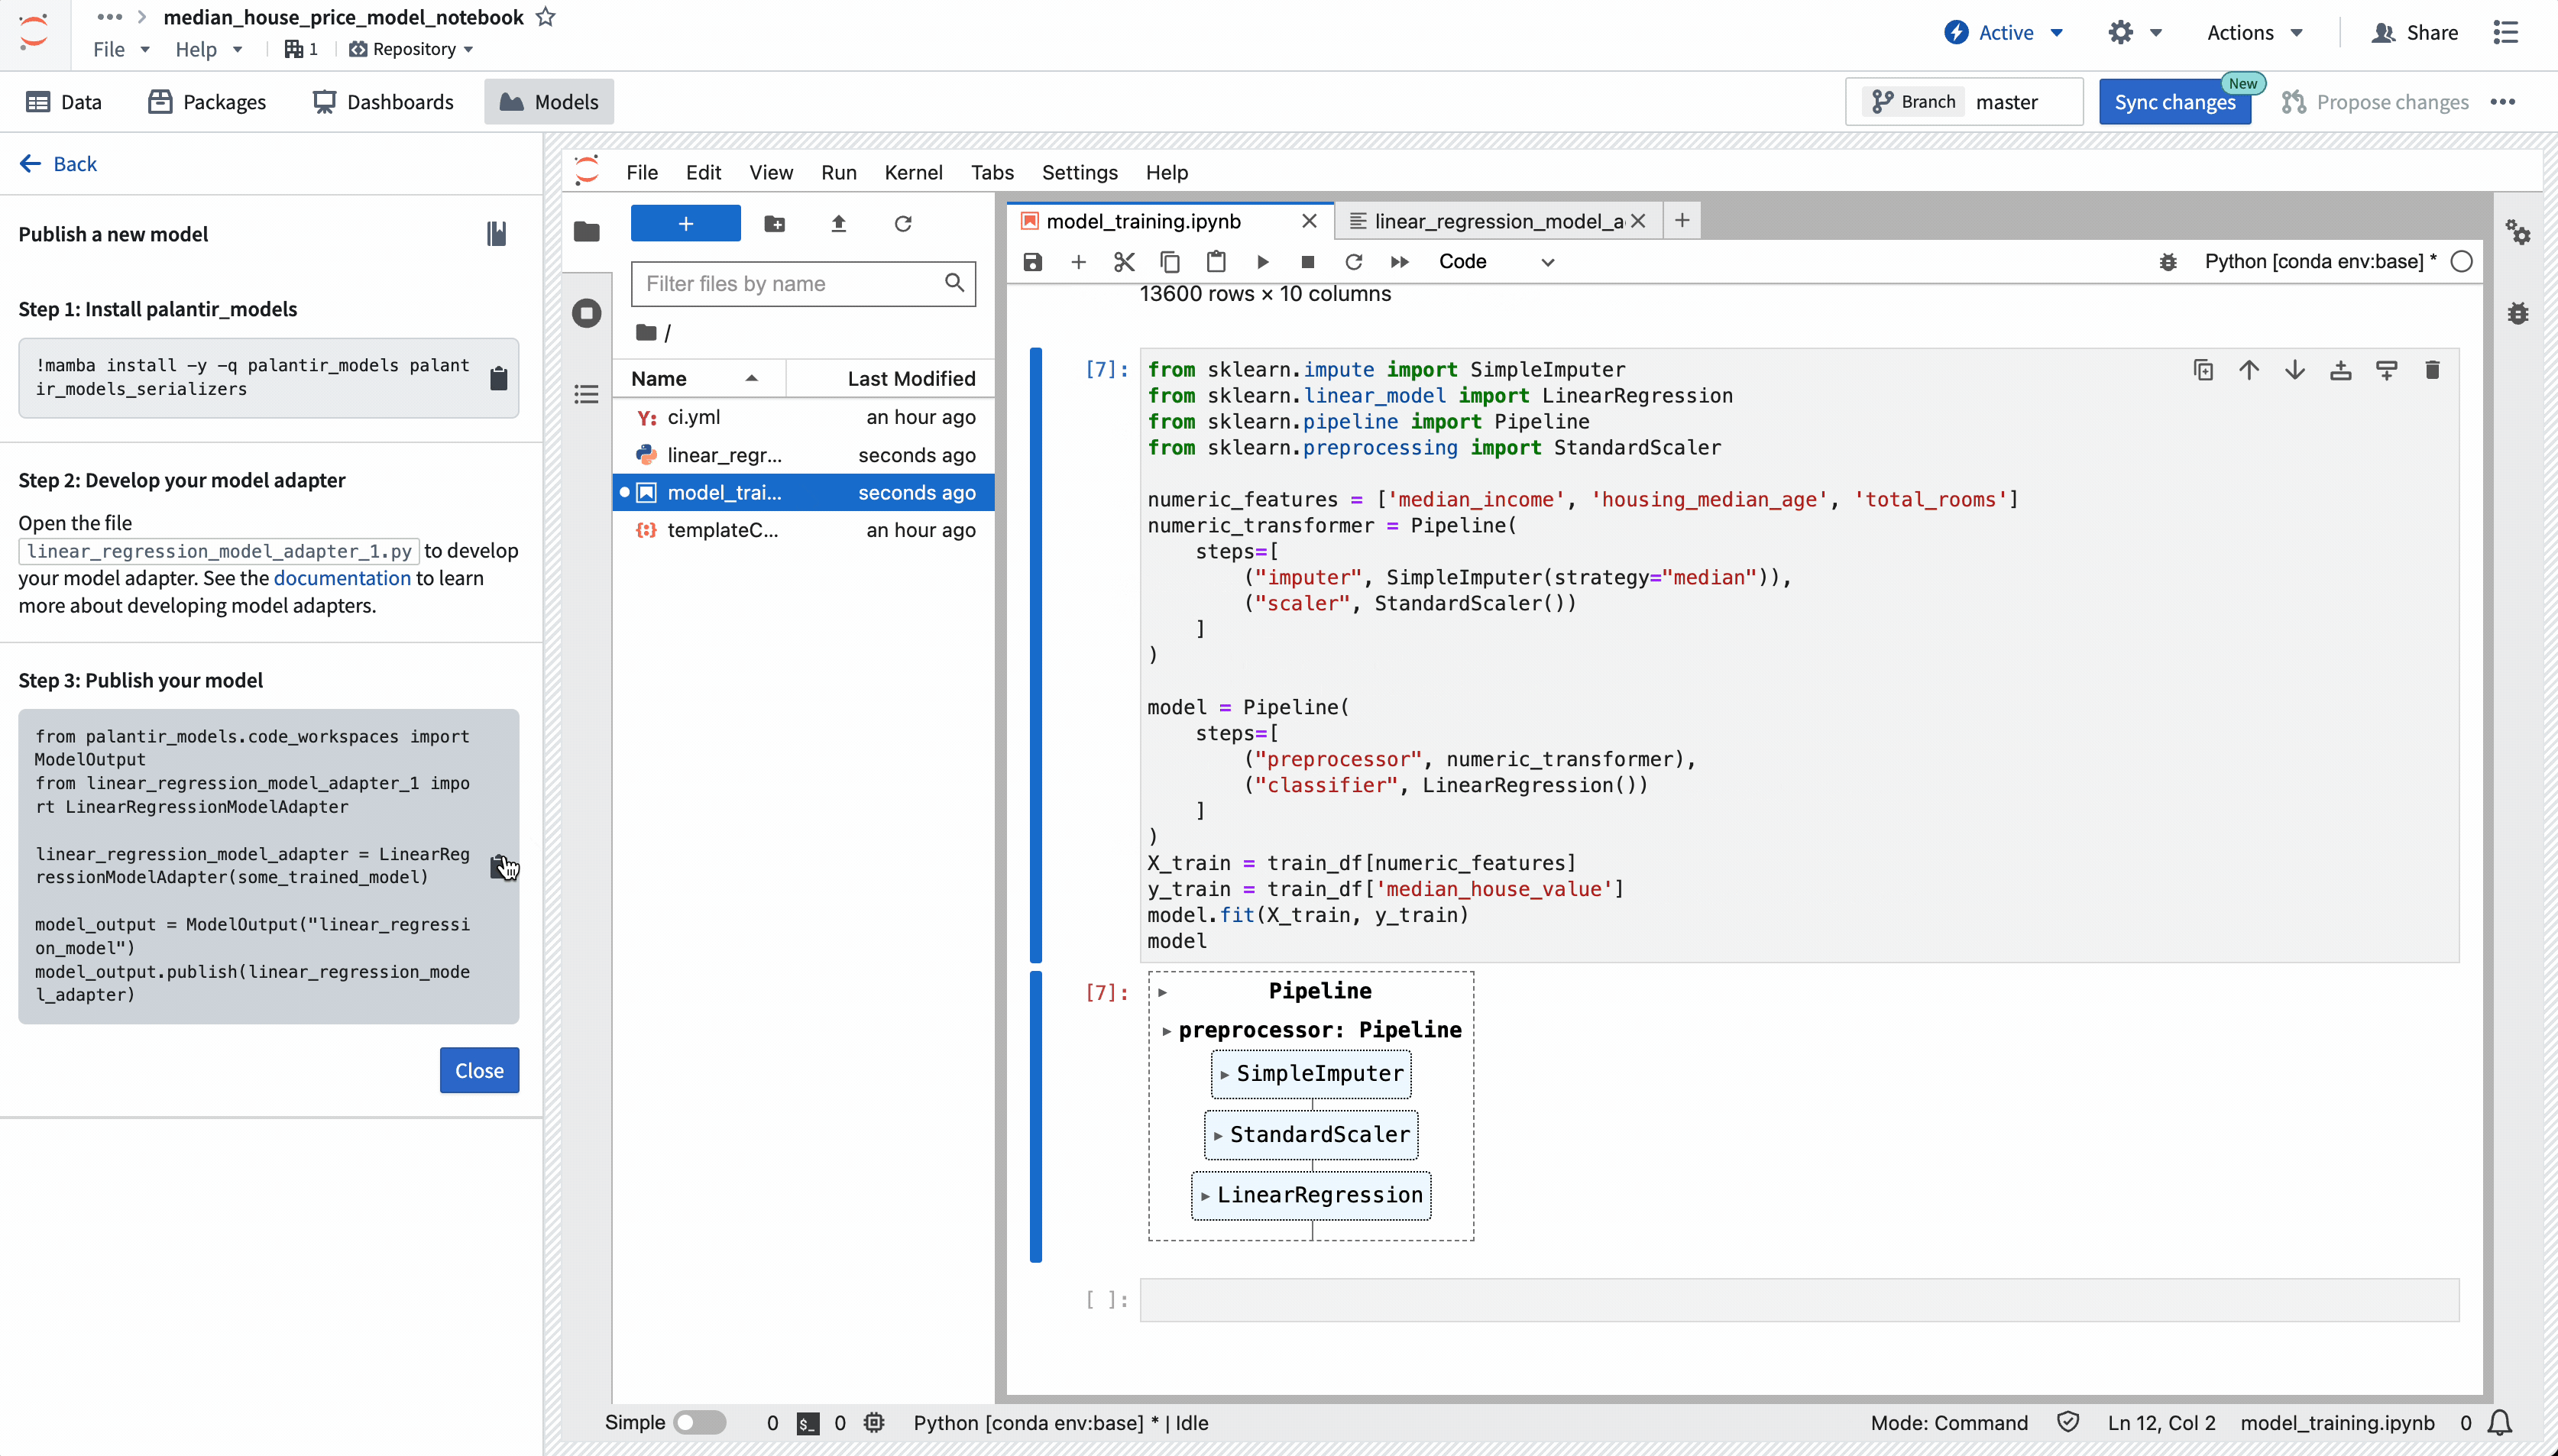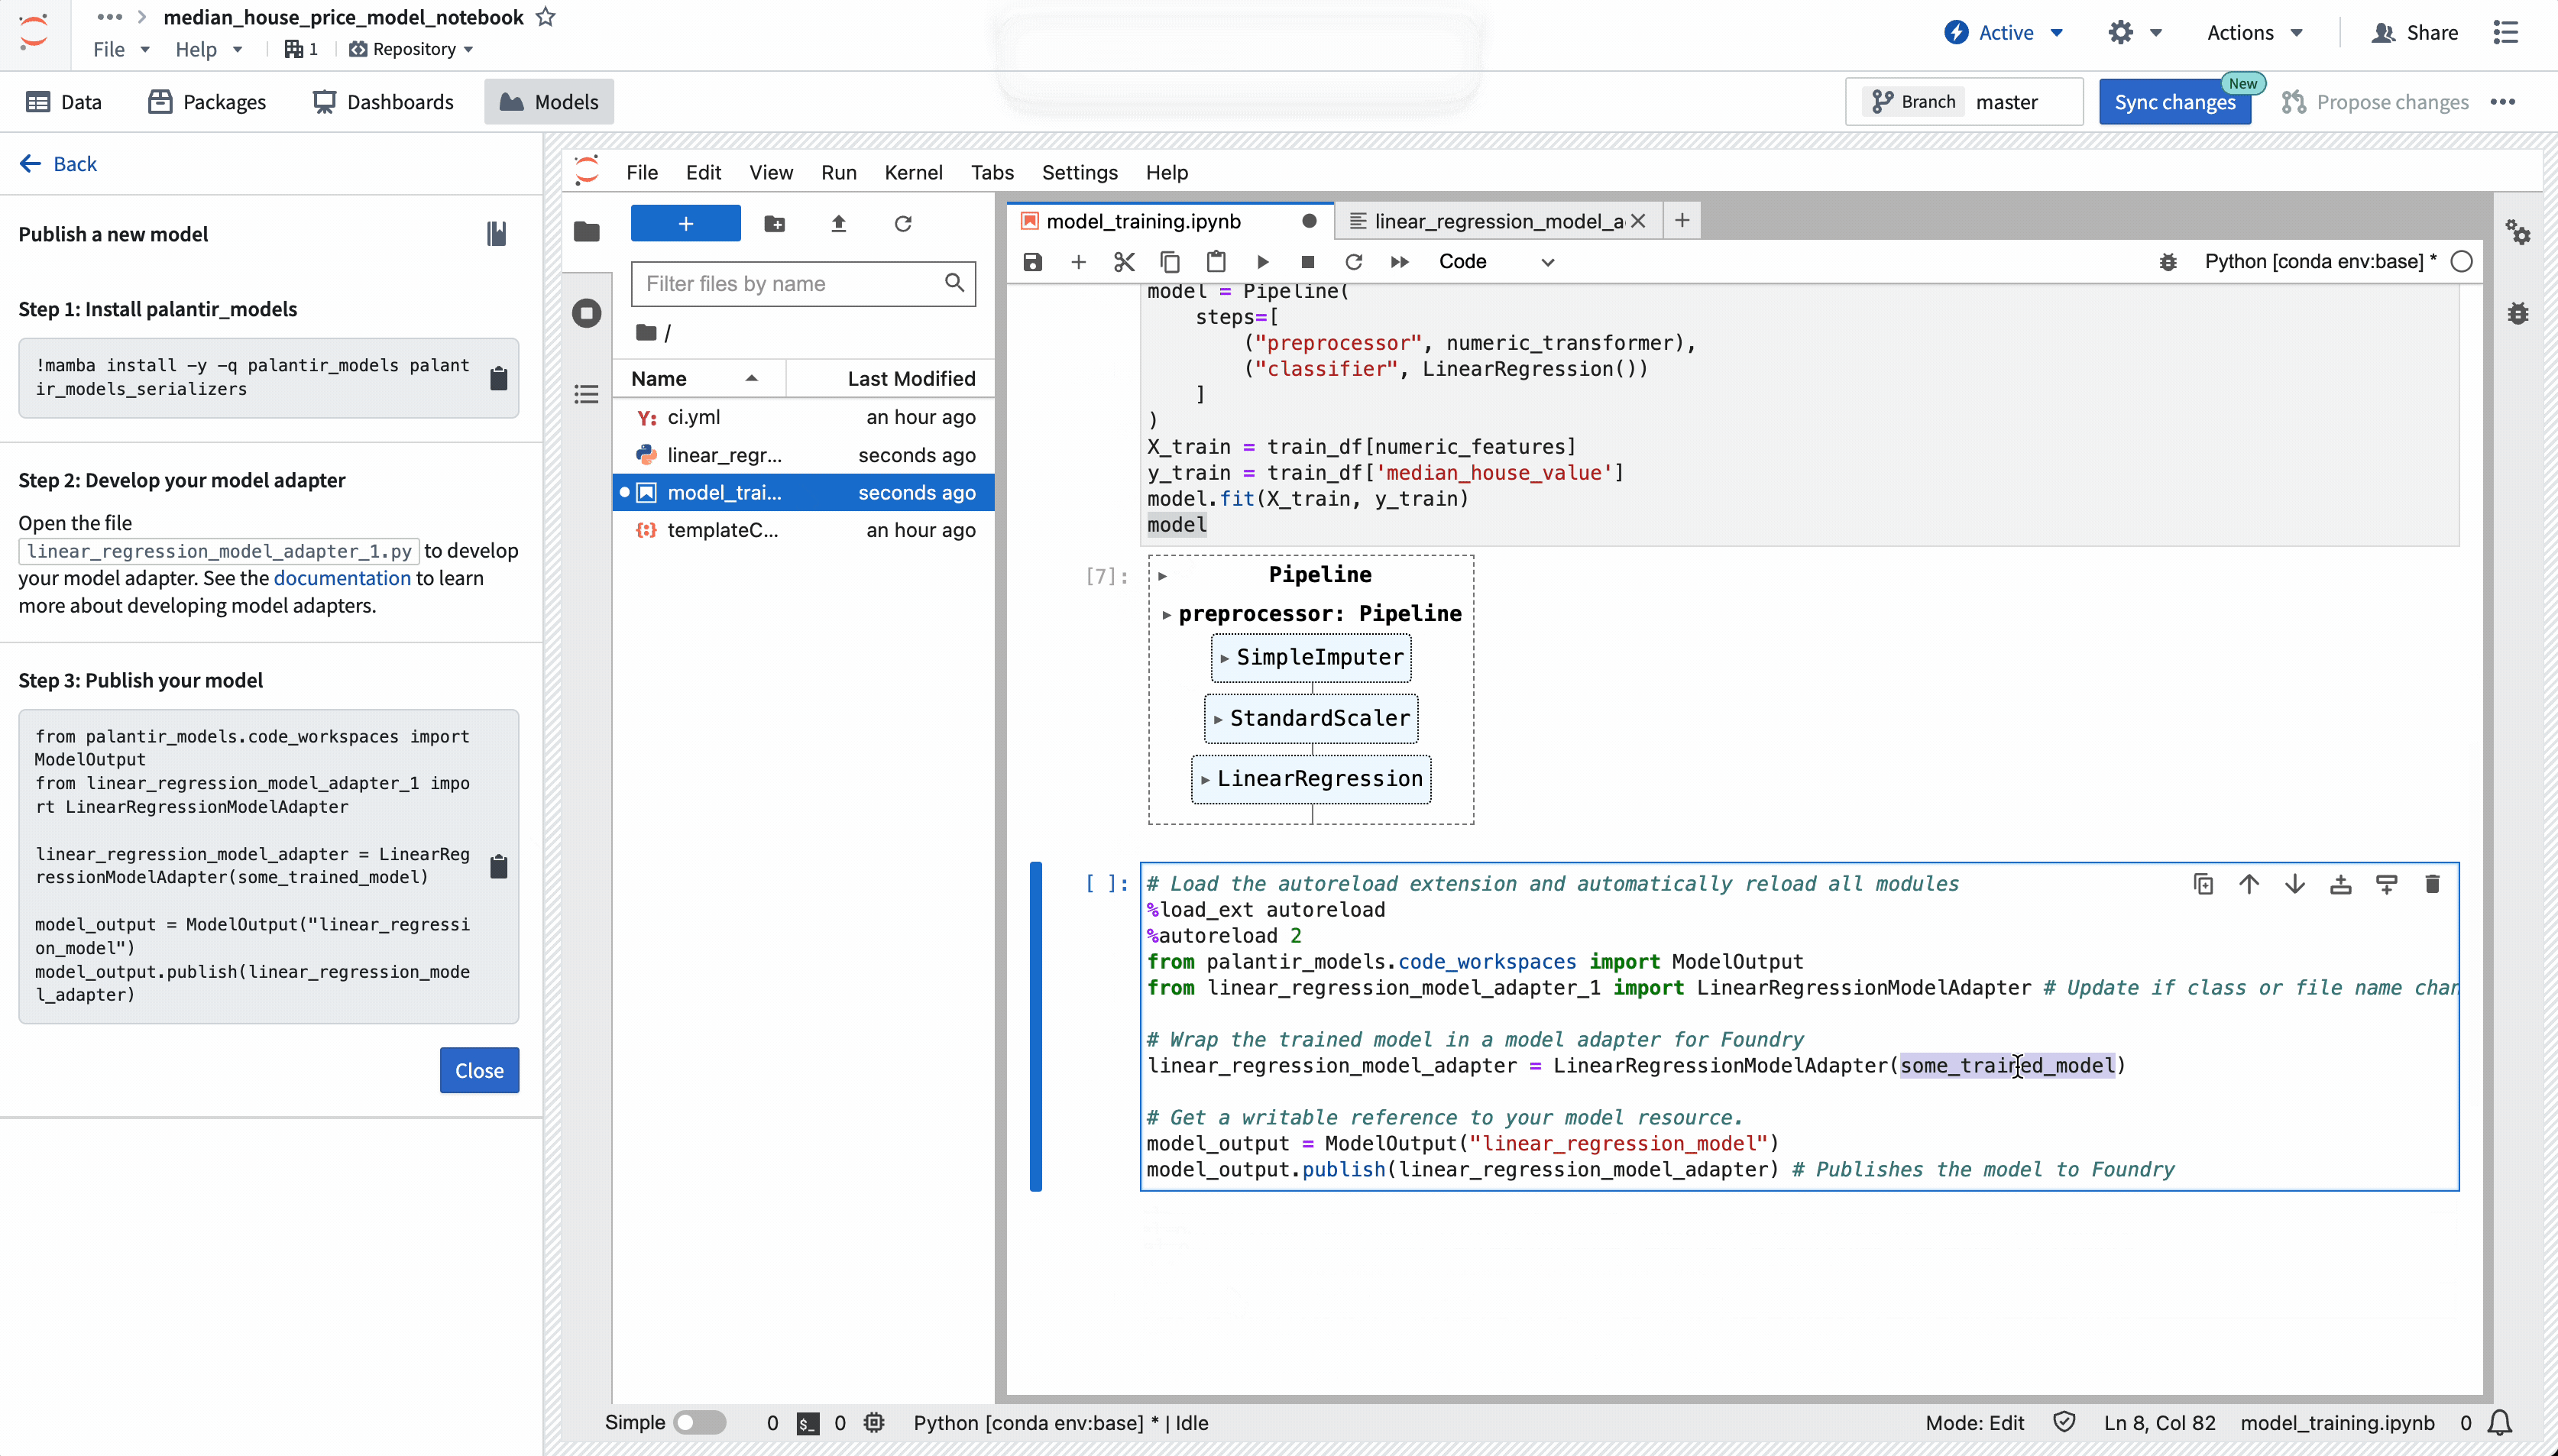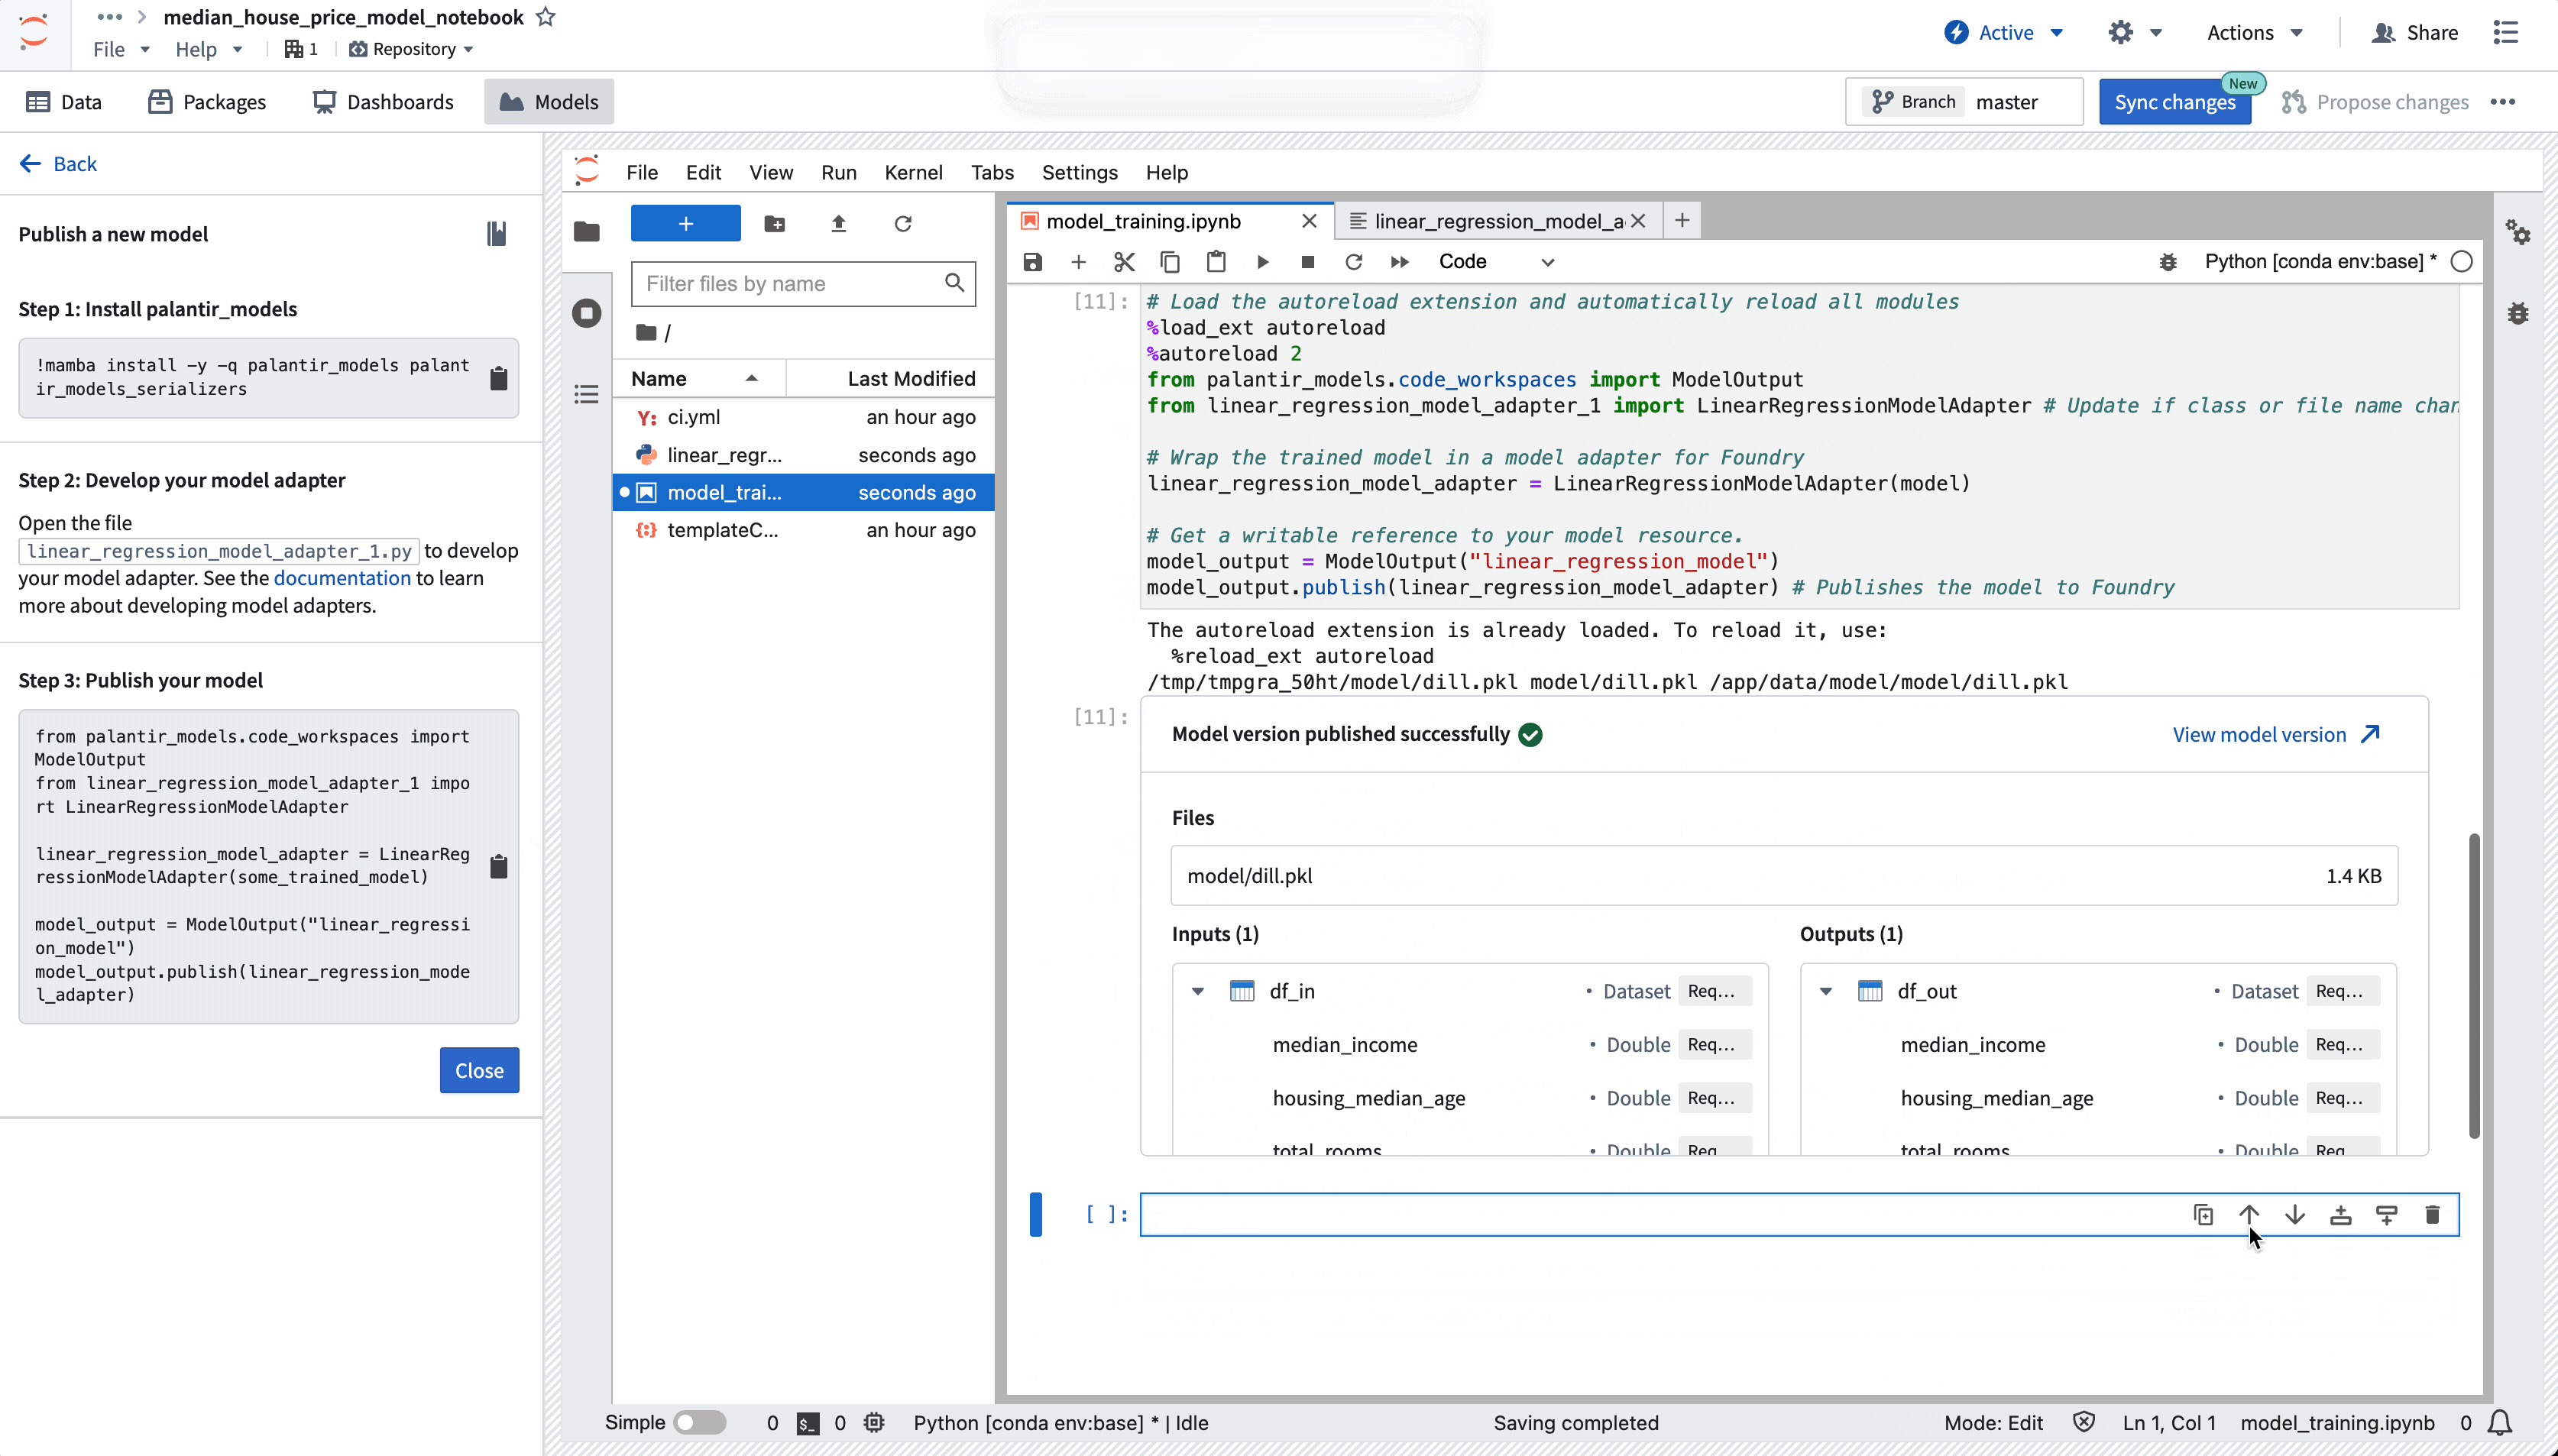
モデルの公開に成功すると、公開が成功したことを示すプレビュー出力が表示され、モデルの API や保存されたモデルファイルなどのモデル情報が表示されます。
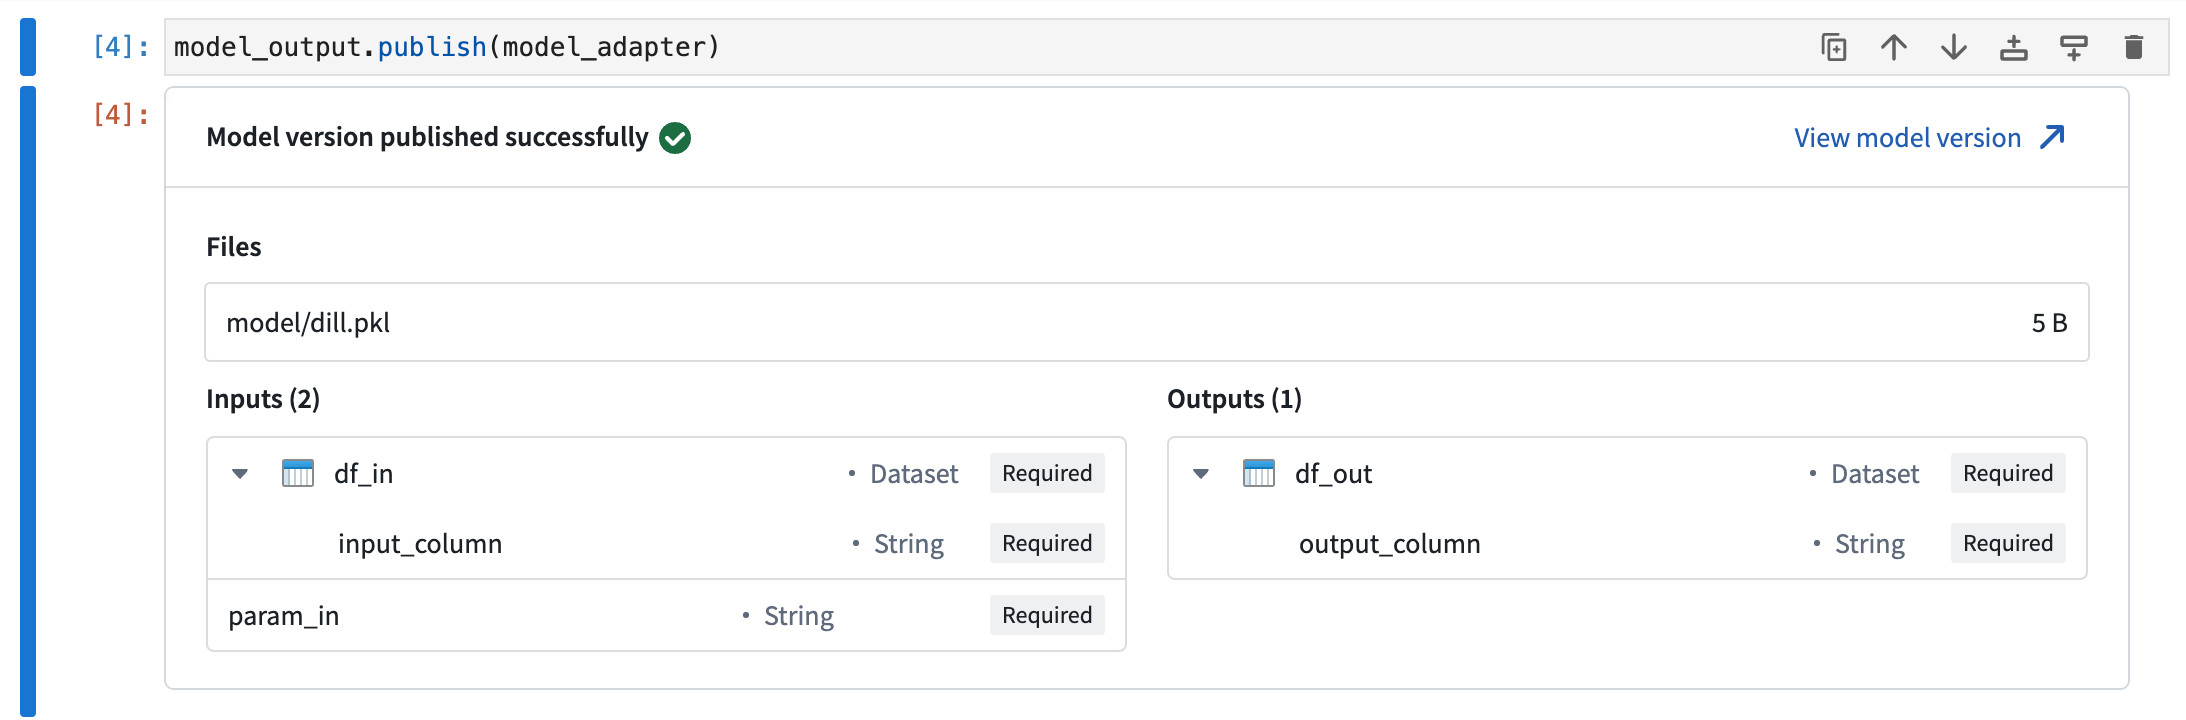
モデルバージョンの公開成功通知。
詳しくはこちら
Code Workspaces でのモデルの開発と公開については、Code Workspaces のモデルトレーニングに関するドキュメントを参照してください。 プロジェクトのセットアップ、モデルの構築、下流のアプリケーションで利用するためのモデルのデプロイを順に説明するチュートリアル全体も参照できます。
Jupyter®、JupyterLab®、および Jupyter® のロゴは、NumFOCUS の商標または登録商標です。記載されている第三者の商標(ロゴおよびアイコンを含む)はすべて、それぞれの所有者に帰属します。提携または推奨を示唆するものではありません。
Preparation (Blacksmith) のサンセット
公開日: 2024-04-30
Preparation (Blacksmith) はサンセット段階に入り、ノーコードのパイプライン構築とデータクリーニングの標準ツールである Pipeline Builder に置き換えられます。Preparation は数年間メンテナンスモードで運用されており、Marketplace 統合には対応しません。新しいエンロールメントにはアクセスが付与されなくなりますが、この変更は当面、既存の Preparation のインストールには影響しません。
Model Catalog の紹介:2024年4月末に一般提供 [GA]
公開日: 2024-04-24
Model Catalog は2024年4月末に一般提供され、Palantir が提供するすべてのモデルを表示し、AIP で新しいモデルを見つけられるようになります。
Model Catalog を使用すると、開発者は次のことができます。
- AIP で利用可能なモデルを表示し、新しいモデルを見つけます。
- ユースケースに適したモデルを選択します。
- Marketplace の基本テンプレートとユースケース全体のテンプレートの両方を使用して、ワークフローをはじめます。
- サンドボックス/プレイグラウンドでさまざまなモデルをテストします。
Model Catalog には、Model Catalog のホームページとモデルのエンティティページという2つの主要コンポーネントがあります。
Model Catalog のホームページ
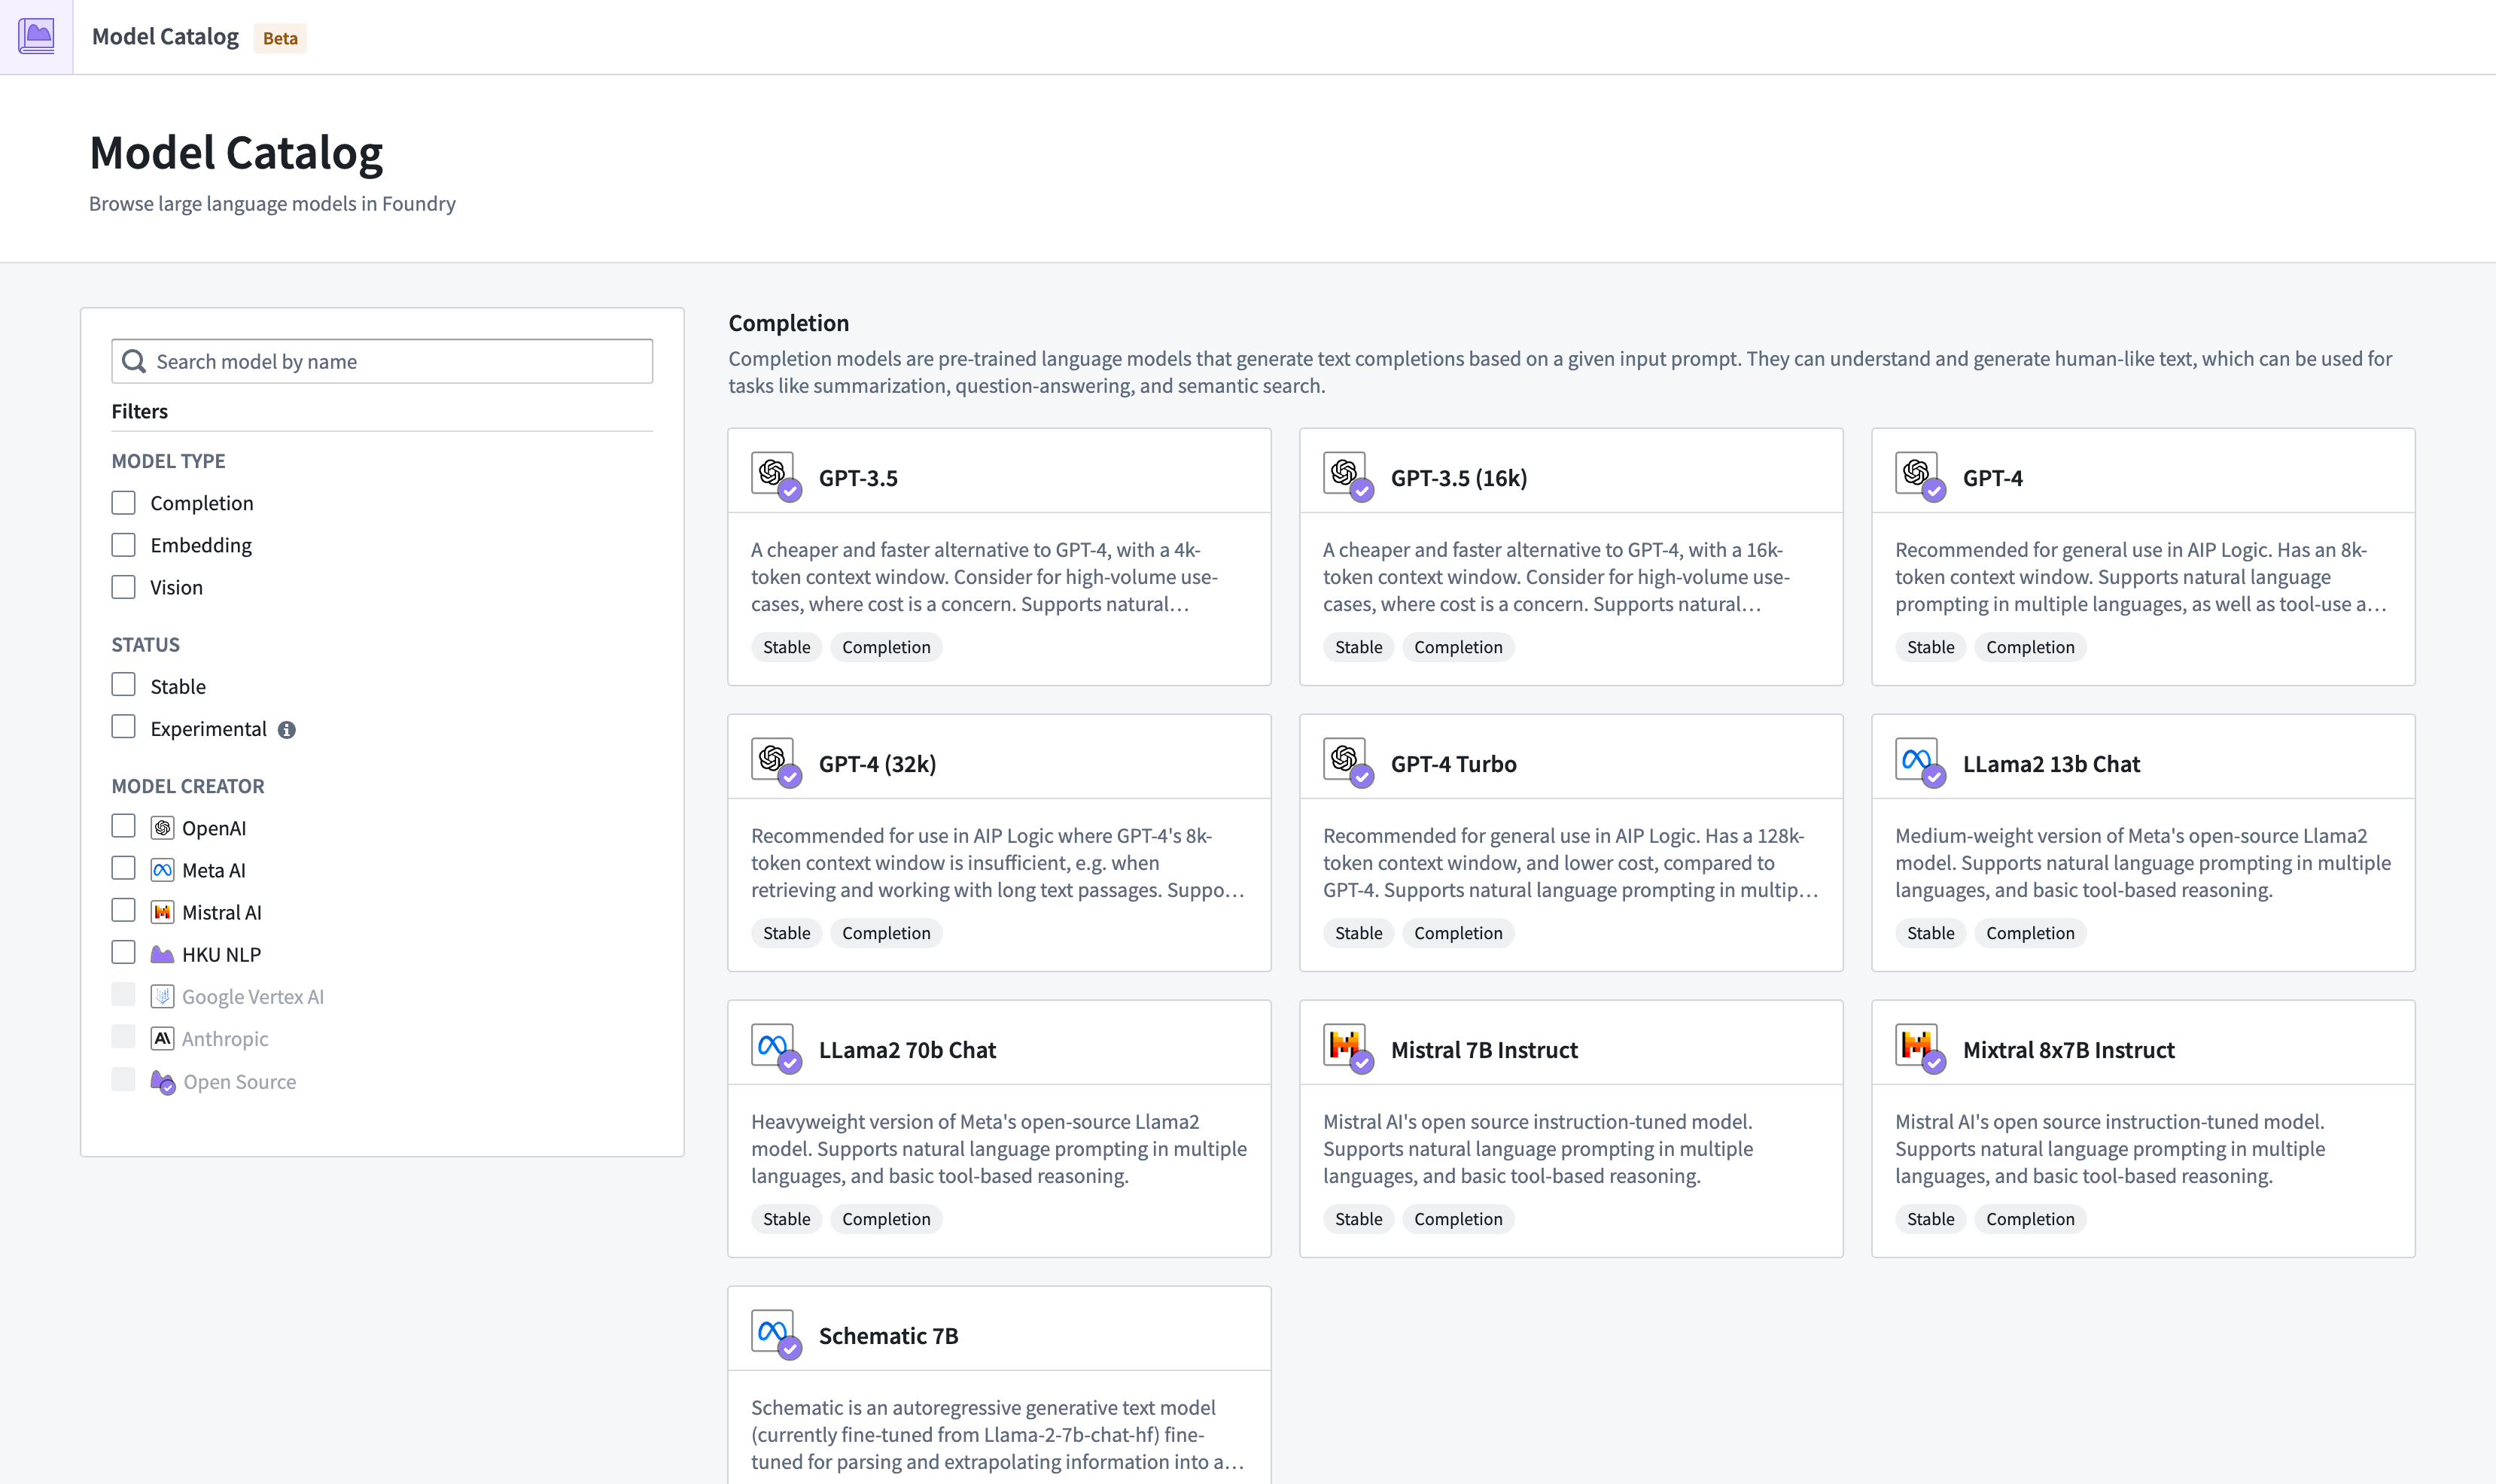
Model Catalog のホームページ。
Model Catalog のホームページは、モデルを見つけて移動するためのインターフェースで、Foundry エンロールメントで利用可能なすべての大規模言語モデルを表示します。
ホームページでモデルを絞り込む方法はいくつかあります。
- モデルの種類:利用可能なすべての補完モデル、埋め込みモデル、またはビジョンモデルを表示します。
- ステータス:ライフサイクルステータスが安定か試験的かに基づいてモデルを表示します。
- モデルの作成者:特定の LLM の作成、開発、保守を担当する組織に基づいてモデルを表示します。
モデルのエンティティページ
各モデルのエンティティページには、3つの主要セクションがあります。
- テスト: 開発者がさまざまなモデルを試すためのインターフェースです。
- 使い方: ワークフローの構築をはじめるために必要なコンテンツがすでに入力されたリソースを作成して、はじめます。Model Catalog は現在、Functions とトランスフォームをサポートしています。
- モデルの説明: 基本的な説明、法的免責事項、トークン上限などのモデルのコンテキストウィンドウ、トレーニングデータのカットオフなどを表示します。
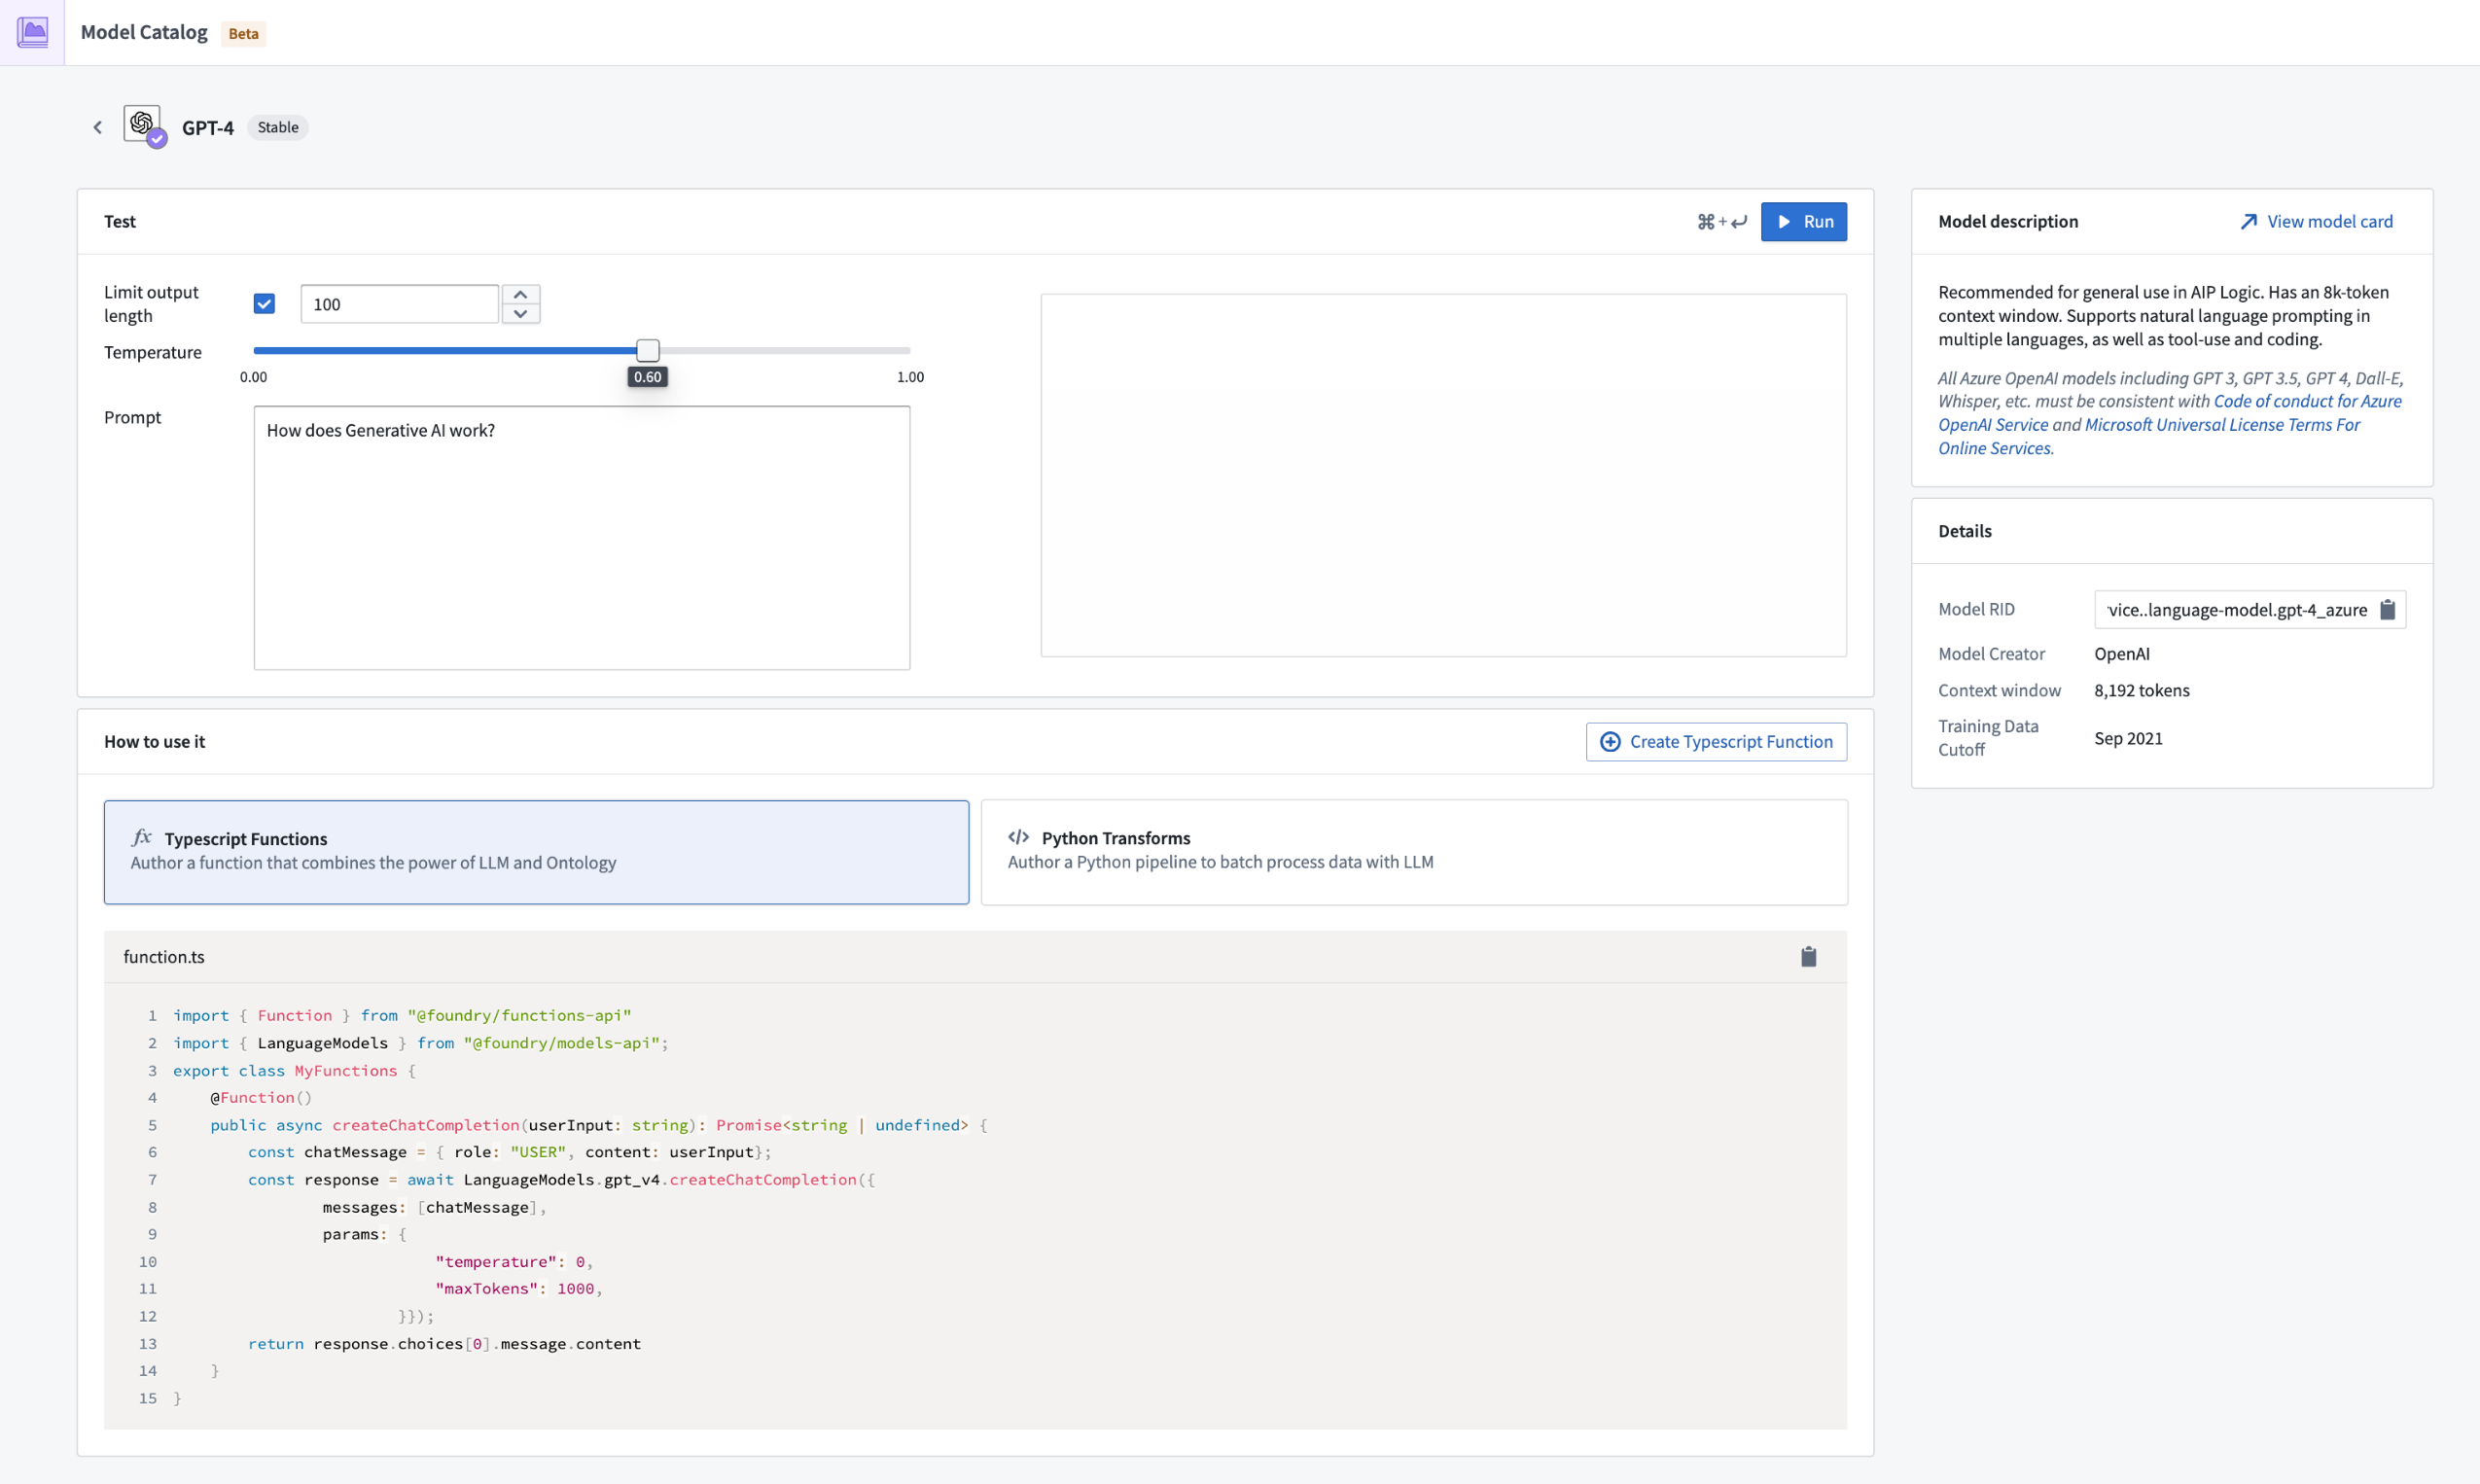
モデルのエンティティページ。
開発ロードマップでは次に何が予定されていますか?
- モデルの比較と意思決定のためのツールやベンチマークをさらに提供します。
- テスト用サンドボックスを改善し、さまざまな機能とプロンプトの種類に対応します。
- 使い方機能をすべての AIP アプリケーションに拡張します。
Model Catalog の詳細については、ドキュメントを参照してください。
オントロジー SDK TypeScript 1.1 のお知らせ
公開日: 2024-04-24
メジャーバージョンへのアップグレード(TypeScript 2.0)に備えて、マイナーバージョン1.1をリリースします。コードをこの新しいバージョンに移行することで、TypeScript 2.0 に向けた準備を進められます。
なぜ TypeScript 2.0 を開発しているのですか?
オントロジーインターフェースやリアルタイム購読などの新しいオントロジープリミティブを活用し、より効率的にデータを扱えるようにするため、オントロジー SDK TypeScript のセマンティクスをリファクタリングしました。この変更はメジャーリリース v2.0 として、2024年末までにリリースされる予定です。
バージョン2.0のリリースに先立ち、今後のアップグレードへの橋渡しとしてバージョン1.1と1.2を先に提供することで、顧客への影響を最小限に抑えることを目指しています。
今後リリースされる2つのバージョンについて、以下に詳しく説明します。
-
バージョン1.1: このバージョンでは現在の言語構文を維持しますが、今後サポートされなくなる一部のメソッドとプロパティを非推奨にします。
-
バージョン1.2: 今年後半にリリースされるバージョン1.2では、主に1.x バージョンと同じ機能を提供しつつ、新しい言語構文を導入します。
オントロジー SDK TypeScript 1.1 では何が変わりますか?
次のテーブルは、非推奨となる機能とその代替の概要です。変更の詳細については、その下で説明します。
| 非推奨 | 代替 |
|---|---|
| page | fetchPage, fetchPageWithErrors |
| __apiName | $apiName |
| __primaryKey | $primaryKey |
| __rid | $rid |
| all() | asyncIter() |
| bulkActions | batchActions |
| searchAround{linkApiName} | pivotTo(linkApiName) |
Page()
page 関数を非推奨にし、利便性のために次の2つのメソッドを追加します。
-
fetchPageWithErrors- これは
pageとまったく同じように動作します。今後の V2.0 の API 命名規則と整合性を保つために、名前を変更しました。 - 変更前
-
Copied!
1 2 3 4 5 6const result: Result<Employee[], ListObjectsError> = await client.ontology .objects.Employee.page(); if(isOk(result)){ const employees = result.value.data; }
-
- 変更後
-
Copied!
1 2 3 4 5 6const result: Result<Employee[], ListObjectsError> = await client.ontology .objects.Employee.fetchPageWithErrors(); if(isOk(result)){ const employees = result.value.data; }
-
- これは
-
fetchPage- 結果のラッパーを持たないページを返します(
Result<Value,Error>はありません)。 - 該当する場合にエラーをスローするため、
try/catchパターンを好むユーザー向けに追加しました。 - 変更前
-
Copied!
1 2 3 4 5 6const result: Result<Employee[], ListObjectsError> = await client.ontology .objects.Employee.page(); if(isOk(result)){ const employees = result.value.data; }
-
- 変更後
-
Copied!
1 2 3 4 5 6 7 8try{ const result: <Page<Employee>> = await client.ontology .objects.Employee.fetchPage(); const employees = result.data; } catch(e) { console.error(e); }
-
- 結果のラッパーを持たないページを返します(
apiName, primaryKey, rid
__apiName、__primaryKey、__rid プロパティを非推奨にし、$apiName、$primaryKey、$rid プロパティに置き換えます。
All()
all() メソッドを非推奨にし、利便性のために代わりに次のメソッドを追加しました。
-
asyncIter()オブジェクトセットのすべての結果を反復処理できる非同期イテレーターを返します。 -
変更前
Copied!1 2 3 4 5 6const result: Result<Employee[], ListObjectsError> = await client.ontology .objects.Employee.all(); if(isOk(result)){ const employees = result.value.data }
- 変更後
Copied!1const employees: Employee[] = await Array.fromAsync(await client.ontology.objects.Employee.asyncIter());
BulkActions
bulkActions を非推奨にし、batchActions に名前を変更します。REST API名に合わせるために名前を変更しました。
- 変更前
await client.ontology.bulkActions.doAction([...])
- 変更後
await client.ontology.batchActions.doAction([...])
SearchArounds
searchAround{linkApiName} を非推奨にし、次に置き換えます。
-
pivotTo(linkApiName)- 関連検索とまったく同じように動作しますが、結果がピボット先のオブジェクトのタイプであることを、名前でより適切に表します。
-
変更前
await client.ontology.objects.testObject.where(...).searchAroundLinkedObject().page()
- 変更後
await client.ontology.objects.testObject.where(...).pivotTo("linkedObject").fetchPage()
どうすれば試せますか?
更新されたジェネレーターのバージョンがリリースされた後、Developer Console を使ってアプリケーション用の新しい SDK バージョンを作成すると、生成されたバージョンにこれらの機能が含まれます。アプリケーションの依存関係を更新すると、非推奨のメソッドとプロパティには searchAroundLinkedObject() のように取り消し線が表示されますが、コードは引き続き以前と同じように動作します。バージョン2.0では、非推奨のメソッドのサポートを終了します。
新しいバージョンを生成するオプションのドロップダウンリストを使って、ジェネレーターの古いバージョンを使用することもできます。
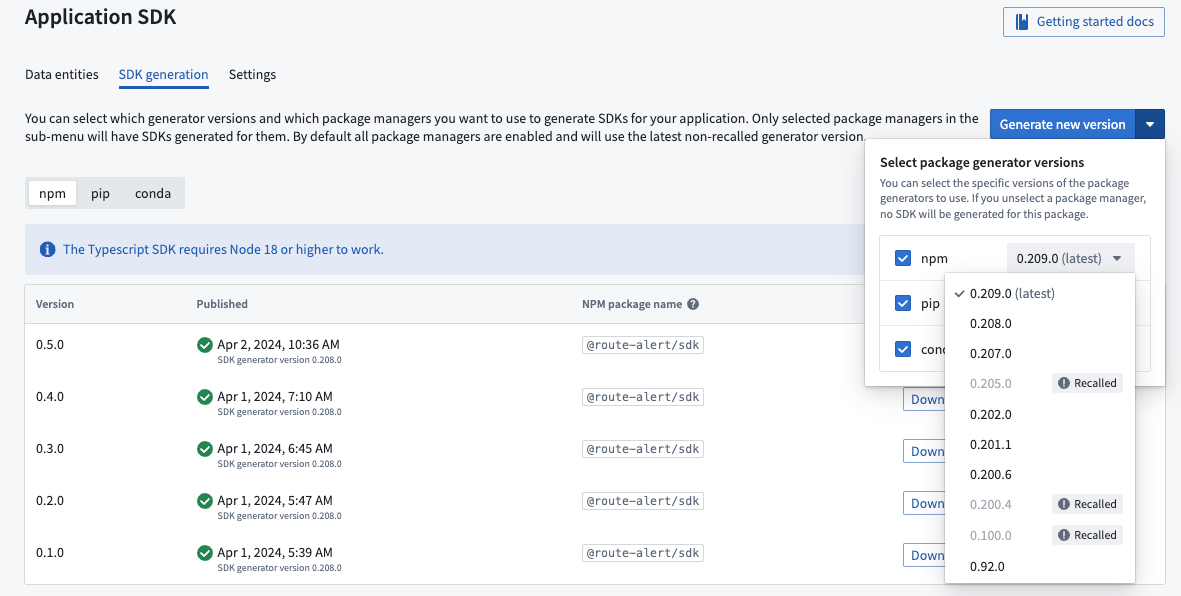
オントロジー SDK TypeScript の今後の予定は?
上記をまとめると、今後のオントロジー SDK TypeScript のバージョンは次のとおりです。
バージョン1.1: このバージョンでは現在の言語構文を維持しますが、今後サポートされなくなる一部のメソッドとプロパティを非推奨にします。
バージョン1.2: 今年後半のリリースを予定しており、新しい言語構文を導入します。
バージョン2.0: 新しい言語構文を一般提供(GA)とし、非推奨のメソッドとプロパティのサポートを終了するとともに、まだ利用できない新しい機能を導入します。
データアクセス用の期限付きグループメンバーシップの一般提供を開始
公開日: 2024-04-11
期限付きグループメンバーシップが、プラットフォームのセキュリティ機能として利用可能になりました。この機能は、ユーザーのデータへのアクセスを制限することで、利用制限や目的の明確化といったデータ保護の原則を支援できます。
メンバーシップの管理権限を持つユーザーは、期間を指定してグループメンバーシップを付与できるようになり、設定に基づいてデータへの一時的なアクセスを許可できます。最新の有効期限または最長期間に基づいてアクセスを設定できます。
- 最新の有効期限: すべての新しいメンバーシップには、この日付より前の有効期限が必要です。
- 最長期間: すべての新しいメンバーシップは、指定された期間内に失効する必要があります。
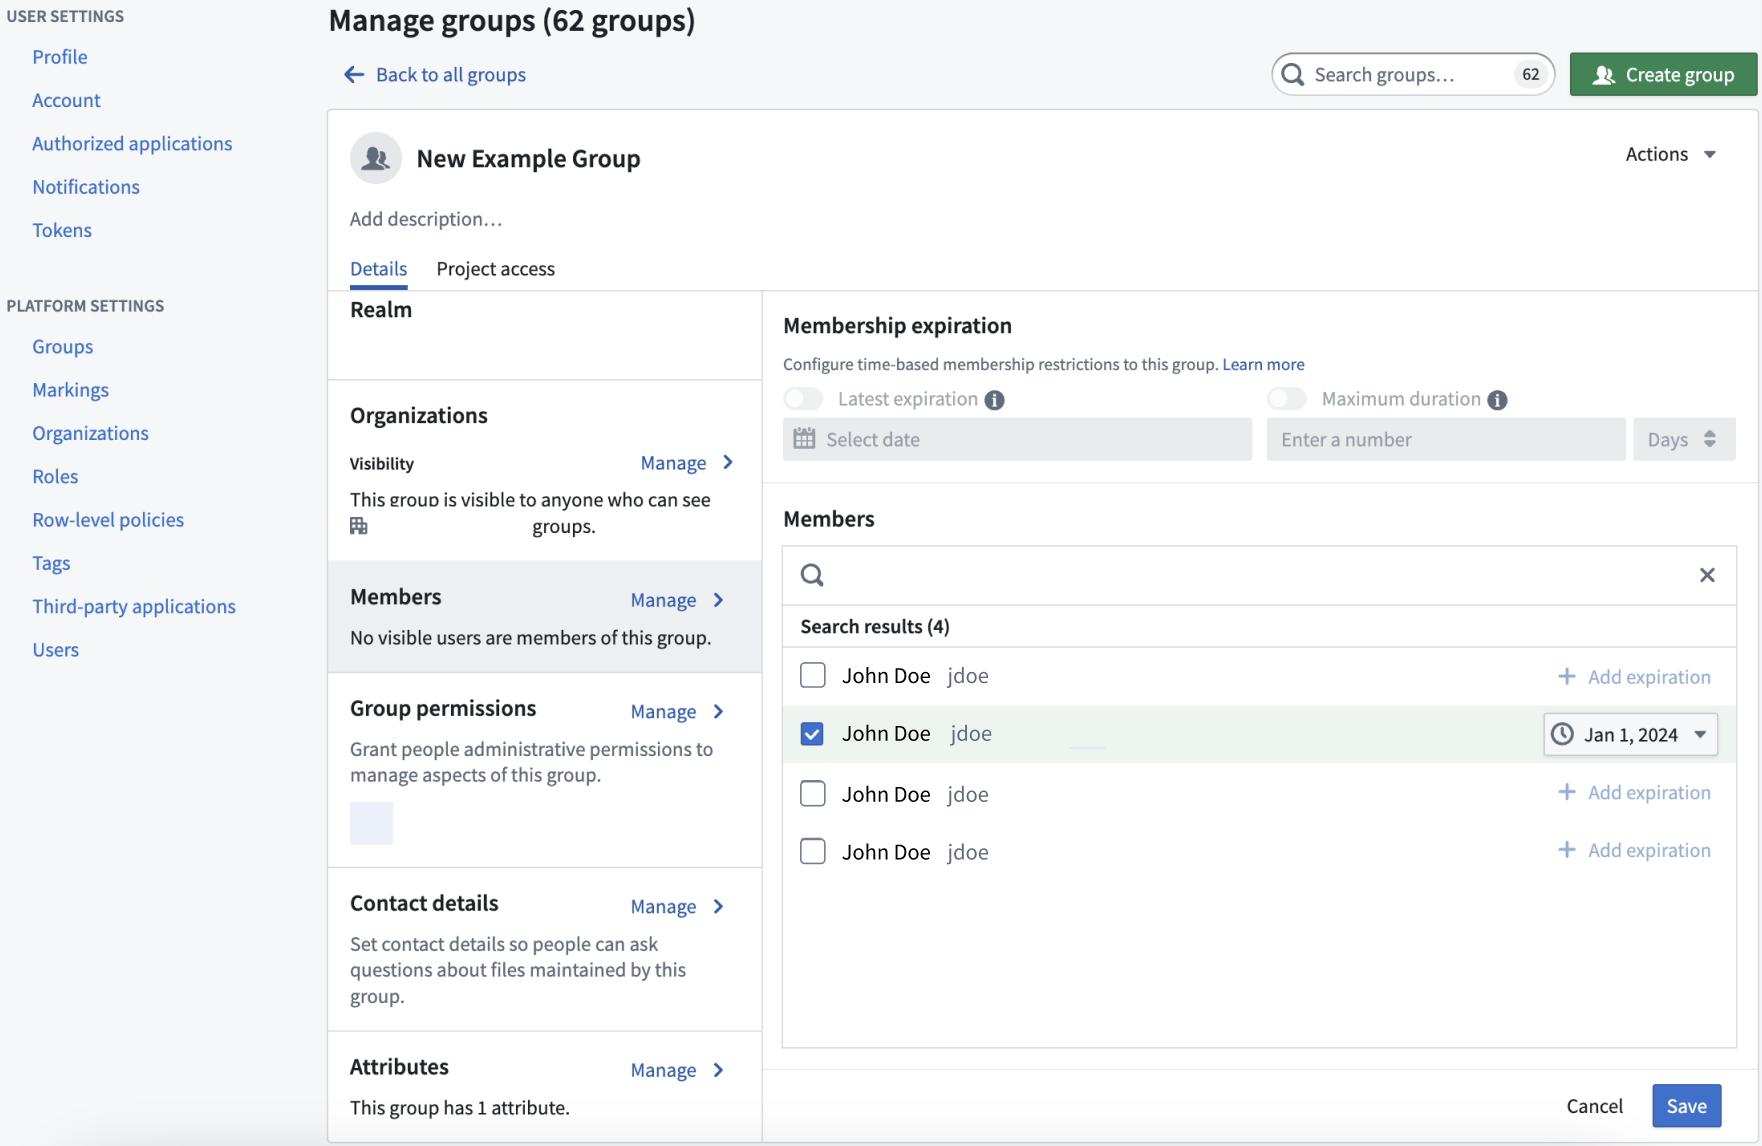
時間制約の設定が表示されたグループ設定ページ。
時間制約が適用されたグループへのメンバーシップのアクセスリクエストは、すべてその制約によって制限されます。
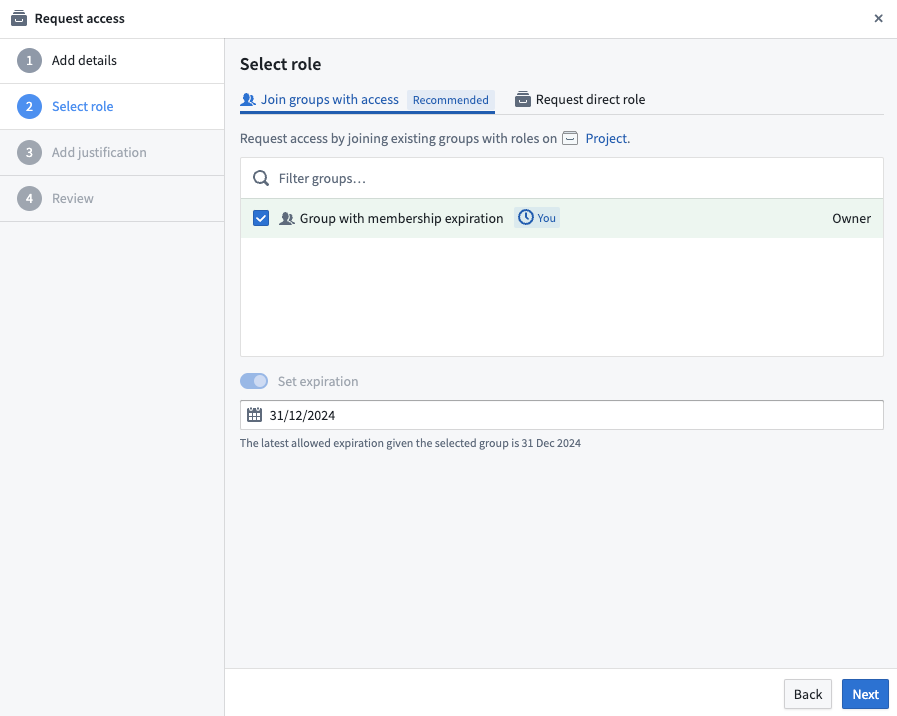
最新の有効期限の制約が31/12/2024に設定されたグループメンバーシップリクエスト。
詳細については、グループを管理する方法のドキュメントを参照してください。
改善された Foundry リソースサイドバーのご紹介
公開日: 2024-04-11
管理ワークフローを効率化し、より容易に発見可能にすることを目的として、デザインを刷新したリソースサイドバーをリリースしました。Palantir Foundry のリソースサイドバーにある右側の概要、アクセス、アクティビティ、使用状況、設定パネルで、新しい外観と構成を体験できます。
何が変わりますか?
- ナビゲーションの改善: 生産性の向上を目指し、すべてのワークフローにより少ないクリック数でアクセスできるよう、入れ子の階層を最小限に抑えました。
- セキュリティモデルのわかりやすさの向上: アクセス要件などのセキュリティガバナンス機能を刷新し、より使いやすく、理解しやすくしました。
- 外観の刷新: よりすっきりとした外観を体験できます。
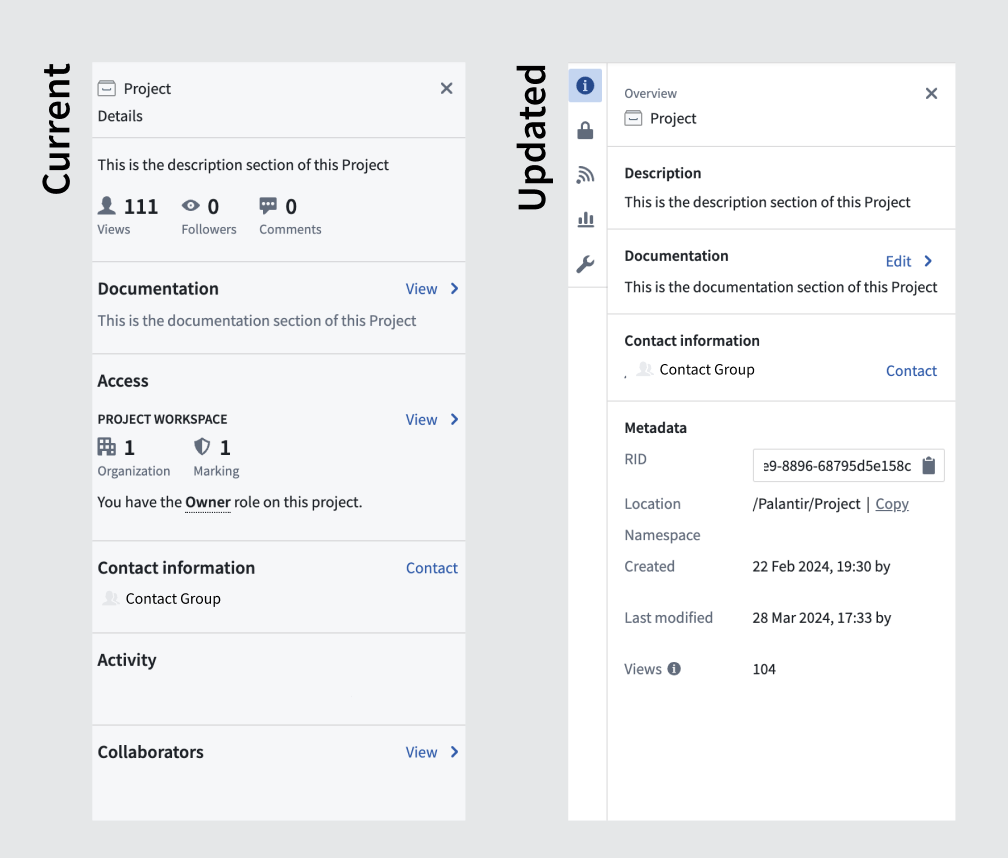
プロジェクト概要ペインの更新されたインターフェース。
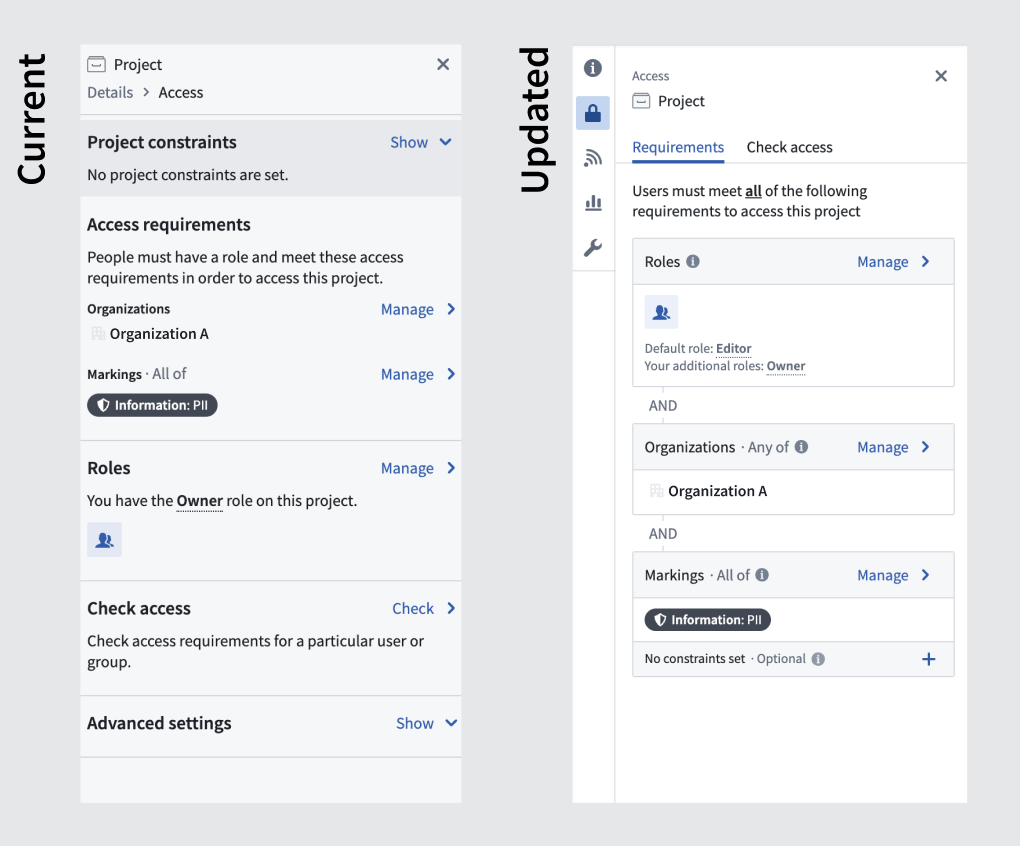
プロジェクトアクセスパネルの更新された外観。
更新されたリソースサイドバーは、既存の機能をすべて維持し、現在のすべてのワークフローを中断することなく引き続きサポートします。
Python コードリポジトリの Natively Accelerated Spark
公開日: 2024-04-11
Pipeline Builder の Natively Accelerated Spark と Python コードリポジトリの Natively Accelerated Spark をご紹介します。これは、バッチジョブのパフォーマンスを向上させ、コストを削減するための機能です。この機能では、低レベルのハードウェア最適化を活用して、データパイプラインの効率を高めることができます。
ネイティブアクセラレーションを使用すると、次のメリットがあります。
- パフォーマンスの高速化: ネイティブアクセラレーションは、
select、filter、partitionなどの一般的な SQL 関数を最適化し、バッチジョブの速度を大幅に向上させます。 - コスト削減: ネイティブアクセラレーションは、パフォーマンスの向上によってバッチジョブの実行に伴うコストの削減にも役立つため、ビッグデータを扱う場合や高いスループットが求められる場合に最適です。
- 詳細な実装ガイド: この機能を設定し、ワークフローに統合するためのガイドが利用可能です。
使用方法と制限事項
ネイティブアクセラレーションは、Pipeline Builder と Python トランスフォーム内で有効にできます。ユーザー定義関数(UDF)や Resilient Distributed Dataset (RDD) の操作を使用するリポジトリでも、この機能によってわずかな効果が得られる場合があります。
ネイティブアクセラレーションは、ビッグデータを扱うワークフローや低遅延が重要なワークフローを使用するデータサイエンティストに特に有益です。頻繁に(5分ごとに)ビルドを実行する場合や、コストに敏感な環境で作業する場合、ネイティブアクセラレーションは強力なソリューションとなります。
ネイティブアクセラレーションの効果を試すには、この機能を有効にしてパイプラインを1回実行するだけです。パフォーマンスの向上が確認できた場合は、そのパイプラインでこの機能を有効にしたままにします。
ネイティブアクセラレーションを有効にする方法
ネイティブアクセラレーションの可能性を最大限に活用するには、Pipeline Builder と Python コードリポジトリの Natively Accelerated Spark に関するドキュメントを確認してください。
Code Workspaces [GA]:JupyterLab® と RStudio® の一般提供を開始
公開日: 2024-04-09
広く知られているツールを使って効果的な探索的分析を行いながら、Palantir Foundry の強力な機能をシームレスに活用できるよう、Code Workspaces を開発しました。一般提供を開始した Code Workspaces は、サードパーティーの IDE である JupyterLab® と RStudio® を Foundry に導入し、ユーザーが生産性を高め、データサイエンスと統計のワークフローを加速できるようにします。Code Workspaces は、比類のない速度と柔軟性を提供することで、包括的な探索的分析を行うための Foundry 内の中心的な拠点となります。
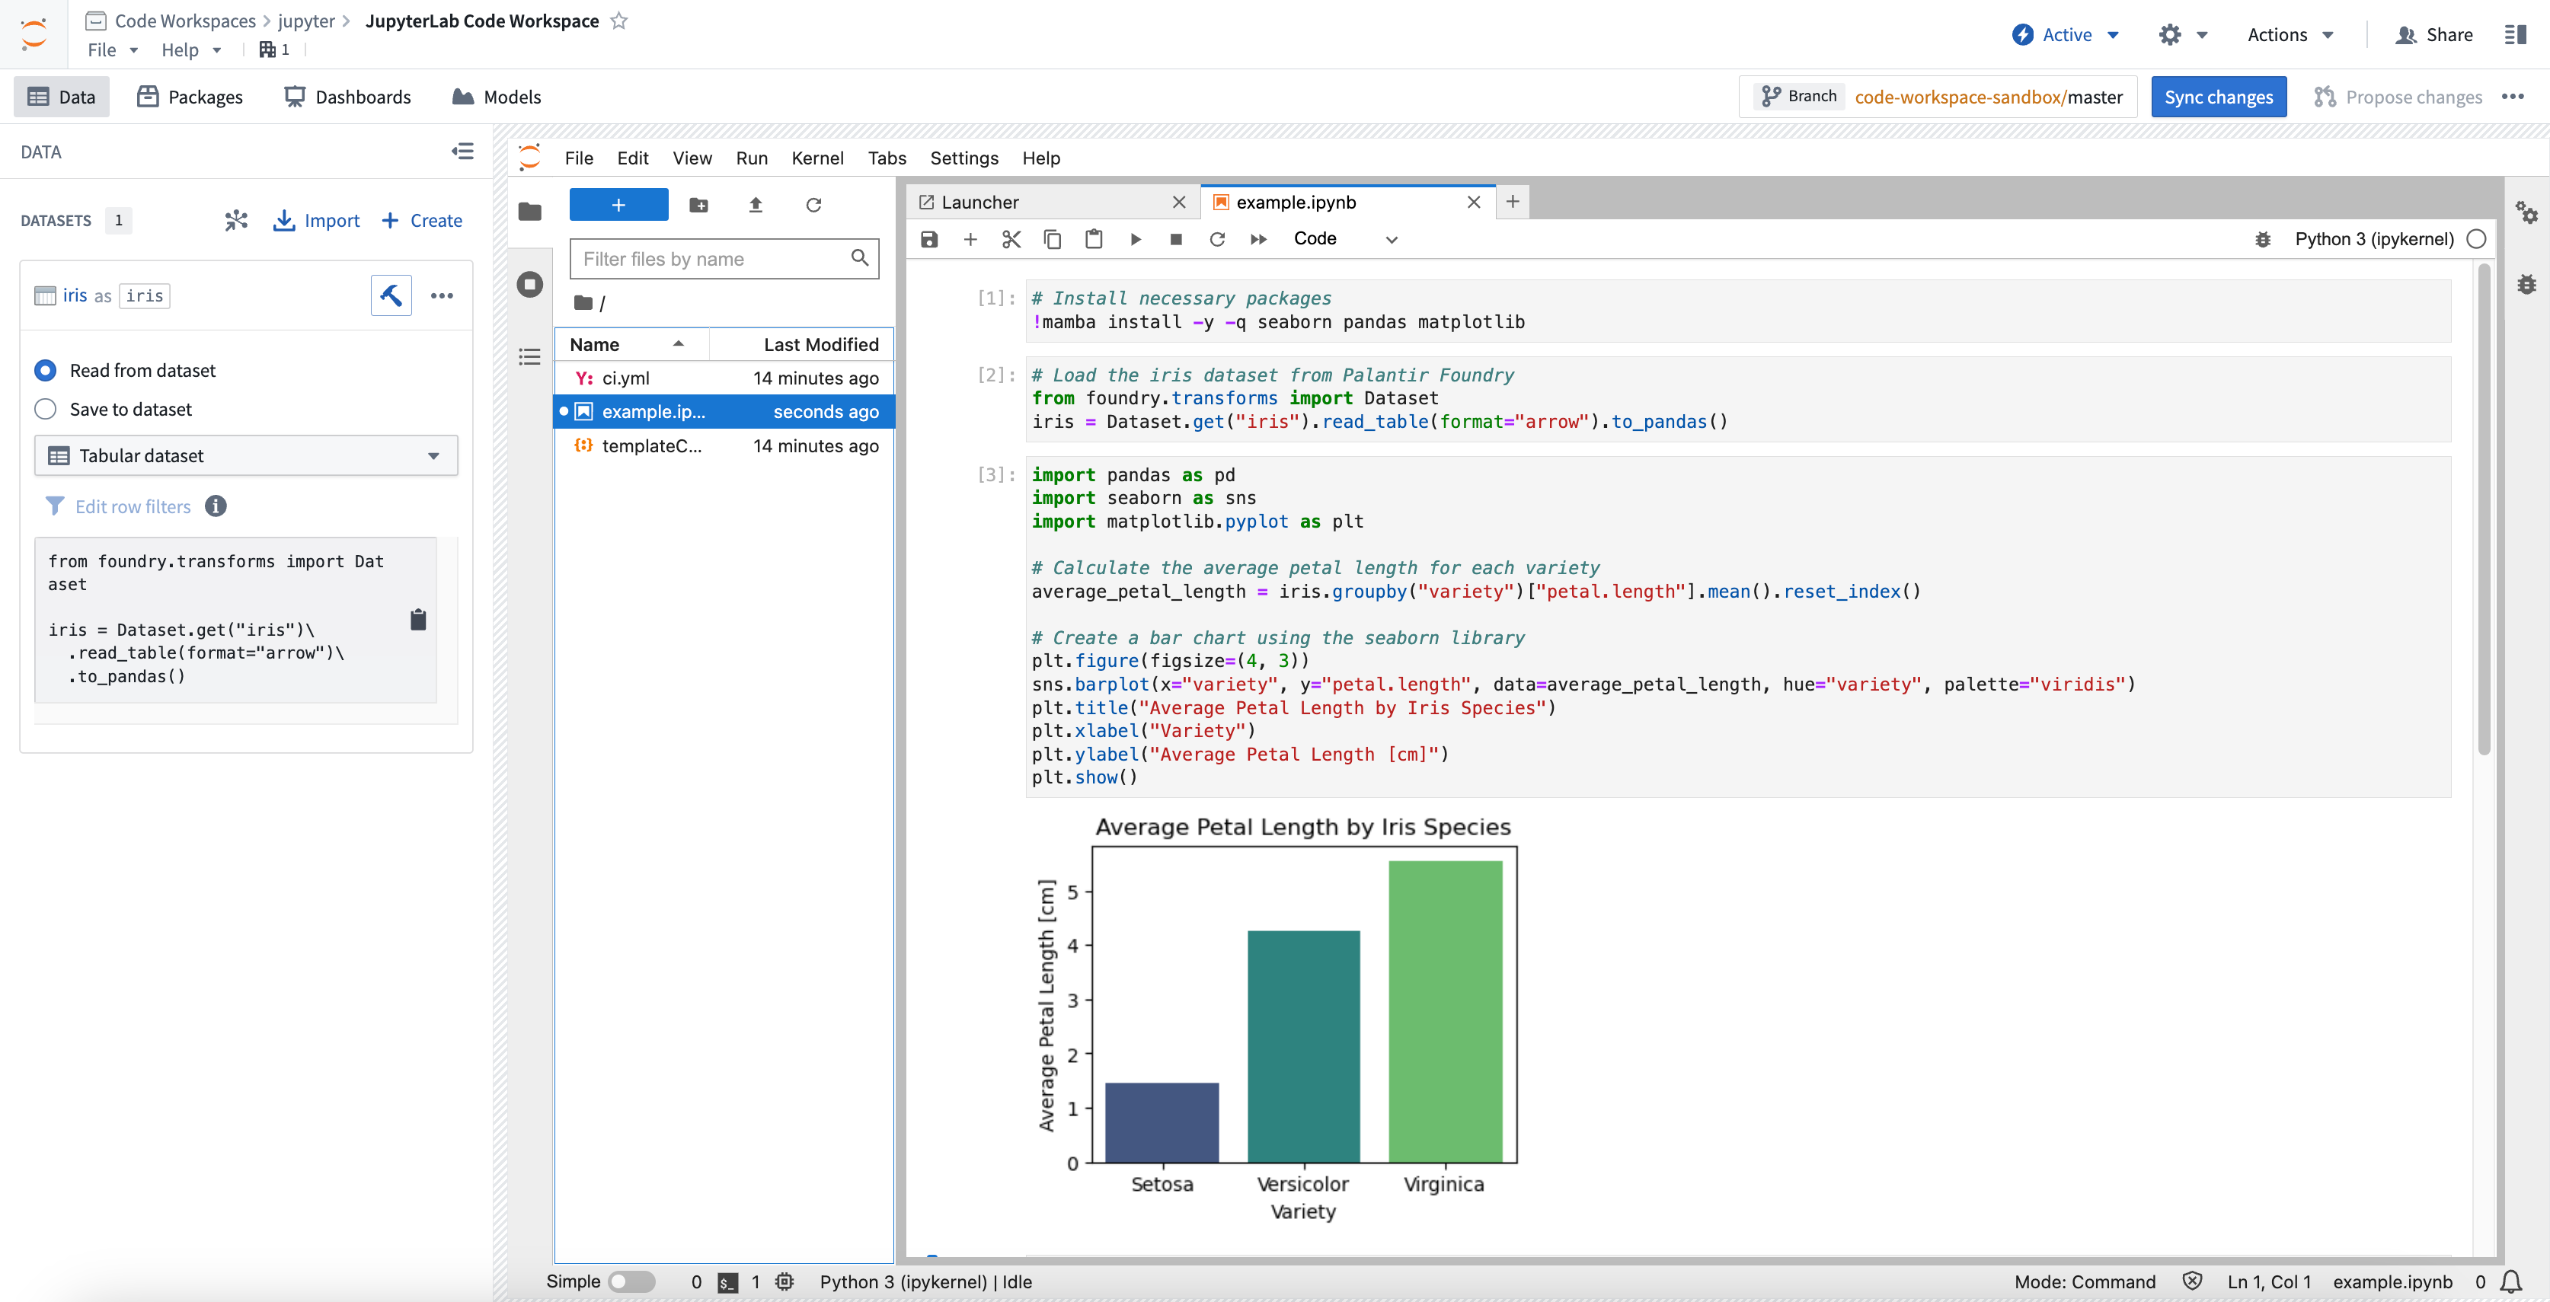
データサイエンスに使用する Jupyter® Code Workspace。
柔軟で効率的な探索的分析
Code Workspaces は、JupyterLab® Notebooks や RStudio® Workbench などの広く使用されているツールと Palantir エコシステムの強力な機能を統合し、Foundry で効率的な探索的分析を行うための定番の場所となります。
まもなく、次の機能を活用できるようになります。
- 広く採用されているデータサイエンスおよび機械学習ツールを使用し、組織のデータ上で RStudio® と Jupyter® をシームレスに統合します。
- セキュリティ、来歴、ガバナンス、データリネージに関する Foundry の世界トップクラスの基本機能を活用しながら、任意のデータセットからデータを読み込みます。
- 対話型のコード開発と書き戻し、即時のフィードバックループ、セル単位の分析によるプレビュー、および REPL ターミナルコマンドを使用します。
- Palantir プラットフォームのほかの部分で利用できるデータ、可視化、レポート、インサイトを加工または生成します。
- 本番環境で使用する前に、機械学習モデルのトレーニング、最適化、実装を効率的に行います。
- Conda、pip、CRAN をサポートする対話型の統合パッケージマネージャーソリューションを使用して、複数の Python 環境と R 環境を完全にカスタマイズします。
- Code Repositories が提供するネイティブな Git バージョン管理と共同作業機能を使用します。
- 対話型の Dash、Streamlit®、Shiny® ダッシュボードを作成し、同僚と分析を共有して意思決定を促進します。
- 処理するデータの規模に合わせて、コンピューティング設定を完全にカスタマイズします。
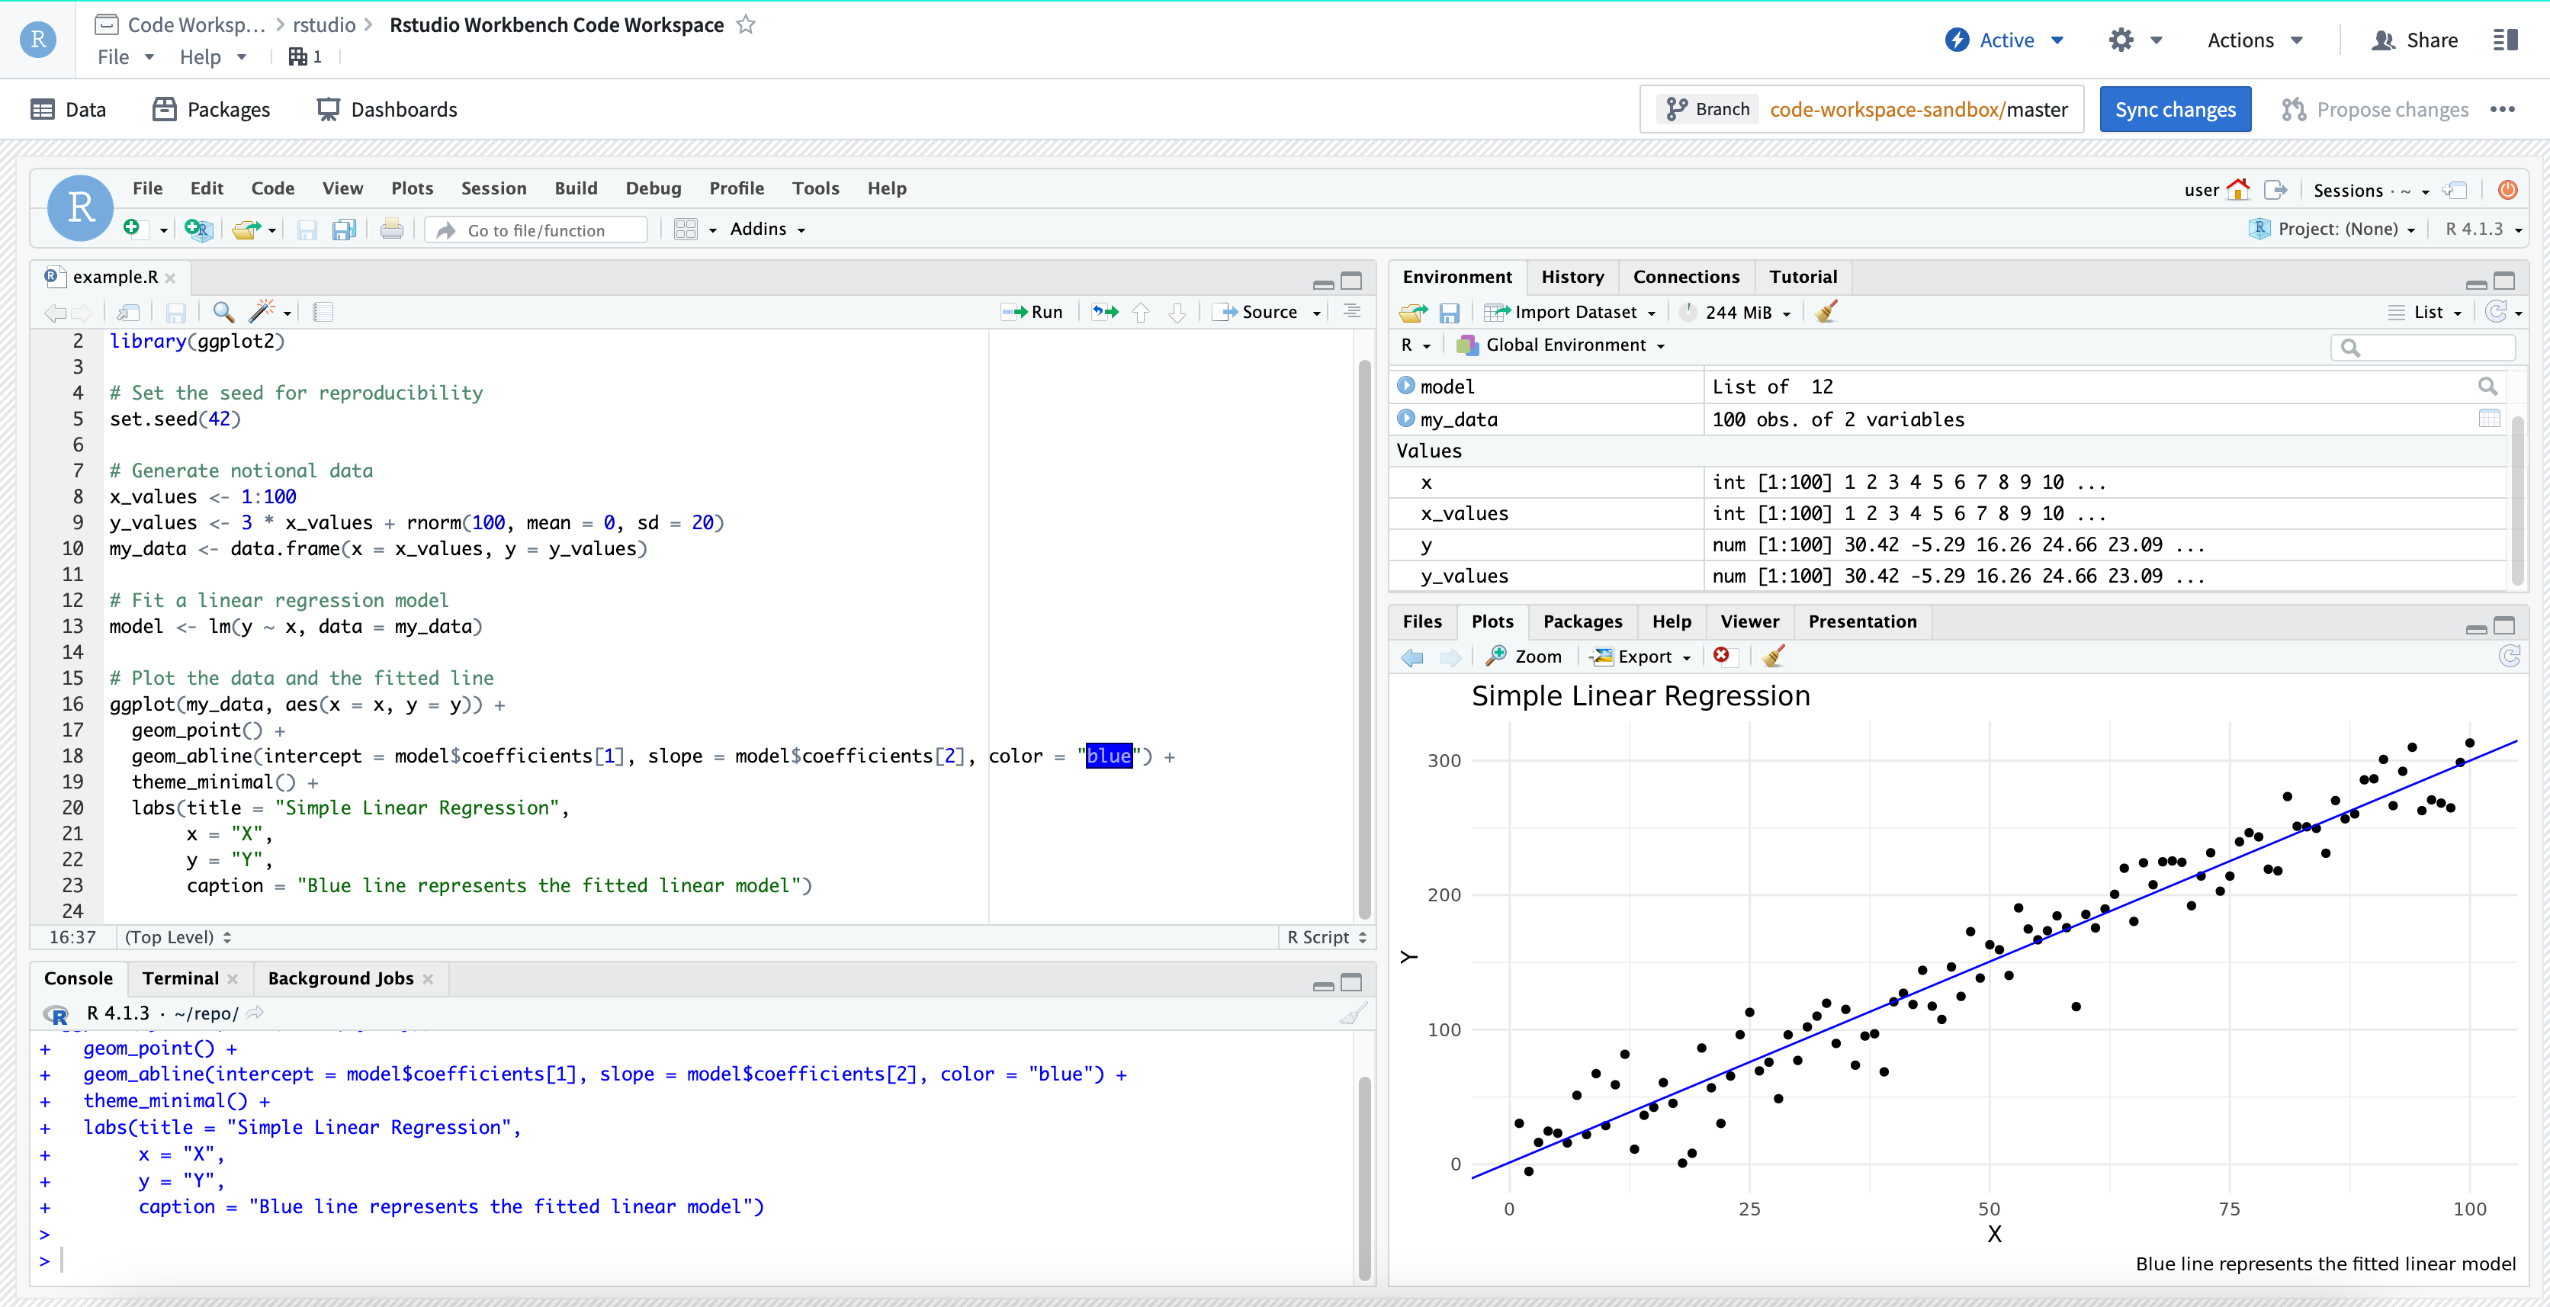
機械学習のトレーニングに使用する RStudio® Code Workspace。
Code Workspaces はどのような場合に使用すべきですか?
Code Workspaces は、データに対して迅速かつ効率的な反復分析を行うための包括的なツールを提供し、サードパーティーツールの優れた機能と Palantir の豊富な組み込みデータ分析機能をシームレスに統合します。データの可視化、プロトタイピング、レポート作成、反復的なデータ加工に使用できます。Code Repositories と Pipeline Builder を使用すると、これらのデータ加工を堅牢な本番パイプラインに変換できます。
ほとんどのワークフローでは、Code Workspaces とほかの Foundry ツールは相互に補完し合います。どのパイプラインの出力も Code Workspaces の分析への入力として使用でき、その逆も可能です。Code Repositories と Code Workspaces は、どちらも同じ Git バージョン管理システムを使用します。大規模な R パイプライン、モデルトレーニング、広範な可視化ワークフローを Code Workbook にエクスポートして、その分散 Spark アーキテクチャを活用することもできます。
成果をもたらす実際のユースケース
以下は、Code Workspaces を活用する数多くの実際のユースケースの一部です。
- 大手保険販売会社が、保険料設定モデルの微調整に Code Workspaces を使用しています。
- 医療機関が、Code Workspaces の Streamlit ダッシュボードを使用し、コンピューター処理に不慣れな生物学者でも多重免疫蛍光データの空間分析を行えるようにしています。
- 小売企業が、Jupyter® Code Workspaces を使用して売上データの探索的分析を行い、予測モデルを開発しています。
- 製薬会社が、RStudio® Code Workspaces を使用して、薬剤試験の有効性を詳述した完全に再現可能なラボレポートを生成しています。
Code Workspaces でできることの詳細については、関連ドキュメントを確認してください。
開発ロードマップには何がありますか?
現在、以下の機能を積極的に開発しています。
- Code Workspaces トランスフォーム: JupyterLab® Notebook または RStudio® の R スクリプトの内容を、Palantir の堅牢なビルドインフラストラクチャを活用して、再現可能なパイプラインとして保存します。
- Palantir 管理モデルとの統合: Foundry のほかの場所で開発されたモデルを読み込んで使用します。
- AIP 統合: Code Workspaces から直接、AIP がサポートする任意の言語モデルを呼び出します。
- オントロジーのサポート: オントロジーの強力な機能を最大限に活用し、オブジェクトを Code Workspaces に読み込んで探索的分析を行います。
- 本格的なレポート作成ソリューション: データ分析を、組織全体の意思決定に役立つ共有可能なレポートに変換します。
Jupyter®、JupyterLab®、および Jupyter® のロゴは、NumFOCUS の商標または登録商標です。 RStudio® および Shiny® は、Posit™ の商標です。 Streamlit® は、Snowflake Inc. の商標です。
記載されているすべてのサードパーティーの商標(ロゴおよびアイコンを含む)は、それぞれの所有者に帰属します。提携関係や推奨を示唆するものではありません。
Pipeline Builder がパイプラインでの大規模な LLM 実行に対応
公開日: 2024-04-04
Pipeline Builder の新しい最先端機能、LLM を使用ノードをリリースしました。この機能により、数回の簡単なクリックで、大規模言語モデル(LLM)の能力を本番パイプラインに手軽に組み込めます。
LLM の機能を本番パイプラインに統合することは、従来、複雑な課題でした。そのため、ユーザーはデータ処理の要件を満たす、シームレスでスケーラブルなソリューションを探す必要がありました。このソリューションは、次の機能を提供することで、これらの課題に対処します。
- LLM 処理の本番運用の保証: 多くの LLM のユースケースは基礎となるデータのみを使用し、ユーザーによる反復的な入力を必要としません。Pipeline Builder が提供する分岐やビルドの監視などの本番パイプライン機能を活用して、Pipeline Builder 内で直接データを処理し、そのデータに対して LLM モデルを実行することで、時間を節約できます。
- デプロイ前に複数の行でプレビュー: ユーザーは、入力データの数行で試行し、プロンプトを繰り返し調整してから、完全なビルドを実行できます。プレビューの計算はわずか数秒で完了するため、フィードバックループが大幅に加速します。
- 事前に設計されたプロンプトテンプレート: 経験豊富なチームが提供するプロンプトエンジニアリングの専門知識を活用できます。これらのテンプレートはすぐに使える出発点となり、ユーザーがプロジェクトを迅速に開始できるようにします。
プロジェクトをすぐに始められる、初心者向けの5つのプロンプトテンプレート
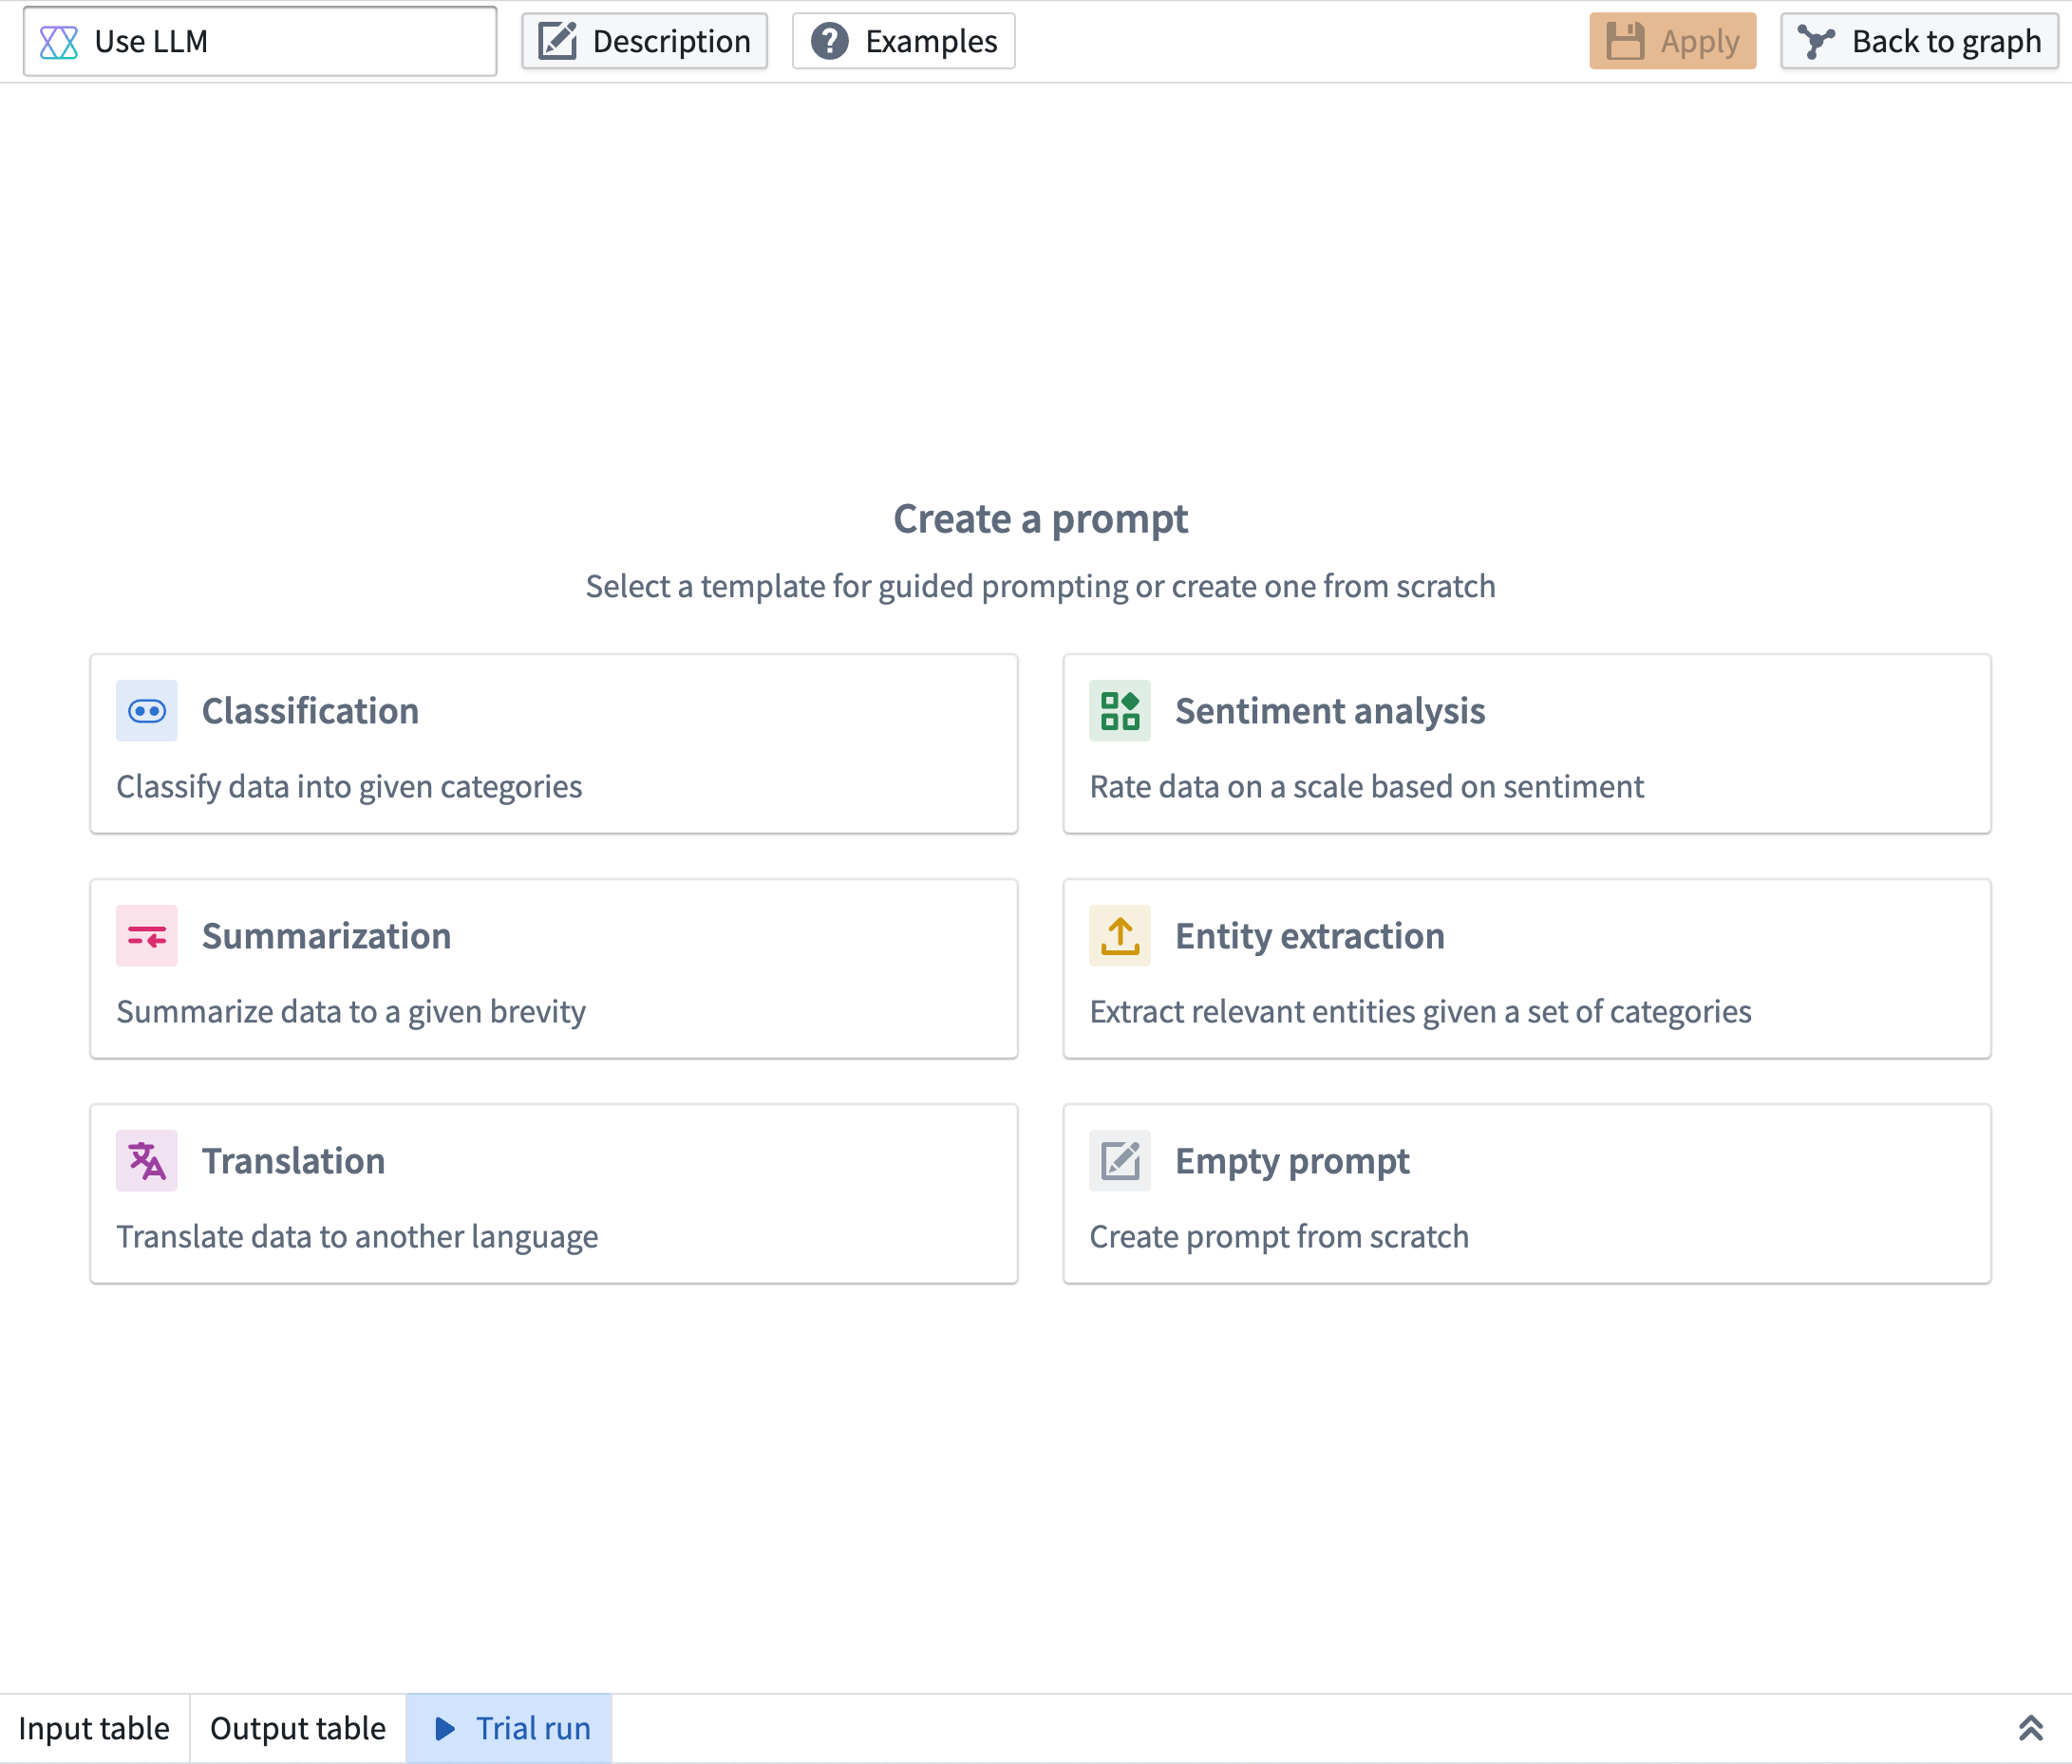
ガイド付きプロンプトを5つ追加する様子を示す Pipeline Builder のインターフェース。
- 分類: LLM を使用して、データを指定されたカテゴリーに分類します。以下の例では、レストランのレビューを料理、サービス、雰囲気の3つのカテゴリーに分類しています。モデルは、各レビューをこれらのカテゴリーの1つ以上に分類します。
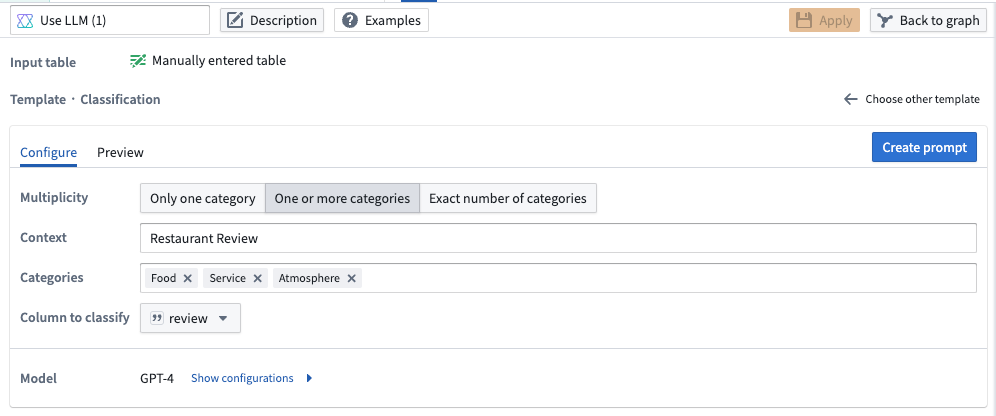
レストランのレビューを3つのカテゴリーに分類するプロンプトを示す Pipeline Builder のインターフェース。
- センチメント分析: LLM を使用して、データのポジティブまたはネガティブなセンチメントを尺度に基づいて評価します。以下の例では、レストランのレビューのポジティブまたはネガティブなセンチメントを、0(最もネガティブ)から5(最もポジティブ)の尺度で評価します。
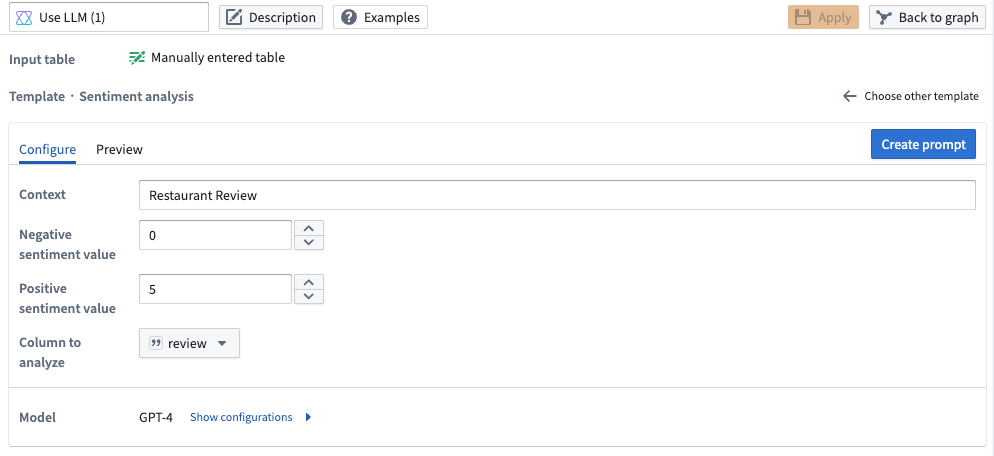
レストランのレビューのポジティブまたはネガティブなセンチメントを評価するプロンプトを示す Pipeline Builder のインターフェース。
- 要約: LLM を使用して、データを指定された長さに要約します。以下の例では、レストランのレビューを1文に要約しています。
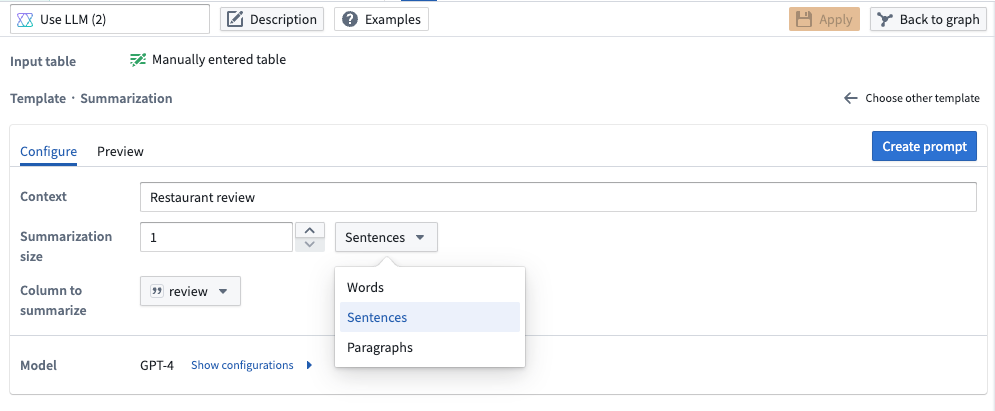
レストランのレビューを指定の長さに要約するプロンプトを示す Pipeline Builder のインターフェース。
- エンティティ抽出: LLM を使用して、指定されたカテゴリーに関連する要素を抽出します。以下の例では、各レストランのレビューから食べ物や飲み物の要素を抽出します。
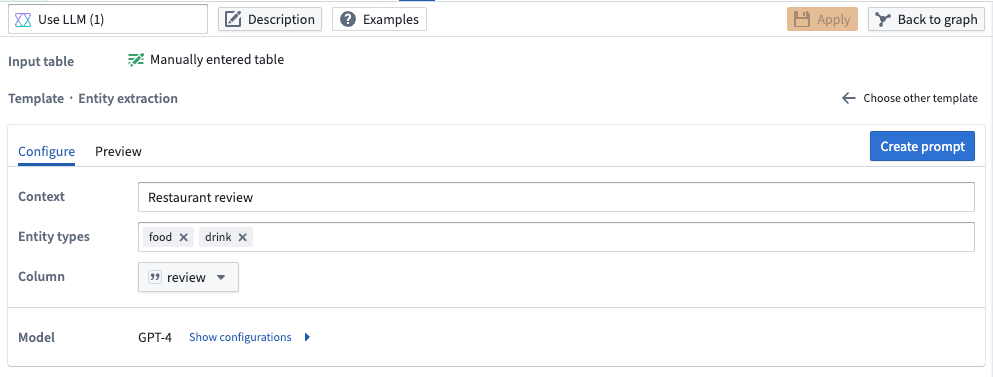
各レストランのレビューから食べ物や飲み物の要素を抽出するプロンプトを示す Pipeline Builder のインターフェース。
- 翻訳: LLM を使用して、データを別の言語に翻訳します。以下の例では、レストランのレビューをスペイン語に翻訳しています。
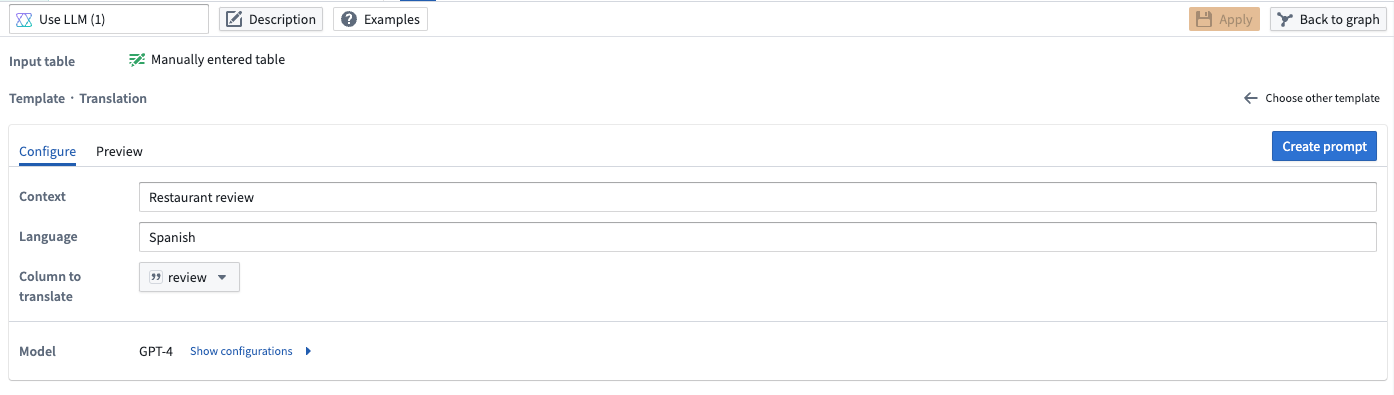
レストランのレビューをスペイン語に翻訳するプロンプトを示す Pipeline Builder のインターフェース。
独自の LLM プロンプトをカスタマイズする
独自の LLM プロンプトを作成して、特定の要件に合わせてモデルを調整します。
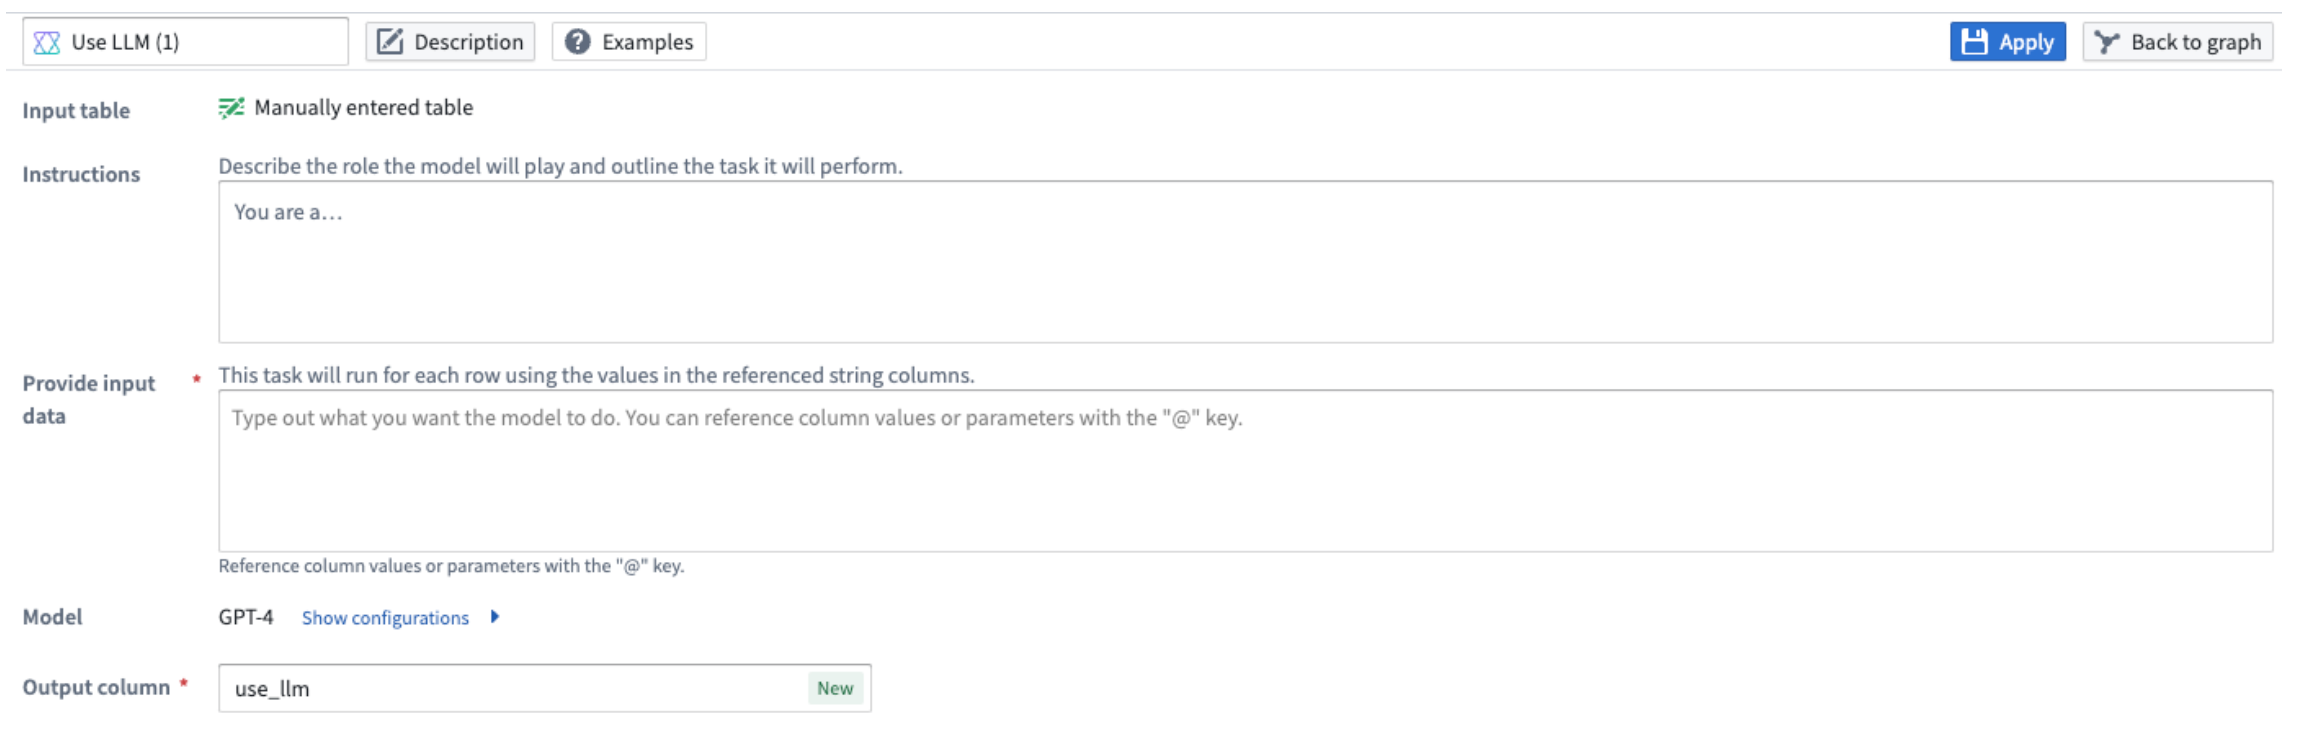
カスタムプロンプトを示す Pipeline Builder のインターフェース。
新しい Pipeline Builder の LLM ノードの使用方法については、ドキュメントを参照してください。
Workshop のモジュールインターフェースのご紹介
公開日: 2024-04-02
Workshop では、「昇格した変数」の名称を「モジュールインターフェース」に変更しました。モジュールインターフェースは、埋め込み時に親モジュールの変数にマッピングでき、URL から初期化できる変数です。モジュールインターフェースは、Workshop モジュールの API と考えることができます。
モジュールインターフェースに変数を追加するには、変数の設定パネルに移動し、外部 ID を追加して、モジュールインターフェースのトグルが有効になっていることを確認します。必要に応じて、モジュールインターフェースの変数に表示名と説明を設定できます。これらは、モジュールが埋め込まれたとき、または Workshop モジュールを開くイベントで使用されたときに表示されます。
昇格した変数からモジュールインターフェースへの移行に伴う機能の変更はごくわずかです。詳細は以下のとおりです。
モジュールインターフェースの値をプレビューする
Workshop モジュールの概要タブで、モジュールインターフェースの全体を確認できるようになりました。また、インターフェース変数に固定のオーバーライド値をプレビュー用に設定する新しい機能も追加されました。
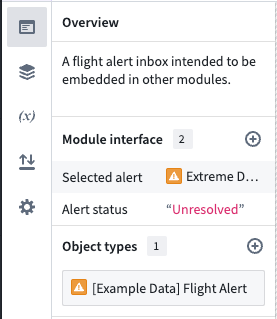
Workshop エディターの概要パネルに追加された、モジュールインターフェースの概要セクション。
変数の設定パネル
新しく追加された変数の設定パネルを使用して、モジュールインターフェースに変数を追加できます。設定パネルでは、モジュールインターフェースの変数に表示名と説明を設定できます。これにより、モジュールを埋め込む場合や Workshop モジュールを開くイベントを設定する場合など、別のモジュールからモジュールインターフェースを通じて渡す変数を、より使いやすい環境で設定できます。さらに、状態の保存とルーティングの機能を個別に有効にできるようになり、モジュールインターフェースをより柔軟に制御できます。
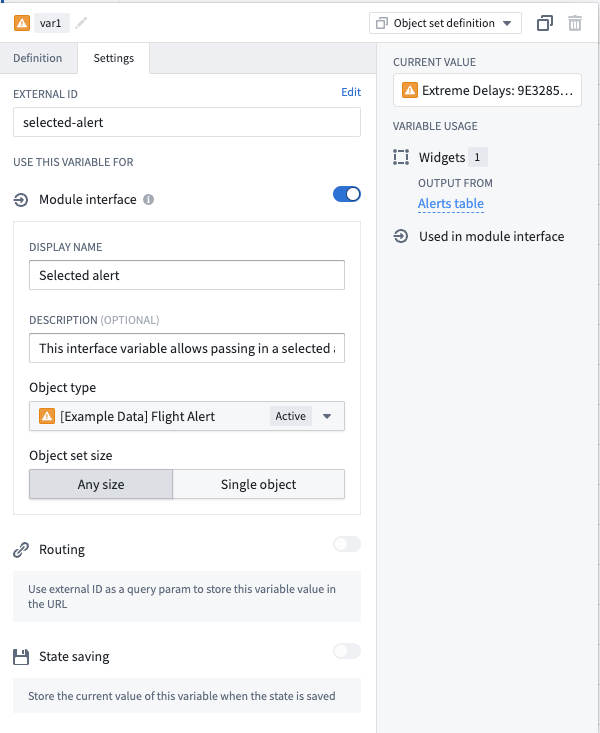
モジュールインターフェースで使用するように設定されたオブジェクトセット変数を示す、変数の設定パネル。
モジュールインターフェースと、これらの変数を使って Workshop のさまざまな機能を有効にする方法について、詳しくはこちら。
新しい Object View のタブは Workshop のみで作成されるようになりました
公開日: 2024-04-02
Object View の新規タブのコンテンツを作成するアプリケーションビルダーは、Workshop のみになりました。レガシーのアプリケーションビルダーを使用して作成された既存の Object View タブは引き続きサポートされますが、この種類のタブを新規作成することはできなくなりました。
Workshop で作成することで、より柔軟なレイアウトオプション、より強力なウィジェットや可視化、アクションによる設定可能なデータ編集を利用できます。新しいタブを作成すると、そのタブの基盤となる新しい Workshop モジュールが自動的に生成されるようになりました。新しいオブジェクトタイプを作成すると、Workshop を基盤とした、よりシンプルなデフォルトの Object View も作成されます。この Object View には、オブジェクトのプロパティとリンクを表示する1個のタブが含まれます。
また、タブ追加の横にある ▼ ドロップダウンメニューを使用して、既存のモジュールを埋め込み、Object View として使用することもできます。
Workshop で Object View を作成する際の操作性について、最近行われた改善には次のものがあります。
- プロパティリストウィジェットの改善。インライン編集のサポート、ワンクリックでの値のコピー、時間依存プロパティのサポート、値の折り返しなどが含まれます。
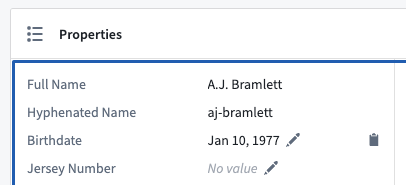
インライン編集とワンクリックでの値のコピー。
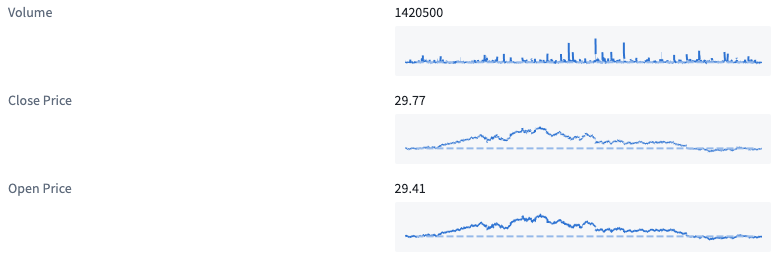
時間依存プロパティ。
- Objects Storage V1 を使用するオブジェクトタイプ向けの、新しいオブジェクト編集履歴ウィジェット。
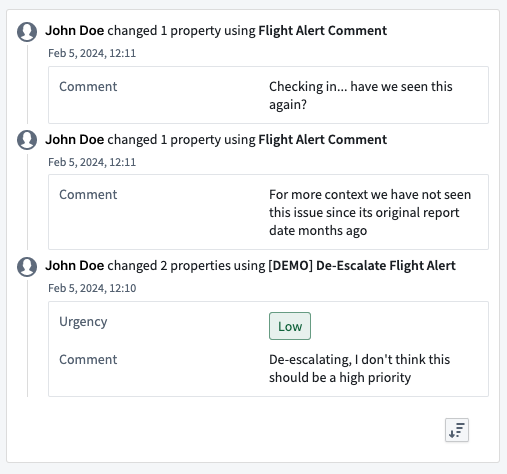
オブジェクト編集履歴を一目で確認。
- Workshop 内で直接 Object View モジュールの名前を変更し、Object View を公開する機能。
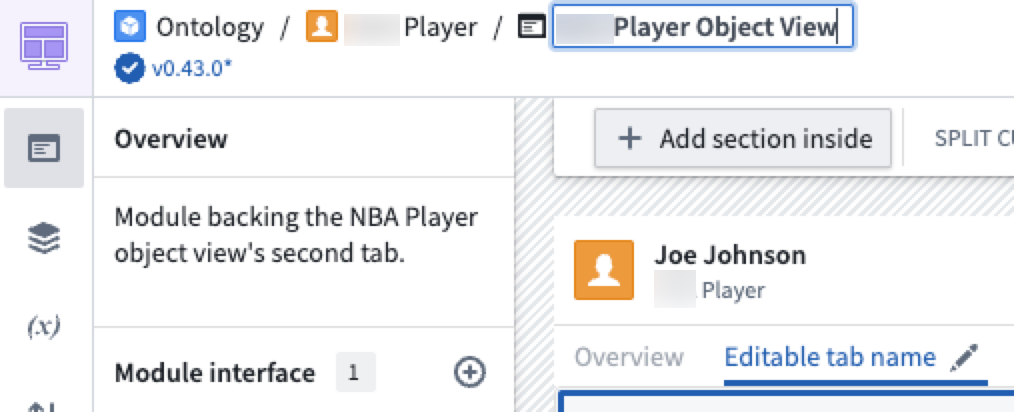
Workshop 内で編集可能なモジュール名と Object View のタブ名。
Object View の編集については、タブを設定するドキュメントを参照してください。
その他の注目事項
管理 | Upgrade Assistant
Upgrade Assistant および関連リソースにメンテナンスオペレーターの連絡先情報を掲載 | Palantir Foundry で必要なアップグレードを実施する際に、メンテナンスオペレーターとエンドユーザーが円滑かつ効率的に作業できるよう、取り組みを進めています。その第一歩として、プラットフォーム全体でメンテナンスオペレーターのロールがより明確に表示されるようになります。ユーザーは、Upgrade Assistant やアップグレードに関する通知、そのほかの関連箇所で、所属組織のメンテナンスオペレーターを確認できるようになります。アップグレードに対応が必要な場合、ユーザーはメンテナンスオペレーターを簡単に特定し、説明やガイダンスが必要なときに速やかに連絡できるようになりました。
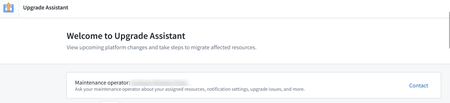
分析 | Code Workspaces
データセットエイリアスのブランチをピン留め | Code Workspaces のデータセットエイリアスマッピングを特定のブランチにピン留めして、データセットの指定したブランチのデータを使用できるようになりました。この変更に伴い、同じデータセットを2回以上インポートすることも可能になり、同じデータセットの複数のブランチからデータを使用できます。この機能を使用するには、インポートしたデータセットのコンテキストメニューを開き、データセットのブランチをピン留めを選択します。ピン留めする特定のブランチを選択するか、推奨を選択してデフォルトの動作に戻します。
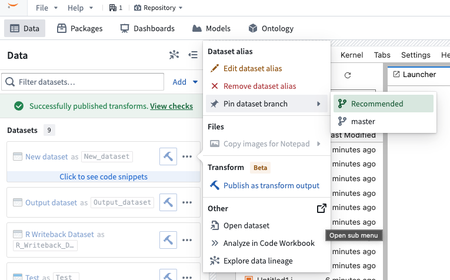
分析 | Notepad
Notepad でメディアセットのリンクを円滑に変換 | Notepad にメディアセットのリンクを埋め込むと、直感的にリソースリンクに変換されるようになり、メディアセットへの接続がより簡単になりました。
分析 | Quiver
実体化の結合エディターでオブジェクト由来のデータセットの一致条件を自動補完 | 実体化の結合エディターで、オブジェクトセットから派生したデータセットの自動補完機能が利用可能になりました。結合の左側と右側の両方が変換済みのオブジェクトセットの場合、エディターは主キー列と外部キー列を使用して結合条件の自動補完を試みます。自動補完ロジックは、どちらか一方が変更されるたびに実行されます。どちらか一方がオブジェクトセットでない場合、設定は変更されません。両側がオブジェクトタイプであってもリンクがない場合、一致条件は未定義になります。入力は直接変換されたオブジェクトセットである必要があります。以前に実体化に変換されたオブジェクトセットは検出されないことに注意してください。
アプリ構築 | オントロジー SDK
オントロジー SDK のリソース処理を改善 | オントロジー SDK のアプリケーションリソース管理の仕組みが改善され、リソースの追加や削除時に依存関係が自動的に考慮されるようになりました。新しいアラート機能は、リソースを除外する際に発生する可能性がある問題について開発者に注意を促し、リソースを保持してアプリケーションの中断を防ぐオプションを提供します。この改善により、SDK の更新時の移行が円滑になり、OAuth & Scopes インターフェースから古いリソースを簡単に削除できます。
アプリ構築 | Workshop
ガントチャートウィジェットでタイミングのオプションを拡充 | ガントチャートウィジェットがアップグレードされ、オブジェクトに対する関数(FoO)を元にしたカスタムタイミングに対応しました。これにより、ガントチャートをより柔軟に視覚化できます。これまで、ガントチャートウィジェットではイベントのタイミングを決めるためにプロパティのみを使用できました。
Workshop の変換機能を拡充 | Workshop の変数変換で、日付からタイムスタンプ、タイムスタンプから日付、文字列から数値への変換など、追加のデータ型変換がサポートされ、より柔軟にデータを操作できるようになりました。
エクスポートボタンのイベントで列名の変更を有効化 | Workshop で CSV 形式やクリップボードへのエクスポートを設定する際に、プロパティの列名をカスタマイズできるようになりました。この更新により、エクスポートするデータの整理やラベル付けをさらに細かくカスタマイズできます。
データ統合 | Code Repositories
データ統合 | Pipeline Builder
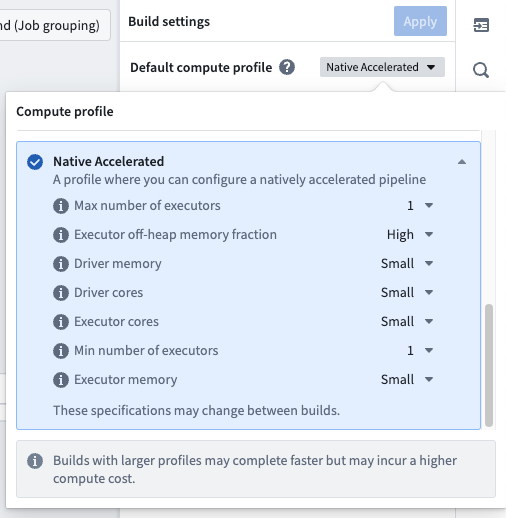
Pipeline Builder のバッチ処理を高速化 | Pipeline Builder がネイティブ高速化パイプラインをサポートするようになり、バッチ処理のパフォーマンスが大幅に向上しました。ネイティブ高速化の管理の詳細については、更新されたドキュメントを参照してください。
Pipeline Builder のデータセットと時系列のラベル付けを改善 | Pipeline Builder で、グラフのコンテキストメニューから入力データセットおよび構築した出力データセットの名前を直接変更できるようになりました。この改善は、構築した時系列同期の名前変更にも適用され、同じコンテキストメニューのインタラクションから利用できます。
Dev Ops | Marketplace
Marketplace の掲載項目のサムネイルをカスタマイズ可能に | Marketplace が改善され、DevOps アプリケーション内で製品のバージョンごとにサムネイルをカスタマイズできるようになりました。これにより、Marketplace Discovery ページでより視覚的に魅力のある表示が可能になります。サムネイルが指定されていない場合は、製品カテゴリーに対応するデフォルトの画像が代わりに表示されます。
モデル統合 | AIP Logic
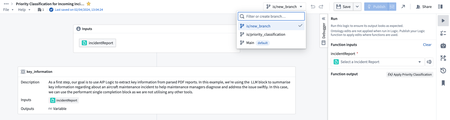
AIP Logic にブランチ機能が登場 | AIP Logic がブランチに対応し、共同作業での編集をより効率的に管理できるようになりました。ユーザーは新しいブランチを作成して変更を保存し、試行を終えたら変更をメインバージョンにマージできるようになりました。
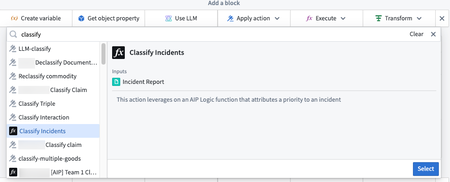
新しい Apply Action ブロックでパラメーターを正確に制御 | AIP Logic の新しい Apply Action ブロックにより、ユーザーは LLM ブロックを経由せずに、パラメーターを正確に設定してアクションを呼び出せます。このブロックにより、パラメーターの入力方法を正確に制御でき、実行も高速化されます。
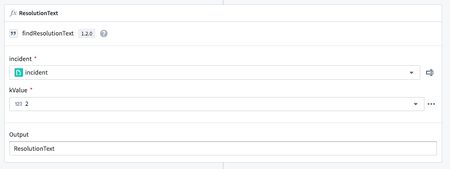
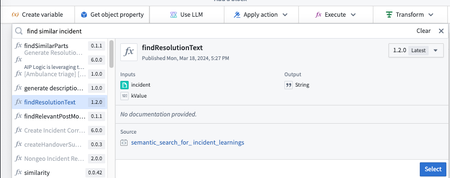
AIP Logic の関数実行を効率化 | Execute ブロックを通じて、AIP Logic 内で関数を決定論的に使用できるようになりました。この改善により、データを正確に読み込み、LLM ブロックに渡したり、Transforms ブロックと併用したりできます。たとえば、Execute ブロックを通じてセマンティック検索関数の出力を活用し、類似したインシデントから解決に関するテキストを取得しやすくできます。
モデル統合 | Modeling
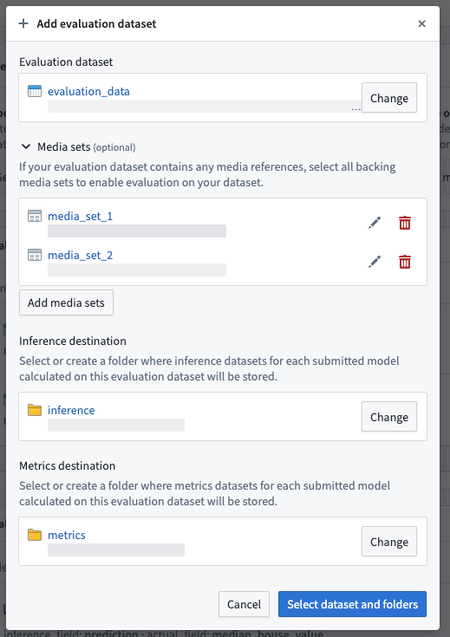
メディアセットの直接統合で評価の設定を効率化 | Modeling の評価設定ワークフローに、メディアセットを直接統合できるようになりました。新しいメディアセット統合機能は、データセットを選択すると利用可能な選択肢を自動的に表示します。これにより、評価の設定プロセスが簡素化され、適切なメディアセットを簡単に含められます。
オントロジー | Object Storage v2
Object Storage v2 のインデックス化の優先順位付けを改善 | Object Storage v2 のキューイングロジックが改善され、特に大きなシャードのインデックス化タスクをより効率的に処理できるようになりました。これにより、メタデータ更新の待ち時間が短縮され、システム全体のパフォーマンスが向上します。
オントロジー | オントロジー管理
Ontology Manager でアクションタイプを最新の関数バージョンに更新 | 関数ベースのアクションを、その基盤となる関数の最新バージョンを使用するよう一括更新できるようになりました。この機能は、Ontology Manager のアクションタイプタブから利用できます。アクションタイプを Functionの実行ルールがあるものに絞り込み、更新するアクションタイプを選択してから、関数バージョンを更新を選択します。
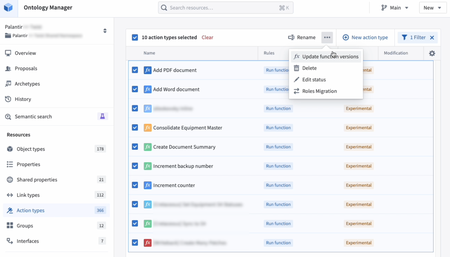
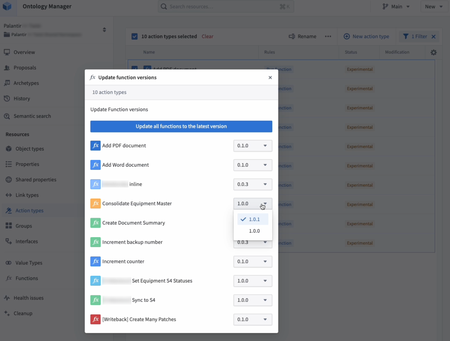
Ontology Manager での関数バージョンの一括管理を強化 | Ontology Manager に、複数の関数バージョンを同時に管理するための機能が強化されました。さまざまなアクションタイプの関数バージョン参照を効率的に一括更新し、全体で最新の機能を使用できるようになりました。サーバーのパフォーマンスを最適化するため、1回の操作で更新できるアクションタイプは50個までに制限されています。なお、大規模関数にリンクされたアクションタイプは一括更新の対象外です。
Ontology Manager でのエイリアス作成を改善 | Ontology Manager がアップグレードされ、オブジェクトタイプに別名(エイリアス)を設定しやすくなりました。これにより、正確な名前がわからない場合でもオブジェクトを見つけやすくなります。
オントロジー | Vertex
Vertex ダイアグラムでのノード操作を効率化 | Vertex ダイアグラムのノード管理が強化され、ダイアグラムのインターフェース内で、ノードの元となるオブジェクトを直接変更できるようになりました。エッジの元となるオブジェクトを調整する機能も改善され、コンポーネントルートエディターからアクセスできるようになったことで、より直感的に使用できます。
セキュリティ | Checkpoint
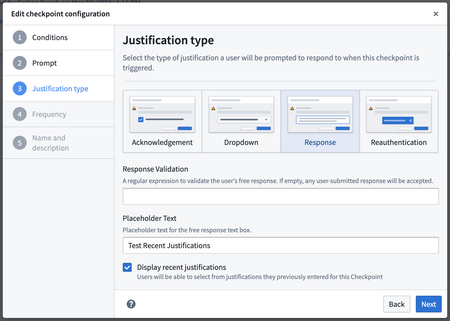
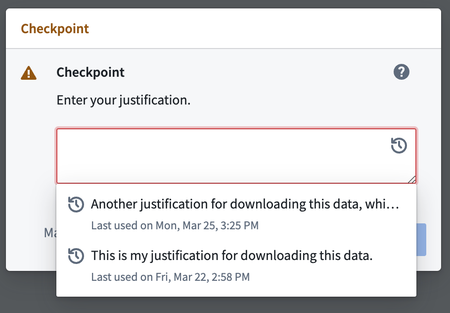
Checkpoint での理由の取得を効率化 | Checkpoint のテキストベースのプロンプトで、直近5件の理由にすばやくアクセスできるようになり、組織の基準をより効率的に遵守できます。この機能は、レスポンスとドロップダウンの両方の Checkpoint の理由カテゴリーで利用でき、理由の作成後30日間利用可能です。この機能を有効にするには、管理者が Checkpoint の設定で対応する設定を選択します。詳細については、最近の理由の設定に関するドキュメントを参照してください。
新しい Checkpoint の種類を導入:スケジュール、削除、実行 | スケジュール、削除、実行という追加の Checkpoint の種類を利用できるようになりました。これらの新しい選択肢により、Checkpoint のスケジュール管理の柔軟性と効率が向上し、ワークフローをさらに効率化できます。
セキュリティ | プロジェクト
プロジェクト制約の一般提供 | プロジェクト制約の導入により、データの使用方法に関する高度なガバナンスのガードレールをサポートできるようになりました。プロジェクト制約を使用すると、所有者はプロジェクト内のファイルに適用してよいマーキングと、適用してはならないマーキングを設定できます。プロジェクト制約により、目的の限定などのデータ保護原則を技術的に効果的に実装できます。
これは通常、結合すべきではないデータをユーザーが誤って結合するのを防ぐために使用されます。ユーザーが複数のマーキングへのアクセスを必要とする一方で、マーキングがついたデータの特定の組み合わせを許可すべきではない状況に適しています。たとえば、銀行ではコンプライアンス上の理由から、機密性の高い投資データを調査データと決して結合してはならないという要件がある場合があります。ただし、コンプライアンス担当者は業務を行うために、投資データと調査データの両方に個別にアクセスする必要があるかもしれません。
詳細については、プロジェクト制約のドキュメントと設定方法の詳細を参照してください。