注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
お知らせ
Python バージョンの非推奨化
公開日: 2023-07-27
オープンソース Python のサポート終了(EOL)スケジュールに従い、Foundry では Python 3.6 および 3.7 を非推奨にします。コードリポジトリでは自動アップグレードが試行されますが、コードワークブックおよび古い foundry_ml モデルでは手動での対応が必要です。Python 3.8 以降は、上流の EOL に伴う非推奨化スケジュールに厳密に従います。
サポートされているバージョンとそれぞれの非推奨化スケジュールについては、ドキュメントの Python バージョンのセクションを確認してください。リソースは常に、サポートされている最新バージョンで維持することを推奨します。
Python 3.6 および 3.7 が非推奨になるのはなぜですか?
オープンソース Python では、毎年、古い Python バージョンをサポート終了(EOL)に指定 ↗し、公式サポートを終了しています。Python 3.6 および 3.7 はすでに EOL を過ぎており、EOL を迎えた Python バージョンを使い続けるとセキュリティリスクにさらされます。さらに、次の点も考慮する必要があります。
- PySpark などのコアパッケージでは、古い Python バージョンのサポートが完全に終了しています(たとえば、Spark における Python 3.6 および 3.7 の非推奨化)。そのため、非推奨の Python バージョンを使用する Python ジョブには、ランタイムの改善やバグ修正を提供できません。
- オープンソースライブラリでは、これらの非推奨の Python リリースに対応しない新しいリリースが引き続き作成されており、チェックやジョブの失敗を引き起こします。
非推奨化はユーザーにどのような影響がありますか?
非推奨の Python バージョンを使用するリソースを所有している場合、次のスケジュールに従って、それらのリソースで開発できなくなります。
- 2024年1月31日
- ワークフローのいずれかが非推奨の Python バージョンに依存している場合、一部のワークフローはサポート対象ではなくなり、失敗が発生してもサポートを受けられなくなります。事前に Palantir と合意した場合は、限られたリソースを許可リストに登録してサポートを延長できます。
- 2024年4月1日
- Python 3.6 および 3.7 に依存するすべてのワークフローがサポート対象ではなくなり、失敗するようになります。
サポートされている Python バージョンへの Foundry リソースの移行
Foundry リソースの移行は、次の方法で行われます。
- コードリポジトリ:自動パッチ PR の形で自動アップグレードが試行されます。
- その他のリソース:非推奨の Python バージョンからの移行を支援する手順とリンクを含む情報バナーが表示されます。詳細については、トラブルシューティングガイドを確認してください。
現在、プラットフォームでサポートされている最新バージョンは Python 3.10.* です。Python 3.8.* および 3.9.* も使用できますが、3.10.* よりも早く非推奨になります。
今後の Python バージョンの非推奨化
Python 3.8 以降、Foundry は上流のサポート終了スケジュールに厳密に従い、上流でサポートが終了した時点で、その Python バージョンを Foundry でも非推奨にします。詳細については、ドキュメントの Python バージョンを参照してください。
オントロジー SDK での Python サポートのご紹介 [ベータ版]
公開日: 2023-07-27
Foundry のオントロジー SDK および Developer Console における Python サポートがベータ版になりました。このリリースにより、開発者は必要なオブジェクトタイプ、アクションタイプ、リンクを含む Python パッケージを生成し、conda または pip を使用してパッケージをインストールし、Jupyter® ノートブックやその他の IDE で結果を分析できます。
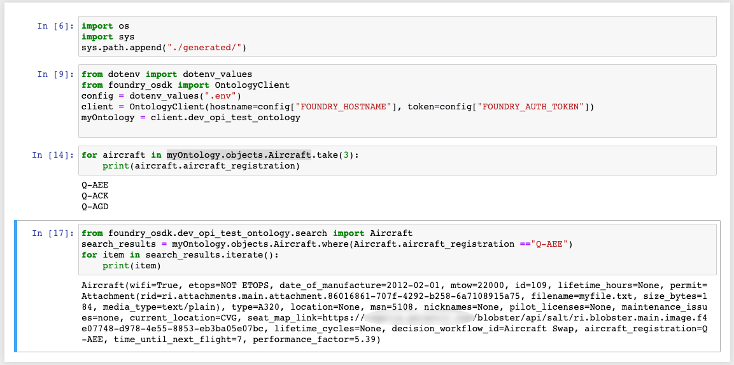
コマンドラインパッケージをインストールすると、それを使って SDK を生成し、Python 環境に SDK をインポートして、オブジェクトの反復処理、特定のオブジェクトの検索、アクションを適用したオブジェクトの編集を開始できます。
どうすれば試せますか?
Developer Console の各アプリケーションには、サポートされているパッケージマネージャーを切り替えるトグルがあります。Application SDK ページの SDK のインストールタブを使うと、TypeScript 用の npm のインストール手順と、Python 用の pip および Conda のインストール手順を切り替えられます。
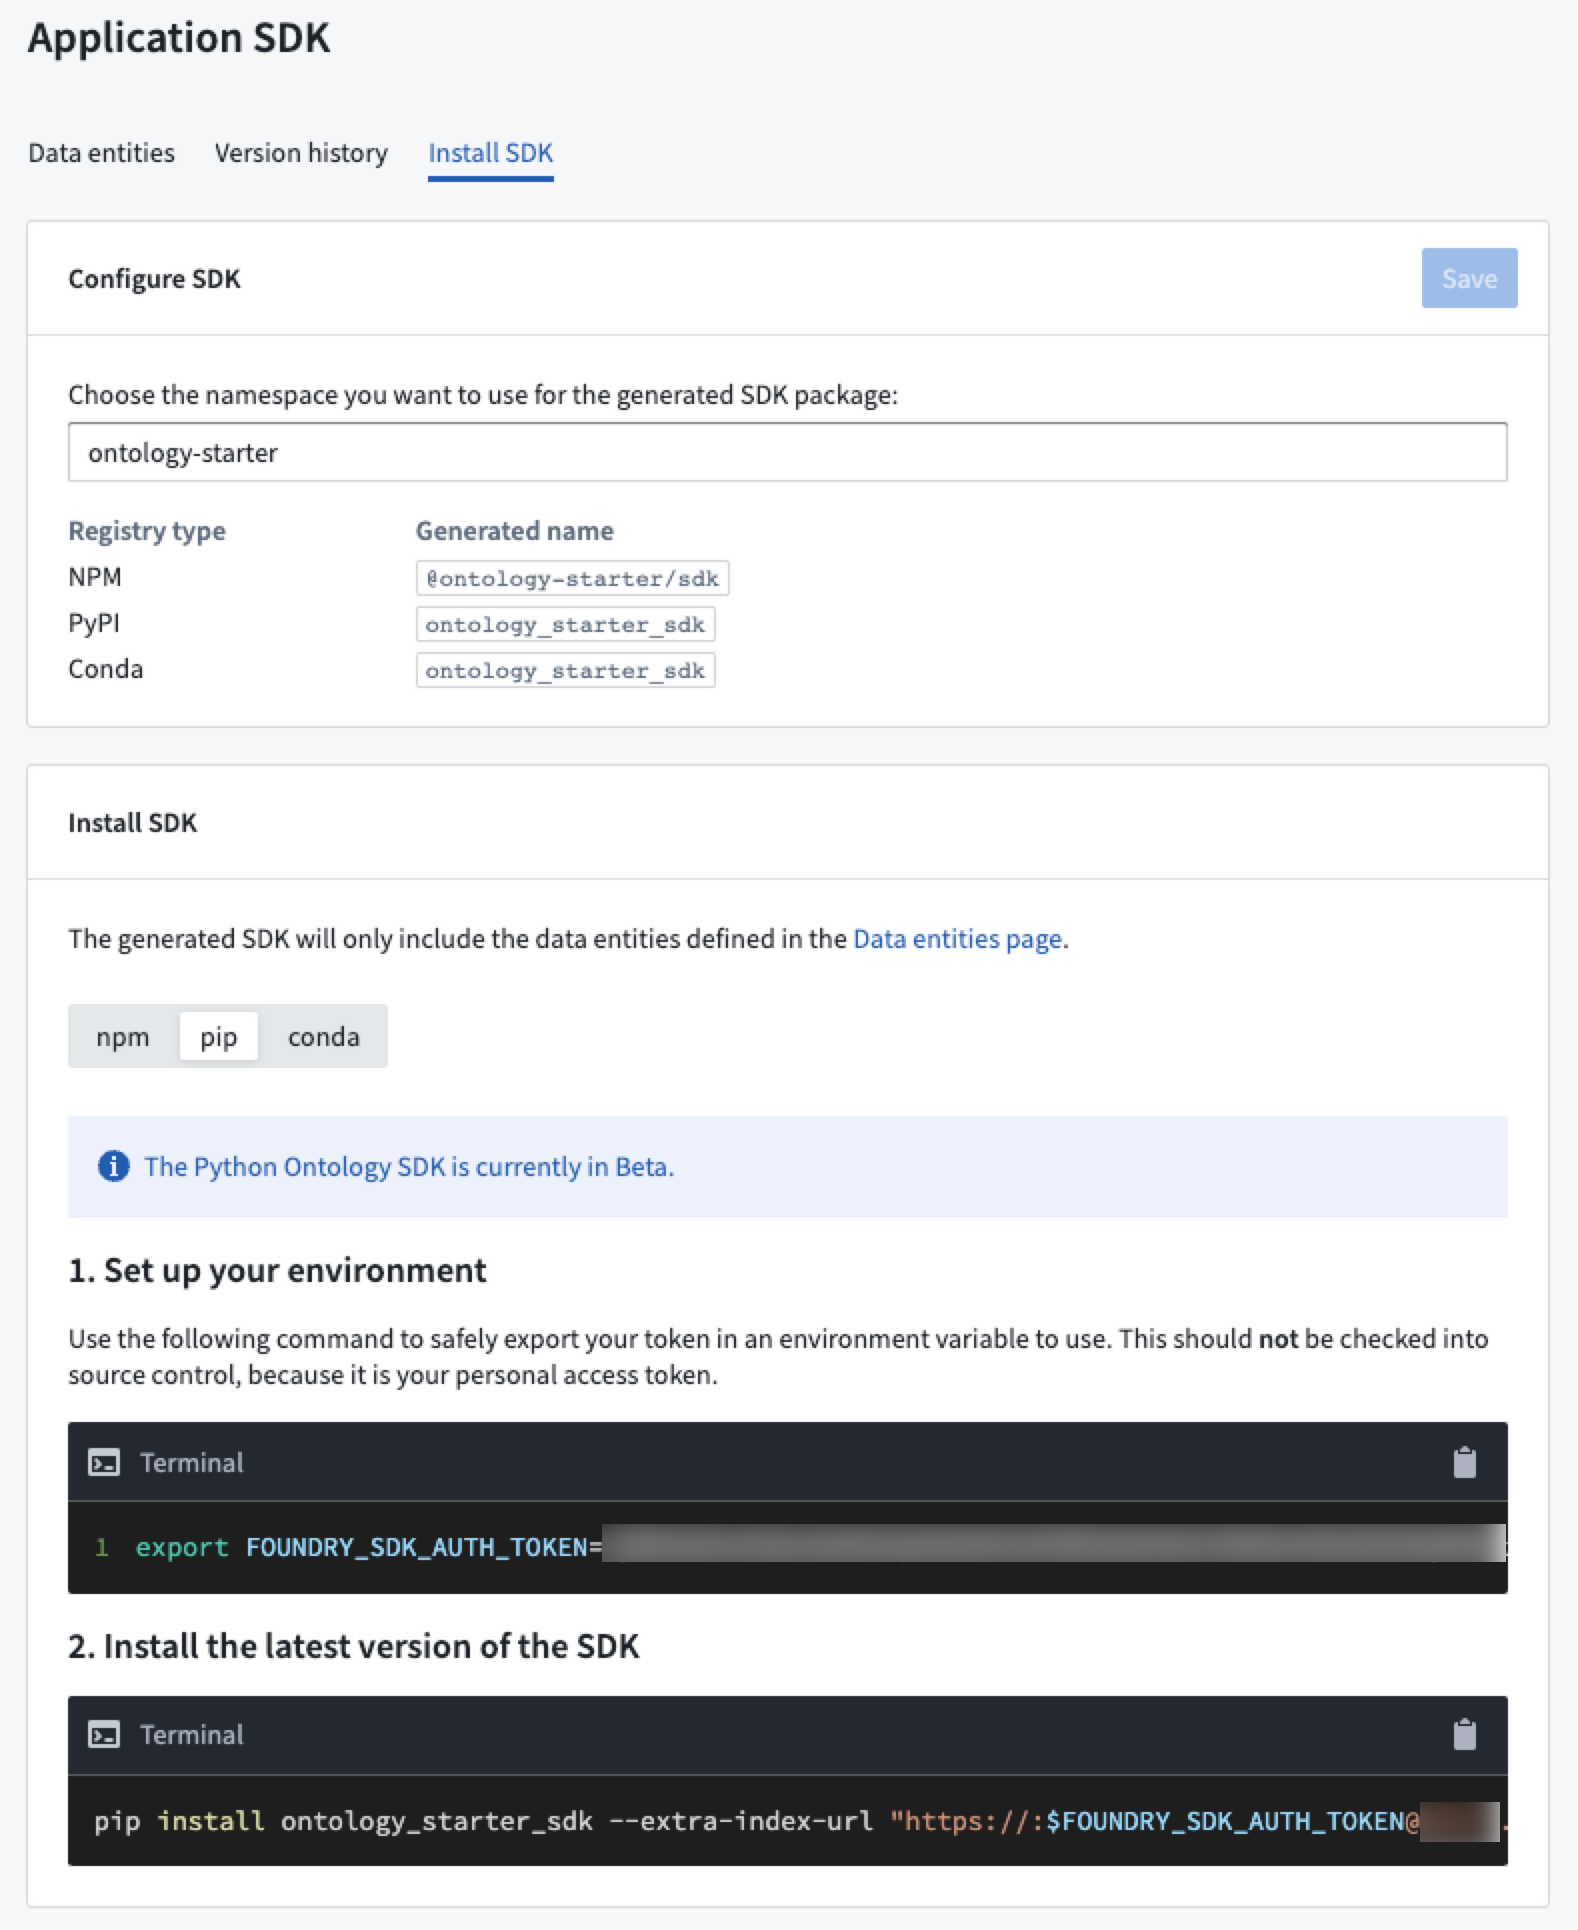
インストールしたら、Python IDE(Jupyter® など)を起動し、生成したパッケージをインポートして、オントロジーのオブジェクトタイプとアクションタイプの操作を開始します。
詳細については、オントロジー SDK で Jupyter® を使用するドキュメントを確認してください。
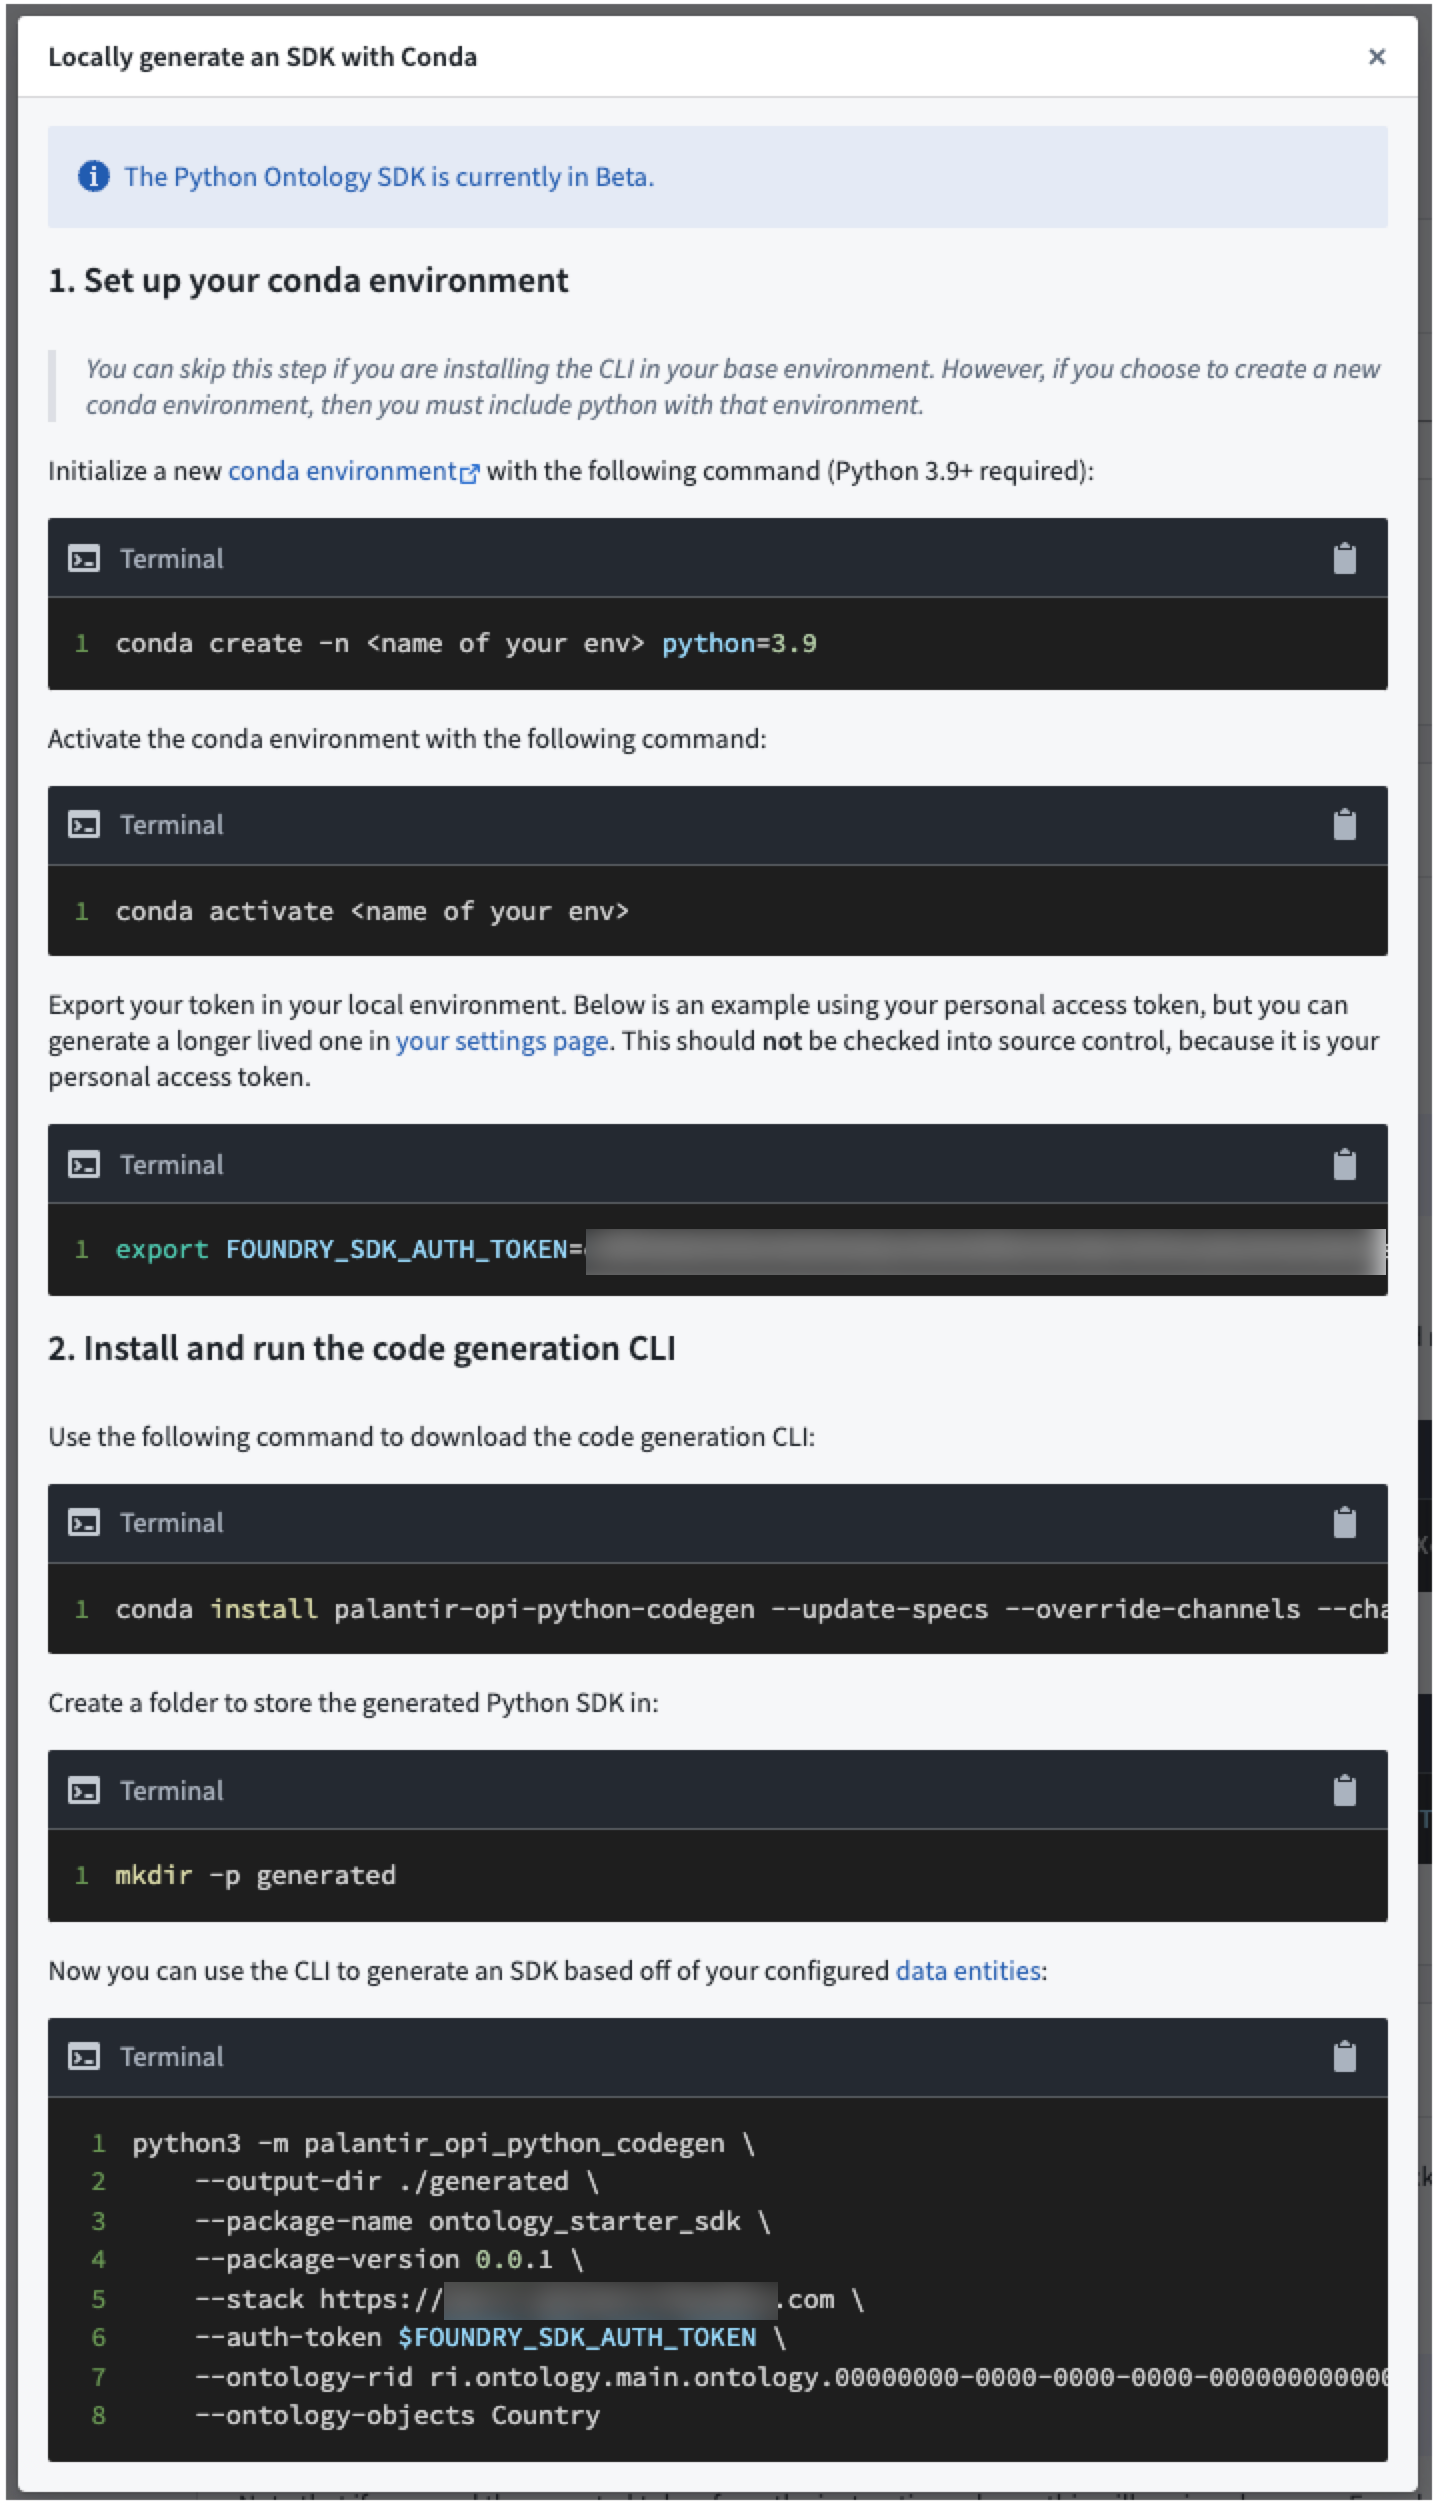
Python パッケージを自分で生成する必要がある場合はどうすればよいですか?
プラットフォームでパッケージを生成できない場合は、コマンドラインインターフェース(CLI)ツールを使ってパッケージを生成する手順が表示されます。
Jupyter® は NumFOCUS の登録商標です。
Vertex および Map のタイムラインのご紹介 [一般提供]
公開日: 2023-07-27
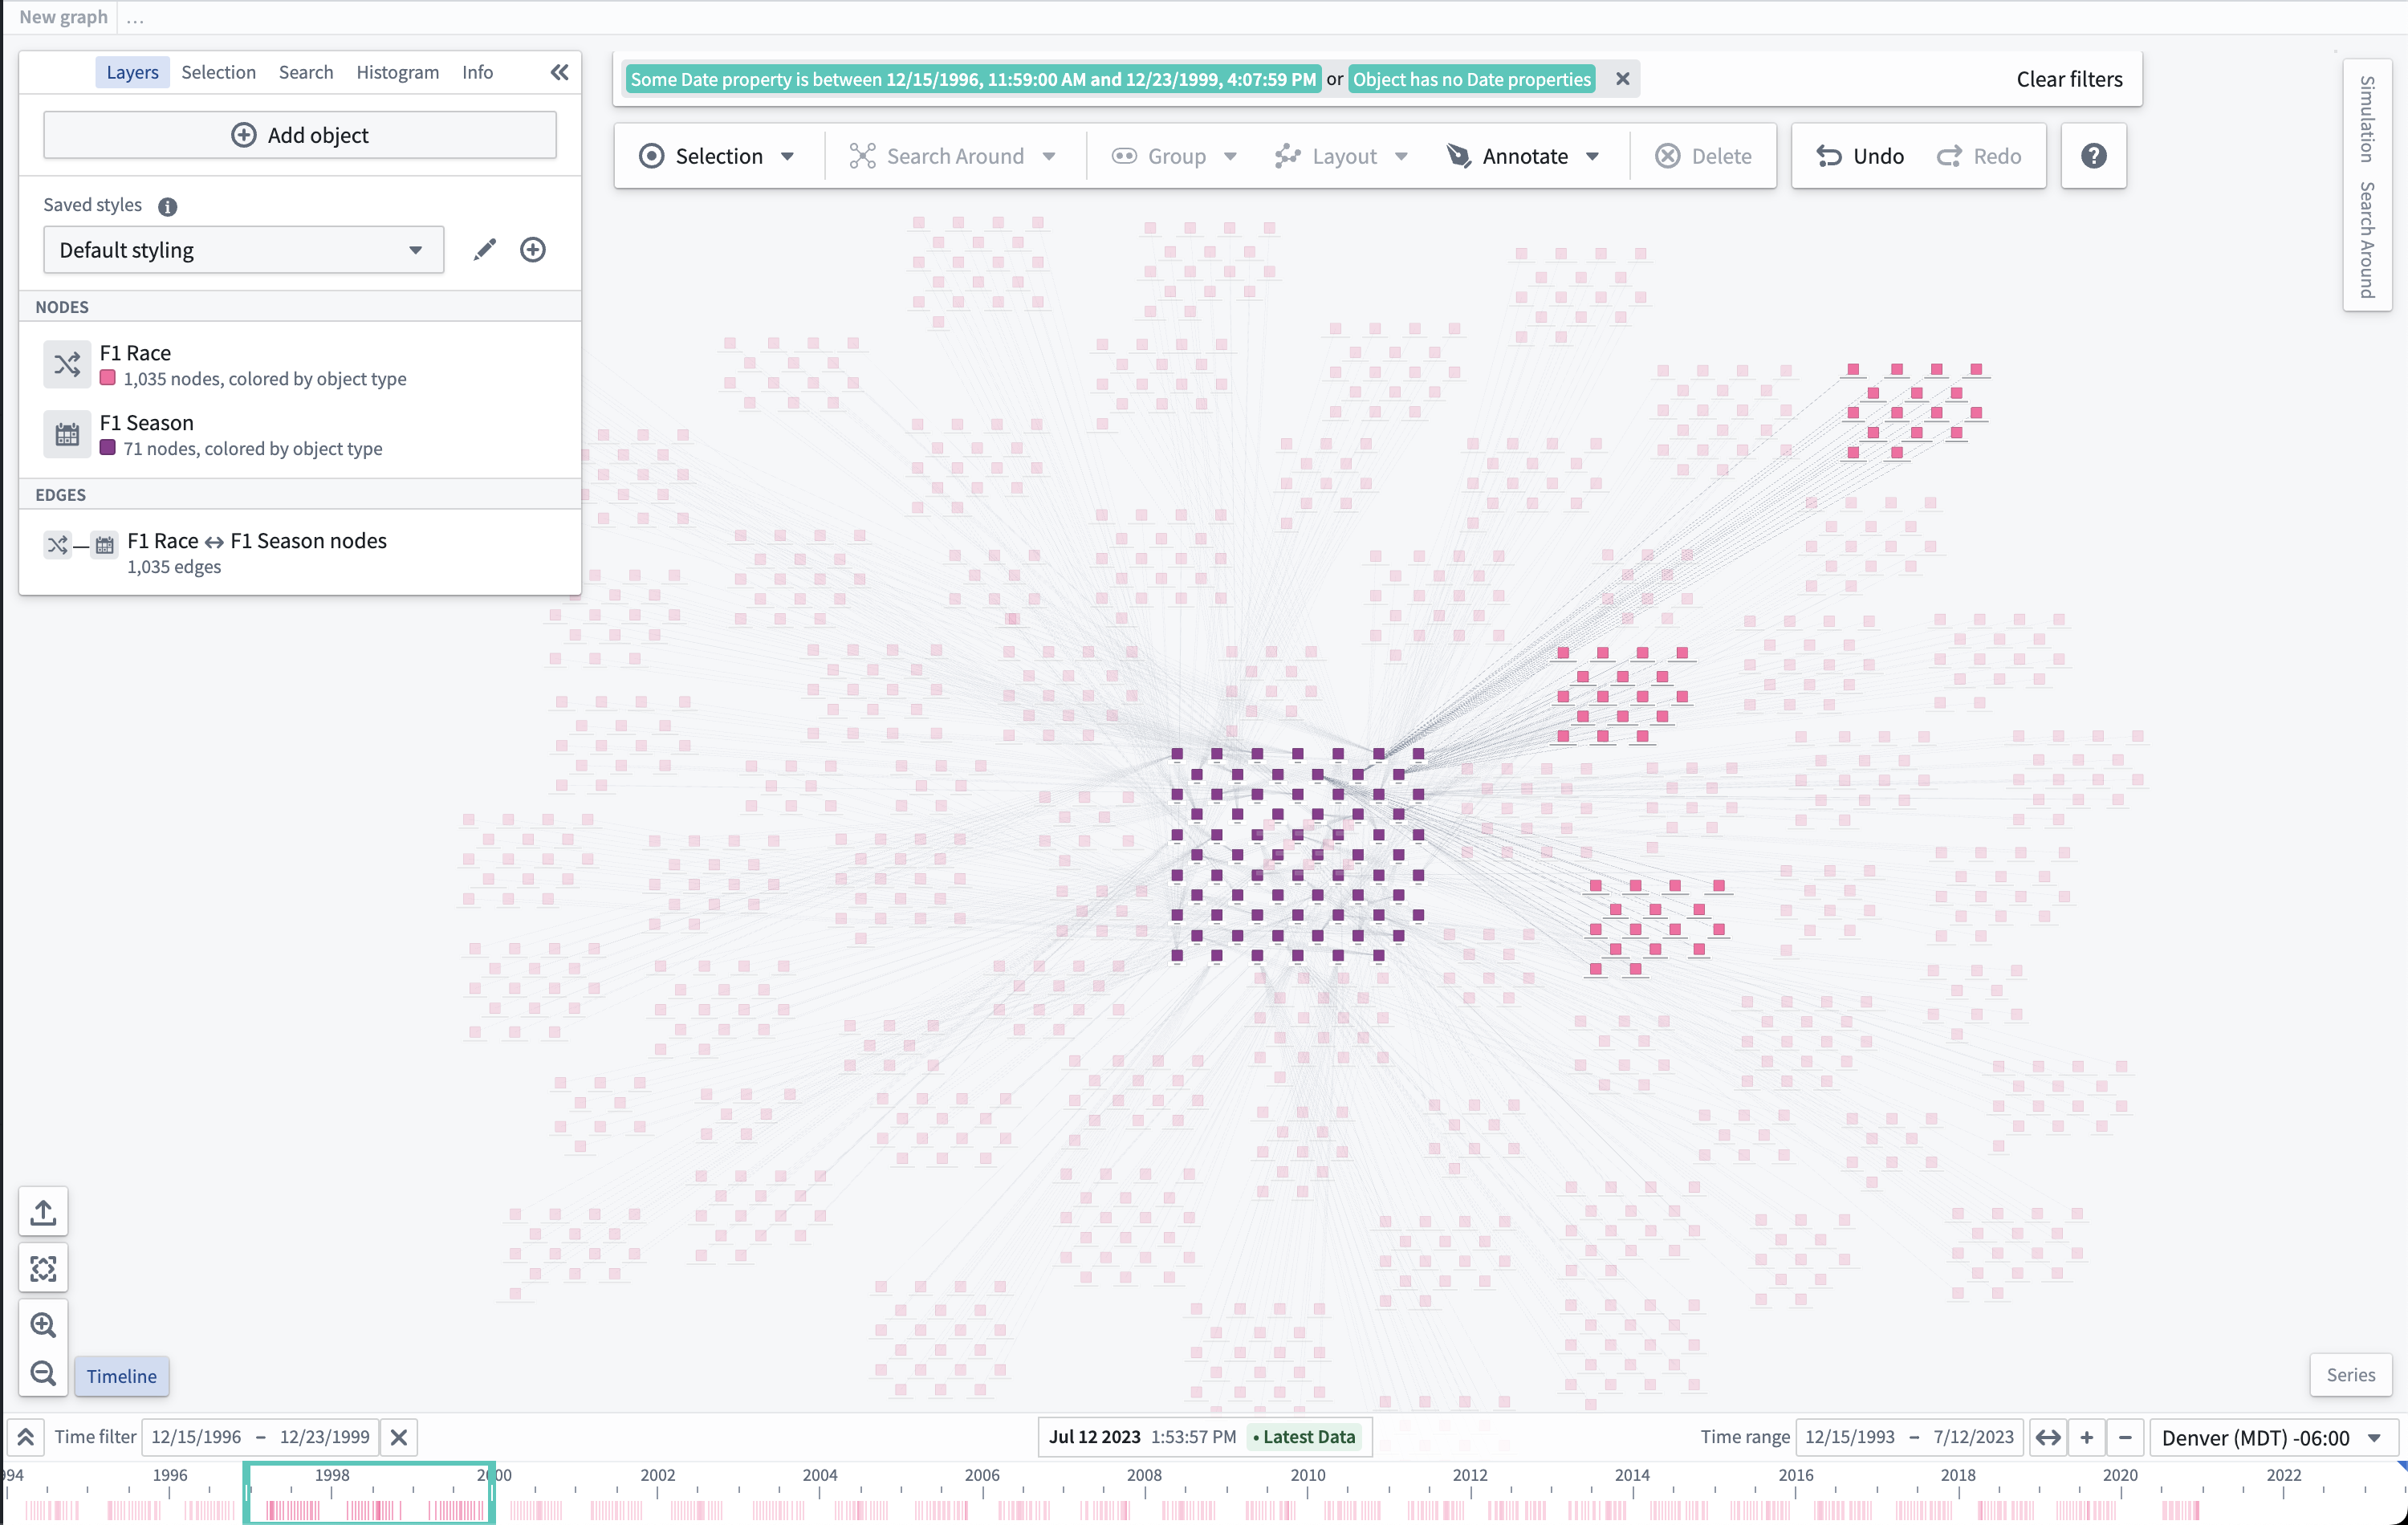
Vertex および Map の機能であるタイムラインが一般提供になりました。この機能では、選択したオブジェクトの時間プロパティを確認し、指定した時間範囲内の特定のイベントに絞り込めます。ズームセレクターの横にあるタイムラインボタンを使うと、現在の Vertex グラフまたはマップ上のオブジェクトイベントを表示するタイムラインパネルが開きます。
Workshop でタイムラインを有効にする
Workshop のグラフウィジェットまたはマップウィジェットにタイムラインを表示するには、いずれかのウィジェットの設定でインターフェースセクションに移動し、タイムラインを有効にするを切り替えます。
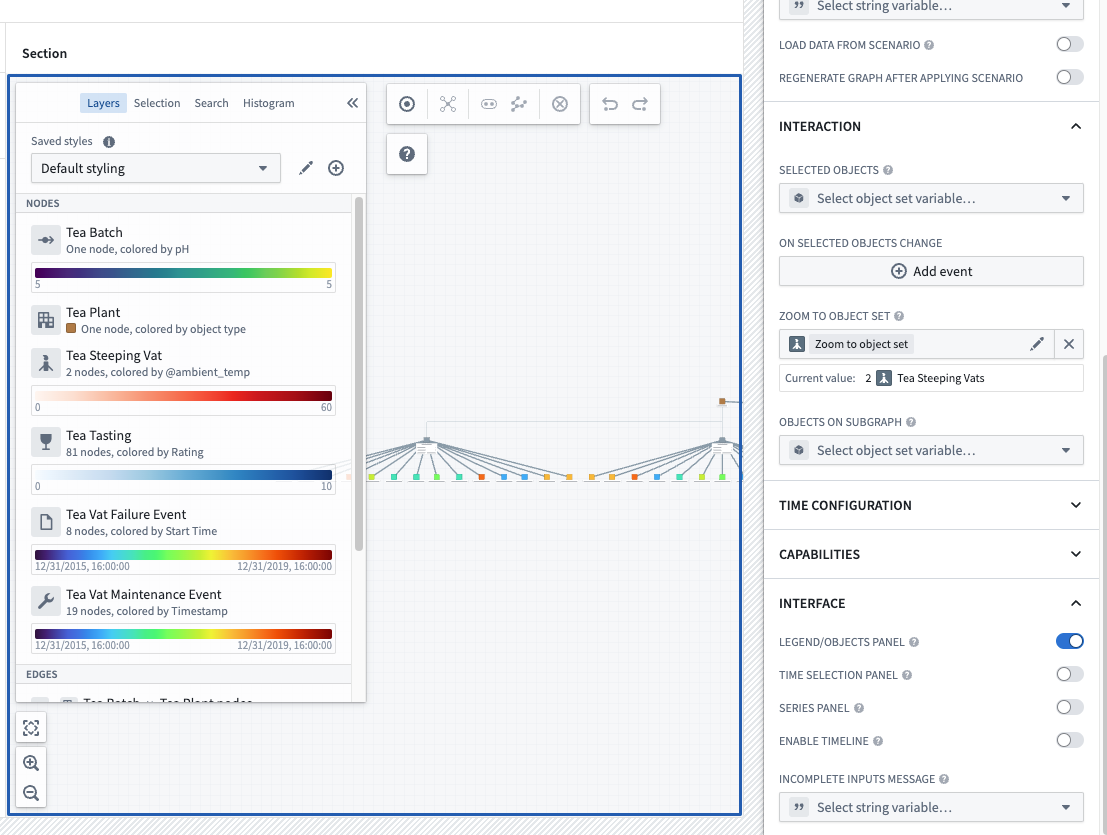
以前にタイムラインのベータ版を使用していた場合、このオプションのデフォルトはオフです。タイムラインを利用可能にするには、対象のモジュールごとに有効にする必要があります。
時間選択パネルの非推奨化予定
タイムラインが一般提供になったため、Foundry Map の既存の時間選択パネル機能は、2023年8月21日(月)までに非推奨になる予定です。
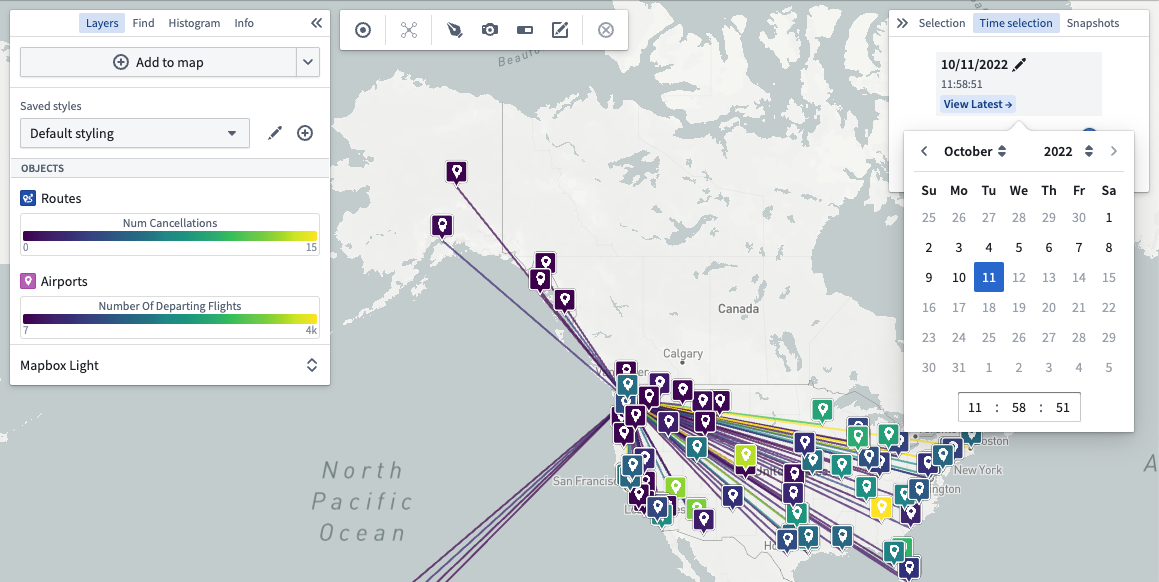
既存の時間関連ワークフローへの影響を避けるため、現在の機能に変更はありませんが、この日付より前に、すべての使用箇所でタイムライン機能に切り替えてください。この更新について質問や懸念がある場合は、Palantir サポートにお問い合わせください。
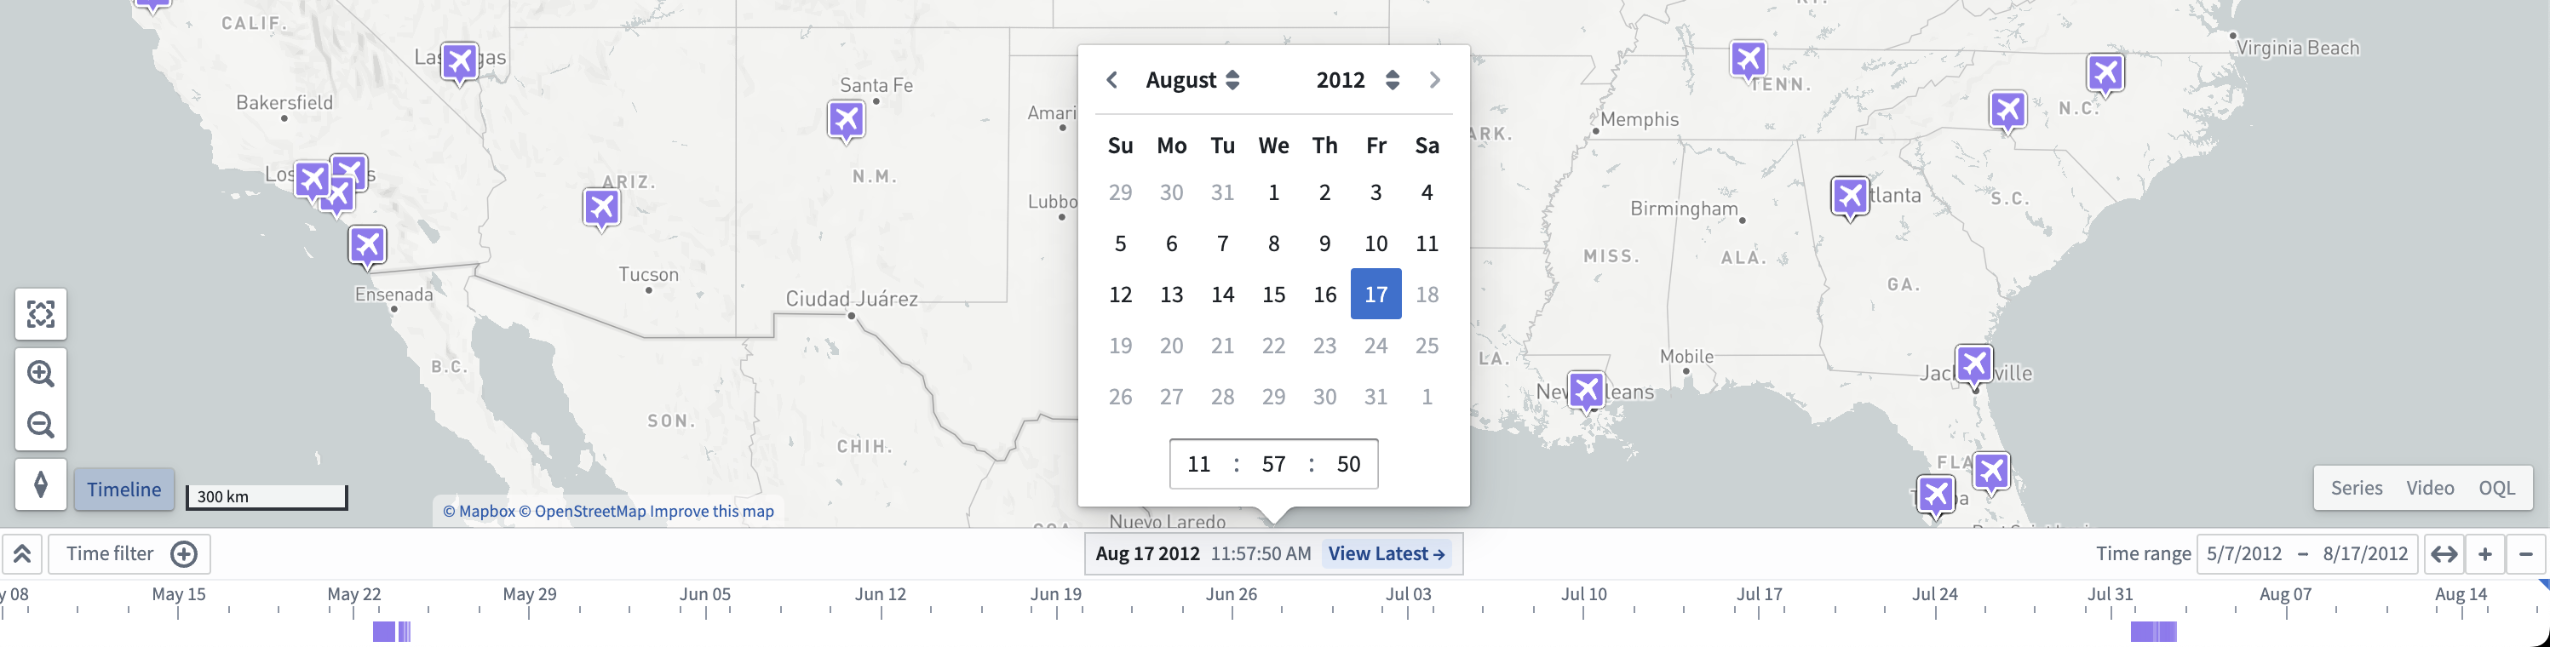
タイムライン向けの追加の時間比較機能とモデリング機能を開発している間、この機能は Vertex で引き続き利用可能です。
開発ロードマップには何が予定されていますか?
読み込み時にタイムラインをデフォルトで折りたたむか、展開するかを設定できる機能を予定しています。
タイムラインとその使用方法の詳細については、Vertex のタイムラインまたは Map のタイムラインのドキュメントを確認してください。
オブジェクトに対する関数で Foundry モデルを利用可能に [GA]
公開日: 2023-07-20
オブジェクトに対する関数内からモデル(FoundryML のライブデプロイメント経由で提供されるモデル)を呼び出せるようになりました。これにより、オントロジーのコンテキストでモデルを実行する方法が広がり、Workshop や Palantir Foundry のほかの場所で利用できます。モデルに対する関数は、通常の関数を使用するあらゆる場所で利用できます。
新たにできること
- 複雑なオントロジーマッピング: 関数の機能を活用して、リンクの設定、オブジェクトの作成に加え、Objective のバインディング UI にあるモデルの入力と出力の1対1の制約を緩和できるようになりました。
- モデルをアクションとして利用:「OntologyEditFunction」を元にしたアクションからモデルを呼び出せるようになりました。これらのアクションは、マスターオントロジーに直接適用することも、シナリオに適用してからマージして戻すこともできます。
- モデルを基本的な関数として利用: オントロジーには影響せず、可視化を直接駆動するモデルを、Workshop 固有のデータ型を返すオブジェクトに対する関数に簡単に統合できるようになりました。この機能により、パフォーマンスが向上し、シナリオを使う不要なセットアップを避けられます。
- モデル実行直前の特徴量エンジニアリング: 関数でオブジェクトの検索や集計を実行し、モデルに渡す前に特徴量を作成できます。
要件
このワークフローを有効にするには、まず FoundryML のライブデプロイメントの設定ページでAPI名を設定し、次の要件を満たす必要があります。
-
Apollo 製品の最小バージョン:
- functions-typescript-asset-bundle: >= 0.442.0
- functions-parent-template-bundle: >= 3.5.0
-
gradle.properties の最小バージョン:
- functionsTypescriptVersion >= 0.442.0
- functionsVersion: >= 3.5.0
モデルに対する関数の仕組み
ワークフローは、Foundry に保存されたモデルから始まります。ユーザーはモデルをモデリング目標に登録し、Foundry ML Live 経由でデプロイします。
関数リポジトリには、オントロジーのインポートダイアログと同様に、Foundry ML Live のデプロイメントをインポートする新しいオプションが追加されました。これによりモデルデプロイメントが登録され、Code Assist がインポート済みの Foundry ML Live デプロイメントの TypeScript バインディングを自動生成できるようになります。このバインディングは、デプロイメントのAPI名を使用してインポートできます。
コードで提供されるインターフェースには、Foundry ML Live を呼び出す transform() メソッドが含まれています。モデリング関数は、新しいモデル資産プリミティブを活用して、モデルの入力と出力を反映した型付きの transform() を提供できます。想定されるインポートワークフローとコード例を以下に示します。
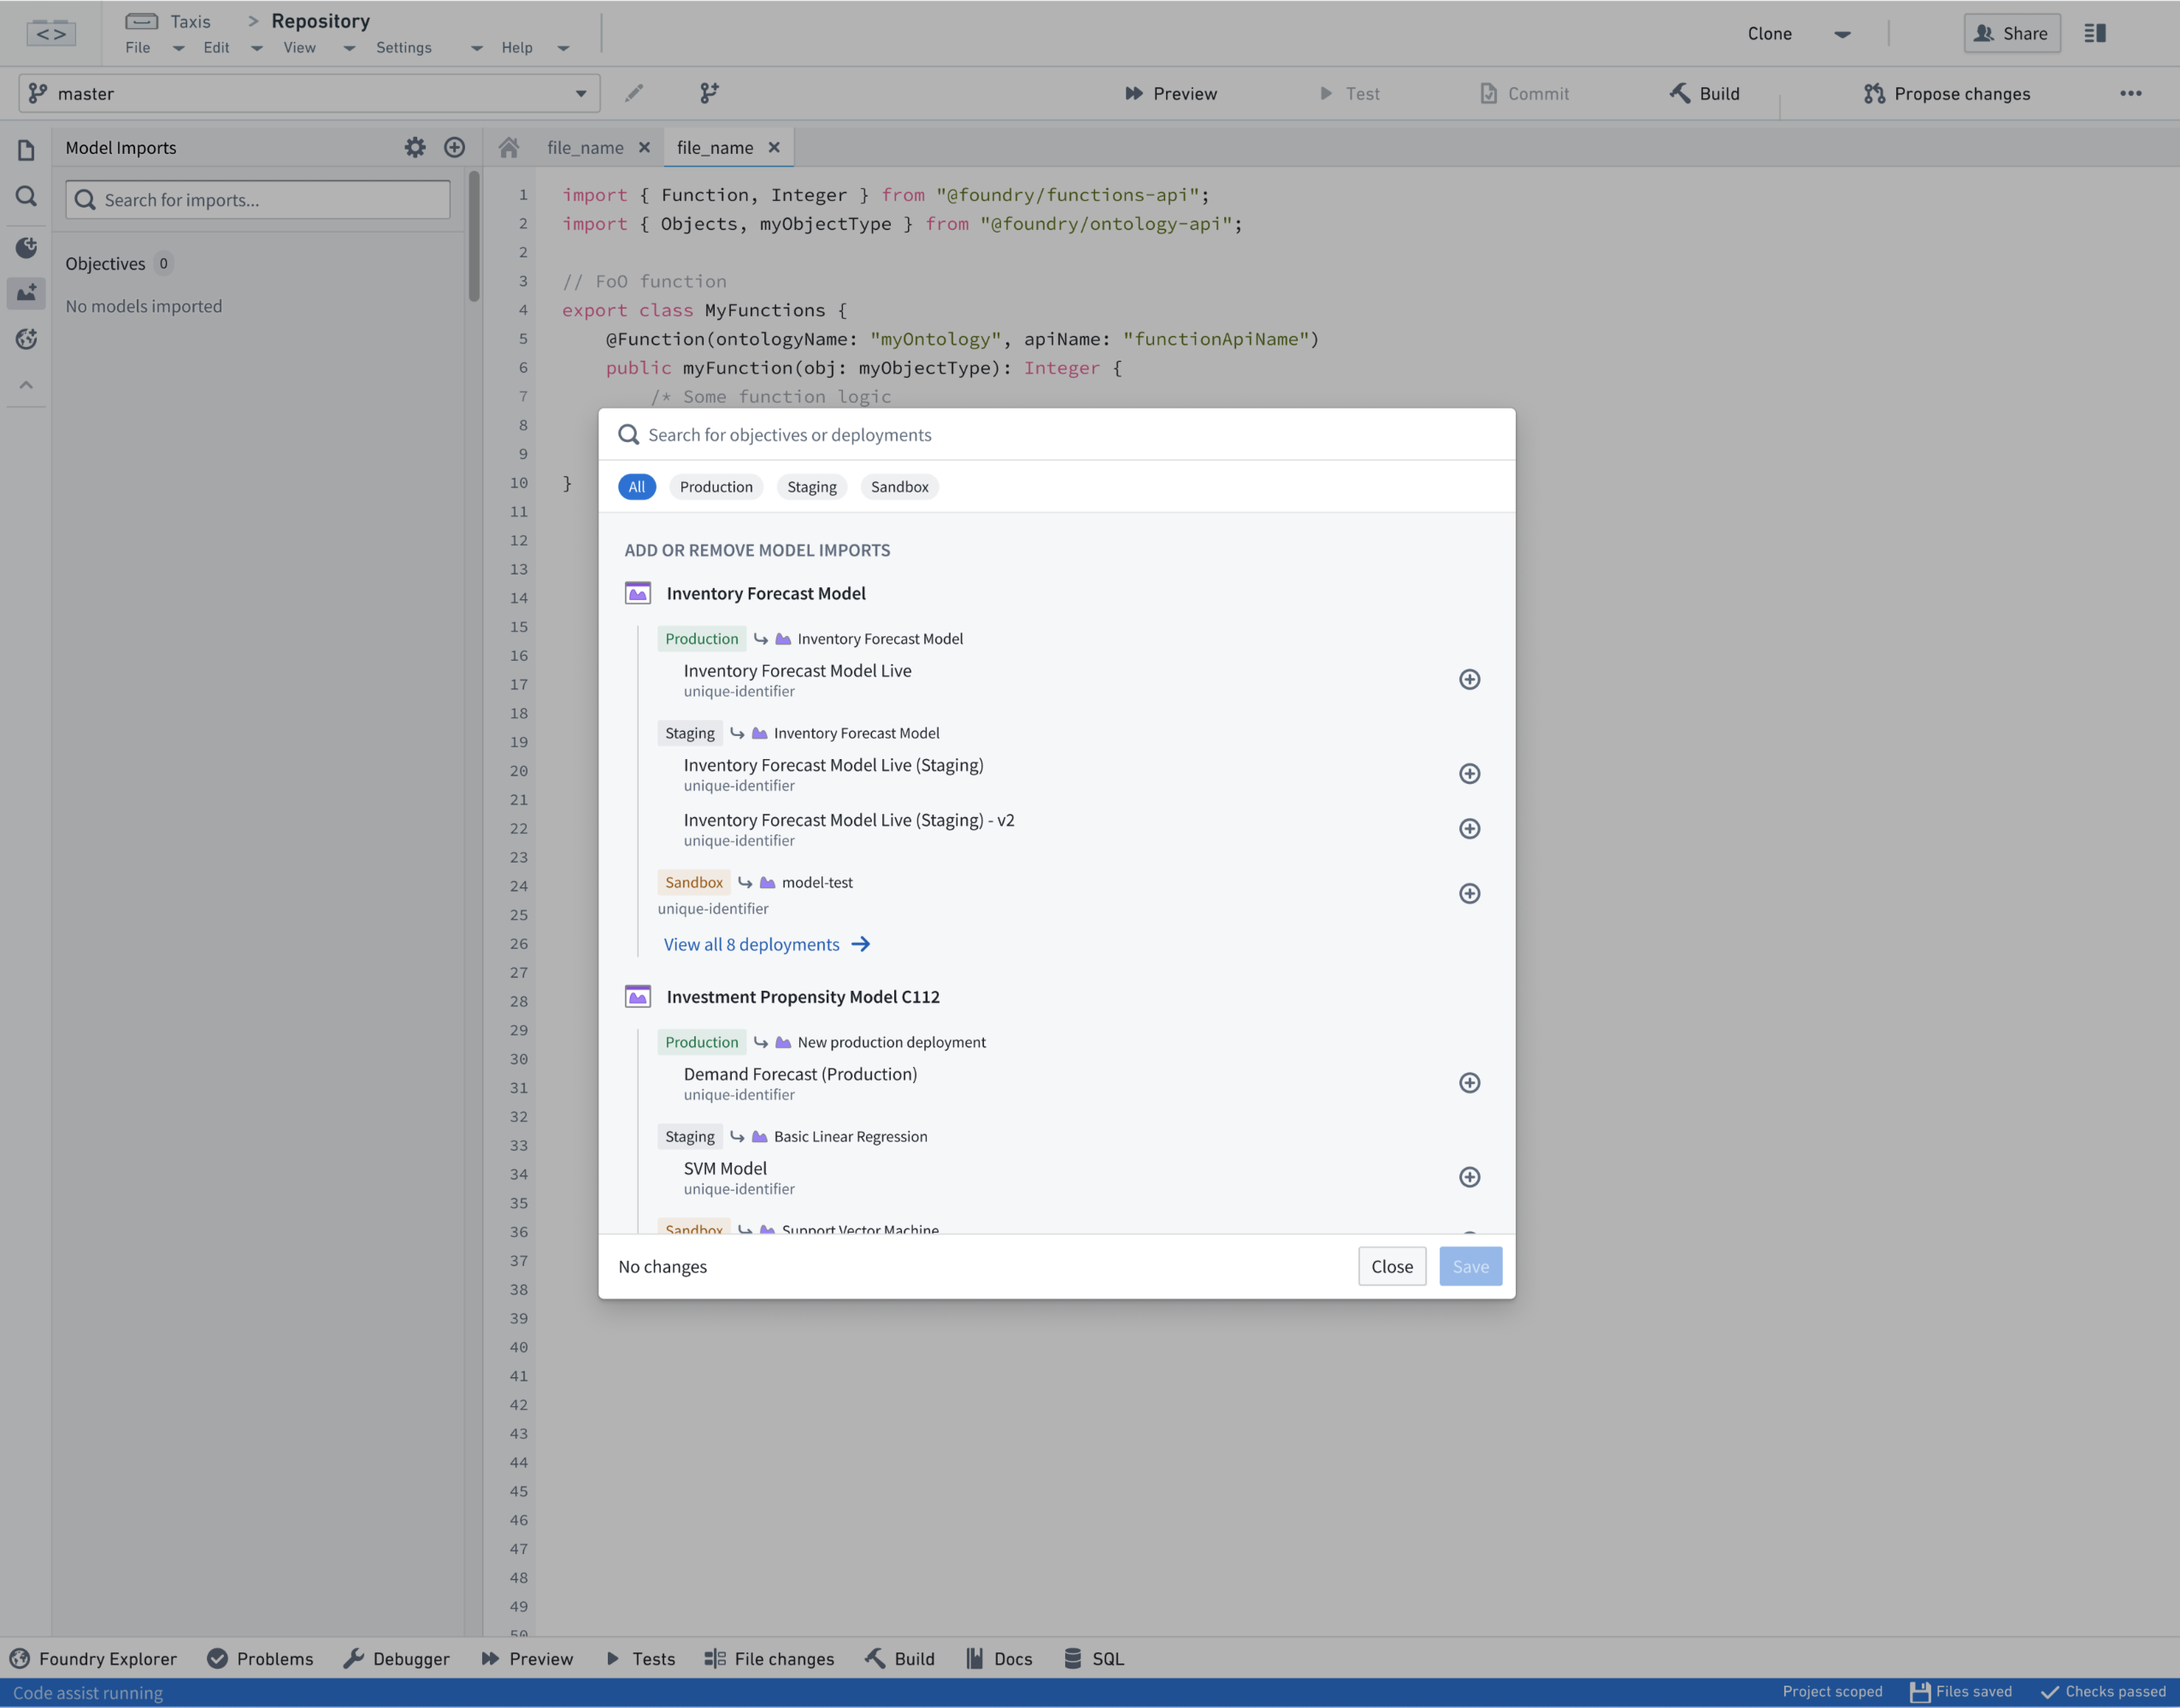
FoundryML のライブデプロイメントのインポートダイアログ
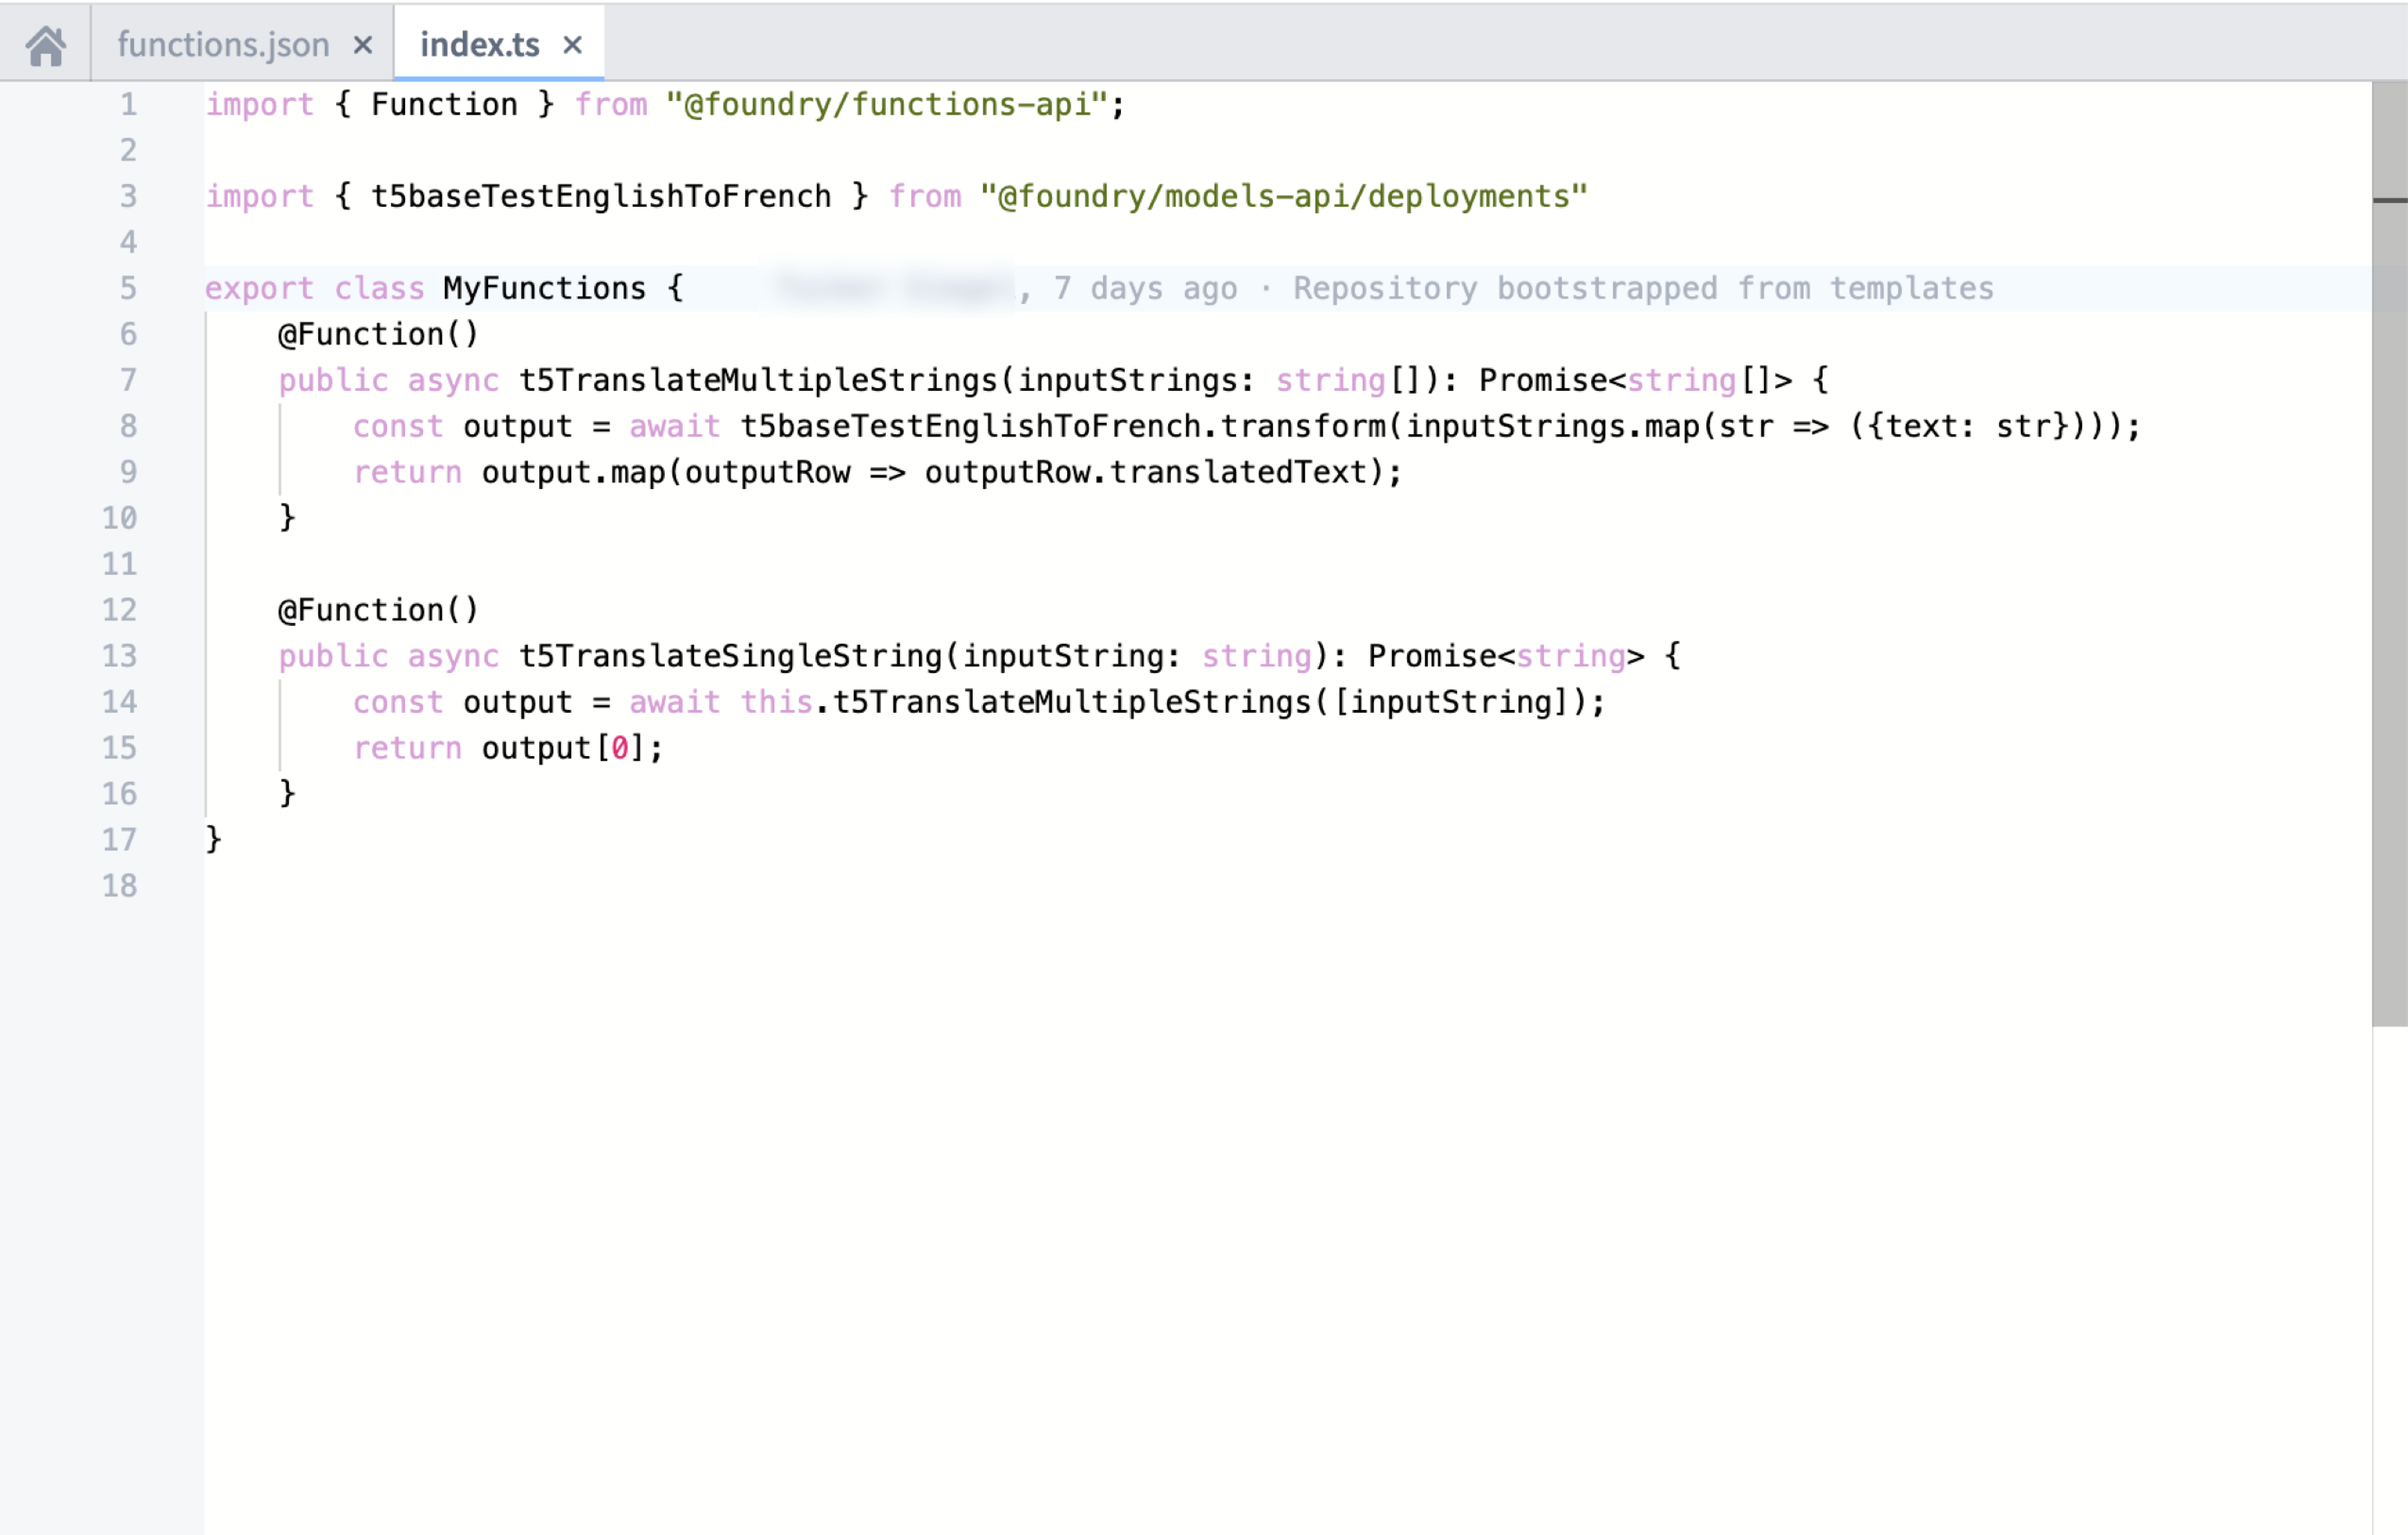
モデルに対する関数のコード例
すでにモデルに対する関数を使用している場合はどうなりますか?
すでにモデルに対する関数を使用している場合、リポジトリをアップグレードすると、この GA に含まれる破壊的変更が適用されます。すべてのユーザーに、古いリポジトリの移行を推奨します。移行は比較的簡単なプロセスです。
- ML Live デプロイメントのAPI名を定義します
- 関数リポジトリに新しいブランチを作成します
functionsVersionとfunctionsTypescriptVersionを上記のバージョンにアップグレードしますfunctions.jsonでuseDeploymentApiNamesを true に設定しますimport { riSanitizedRid } from "@foundry/models-api"からのインポートをすべてimport { MyDeploymentApiName} from "@foundry/models-api/deployments"に変更します- 新しいブランチでコード生成が動作することを確認し、メインブランチにマージして戻すためのプルリクエストを送信します
モデルに対する関数については、ドキュメントの詳しくはこちらをご覧ください。
Resource Management のデータエクスポート機能のご紹介
公開日: 2023-07-20
Resource Management の管理者は、Control Panel からリソース管理データを Foundry データセットにエクスポートできるようになりました。これにより、Contour などの Foundry ツールで使用量データを独自に調査・分析できます。
Control Panel からデータをエクスポートするには、内部データセットのエクスポートに移動し、詳細な使用量データを新しいデータセットにエクスポートします。エクスポート後、このデータセットは上流のデータソースに合わせて最新の状態に保たれます。監査ログと同様に、機密データセットをエクスポートした後は、そのデータセットに適切な権限を設定してください。
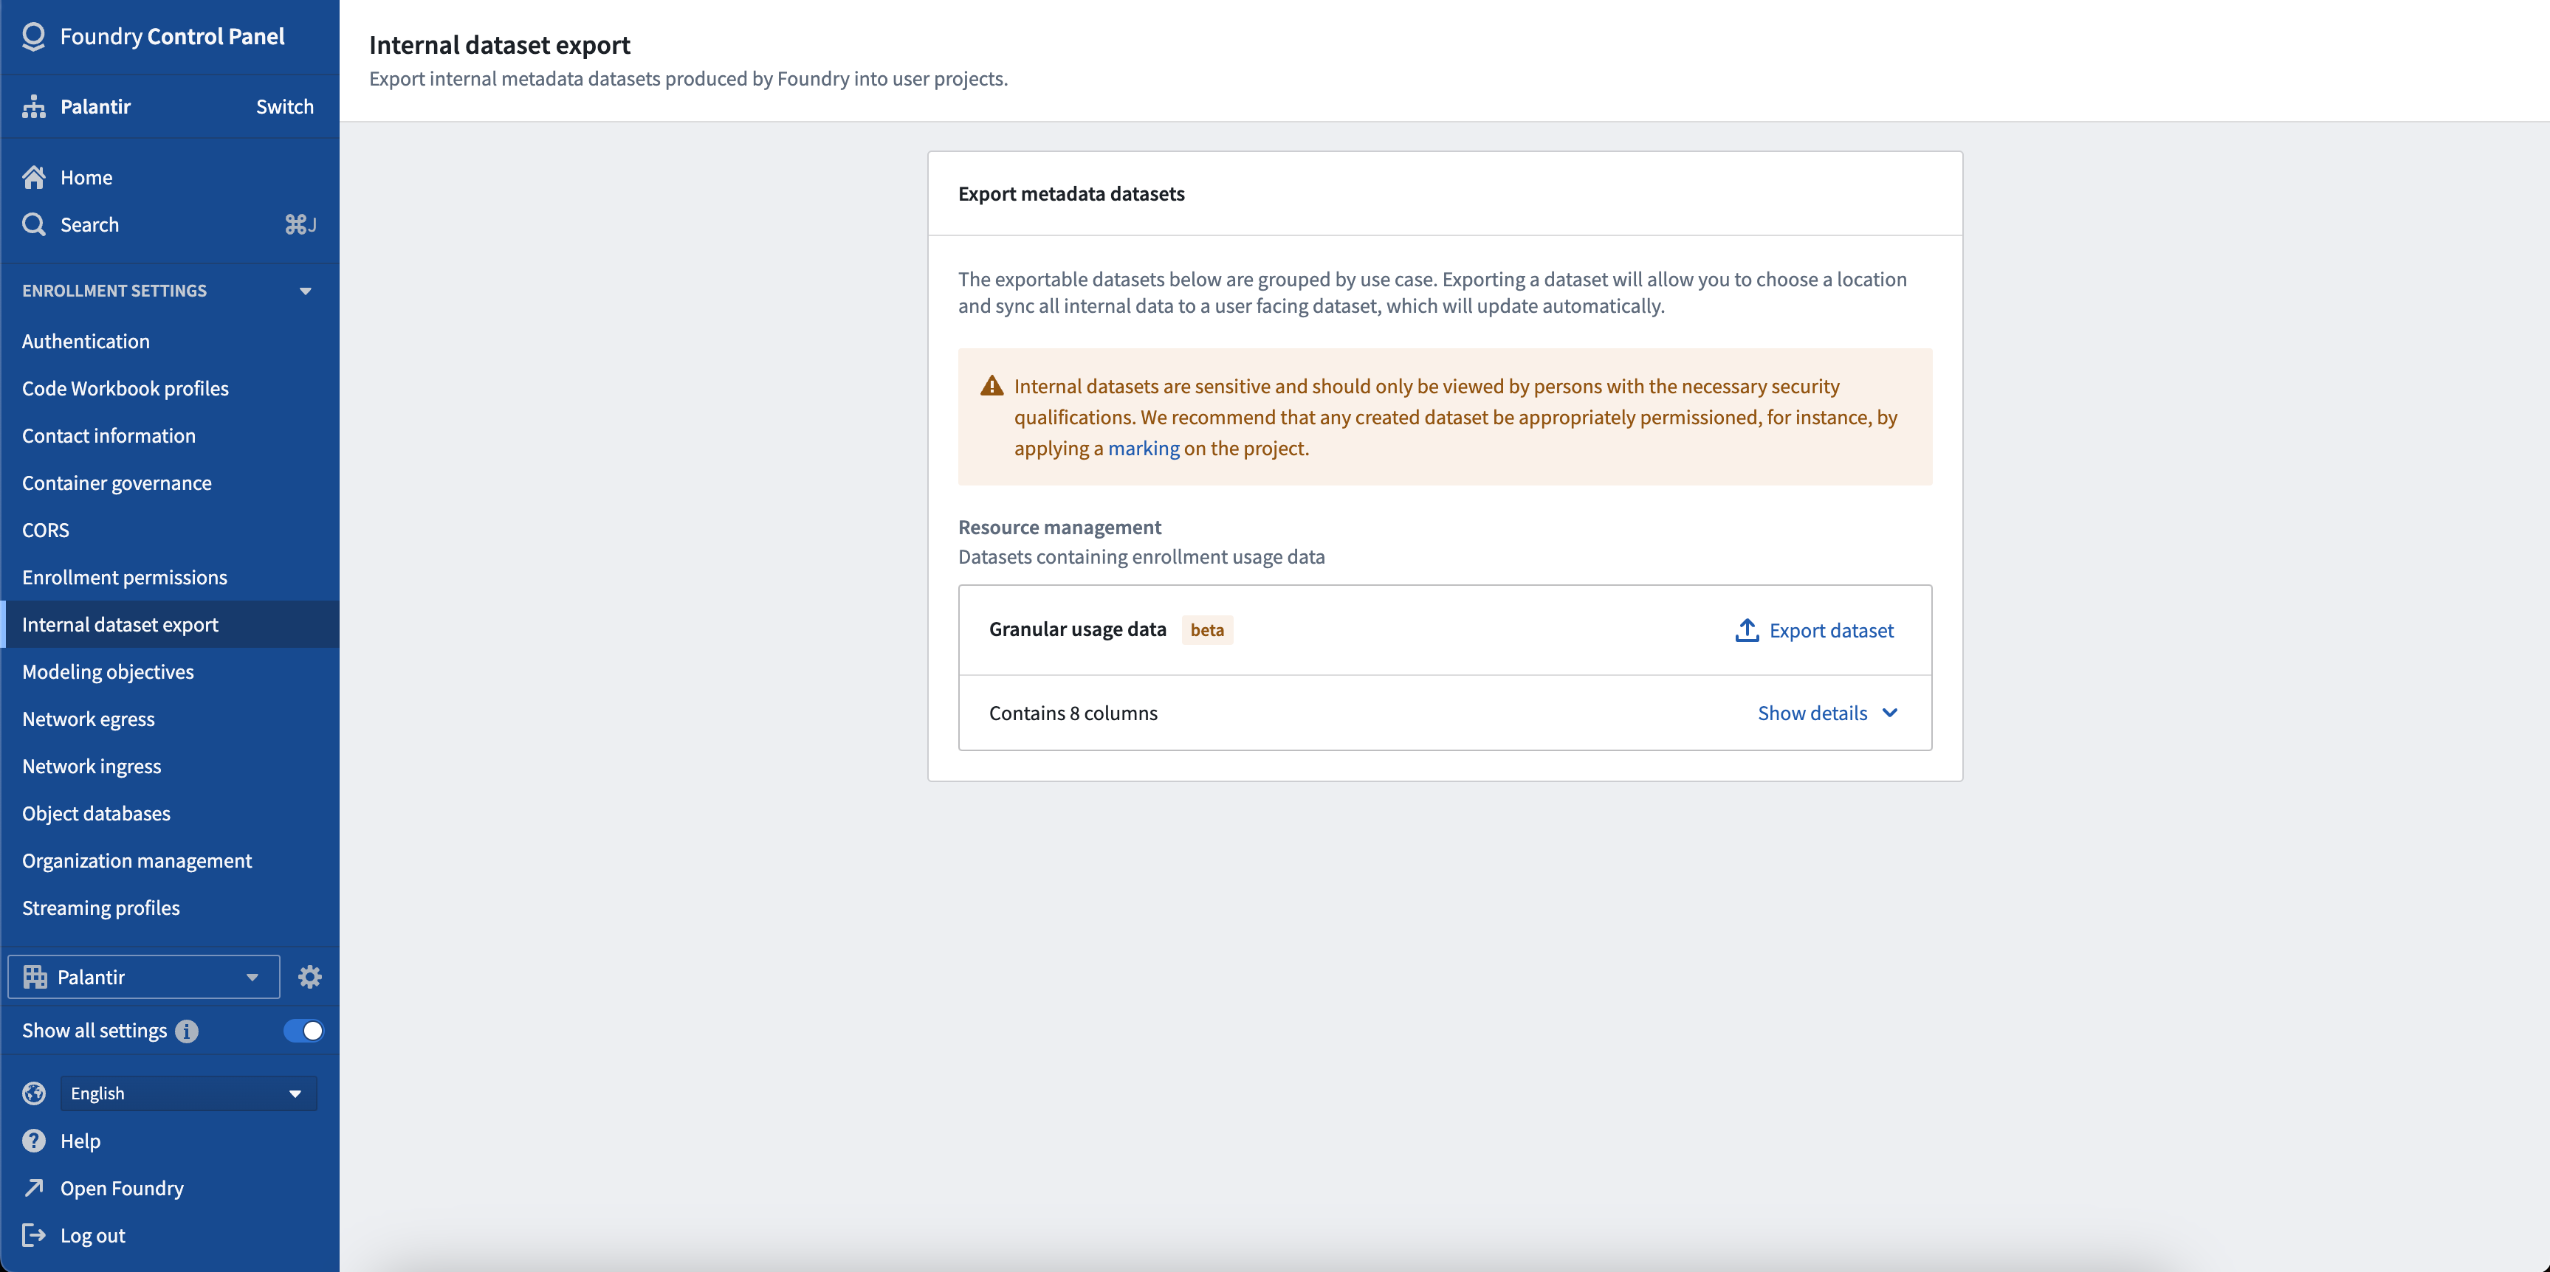
Control Panel からリソース管理データをエクスポートするには、内部データセットのエクスポートに移動してエクスポートします。
RMA データのスキーマは以下のとおり
enrollment:使用量データのエクスポート元のエンロールメントです。この列には、単一のエンロールメント RID が含まれます。invoiced_dimension:エンロールメントの契約で定められた、この使用量の行が属する請求対象のディメンションです。source:特定の使用量の行が属するソースです。summary_resource_rid:詳細な使用量の親です。データセットの場合はデータセットが保存されているプロジェクト、オントロジーオブジェクトの場合はオントロジー RID です。granular_resource_rid:この使用量が属するリソースです。date:この使用量が消費された日付です。usage:消費された使用量です。usage_unit:使用量の単位です。ストレージの場合は GB-months、コンピューティングの場合は compute-seconds です。
詳細については、内部データセットのエクスポートのドキュメントを参照してください。
コンテナベースのモデルのご紹介 [GA]
公開日: 2023-07-18
コンテナベースのモデルの導入により、コンテナイメージを元にしたモデルを設定できるようになり、Foundry 内でバッチ推論やリアルタイム推論に使用できるモデルの範囲が大幅に広がります。任意の実行ロジックをコンテナイメージにパッケージ化し、そのモデルを Foundry での評価、推論、業務アプリケーションとの統合に使用できるようになりました。コンテナベースのモデル資産は、大規模な事前学習済みモデル、Foundry Models がネイティブにサポートしていない言語(R など)で記述されたモデル、またはほかの目的ですでにコンテナ化されているモデルに特に役立ちます。
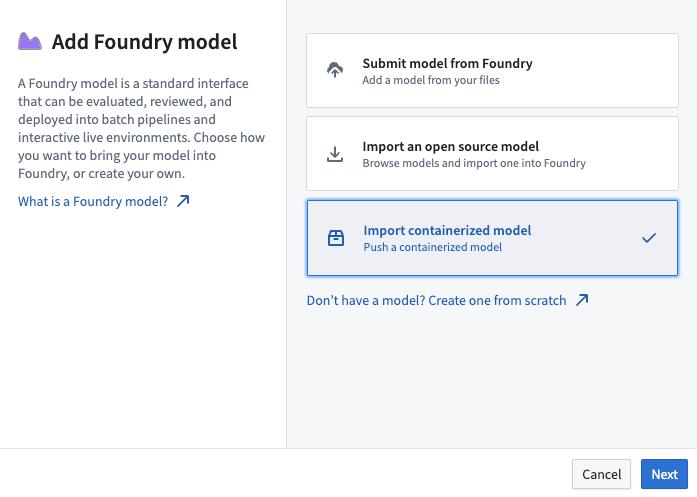
コンテナベースのモデルの主な機能
- 柔軟性:幅広い機械学習フレームワーク、カスタムコード、言語をサポートするようにコンテナを設定できます。
- モデルのバージョン管理:コンテナベースのモデルをモデルバージョンにパッケージ化して、Foundry でモデルを独立して評価、レビュー、リリースできます。
- GPU サポート:推論や実行のために Foundry のさまざまな GPU にアクセスして実行するよう、コンテナベースのモデルを設定できます。
- メディア:コンテナベースのモデルは表形式データとメディアデータにアクセスでき、Foundry 内でコンピュータービジョン、音声、動画のワークフローをネイティブに設定できます。
コンテナベースのモデルを設定する方法
- Control Panel でコンテナワークフローを有効にします。
- モデル資産を作成し、そこにコンテナイメージをプッシュします。
- コンテナとやり取りするためのモデルアダプターを作成します。
- コンテナイメージとモデルアダプターを使用してモデルバージョンを設定します。
- コンテナベースのモデルをデプロイし、業務アプリケーションと統合します。
コンテナベースのモデルの作成、デプロイ、管理の詳しい手順など、詳細についてはドキュメントを参照してください。
Home アプリのご紹介 [GA]
公開日: 2023-07-18
Home アプリは、新しくアプリケーションを作成するユーザー向けに設計された、Foundry ワークスペースの新しいデフォルトホームページです。ガイド付きの操作体験を通じて、主要なワークフローの完了方法に慣れ、オンボーディングプロセスを円滑に進められます。
Home アプリの機能は、次のことに役立ちます。
- Foundry 内でユーザーが実行できるさまざまなワークフローを紹介します
- 主要なワークフローに必要なリソース、アプリ、ドキュメントへのアクセスポイントを一元化し、新しい開発者がより容易に作業を進められるようにします
- ユーザーがワークフローの目標を選択できるようにし、それぞれの目標に合わせた Foundry の初期体験を実現します
- ユーザーのスタックと、利用可能な Foundry アプリケーションおよびリソースに基づいて、効率的な開始点を推奨します
- オントロジー、データセット、さまざまな Foundry アプリケーションがエコシステム内でどのように位置付けられるかを、ユーザーが明確に理解できるようにします
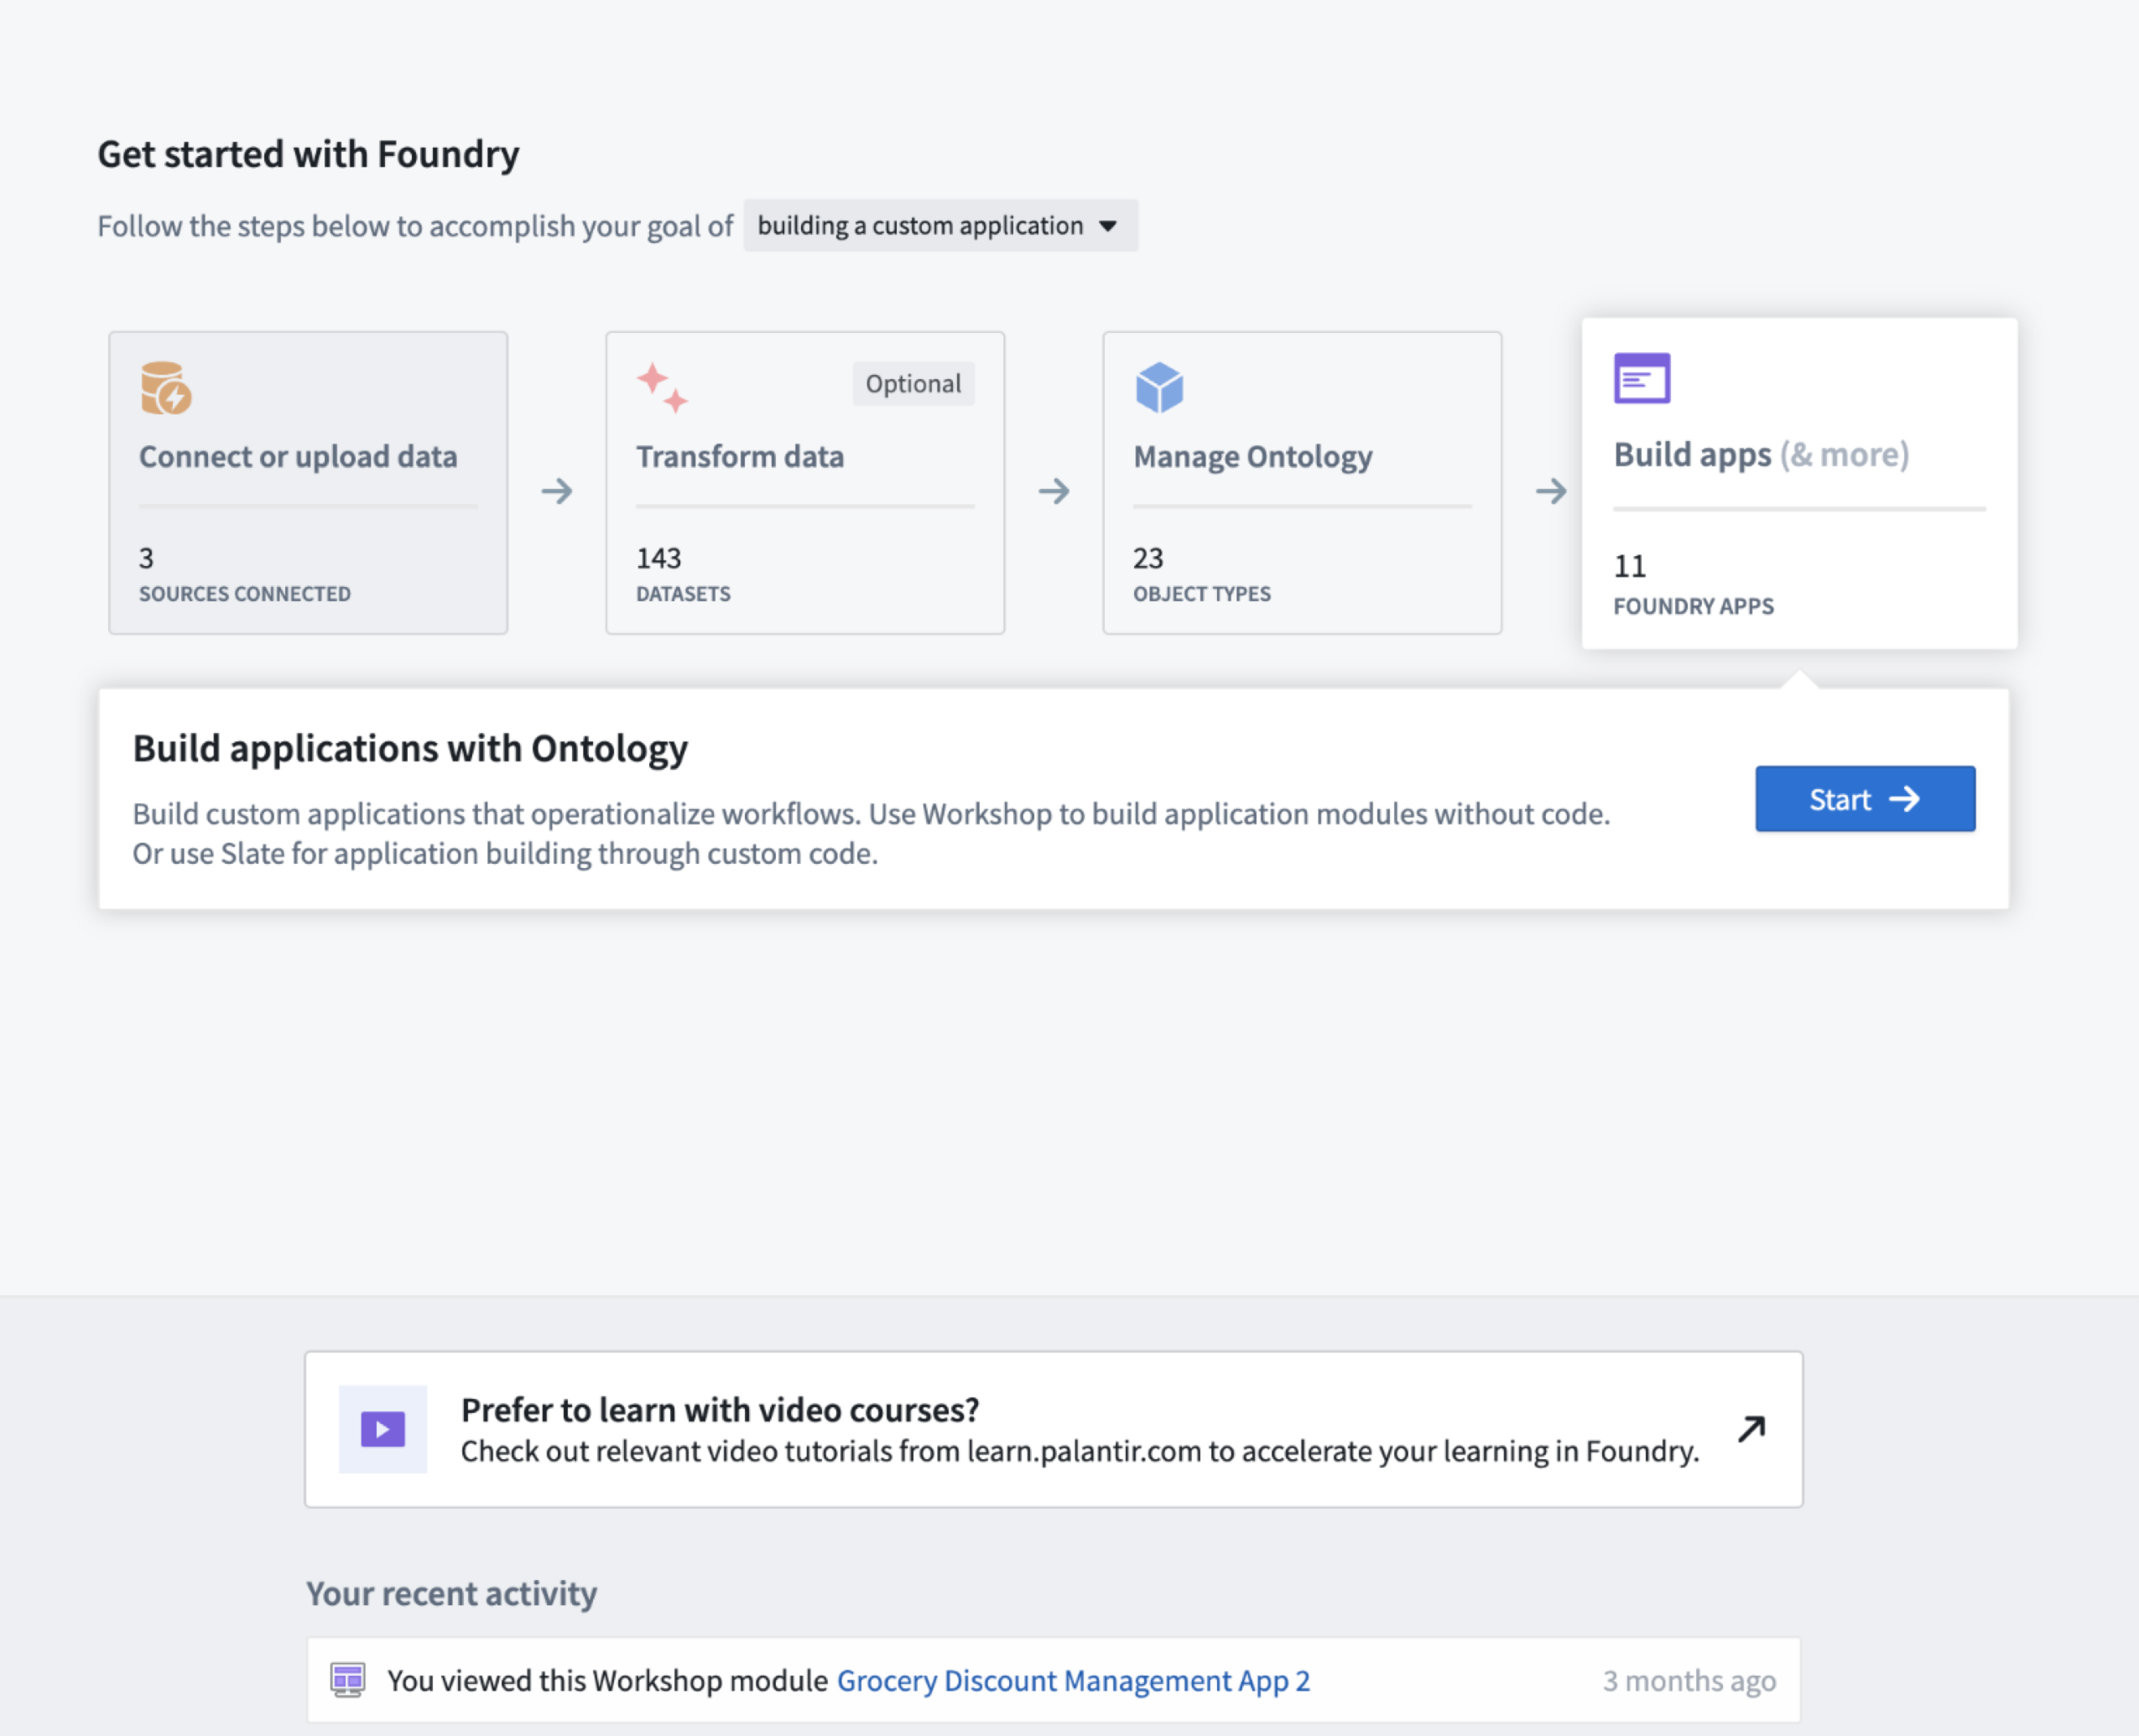
Home アプリをデフォルトのホームページに設定する
Home アプリはすべてのインスタンスに自動的にインストールされ、既存のアカウントと新しいアカウントの両方に導入されます。Home アプリをスタックのデフォルトホームページに設定するには、Control Panel でホーム URL の設定にアクセスし、すべてのユーザーまたは特定のユーザーグループのホームページとして /narrative を選択します。スタックで Home アプリを表示するには、/workspace/narrative にアクセスします。
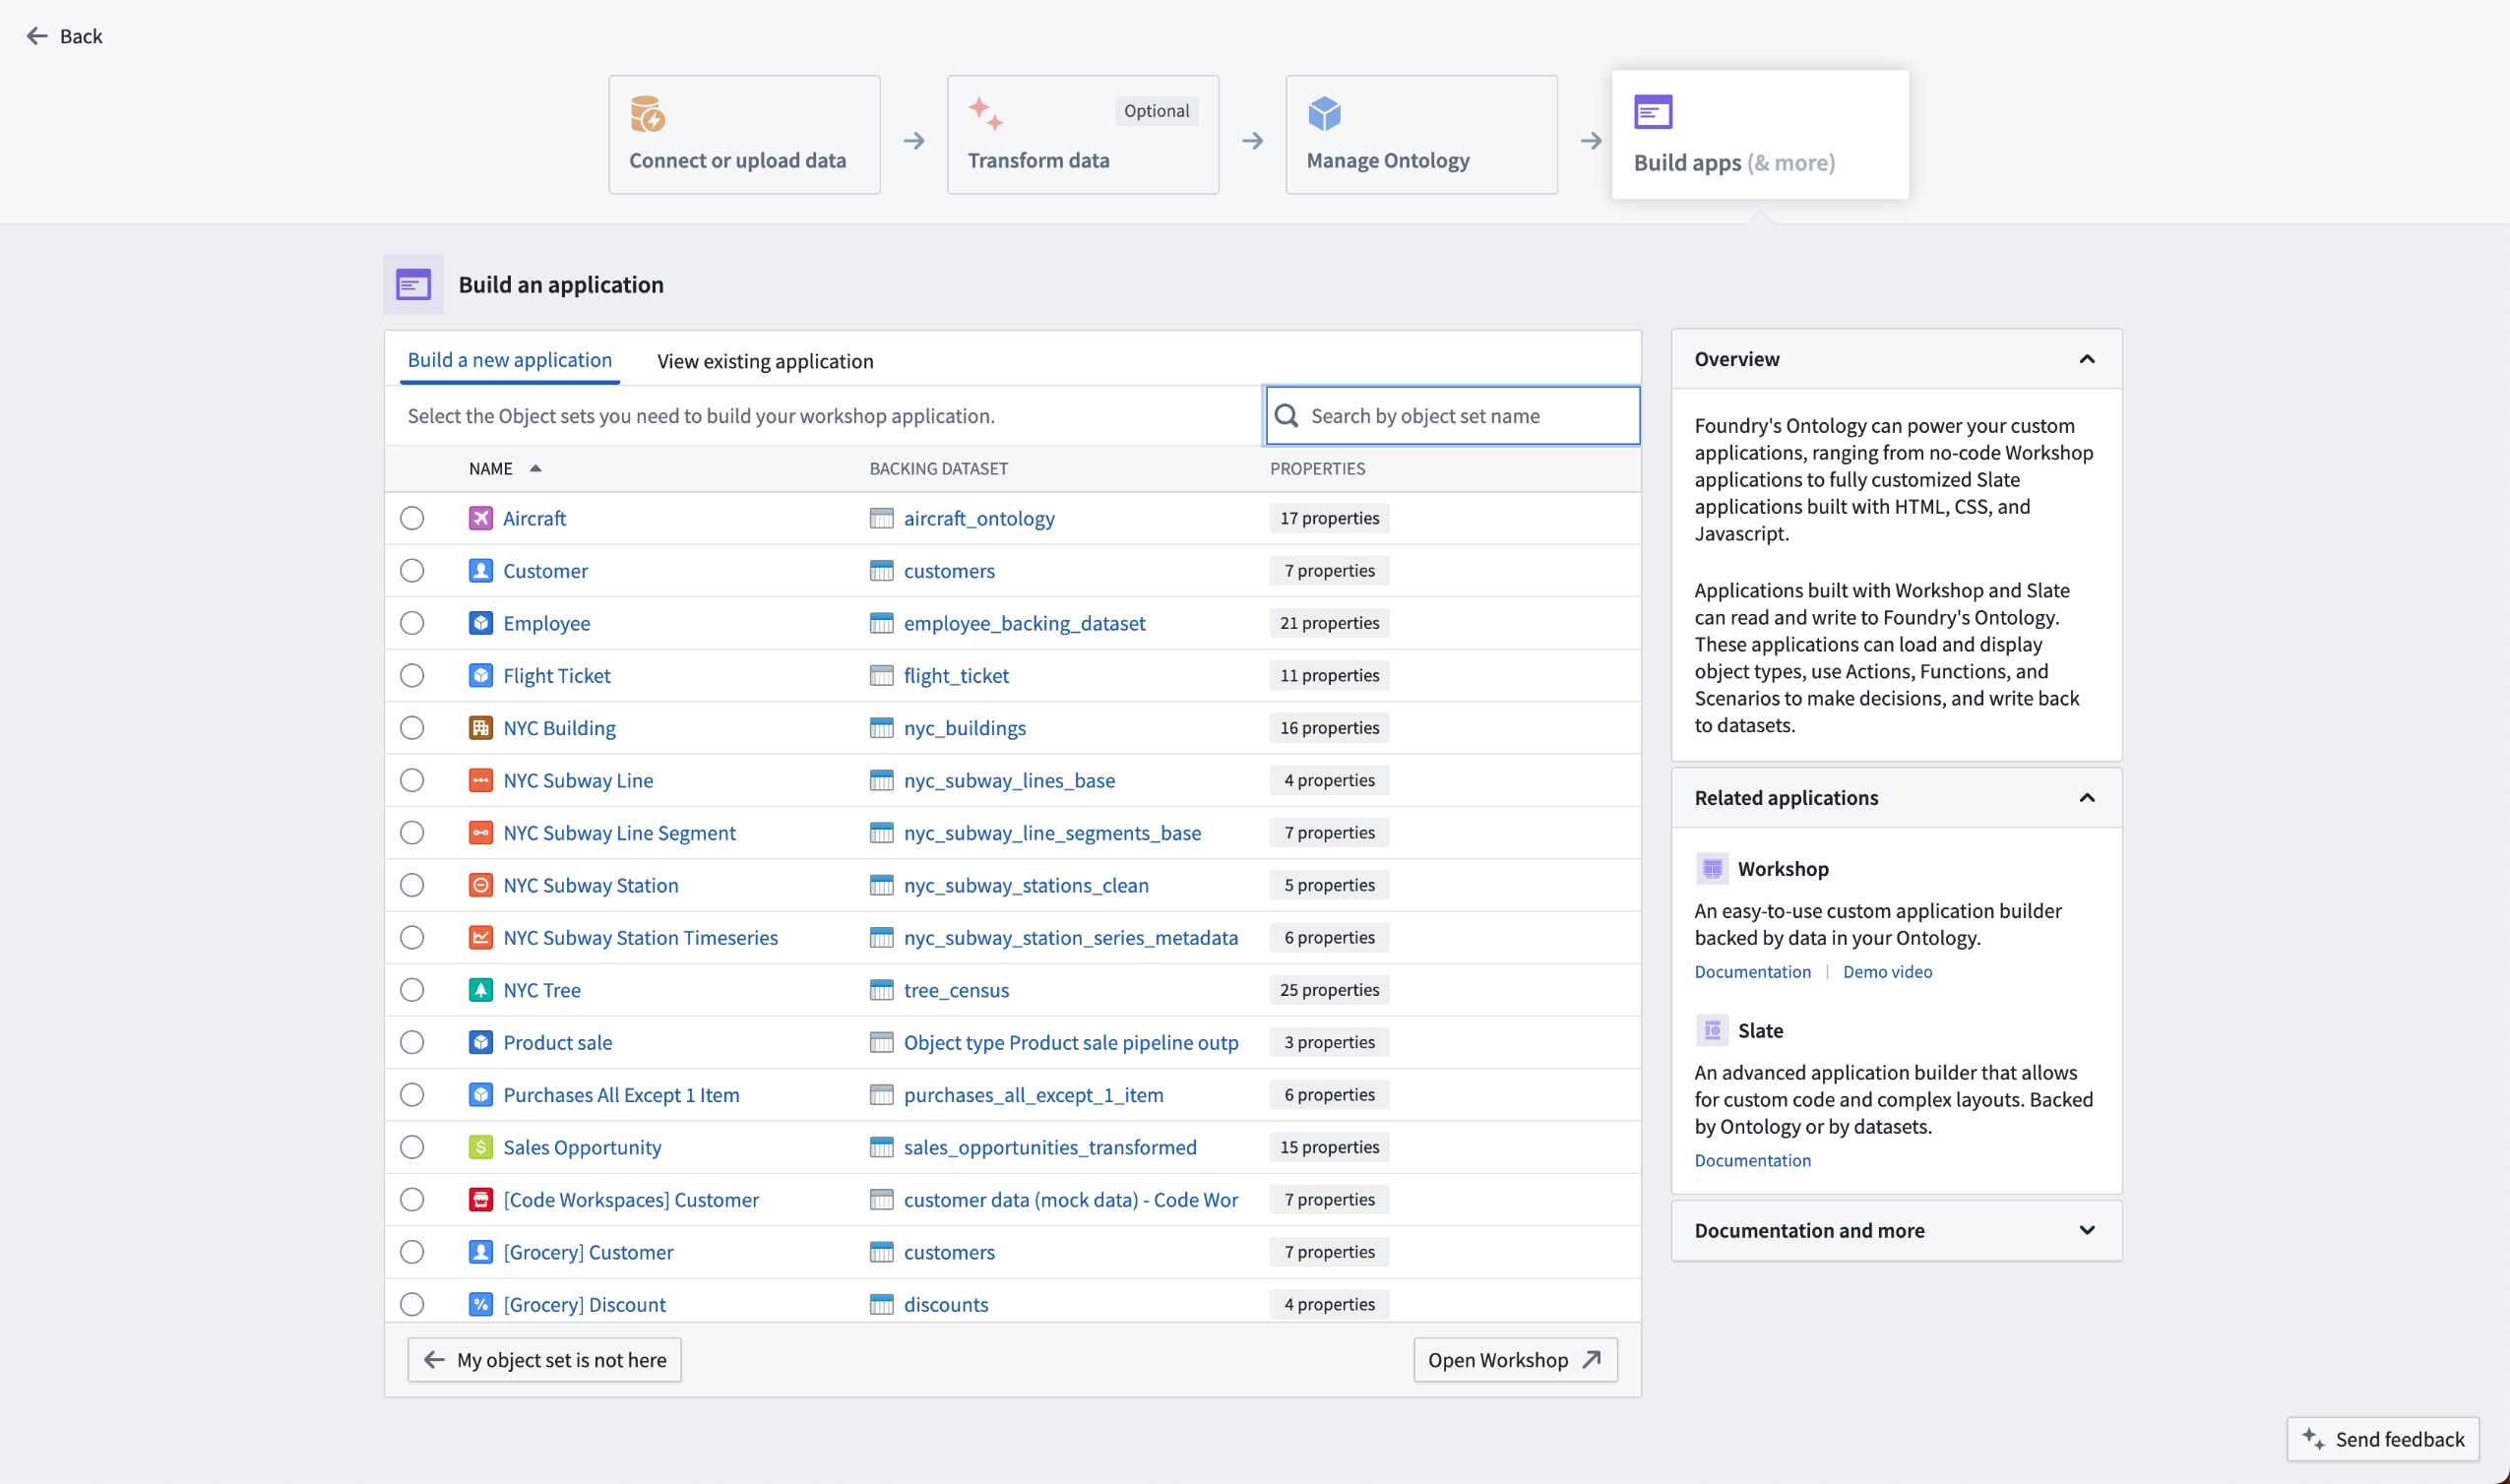
プラットフォーム体験の設定に関するドキュメントで詳しくはこちらをご覧ください。
Foundry Quicksearch がデフォルトで有効に
公開日: 2023-07-18
Foundry Quicksearch がすべてのユーザーに対してデフォルトで有効になり、より高速で直感的な検索体験を提供します。7月末までは、UI の「オフにする」ボタンを使用して、レガシーの Foundry Search に一時的に戻せます。その後は Quicksearch が唯一の選択肢となり、レガシー検索のボタンは削除されます。詳細については、Quicksearch のドキュメントと Quicksearch の GA のお知らせをご覧ください。
時系列の更新されたワークフローと UI のご紹介
公開日: 2023-07-18
Foundry の時系列セットアップワークフローは、データを適切な形式に変換し、分析を充実させる堅牢なオントロジーを構築し、ビジネス上重要な意思決定を行うための分析アプリケーションや業務アプリケーションを作成する、複数の段階にわたります。時系列のセットアッププロセスにウォークスルーと更新されたユーザーインターフェースが加わり、Foundry の新規ユーザーと既存ユーザーのどちらにとっても使いやすくなりました。
時系列ワークフローを探索するためのウォークスルー
データセットプレビュー、Ontology Manager、Pipeline Builder で、新しいウォークスルーが利用可能になりました。これらの便利なガイドでは概念とワークフローを紹介しており、確認することで Foundry での時系列データの使用について理解を深められます。
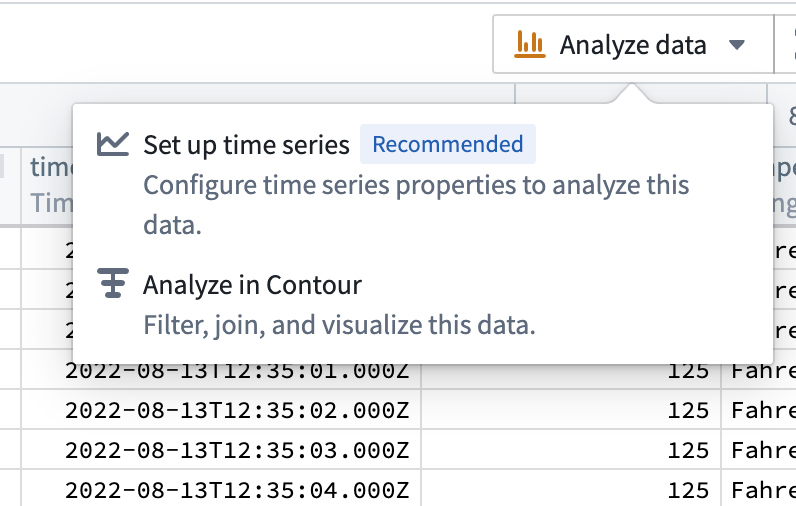
データセットプレビューでは、ストリームまたはバッチデータセットから「データを分析」を選択し、ウォークスルーを開いて、時系列ワークフローの主要な概念とセットアップ要件について学べます。
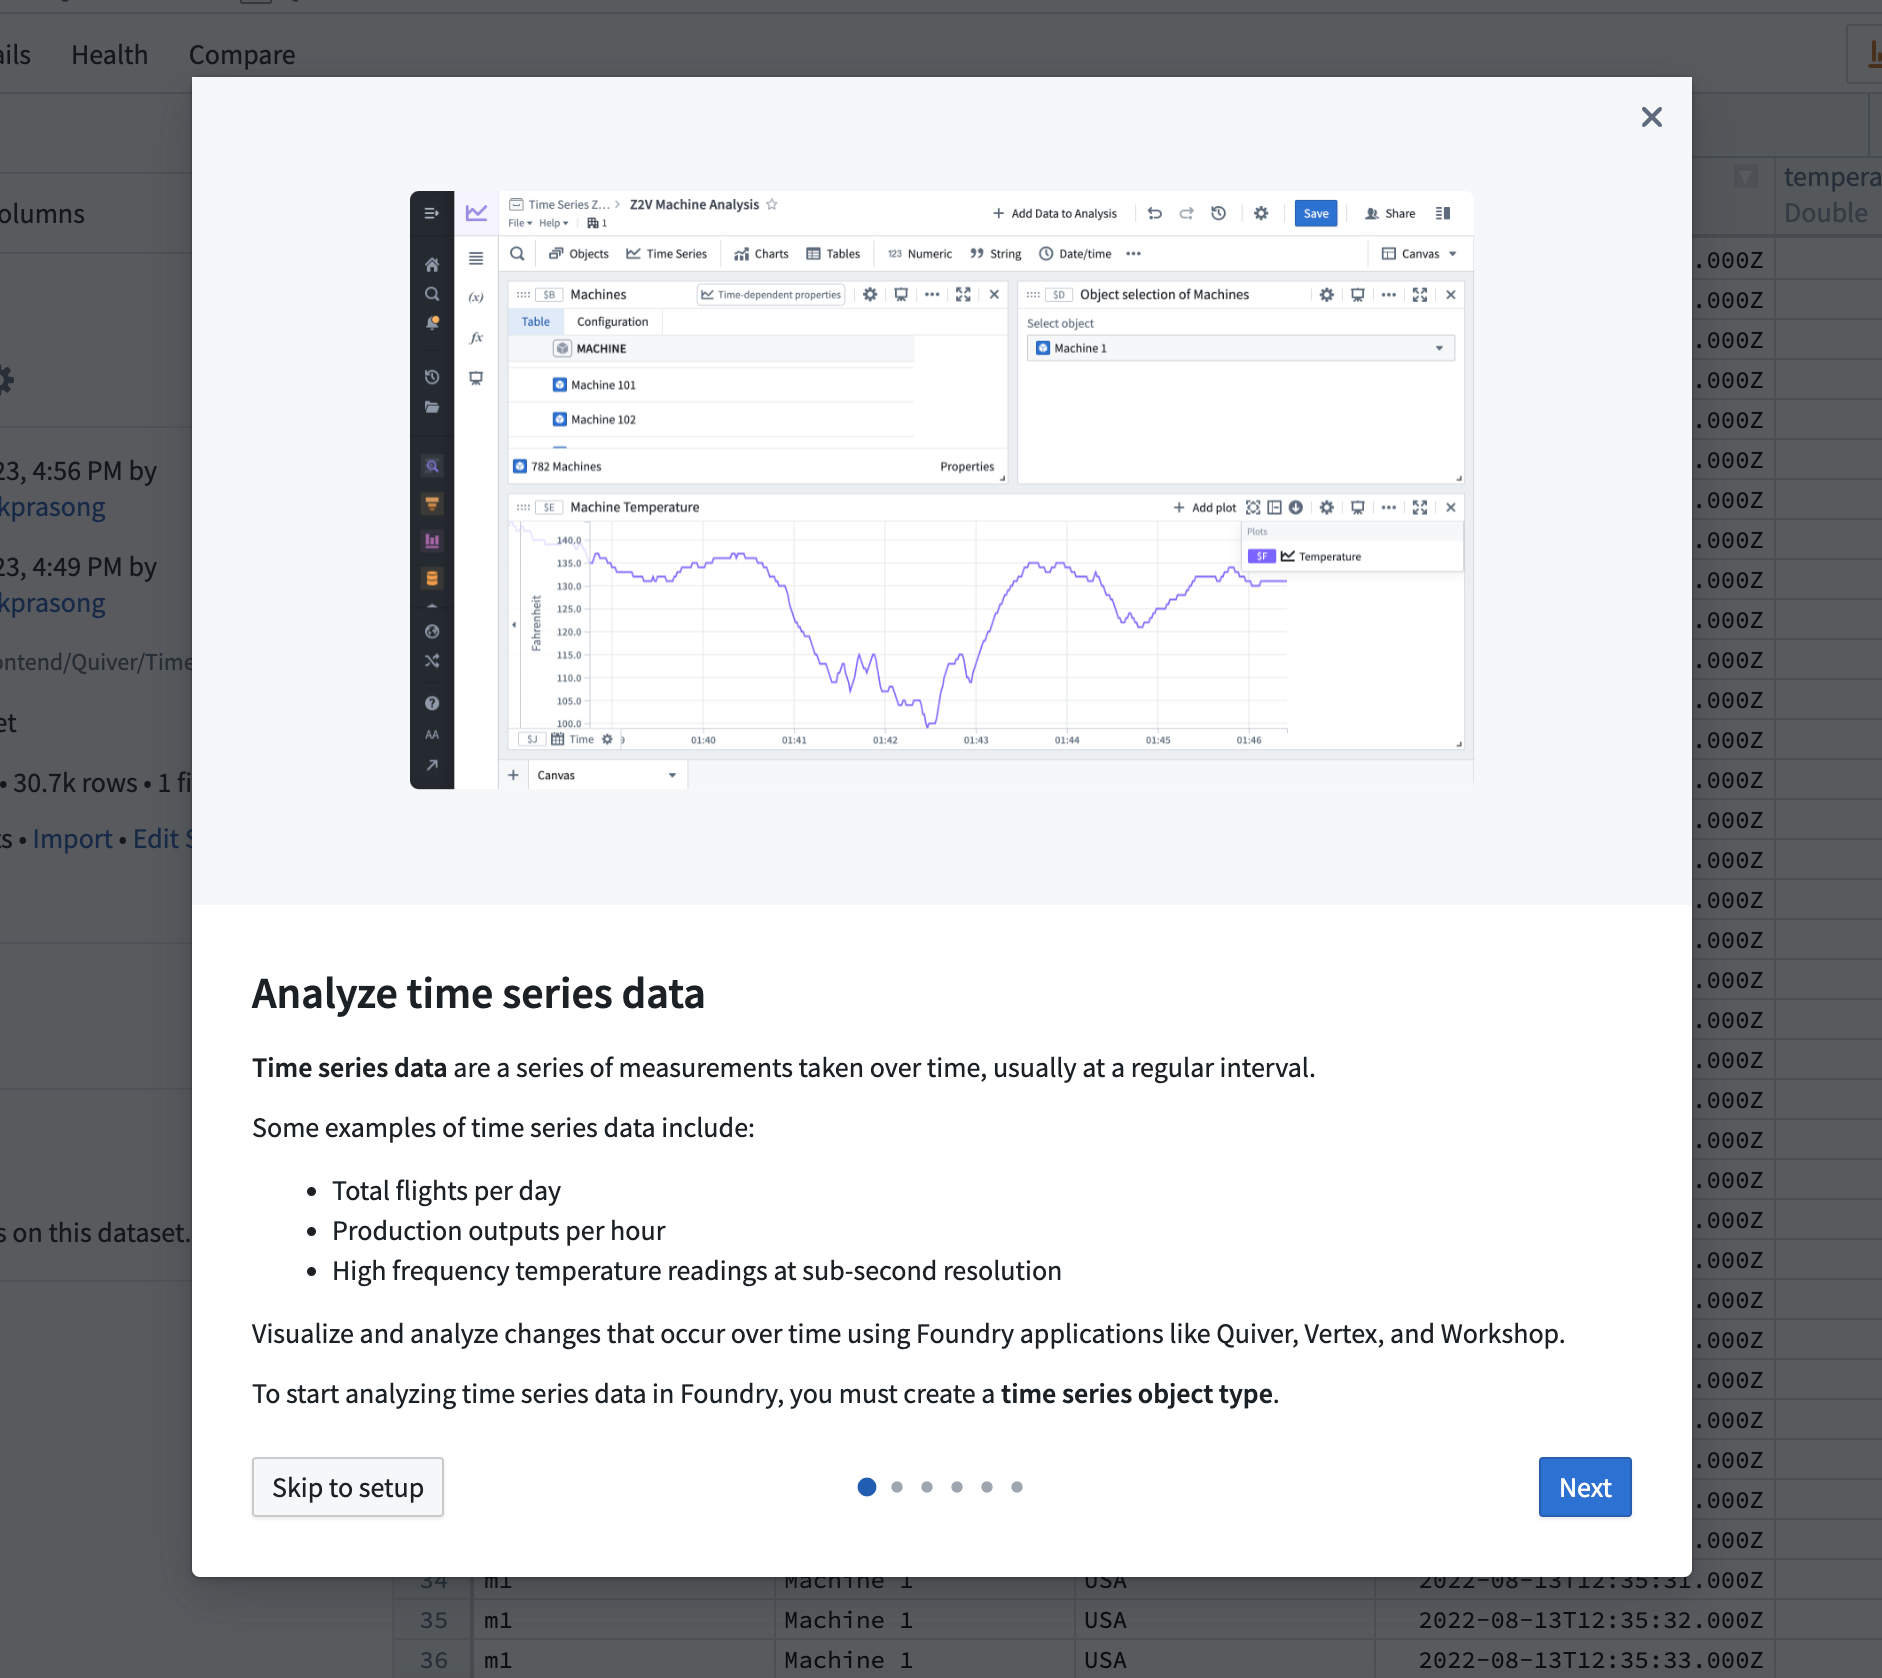
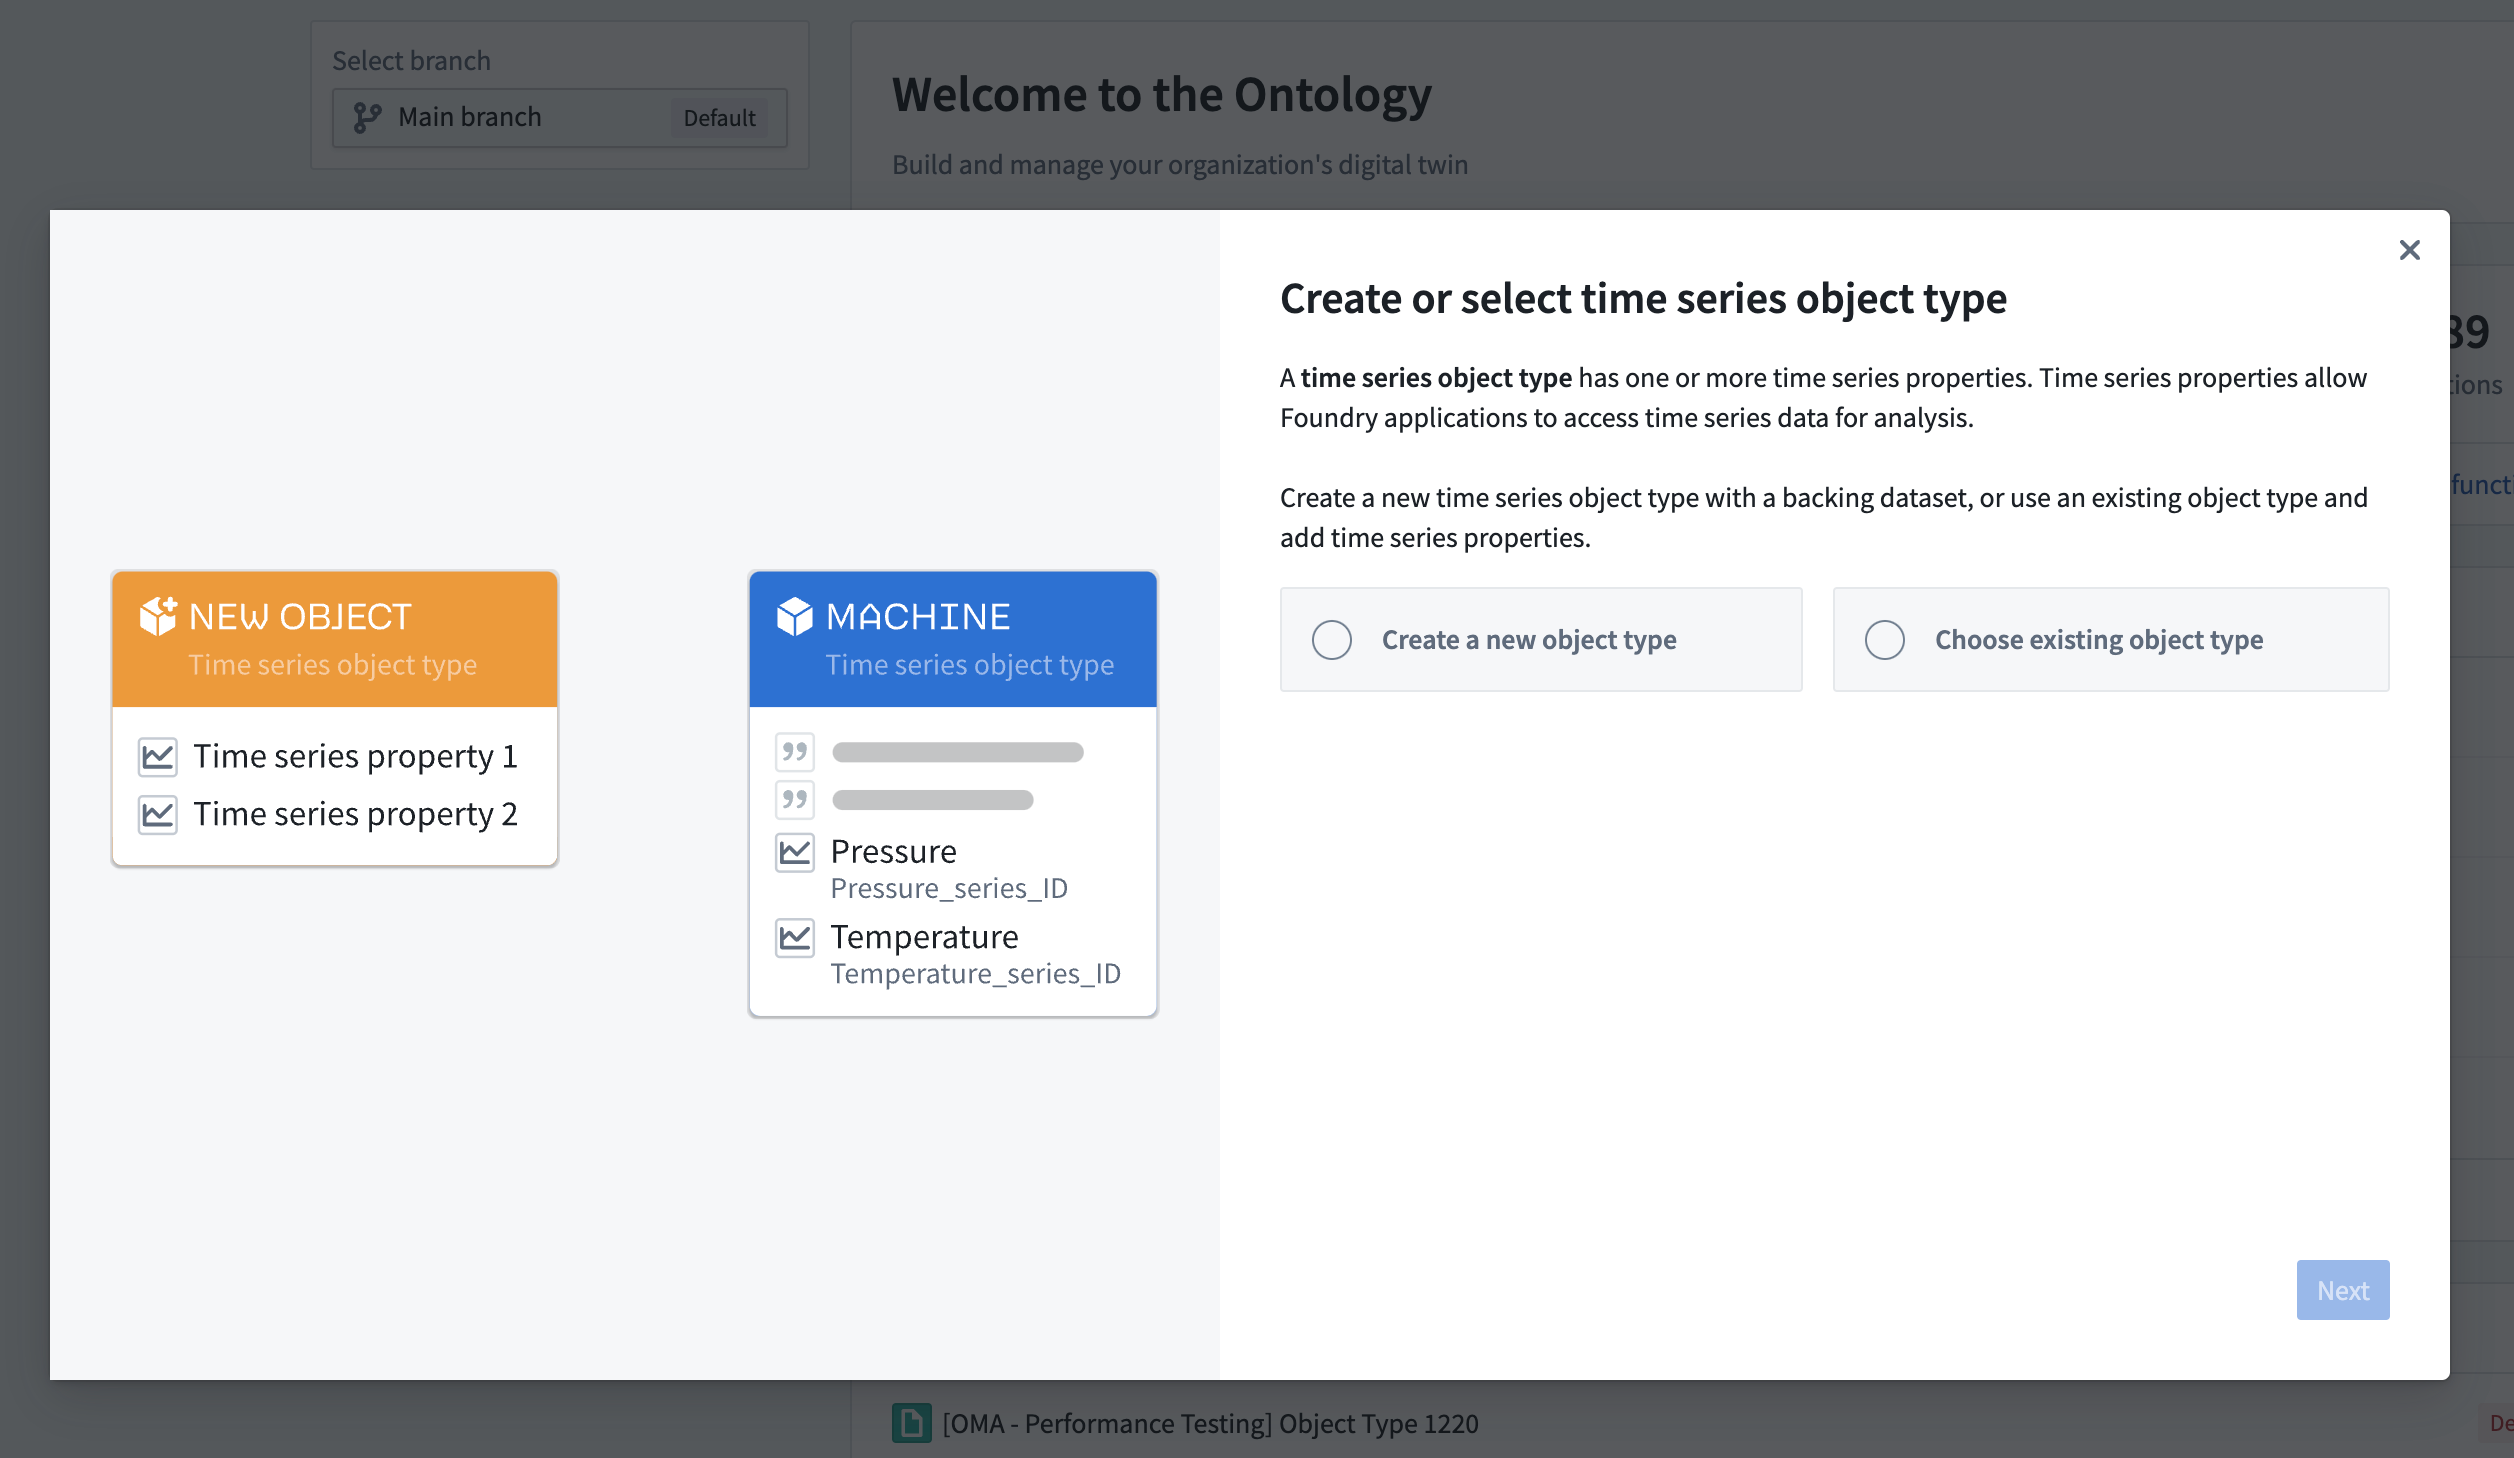
Ontology Manager では、新しいウォークスルーを使って、時系列オブジェクトタイプを作成または選択し、時系列プロパティのセットアップを完了できます。これらのウォークスルーには、Foundry における時系列データのアーキテクチャと使用方法を示す視覚的な例が含まれています。
時系列管理のための改善されたインターフェース
Ontology Manager の更新されたユーザーインターフェースでは、[機能] タブから時系列プロパティを直接作成および管理できます。ここから、既存のパイプラインの時系列同期をリンクしたり、新しいパイプラインを構築して時系列同期を作成したりできます。
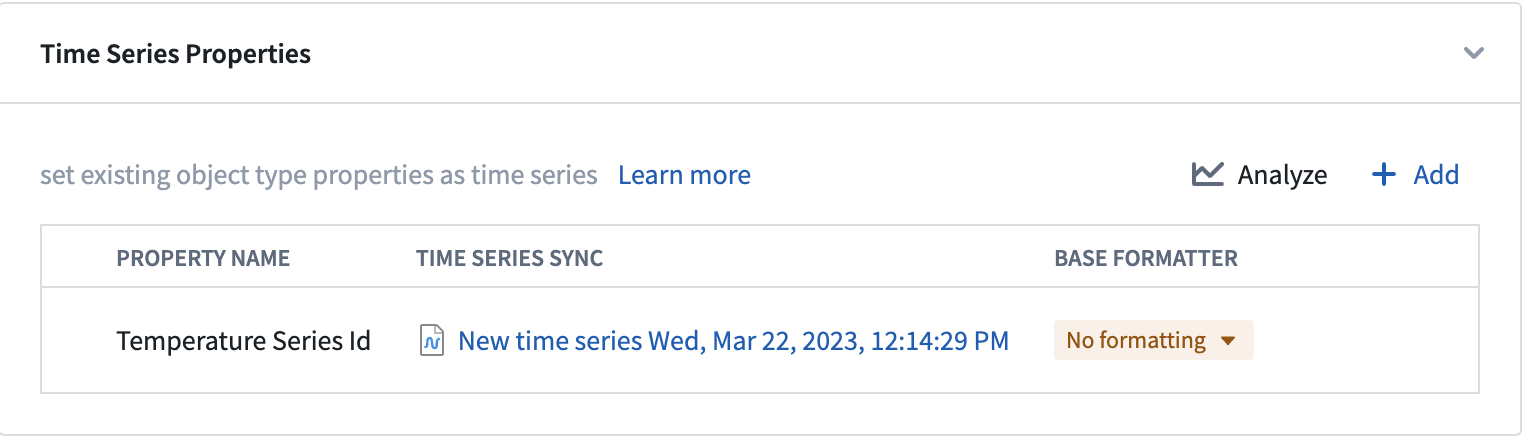
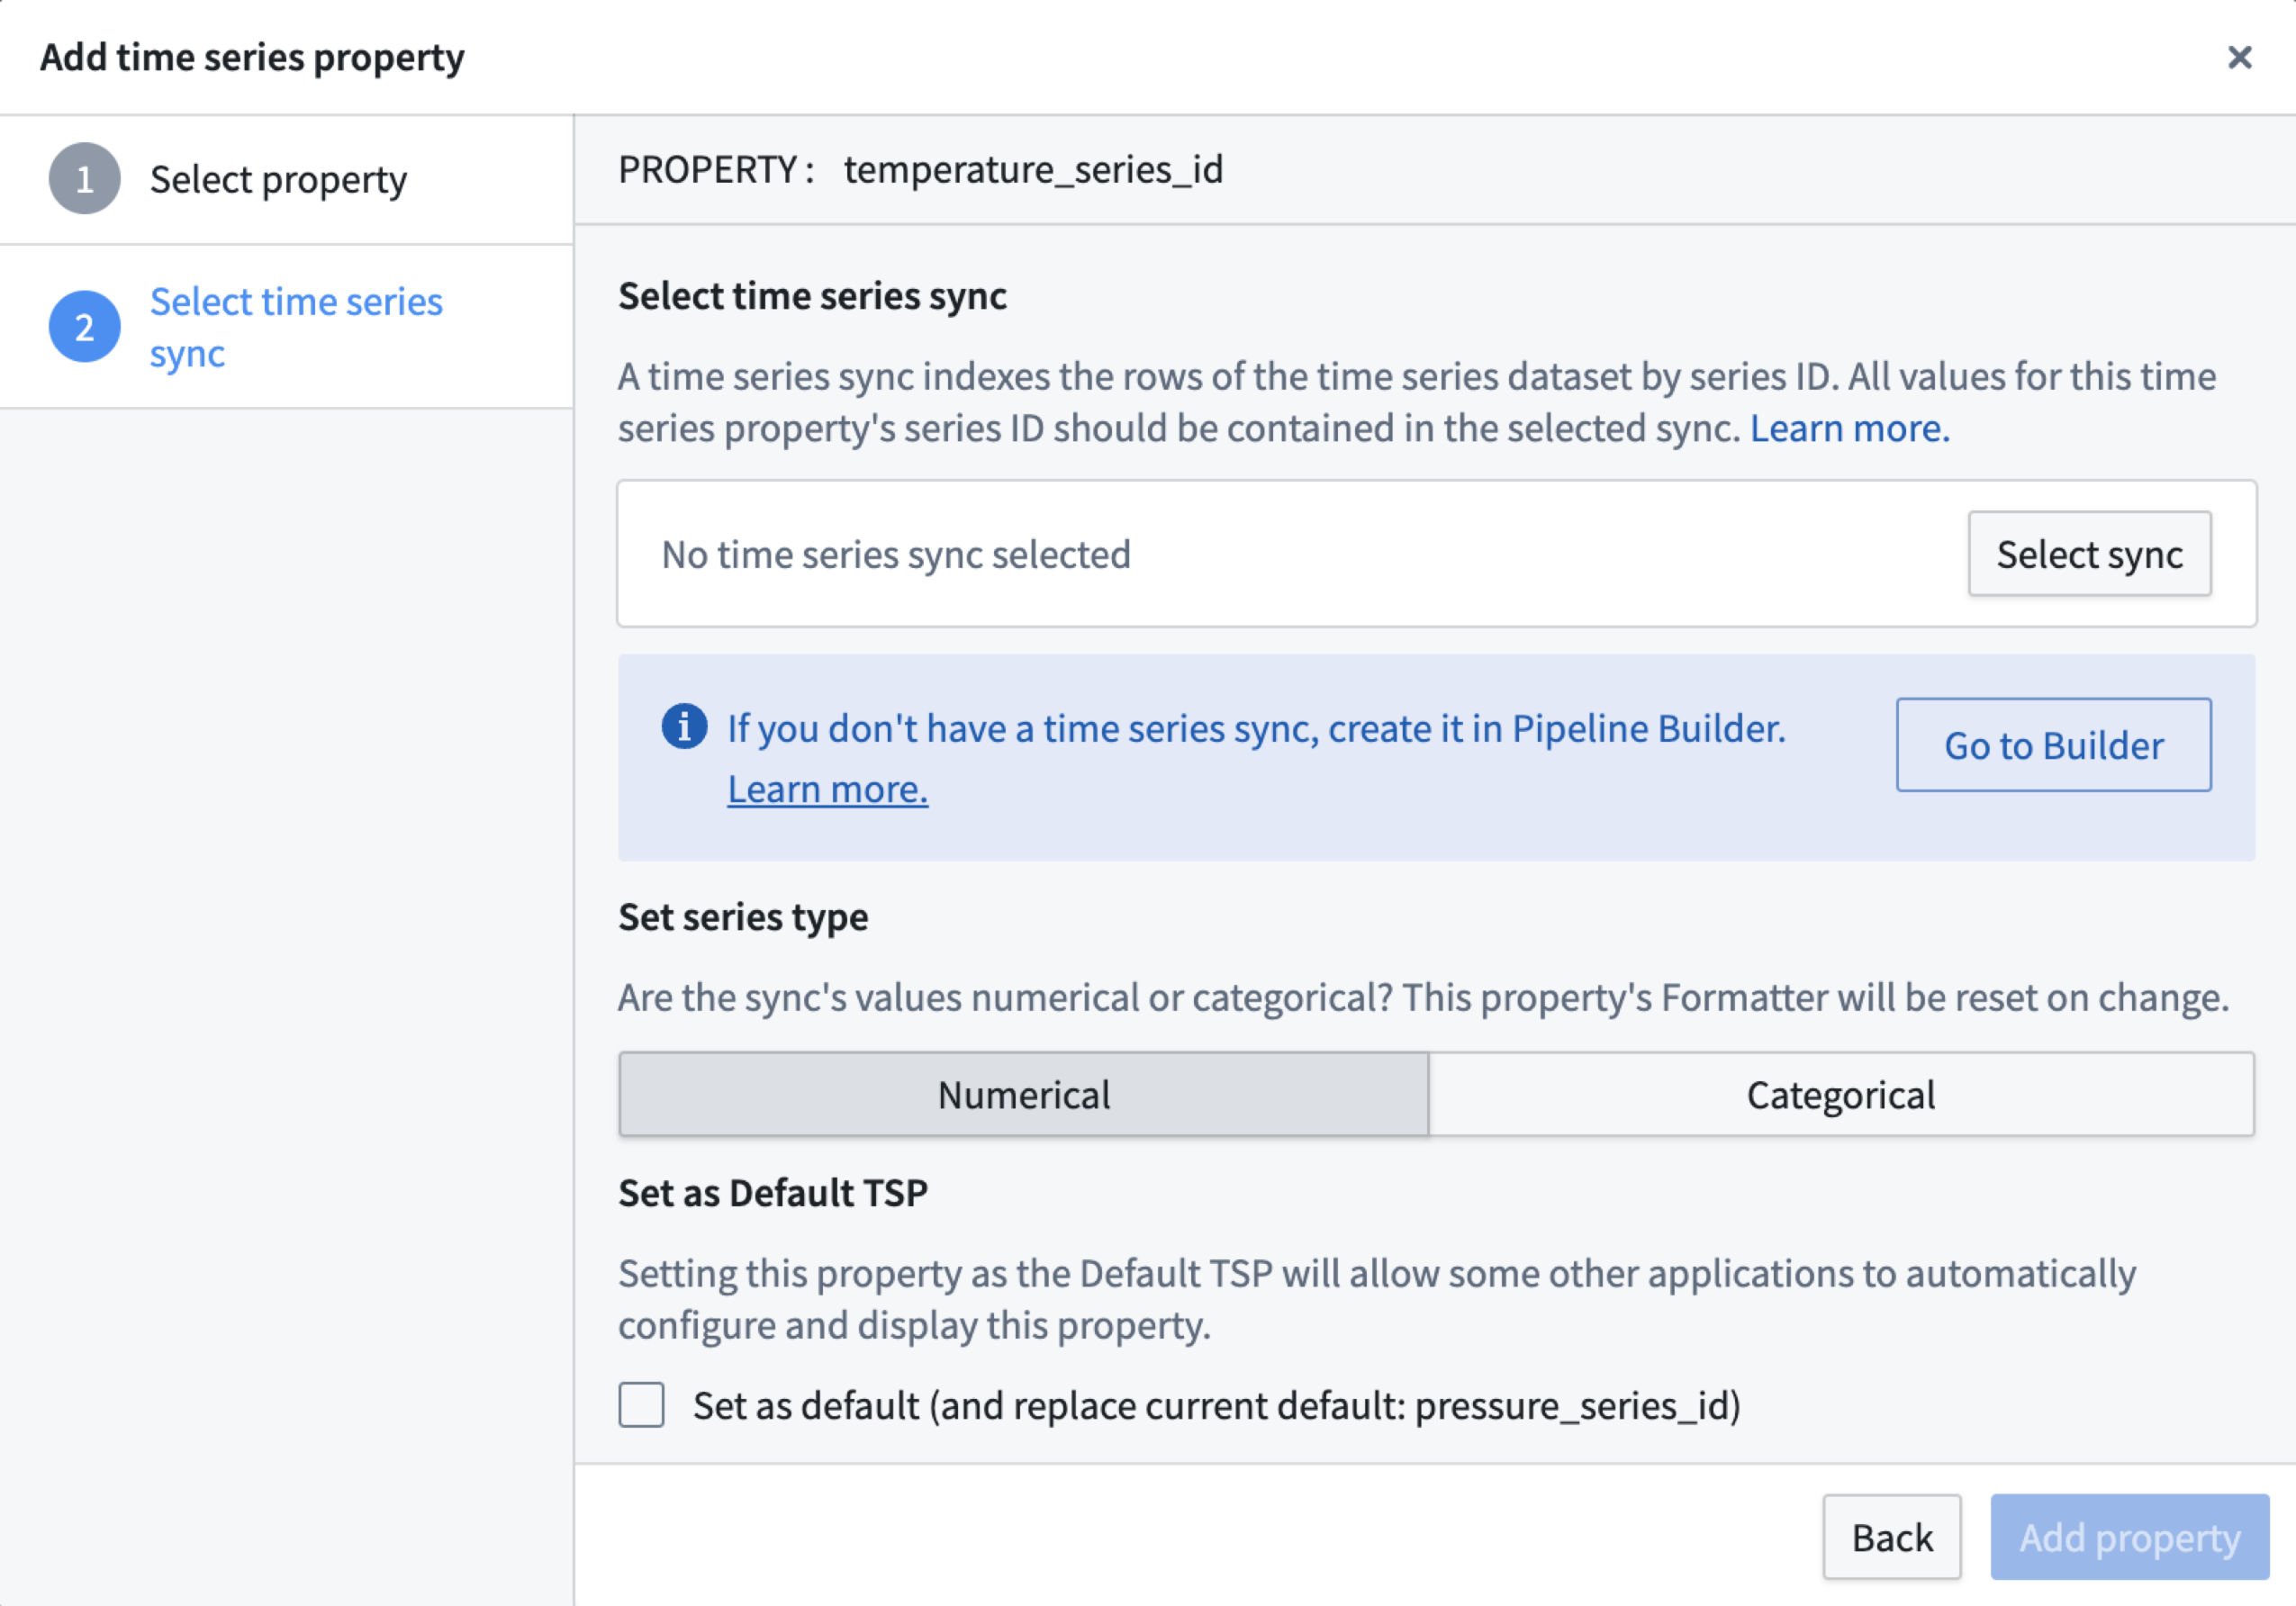
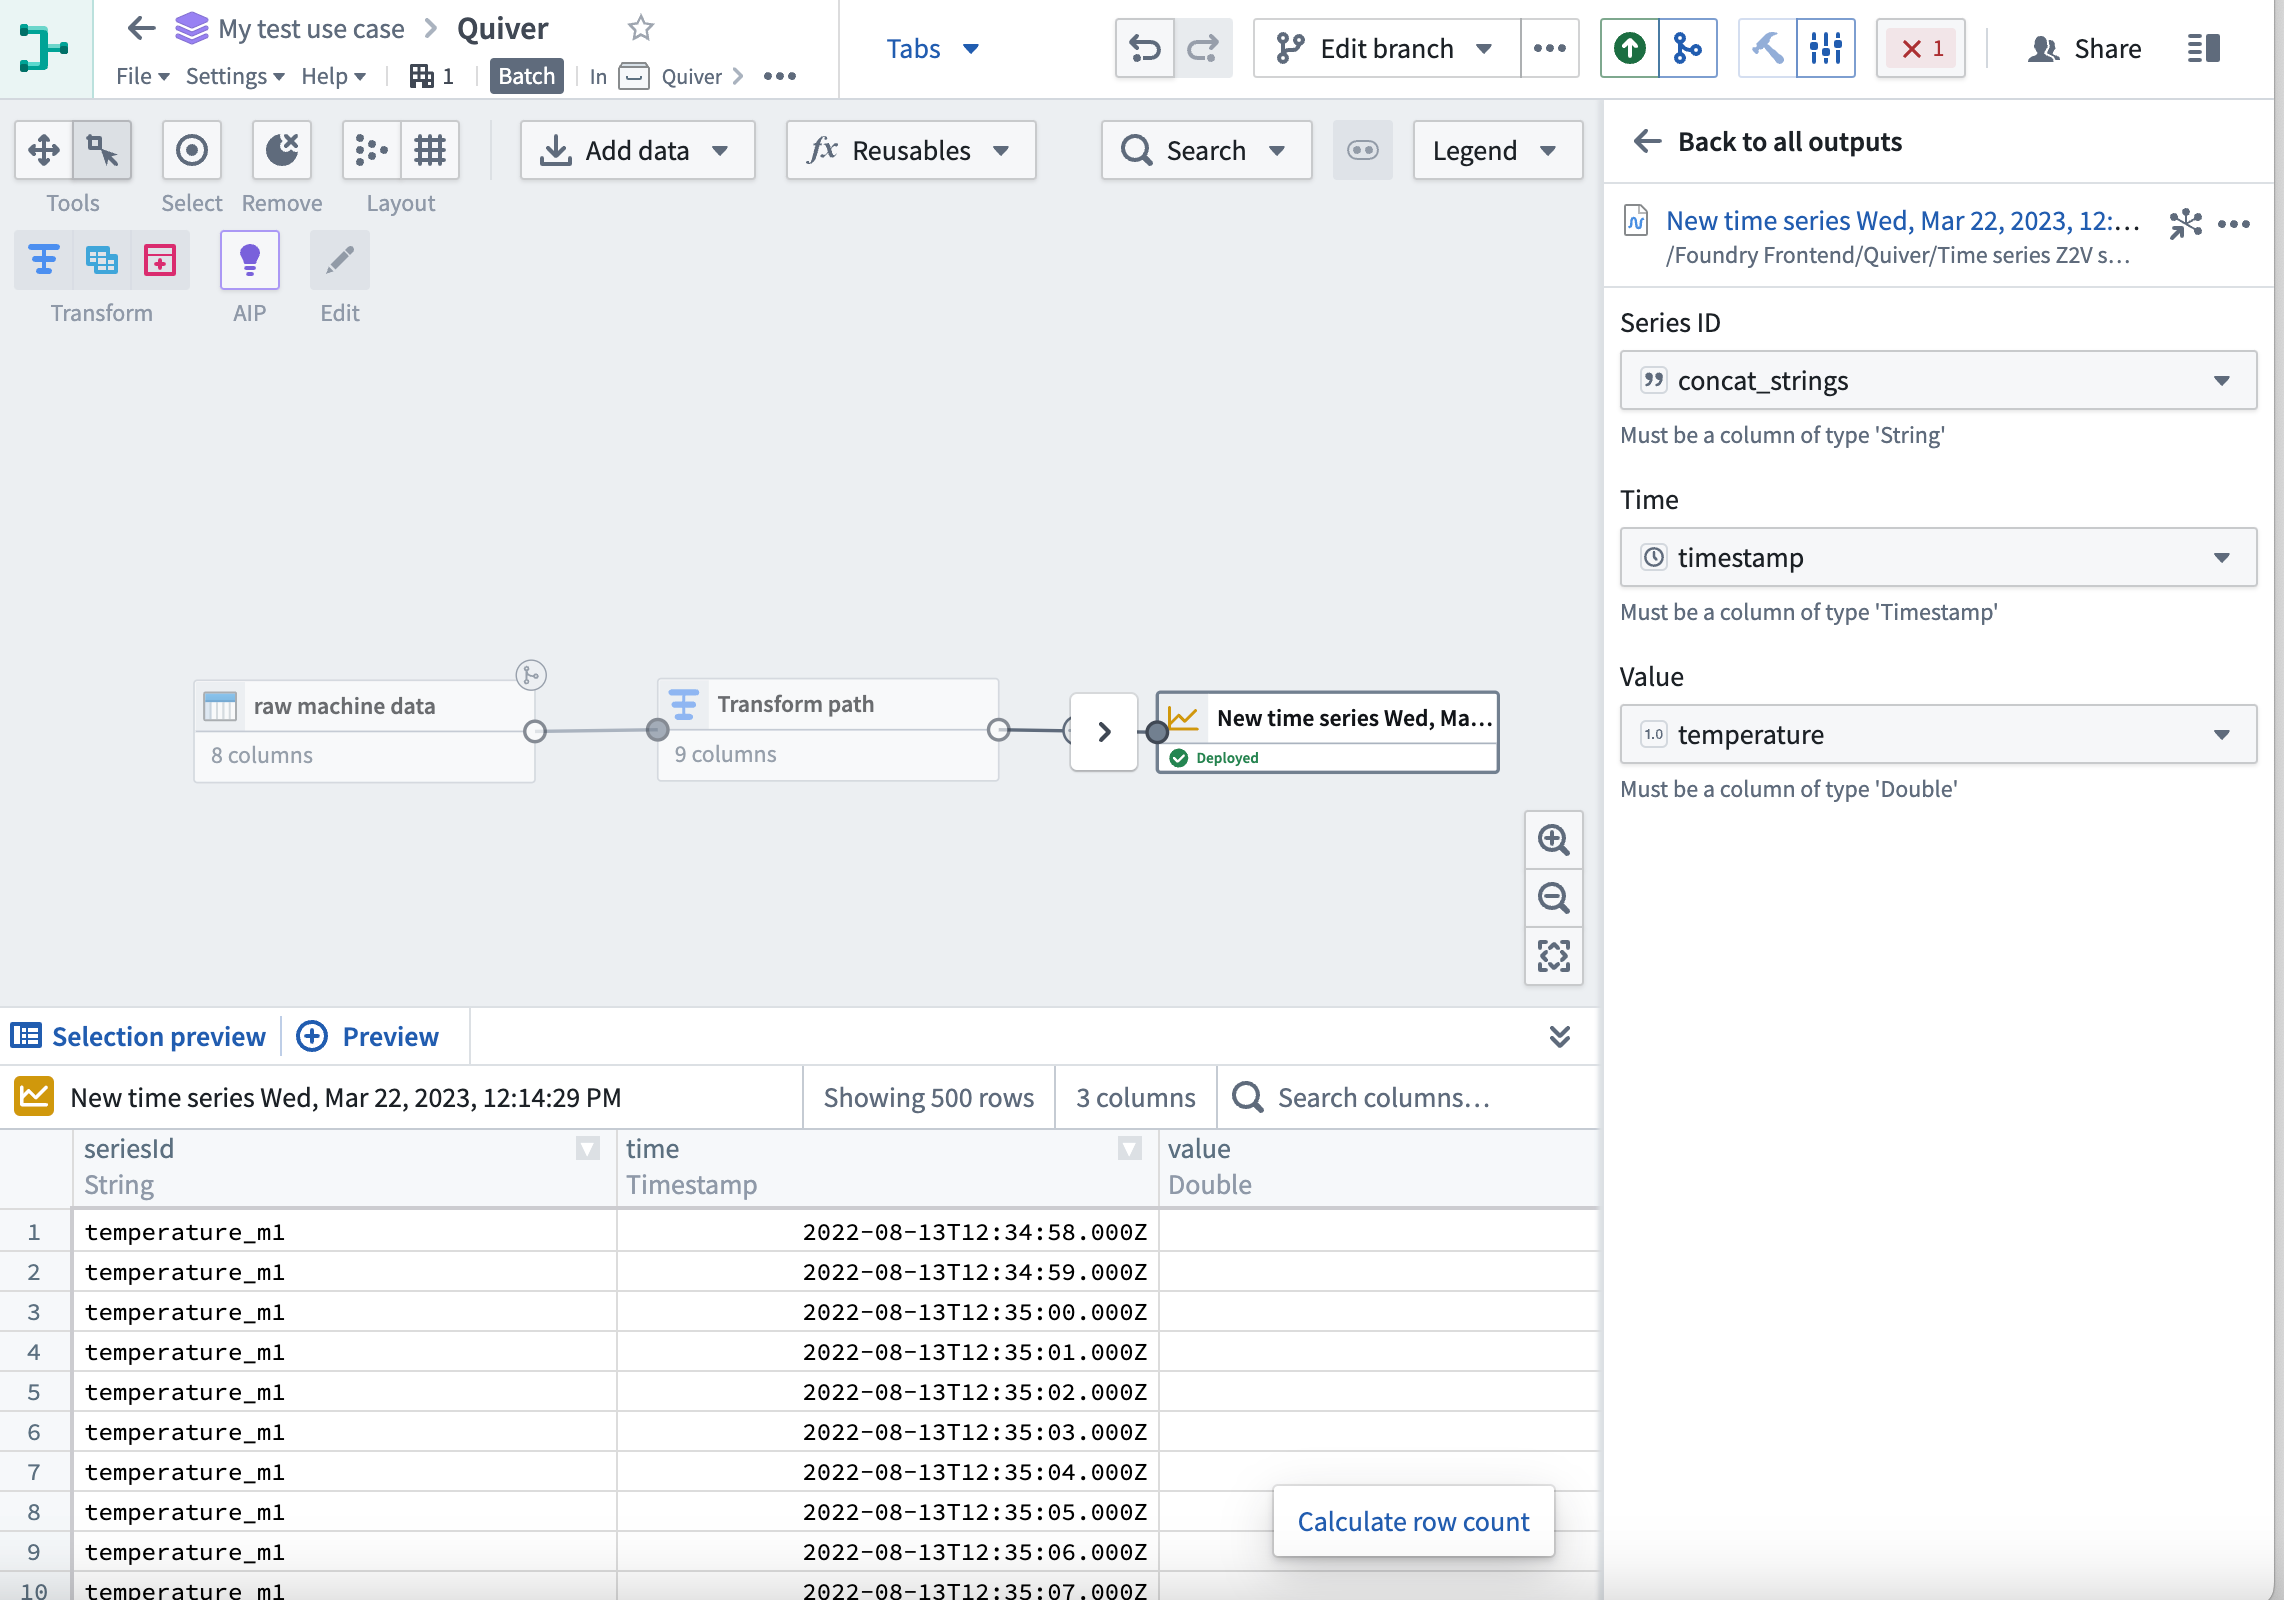
さらに、Pipeline Builder は、ストリーミングまたはバッチの時系列データから時系列出力を作成する機能を完全にサポートするようになりました。Pipeline Builder の出力について詳しくはこちら。
更新されたワークフローと新機能の詳細については、時系列のドキュメントをご覧ください。主要な概念と、データから分析までのエンドツーエンドのセットアッププロセスが更新されています。
開発ロードマップには何がありますか?
Palantir の時系列製品を製造、自動化、プロセス管理の分野で業界をリードする製品にするという目標の一環として、一連の作業を直感的かつ容易にする重要な領域への投資を続けています。現在、次の機能を開発しています。
- 派生時系列とカテゴリカル時系列で時系列ワークフローを強化:プラットフォーム内で作成および管理します。
- 派生系列を生成:Quiver のビジュアル関数 UI を使用して、派生時系列を作成します。Quiver、Workshop、Vertex などのアプリケーションから、派生時系列と非派生時系列を同じ方法で操作します。
- カテゴリカル時系列を作成:Workshop、Object Explorer、Quiver で、プラットフォーム全体のカテゴリカル時系列プロパティを可視化します。当面は、Workshop のメトリックカードとオブジェクトテーブルでカテゴリカル時系列のサポートを追加することに重点を置きます。
- Measures の概念を刷新:分析アプリケーションや業務アプリケーションで時系列プロパティにアクセスするエンドユーザーに対し、プロパティがルートオブジェクトタイプに直接存在するか、リンクされたセンサーオブジェクトに存在するか(たとえば Measures 経由)に関係なく、統一された体験を提供することで、Measures の概念はオントロジーのセットアップ上の区別に限定されます。
オブジェクトベースのマップレイヤーのご紹介 [ベータ版]
公開日: 2023-07-12
Map のレイヤーエディターで、オブジェクトタイプを選択してマップレイヤーを設定できるようになりました。これらのオブジェクトレイヤーは、新しいバックエンド機能を活用してオントロジーに保存されたデータから直接タイルを生成することで、極めて大規模なオブジェクトデータを処理できます。
これまで、同様のワークフローを実現するには、追加の独立したサービスとオントロジーの同期を維持するために、多くの手動設定が必要でした。新しいオブジェクトレイヤーにより、オントロジー内のデータを元にしたレイヤーの作成とスタイル設定に必要な作業が大幅に削減されます。
次の画像は、100万個を超えるオブジェクトをリアルタイムで可視化できるレイヤーを作成するプロセス全体を示しています。
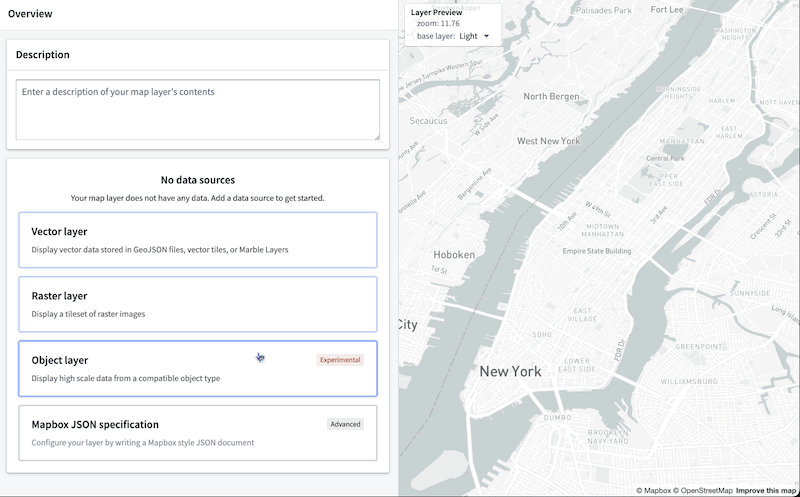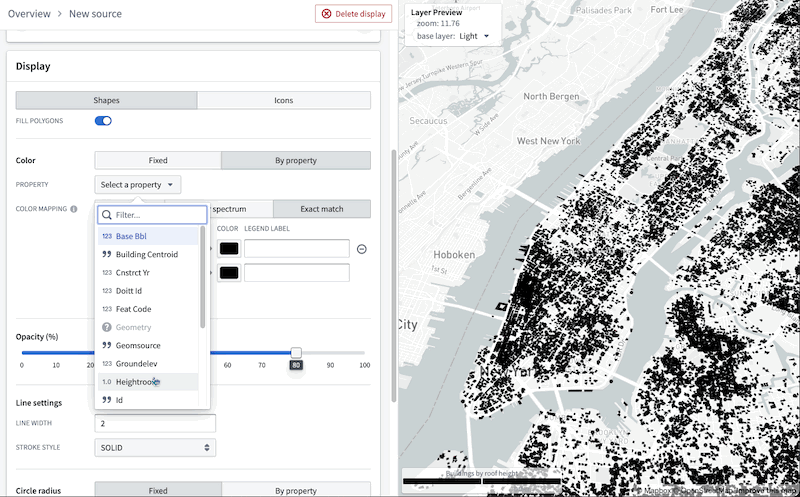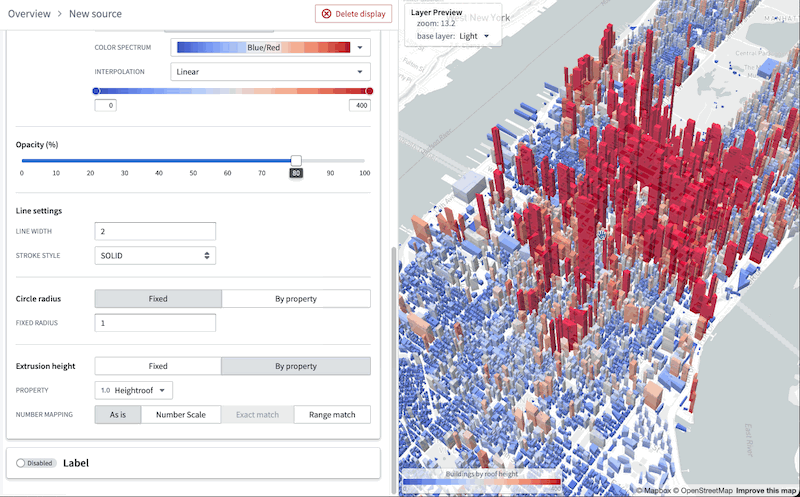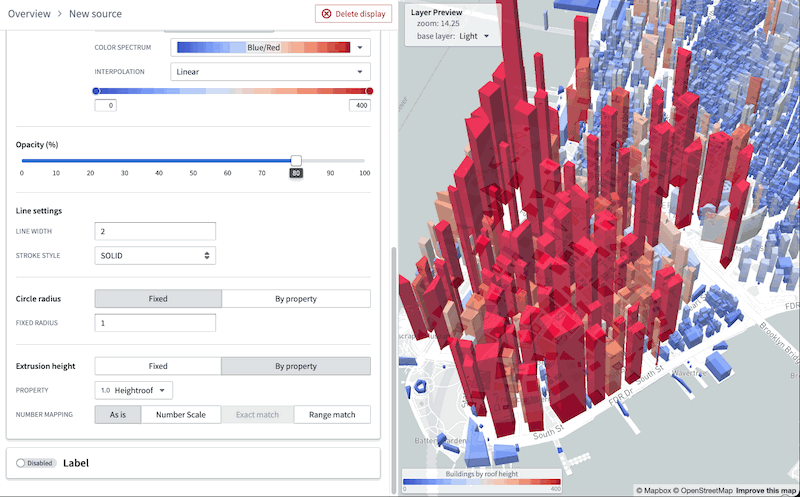
さらに、マップレイヤーエディターの強化されたユーザーインターフェースを利用して、オブジェクトベースのレイヤーの各列のデータ型を簡単に検証し、外観を設定できます。JSON スタイル仕様を手動で記述する手間がなくなります。
この新機能には OQL が必要ですが、すべてのインスタンスで利用可能なわけではないことに注意してください。詳細については、Palantir の担当者にお問い合わせください。
Workshop の視覚的な奥行きを表現する新しいスタイル機能のご紹介
公開日: 2023-07-12
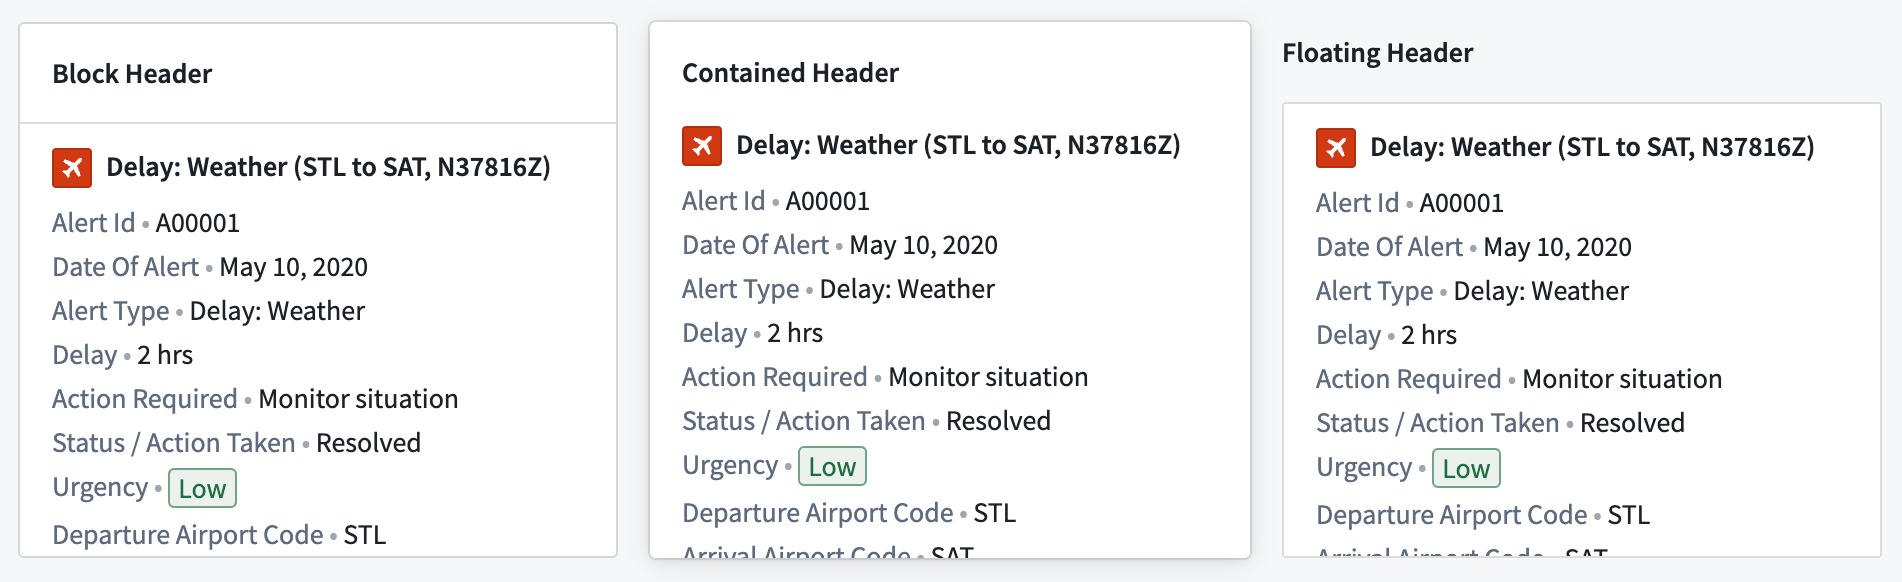
Workshop では、さまざまなスタイルの書式設定をより細かく制御できるようになり、アプリケーション作成者がモジュールのデザインや見た目をさらにカスタマイズできるようになりました。ページ、セクション、ウィジェットの各レベルで、ヘッダーの書式設定、背景色、境界線のスタイルなどを設定できます。
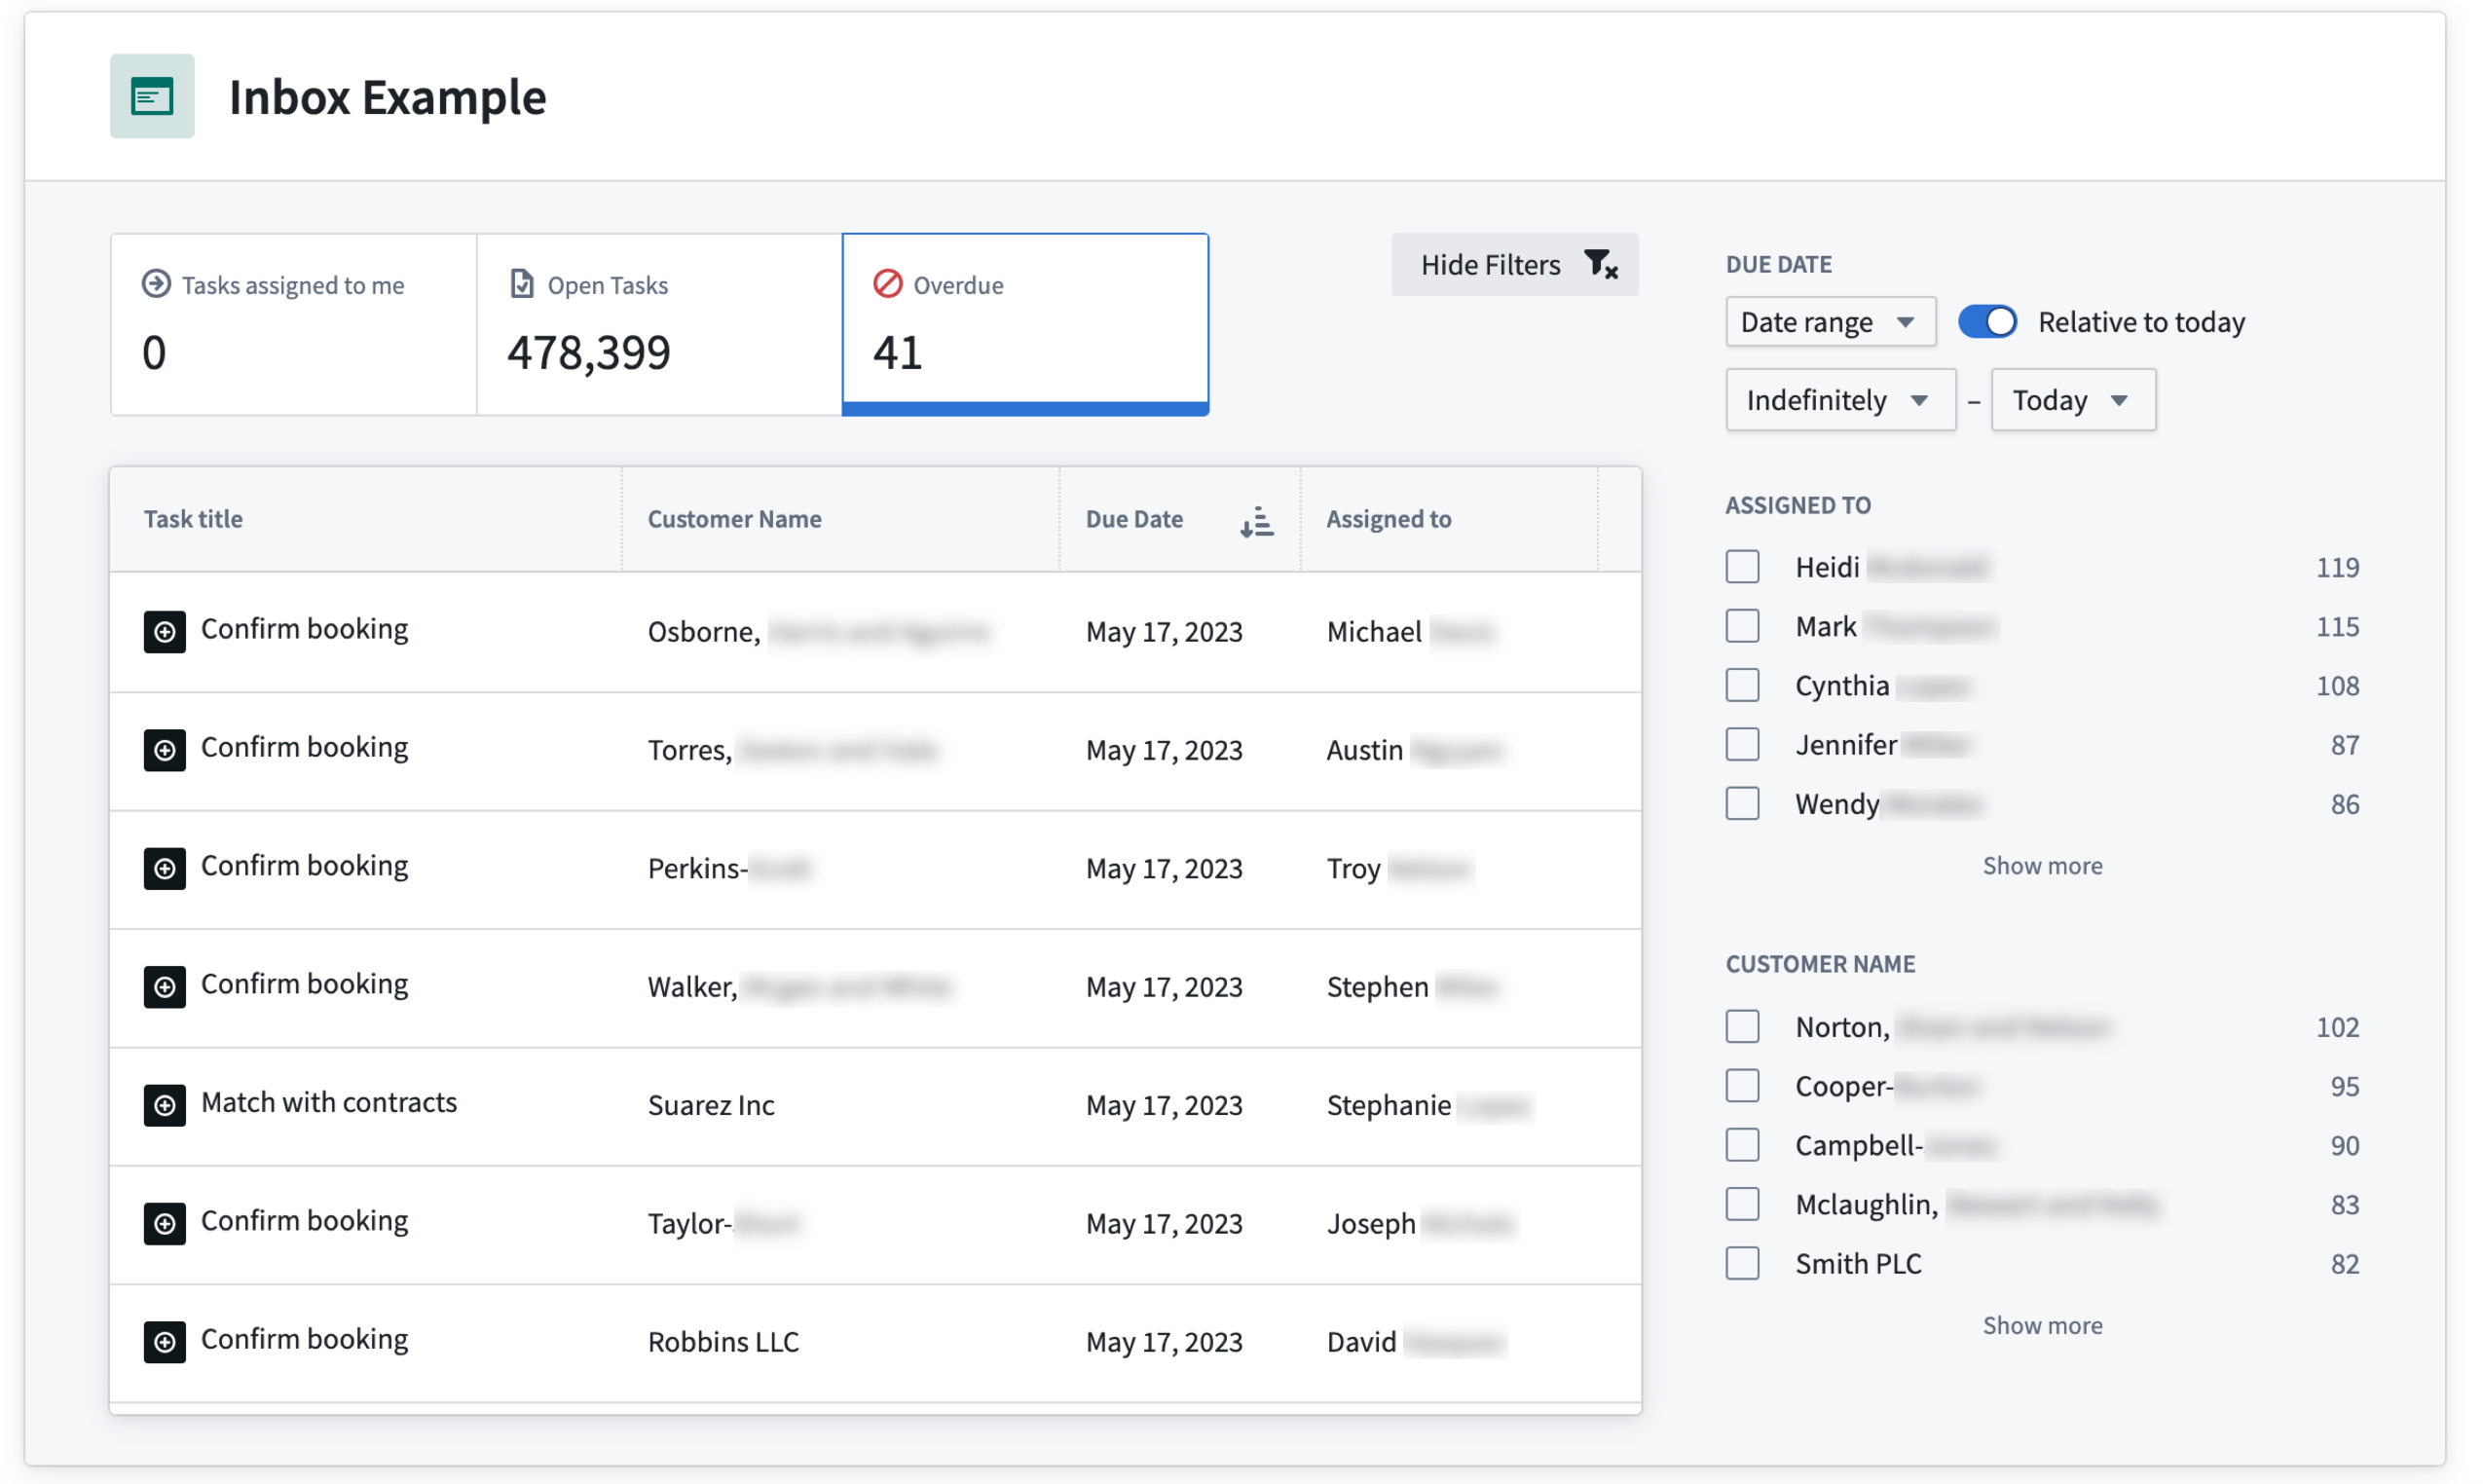
ヘッダーの書式設定
セクションでヘッダーを有効にすると、ヘッダーの書式設定オプションを追加できます。
背景色
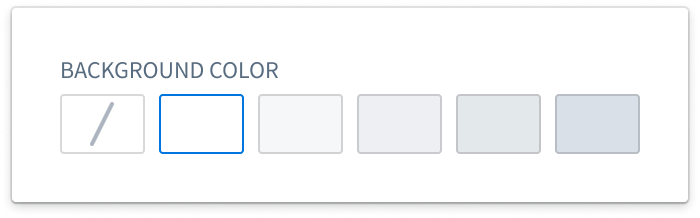
ページ、セクション、ウィジェットに背景色を適用して、モジュールの各部分を視覚的に区切ることができます。ライトモードとダークモードのそれぞれで5段階の色合いと、透明の選択肢を利用できます。
境界線のスタイル
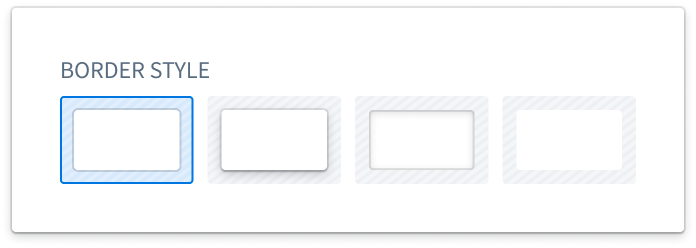
セクションとウィジェットに境界線のスタイルを設定することで、モジュール内で異なる高さに配置されているように見せることができます。
パディング(内側の余白)の制御
ページとセクションにパディングを設定して、内部のすべての子コンポーネントの周囲に一定のパディングや間隔を設けることができます。パディングによってコンポーネント間に間隔を設けると、モジュール内の要素が区切られ、ゆとりのある表示になります。
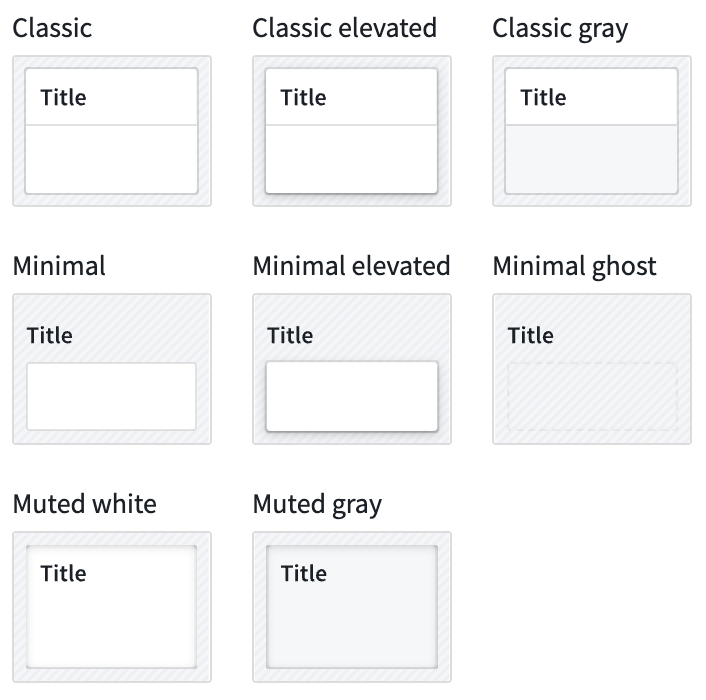
これらのスタイルを適用する方法については、ドキュメントのレイアウトを参照してください。
Contour のロジックを Pipeline Builder にエクスポートする
公開日: 2023-07-12
Contour では、ほとんどの Contour 分析を Pipeline Builder に直接エクスポートできるようになりました。これにより、本番アプリケーションにデータを供給するエンドツーエンドのパイプラインを構築するための包括的な機能を活用できます。
Contour 分析から Pipeline Builder に直接アクセスできるため、Foundry ユーザーは使いやすいインターフェースを通じてオントロジーの柔軟性と強力な機能を活用できます。Pipeline Builder で使用できるようにパイプラインを変換した後は、効率的なデータ統合、カスタムコンピューティングプロファイル、共同作業、型安全性、インクリメンタル(差分処理)モードなどに対するアプリケーションの充実したサポートを活用し、ワークフローの基盤をさらに発展させることができます。また、AIP が有効になっているインスタンスでは、自然言語のプロンプトによる追加機能も活用できます。
まず、既存の Contour 分析を開き、Pipeline Builderに変換を選択すると、同等のパイプラインが Pipeline Builder に作成されます。

プロンプトに従ってエクスポートするパイプラインの保存先フォルダーを選択すると、Pipeline Builder で開くことができるようになります。
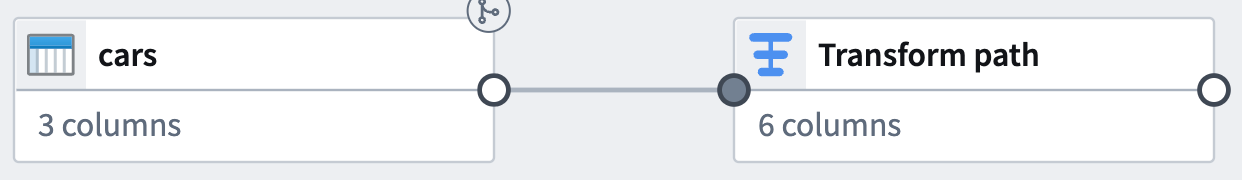
詳細については、ドキュメントの Contour のロジックを Pipeline Builder にエクスポートするを参照してください。
Ontology Proposals のご紹介 [GA]
公開日: 2023-07-06
オントロジーブランチでは、提案と承認のワークフローを組み込んだバージョン管理システムを使用して、オントロジーへの変更を提案できます。これにより、ほかのメンバーとの共同作業が容易になり、オントロジーへの変更の透明性が高まります。
オントロジーの提案では、次の機能を活用できます。
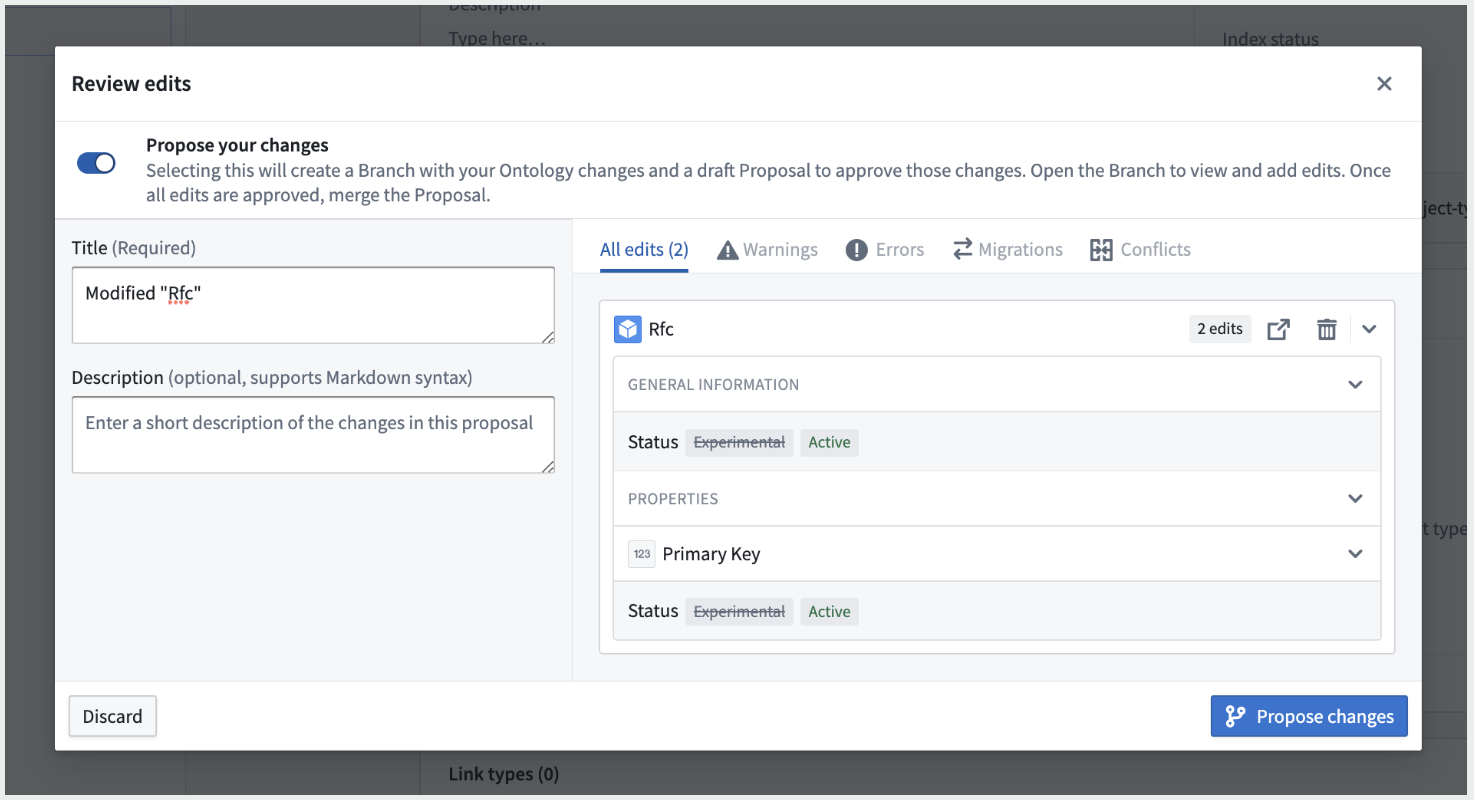
- ブランチの作成: オントロジーへの変更を含むブランチを作成できるようになりました。必要な変更を加えた後で保存を選択するか、変更を加える前にブランチを作成を選択して作成できます。
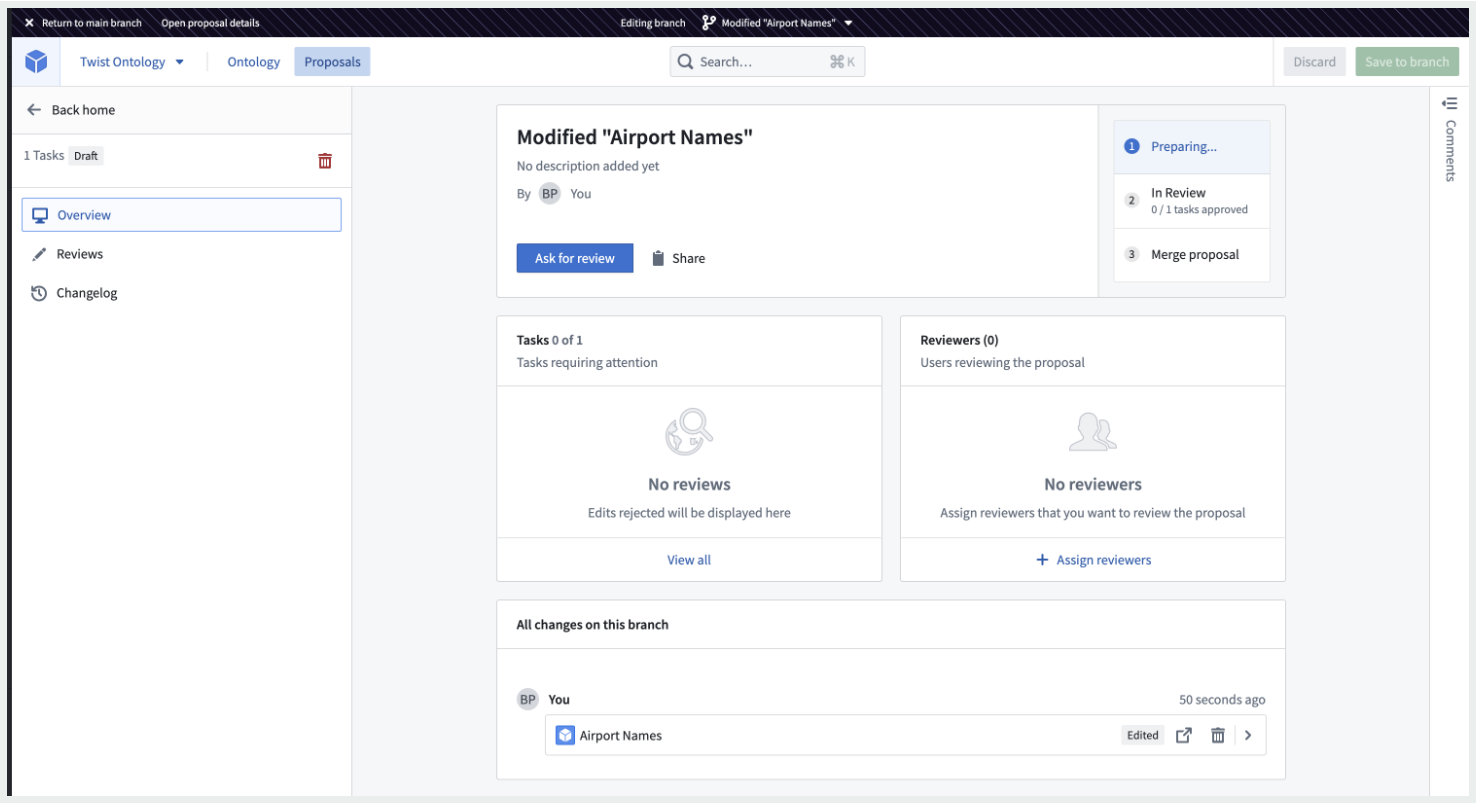
- 提案の概要: 提案の概要ページには、説明、段階、レビュー担当者、オントロジーの変更に関連するタスクなど、提案の概要情報が集約されます。また、この概要ページから、提案の編集、レビュー担当者の追加、保留中のタスクの確認、提案の次の段階への移行を開始できます。
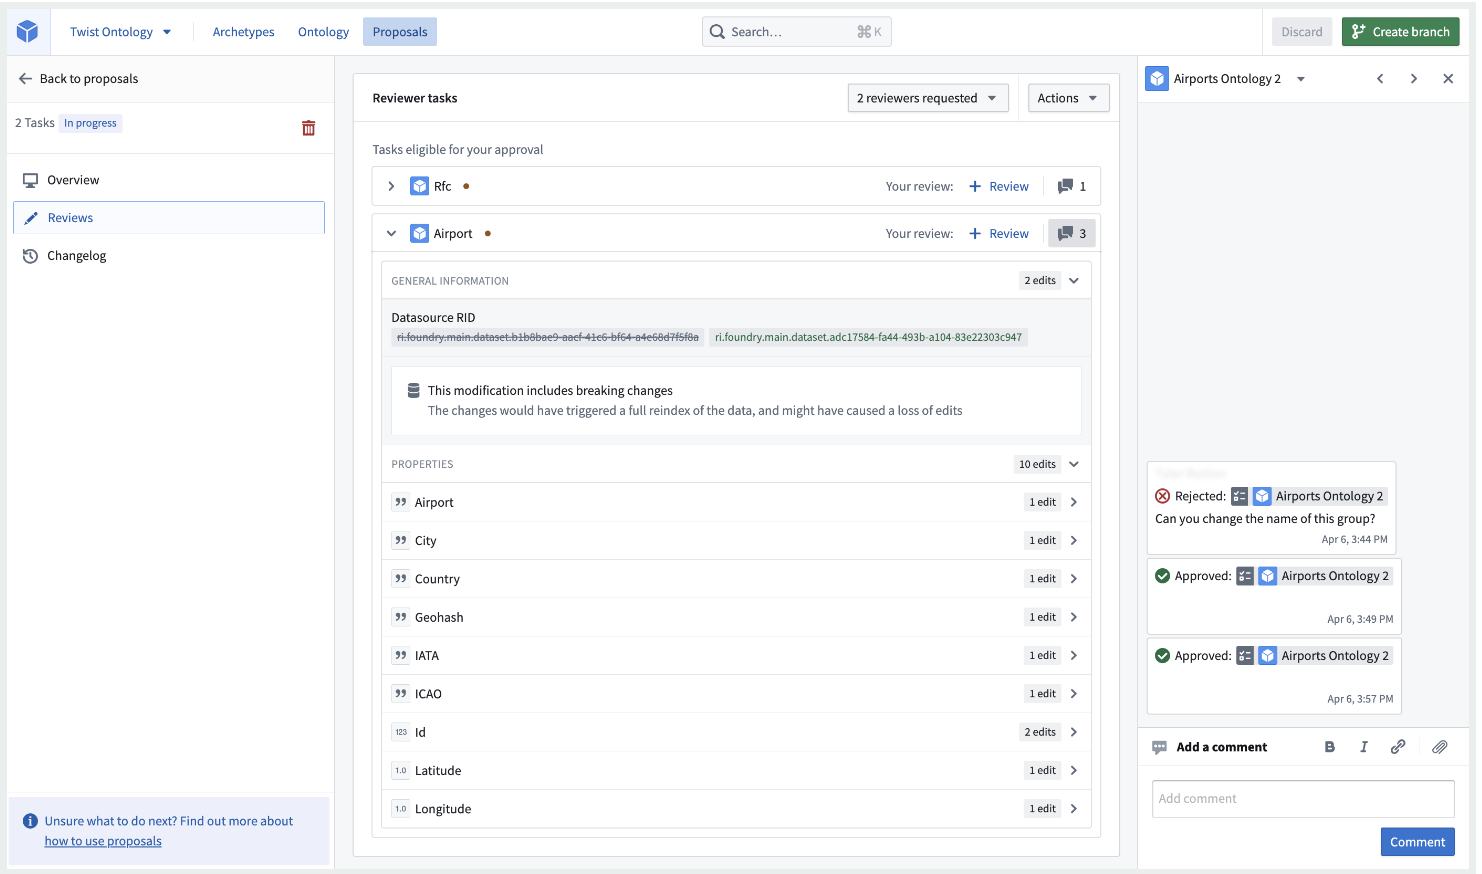
- 提案のレビュー: レビュー担当者は、変更を承認または拒否し、レビューを補足するコメントを追加できます。
- 提案のリリース: すべての変更がレビューされ、承認されると、ご自身または共同作業者が変更をオントロジーに保存することを選択できます。
Control Panel からオントロジーの提案を有効にする
提案は、すべてのプライベートオントロジーと、複数の組織間で共同作業を行っていないすべてのデフォルトオントロジーで有効にできます。オントロジーの提案を有効にするには、Control Panel のオントロジー設定タブに移動し、組織の Ontology Proposals をオンにします。
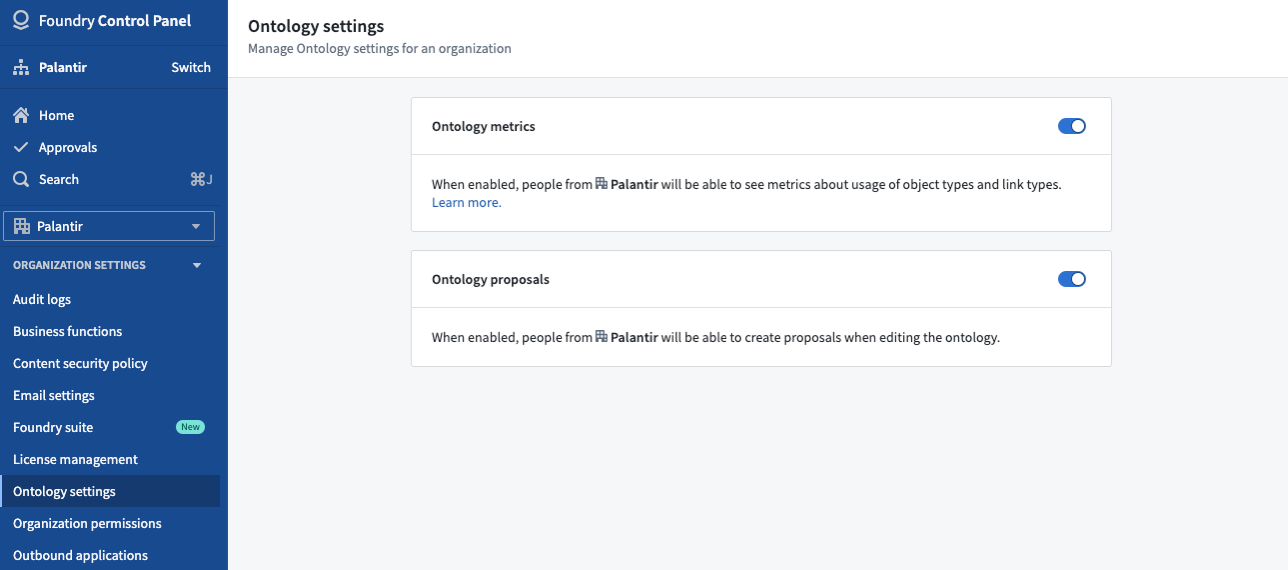
詳細と使用方法については、公開ドキュメントのオントロジーブランチを参照してください。
Retention Policies アプリケーションのご紹介 [ベータ版]
公開日: 2023-07-06
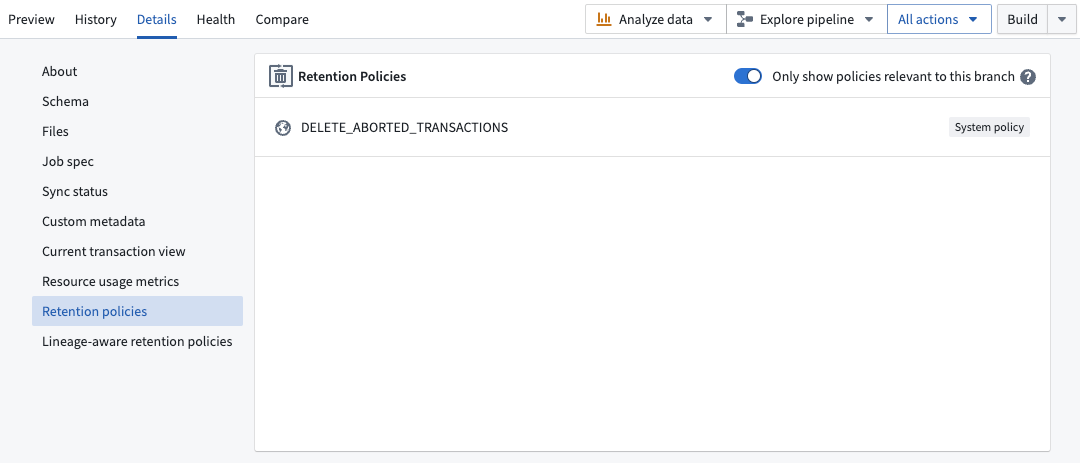
Palantir Foundry の新しい Retention Policies アプリケーションでは、単一のセルフサービスインターフェースで、データの過去のバージョンをデータセットからどのように削除するかを決めることができます。管理者は、選択したデータセットに適用するポリシーを簡単に設定できるようになりました。また、Foundry ユーザーは、データセットの詳細表示にある保持ポリシータブで、特定のデータセットに適用される保持ポリシーを表示し、絞り込むことができます。
Retention Policies アプリケーションは、管理者にとって削除プロセスをより直感的にする一方、データセットの詳細ページの対応するタブを通じて、一般の Foundry ユーザーに対する透明性も向上させます。
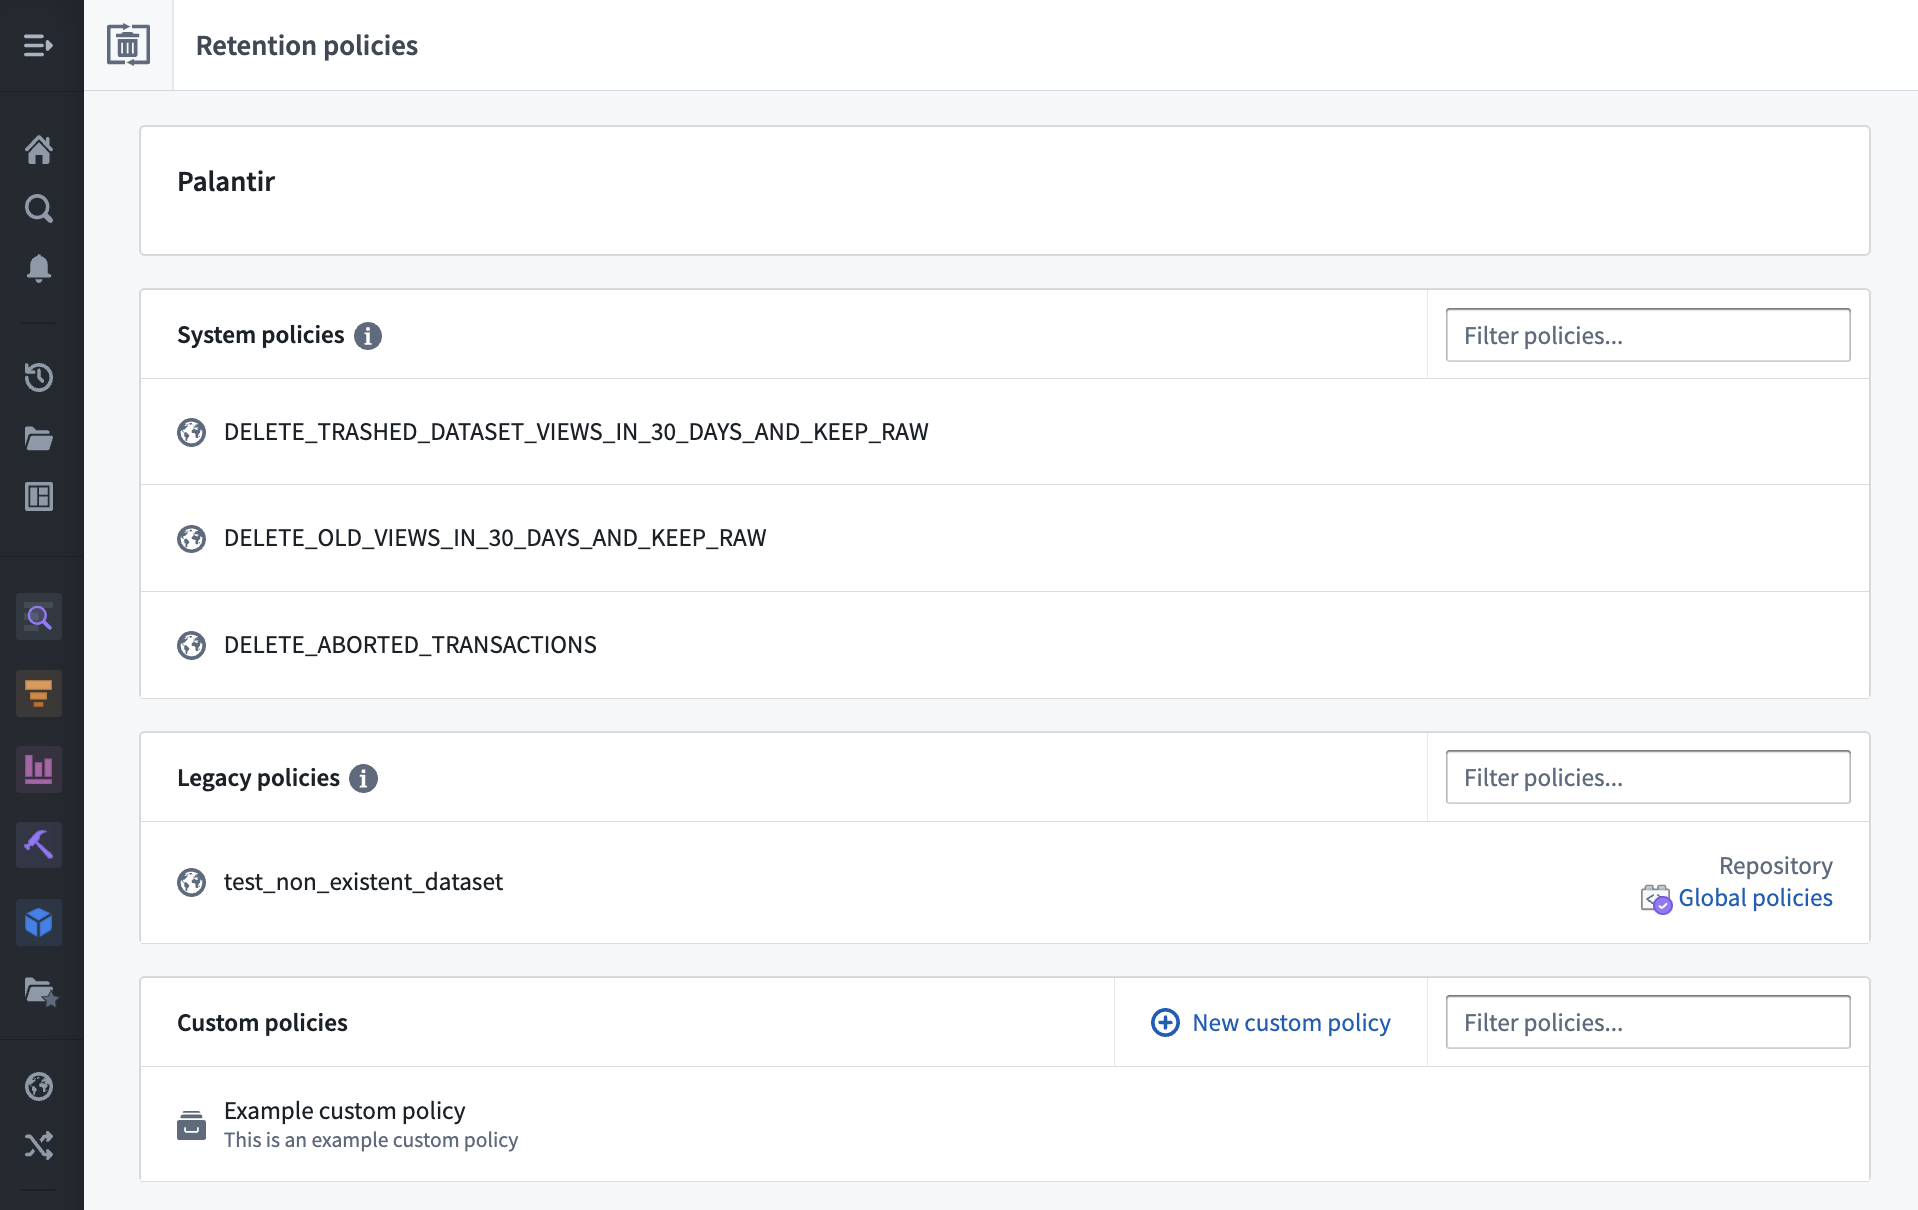
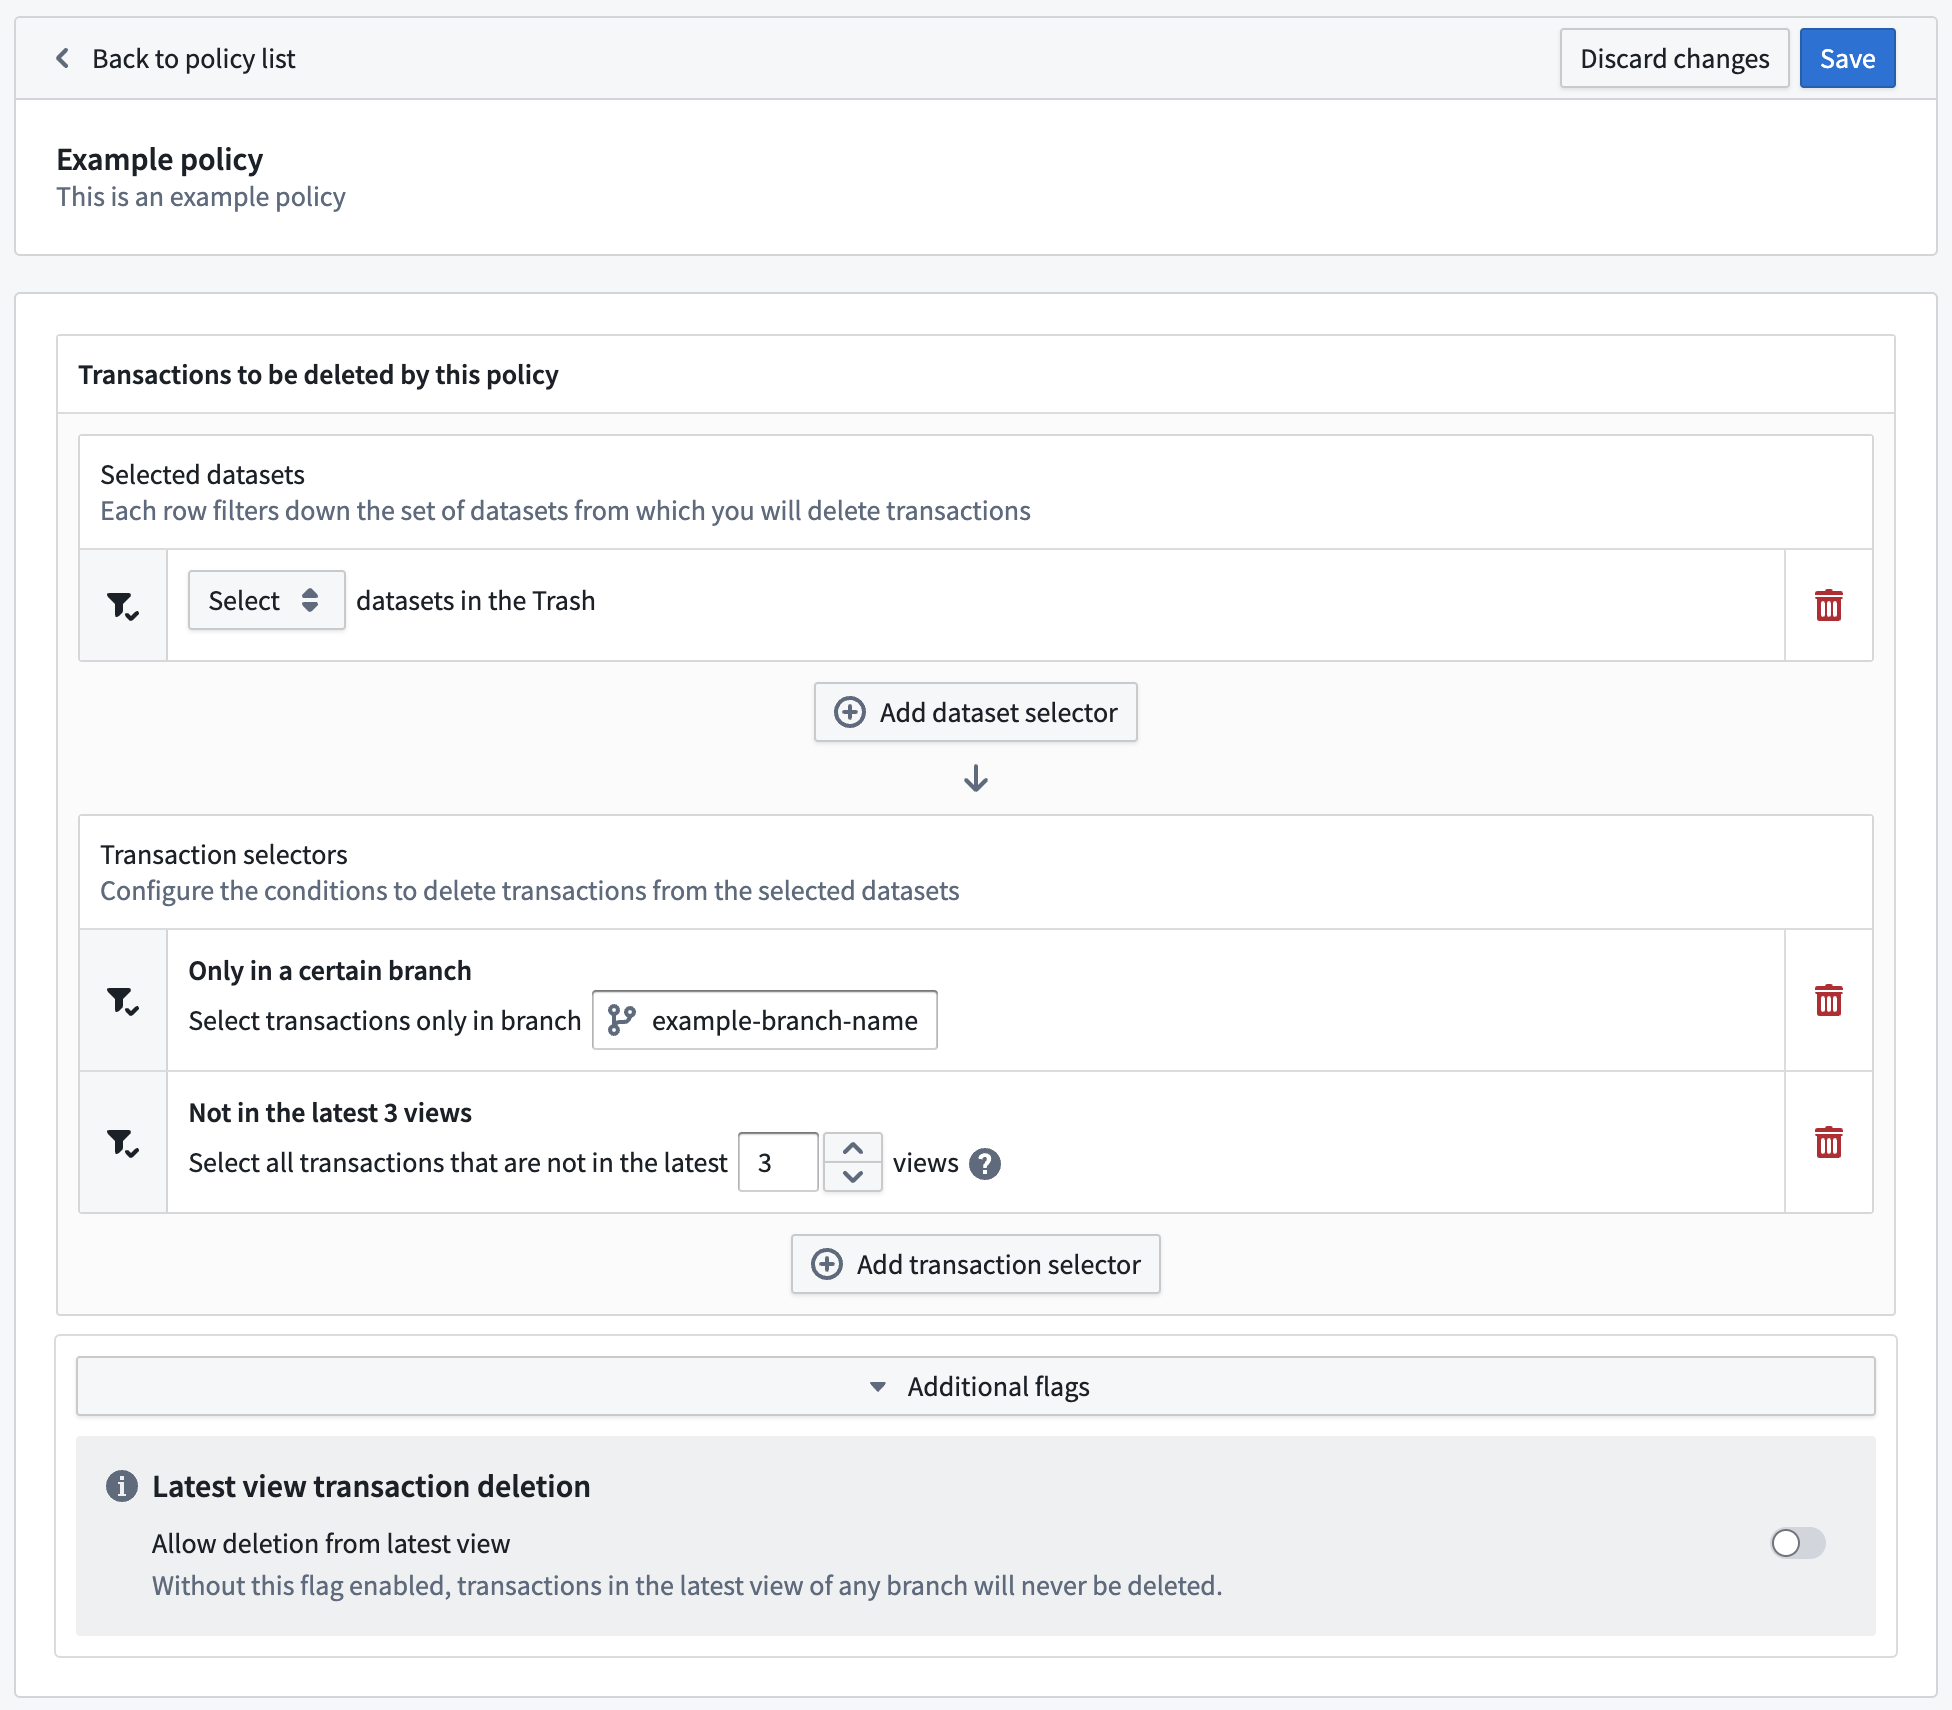
Retention Policies アプリケーションでは、次の機能を活用できます。
Retention Policies アプリケーション(Foundry 管理者向けの設定)
- 指定された名前空間に適用される保持ポリシーをすべて表示
- Code Repositories で定義されたレガシーポリシーをワンクリックで移行
- 設定されたポリシーに潜在的な危険性がある場合に警告する検証機能を備えた編集モード
データセットの詳細表示の保持ポリシータブ(Foundry ユーザー向けの表示)
- 指定されたデータセットに適用される保持ポリシーをすべて表示
- データセットの選択されたブランチに影響するポリシーのみに絞り込む任意の切り替え機能
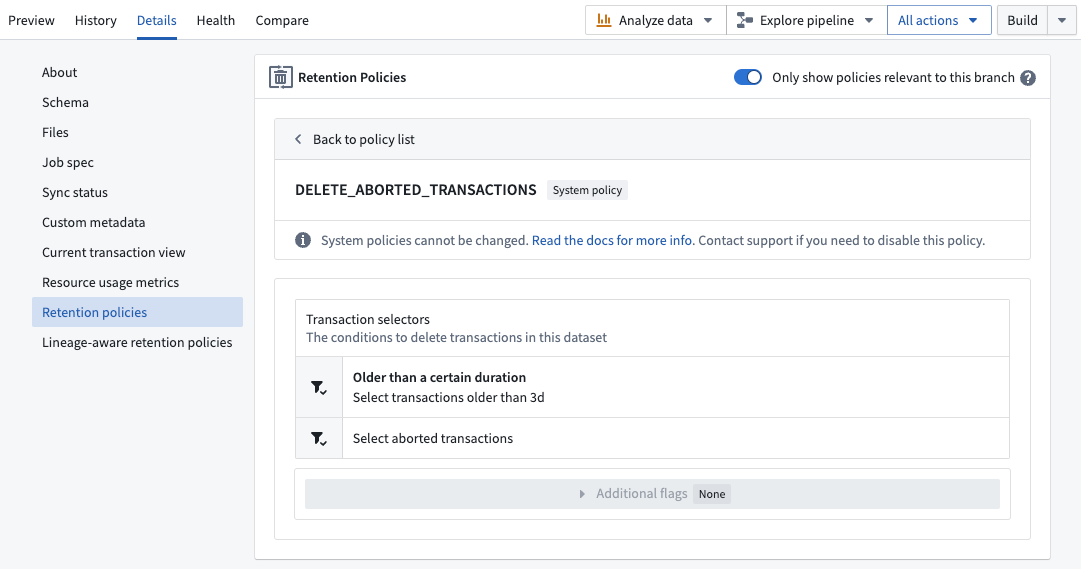
詳細については、保持ポリシーのドキュメントを参照してください。
開発ロードマップには何がありますか?
リネージを考慮した保持ポリシーとの統合の改善: 顧客に一定期間後のデータ削除を求める規制要件がある場合、上記の保持ポリシーをパイプライン全体に一度に適用するよう設定するのは難しいことがあります。1個のデータセットから削除を開始し、削除されたデータの下流へと削除を進められる新しい種類のポリシーのサポートを開発中です。
Quiver の AIP を紹介 [ベータ版]
公開日: 2023-07-06
Quiver で AIP が利用可能になりました。アプリケーション開発を始めたばかりの方から既存の開発者、データアナリスト、分野の専門家まで、経験を問わず、自然言語のプロンプトを使って簡単にデータを探索できます。AIP は Quiver の機能と統合されており、カードとその設定を推定して、意味のあるグラフを構築できます。
Quiver の AIP は、次のことに役立ちます。
- 回答の根拠となる分析を生成して、ビジネスや分析に関する質問に回答する
- 出力の可視化を設定する(レイアウト、色、向き、タイトルなど) 豊富で強力なデータ変換、可視化、ダッシュボード作成の機能を備えた Quiver アプリケーションの使い方を学びます
AIP が提示した候補とその根拠を確認し、承認または拒否できます。ボタンをクリックするだけで、分析を柔軟かつ簡単に変換できます。
分析を生成して、インサイトをより迅速に得る
AIP を使うことで、Quiver でビジネスや分析に関する質問への回答をこれまで以上に迅速に得られるようになりました。ユーザーは、Quiver に次のような自然言語の質問をするだけで分析を生成できます。
- 2020~2022年のアトランタとテキサスで、売上高が最も高い小売業者はどこですか?
- 2022年の A 社と B 社のマーケティング支出の合計はいくらでしたか?また、それぞれいくらでしたか?
- 小売業者ごとに、広告チャネル別のマーケティング支出の合計はいくらでしたか?
(以下のデモ用スクリーンショットには架空のデータが表示されています)
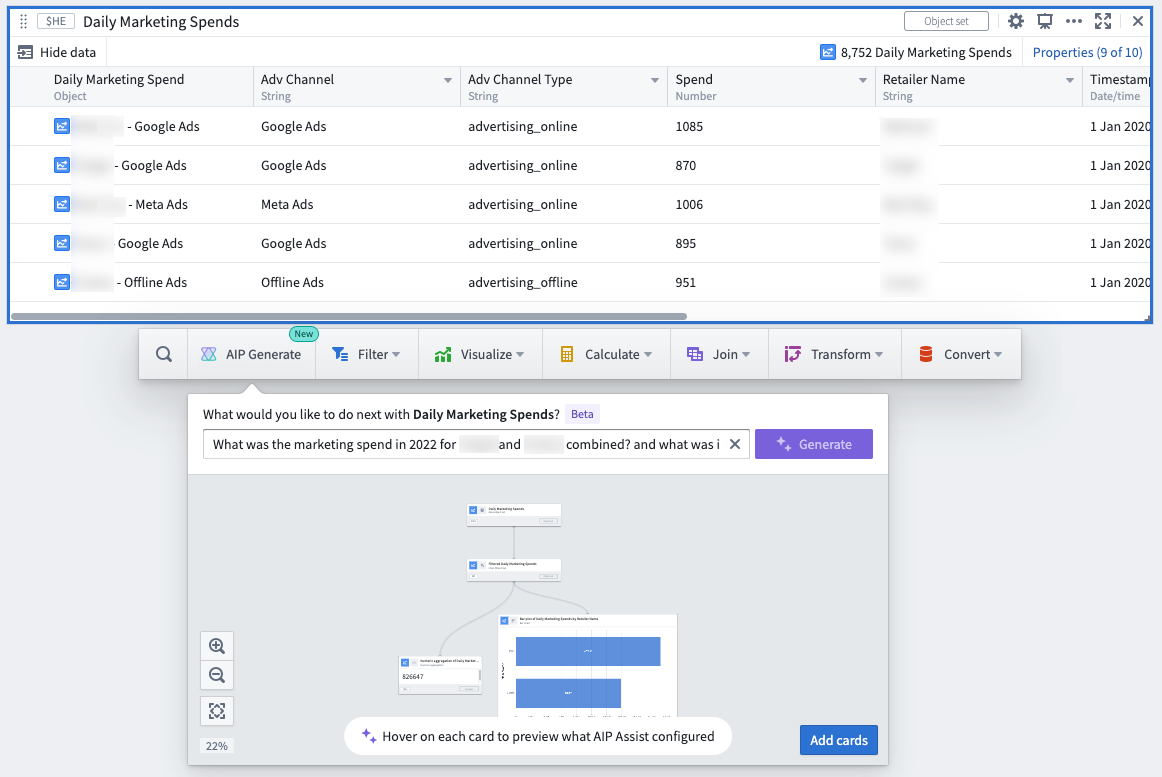
AIP は大規模言語モデル(LLM)を使ってユーザーの質問をパースし、結果となる Quiver グラフを構築します。その際、特定のカードを選んだ理由や、それぞれのプロンプトに対してカードをどのように設定したかについて、わかりやすい説明も提供します。
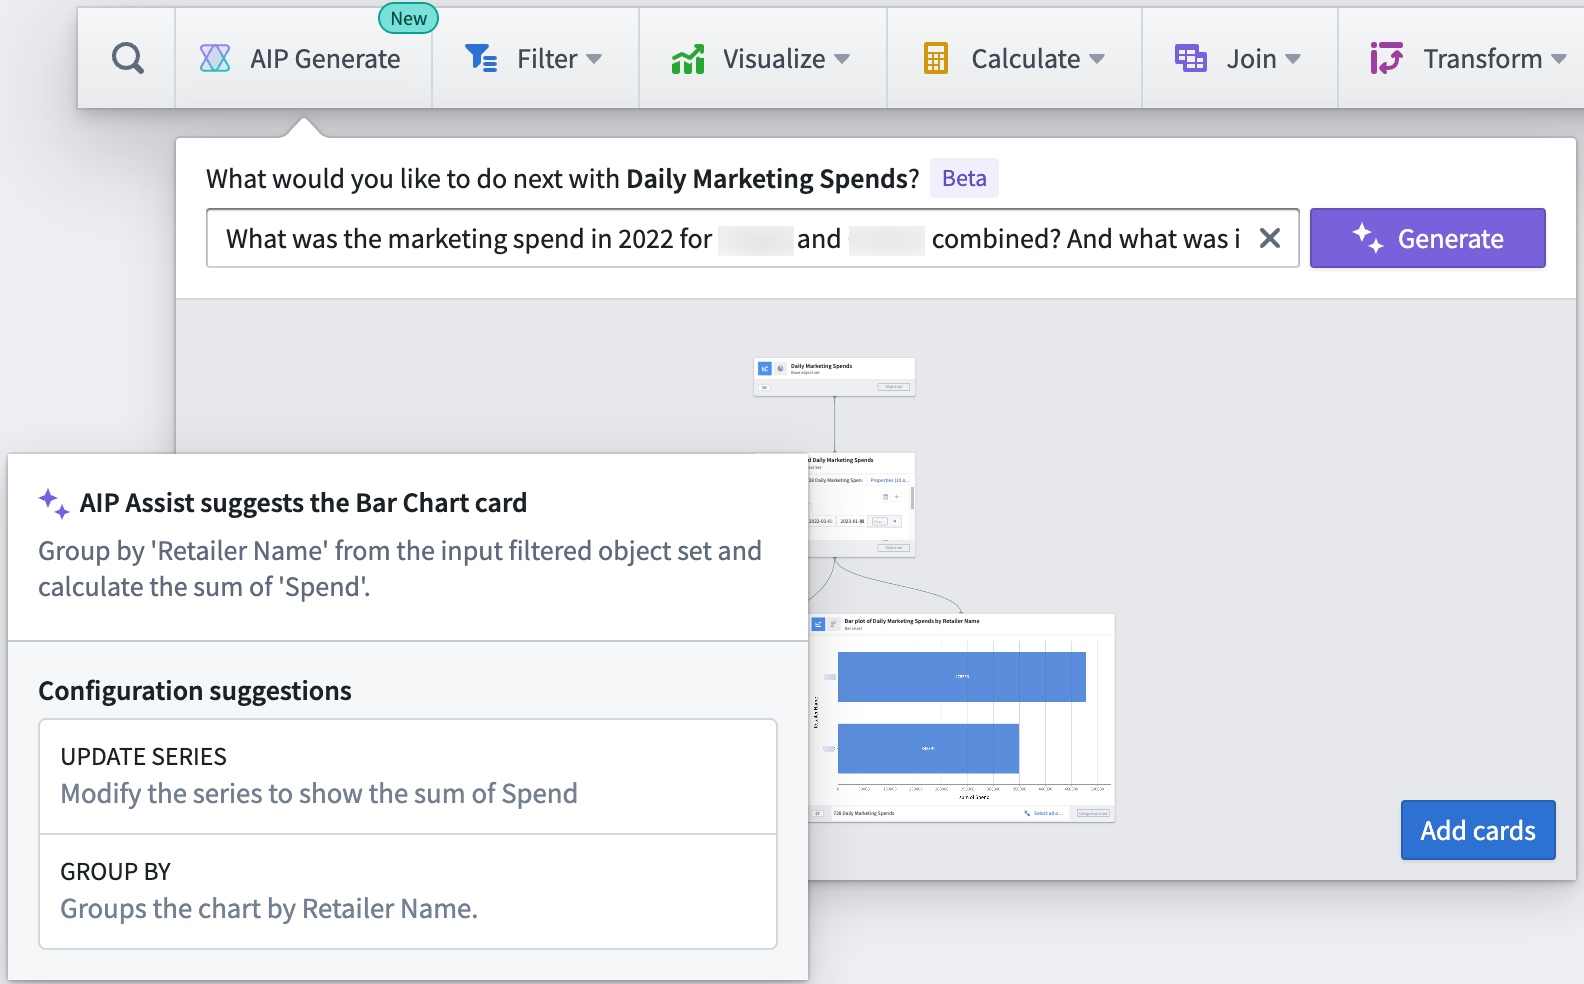
Quiver のユーザーは、生成されたグラフを分析キャンバスに一括で追加し、各カードの設定や可視化をさらに変更したり、仕上げたりできます。
望む出力を説明して可視化を設定する
Quiver のユーザーは、各 Quiver カードで利用可能な可視化設定を知らなくても、思いどおりの可視化を作成できるようになりました。AIP に次のように設定を説明できるため、カードの設定を簡単に更新できます。
- 「凡例を下部に移動して、スタイルをグループ化に変更してください」。
- 「メトリクスを売上の合計に変更して、y 軸のタイトルを
Total Salesに更新してください」。
各コマンドに対して、AIP はカード設定の候補と、各候補を提示した理由の説明を返します。ユーザーはそれらを承認または拒否できます。
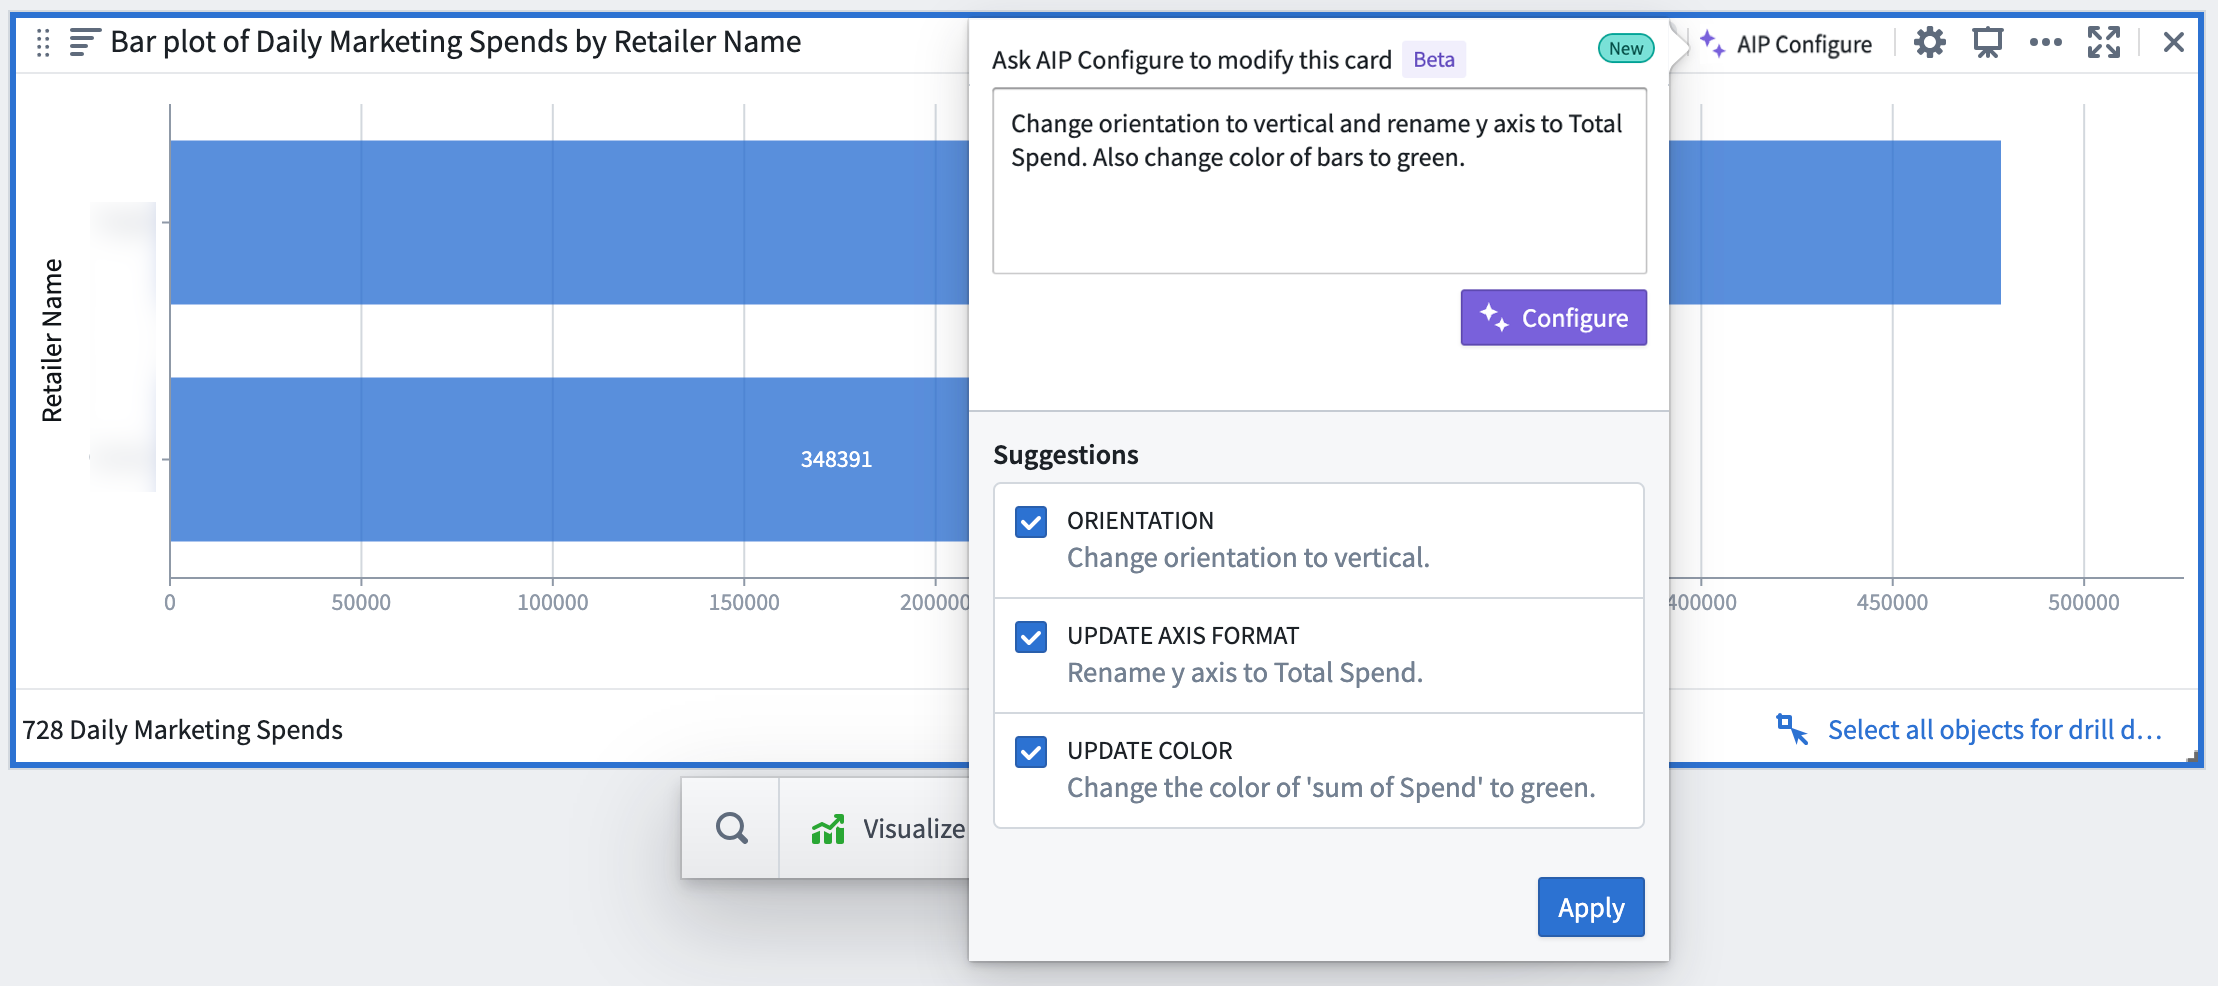
現在、Quiver の AIP はオブジェクトセットカードとオブジェクトカードのみをサポートしています。サポートされているカードには「AIP サポート」というラベルが付いています。
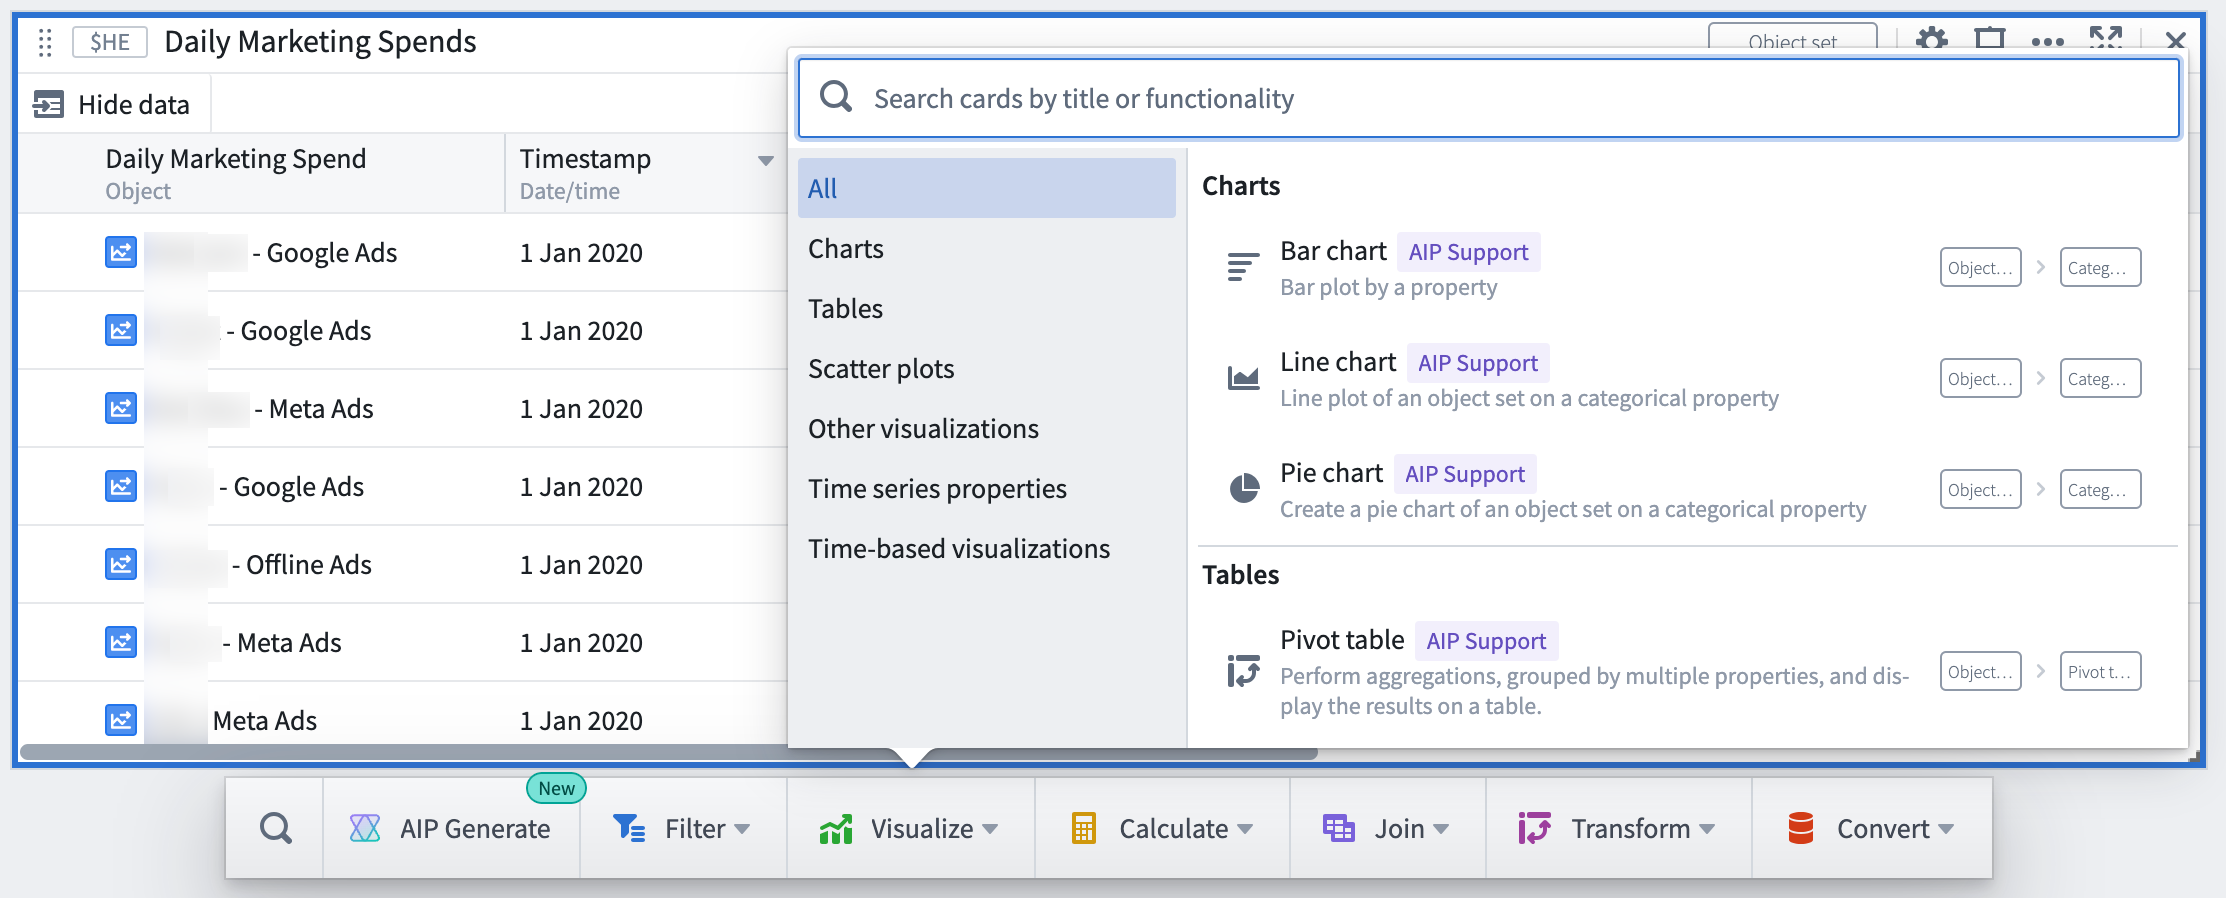
AIP は、ユーザーの1回のコマンドだけで Quiver の高度な機能を幅広く活用できるようにし、新規ユーザーも既存ユーザーも、Quiver から価値を得るまでの時間を短縮します。これらの新機能は、AIP によって Quiver の分析を拡張する魅力的な取り組みの始まりであり、今後さらに機能が追加される予定です。
詳細は、Quiver の AIP 機能に関するドキュメントを参照してください。
その他のハイライト
セキュリティ | プロジェクト
アクセス確認パネルに追加のデータ要件を表示 | ワークスペースのサイドバーにあるアクセス確認パネルに、特定のファイルに関する追加のデータ要件が表示されるようになりました。これには、データセットのリネージを通じて継承されるマーキングや、Workshop モジュールおよび Slate アプリケーションのオントロジー依存関係などが含まれます。
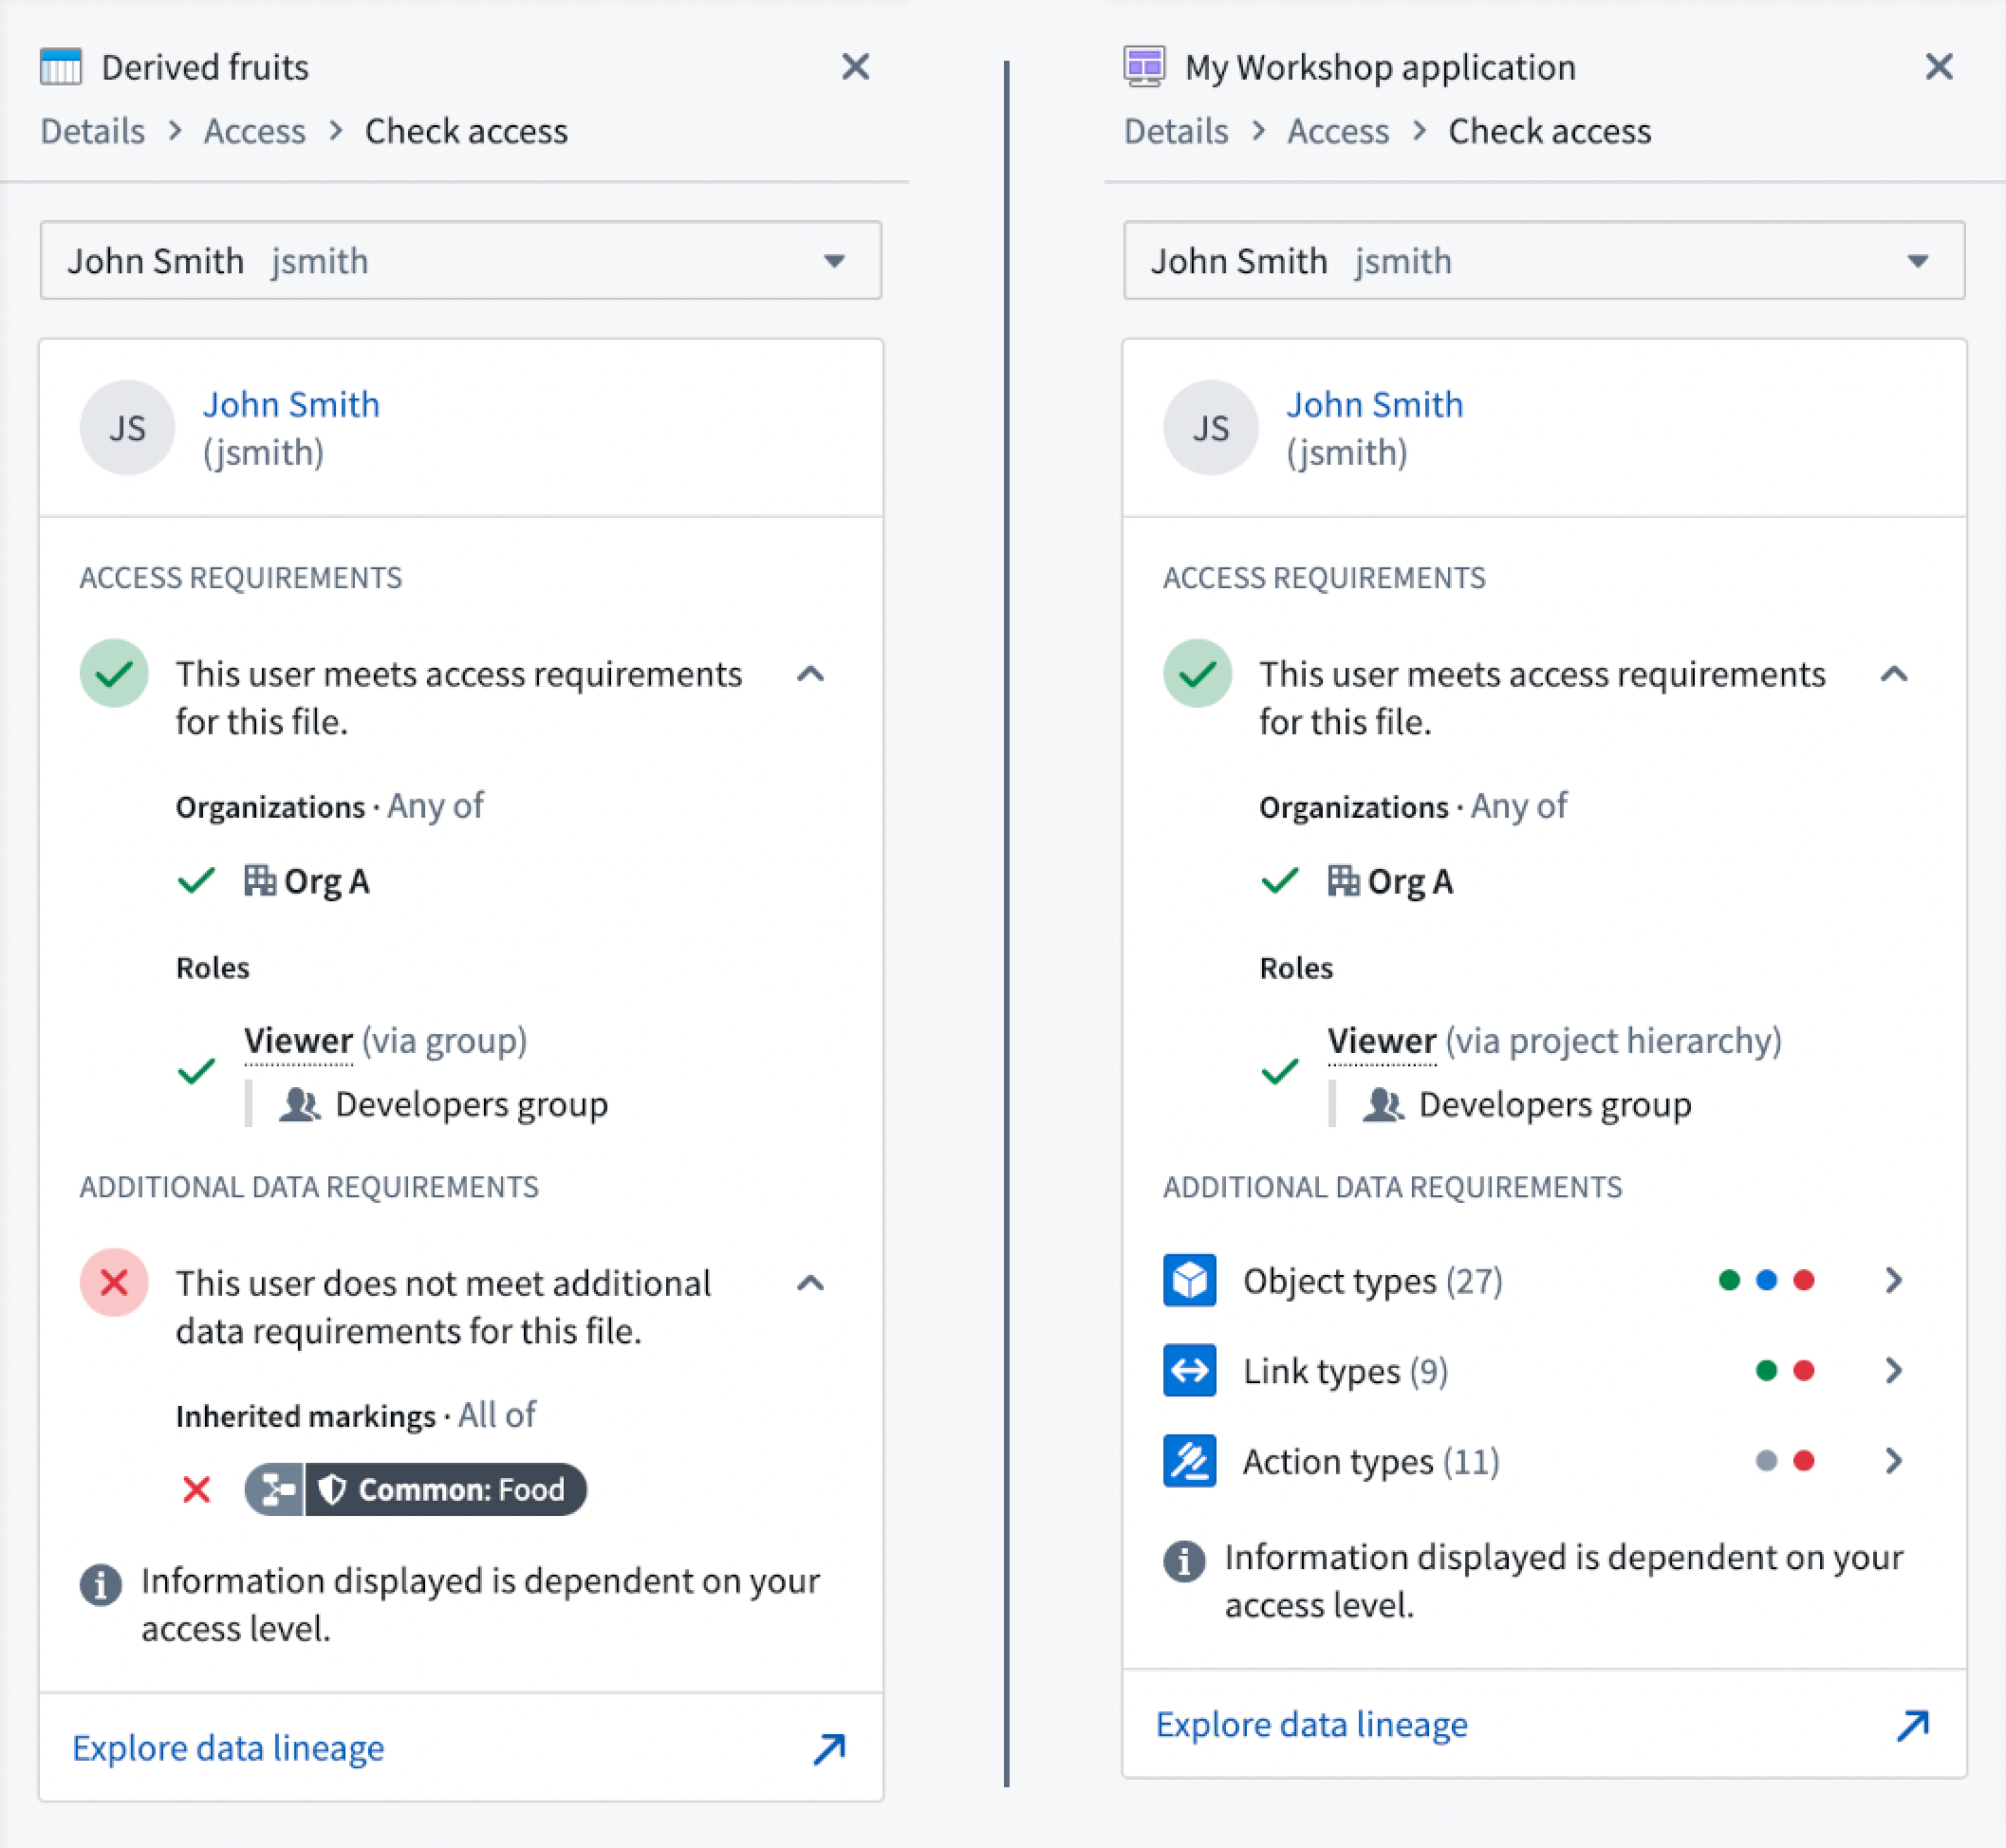 データセットと Workshop モジュールの追加のデータ要件
データ統合 | Code Repositories
新しいコードリポジトリでは PR のマージ時にソースブランチをデフォルトで削除 | 新しいコードリポジトリではすべて、対応するプルリクエストがマージされたときに、デフォルトでソースブランチが削除されるようになります。既存のリポジトリには影響しません。新しいリポジトリでは、リポジトリごとにこの動作を無効にできます。この変更により、ブランチの増加を抑え、下流サービスへの負荷を最小限にすることで、パフォーマンスと安定性が向上します。
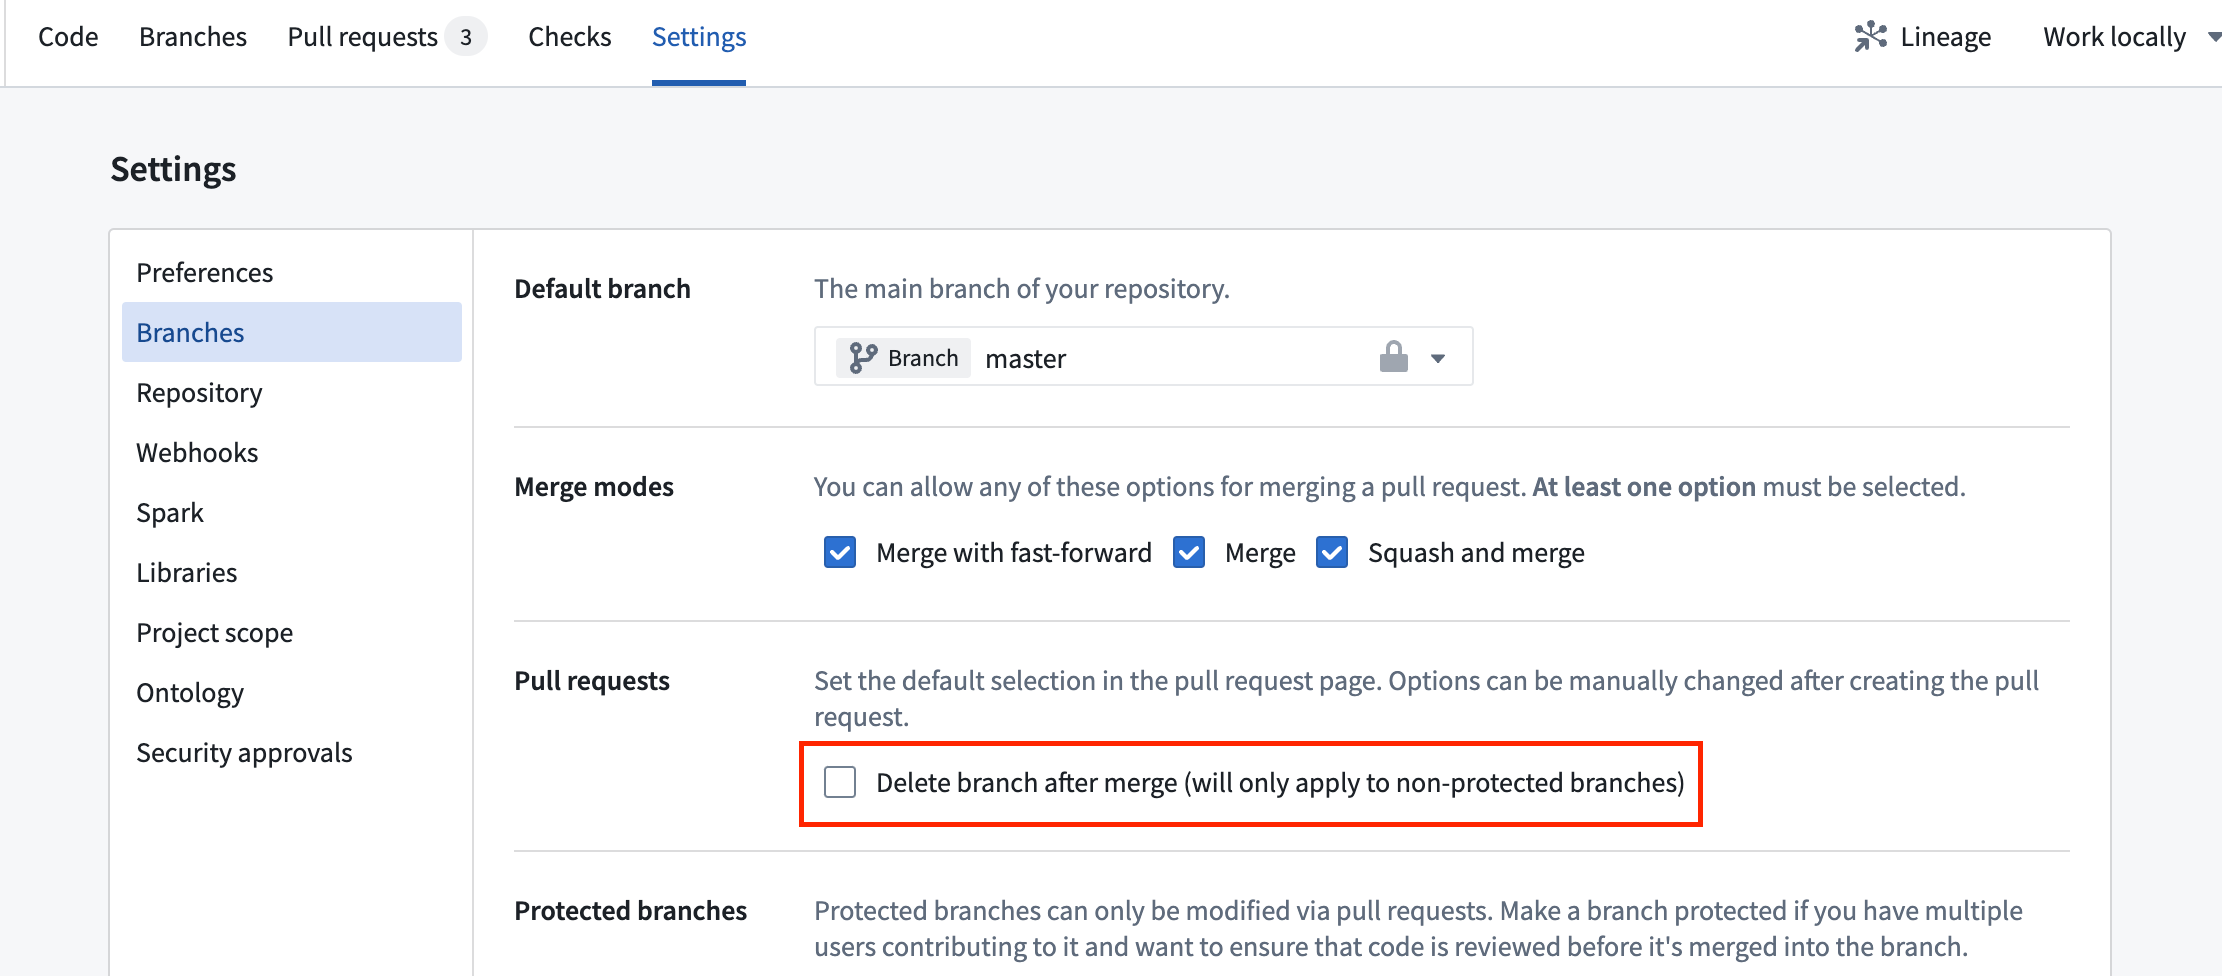 ブランチ削除の設定
データ統合 | Data Connection
Data Connection でのエクスポートのサポート | Data Connection でエクスポートがサポートされるようになりました。エクスポートはエクスポートタスクを置き換えることを目的としており、Foundry からほかのシステムへのデータフローを設定するための使いやすいインターフェースを提供します。エクスポートを使用すると、同じ接続で Foundry へのデータ同期と Foundry からのデータエクスポートの両方を行えます。サポート対象のソースでは、ソースの概要ページにエクスポートのテーブルと、新しいエクスポートを作成するための選択肢が表示されるようになります。このリリースでは、S3 および Kafka ソースでエクスポートを利用できます。今後、さらに多くの種類のソースがサポートされる予定です。
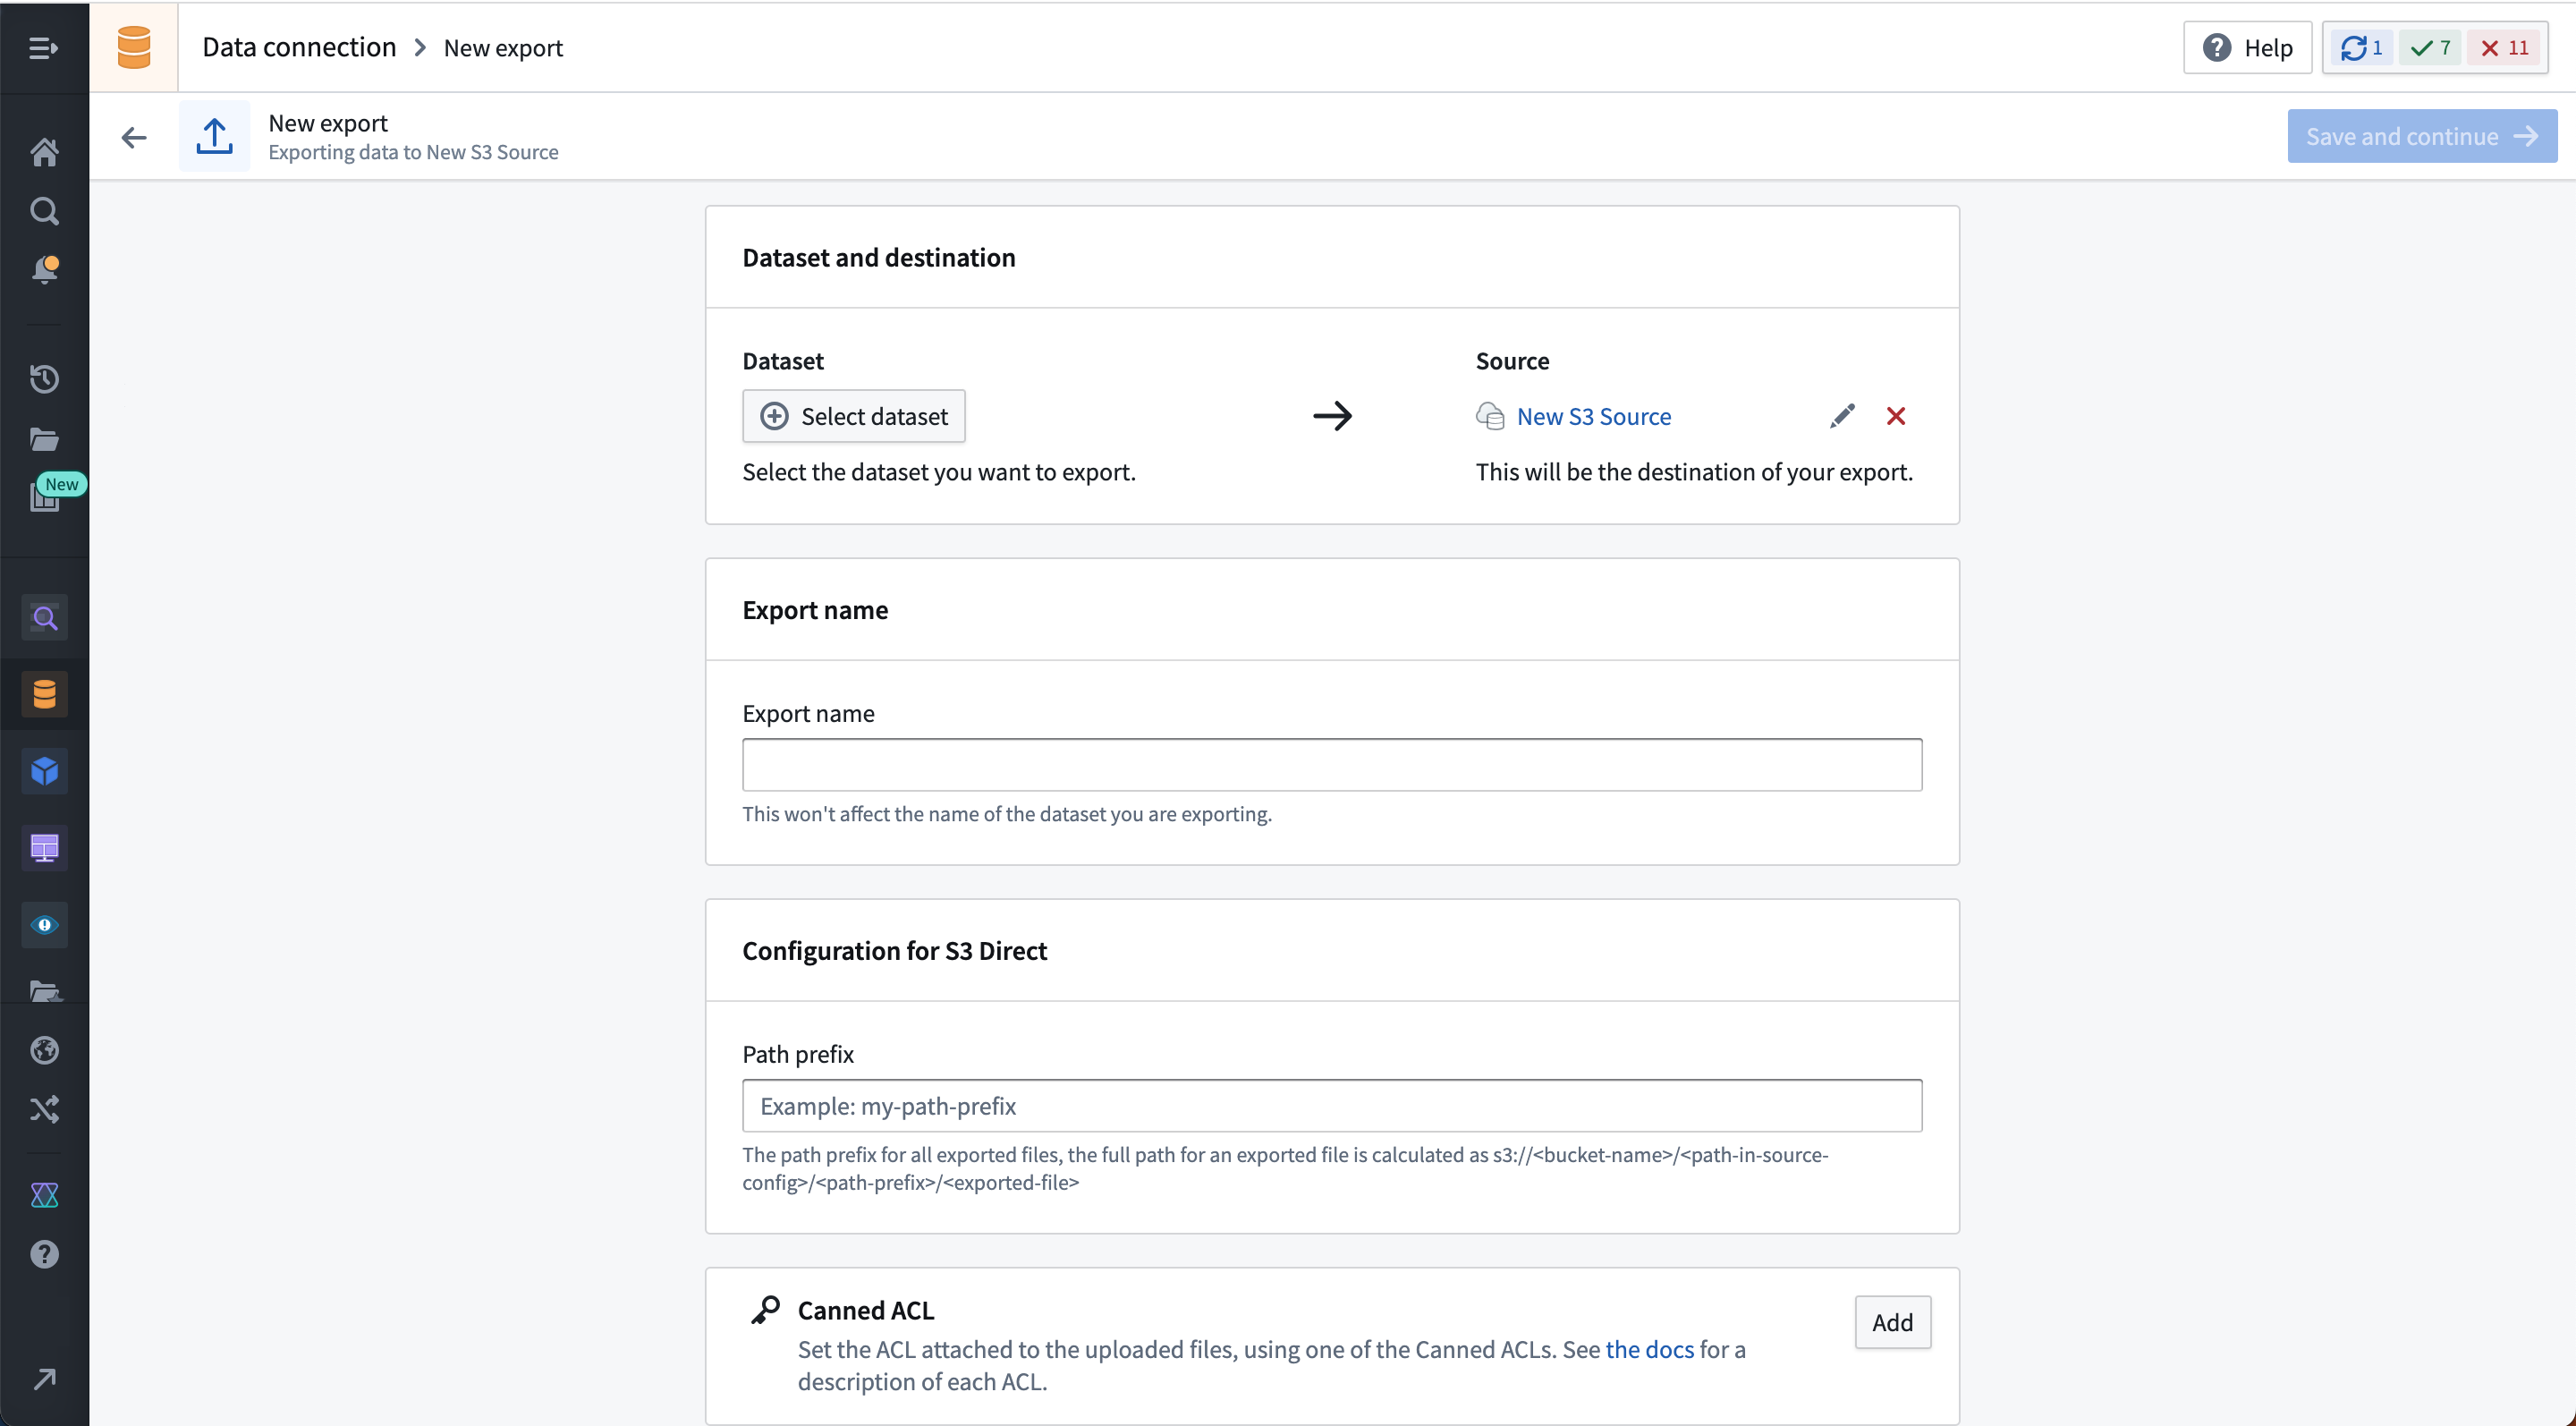 Data Connection の新しい S3 エクスポートページ
Foundry | Cipher
Cipher ライセンスから Builder パイプラインへ | Cipher ユーザーは、Cipher アプリから Builder パイプラインを作成して、特に機密性の高いデータの暗号化を開始できるようになりました。この機能は、暗号化が許可されている Admin および Data Manager ライセンスで利用できます。利用するには、暗号化するデータセットと特定の列を選択する必要があります。その後、Cipher が、選択された列がすでに暗号化されたパイプラインを自動生成し、ユーザーはそのパイプラインを基に開発を進められます。
アプリ構築 | Workshop
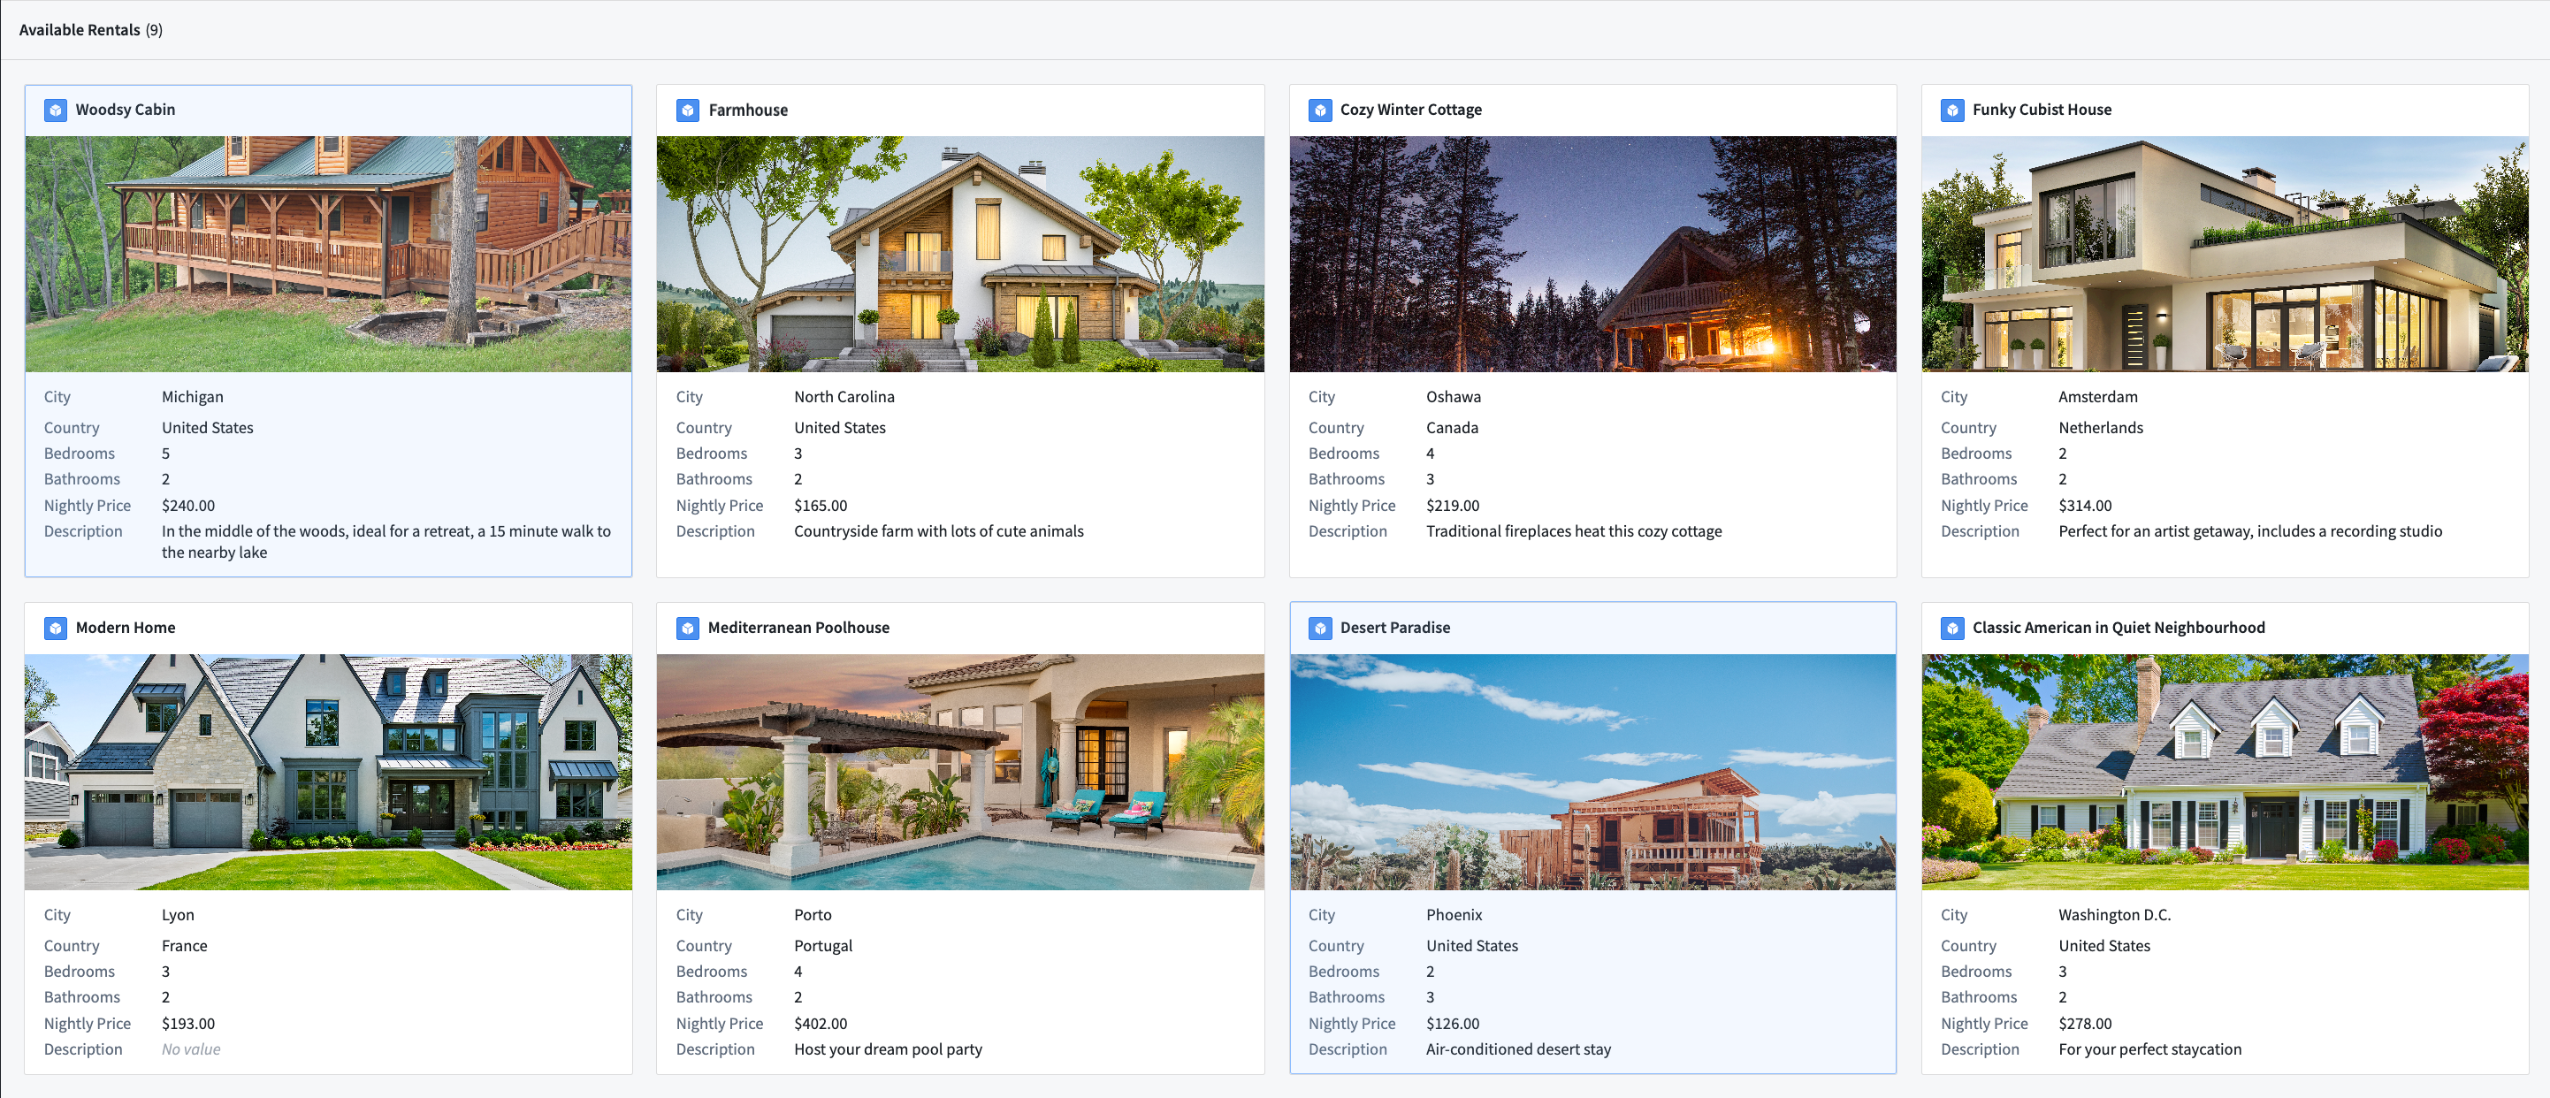
オブジェクトリストウィジェット:カードスタイルとメディアサポートの拡充 | オブジェクトリストウィジェットで、オブジェクトごとのカードスタイルがサポートされるようになりました。また、画像、音声、その他のメディア添付ファイルをインライン表示するためのオプションも増えました。各オブジェクトにインライン画像を目立つように表示する、新しいカードスタイルの例をご覧ください。
アプリ構築 | Workshop
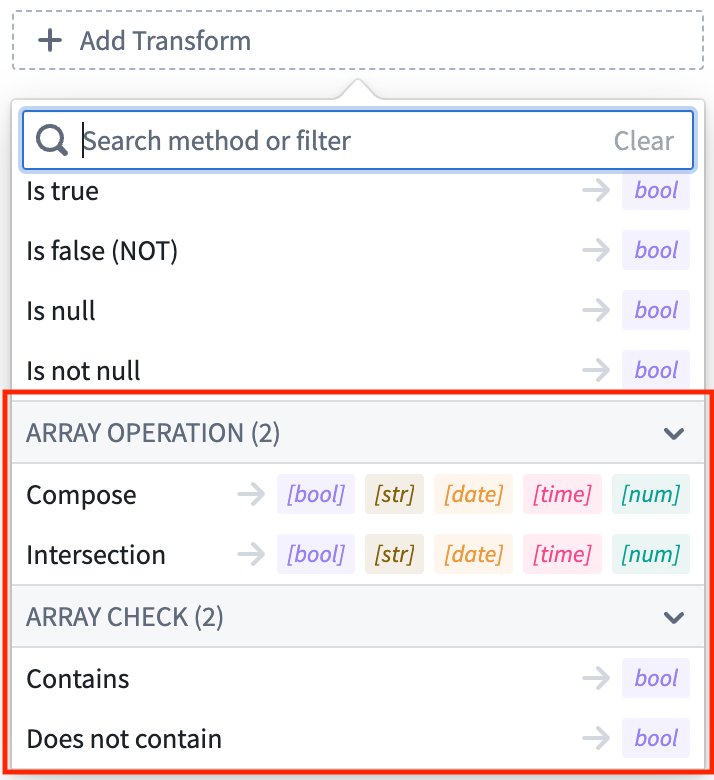
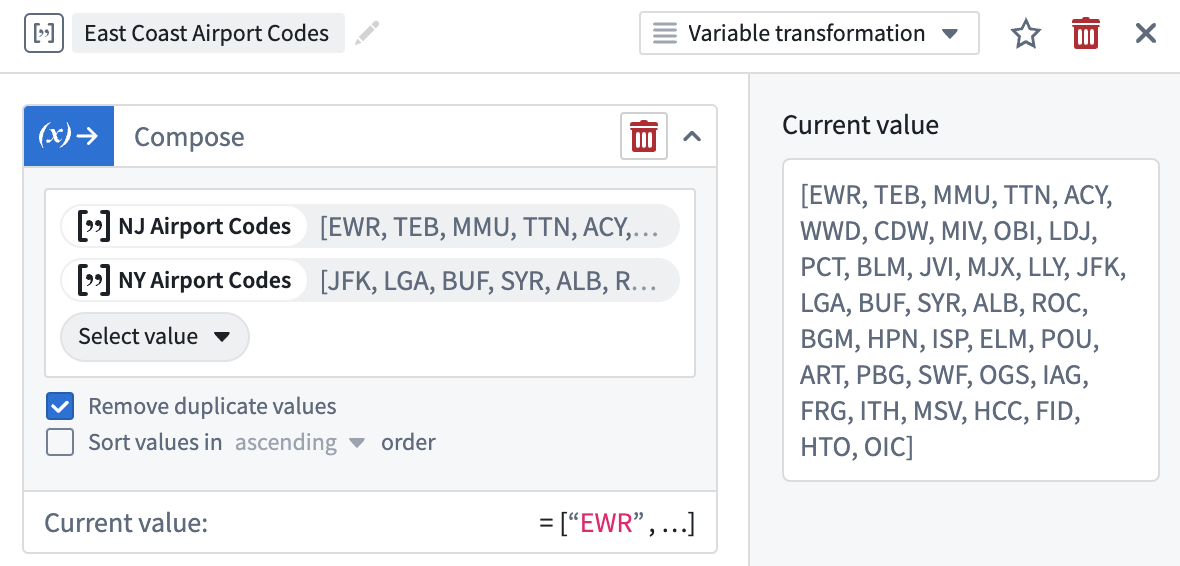
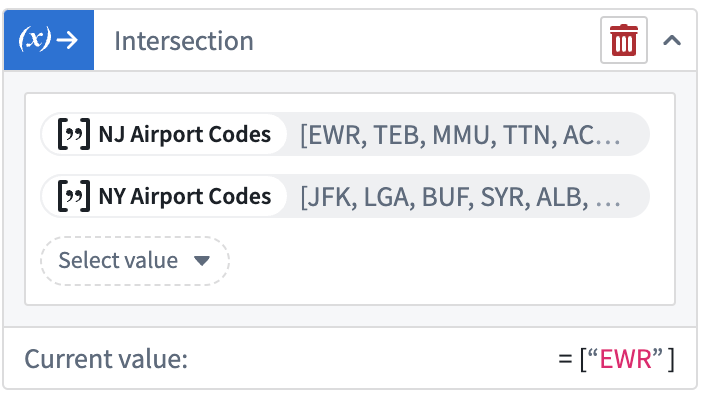
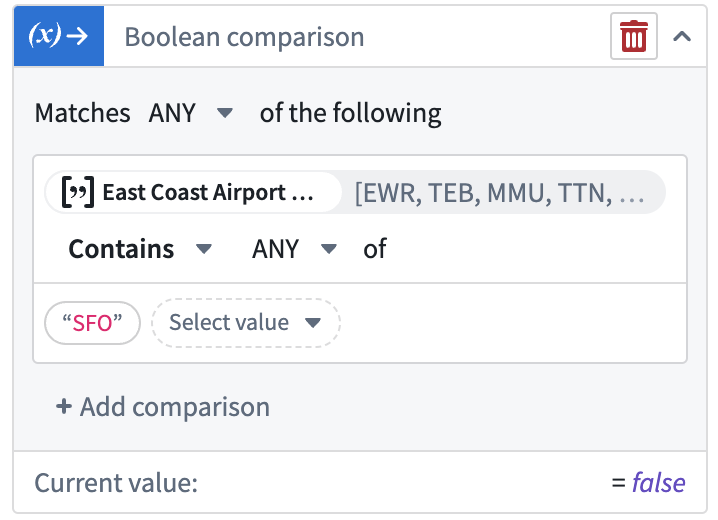
変数変換:配列操作 | Workshop のフロントエンドの変数変換システムで、配列操作がサポートされるようになりました。変換を使用して、新しい配列の作成、配列間の積集合の計算、配列内に値が存在するかどうかのブール値によるチェックを行えます。
アプリ構築 | Workshop
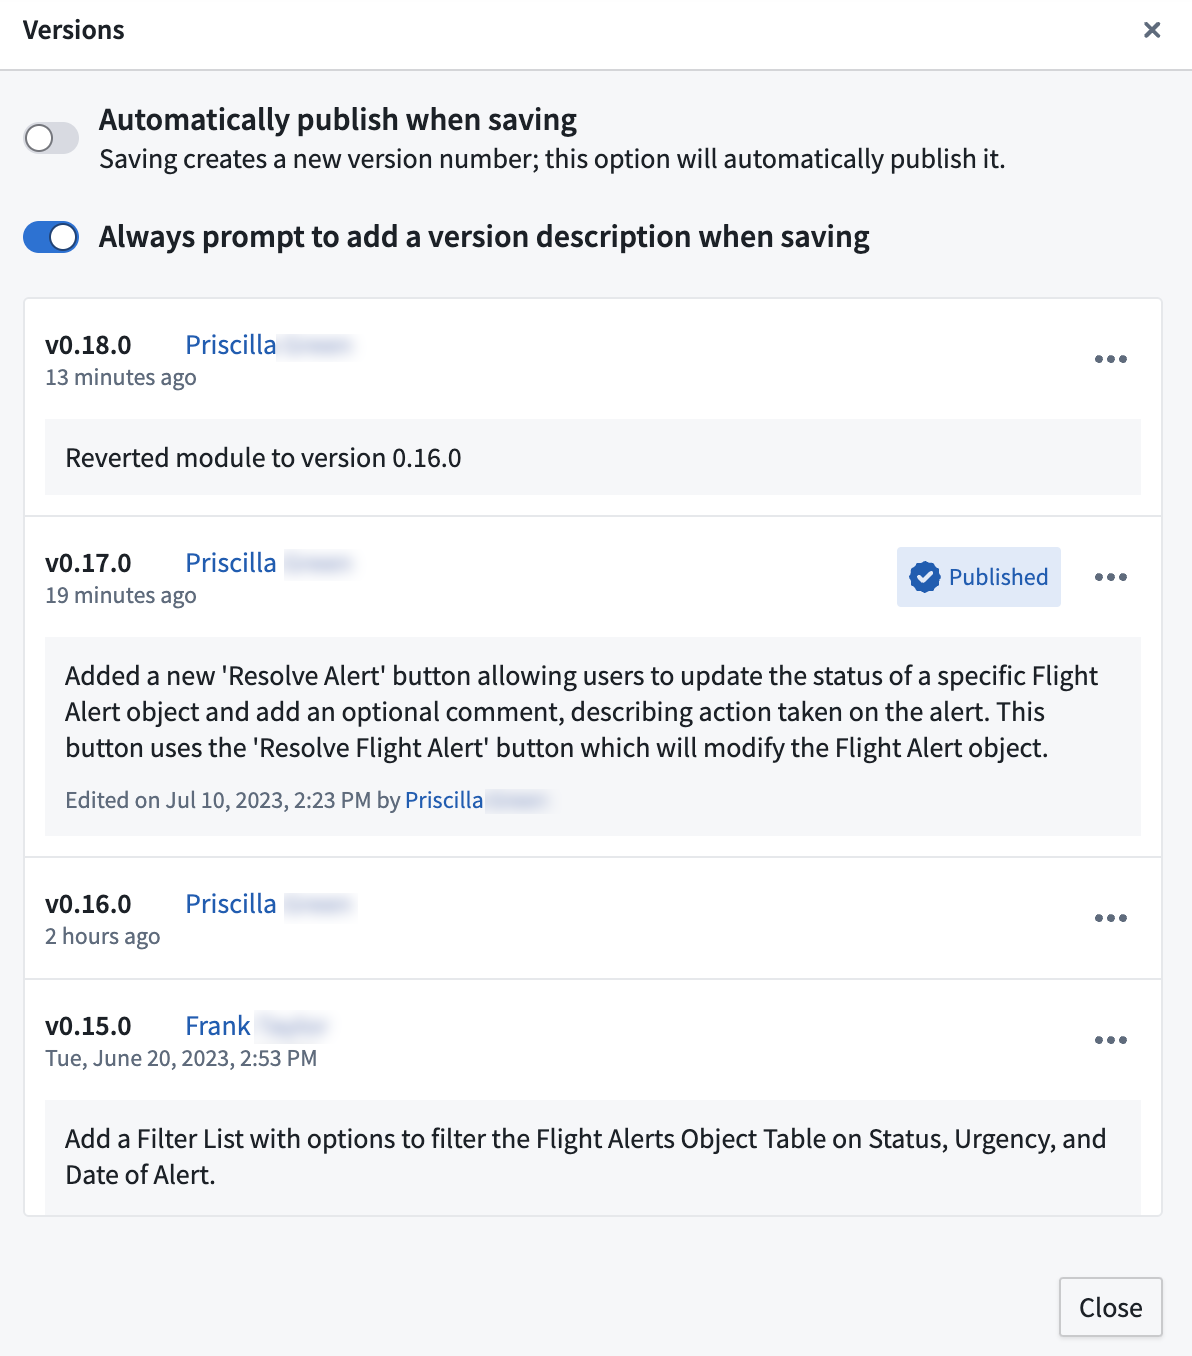
モジュールのバージョンに説明を追加 | アプリケーションの構築者は、新しいモジュールのバージョンを保存するときに、任意の説明を追加できるようになりました。これにより、本番モジュールに加えられた変更の経緯を文書化し、モジュールの履歴をより詳細に記録できます。説明は、モジュールのバージョンダイアログで表示、追加、編集できます。後から追加または編集された説明には、正確なタイムスタンプと編集者の詳細とともに、編集済みであることが表示されます。モジュールを以前のバージョンに戻すと、実行した「元に戻す」操作を記録する説明が自動生成されます。
セキュリティ | プロジェクト
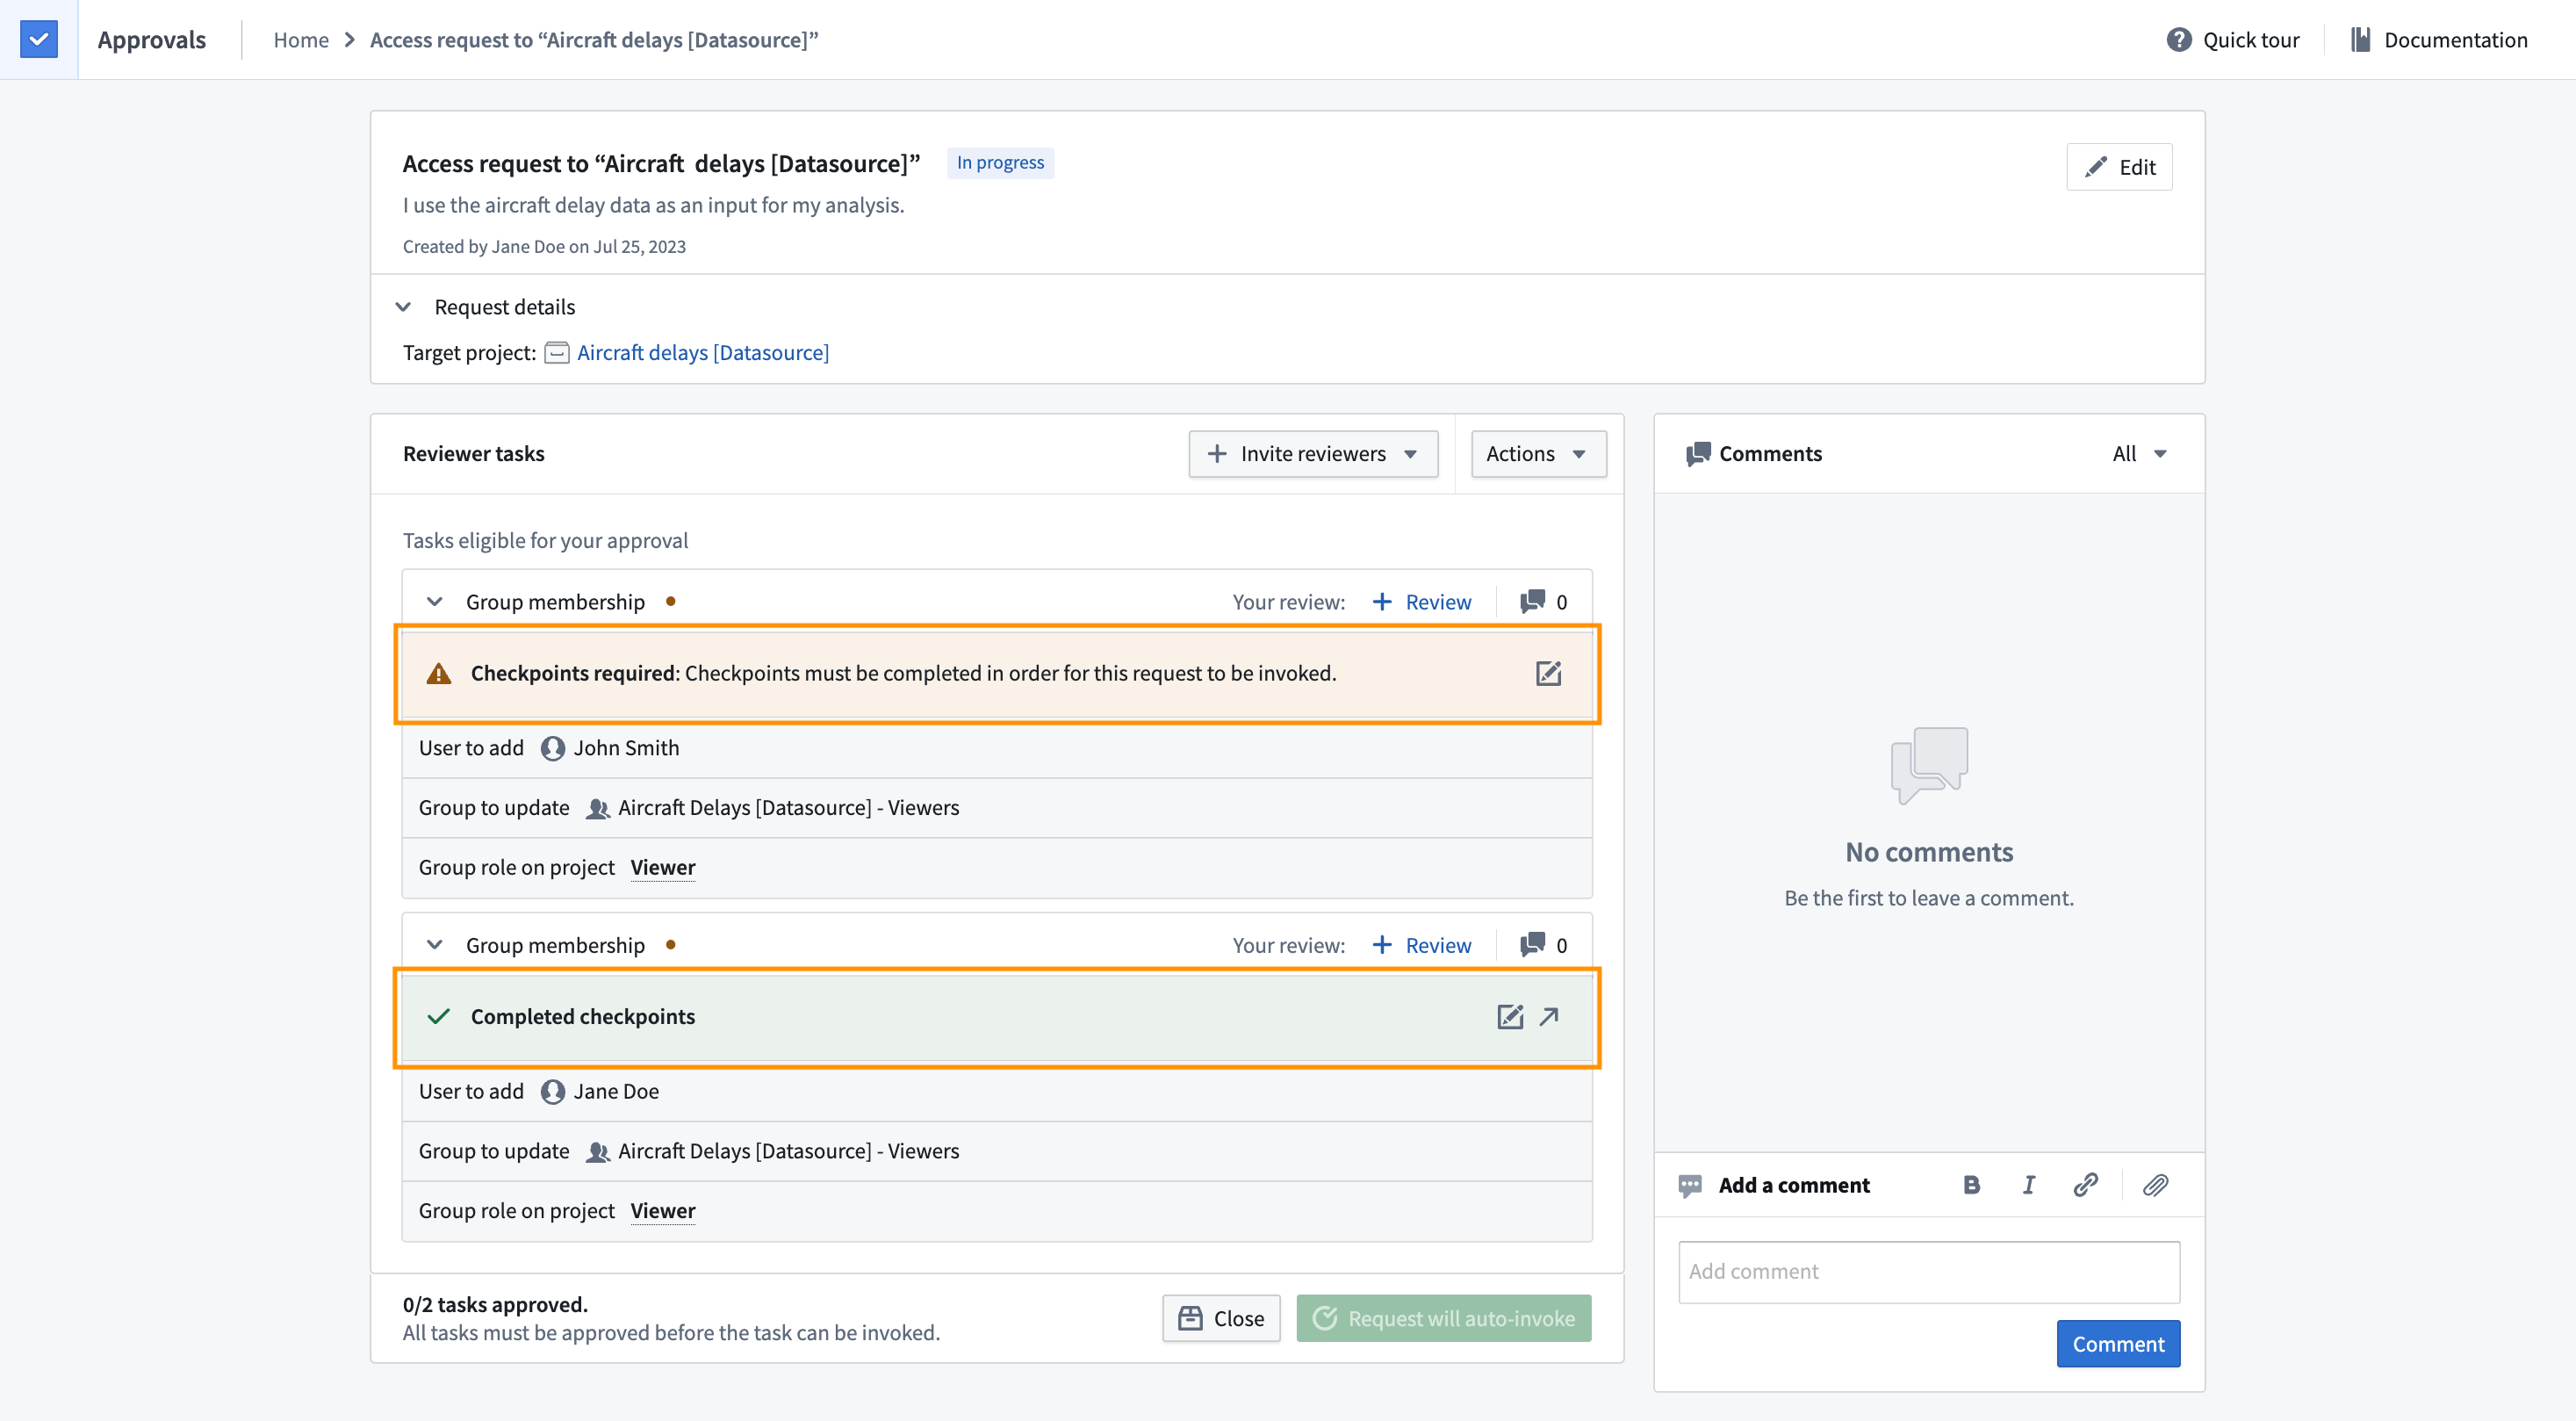
非同期リクエストで実行される操作に Checkpoint を必須化 | プロジェクトへの参照の追加など、特定の同期操作に Checkpoint が設定されている場合、非同期リクエストでも理由の記入が必要になりました。対応するタスクには、Checkpoint がすでに完了しているかどうかが表示されます。
分析 | Quiver
ブール値のフィルター変換を追加 | ブール列でトランスフォームテーブルの行を絞り込むための、次に等しい: および次と等しくない: 比較変換が追加されました。これらの新しい変換により、絞り込み機能が強化され、ブール列や、日付、文字列などのほかのデータ型の列で絞り込めます。比較変換は、トランスフォームテーブルの外でも単独で使用できます。
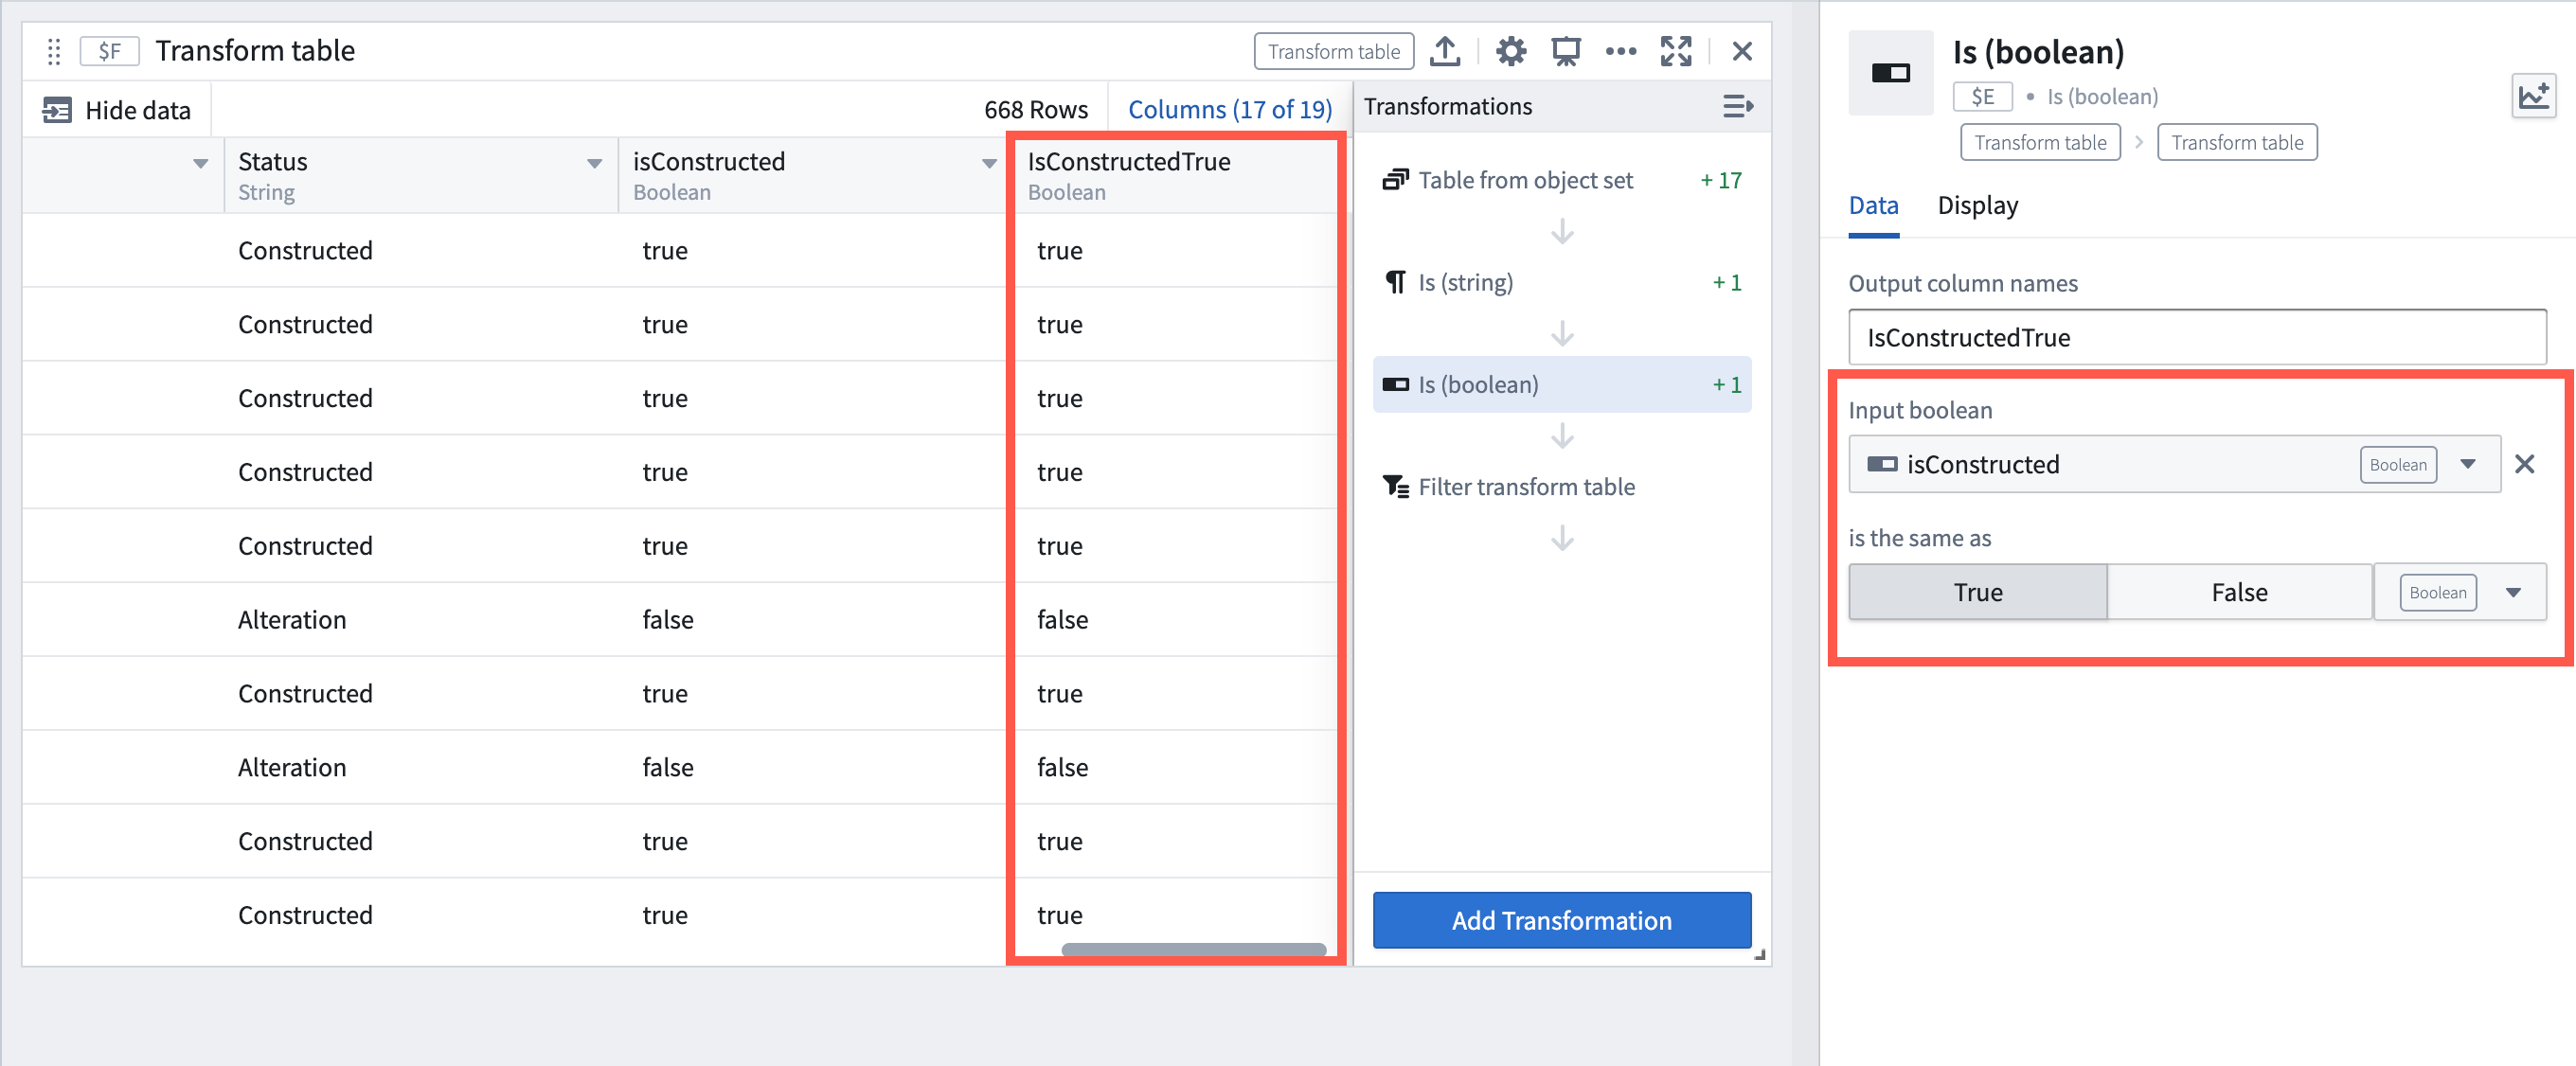
新しいブール比較変換を使用して、ブール列が true かどうかを確認する例。
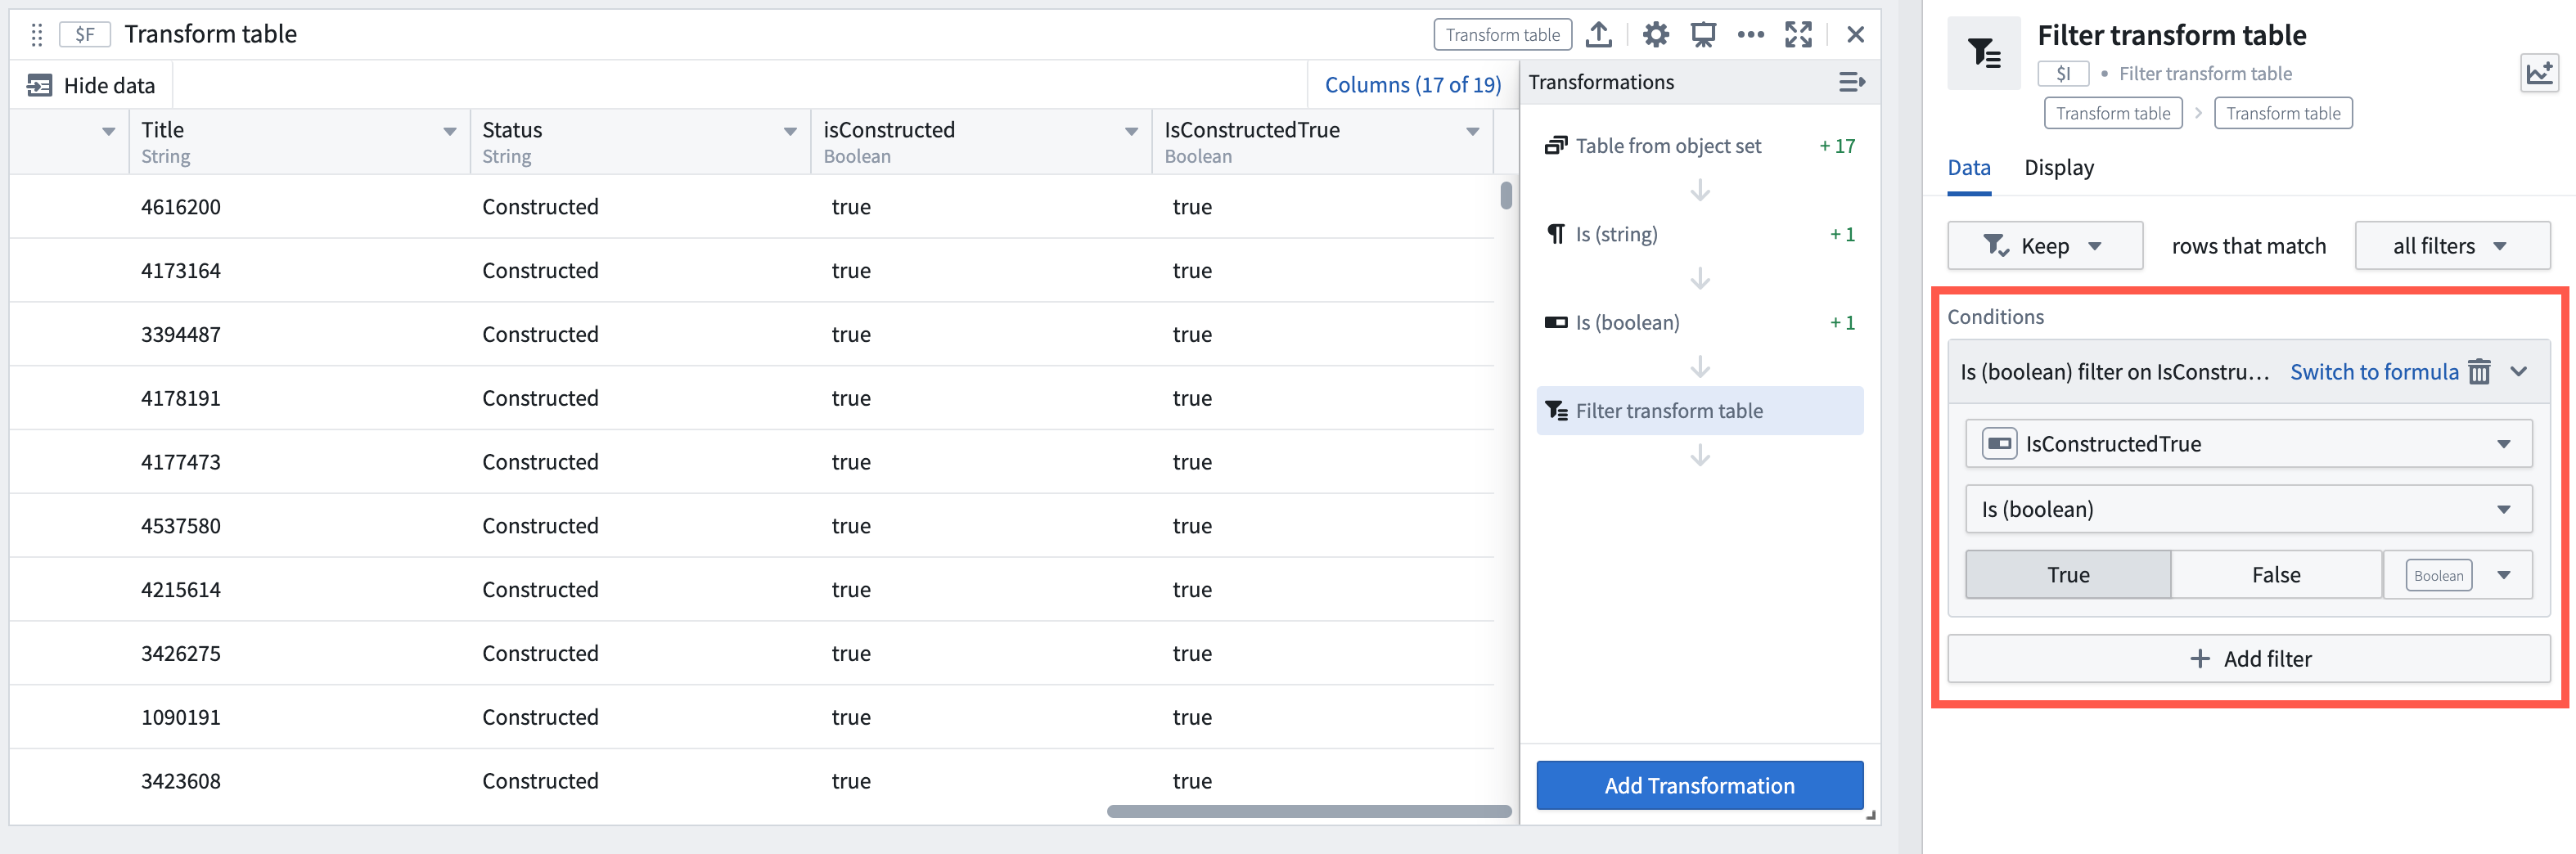
ブール比較変換の出力を使用して行を絞り込むトランスフォームテーブルの例。
オントロジー | オントロジー管理
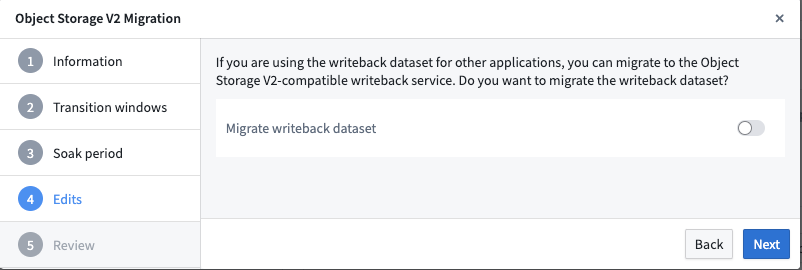
ユーザー編集のあるオブジェクトタイプの OSv1 -> OSv2 移行をサポート | ユーザーが編集したオブジェクトタイプと多対多リンクタイプを、Ontology Manager で OSv2 に移行できるようになりました。以前は、移行フレームワークでは、既存のユーザー編集があるオブジェクトタイプと多対多リンクタイプを移行できませんでした。編集されたオブジェクトタイプでも、OSv2 の新しい機能を活用できるようになりました。
分析 | Quiver
数値グループ集計を数値配列集計変換に置き換え | 「数値配列集計」は、先頭、末尾、合計、平均、標準偏差、最大値、最小値、差、積、件数の機能を実行する新しい変換です。トランスフォームテーブル内でしか使用できない既存の「数値グループ集計」変換に代わるもので、この新しい変換はトランスフォームテーブル内でも、テーブルとは別にでも使用できます。
分析 | Quiver
数値から日付への変換を追加 | 日付の数値表現(UTC のタイムスタンプを表す Unix 秒またはミリ秒)を日付型に変換する、新しい「数値から日付」変換がリリースされました。この変換は、たとえば、日付のプロパティタイプに対する数値集計で返された数値型の値を日付型に戻し、ほかの変換やカードの入力として使用する場合に役立ちます。
データ統合 | Pipeline Builder
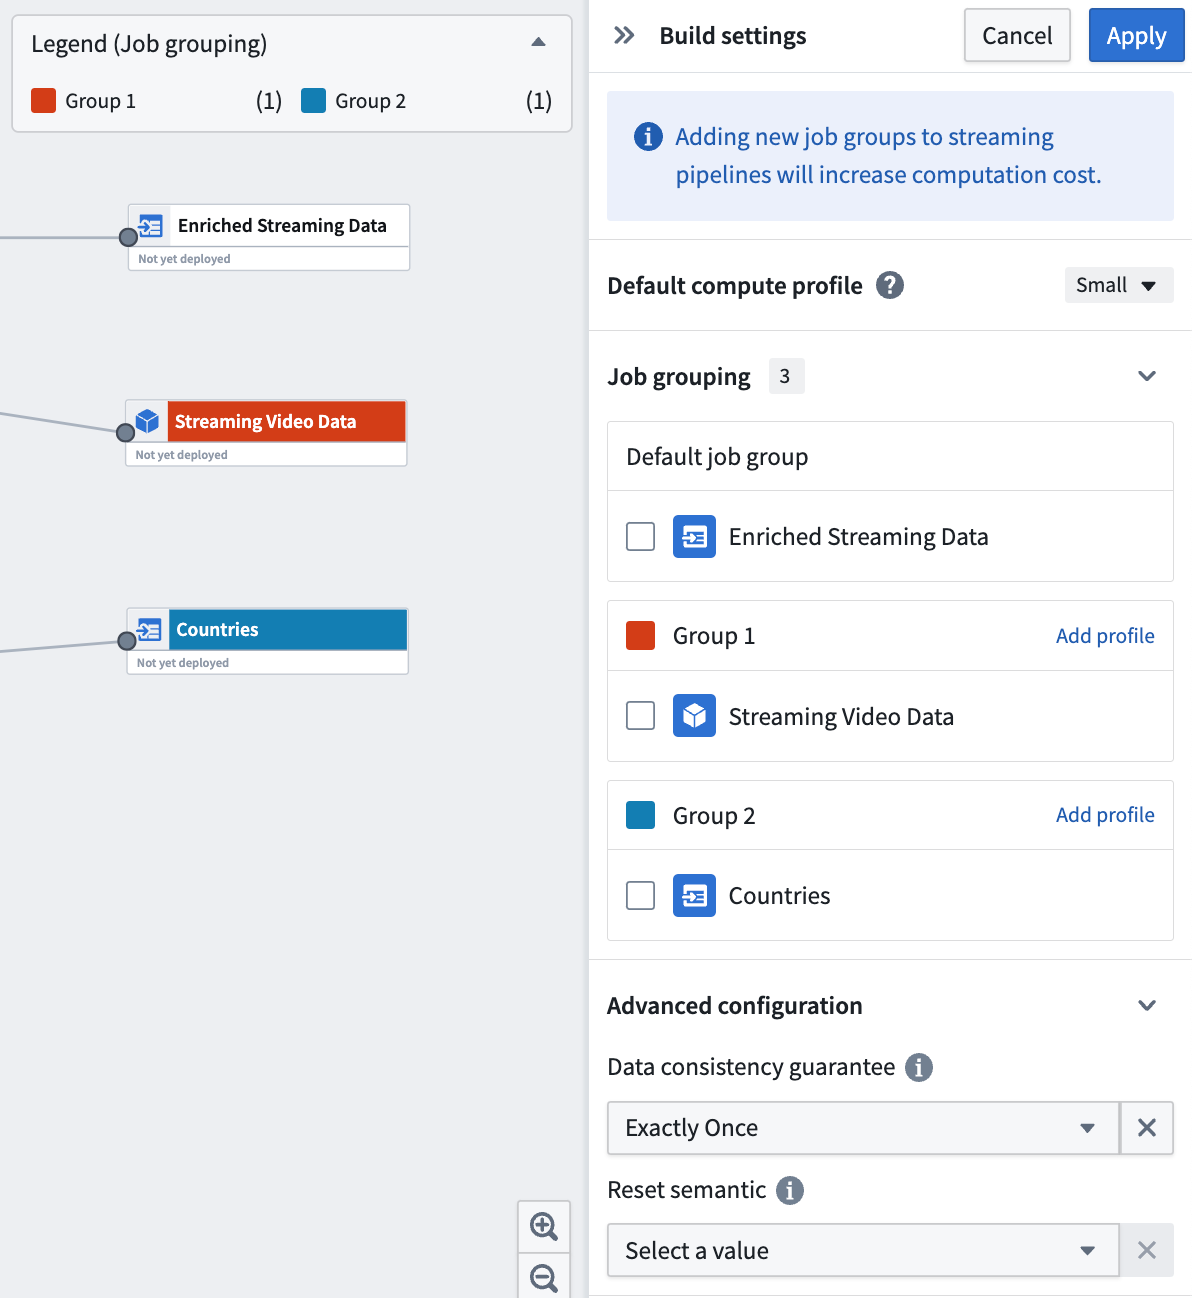
Pipeline Builder でジョブグループを作成する機能 | Pipeline Builder では、デプロイに成功するたびに1回のビルドが開始されます。バッチパイプラインでは、デフォルトで各出力が個別のジョブとしてビルドされるため、出力ジョブの成功または失敗はそれぞれ独立しています。ストリーミングパイプラインでは、デフォルトですべての出力が、単一の Flink クラスター上で実行される1個のジョブにまとめられるため、出力ストリームはすべてまとめて成功するか、すべてまとめて失敗します。
ジョブのグループ化により、バッチパイプラインでは複数の出力を1個のジョブにまとめたり、ストリーミングパイプラインでは各出力を個別のジョブに分割したりできます。また、グループごとにコンピューティングプロファイルを指定して、出力のビルド方法を細かく制御できます。
データ統合 | Pipeline Builder
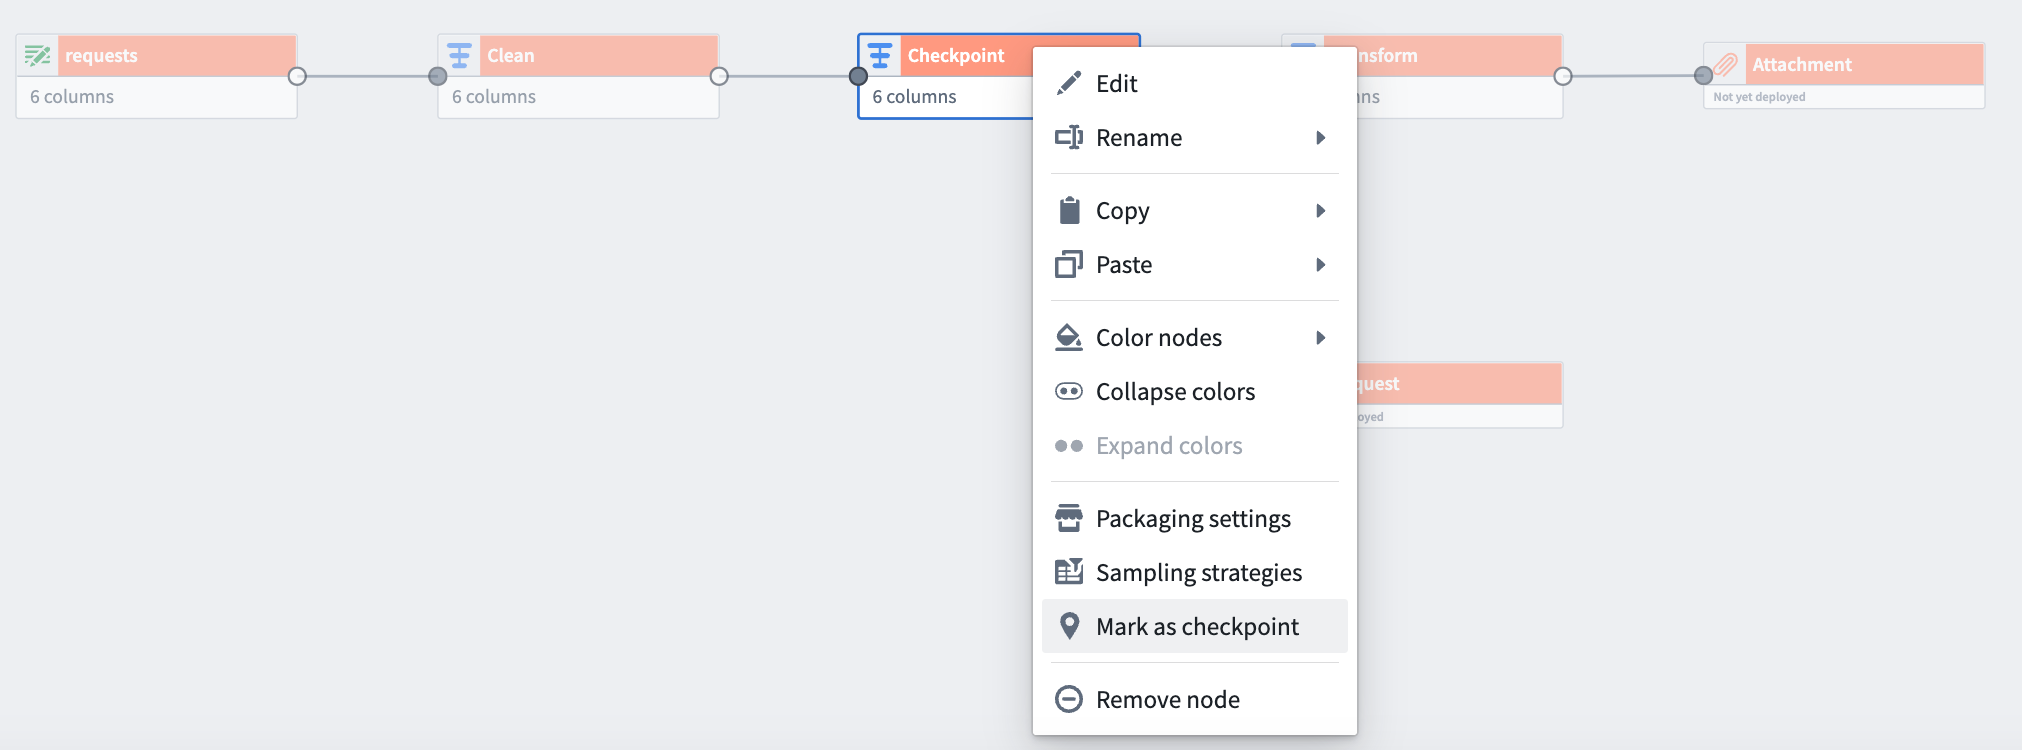
バッチパイプラインでチェックポイント機能が利用可能に | パイプラインを構築する際、複数の出力間で共有するデータ加工ノードを使うことがよくあります。このロジックは通常、出力ごとに1回再計算されます。チェックポイント機能を使うと、データ加工ノードを「チェックポイント」として指定し、次回のビルド時に中間結果を保存できます。そのチェックポイントノードまでのロジックは、共有するすべての出力に対して1回だけ計算されます。これにより、コンピューティングリソースを節約し、ビルド時間を短縮できます。
オントロジー | Foundry Rules
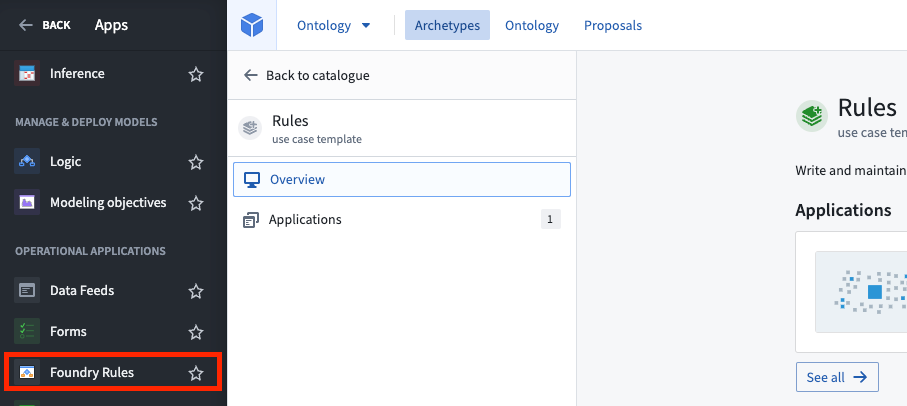
サイドバーから Foundry Rules の設定にアクセス可能に | Foundry Rules のデプロイと設定の UI に、より目立つサイドバーアイコンからアクセスできるようになりました。詳細は、ドキュメントのワークフローテンプレートをデプロイするを参照してください。
オントロジー | オントロジー管理
OMA のパフォーマンス改善:表示速度 | Ontology Manager は、アプリ全体ではなく更新された要素のみを読み込むことで、表示が速くなりました。Ontology Manager のユーザーは、ページ間の移動や編集時に、より応答性の高い操作を体験できます。
データ統合 | スケジューラー
ビルド所要時間のモニターを追加する | Data Health アプリの監視ビューで、ビルド所要時間のモニターを作成できるようになりました。