注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
トランスフォーム内で Palantir 提供の言語モデルを使用する
Palantir は、Spark トランスフォームと軽量トランスフォームを含む Python トランスフォーム内で使用できる言語モデルと埋め込みモデルを提供しています。これらのモデルは、palantir_models ライブラリを通じて使用できます。このライブラリは、transforms.api.transform デコレーターで使用できる入力パラメーターを提供します。
共通のモデル API を通じてテキストで会話するには、GenericChatCompletionLanguageModelInput を使用します。Python の例、および GenericChatCompletionRequest、メッセージロール、レスポンスフィールドのドキュメントについては、汎用チャット補完リファレンスを参照してください。
前提条件
Palantir 提供の言語モデルを使用するには、エンロールメントで AIP を事前に有効にする必要があります。
リポジトリのセットアップ
トランスフォームに言語モデルのサポートを追加するには、コードリポジトリの左側にあるライブラリ検索パネルを開きます。palantir_models を検索し、ライブラリタブでライブラリの追加とインストールを選択します。language-model-service-api についてもこの手順を繰り返し、そのライブラリも追加します。
すると、コードリポジトリですべての依存関係が解決され、チェックが再実行されます。チェックの完了には少し時間がかかる場合があります。完了すると、トランスフォームでライブラリを使用できるようになります。
トランスフォームの設定
palantir_model クラスは、transforms.api.transform デコレーターでのみ使用できます。この例では、palantir_models.transforms.OpenAiGptChatLanguageModelInput を使用します。まず、Python ファイルに OpenAiGptChatLanguageModelInput をインポートします。これで、このクラスを使用してトランスフォームを作成できます。次に、画面の案内に従って、入力として使用するモデルとデータセットを指定し、インポートします。
Copied!1 2 3 4 5 6 7 8 9 10 11from transforms.api import transform, Input, Output from palantir_models.transforms import OpenAiGptChatLanguageModelInput from palantir_models.models import OpenAiGptChatLanguageModel @transform( source_df=Input("/path/to/input/dataset"), model=OpenAiGptChatLanguageModelInput("ri.language-model-service..language-model.gpt-4_azure"), output=Output("/path/to/output/dataset"), ) def compute_generic(ctx, source_df, model: OpenAiGptChatLanguageModel, output): ...
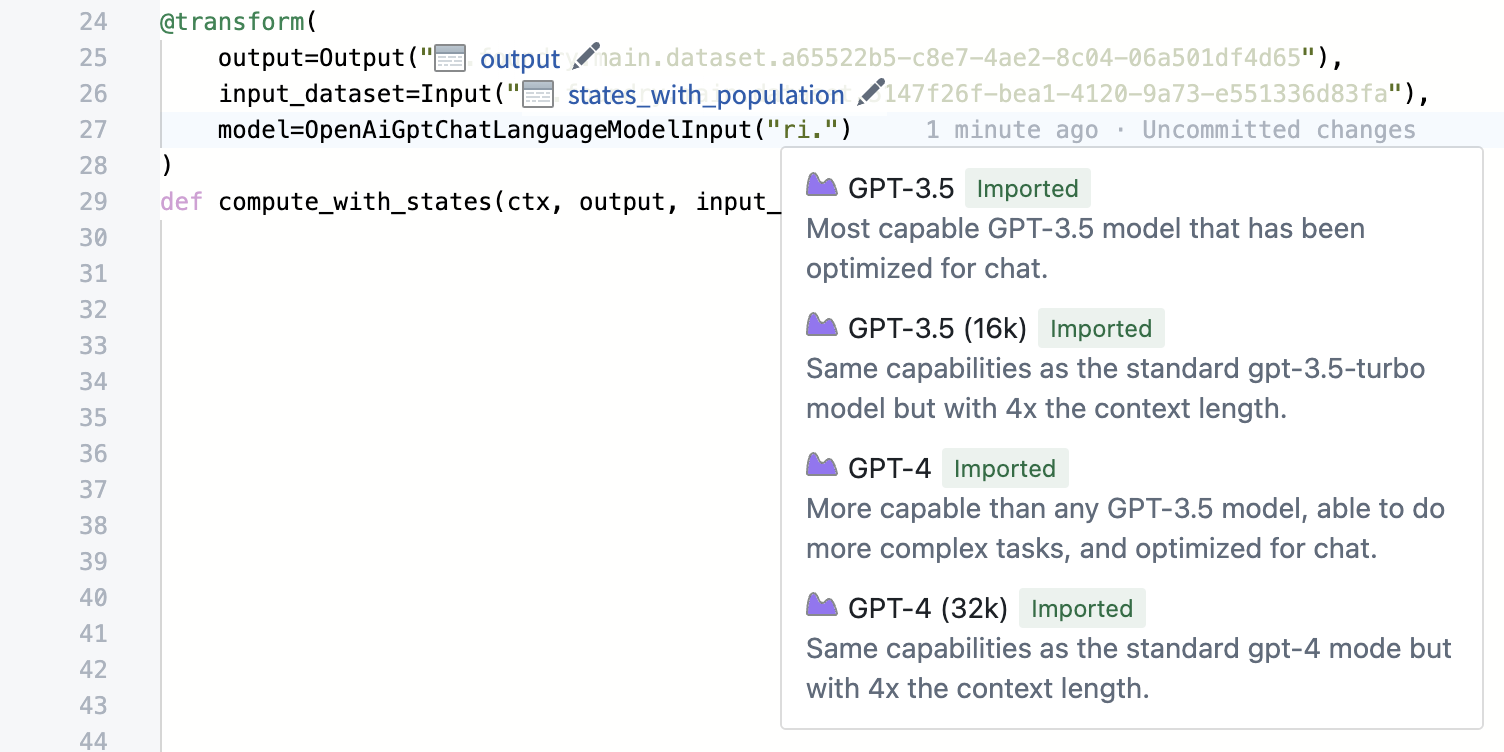
リソース識別子を入力し始めると、使用可能なモデルを示すドロップダウンメニューが自動的に表示されます。ドロップダウンから目的の選択肢を選択できます。
言語モデルを使用して補完を生成する
この例では、言語モデルを使用して、入力データセット内の各レビューの感情を判定します。入力データセットには review_content 列が含まれている必要があります。OpenAiGptChatLanguageModelInput は、実行時に OpenAiGptChatLanguageModel をトランスフォームに渡します。これを使用して、レビューに対する補完を生成できます。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25from transforms.api import transform, Input, Output from palantir_models.transforms import OpenAiGptChatLanguageModelInput from palantir_models.models import OpenAiGptChatLanguageModel from language_model_service_api.languagemodelservice_api_completion_v3 import GptChatCompletionRequest from language_model_service_api.languagemodelservice_api import ChatMessage, ChatMessageRole @transform( reviews=Input("/path/to/reviews/dataset"), model=OpenAiGptChatLanguageModelInput("ri.language-model-service..language-model.gpt-4_azure"), output=Output("/output/path"), ) def compute_sentiment(ctx, reviews, model: OpenAiGptChatLanguageModel, output): def get_completions(review_content: str) -> str: system_prompt = "Take the following review determine the sentiment of the review" request = GptChatCompletionRequest( [ChatMessage(ChatMessageRole.SYSTEM, system_prompt), ChatMessage(ChatMessageRole.USER, review_content)] ) resp = model.create_chat_completion(request) return resp.choices[0].message.content reviews_df = reviews.pandas() reviews_df['sentiment'] = reviews_df['review_content'].apply(get_completions) out_df = ctx.spark_session.createDataFrame(reviews_df) return output.write_dataframe(out_df)
埋め込み
Palantir は、生成言語モデルに加えて埋め込みモデルも提供しています。次の例では、palantir_models.transforms.GenericEmbeddingModelInput を使用して、同じ reviews データセットの埋め込みを計算する方法を示します。GenericEmbeddingModelInput は、実行時に GenericEmbeddingModel をトランスフォームに渡します。これを使用して、各レビューの埋め込みを計算できます。オントロジーのベクトルプロパティで必要なため、埋め込みは明示的に Float にキャストされます。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22from transforms.api import transform, Input, Output from language_model_service_api.languagemodelservice_api_embeddings_v3 import GenericEmbeddingsRequest from palantir_models.models import GenericEmbeddingModel from palantir_models.transforms import GenericEmbeddingModelInput from pyspark.sql.types import ArrayType, FloatType @transform( reviews=Input("/path/to/reviews/dataset"), embedding_model=GenericEmbeddingModelInput("ri.language-model-service..language-model.text-embedding-ada-002_azure"), output=Output("/path/to/embedding/output") ) def compute_embeddings(ctx, reviews, embedding_model: GenericEmbeddingModel, output): def internal_create_embeddings(val: str): return embedding_model.create_embeddings(GenericEmbeddingsRequest(inputs=[val])).embeddings[0] reviews_df = reviews.pandas() reviews_df['embedding'] = reviews_df['review_content'].apply(internal_create_embeddings) spark_df = ctx.spark_session.createDataFrame(reviews_df) out_df = spark_df.withColumn('embedding', spark_df['embedding'].cast(ArrayType(FloatType()))) return output.write_dataframe(out_df)
軽量トランスフォーム
言語モデルの入力は、Spark を使用せずに単一ノードで実行される軽量トランスフォームでもサポートされています。Spark の分散処理が不要な場合、軽量トランスフォームのほうが高速で、コスト効率も優れています。transforms.api.transform.using() を使用し、PySpark の代わりに pandas DataFrame を直接操作します。
次の例では、軽量トランスフォームで言語モデルを使用して感情を分類します。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28import pandas as pd from transforms.api import transform, Output from palantir_models.transforms import OpenAiGptChatLanguageModelInput from palantir_models.models import OpenAiGptChatLanguageModel from language_model_service_api.languagemodelservice_api_completion_v3 import GptChatCompletionRequest from language_model_service_api.languagemodelservice_api import ChatMessage, ChatMessageRole @transform.using( model=OpenAiGptChatLanguageModelInput("ri.language-model-service..language-model.gpt-4-1-nano"), output=Output("/path/to/output/dataset"), ) def compute_sentiment(model: OpenAiGptChatLanguageModel, output): items = ["I love this product!", "This is terrible.", "It was okay, nothing special."] def get_sentiment(text): request = GptChatCompletionRequest( [ ChatMessage(ChatMessageRole.SYSTEM, "Respond with one word: positive, negative, or neutral."), ChatMessage(ChatMessageRole.USER, text), ] ) resp = model.create_chat_completion(request) return resp.choices[0].message.content df = pd.DataFrame({"text": items}) df["sentiment"] = df["text"].apply(get_sentiment) output.write_table(df)
軽量トランスフォームでは、OpenAiGptChatLanguageModelInput、GenericChatCompletionLanguageModelInput、GenericEmbeddingModelInput、AnthropicClaudeLanguageModelInput など、すべての言語モデル入力タイプがサポートされています。
視覚言語モデルを使用して PDF ドキュメントの内容を抽出する
視覚言語モデルを使用した PDF ドキュメント抽出ワークフローには、AIP Document Intelligence の使用を推奨します。AIP Document Intelligence は、ドキュメントに対してさまざまな抽出方法をテストし、結果を比較して、本番環境にデプロイする前に抽出品質を評価できる、直感的なインターフェースを提供します。
設定をデプロイすると、Python トランスフォームのコードリポジトリが作成され、選択した抽出方法、モデル、およびカスタムプロンプトがある場合はそれらが自動的に設定されます。ドキュメント抽出用のトランスフォームコードを手動で記述する必要はありません。詳しくはこちら:Python トランスフォームへのデプロイ。