注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
JDBC 同期を最適化する
このガイドでは、JDBC 同期の速度と信頼性を向上させるためのヒントを紹介します。
同期がすでに安定して動作している場合は、以下の操作を行う必要はありません。新しい同期を設定する場合や、同期の完了に時間がかかりすぎる、または安定して完了しない場合は、このガイドに沿って進めることを推奨します。
JDBC 同期を高速化するには、主に2つの方法があります。まず同期をインクリメンタルにし、それだけでは不十分な場合にのみ SQL クエリの並列化に進むことを推奨します。
インクリメンタル(差分)同期
デフォルトでは、バッチ同期は対象テーブルから条件に一致するすべての行を同期します。一方、インクリメンタル同期は、直近の同期に関する状態を保持するため、対象から条件に一致する新しい行のみを取り込むことができます。これにより、行数の多いテーブルの同期パフォーマンスを大幅に改善できます。インクリメンタル同期は、同期先のデータセットに APPEND トランザクションとしてデータを追加することで動作します。
以下は、インクリメンタルバッチ同期の設定例です。
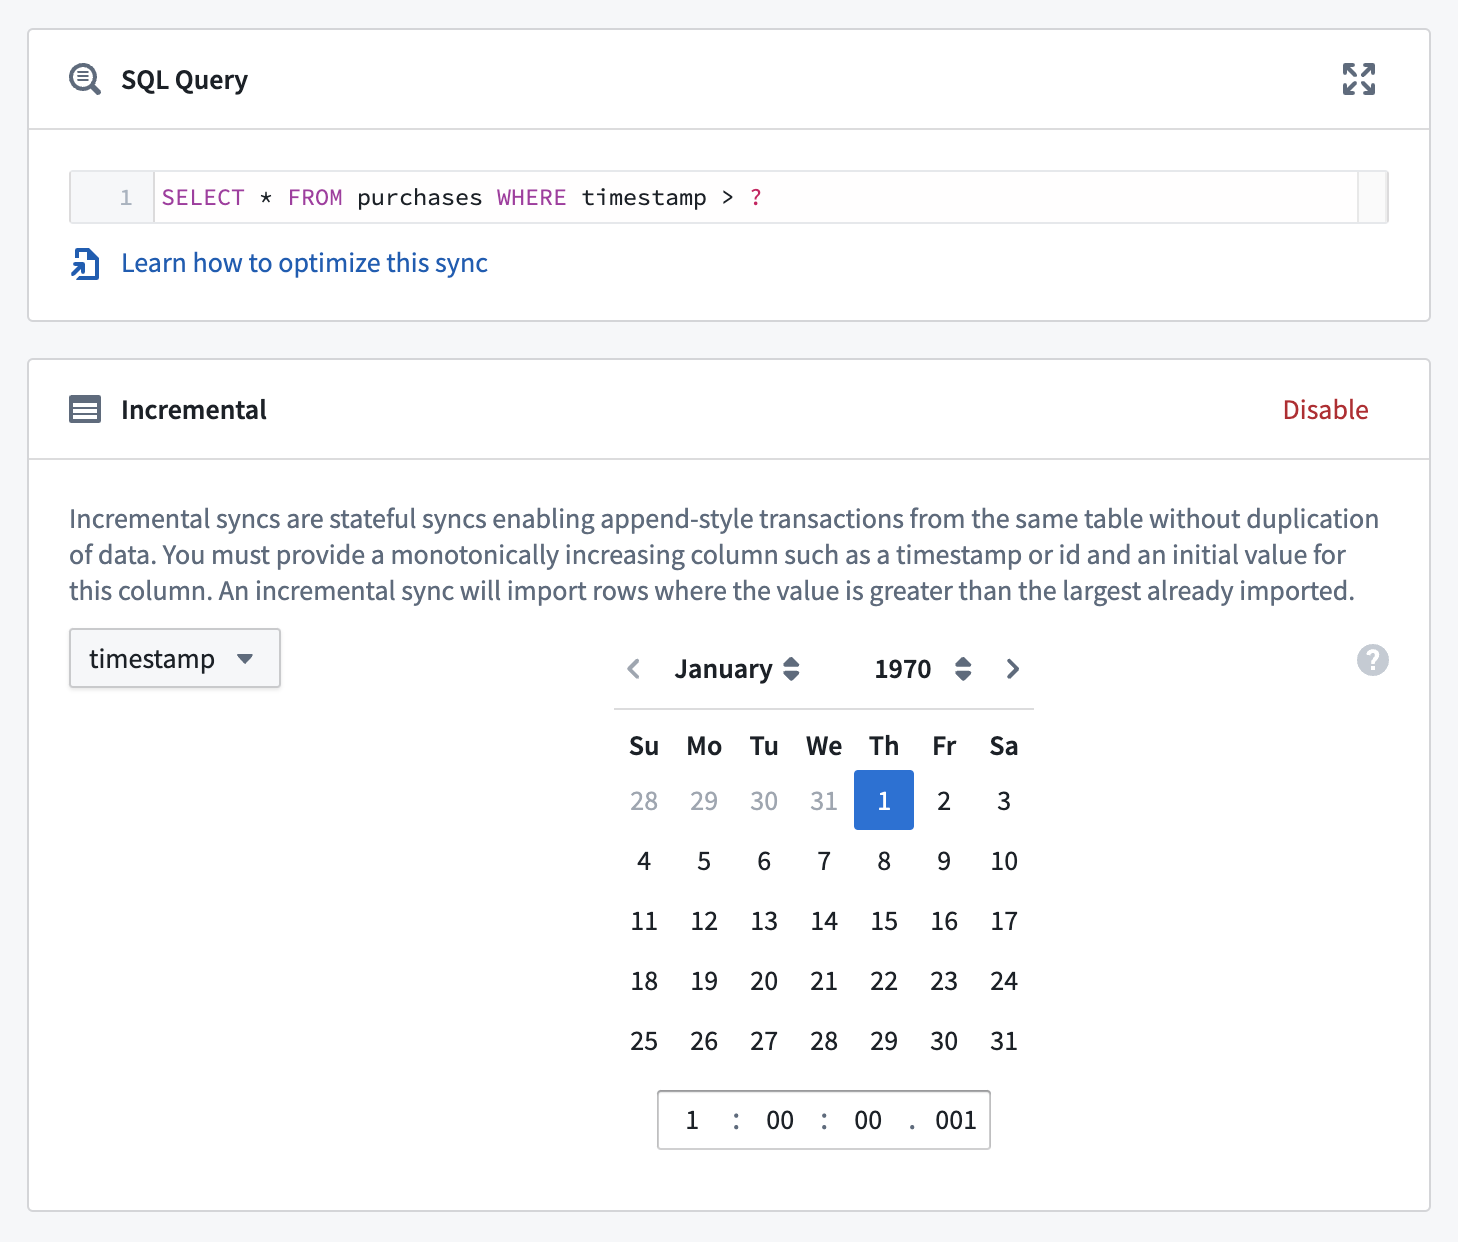
インクリメンタルバッチ同期を設定するには、次の手順を実行します。
-
変換する同期の設定ページに移動し、プレビューが動作していることを確認します。
-
トランザクションタイプを
APPENDに設定します。これは、以前の同期で取り込んだ行が上書きされるのを防ぐために必要です。 -
インクリメンタルボックスで有効にするを選択します。この同期でプレビューが正常に実行されたことを確認してください。プレビューが正常に動作すると、インクリメンタルボックスが展開され、同期の初期インクリメンタル状態を設定できるようになります。
-
同期のインクリメンタル状態を設定します。この状態は、インクリメンタル列と初期値で構成され、ユーザーインターフェースで設定できます。これらの値を設定するときは、次の重要な点に留意してください。
- インクリメンタル列の値は、同期のたびに_厳密に増加_する必要があります。行が不変である場合(つまり、既存の行をその場で更新できない場合)は、一貫して増加する列(自動インクリメントされる ID や、行が追加された時刻を示すタイムスタンプなど)であれば十分です。行が可変である場合(つまり、新しい行の挿入だけでなく、既存の行の更新もテーブルで許可されている場合)は、データが変更されるたびに値が増加する列(
update_time列など)が必要です。 - 同じ行を2回以上取り込まないようにするには、インクリメンタル列の初期値を、以前の実行で同期した_すべての行_の値より大きくする必要があります。たとえば、直近の
SNAPSHOT同期で取り込んだ行の Integer 型のid列の値が最大1999であった場合、初期値を2000に設定できます。
- インクリメンタル列の値は、同期のたびに_厳密に増加_する必要があります。行が不変である場合(つまり、既存の行をその場で更新できない場合)は、一貫して増加する列(自動インクリメントされる ID や、行が追加された時刻を示すタイムスタンプなど)であれば十分です。行が可変である場合(つまり、新しい行の挿入だけでなく、既存の行の更新もテーブルで許可されている場合)は、データが変更されるたびに値が増加する列(
既存の行の更新後のバージョンを取り込んでも、Foundry データセットにはその行の以前のバージョンが引き続き含まれます(この同期では APPEND トランザクションタイプを使用していることに留意してください)。各行の_最新_バージョンのみが必要な場合は、Transforms などの Foundry の別のツールを使用してデータをクレンジングする必要があります。インクリメンタルパイプラインに関するガイドで詳しくはこちらをご覧ください。
- 最後に、ワイルドカード記号
?を使用するようにクエリを更新します。クエリにワイルドカードをどのように含めるかは、クエリのロジックによって異なります。以下の簡単な例を参照し、次の点に留意してください。- 最初のインクリメンタル実行では、このワイルドカードは前の手順で指定した初期値に 置き換えられます。
- それ以降の実行では、ワイルドカードは前回の実行で同期されたインクリメンタル列の_最大_値に置き換えられます。
前述のとおり、インクリメンタル状態のインターフェースは、同期のプレビューが正常に実行された場合にのみ動作します。そのため、インクリメンタル同期を最初から作成する場合や、既存のインクリメンタル同期を複製する場合は、クエリにワイルドカード ? 演算子を含めずにプレビューを実行する必要があります。
例
employees というテーブルを、トランザクションタイプを SNAPSHOT に設定し、次の簡単な SQL クエリで取り込むとします。
Copied!1 2 3 4SELECT * FROM employees
時刻 T1 では、テーブルは次のようになっています。
| id | name | surname | update_time | insert_time |
|---|---|---|---|---|
1 | Jane | Smith | 1478862205 | 1478862205 |
2 | Erika | Mustermann | 1478862246 | 1478862246 |
このテーブルは可変であり、後の時刻 T2 では次のようになっているとします。
| id | name | surname | update_time | insert_time |
|---|---|---|---|---|
1 | Jane | Doe | 1478862452 | 1478862205 |
2 | Erika | Mustermann | 1478862246 | 1478862246 |
3 | Juan | Perez | 1478862438 | 1478862438 |
この同期をインクリメンタルに変換するため、トランザクションタイプを APPEND に更新します。
インクリメンタル列には何を使用すべきでしょうか。id 列も insert_time 列も、インクリメンタル列として使用するには適していません。これらの列では、Jane の行の surname 列の変更のような更新を検出できないためです。代わりに、インクリメンタル列として update_time を使用します。
初期値として何を選ぶかは、このテーブルの行が以前に同期されているかどうかによって異なります。時刻 T1 に SNAPSHOT 同期を実行し、update_time の値が最大 1478862246 の行まですでに同期しているとすると、重複を避けるために初期値として 1478862247 を使用します。このテーブルの行を一度も同期していない場合は、初期値として 0(日付を設定する場合は 01/01/1970)を使用できます。
最後に、SQL クエリを次のように変更します。
Copied!1 2 3 4 5 6SELECT * FROM employees WHERE update_time > ?
これで変換は完了です。同期をインクリメンタルに実行すると、データセットには Jane の行が複数含まれるようになります(更新ごとに1行)。前述のとおり、これらの重複は、たとえば Contour や Transforms などの下流のロジックで処理する必要があります。
インクリメンタル JDBC 同期で問題が発生した場合は、トラブルシューティングガイドのこのセクションが役立つ場合があります。
SQL クエリを並列化する
並列機能では対象のデータベースに対して個別のクエリを実行するため、実行タイミングがわずかに異なるクエリによって、ライブ更新されるテーブルが異なる状態で扱われる場合があることを慎重に検討してください。
並列機能を使用すると、SQL クエリを複数の小さなクエリに簡単に分割し、Agent で並列に実行できます。
この動作を実現するには、SQL 文を次の構造に変更する必要があります。
Copied!1 2 3 4 5 6 7 8 9SELECT /* FORCED_PARALLELISM_COLUMN({{column}}), FORCED_PARALLELISM_SIZE({{size}}) */ column1, column2 FROM {{table_name}} WHERE {{condition}} /* ALREADY_HAS_WHERE_CLAUSE(TRUE) */
クエリの主要な部分は次のとおりです。
FORCED_PARALLELISM_COLUMN({{column}})- テーブルの分割に使用する列を指定します。
- 分布が_できるだけ均等_な数値列(または数値列を生成する列の式)を指定する必要があります。
FORCED_PARALLELISM_SIZE({{size}})- 並列度を指定します。たとえば、
4を指定すると、指定した並列化用の列の値を分割する4個のクエリと、並列化用の列の NULL 値を対象とする1個のクエリの、合計5個のクエリが同時に実行されます。
- 並列度を指定します。たとえば、
ALREADY_HAS_WHERE_CLAUSE(TRUE)WHERE句がすでにあるか、生成する必要があるかを指定します。FALSEの場合、生成される各クエリにWHERE column%size = Xが追加されます。TRUEの場合は、代わりにANDを使用してこの条件が追加されます。
例
次のデータを含む employees というテーブルを同期するとします。
| id | name | surname |
|---|---|---|
1 | Jane | Smith |
2 | Erika | Mustermann |
3 | Juan | Perez |
NULL | Mary | Watts |
基本的なクエリは次のようになります。
Copied!1 2 3 4SELECT id, name, surname FROM employees
このクエリはデータベースで1個のクエリを実行し、テーブルからすべてのレコードの取得を試みます。
並列化の仕組みを活用するには、クエリを次のように変更します。
Copied!1 2 3 4 5 6SELECT /* FORCED_PARALLELISM_COLUMN(id), FORCED_PARALLELISM_SIZE(2) */ id, name, surname FROM employees /* ALREADY_HAS_WHERE_CLAUSE(FALSE) */
これにより、次の3個のクエリが並列に実行されます。
Copied!1 2 3 4 5 6SELECT id, name, surname FROM employees WHERE id % 2 = 1
抽出結果:
| id | name | surname |
|---|---|---|
1 | Jane | Smith |
3 | Juan | Perez |
および
Copied!1 2 3 4 5 6SELECT id, name, surname FROM employees WHERE id % 2 = 0
抽出結果:
| id | name | surname |
|---|---|---|
2 | Erika | Mustermann |
および
Copied!1 2 3 4 5 6SELECT id, name, surname FROM employees WHERE id % 2 IS NULL
抽出結果:
| id | name | surname |
|---|---|---|
NULL | Mary | Watts |
OR 条件を含む WHERE 句での並列化
OR 条件を含む WHERE 句で並列化を使用する場合は、条件の評価方法を示すために、条件を括弧で囲む必要があります。たとえば、次の同期を確認します。
Copied!1 2 3 4 5 6 7SELECT /* FORCED_PARALLELISM_COLUMN(col1), FORCED_PARALLELISM_SIZE(32) */ col1, col2 FROM tbl WHERE condition1 = TRUE OR condition2 = TRUE /* ALREADY_HAS_WHERE_CLAUSE(TRUE) */
この同期の例は、次のように変換されます。
Copied!1condition1 = TRUE OR condition2 = TRUE AND col1 % X = 0
ただし、この文は、意図した (condition1 = TRUE OR condition2 = TRUE) AND col1 % X = 0 ではなく、condition1 = TRUE OR (condition2 = TRUE AND col1 % X = 0) と論理的に解釈される場合があります。WHERE 句全体を括弧で囲むことで、意図したとおりに解釈されるようにできます。上記の例では、次のようになります。
Copied!1 2 3 4 5 6 7SELECT /* FORCED_PARALLELISM_COLUMN(col1), FORCED_PARALLELISM_SIZE(32) */ col1, col2 FROM tbl WHERE (condition1 = TRUE OR condition2 = TRUE) /* ALREADY_HAS_WHERE_CLAUSE(TRUE) */