注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
Iceberg テーブルによるインクリメンタル(差分処理)
インクリメンタル計算は、入力を処理して出力を生成する効率的な方法です。インクリメンタル計算を使用すると、毎回入力全体を再処理するのではなく、前回の実行以降に変更されたデータだけを処理できます。
このページでは、Iceberg テーブルをインクリメンタルに扱うための概念を説明します。Python トランスフォームの API ガイドについては、インクリメンタル Python トランスフォームと、付随するインクリメンタルコードの例を参照してください。変更履歴に特化したガイダンスについては、Iceberg の変更履歴と CDC パイプラインを参照してください。
Iceberg によるインクリメンタルビルドのサポート
次のテーブルは、Iceberg によるインクリメンタルビルド計算に対する Foundry のサポートをまとめたものです。
| 計算エンジン | インクリメンタルのサポート |
|---|---|
| Python トランスフォーム: Spark | ✅ 追加専用 ✅ 変更履歴 |
| Python トランスフォーム:単一ノード* | ✅ 追加専用 ❌ 変更履歴 |
| Pipeline Builder: Spark | ✅ 追加専用 ❌ 変更履歴 |
| Pipeline Builder: 高速パイプライン | ❌ 追加専用 ❌ 変更履歴 |
オントロジーのオブジェクトタイプのインクリメンタルインデックス化
Copy-on-write の Iceberg テーブルを元にしているオブジェクトタイプは、行単位でインクリメンタルにインデックス化されます。元テーブルの行の編集と削除は、オブジェクトの編集と削除としてオントロジーに伝播するため、1行を削除すると、テーブル全体を再インデックス化するのではなく、対応するオブジェクトだけが更新されます。
Iceberg の copy-on-write は、データファイル全体を書き換えることで行単位の変更を適用します。そのため、インクリメンタルインデックスビルドで読み取られるデータ量は、変更された行数ではなく、書き換えられたファイルのサイズに応じて増加します。多数のファイルに分散した行に影響する変更は、少数のファイルに集中した同じ件数の変更よりも、インデックス化のコストが高くなります。
Merge-on-read は、データファイルを書き換えるのではなく、削除ファイルとして行単位の変更を記録します。現在、Iceberg の変更履歴スキャンでは、削除ファイルを含むスナップショットを読み取れません。オブジェクトタイプの元となるテーブルで merge-on-read による削除または更新が行われると、インクリメンタルインデックスビルドに失敗します。
オブジェクトタイプの元となるテーブルは、Iceberg のデフォルトである copy-on-write のままにしてください。Foundry はこのデフォルトをオーバーライドしないため、明示的にプロパティを設定して変更しない限り、テーブルは copy-on-write になります。
変更を読み書きする
変更を読み取る
Iceberg テーブルをインクリメンタルに読み取る場合、Foundry は指定された読み取りモードに従って、指定されたスナップショット範囲内の変更を取得します。
デフォルトの追加専用読み取りモードでは、スナップショット範囲に追加または置換(コンパクション)のみが含まれる場合、Foundry はインクリメンタルに処理できます。上書きまたは削除のスナップショットが含まれる場合、インクリメンタルチェックに失敗し、require_incremental 設定に応じて、Foundry は非インクリメンタルな全体読み取りにフォールバックするか、ジョブを失敗させます。
変更履歴読み取りモードでは、Foundry は追加、上書き、削除、置換を含めてインクリメンタルに処理できます。このモードでは、変更データキャプチャ形式のパイプライン向けの Iceberg の変更履歴ビュー ↗など、変更履歴に基づく読み取りが可能になります。
変更を書き込む
Iceberg テーブルは、標準の Spark SQL 書き込みステートメント ↗に対応しています。
次のテーブルは、変更をインクリメンタルに書き込む際に特に関連するステートメントをまとめたものです。
| ステートメント | 指定するソース | 出力テーブルへの効果 |
|---|---|---|
INSERT INTO | 追加する行 | 行を追加します。既存の行が変更されることはなく、その行が新しいかどうかもチェックされません。 |
MERGE INTO | テーブルまたはクエリ | 記述した WHEN MATCHED 句と WHEN NOT MATCHED 句を適用します。識別子が一致する行を更新し、一致しない行を挿入する upsert に使用します。また、THEN DELETE 句を追加して、一致した行を削除するためにも使用します。 |
UPDATE | 述語と新しい値 | 述語に一致する行を更新します。 |
DELETE FROM | 述語 | 述語に一致する行を削除します。 |
Foundry 内でインクリメンタルに書き込む際には、これらのオープンソース API を直接使用できます。例については、高度な Iceberg API を参照してください。Foundry は、INSERT INTO(追加専用のインクリメンタル処理経由)と MERGE INTO(Foundry の apply_changelog 経由)に対する便利なラッパーも提供しています。Foundry API の使用方法の詳細については、インクリメンタル Python トランスフォームを参照してください。
Copy-on-write と merge-on-read
Iceberg には、行単位の変更を適用するための2つの方式があります。方式を選択するのはテーブルの生成元ですが、その選択はテーブルの利用側を制約するため、パイプラインレベルでの判断になります。
| 方式 | 動作 | トレードオフ |
|---|---|---|
| Copy-on-write (Iceberg のデフォルト) | 影響を受ける行を含むすべてのデータファイルを書き換えます。 | 書き込みが遅く、読み取りが速い |
| Merge-on-read | 既存のデータファイルをそのまま保持し、影響を受ける行を削除済みとして指定する削除ファイルを追加で書き込みます。更新とマージでは、更新された行を含む新しいデータファイルも書き込みます。利用側はクエリ時に削除ファイルを適用して、テーブルの現在の状態を再構成します。 | 書き込みが速く、読み取りが遅い |
テーブルが copy-on-write と merge-on-read のどちらを使用するかは、write.delete.mode、
write.update.mode、write.merge.mode のテーブルプロパティによって決まります。これらのプロパティが明示的に設定されていない場合、テーブルは Iceberg のデフォルトである copy-on-write を継承します。これらのプロパティは、行単位の変更が適用されたときにのみ効果を発揮します。追加のみが行われてきた merge-on-read テーブルには削除ファイルが含まれず、copy-on-write テーブルと同様に動作します。
次の図は、1行の編集を適用する際の copy-on-write と merge-on-read の違いを示しています。
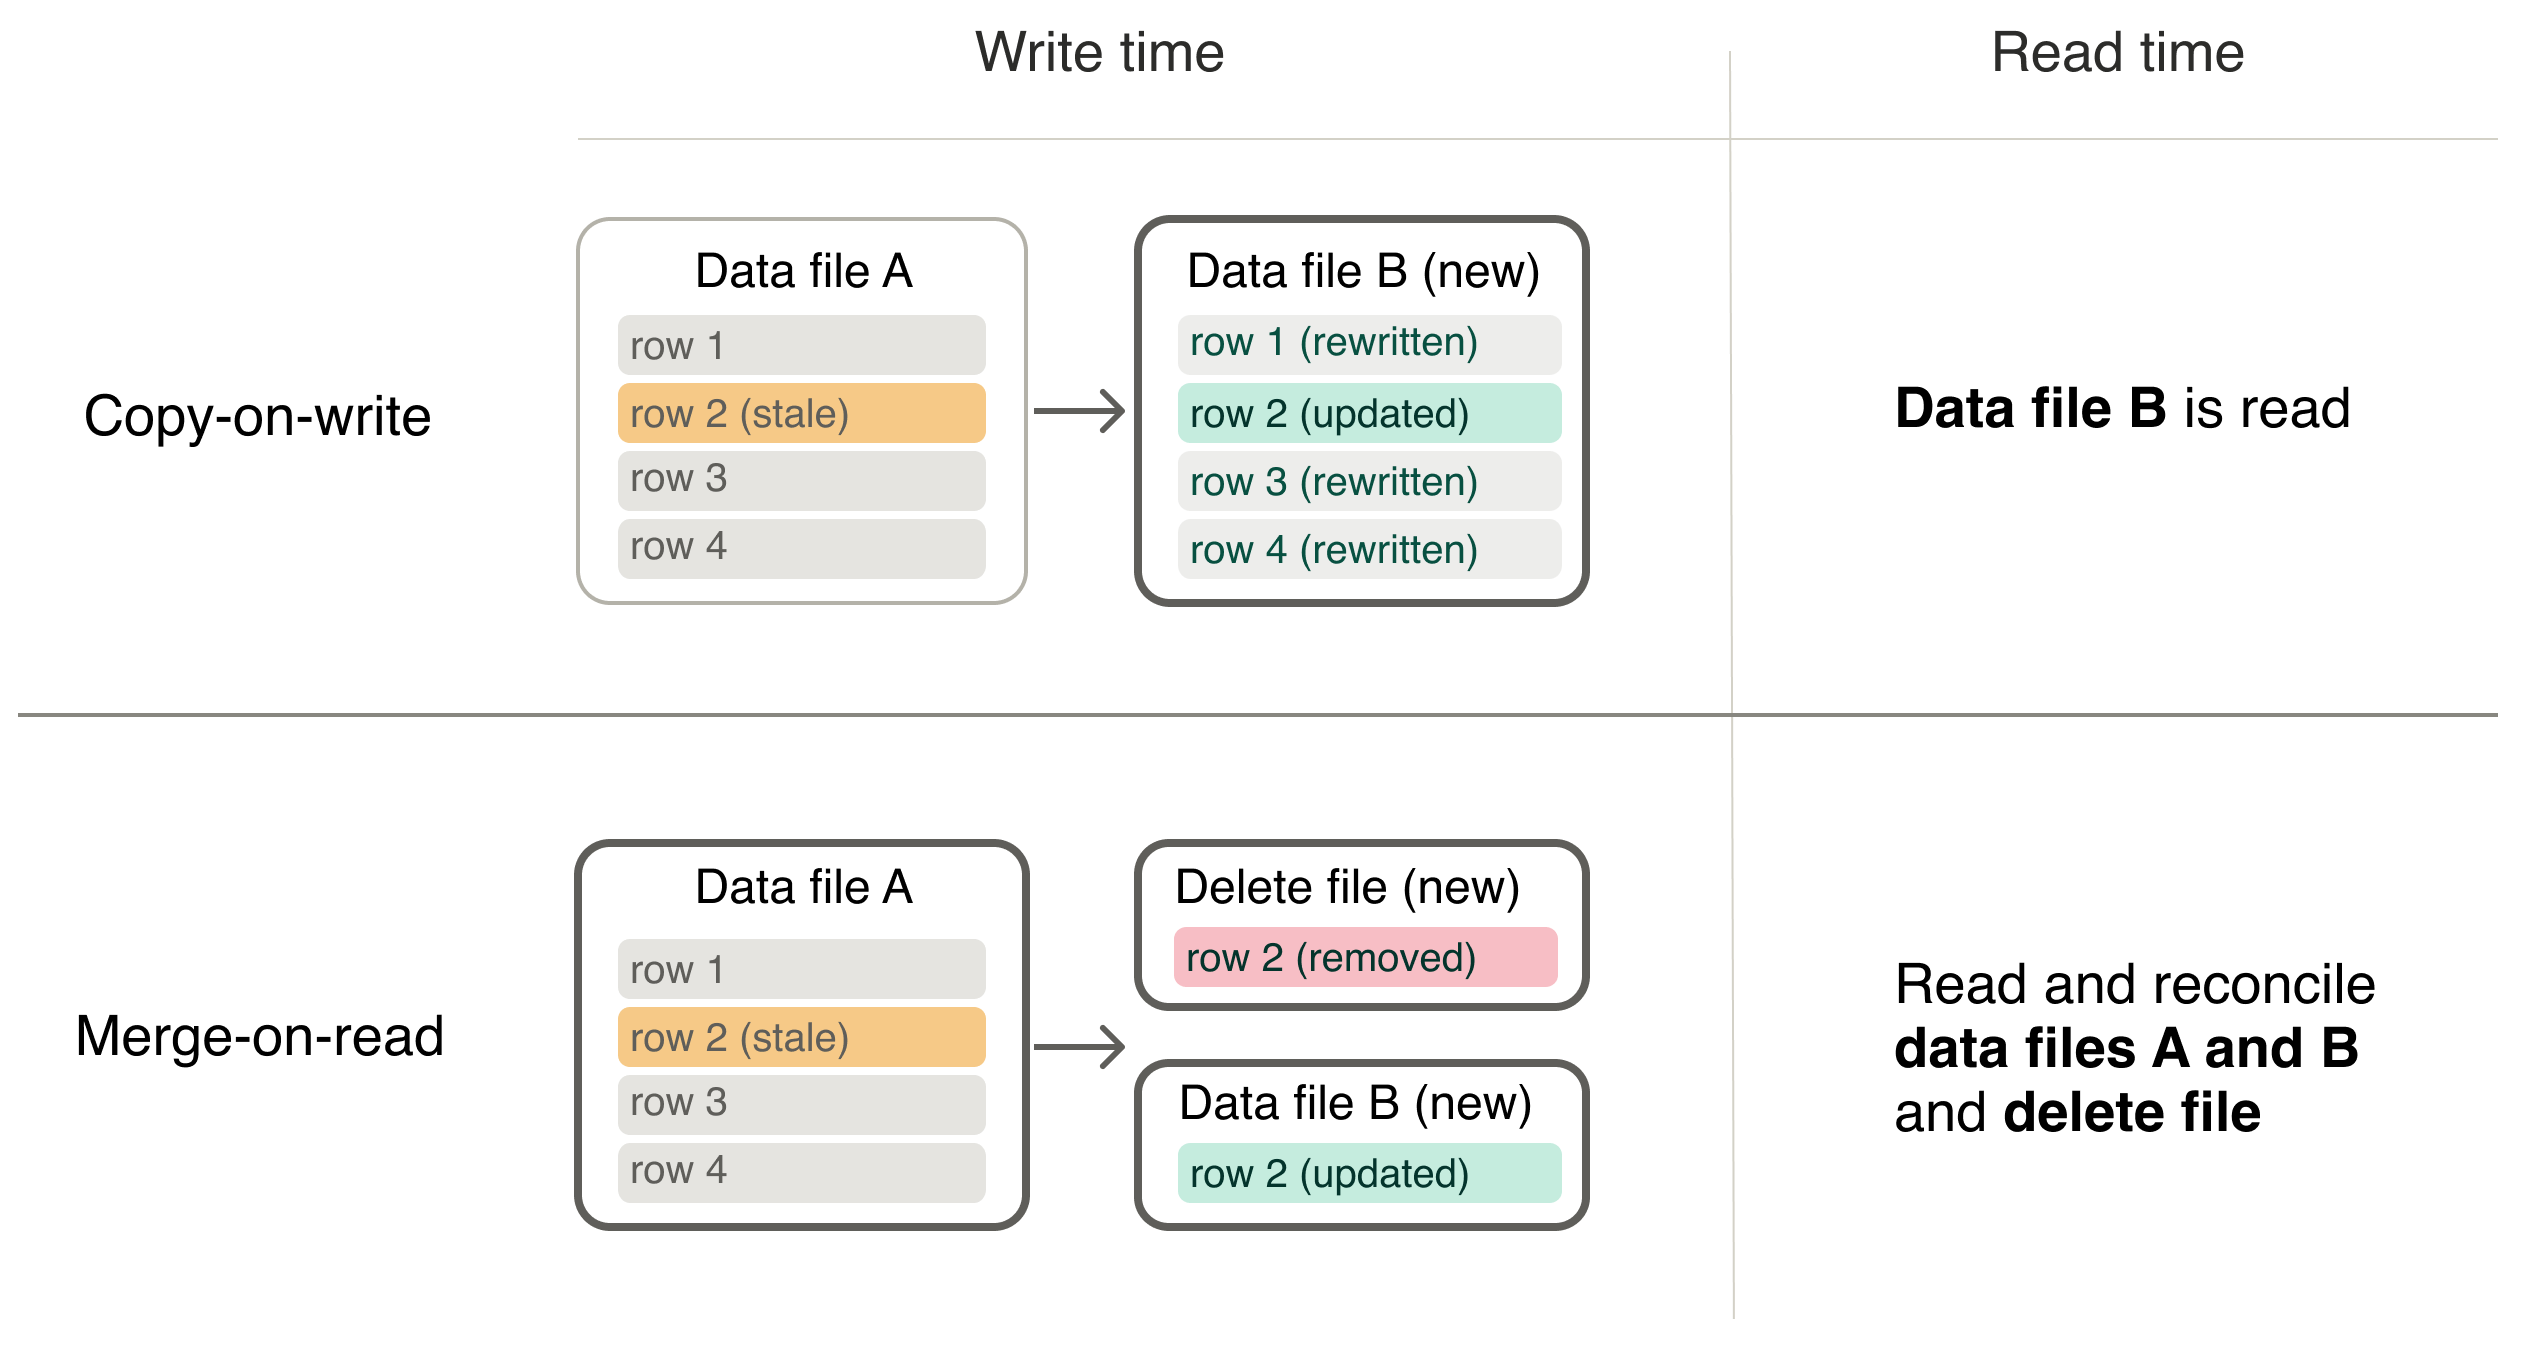
Merge-on-read テーブルでは、データファイルを書き換えメンテナンスタスクを使用して定期的にコンパクションを実行すると効果的です。このタスクは未適用の削除ファイルを適用し、結果を新しいデータファイルに統合します。そのため、読み取り増幅は次のコンパクションまでしか続きません。
Iceberg の変更履歴スキャン ↗では、削除ファイルを含むスナップショットを読み取れません。テーブルに merge-on-read による削除、更新、またはマージが適用されると、そのテーブルを変更履歴として読み取る際に Delete files are currently not supported in changelog scans で失敗し、そのテーブルをインクリメンタルにインデックス化されるオントロジーのオブジェクトタイプの元として使用できなくなります。
変更履歴として読み取るテーブルや、オブジェクトタイプの元となるテーブルは、copy-on-write のままにしてください。