注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
SAP ERP
SAP ERP コネクターを使用すると、Foundry を SAP のオンプレミスの ERP Central Component (ECC) および S/4 HANA(オンプレミスおよび Cloud Private Edition ↗)に接続できます。SAP ERP コネクターを使用すると、Foundry から次のようなさまざまな種類の SAP データを操作できます。
- SAP アプリケーションテーブル
- SAP CDS ビュー
- SAP HANA 情報ビュー
- SAP BW コンテンツエクストラクター(リモート接続のみ)
- SAP トランザクションコードおよび ABAP レポート
- SAP 汎用モジュール
- SAP メディア(DMS ドキュメント)
SAP ERP ソースを使用するには、対象の SAP アプリケーション層に Palantir Foundry Connector 2.0 for SAP Applications アドオンをインストールする必要があります。
このページの内容
| セクション | 対象内容 |
|---|---|
| セットアップ | ソースの作成と接続の種類の設定。 |
| 認証 | サポートされている認証方法。 |
| ネットワークと接続 | エグレスポリシーと証明書。 |
| バッチ同期 | SAP オブジェクトタイプ、インクリメンタル(差分)同期、および同期パラメーター。 |
| メディアセット | SAP の文書管理システムからのメディアファイルの取り込み。 |
| Webhook | BAPI を介した SAP へのデータのライトバック。 |
| コードリポジトリで使用する | 外部トランスフォームまたは関数からの SAP アドオン REST API の直接呼び出し。 |
サポートされている機能
| 機能 | ステータス |
|---|---|
| 探索 | 🟢 一般提供 |
| バッチ同期 | 🟢 一般提供 |
| インクリメンタル(差分連携) | 🟢 一般提供 |
| メディアセット | 🟡 ベータ版 |
| Webhook | 🟢 一般提供 |
| 一括ライトバック | 🟢 一般提供 |
| コードリポジトリで使用する | 🟢 一般提供 |
セットアップ
- Data Connection アプリケーションを開き、画面右上の + 新規ソースを選択します。
- 利用可能なコネクターの種類から SAP ERP を選択します。
- 追加で表示される設定プロンプトに従い、以下のセクションの情報を使用してコネクターのセットアップを続けます。
Foundry でのコネクターのセットアップについて、詳しくはこちらをご覧ください。
接続の種類
SAP ERP コネクターは、2種類の接続をサポートしています。
| 接続の種類 | 説明 |
|---|---|
| 直接 | SAP システムに直接接続します。これがデフォルトです。 |
| リモート(ゲートウェイ経由) | ゲートウェイを介してリモートの SAP システムに接続します。ゲートウェイ経由で接続トグルを有効にし、リモートシステムを識別するためのコンテキスト値を指定します。 |
接続の種類によって、利用可能な SAP オブジェクトタイプが決まります。リモート接続およびリモートエージェントの設定について、詳しくはこちらをご覧ください。
認証
SAP ERP コネクターは、次の認証方法をサポートしています。
| 認証方法 | 説明 |
|---|---|
| 基本認証 | コネクターのインストール時に作成した技術ユーザーのユーザー名とパスワードを入力します。 |
| 認証トークン | 認証用のトークンを指定します。 |
| カスタム認証ヘッダー | カスタム認証ヘッダーを指定します。 |
| 認証なし | Agent マシン上で証明書による認証が設定されている場合は、この選択肢を使用します。 |
ネットワークと接続
Foundry が SAP システムに到達できるように、エグレスポリシーを適切に設定してください。オンプレミスの SAP 環境では、通常、トラフィックを正しくルーティングするために Agent プロキシポリシーが必要です。
多くの SAP システムではカスタム署名証明書が使用されているため、初めて接続を設定する際に SSL ハンドシェイク例外が発生することがあります。システムの正しいカスタム証明書を用意し、ソースに追加してください。
SAP Data Accelerator
SAP Data Accelerator(SAP Cloud Connector を介して公開されるシステム向けの、SAP のマネージド接続サービス)を介してこの SAP システムに到達するには、ソースのホストとポートを Cloud Connector の仮想ホストとポートに設定します。次に、Palantir から提供されたクライアント証明書を割り当て、SAP Data Accelerator のコントロールプレーンとデータプレーンへのエグレスを許可し、コントロールプレーンの URL を指定して SAP Data Accelerator プロパティを追加します。この接続経路では、Foundry ワーカーを使用する必要があります。
バッチ同期
同期を作成する
- ソースの概要ページで、バッチ同期の横にある + 新規を選択します。
- 標準設定として、名前、対象データセット、スケジュールを設定します。
- トランザクションタイプを次のいずれかに設定します。
- APPEND — インクリメンタル(差分)更新用です。詳細はインクリメンタル同期を参照してください。
- SNAPSHOT — フルロード用です。
- ドロップダウンから SAP オブジェクトタイプを選択します(以下の SAP オブジェクトタイプを参照)。
- オブジェクト名を入力します。入力すると、選択したオブジェクトタイプに基づいて、一致するオブジェクトがフィールドに候補として表示されます。
- 必要に応じて、追加設定タブで追加のパラメーターを設定します。
SAP オブジェクトタイプ
利用可能なオブジェクトタイプは、ソースに設定されている接続タイプによって異なります。
| オブジェクトタイプ | 直接 | リモート(ゲートウェイ経由) | 説明 |
|---|---|---|---|
| ERP テーブル | ✓ | ✓ | クラスター、プール、およびカスタム Z* テーブルを含む、SAP ABAP データディクショナリ内の任意の ERP テーブルまたはビューからデータを抽出します。 |
| CDS ビュー | ✓ | WITH PARAMETERS で宣言されたビューを含む、ABAP CDS (Core Data Services) ビューからデータを抽出します。以下の CDS ビューのパラメーターを参照してください。 | |
| HANA ビュー | ✓ | SAP アプリケーション層で有効になっている HANA ビューからデータを抽出します。前提条件については、SAP から HANA ビューを取り込むを参照してください。 | |
| BW コンテンツエクストラクター | ✓ | ERP Business Content エクストラクターを実行します。ソースでゲートウェイ経由で接続が有効になっており、コンテキスト値が設定されている場合にのみ、オブジェクトタイプのドロップダウンに表示されます。デルタ抽出をサポートするエクストラクターには APPEND を使用します。エクストラクターを設定するを参照してください。 | |
| トランザクションコード | ✓ | ✓ | SAP トランザクションコードまたは ABAP レポートを実行し、表示された出力を取り込みます。以下のトランザクションコードのパラメーターを参照してください。 |
| 汎用モジュール | ✓ | ✓ | SAP 汎用モジュール(BAPI など)を呼び出し、構造化されたレスポンスを取り込みます。以下の汎用モジュールのパラメーターを参照してください。 |
インクリメンタル同期
インクリメンタル同期では、同じテーブルから APPEND 形式のトランザクションを実行できます。インクリメンタル同期を有効にするには、トランザクションタイプを APPEND に設定します。
利用可能なインクリメンタルモードは、オブジェクトタイプによって異なります。
| インクリメンタル(差分連携)モード | ERP テーブル | CDS ビュー | HANA ビュー | BW コンテンツエクストラクター |
|---|---|---|---|---|
| 複数のフィールド | ✓ | ✓ | ✓ | |
| フィールドを連結 | ✓ | ✓ | ✓ | |
| 変更文書テーブル | ✓ | |||
| ツインテーブル | ✓ | |||
| SAP 組み込みデルタ | ✓ |
- 複数フィールド: 指定したフィールドのいずれかが、すでにインポートした最大値以上である行をインポートします。フィールドはカンマで区切ります。
- フィールドを連結: 複数フィールドと同様ですが、OR で組み合わせる代わりにフィールドの値を連結します。
- 変更文書テーブル: SAP の変更文書テーブルの更新に基づいて行をインポートします。CDPOS のみまたは CDHDR と CDPOS の2つのサブモードを利用できます。
- ツインテーブル: 別の「ツイン」テーブルのフィールドがインクリメンタル条件を満たすときに、対象テーブルから行をインポートします。
- SAP 組み込みデルタ: エクストラクターに組み込まれた変更データキャプチャの仕組みを使用します。
インクリメンタルフィールドには、単調増加する値を使用することが理想的です。特定の日付の途中で同期が実行された場合にデータの取りこぼしを防ぐため、システムは「以上」の比較を使用します。Foundry データセットに重複する値が含まれる場合があるため、変換パイプラインの最初のステップで削除してください。
トランザクションコードおよび関数モジュールのオブジェクトタイプは、インクリメンタル同期をサポートしていません。常にスナップショットとして実行されます。
テーブルタイプのインクリメンタル同期では、同期あたりの最大行数設定で、1回の実行で返される行数のおおよその上限を指定します。断続的な問題(ネットワーク障害など)によって長時間の同期が中断される場合は、この設定を使用して、大きなテーブルの初回同期を、より小さく障害に強い一連の実行に分割します。
ツインテーブルの設定
インクリメンタルモードとしてツインテーブルを使用する場合、インクリメンタルツインテーブル設定でツインテーブルの名前を指定し、インクリメンタルツインマッピング設定で主要テーブルとツインテーブルの結合条件を定義します。マッピングのエントリーには次の形式を使用します。
{PRIMARY_TABLE_NAME}-{FIELD_NAME}={TWIN_TABLE_NAME}-{FIELD_NAME}
複数の結合条件はセミコロン(AND 演算子)で組み合わせます。
インクリメンタル状態をリセットする
フルロードを強制的に実行してインクリメンタル取り込みを再初期化するには、同期のインクリメンタル状態のリセットトグルを有効にします。これにより、SAP からデータの完全なスナップショットが取得され、データセット内のすべてのファイルが置き換えられます。同期が完了したら、以降の同期でインクリメンタルな追加が再開されるように、トグルを無効にします。
インクリメンタル状態のリセットは、ERP テーブル、CDS ビュー、HANA ビュー、BW コンテンツエクストラクターのオブジェクトタイプでサポートされています。
同期パラメーター
同期の設定時には、次のパラメーターを利用できます。
一般パラメーター
| パラメーター | 適用対象 | 説明 |
|---|---|---|
| フィルター | ERP テーブル、CDS ビュー、HANA ビュー、BW コンテンツエクストラクター | 条件ビルダーを使用して、SAP から抽出するデータを絞り込みます。 |
| 列を削除 | ERP テーブル、CDS ビュー、HANA ビュー、BW コンテンツエクストラクター | 抽出前に選択した列を除外します。パフォーマンスを向上させ、機密フィールドや不要なフィールドの取り込みを防ぎます。 |
| タイムスタンプ | すべて | /PALANTIR/TIMESTAMP(同期実行時刻)列と /PALANTIR/ROWNO(レコード順序)列を追加します。下流で重複レコードを削除する際に役立ちます。 |
| 取得オプション | BW コンテンツエクストラクター | データの取得方法を制御します。 |
| スキーマの変更を許可 | すべて | 同期の実行ごとに出力スキーマの変更を許可するかどうかを制御します。 |
フィルター
条件グループを追加し、各グループ内でフィールド、演算子、値の行を設定します。すべてのフィールド名は、SAP データディクショナリと一致している必要があります。
- 日付列には、
YYYYMMDD形式を使用します(たとえば、2021年1月1日の場合は20210101)。 - パターン一致およびパターン不一致の演算子は、
*ワイルドカードをサポートしています(たとえば、A*12*はAで始まり12を含む任意の文字列に一致します)。 - フィルター値には、動的フィルターのキーワードや日付計算関数も使用できます。
動的フィルター
動的フィルター値では、特殊なキーワードと日付計算関数を使用して、より柔軟なフィルター式を作成できます。アドオンバージョン SP26 以降で利用可能です。フィルター値を指定できる場所であれば、どこでも使用できます。
固定キーワード
| キーワード | 説明 |
|---|---|
[CURRENTYEAR] | YYYY 形式の現在の年。 |
[TODAY] | YYYYMMDD 形式の今日の日付。 |
[LASTDAYOFMONTH] | YYYYMMDD 形式の今月の最終日。 |
[LASTDAYOFLASTMONTH] | YYYYMMDD 形式の先月の最終日。 |
[FIRSTDAYOFMONTH] | YYYYMMDD 形式の今月の初日。 |
[FIRSTDAYOFLASTMONTH] | YYYYMMDD 形式の先月の初日。 |
日付計算関数
| 関数 | 説明 |
|---|---|
[ADDDAY] | 選択した日付に日数を足し合わせます。例:[ADDDAY(22102022,1)] → 23102022。 |
[ADDMONTH] | 選択した日付に月数を足し合わせます。 |
[ADDYEAR] | 選択した日付に年数を足し合わせます。 |
[GETMONTH] | 選択した日付の月を2桁の値(01–12)で返します。 |
[GETDAY] | 月内の日を2桁の値で返します。 |
[GETYEAR] | 選択した日付の年を返します。 |
関数は固定キーワードと直接組み合わせることも、入れ子にすることもできます。たとえば、[ADDDAY([TODAY], 1)] や [GETDAY([ADDDAY([FIRSTDAYOFMONTH], -1)])] のように使用します。
トランザクションコードのパラメーター
オブジェクトタイプがトランザクションコードの場合、オブジェクト名は SAP トランザクションコードまたは Advanced Business Application Programming (ABAP) レポートのいずれかを指し、次の追加フィールドを利用できます。
| パラメーター | 説明 |
|---|---|
| プログラムの種類 | オブジェクト名がトランザクションコードを指すか、ABAP レポートを指すかを指定します。必須です。 |
| 選択バリアント | トランザクションまたはレポートの実行前に適用する SAP 選択バリアントの名前。 |
| 出力バリアント | 結果一覧の構造を制御する SAP 出力バリアント(レイアウト)の名前。 |
| スプール取り込みを使用 | 有効にすると、実行時のメモリーではなく SAP スプールシステムからレポート出力を取得します。レポート出力が 2 GB を超える場合は必須です。 |
| 小計行と概要行を非表示 | 有効にすると、取り込んだデータから集計の小計行と概要行が削除されます。 |
CDS ビューのパラメーター
WITH PARAMETERS 句で宣言された Core Data Services (CDS) ビューでは、同期時にパラメーターを指定する必要があります。オブジェクトタイプが CDS ビューの場合、任意のプロパティである CDS ビューパラメーターに、パラメーター名とパラメーター値のペアを行として指定できます。パラメーター名は CDS ビューで宣言されている名前と一致する必要があります。不明なパラメーターや不足しているパラメーターがあると、同期は失敗します。空の行は保存時に破棄されます。
関数モジュールのパラメーター
オブジェクトタイプが関数モジュールの場合、オブジェクト名は関数モジュール(通常は Business Application Programming Interface (BAPI))を指します。次の追加フィールドを利用できます。
| パラメーター | 説明 |
|---|---|
| 関数の入力パラメーター | 汎用モジュールの IMPORTING パラメーターとして渡される、parameter name と parameter value のペアの行です。ほとんどの BAPI で必須です。 |
| 関数呼び出し後にコミット | 有効にすると、関数呼び出し後に COMMIT WORK 文が発行されます。変更の永続化にコミットを必要とする標準 BAPI では必須です。デフォルトではオフです。 |
詳細設定
次の設定は、各同期の詳細設定に表示されます。一部はソースレベルでも設定できます。
| 設定 | 説明 |
|---|---|
| 最大ファイルサイズ | 各出力 Parquet ファイルの最大サイズです。デフォルトはファイルあたり50,000行です。 |
| Avro 用にフィールド名を整形 | Foundry ストリームで使用される Avro ↗ のスキーマルールに準拠するようにフィールド名を整形します。データセットをストリーミングパイプラインで使用する場合は必須です。 |
| 想定外の値を無視 | 有効にすると、パースに失敗した日付または数値は null として書き込まれ、同期の終了時にパース例外の概要がログに記録されます。 |
| 日付を文字列に変換 | 日付フィールドを文字列として取り込みます。SAP の日付フィールドに、特殊な意味を持つパースできない値が含まれており、下流で処理する必要がある場合に役立ちます。 |
| ページサイズ | SAP からデータを取得する際にページごとに返される行数です。デフォルトは50,000行です。最小は5,000行です。 |
| 並列ページングスレッド | ページデータの生成に使用する SAP ワークプロセスの数。 |
| プラグインワーカースレッド | ページデータの取得に使用する Data Connection Agent スレッドの数。 |
| シリアライズエンジン | データ転送に使用するシリアライズ方法。 |
| 再試行とタイムアウト | 再試行回数、再試行までの待機時間、およびリクエストのタイムアウト。 |
| リソースチェック | 抽出中のメモリーと CPU のチェックです。無効にすると、SAP システムに過剰な負荷がかかる可能性があります。 |
| デバッグ設定 | トレースログとデバッグログの記録です。デバッグログの記録は SAP でバックグラウンドプロセスを開始するため、慎重に使用してください。 |
メディアセット
SAP ERP コネクターは、SAP の Document Management System (DMS) に保存されているメディアファイルや文書を取り込むためのメディアセットをサポートしています。
新しいメディア取り込みを作成するには、次の手順を実行します。
- ソースの概要ページに移動します。
- メディアセット同期の横にある + 新規を選択します。
- メディアセットの形式を定義します。特定の形式を指定すると、下流のデータ変換で、その形式に固有の変換ステップを使用できるようになります。メディアセットの形式の詳細を参照してください。
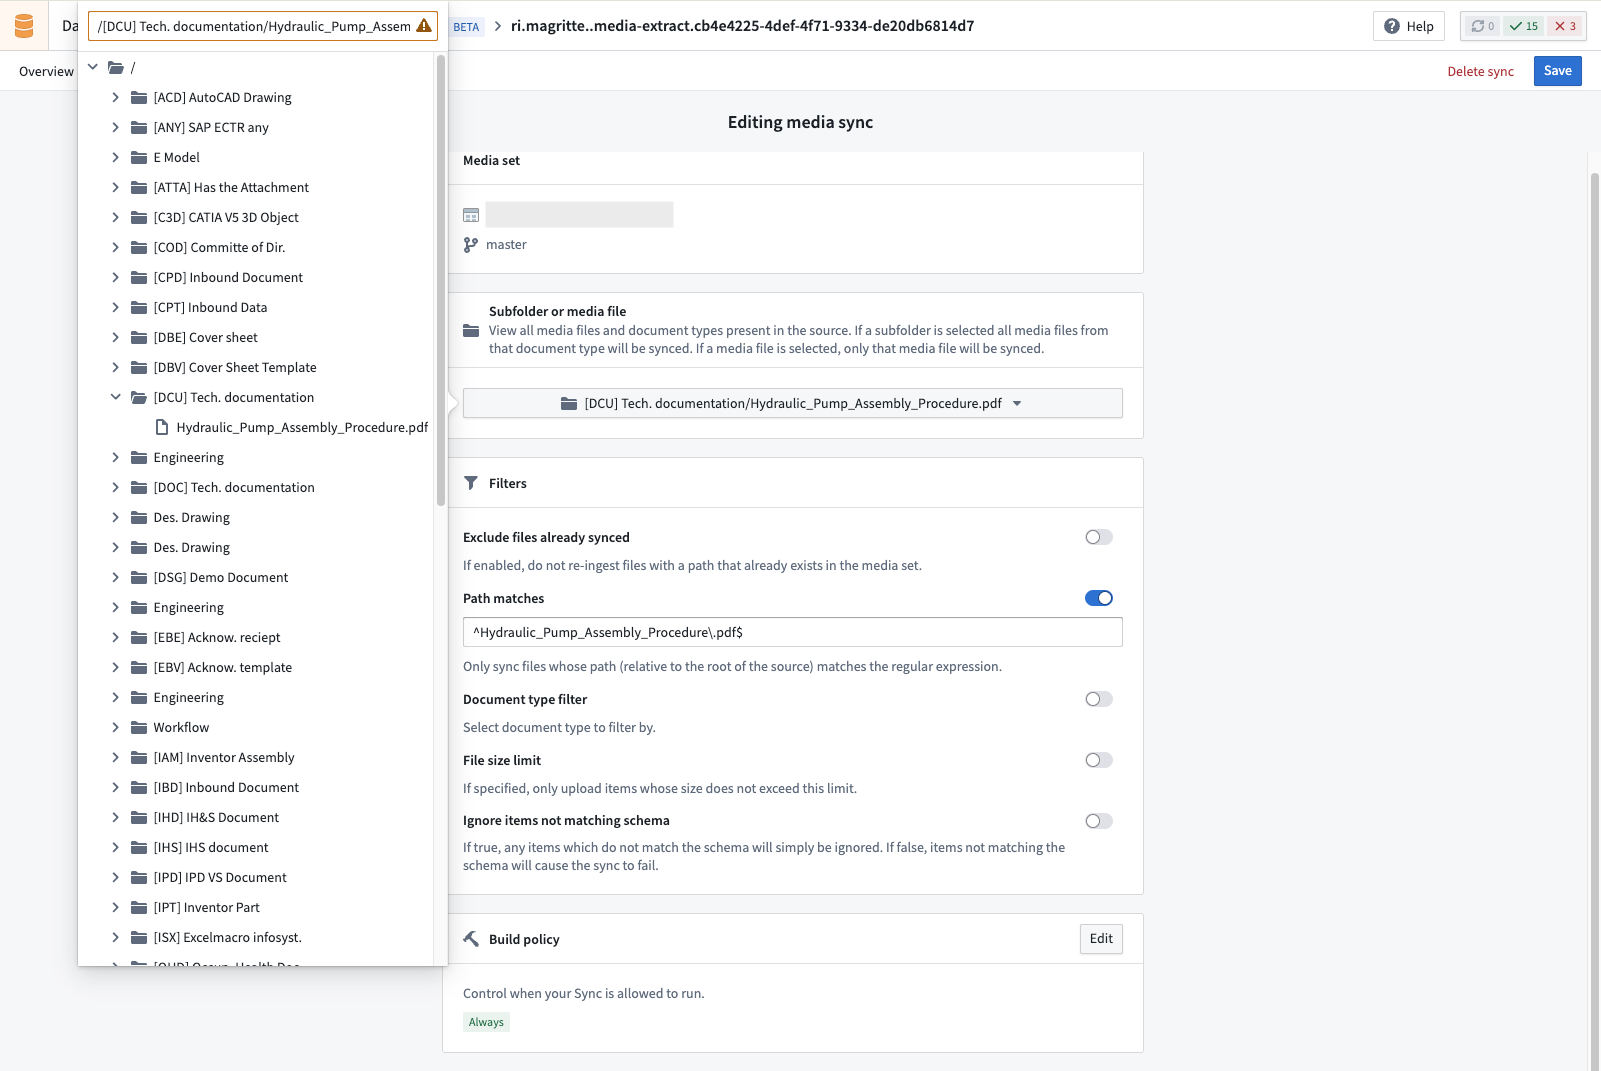
- 文書タイプごとにファイルを整理するソース探索ツールを使用して、取り込むファイルを選択するか、フィルターセクションで独自のフィルターを直接定義します。
探索
サブフォルダーまたはメディアファイルを選択すると、特定の文書タイプ(CPD など)を選択して関連するすべての文書を取り込むか、単一の文書を選択してそのファイルのみを取り込むことができます。
メディアフィルター
メディアセット同期には、次のフィルターを適用できます。
| フィルター | 説明 |
|---|---|
| 同期済みのファイルを除く | パスがメディアセットにすでに存在するファイルをスキップします。 |
| パスの一致条件 | 正規表現パターンに一致するファイルのみを同期します。デフォルトは .pdf です。 |
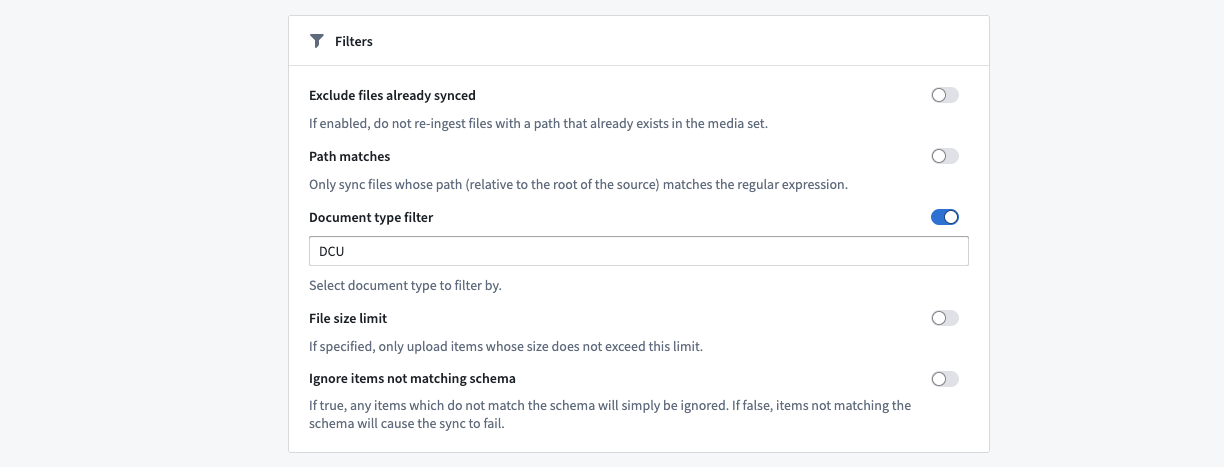
| 文書タイプ | SAP の文書タイプで絞り込みます。 |
| ファイルサイズの上限 | 指定したサイズの上限(バイト単位)以内のファイルのみを同期します。 |
例:文書タイプを選択する
SAP メディアの文書タイプは、略語と、その用途を示す平易な英語の説明で表されます。文書タイプで絞り込むときは、略語表記を使用して、メディア取り込みの対象範囲を絞り込めます。
Webhook
SAP Webhook を使用すると、Foundry から汎用モジュール(通常は BAPI(Business Application Programming Interface))を呼び出して、SAP にデータをライトバックできます。Webhook の設定方法の概要については、Webhook を参照してください。
SAP Webhook は、Foundry が管理するクラウドコンピューティングでの Foundry ワーカー接続をサポートしています。SAP Webhook には、Data Connection Agent 経由で実行する代わりに、このランタイムを使用することを推奨します。Foundry ワーカー上に設定された既存の SAP ソースは、移行なしで自動的にクラウド実行のメリットを得られます。Data Connection Agent 上で実行されている SAP ソースでクラウド実行の Webhook を利用するには、Foundry ワーカーに切り替える必要があります。
BAPI を呼び出すには、タスクの種類として sap-erp-run-function-webhook-task-v0 を選択します。
Webhook のタスク本文は、Handlebars ↗ 構文で記述する JSON ドキュメントです。呼び出す SAP 汎用モジュールを指定し、その入力を指定して、返す出力を選択します。
タスク本文のフィールド
| フィールド | 必須 | データ型 | 説明 |
|---|---|---|---|
function-name | はい | 文字列 | 呼び出す SAP 汎用モジュールまたは BAPI です。たとえば、BAPI_SALESORDER_CHANGE を指定します。 |
inputs | いいえ | オブジェクト、またはオブジェクトの配列 | 関数の入力パラメーターです。1件のレコードをライトバックするには1個のオブジェクトを指定し、1回の呼び出しで複数件のレコードをライトバックするにはオブジェクトの配列を指定します。関数が入力を必要としない場合は省略します。 |
output | いいえ | 文字列、または文字列の配列 | 返す出力変数です。1個の変数名を指定するか、複数の変数を返すには名前の配列を指定します。 |
commit | いいえ | ブール値 | 変更をコミットするかどうかを指定します。コミットする場合は省略します(デフォルト)。コミットを抑制するには false に設定します。標準 BAPI では、変更を永続化するためにコミットが必要です。 |
parallel | いいえ | オブジェクト | 並列ライトバックを選択し、必要に応じてその実行を調整します。複数のレコードをライトバックするを参照してください。 |
api-version | いいえ | Integer | SAP アドオンの API バージョンです。デフォルトは 1 です。バージョン2の機能を使用するには 2 に設定します。SAP アドオンの互換性を参照してください。 |
リモート SAP システムの場合は、ソースの接続の種類をリモート(ゲートウェイ経由) に設定し、ソースのコンテキストを指定します。
単一のレコードをライトバックする
次の例では、BAPI_SALESORDER_CHANGE を呼び出して販売伝票の購入日を変更し、SAP の RETURN テーブルを返します。
Copied!1 2 3 4 5 6 7 8 9 10{ "function-name": "BAPI_SALESORDER_CHANGE", "inputs": { "SALESDOCUMENT": {{json sales-doc-id}}, "ORDER_HEADER_IN": { "PURCH_DATE": {{json purchase-date}} }, "ORDER_HEADER_INX": { "UPDATEFLAG": "U", "PURCH_DATE": "X" } }, "output": "RETURN", "api-version": 2 }
複数のレコードをライトバックする
一括ライトバックと並列ライトバックは、OAuth 2.0 認証をサポートしていません。
1回の呼び出しで複数のレコードをライトバックするには、inputs にオブジェクトの配列を渡し、必要な変数を output に列挙します。任意の parallel ブロックを使用して、実行を調整します。次の例では、BAPI_PR_CREATE で2件の購買依頼を作成し、2個の出力変数を返します。
Copied!1 2 3 4 5 6 7 8 9 10 11{ "function-name": "BAPI_PR_CREATE", "commit": true, "parallel": { "max-jobs": 2, "max-calls-per-job": 4 }, "inputs": [ { "PRHEADER": { "PR_TYPE": "NB" }, "PRITEM": [ { "MATERIAL": "100-100", "PLANT": "1100", "QUANTITY": "1" } ] }, { "PRHEADER": { "PR_TYPE": "NB" }, "PRITEM": [ { "MATERIAL": "100-200", "PLANT": "1100", "QUANTITY": "2" } ] } ], "output": ["NUMBER", "PRHEADEREXP"], "api-version": 2 }
Webhook の実行は SAP 側で並列化できます。これは、inputs が複数のオブジェクトを含む配列である場合、または parallel ブロックを明示的に指定した場合に自動的に行われます。空のブロックでも同様です。任意の parallel ブロックを使用して、実行を調整します。
max-jobs— 同時に実行するジョブの最大数。max-calls-per-job— 各ジョブが処理するレコードの最大数。
省略した設定には、SAP アドオンで定義された値が使用されます。デフォルトは、ジョブ数が3、ジョブあたりの呼び出し回数が4です。
max-jobs をレコード数より大きい値に設定しても問題はありません。余分なジョブは使用されず、リソースが無駄になることもありません。
レスポンス
parallel ブロックを使用しない単一レコードの場合、レスポンスは要求した出力変数の数によって異なります。
出力変数が1個の単一レコードの場合、その変数の行のリストが返されます。
Copied!1 2 3[ { "NUMBER": "0010048439" } ]
出力変数が複数ある単一レコードの場合、変数名をキーとするオブジェクトが返されます。output["NUMBER"] のように、名前を使ってアクセスします。
Copied!1 2 3 4{ "NUMBER": [ { "NUMBER": "0010048439" } ], "PRHEADEREXP": [ { "PREQ_NO": "0010048439", "PR_TYPE": "NB" } ] }
並列ライトバックでは、入力が1件だけの場合でも、入力レコードごとに1個の要素を持つ配列が返されます。次に例を示します。
Copied!1 2 3 4 5 6 7[ { "OUTPUT": { "NUMBER": [ { "NUMBER": "0010048439" } ], "PRHEADEREXP": [ { "PREQ_NO": "0010048439" } ] }, "ROWNO": 1, "MSG": [ { "MSGTYP": "S", "MSGTXT": "Purchase requisition 0010048439 created" } ] } ]
OUTPUTは、そのレコードの結果です。形式は単一レコードのレスポンスと同じです。ROWNOは、inputs配列内の対応するエントリーの位置(1から開始)です。これにより、各結果を入力に対応付けることができます。MSGは、そのレコードの SAP メッセージログです。各メッセージには、種類(MSGTYP:成功はS、エラーはE、警告はW、情報はI、中止はA)とテキスト(MSGTXT)があります。各レコードが独自のメッセージを報告するため、どのレコードが成功し、どのレコードが失敗したかを確認できます。
HTTP レスポンスが失敗を示す場合、Webhook はエラーを返します。Webhook のレスポンスが成功を示していても、SAP の業務エラーが含まれている場合があります。SAP の RETURN 出力が利用可能な場合は、それを要求して内容を確認し、レコードごとの MSG エントリーをチェックして、要求した変更が成功したかどうかを判断してください。
SAP アドオンの互換性
複数の出力変数、一括ライトバック、および並列ライトバックを使用するには、api-version を 2 に設定します。バージョン 2 には、SAP アドオン 2.29.0 以降が必要です。api-version を省略すると、Webhook はバージョン 1 を使用します。このバージョンは、parallel ブロックなしで、単一の入力と単一の出力変数をサポートします。
バージョン 2 に切り替える際は、0 より大きい retries-per-request 設定を削除してください。
ユーザーに紐づくライトバック
SAP Data Accelerator 経由のユーザーに紐づくライトバックでは、sap-erp-oauth2-token-webhook-task と sap-erp-oauth2-refresh-webhook-task を使用して、アウトバウンドアプリケーションを設定します。セットアップの手順については、SAP Data Accelerator を使用したユーザーに紐づく SAP ライトバックを参照してください。
コードリポジトリで使用する
SAP ERP ソースを Python の外部トランスフォームまたは関数にインポートすると、コードから SAP アドオンの REST API に直接アクセスできます。バッチ同期、メディアセット同期、Webhook では十分に制御できない場合に、この方法を使用します。たとえば、Workshop アクションから BAPI を同期的に呼び出す場合、大規模な入力データセットをループ処理して行ごとに BAPI を呼び出す場合、Foundry 側のデータに基づいて特定の DMS ドキュメントを取得する場合、または1回のビルドで複数の SAP 呼び出しを連鎖させる場合です。
以下の例では、次のエンドポイントを使用します。すべてソース URL(https://<host>:<port>/sap/palantir)からの相対パスです。
| エンドポイント | 目的 |
|---|---|
POST /v2/function/{functionName}/writeback | 1個の汎用モジュール(BAPI)を同期的に呼び出します。 |
POST /v2/function/{functionName}/parallel_writeback | 一括入力を使用して汎用モジュールを同期的に呼び出し、サーバー側で並列処理します。 |
GET /v2/get_documents | DMS 文書を一覧表示します。必要に応じて、文書タイプ、ファイル形式、ファイル名、またはオブジェクトリンクで絞り込みます。 |
GET /v2/get_document | ID を指定して1件の DMS 文書をダウンロードします。 |
これらの例を使用する前に、SAP ERP ソースをリポジトリにインポートしてください。
- トランスフォームの場合は、外部トランスフォームを設定するに沿って進め、
external_systemsデコレーターを使用します。 - 関数の場合は、関数から API 呼び出しを行うに沿って進め、
@function(sources=[...])デコレーターでソースを宣言します。
例:BAPI を介した SAP へのライトバック(トランスフォーム)
次の外部トランスフォームは、入力データセットの行ごとに BAPI_SALESORDER_CHANGE を1回呼び出して各販売伝票の購買日付を更新し、確認用に SAP の RETURN テーブルを出力データセットに記録します。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38from transforms.api import Input, Output, transform from transforms.external.systems import external_systems, Source, ResolvedSource @external_systems( sap_source=Source("<source_rid>"), ) @transform( sales_order_updates=Input("<input_dataset_rid>"), # 列: sales_doc_id, purchase_date (YYYYMMDD) writeback_results=Output("<output_dataset_rid>"), ) def update_purchase_dates(ctx, sap_source: ResolvedSource, sales_order_updates, writeback_results): base_url = sap_source.get_https_connection().url client = sap_source.get_https_connection().get_client() results = [] for row in sales_order_updates.dataframe().collect(): response = client.post( f"{base_url}/v2/function/BAPI_SALESORDER_CHANGE/writeback", json={ "commit": True, "input": { "SALESDOCUMENT": row.sales_doc_id, "ORDER_HEADER_IN": {"PURCH_DATE": row.purchase_date}, "ORDER_HEADER_INX": {"UPDATEFLAG": "U", "PURCH_DATE": "X"}, }, "output": ["RETURN"], }, ) response.raise_for_status() results.append({ "sales_doc_id": row.sales_doc_id, "purchase_date": row.purchase_date, "status_code": response.status_code, "sap_return": str(response.json()), }) writeback_results.write_dataframe(ctx.spark_session.createDataFrame(results))
変更を保存するためにコミット文が必要な標準 BAPI では、"commit": true を設定します。関数を呼び出す前に、metadata エンドポイント(GET /v2/function/{functionName}/metadata)を使用して、期待される入出力構造を確認します。
例:BAPI を介した SAP へのライトバック(関数)
Workshop アクション、オントロジーのアクションバックエンド、または Foundry 関数のほかの呼び出し元から BAPI を同期的に呼び出すには、ライトバックを Python のソースを使用する関数として公開します。この関数は、型付きの入力を受け取り、SAP の RETURN 構造を呼び出し元に返します。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35from functions.api import function from functions.sources import get_source @function(sources=["sap_source"]) def update_sales_order_purchase_date(sales_doc_id: str, purchase_date: str) -> str: """BAPI_SALESORDER_CHANGE を介して受注伝票の購買日を更新します。 Args: sales_doc_id: SAP 販売伝票番号です。 purchase_date: YYYYMMDD 形式の新しい購買日です。 Returns: SAP RETURN テーブルの文字列表現です。 エラーメッセージや警告メッセージを呼び出し元に伝えるのに役立ちます。 """ source = get_source("sap_source") base_url = source.get_https_connection().url client = source.get_https_connection().get_client() response = client.post( f"{base_url}/v2/function/BAPI_SALESORDER_CHANGE/writeback", json={ "commit": True, "input": { "SALESDOCUMENT": sales_doc_id, "ORDER_HEADER_IN": {"PURCH_DATE": purchase_date}, "ORDER_HEADER_INX": {"UPDATEFLAG": "U", "PURCH_DATE": "X"}, }, "output": ["RETURN"], }, timeout=30, ) response.raise_for_status() return str(response.json())
関数でソースを使用するには、そのソースでコードインポートとエクスポートが有効になっている必要があります。重大度がゼロ以外の SAP の RETURN メッセージは、呼び出し元が対応できるように、ユーザー向けエラーとして表示します。
例:並列ライトバック(トランスフォーム)
外部トランスフォームから parallel_writeback エンドポイントを使用して、1つのリクエストで多数の BAPI 呼び出しを送信します。SAP システムは複数のバックグラウンドジョブを起動し、それらに呼び出しを分散します。大規模なバッチでは、writeback を順次呼び出す場合よりも大幅に高速です。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43from transforms.api import Input, Output, transform from transforms.external.systems import external_systems, Source, ResolvedSource @external_systems( sap_source=Source("<source_rid>"), ) @transform( sales_order_updates=Input("<input_dataset_rid>"), writeback_results=Output("<output_dataset_rid>"), ) def update_purchase_dates_parallel( ctx, sap_source: ResolvedSource, sales_order_updates, writeback_results ): base_url = sap_source.get_https_connection().url client = sap_source.get_https_connection().get_client() bulkinput = [ { "SALESDOCUMENT": row.sales_doc_id, "ORDER_HEADER_IN": {"PURCH_DATE": row.purchase_date}, "ORDER_HEADER_INX": {"UPDATEFLAG": "U", "PURCH_DATE": "X"}, } for row in sales_order_updates.dataframe().collect() ] response = client.post( f"{base_url}/v2/function/BAPI_SALESORDER_CHANGE/parallel_writeback", json={ "commit": True, "output": ["RETURN"], "bulkinput": bulkinput, "parallel": True, "paralleljobs": 5, "functioncallperjob": 10, }, ) response.raise_for_status() results = [ {"index": i, "result": str(r)} for i, r in enumerate(response.json()) ] writeback_results.write_dataframe(ctx.spark_session.createDataFrame(results))
ワークロードと SAP システムで利用可能な処理能力に基づいて、paralleljobs(SAP で起動するバックグラウンドジョブ数)と functioncallperjob(ジョブごとに処理する呼び出し数)を調整します。単一の一括リクエストを引き続き使用しながら逐次実行に切り替えるには、"parallel": false を設定します。
例:DMS ドキュメントをメディアセットに取得する(トランスフォーム)
次の外部トランスフォームは、DMS の一覧取得エンドポイントとダウンロードエンドポイントを組み合わせ、SAP の Document Management System からドキュメントを取得してメディアセットに書き込みます。組み込みのメディアセット同期では十分に制御できない場合、たとえば、ドキュメントの選択が Foundry 側のデータに依存する場合や、ダウンロード前に複数のフィルターを組み合わせる必要がある場合に、このパターンを使用します。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34import io from transforms.api import transform from transforms.external.systems import external_systems, Source, ResolvedSource from transforms.mediasets import MediaSetOutput @external_systems( sap_source=Source("<source_rid>"), ) @transform( documents=MediaSetOutput("<media_set_rid>"), ) def fetch_dms_documents(ctx, sap_source: ResolvedSource, documents): base_url = sap_source.get_https_connection().url client = sap_source.get_https_connection().get_client() # 文書の種類とファイル形式で絞り込み、DMS 内の文書を一覧表示します。 list_response = client.get( f"{base_url}/v2/get_documents", params={"DOCUMENTTYPE": "CPT", "FILEFORMAT": "pdf"}, ) list_response.raise_for_status() for doc in list_response.json(): document_id = doc["DOCUMENT_ID"] document_name = doc["DOCUMENT_NAME"] download_response = client.get( f"{base_url}/v2/get_document", params={"DOCUMENT_ID": document_id}, ) download_response.raise_for_status() documents.put_media_item(io.BytesIO(download_response.content), document_name)
Foundry の入力データセットに基づいて取り込みを行うには、たとえば EBELN(購買発注)の値のリストで参照されるドキュメントのみを取得する場合は、OBJECTLINK フィルターを指定して /v2/get_documents を呼び出すか、入力行から各 DOCUMENT_ID を /v2/get_document に直接渡します。
関連するハウツーガイド
以下のガイドでは、SAP 側と Foundry 側の両方での設定を伴うワークフローを説明します。
- SAP から長文テキストを抽出する:
STXLテーブルの長文テキストを解凍して取り込みます。 - カスタム権限とロール管理を設定する:SAP アドオンのカスタム権限ロールを設定します。
- エクストラクターを設定する:SAP BW Business Content のエクストラクターを設定します。
- SAP から HANA ビューを取り込む:HANA 外部ビューを公開して取り込みます。
- OAuth 2.0 によるユーザーに紐づく SAP ライトバック:指定ユーザーとして SAP にライトバックするための OAuth 2.0 を設定します。