注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
変更データキャプチャ(CDC)
変更データキャプチャ ↗ (CDC) は、リレーショナルデータベースからほかのコンシューマーにリアルタイムの更新をストリーミングするためによく使用される、エンタープライズデータ統合のパターンです。
Foundry は、変更データキャプチャフィードを生成するシステムからのデータの同期、処理、保存をサポートしています。データコネクター、ストリーム、パイプライン、Foundry オントロジーなど、プラットフォーム全体のコンポーネントは、元となるデータのスキーマに設定されたメタデータを使用して、この変更履歴データをネイティブに扱うことができます。
Foundry における変更データキャプチャのサポート
Foundry は、変更データキャプチャの更新に対して、次のサポートを提供しています。
| アプリケーション | CDC のサポート |
|---|---|
| Data Connection | 同期で CDC のサポートが利用可能(ソースシステムに依存) |
| オントロジー | バッチおよびストリームを元データとするオブジェクトの CDC インデックス化 |
| Pipeline Builder | 完全な CDC ストリーム処理、およびバックフィルを伴う部分的な CDC ストリーム |
| ストリーム | ライブビューとアーカイブビューでの完全な CDC サポート |
| トランスフォーム | データセット向けの追加のみのインクリメンタル(差分処理)、Iceberg テーブル向けの完全な変更履歴のインクリメンタル処理が利用可能 |
| Workshop | 頻繁に更新されるオブジェクトの自動更新が利用可能 |
変更履歴のメタデータ
変更履歴のメタデータには、データに次の属性が必要です。
- 1個以上の主キー列
- 変更履歴は、その主キーを持つレコードで発生した個々の変更をすべて伝えるためのものなので、変更履歴データには主キー列の値が同一のエントリーが多数含まれます。変更データキャプチャは、不変のデータや追加のみのデータフィードよりも、編集されるデータに特に有用です。
- 1個以上の順序列
- 順序列は数値である必要があり、指定された主キーの組み合わせを持つレコードについて、変更の相対的な順序を判断するために使用されます。順序列は Long で表されるタイムスタンプであることが多いですが、常にそうとは限りません。順序列がタイムスタンプでない場合でも、最大の値が最も新しいものとみなされます。
- 削除列
- 削除列は、指定された更新によって、指定された主キーの組み合わせを持つレコードが削除されたかどうかを判断するために使用されます。この列はブール値である必要があり、レコードが削除された場合は true、それ以外の場合は false にする必要があります。
この変更履歴のメタデータは、変更履歴からソースシステム内のデータの現在のビューを導き出すための解決戦略を指定する際に使用されます。変更データキャプチャの解決戦略は、次のように機能します。
- 主キー列に基づいてデータをグループ化します。
- 順序列の値が最大のエントリーを見つけます。
- このエントリーの削除列の値が
trueの場合、そのエントリーを削除します。
これらの手順を実行すると、変更履歴は、それを生成している上流のソースシステムで表示されるものと同じビューに集約されます。変更履歴のメタデータと解決戦略は、以下で説明するように、Palantir のさまざまなコンポーネントで異なる方法で使用されます。
Data Connection での変更データキャプチャ
Data Connection で利用可能なソースでは、変更履歴メタデータを適用したストリームとして、システムからデータを同期できる場合があります。ソースが変更履歴データを同期する機能を実装できるかどうかは、ソースシステムが必要な属性(主キー列、順序付け列、削除列)を持つログデータを生成できるかどうかに依存します。
MySQL、PostgreSQL、Oracle、Db2、SQL Server など、広く使われている多くのデータベースは、CDC 変更履歴データを生成できます。Foundry のこれらのシステム用データコネクターは、こうした変更履歴の直接同期をサポートしている場合と、していない場合があります。コネクターが現在 CDC 同期をサポートしていなくても、Kafka やその他のストリーミングミドルウェアを介してデータを同期し、Foundry に到着したデータを変更履歴として使用できます。
Data Connection では、現在、次のソースの種類が CDC 同期をサポートしています。
- Db2
- Microsoft SQL Server
- Oracle
- PostgreSQL
Kafka、Kinesis、Amazon SQS、ストリームとのプッシュベースの統合など、ほかのソースから変更履歴形式のデータを利用できる場合は、Pipeline Builder の key-by ボードを使用して変更履歴メタデータを手動で設定する方法を参照してください。
外部データベースで変更データキャプチャを有効にする
サポートされているソースの種類から変更履歴フィードを同期するには、該当するテーブルで適切な設定を有効にする必要があります。場合によっては、データベース全体でも有効にする必要があります。
たとえば、Microsoft SQL Server で変更データキャプチャを有効にするには、データベースで CDC を有効にするコマンドを実行する必要があります。
USE <database>
GO
EXEC sys.sp_cdc_enable_db
GO
次に、変更履歴を記録する各テーブルで別のコマンドを実行します。
EXEC sys.sp_cdc_enable_table
    @source_schema = N'<schema>'
  , @source_name = N'<table_name>'
  , @role_name = NULL
  , @capture_instance = NULL
  , @supports_net_changes = 0
  , @filegroup_name = N'PRIMARY';
GO
上記の例は、ソースシステムで変更履歴データを生成できるようにするために必要となる可能性のある手順の概要を示しています。特定のシステムで変更データキャプチャのログを有効にする方法の詳細は、そのシステムのドキュメントを参照してください。
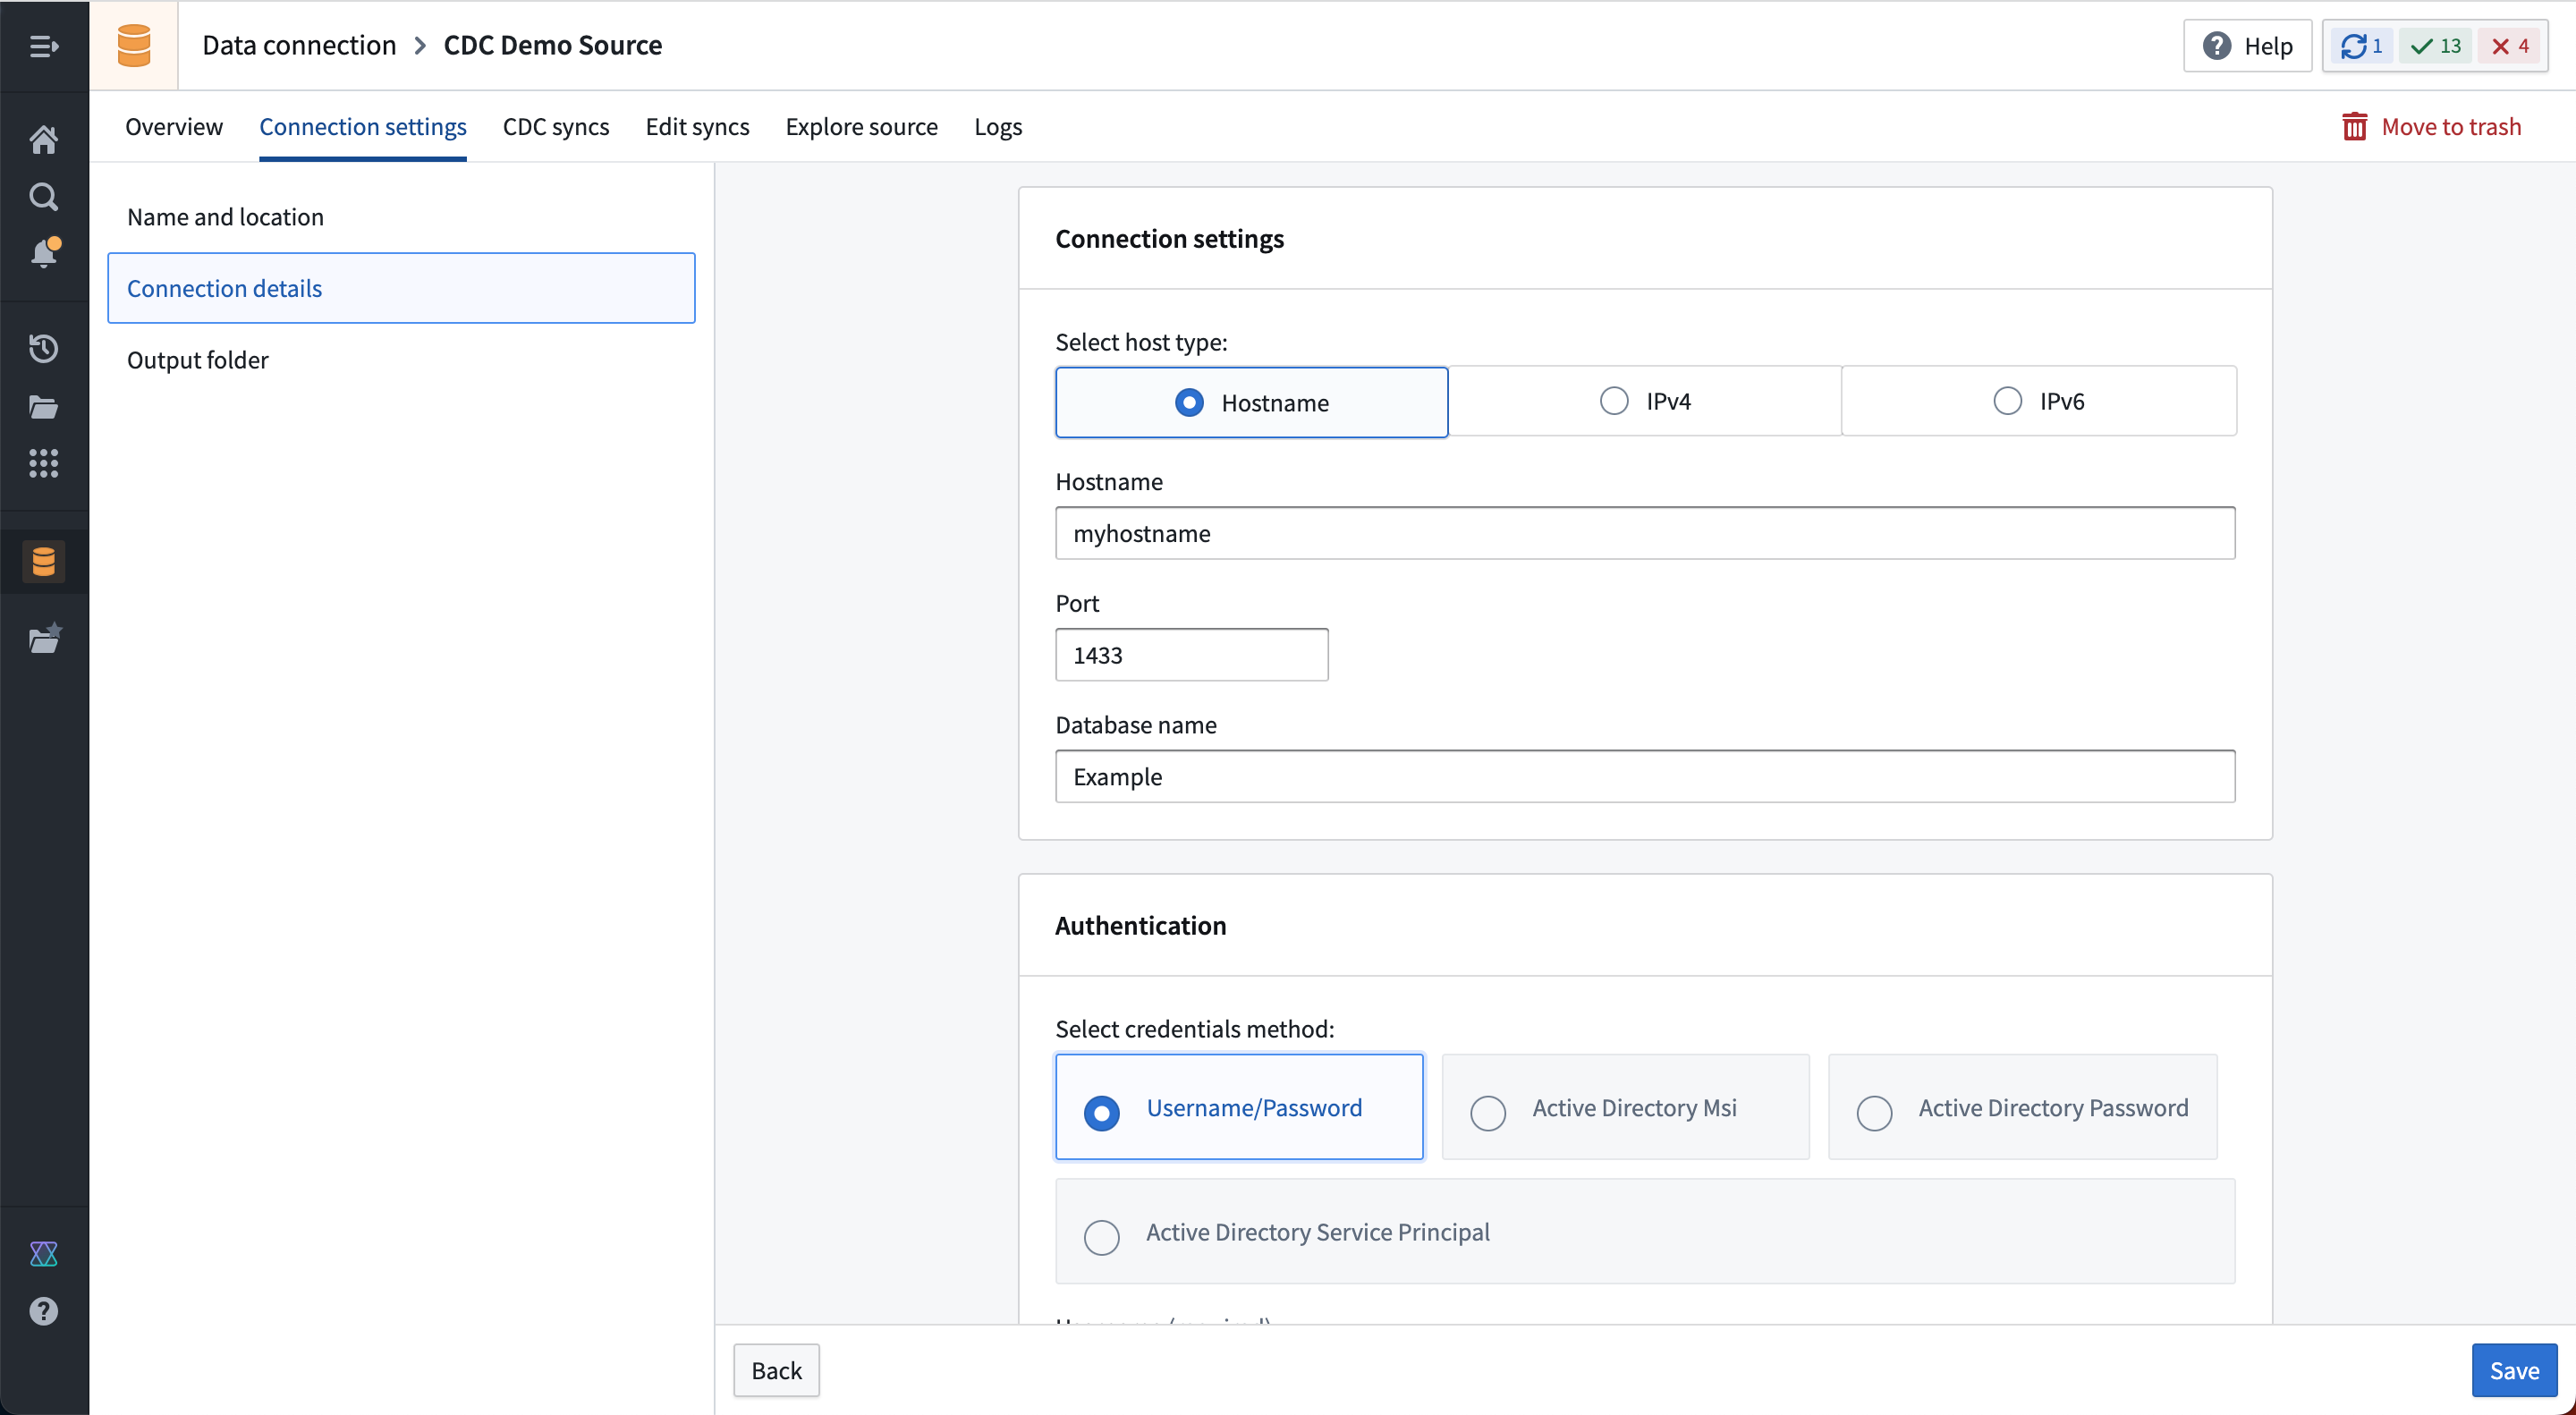
変更データキャプチャ用のソース接続を設定する
これで、変更履歴をキャプチャするシステムに接続するソースを Data Connection で設定できます。引き続き同じ例で、以下のように Microsoft SQL Server コネクターを使用して接続を設定します。
変更データキャプチャ同期を作成する
ソースの概要ページには、CDC 同期の空のテーブルがあります。
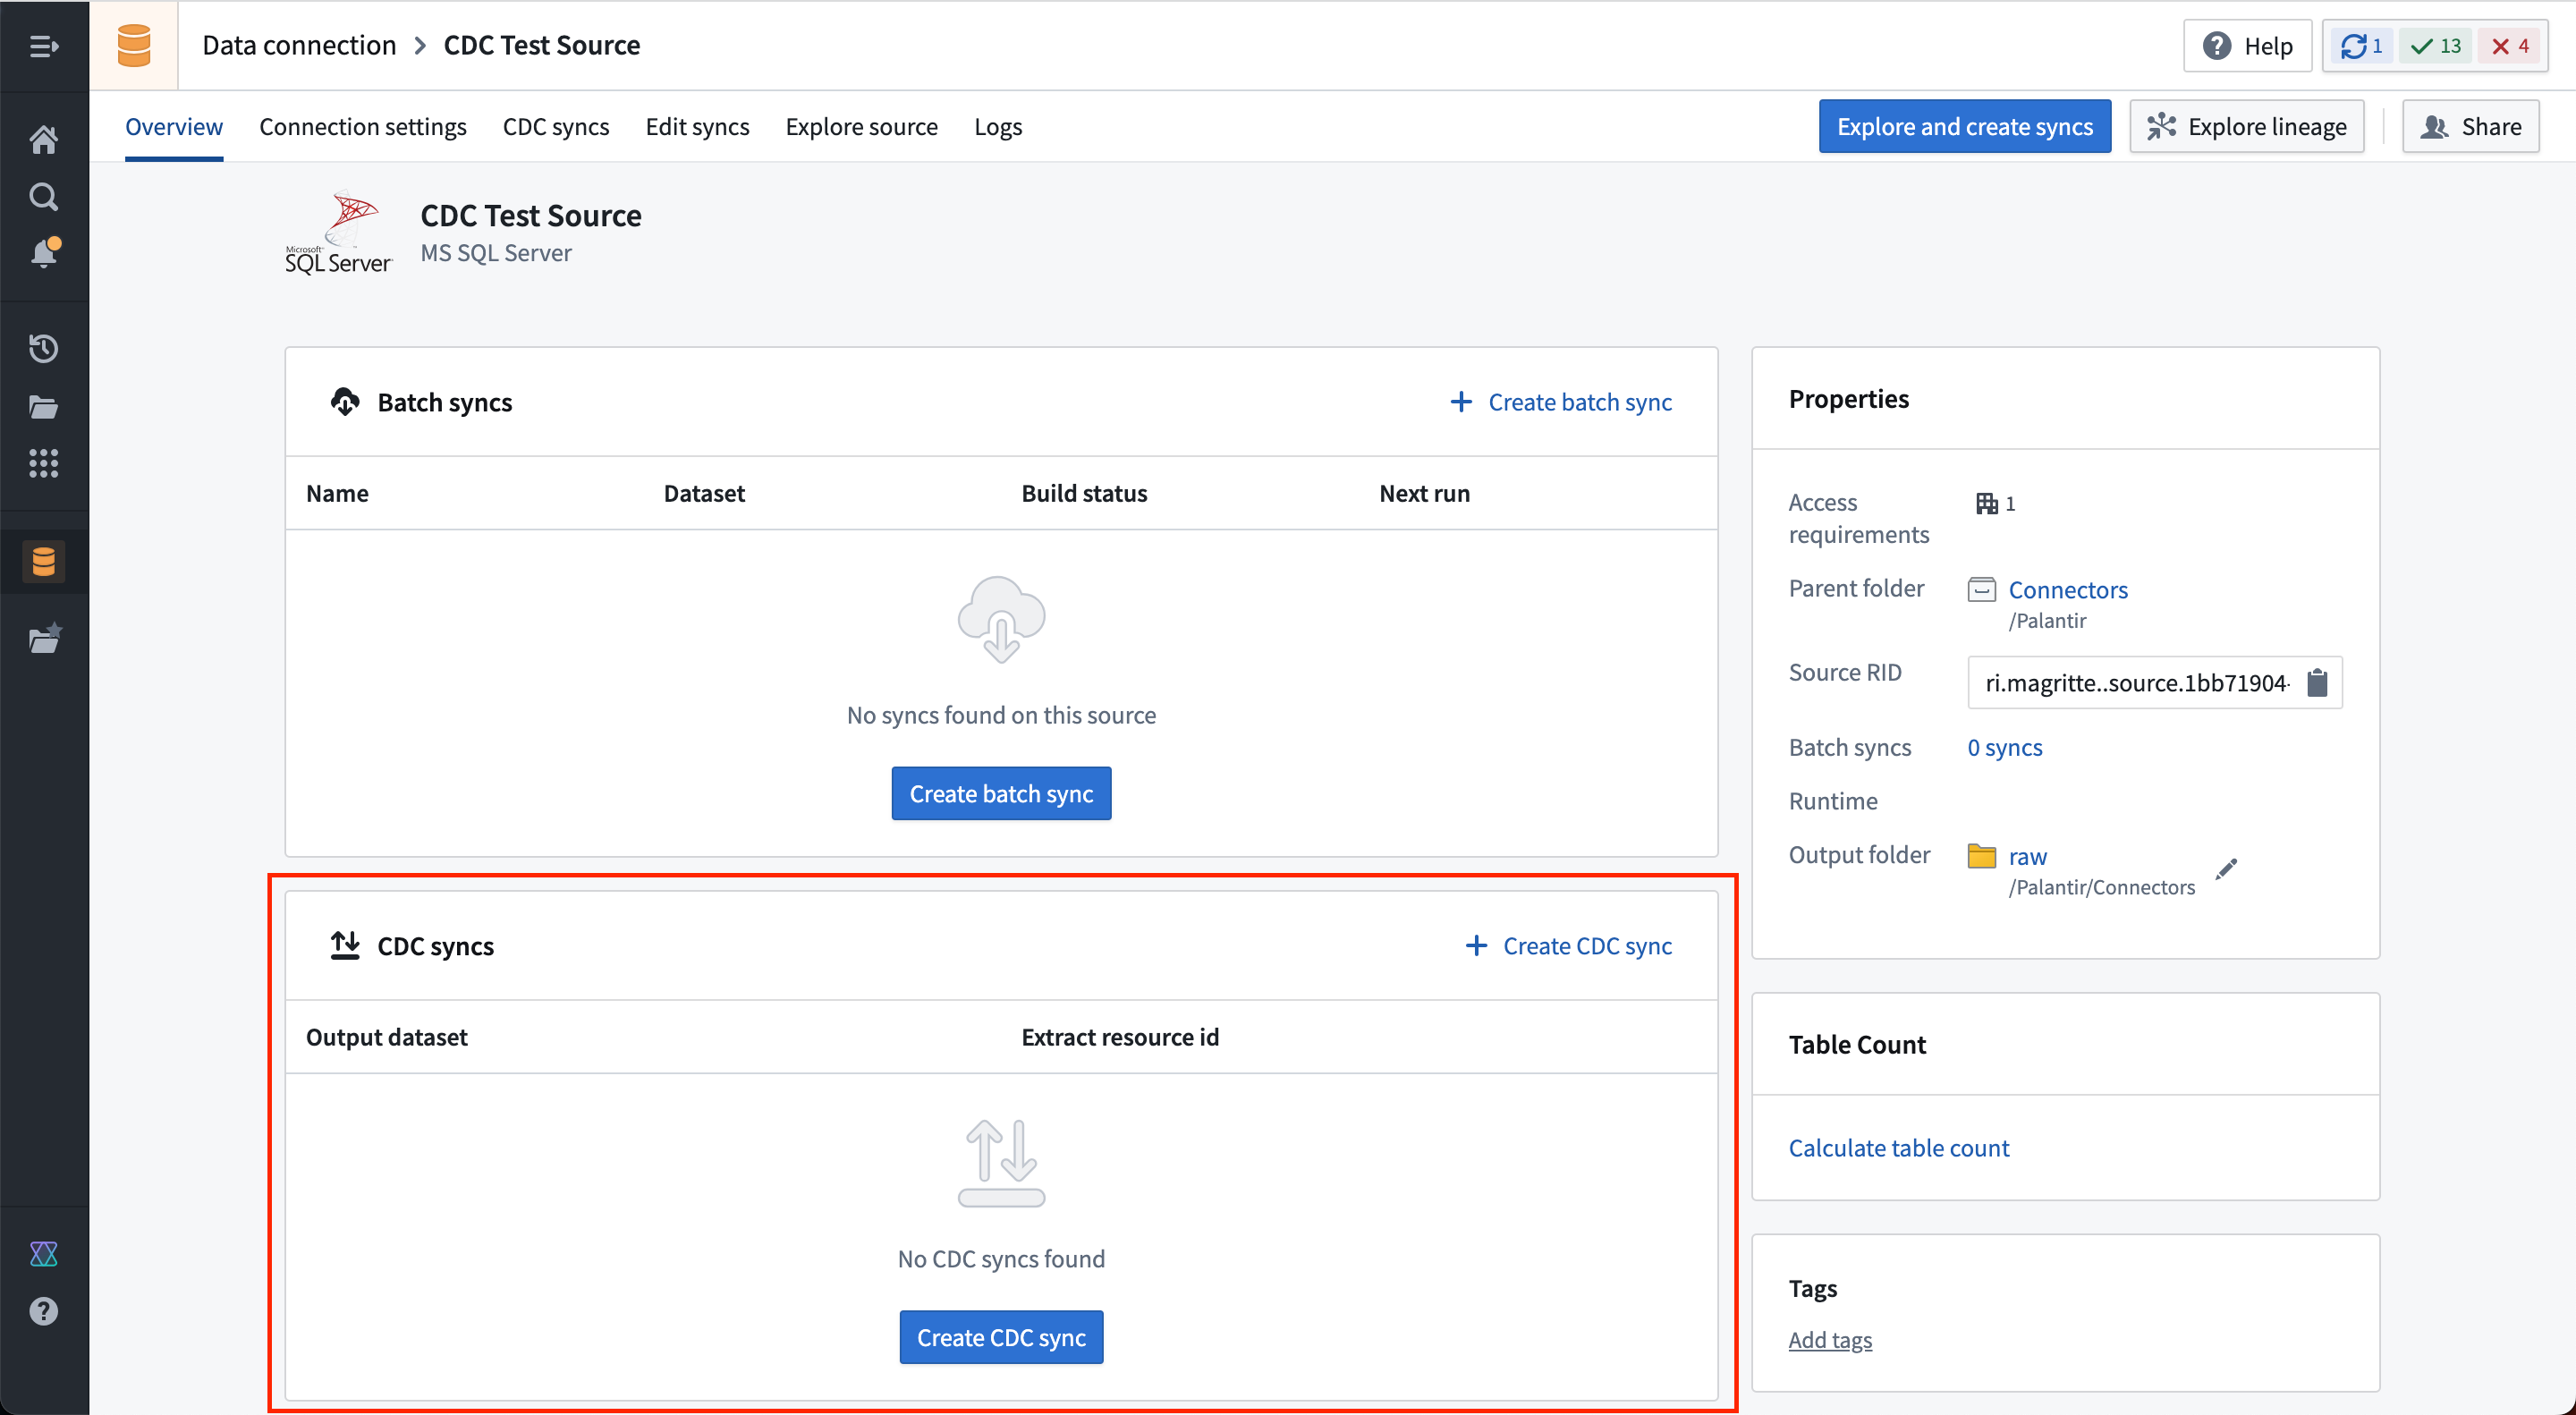
CDC 同期を作成を選択して、新しい変更データキャプチャ同期を追加します。同期するテーブルを指定すると、コネクターが次の情報を自動的に導出します。
- 出力ストリーミングデータセットのスキーマ。
- 主キー列、順序付け列、削除列を含む変更履歴メタデータ。
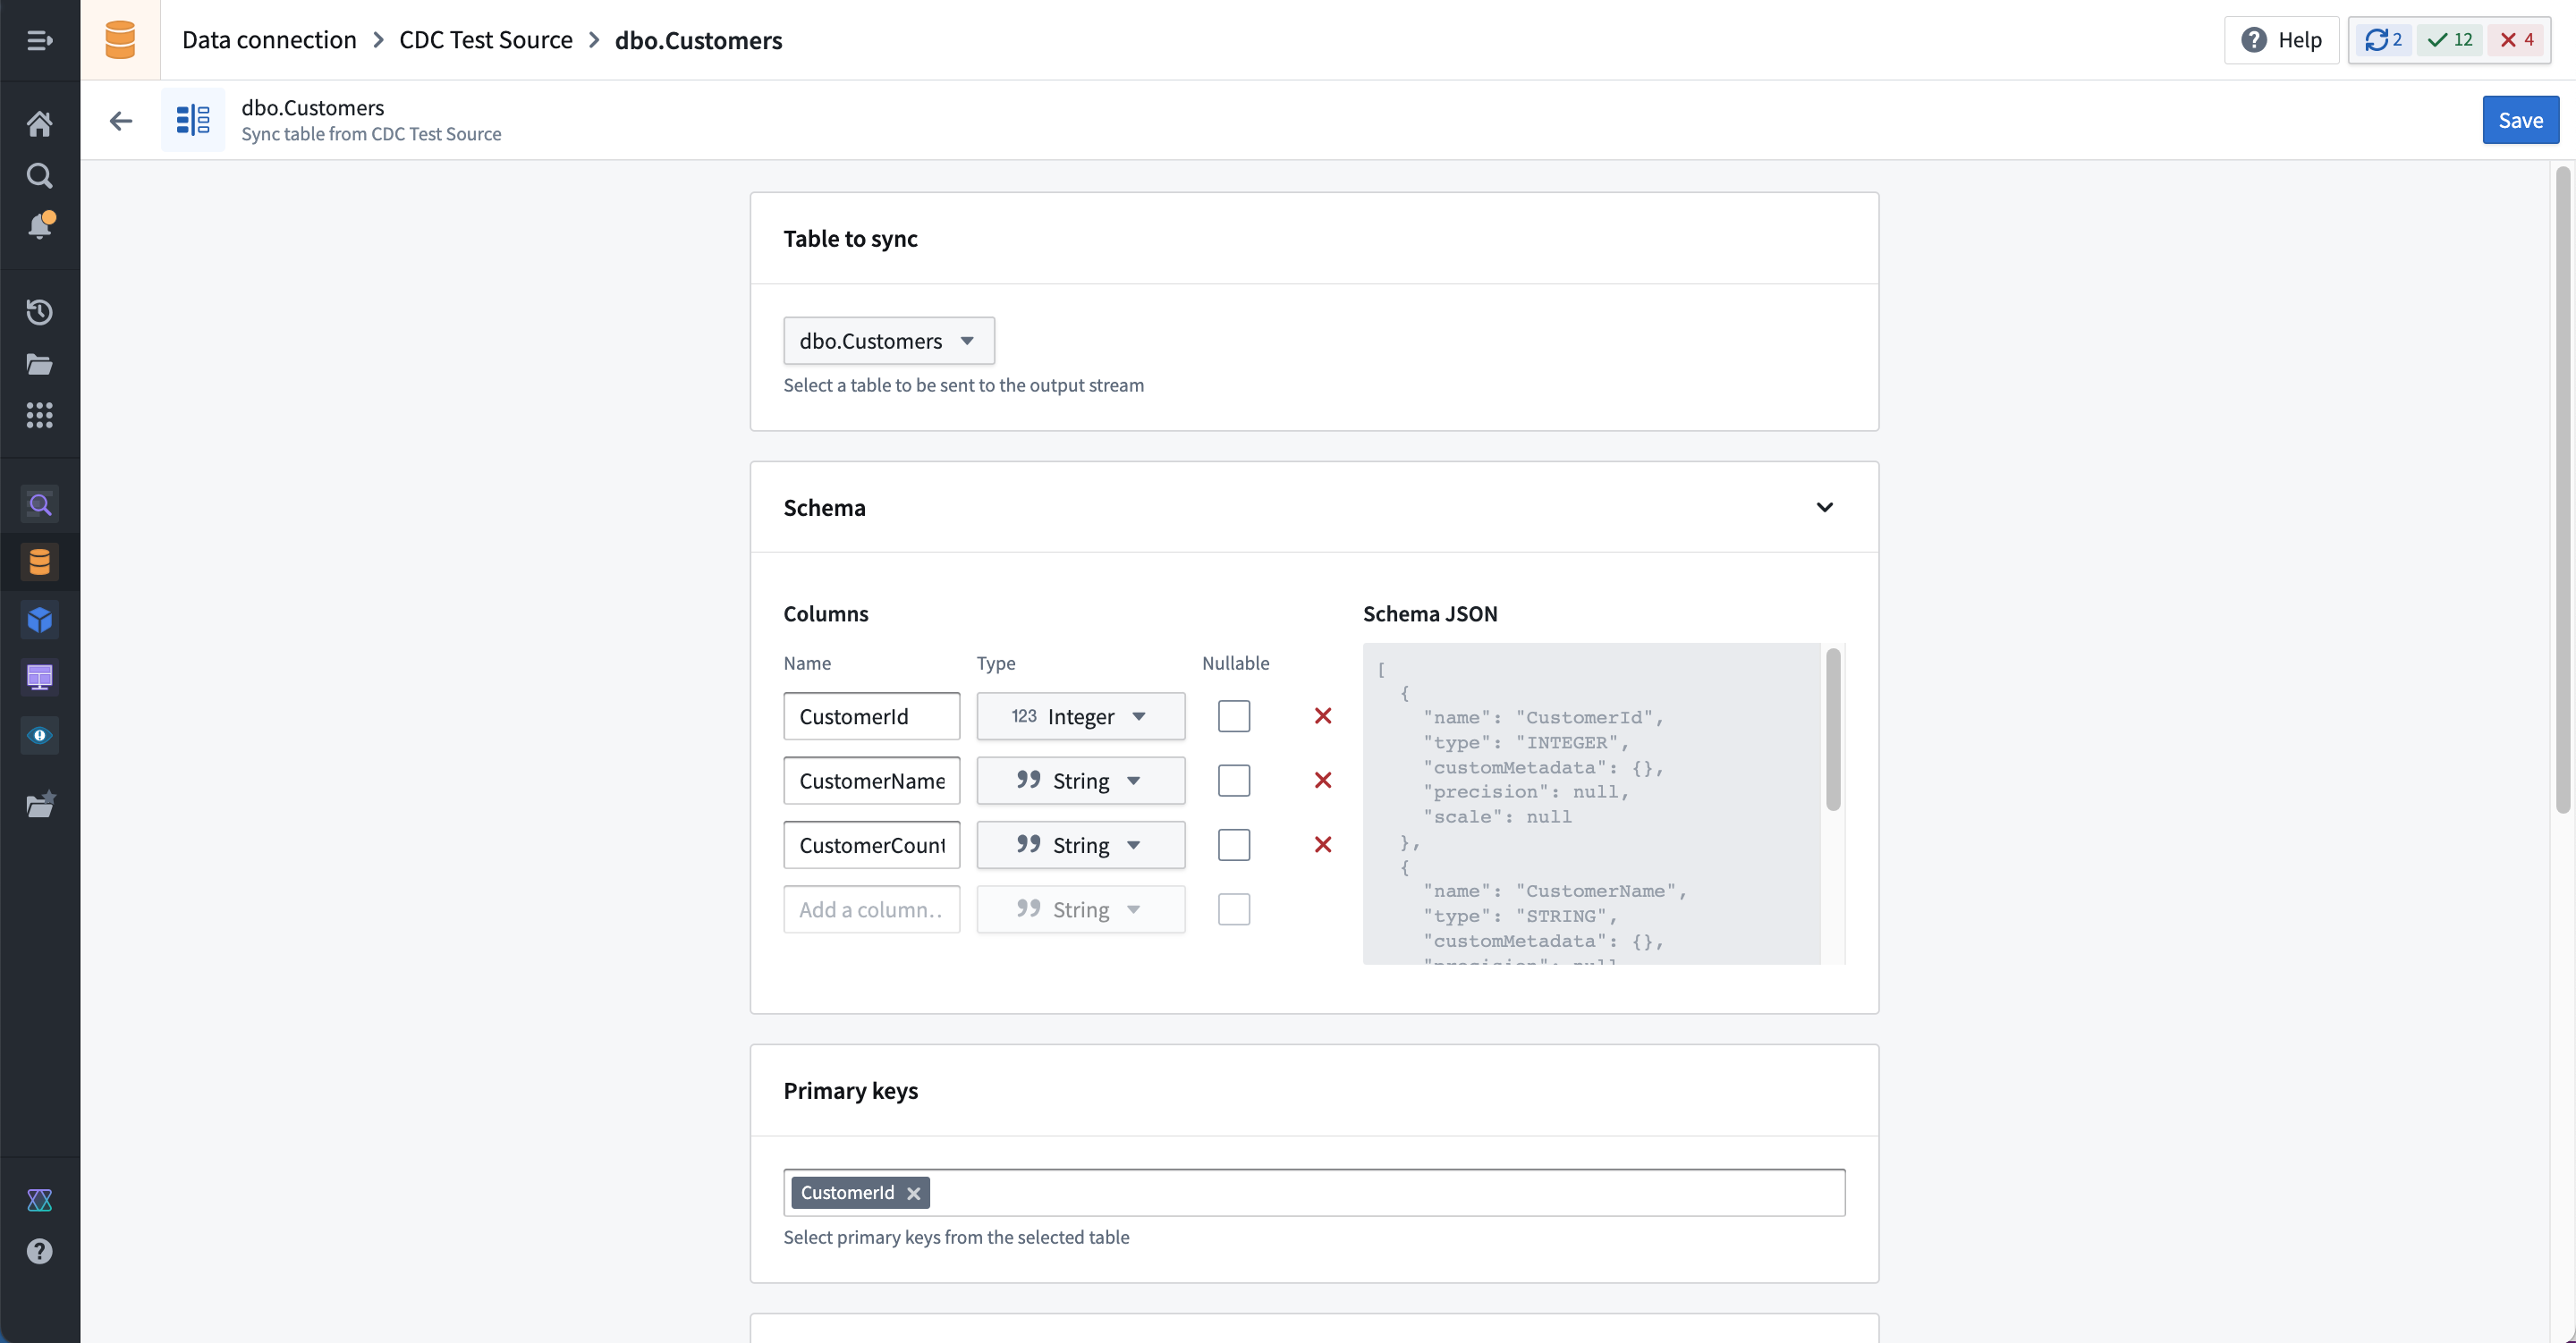
ほかのストリームと同様に、作成時に想定されるスループットを指定する必要があります。同期の作成後はスループットを変更できません。想定される変更履歴データ量に対応できるようにストリームを設定してください。デフォルトのデータ量は 5MB/s で、通常、ほとんどの変更データキャプチャワークフローで必要とされる量を上回ります。リレーショナルデータベースの変更は「人間の活動規模」で発生することが多いため、変更の量と頻度は、センサーや機器のデータで生じ得る「機械の活動規模」のものよりもはるかに小さくなります。
同期の設定を保存すると、指定した出力場所に新しいストリームが作成されます。
現在、変更を加えた後は、CDC ジョブを手動で開始または再起動する必要があります。すべての CDC 同期は、複数の出力を持つ単一の抽出ジョブとして実行されます。このため、フィードを追加または削除するたびに、同じソースの既存の CDC ストリームを一時的に停止する必要があります。ストリームは、ストリーミング同期ジョブの停止中に変更されたデータを問題なく取り込み、最新の状態に追いつきます。
出力ストリームを開始すると、変更履歴データが流れ始め、出力ストリーミングデータセットのライブビューに表示されるはずです。
ソースごとにカスタム CDC 設定を行う
Foundry の CDC 実装では、オープンソースプラットフォームの Debezium ↗ を使用してデータソースのログを読み取ります。Data Connection のインターフェースから直接、個々のソースの Debezium 接続およびエンジンのプロパティを設定できます。まず、設定する作成済みのソースに移動します。次に、右上の CDC 同期を選択します。CDC 設定セクションを選択して、設定オプションを展開します。

Foundry のデフォルトの CDC 設定は、円滑なセットアップを実現し、ソースシステムへの影響を最小限に抑えるように設計されています。ただし、デフォルト設定がデータ要件に合っていることを確認するために、コネクターの具体的なデフォルト動作、特にスナップショットモードを確認することを強く推奨します。
データソースの種類ごとに、設定可能な推奨項目があります。たとえば、上の画像には、Microsoft SQL Server コネクターのトランザクション分離レベルが表示されています。ただし、Debezium の詳細な設定オプションを使用して、任意の Debezium プロパティを設定することもできます。この柔軟性により、各データソース固有のニーズに合わせて設定をカスタマイズできます。
データコネクターの CDC 設定のカスタマイズは、次の例を含むさまざまな状況で役立ちます。
- 大量のトランザクション: トランザクションが急激に集中するデータコネクターでは、デフォルトの
max.batch.size設定によって小さなバッチの処理が過剰に発生し、オーバーヘッドの増加やデータ伝播の遅延につながる可能性があります。max.batch.sizeを増やすことで、変更をより大きなバッチにまとめ、効率とデータフローを改善できます。 - ネットワークの不安定性: 一時的なネットワークの問題やエラーが発生しやすいデータコネクターでは、
error.max.retriesを増やすことで、コネクターが自律的に復旧する機会が増え、データの取りこぼしのリスクを低減できます。 - リアルタイムの更新: ほぼリアルタイムの更新が重要となる、トランザクションの多い環境では、
offset.flush.interval.msを小さくすると、オフセットのフラッシュがより頻繁に行われ、復旧ウィンドウが最小限に抑えられ、変更がより迅速に伝播されます。
データコネクターの種類ごとに設定できるプロパティについては、Debezium のドキュメント ↗を参照してください。
任意の Debezium プロパティを設定する場合、互換性と機能が正常に動作することを確認する責任はご自身にあります。不適切な設定は、予期しない動作やデータ損失につながる可能性があります。慎重に進め、Debezium のドキュメントを参照して確認してください。
ストリームでの変更データキャプチャ
変更履歴メタデータを持つストリームでは、データの2つのビューが表示されます。
- 変更履歴エントリーの完全に展開されたリストを表示するライブビュー。
- 解決戦略に従ってデータを解決し、現在の最新データのビューに集約するアーカイブビュー。
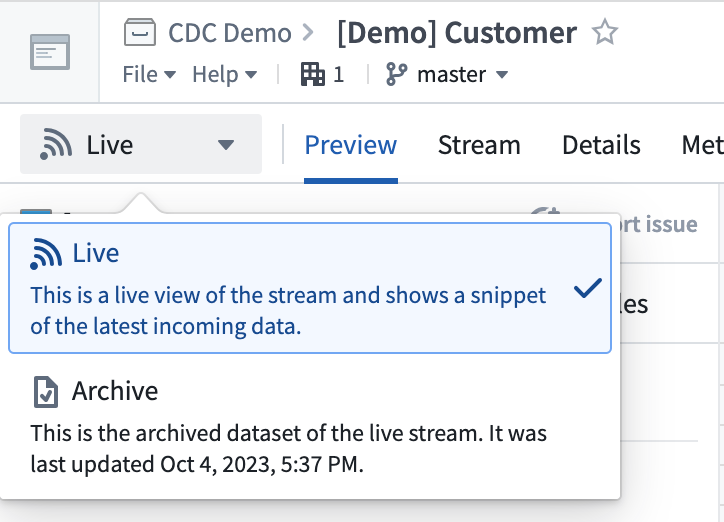
スキーマの詳細表示では、変更履歴メタデータが主キー解決戦略として表示されます。
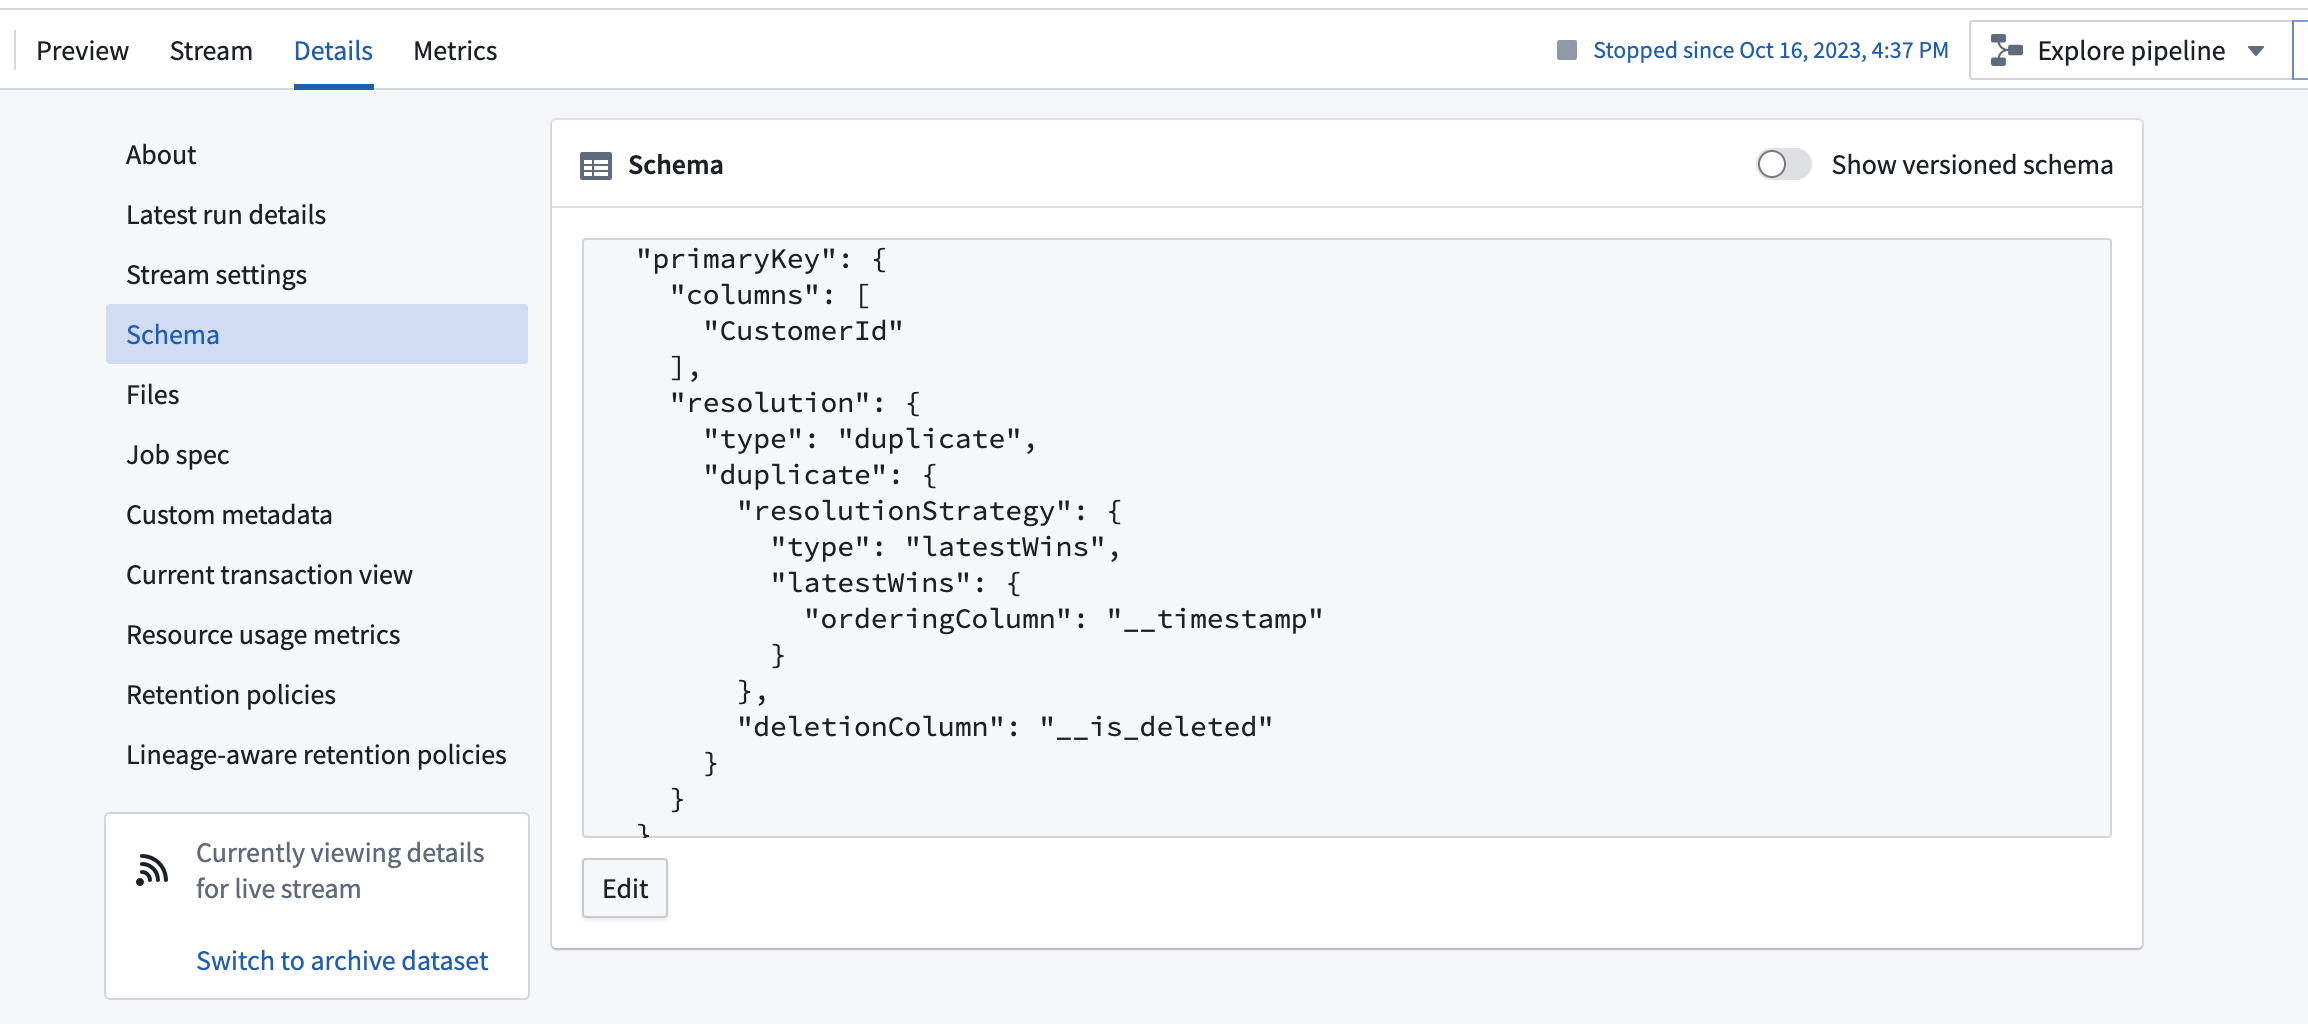
ストリームでは、データを順序どおりに受信しなかった場合でも、指定された順序付け列を使用してアーカイブビューを解決します。この動作は、Foundry オントロジーの変更履歴データとは異なります。オントロジーでは、オブジェクトタイプの元となるストリームへの到着順に基づいてデータをインデックス化します。
Pipeline Builder での変更データキャプチャ
Pipeline Builder は、変更データキャプチャ(CDC)ストリームを処理および設定するための強力な機能を提供します。このセクションでは、完全な CDC ストリームを扱う場合と、バックフィルが必要な部分的な CDC ストリームを扱う場合の2つのシナリオについて説明します。
完全な CDC ストリームを処理する
Pipeline Builder でストリーミング変換を扱う場合、メタデータを保持したまま変更履歴データを処理できます。変換中にメタデータ列(主キー、順序付け、削除)が変更されなければ、変更履歴メタデータはすべての出力に自動的に伝播します。
バックフィルデータセットを使用して部分的な CDC ストリームを設定する
CDC ストリームにすべての履歴データが含まれていない場合があります。代わりに、特定の時点以降の変更のみが含まれていることがあります。完全なデータセットを作成するには、バックフィルデータセットと継続的な CDC ストリームを組み合わせる必要があります。そのためには、以下の手順を使用します。
-
バックフィルデータセットを準備する:
- CDC ストリームに使用したものと同じ Data Connection ソースを使用して、データのスナップショットを取り込みます。
- バックフィルデータセットにタイムスタンプ列が含まれていることを確認してください。ソースデータに含まれていない場合は、SQL 関数(たとえば
CURRENT_TIMESTAMP())を使用して生成します。
-
Pipeline Builder でデータセットを組み合わせる:
- ユニオンデータ加工を使用して、バックフィルデータセットと継続的な CDC ストリームを組み合わせます。
-
CDC メタデータを設定する:
- Key By データ加工ボードを使用して、組み合わせたデータをオントロジーに同期できるよう準備します。
- 主キー列をソースシステムの主キー列と一致するように設定します。
- タイムスタンプ列を順序付け列として選択します。
- 該当する場合は、削除列を指定します。
-
削除と順序付けを処理する:
- タイムスタンプ列でデータを順序付けるように Key By ボードが設定されていることを確認してください。
- ソースデータに明示的な削除情報が含まれていない場合は、削除を推定するロジックを実装する必要がある場合があります(たとえば、連続するスナップショットを比較する方法があります)。
Key By データ加工ボードは、次の情報を含む必要な CDC メタデータをストリームに追加します。
- 主キー解決戦略
- 順序付け列
- 削除列
この設定により、オントロジーへの同期時にデータを適切に解決できるようになり、タイムスタンプの順序付けに基づいて各レコードの最新の状態が維持されます。
CDC 以外のデータに CDC メタデータを適用する
入力ストリームに変更履歴メタデータがない場合や、変換中にメタデータ列が変更された場合でも、Key By ボードを使用して出力に変更履歴メタデータを適用できます。これにより、任意のデータセットを CDC ストリームとして扱えるようになり、強力なデータ統合機能とリアルタイム更新機能を利用できます。
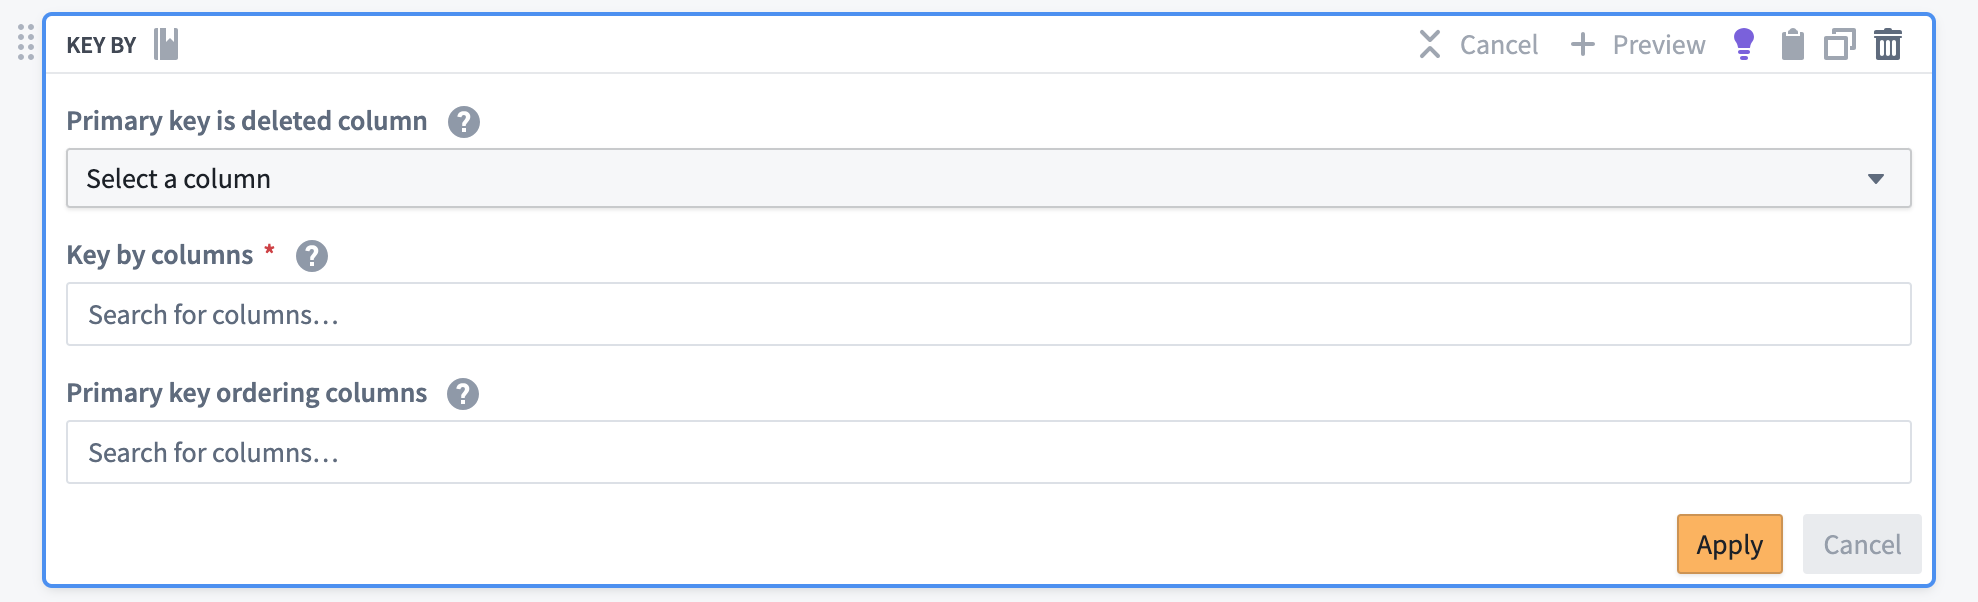
オントロジーでの変更データキャプチャ
オントロジーは変更履歴メタデータを使用して、ストリーミングデータソースを元にした Object Storage v2 のオブジェクトタイプにデータをインデックス化します。ストリームに到着したデータは解決され、現在の最新データのビューとしてインデックス化されます。このビューは、オントロジーへのクエリ時に利用できます(たとえば、Workshop モジュールに表示する場合)。
変更履歴メタデータを持つデータソースに保持が設定されている場合、保持ウィンドウの期間内に更新を受信しなかったレコードはオントロジーから消えます。
オントロジーは現在、変更履歴メタデータで指定された順序付け列を無視します。代わりに、Object Storage v2 は元データソースへの到着順に基づいてデータをインデックス化します。具体的には、ある主キーについて、順序付けの値が 2 で data_column=foo のログエントリーが t1 に到着し、その後に、順序付けの値が 1 で data_column=bar の別のログエントリーが t2 に到着した場合、ソースシステムの最新の値が data_column=foo であっても、レコードは data_column=bar として表示されます。データが順序どおりに到着しない場合、この動作により、オントロジーがソースシステムのデータを正しく反映しなくなる可能性があります。
Palantir で使用するコネクターはデータを順序どおりに配信することが保証されており、Foundry ストリームも順序を維持するため、このオントロジーの動作が影響するのは、カスタムセットアップ、または手動でバックフィルされ、同期前に並べ替えられていない古いストリーミング変更履歴に限られると考えられます。この状況が発生した場合は、オントロジーへの同期前に Pipeline Builder で変換を適用してデータを並べ替えることを推奨します。
Workshop での変更データキャプチャ
Workshop は自動更新をサポートしており、頻繁に更新されるデータがオントロジーで利用可能になるとすぐに表示します。自動更新は CDC に対応しており、変更データキャプチャによってストリーミングされたデータを Workshop アプリケーションで速やかに利用できるようにするために使用できます。自動更新の用途は CDC データに限りません。元データソースに変更履歴メタデータがあるかどうかにかかわらず、Workshop モジュールを開いている間に頻繁な更新が期待されるデータであれば、自動更新を使用できます。
変更データキャプチャを使用する際の考慮事項
CDC ワークフローを使用する前に、バックフィル、障害、その他の既知の制限事項に関する以下の情報を確認することを推奨します。
バックフィル
変更履歴の同期はすべて、「今後発生する変更」のみを対象として処理されます。自動バックフィルは実行されません。
ほとんどのシステムではデフォルトで CDC が有効になっていないため、変更履歴の完全なバックフィルができない場合が多くあります。変更履歴が有効になっていても、ほとんどのシステムには保持期間が設定されており、この期間が過ぎると変更履歴は完全に削除され、復元できなくなります。
完全なバックフィルが必要な場合は、以下を推奨します。
- 「今後発生する変更」を対象とする CDC ストリームを設定します。
- バッチ同期を実行して、必要な履歴データを抽出します。
- 履歴バッチデータを、主キーごとの「作成」レコードのストリームに変換し、そのストリームを CDC ストリームにマージします。
バックフィルによってデータの順序が乱れる場合があるため、オントロジーへの同期に向けてデータを適切に準備するには、ストリームを手動で並べ替えたり、再実行したりする必要がある場合があります。
障害
CDC ワークフローを使用する際に、以下の障害が発生する可能性があります。
- ソースデータベースと Foundry Agent 間のネットワーク接続の障害
- Foundry Agent ホストと Foundry 間のネットワーク接続の障害
- Foundry の障害
- データベースの障害
- Agent の障害
データベースのレプリケーションログと変更履歴の保持期間が、想定される最大障害時間よりも長く設定されていれば、障害から円滑に復旧できます。
たとえば、Foundry への接続が数時間失われ、Microsoft SQL Server のログ保持期間が1日に設定されている場合、データベースは変更履歴エントリの記録を継続します。Foundry がオンラインに戻り、Microsoft SQL Server に再接続すると、円滑に未処理の変更に追いつきます。変更履歴エントリのキューがクリアされるまで新しいデータは流れないため、変更が再びほぼリアルタイムで Palantir に流れ込むようになるまで、多少の遅延が生じる場合があります。
変更履歴以外のソースから取得した変更履歴形式のデータを使用する
CDC ワークフローを使用するために、データを変更履歴として取り込む必要はありません。Palantir 内の任意のストリーミングデータに変更履歴メタデータを使って「キーを付与」し、オントロジーに同期した後、ワークフローで CDC データとして使用できます。
つまり、たとえばストリームプロキシを使用したプッシュベースの取り込みによって、変更履歴形式のレコードをストリームに手動でプッシュできます。
同様に、Kafka トピック内で変更履歴データが利用可能な場合は、標準(非 CDC)の同期を使用して取り込めます。その後、Pipeline Builder を使用して「キーを付与」し、オントロジーおよびその先で使用できます。
変更履歴メタデータを削除する
変更履歴メタデータを削除すると便利な場合があります。たとえば、変更履歴に記録されたプロセスフローを分析するために、メタデータを削除したい場合があります。変更履歴メタデータを削除するには、以下のいずれかの方法を使用します。
- メタデータ列に任意の変換を実行します
- ストリーミングデータセットのスキーマから解決戦略を手動で削除します
CDC テーブルへのアクセスを有効にする
ソースシステムに接続する際は、接続情報でユーザーの資格情報を指定する必要があります。これらの資格情報は、ソースで設定された権限に紐づいています。基本的なデータ取り込みでは、このユーザーに、取り込む予定のデータセットに対する SELECT 権限が必要です。ただし、CDC 接続では、取り込み元のテーブルとそのスキーマの両方に対する SELECT 権限と EXECUTE 権限がユーザーに必要となる場合があります。
CDC のデフォルトの動作
以下は、CDC 接続に共通するデフォルト設定です。
| プロパティ | デフォルト値 | 注記 |
|---|---|---|
tombstones.on.delete | false | 行が削除されても、トゥームストーンレコードは生成されません。 |
decimal.handling.mode | string | Decimal 列は文字列に変換されます。 |
include.schema.changes | false | DDL イベント(スキーマ変更)は出力トピックに転送されません。 |
offset.flush.interval.ms | 60000(1分) | Debezium は1分ごとにオフセットのフラッシュを試みます。 |
error.max.retries | 5 | エンジンは一時的なエラーからの復旧を5回試みた後、失敗します。 |
コネクター固有のデフォルト設定
ほとんどのデータベースコネクターには、スナップショットモードやその他のパラメーターのデフォルト設定もあります。以下のテーブルに、最も重要な設定の概要を示します。これらの設定は、CDC 同期ページからオーバーライドできます。CDC 設定のドロップダウンセクションで編集を選択し、次にDebezium の詳細な設定の下にあるプロパティを追加を選択します。
Oracle
| プロパティ | デフォルト値 |
|---|---|
snapshot.mode | schema_only |
schema.history.internal.store.only.captured.tables.ddl | true |
internal.log.mining.log.query.max.retries | 10 |
log.mining.strategy | online_catalog |
log.mining.query.filter.mode | in |
log.mining.batch.size.default | 50000 |
database.connection.adapter | logminer |
PostgreSQL
| プロパティ | デフォルト値 |
|---|---|
snapshot.mode | never |
plugin.name | pgoutput |
Db2
| プロパティ | デフォルト値 |
|---|---|
snapshot.mode | no_data |
snapshot.isolation.mode | none |
Microsoft SQL Server
| プロパティ | デフォルト値 |
|---|---|
snapshot.mode | schema_only |
offset.flush.interval.ms | 1000 |
スナップショットモードの考慮事項
デフォルトでは、Foundry はデータベースの可用性に影響を与えないように、snapshot.mode を schema_only(Oracle、SQL Server)、no_data(Db2)、または never(PostgreSQL)に設定します。これらの設定では、スナップショット処理中にテーブルをロックしないため、実行中のデータベース操作への影響を控え目に抑えます。これらのモードはテーブルのロックを回避しますが、Debezium が処理する前にアーカイブログが削除されると、データが失われるリスクは依然としてあります。たとえば、Oracle は時間の経過とともに古い REDO ログを削除することがあります。Debezium が削除済みのログを読み取ろうとした場合、完全なスナップショットがなければ、失われたデータを復元できません。
代替設定
ログの削除に備えたい場合や、ベースとなるデータセットを確保したい場合は、代わりに、より完全なスナップショット設定を検討してください。
-
recovery- 動作: スキーマ履歴トピックが失われたり破損したりした場合に、すでに変更をキャプチャしているコネクターを復旧します。前回のシャットダウン以降にスキーマの変更がなかった場合、再起動時にデータベースのスキーマ履歴をリセットして再構築します。
- 制限事項: スキーマ履歴トピックを無期限に保持する必要があります。
-
always- 動作: コネクターが再起動するたびに完全なスナップショットを取得し、データのコピーが完全に最新であることを保証します。
- 制限事項: 起動のたびにテーブルのロックと追加のオーバーヘッドが発生する可能性があります。
when_needed- 動作: Debezium が有効なオフセットを検出できない場合にのみスナップショットを取得します。たとえば、オフセットが存在しない場合や、有効期限が切れている場合です。
- 制限事項: スナップショットがトリガーされたときに、テーブルがロックされる可能性は依然としてあります。