注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
HyperAuto V2 の設定オプション
このページでは、HyperAuto V2 の設定オプションについて説明します。HyperAuto V1 の設定リファレンスについては、レガシードキュメントを参照してください。HyperAuto V2 の設定プロセスは、次のステップで構成されます。
名前と場所
HyperAuto V2 設定ウィザードの最初のステップでは、新しいパイプラインの名前と、Foundry ファイルシステム内の目的のフォルダーの場所を指定します。HyperAuto パイプラインリソースと関連する出力データセットは、このフォルダー内に作成されます。
ソース設定
HyperAuto V2 のソース設定ページでは、ソースシステムと取り込み方法を選択できます。
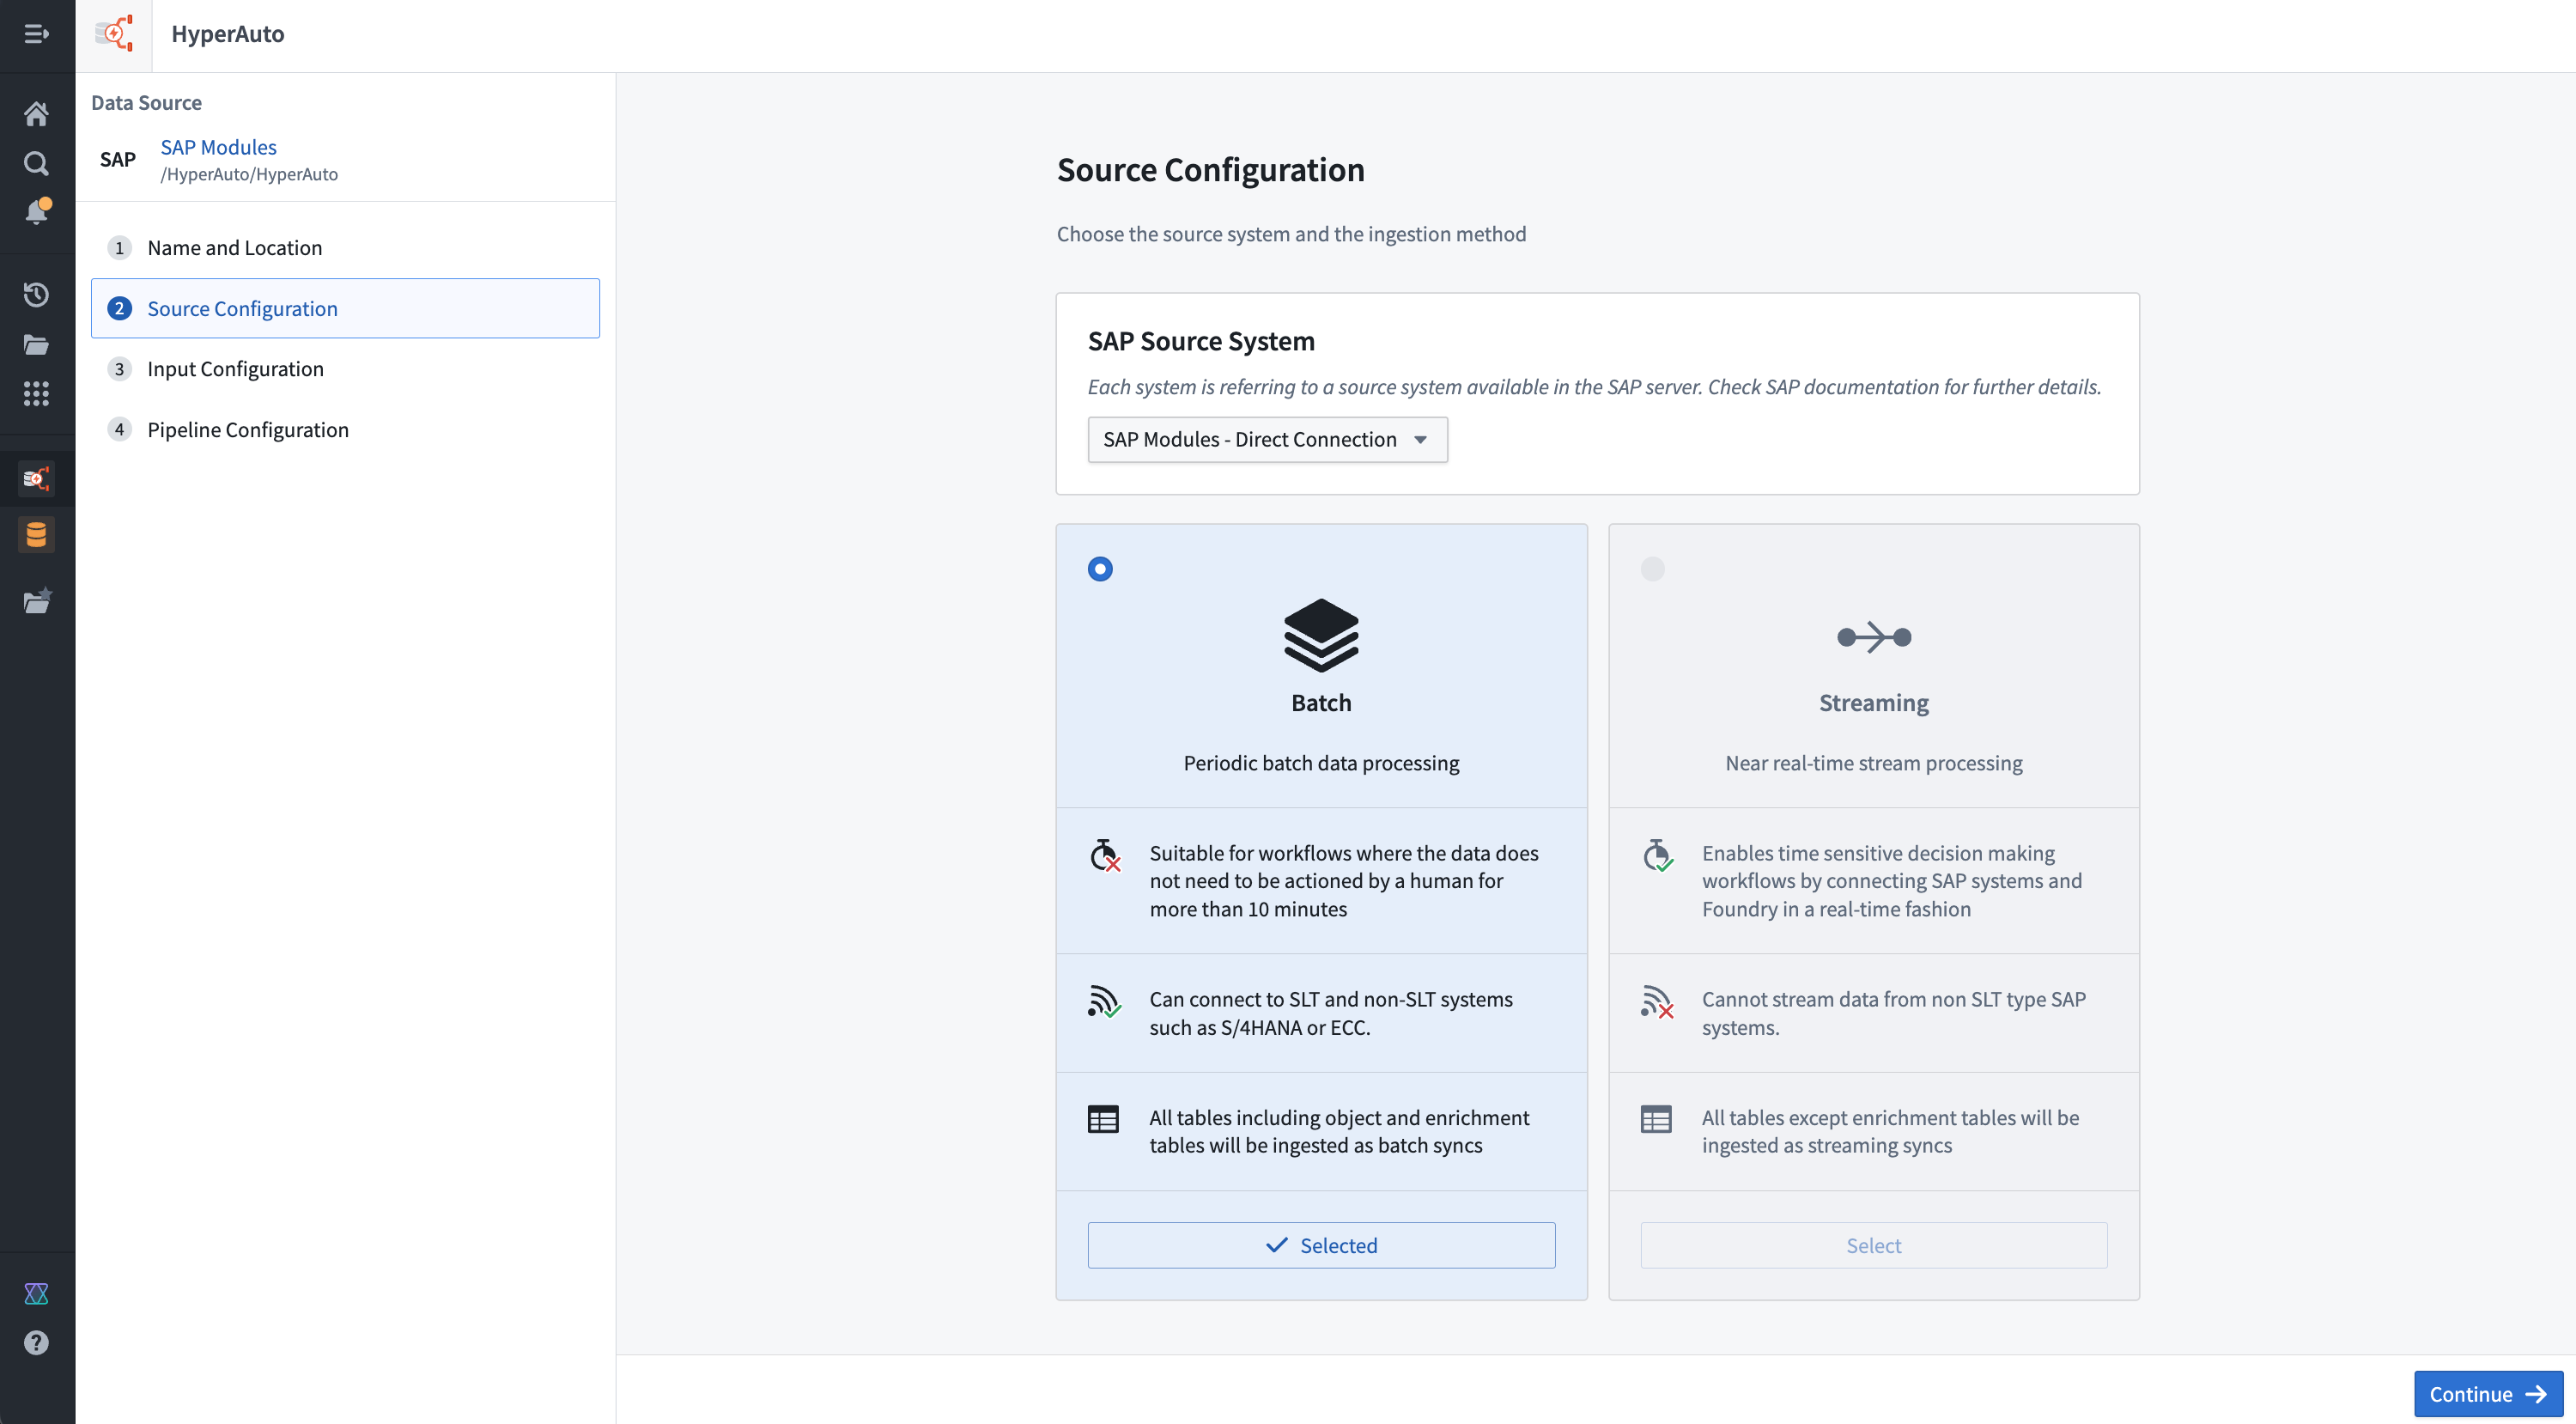
ソースシステム
この選択項目は、ユーザーが選択する必要のあるサブシステムを持つソース(たとえば、SAP 内の「コンテキスト」)で利用可能です。サブシステムとは、利用可能なテーブルとメタデータがそれぞれ異なる、ソース内の設定を指します。そのため、サブシステムを切り替えると、サポートされるパイプラインモード(バッチまたはストリーミング)や、入力設定ページで選択できるテーブルと既存の同期など、ほかの利用可能な設定が完全に変わります。
SAP ソースシステム
Foundry を SAP システムに接続するには、主に3つのアーキテクチャパターンがあります。
- Direct: コネクターは ERP システム自体のアプリケーションサーバーにインストールされ、テーブルへの直接アクセスを提供します。
- SLT: コネクターは SAP SLT Replication Server にインストールされ、このサーバーが背後の ERP システムに接続します。ストリーミングパイプラインモードを使用するには SLT が必要です。
- リモート: コネクターは、背後の ERP システムに接続する「ゲートウェイ」アプリケーションサーバーにインストールされます。ほかの方法では SAP ソースがコネクターの前提条件を満たさない場合によく使用されます。 SLT 接続またはリモート接続の場合、ユーザーは接続先の SAP サブシステムを識別するためのコンテキストを選択する必要があります。
パイプラインモード
HyperAuto は、同期とデータ変換に2つのモードをサポートしています。HyperAuto パイプラインの初期セットアップ時に、ソース設定ページでストリーミングモードまたはバッチモードを選択できます。
- バッチ: パイプラインを実行するたびに、すべての入力を再処理し、既存のすべての出力を上書きします。これはデフォルトのモードであり、集計や重複排除など、最も幅広い機能を利用できます。ほとんどのユースケースでは、このモードを推奨します。
- ストリーミング: ソースシステムに対して、未処理のデータがないか常時ポーリングします。データがソースシステムで利用可能になるとすぐに処理されるため、同期からオントロジーへの反映までの遅延がほぼリアルタイムにまで短縮されます。これは、ストリーミングされたデータの重複排除をオントロジーに依存するリアルタイムアプリケーションを支えるうえで、特に有用です。
ストリーミングでは、データをリアルタイムで処理するために常時稼働する計算処理が必要なため、ソースシステムおよび Foundry 内の負荷が増加する可能性が高くなります。
入力設定
入力設定ページでは、特定の HyperAuto パイプラインで処理する入力をユーザーが選択します。
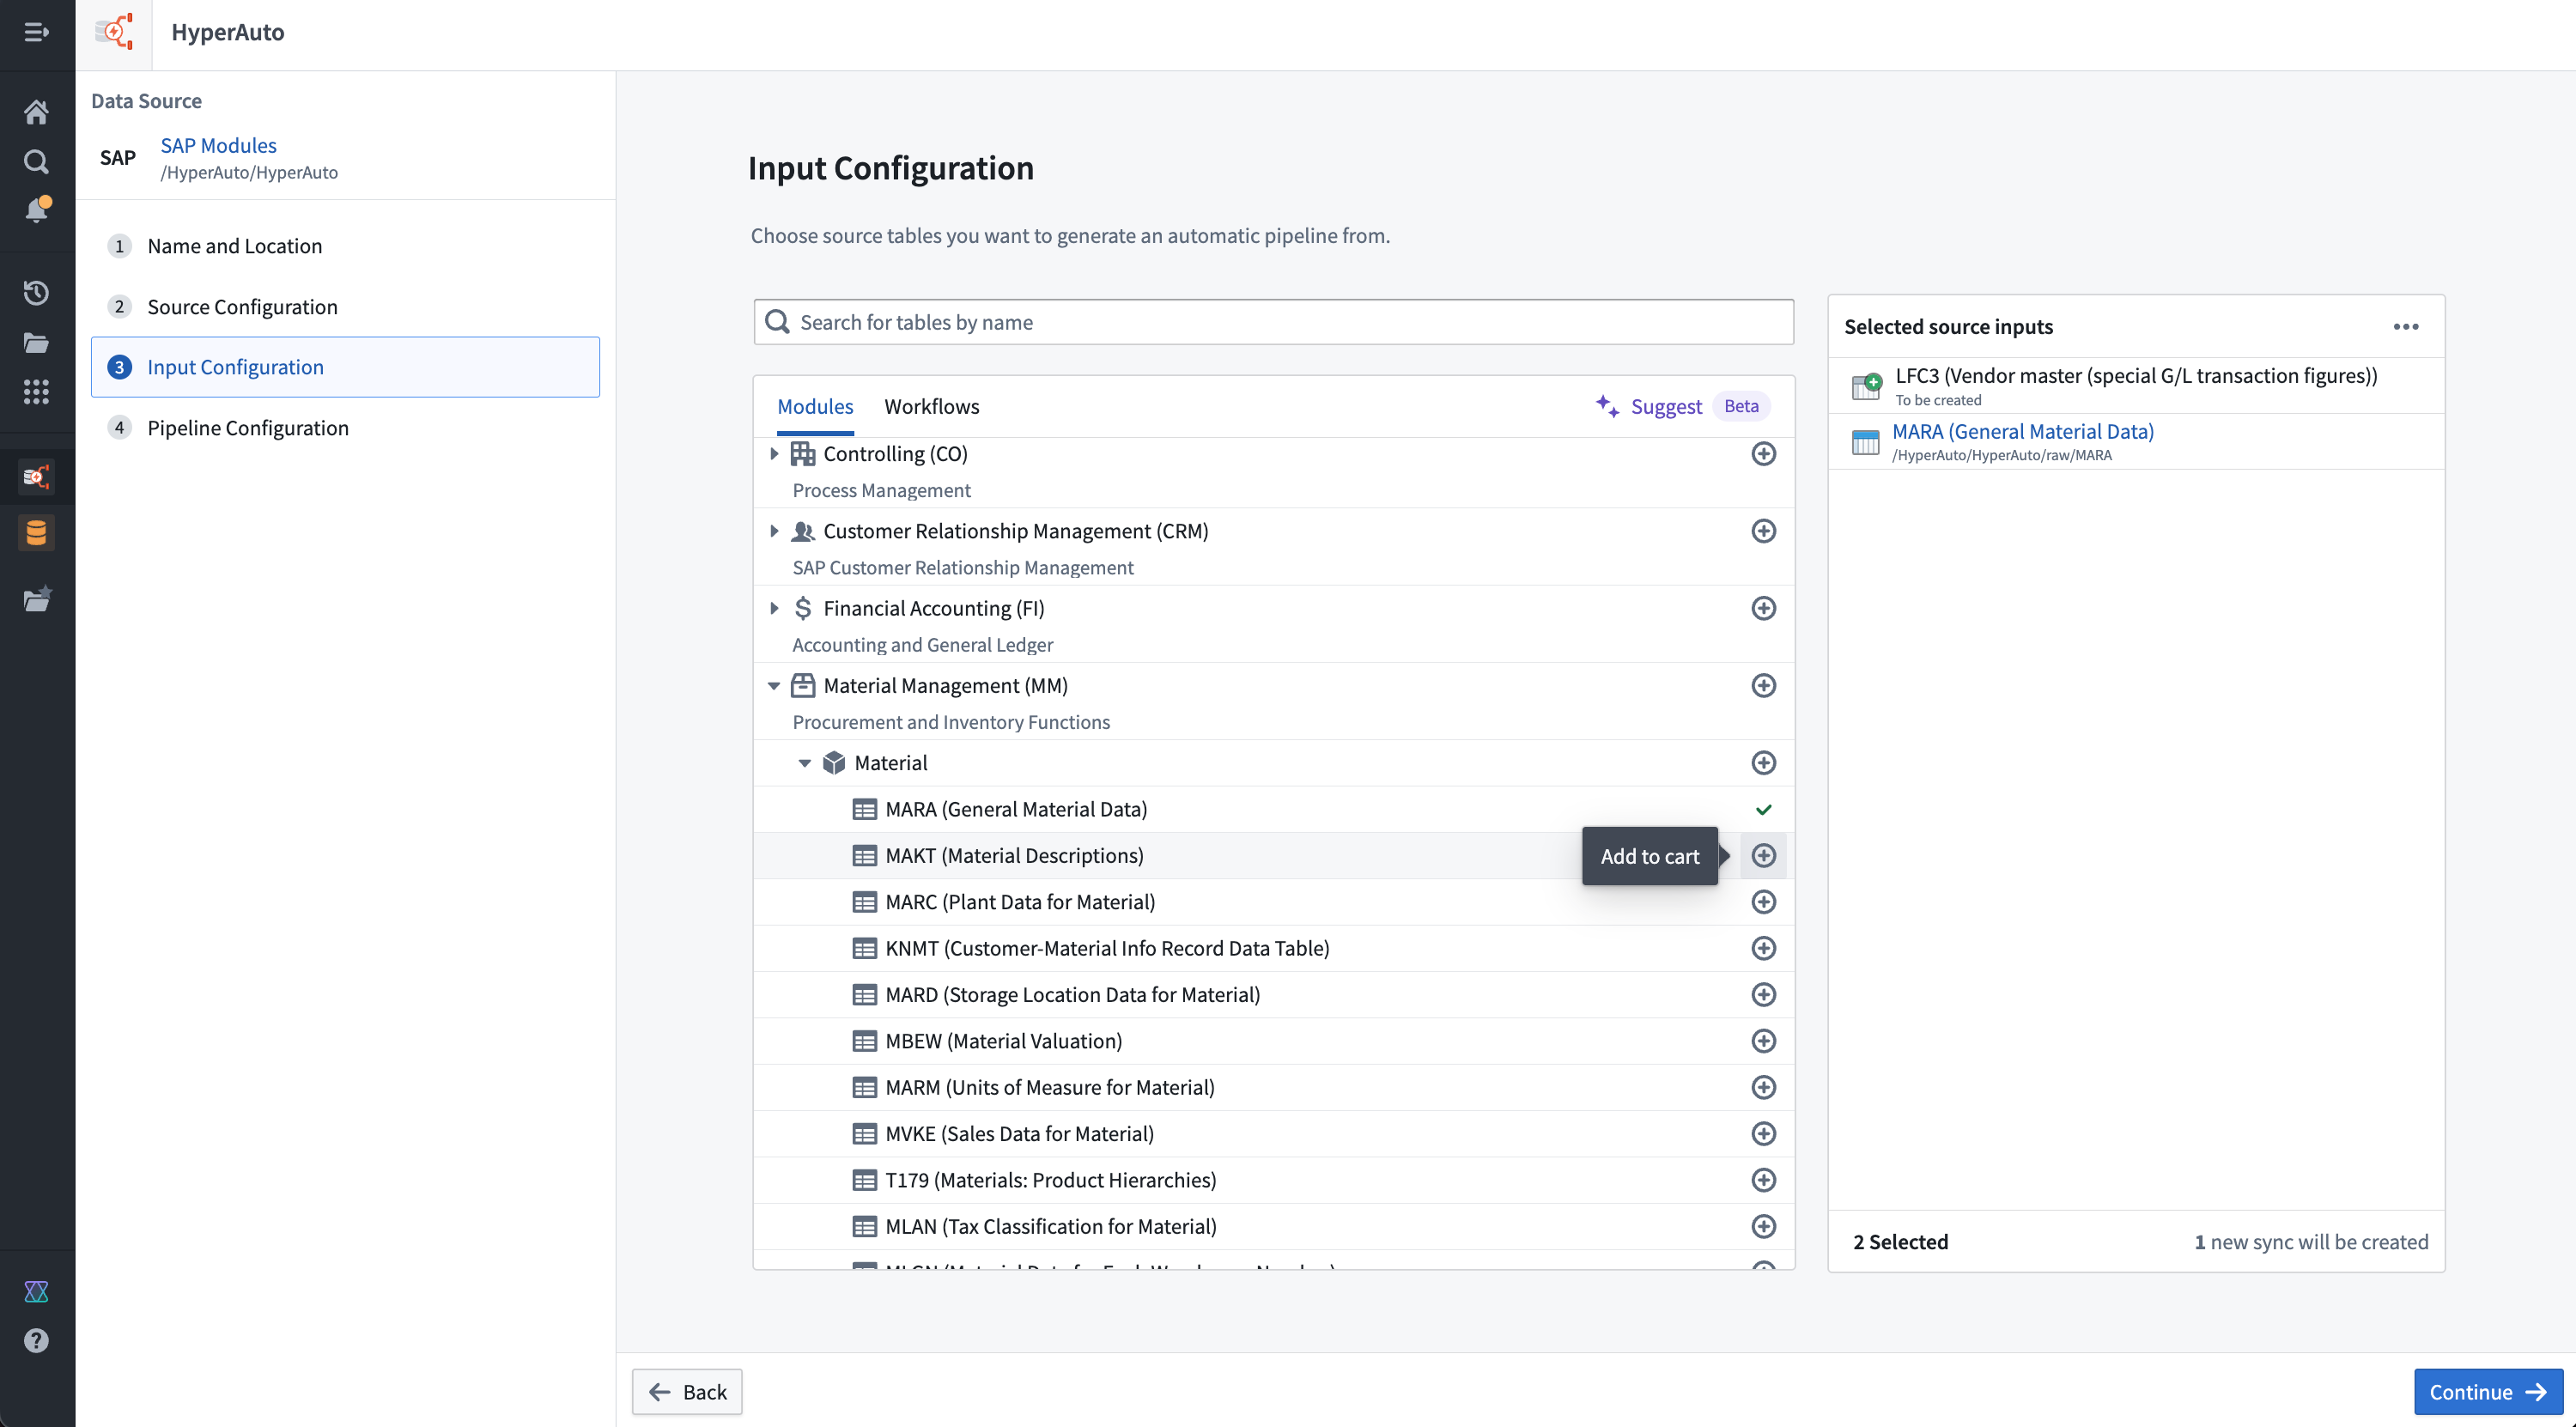
使いやすさを考慮し、入力選択 UI は、関連するソーステーブルの一覧を見たり、テーブルを見つけたりするための方法をいくつかサポートしています。SAP では、次の方法があります。
- モジュール: ソース内のテーブルを一定の方針に基づいて分類し、ユーザーが探索して一括追加できる階層ビューを提供します。関連する場合は、テーブルが複数のモジュールに含まれることがありますが、同じテーブルを2回以上選択することはできません。
- ワークフロー: ソースでよくある特定のユースケース(SAP ソースでのサプライチェーン管理など)に焦点を当てた、もう1つのテーブル分類方法です。同様に、ユーザーは必要に応じてワークフローを使用して探索や一括追加を行えます。また、進行状況を失ったり、誤って選択が重複したりすることなく、ワークフローとモジュールを切り替えられます。
入力設定ページでは同期の作成も利用可能で、同期がまだ存在しない入力に対して新しい同期を作成できます。これにより、ユーザーは個々の同期の設定方法を調べることなく、未設定のソースから、設定済みの HyperAuto パイプラインを数回のクリックで作成できます。
同期の作成は開発のベータ版段階にあり、お使いのエンロールメントでは利用できない場合があります。開発が進行している間に機能が変更される場合があります。同期の作成の利用をご希望の場合は、Palantir サポートにお問い合わせください。
お使いの Foundry エンロールメントでは、提案タブで AIP 機能が有効になっている場合があります。詳細は、AIP ドキュメントを参照してください。
パイプライン設定
パイプライン設定ページでは、次のようなオプションを使用して、ニーズに合ったパイプラインを設定できます。
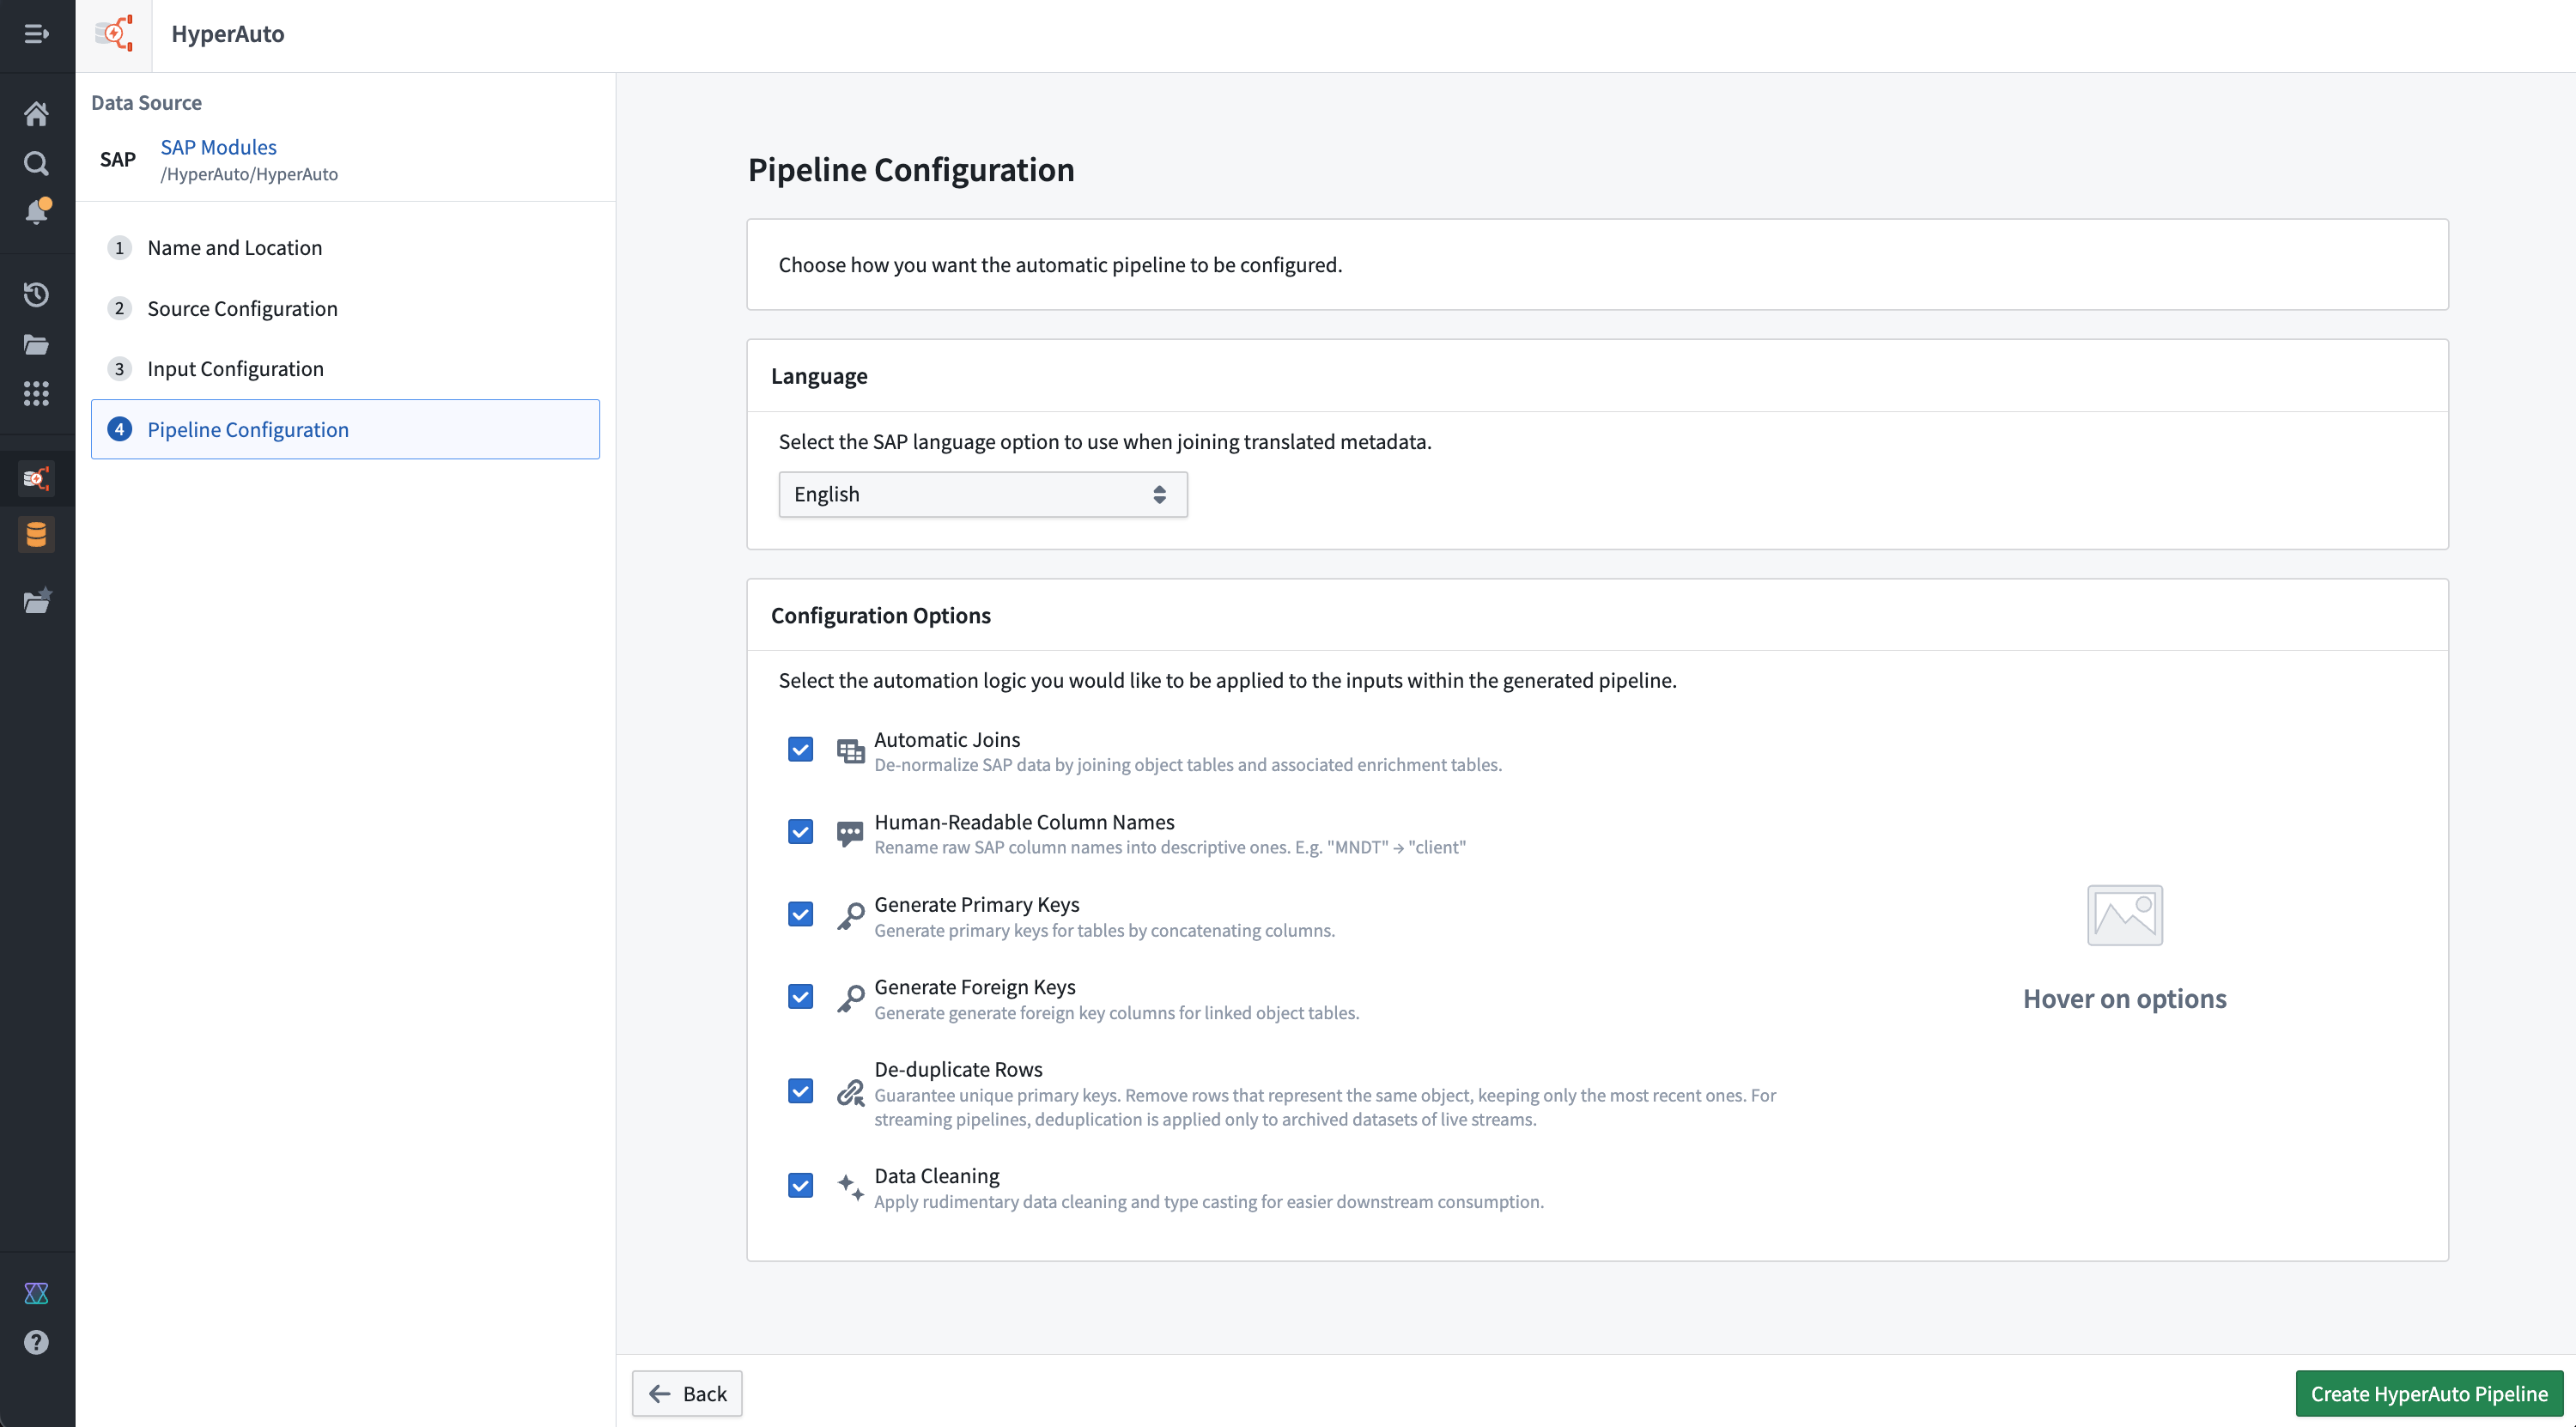
言語の選択
複数言語のデータを含むテーブルがあるソースに対して、HyperAuto は言語で絞り込むステップを提供し、出力に言語ごとの行が生成されることを防ぎます。ここで選択した言語は、追加の変換(ほかのテーブルとの結合など)が適用される前に、関連するテーブルに対するフィルターとして適用されます。
設定オプション
パイプラインの設定オプションで、すべてのソース入力に自動的に適用する処理の範囲を決められます。すべての設定オプションはデフォルトで有効ですが、必要に応じて無効にできます(たとえば、機能とパイプラインのパフォーマンスのバランスを取るため)。
自動結合
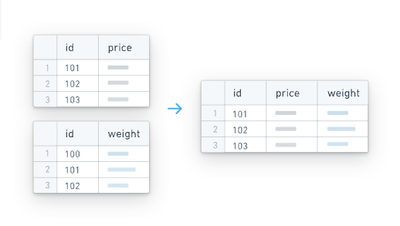
HyperAuto はソースのメタデータを通じてテーブルの分類情報を受け取り、オブジェクトテーブルとエンリッチメントテーブルに分けます。ここでいうエンリッチメントテーブルとは、それ自体に本質的な価値があるのではなく、関連するオブジェクトテーブルの拡張機能や参照テーブルとして機能するテーブルです(たとえば、テキストの説明テーブル)。
このように、HyperAuto はソースから object <-> enrichment のテーブル間の関係をクエリし、対応する左結合でエンリッチメントテーブルをオブジェクトテーブルに結合できます。その結果、オブジェクトごとに豊富で包括的な非正規化データセットが作成され、ほかのテーブルと結合しなくても詳細な確認ができるようになります。
これは、意味を重視した非正規化データモデルを使用することが標準的なアプローチとなる Foundry オントロジーの構築で、特に役立ちます。
SAP での自動結合
SAP の場合、HyperAuto の処理では「TEXT」テーブルがエンリッチメントテーブルに分類されます。たとえば、MAKT(品目説明)を MARA(一般品目データ)に結合できます。
ストリーミング
エンリッチメントに分類されたテーブルは、ストリームではなくバッチ入力として使用されます。これにより、パイプラインはこれらのテーブルからコアストリームへの参照用の左結合を作成でき、2つのライブストリームを同時に結合しようとすることなく、ストリームデータを拡充できます。
ストリーミングモードのエンリッチメントテーブルに対する既存の同期は、スキーマが Foundry のストリーミングと、その基盤として使用される Avro ファイル形式に準拠している場合にのみ、該当する入力の設定時に選択肢として表示されます。
SAP の同期では、cleanFieldNamesForAvro 設定オプションを true に設定すると、スキーマが Avro(ストリーミング)に準拠するようになります。HyperAuto が作成する同期では、このオプションがデフォルトで有効になります。
人が理解しやすい列名
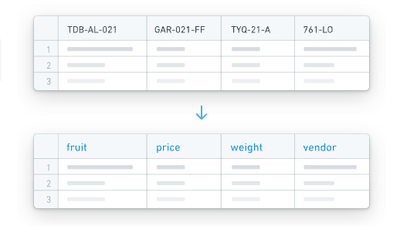
HyperAuto はソースから提供される列のメタデータを使用して、ソースで定義された列名を、ソースのスキーマに詳しくないユーザーにも意味がわかりやすく使いやすい名前に変更できます。
これは、人が理解しやすい列名を元の列名と Human readable_|_original の形式で連結することで行われます。データを扱う際に両方の形式を利用できるため、使いやすさが最大限に高まります。
人が理解しやすい出力データセット名
有効にすると、HyperAuto はソーステーブルのメタデータに基づいて、新しく作成する出力データセットにわかりやすい名前を生成します。これにより、元のソーステーブル名を参照しなくても、パイプラインの出力を識別して移動しやすくなります。既存のパイプラインでこのオプションをオンにしても、既存の出力データセットの名前は変更されません。
主キーを生成する
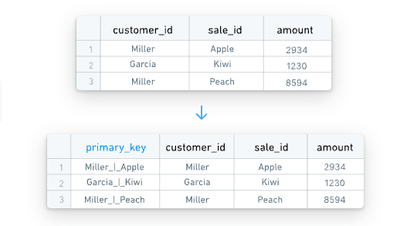
ソースに単一列の主キーがない場合、HyperAuto は主キーを動的に生成できます。ソースのメタデータには、テーブル内のどの列を組み合わせると主キーになるかを示す情報が含まれています。HyperAuto はこの情報を使用して連結ロジックを作成し、primary_key 列を作成します。
値は _|_ 区切り文字で連結されます。
出力をオントロジーオブジェクトの元データセットとして使用するには、主キーが単一列である必要があります。
外部キーを生成する
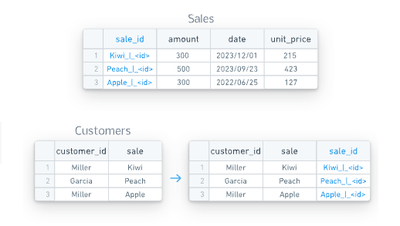
HyperAuto は、ソースのデータモデルのメタデータで定義されたオブジェクト間の関係にもアクセスできます。このメタデータを使用して、関係ごとに外部キー列を生成するロジックをパイプラインに作成できます(主キーのロジックと同様に、関連する列を連結します)。この列は、結合やオントロジーのリンクの作成に使用できます。
外部キーの名前は column1_column2_|_foreign_key_tableA の形式で、次のようになります。
- 列の値は、
column1とcolumn2を区切り文字_|_で連結して作成されます。 - 外部関係が存在するため、このテーブルのこの列を、
tableAのprimary_keyと結合できます。
オブジェクト間のオントロジーの関係を作成するには、外部キーが必要です。
自動結合の設定オプションが有効な場合、オブジェクトテーブルとエンリッチメントテーブルの関係には外部キーが作成されません。
行の重複を排除する
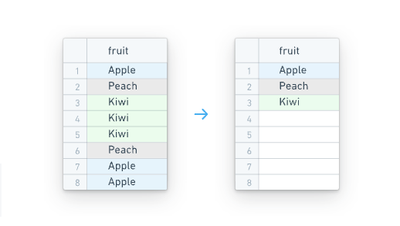
HyperAuto は、重複する行を含むテーブルの重複を自動的に排除するロジックを提供します。これは、変更が発生するたびに新しい行を追加する変更データキャプチャ(CDC)システムなどで役立ちます。HyperAuto は、主キーごとに最新の行を選択して重複を排除します。
ストリーミング
ストリーミングモードでは、重複排除の処理方法が異なります。2個のストリーミング出力が作成されます。メイン出力は、バッチまたはインクリメンタル(差分処理)パイプラインで読み取ると、重複排除済みのデータセットになります。変更履歴の出力は、必要に応じてバッチまたはインクリメンタルパイプラインで読み取ると、重複排除されていないデータセットになります。どちらの出力も、通常どおり別のストリームで使用できます。
テーブルの主キーを構成する列が次のいずれのデータ型でもない場合、重複排除が機能するように文字列にキャストされます。
- 文字列
- タイムスタンプ
- ブール値
- バイナリ
- Integer
- Byte
- Short
- Float
- Long
- Double
データクリーニング
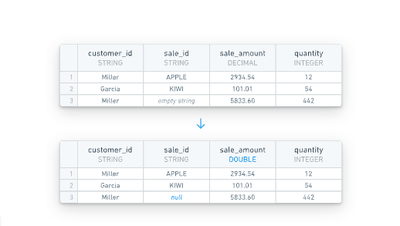
データクリーニングの設定オプションは、すべてのテーブルから一般的なデータ品質の問題を取り除きます。対処する問題の種類について、詳しくは次を参照してください。
- 空の文字列の処理:
""文字列はnullに変換されます(Foundry のデータに対する標準的な処理です)。 - DECIMAL のキャスト:
DECIMALデータ型はDOUBLEにキャストされます。これには、オントロジーのプロパティのサポートが有効になるなど、プラットフォーム全体で利点があります。
インクリメンタル(差分処理)
HyperAuto パイプラインのインクリメンタル処理は、開発の試験的フェーズにあり、お使いのエンロールメントでは利用できない場合があります。開発が進行している間に、機能が変更される可能性があります。
バッチの SAP パイプラインでは、インクリメンタル処理を有効にできます。有効にすると、パイプラインは実行のたびにすべての入力を再処理するのではなく、前回のビルド以降に入力データセットに追加された新しいデータのみを処理します。これにより、頻繁に更新される大規模な入力データセットを持つパイプラインで、コンピューティングリソースの使用量とビルド時間を削減できます。
インクリメンタル処理は、SAP に直接接続するバッチパイプラインでのみ利用可能です。インクリメンタル計算について、詳しくはバッチ入力データセットの計算モードを参照してください。
バッチコンピュート設定
HyperAuto パイプラインのバッチコンピュート設定は、開発のベータ版段階にあります。開発が進行中のため、機能が変更される場合があります。
バッチパイプラインでは、パイプライン設定ページのバッチコンピュート設定セクションでコンピュートバックエンドを選択できます。この設定によって、パイプラインの処理に使用するコンピュート方式が決まります。
次のコンピュートバックエンドの選択肢が利用可能です。
- 標準:Spark ↗ を使用するデフォルトのバックエンドです。この選択肢は、Pipeline Builder で利用可能なすべての式とデータ加工をサポートします。
- 高速: Rust で記述されたオープンソースのクエリエンジンである DataFusion ↗ を使用する代替バックエンドです。高速パイプラインは、ビルド時間を最適化し、低遅延の操作を効率的に実行するために特別に設計されています。特に、実行時間が15分未満のパイプラインは、高速パイプライン設定によるメリットが最も大きくなります。
新しい HyperAuto パイプラインを作成するときに高速バックエンドを選択できます。また、パイプライン設定を編集して、既存のパイプラインのバックエンドを切り替えることもできます。