注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
SAP(カスタムソース)
SAP(カスタムソース)コネクターを使用すると、magritte-sap-source コネクタータイプで手動設定したソースを使って、Foundry を SAP システムに接続できます。このコネクターでは、新しい SAP コネクターで利用可能なガイド付き設定ではなく、YAML ベースのカスタム設定を使用します。
新しい SAP 統合には、SAP ERP または SAP SLT コネクターを使用してください。これらのコネクターは、より新しく高性能な API を使用して SAP からデータを読み取り、ガイド付きのセットアップを提供します。SAP(カスタムソース)コネクターは、これらのコネクタータイプが利用可能になる前にセットアップされた既存の統合を対象としています。
SAP(カスタムソース)コネクターを使用するには、対象の SAP アプリケーションレイヤーに Palantir Foundry Connector 2.0 for SAP Applications アドオンをインストールする必要があります。
サポートされる機能
| 機能 | ステータス |
|---|---|
| 探索 | 🟢 一般提供 |
| バッチ同期 | 🟢 一般提供 |
| インクリメンタル(差分連携) | 🟢 一般提供 |
| ストリーミング同期 | 🟡 ベータ版 |
| Webhook | 🟢 一般提供 |
| 一括ライトバック | 🟢 一般提供 |
セットアップ
-
Data Connection アプリケーションを開き、画面右上の + 新規ソースを選択します。
-
カスタムソースを追加を選択します。
-
ソースの名前と場所を指定します。
-
カスタム YAML セクションに、ソース定義を入力します。
Copied!1 2 3type: magritte-sap-source url: https://<host>:<port>/sap/palantir usernamePassword: <username>:{{password}}<host>は SAP アプリケーションサーバーのホスト名です。<port>は Internet Communication Manager (ICM) の HTTPS(または HTTP)ポートです。- ユーザー名とパスワードは、コネクターのインストール時に Foundry 用に作成した技術ユーザーのものです。
{{password}}は表示どおりに正確に入力してください。保存後、ダイアログ右側の暗号化された値にパスワードの値を入力してください。 -
保存を選択します。
Foundry でのコネクターのセットアップについて詳しくはこちら。
ストリーミング同期を有効にする(SLT のみ)
ストリーミング同期をサポートするには、ソースに SLT 接続タイプを明示的に設定する必要があります。ソースの YAML に connectionType パラメーターを追加します。
Copied!1 2 3 4 5 6 7type: magritte-sap-source url: https://<host>:<port>/sap/palantir usernamePassword: <username>:{{password}} connectionType: type: slt slt: context: <context>
context の値は、SLT Replication Server とソース ERP システム間の RFC 接続の一意の識別子です。SLT の設定について詳しくはこちら。
SAP Data Accelerator 経由で接続する
既存の SAP(カスタムソース)接続を SAP Data Accelerator 経由にできます。これには、Foundry ワーカー、SAP 側のセットアップ、割り当て済みのクライアント証明書、およびコントロールプレーンとデータプレーンの両方のエグレスポリシーが必要です。SAP Data Accelerator のセットアップ手順に従って、これらの前提条件を設定してください。
ソースの YAML に、最上位のフィールドとして controlPlaneUrl と、必要に応じて locationId を追加します。
Copied!1 2 3 4 5type: magritte-sap-source url: https://<virtual-host>:<virtual-port>/sap/palantir usernamePassword: <username>:{{password}} controlPlaneUrl: https://<tenant>.sharing.hdl.<region>.hanacloud.ondemand.com locationId: <cloud-connector-location-id>
url のホストとポートを、SAP Cloud Connector でマッピングした仮想ホストと仮想ポートに設定します。SAP アドオンのエンドポイントパスと認証設定はそのままにします。controlPlaneUrl を SAP Data Accelerator のコントロールプレーン URL に設定します。この URL は HTTPS を使用する必要があります。同じ SAP Data Accelerator テナントに複数の Cloud Connector が登録されていて、その中から選択する必要がある場合を除き、locationId は省略します。
controlPlaneUrl を設定する前に、proxy フィールドがあれば削除します。SAP Data Accelerator とプロキシを同じソースに設定することはできません。controlPlaneUrl を省略した場合、ソースは既存の接続動作を維持します。
ソース設定
ソースでは、次のパラメーターを設定できます。
| パラメーター | 必須 | デフォルト | 説明 |
|---|---|---|---|
url | はい | SAP アドオンサービスのエンドポイントのベース URL です。SAP Data Accelerator を使用する場合は、SAP Cloud Connector でマッピングされた仮想ホストと仮想ポートを使用します。 | |
usernamePassword | はい | Foundry 用に作成した技術ユーザーのユーザー名とパスワードです。 | |
controlPlaneUrl | いいえ | なし | SAP Data Accelerator のコントロールプレーン URL です。HTTPS を使用する必要があります。この項目を設定すると、SAP Data Accelerator 接続が有効になります。proxy とは併用できません。既存の接続動作を維持するには、この項目を省略します。 |
locationId | いいえ | なし | controlPlaneUrl とともに使用する SAP Cloud Connector のロケーションIDです。同じ SAP Data Accelerator テナントに複数の Cloud Connector が登録されている場合にのみ必須です。 |
useKernelJsonSerialization | いいえ | false | ページ分割されたデータにカーネルの JSON シリアル化を使用します。useTsvFormat: true とは併用できません。 |
useTsvFormat | いいえ | false | ページ分割されたデータに JSON ではなく TSV 形式を使用します。 |
output | いいえ | 50,000行 | リクエストあたりの Parquet ファイルの最大サイズ(行数またはバイト数)です。同期ごとに上書きすることもできます。 |
convertDatesToStrings | いいえ | false | このソース配下のすべての同期で、すべての日付を文字列として取り込みます。 |
proxy | いいえ | なし | SAP に接続するためのプロキシ設定です。controlPlaneUrl とは併用できません。 |
cacheConfigurations | いいえ | なし | SAP オブジェクトタイプごとのキャッシュタイムアウト設定です。 |
ネットワークと接続
Foundry が SAP システムに接続できるように、エグレスポリシーを適切に設定してください。オンプレミスの SAP 環境では通常、トラフィックを正しくルーティングするために Agent プロキシポリシーが必要です。
多くの SAP システムではカスタム署名証明書を使用しており、初めて接続を設定するときに SSL ハンドシェイク例外が発生することがあります。システムから正しいカスタム証明書を取得し、ソースに追加してください。
ソース探索
ソースを作成したら、SAP Source Explorer を使用して対話的に探索します。
-
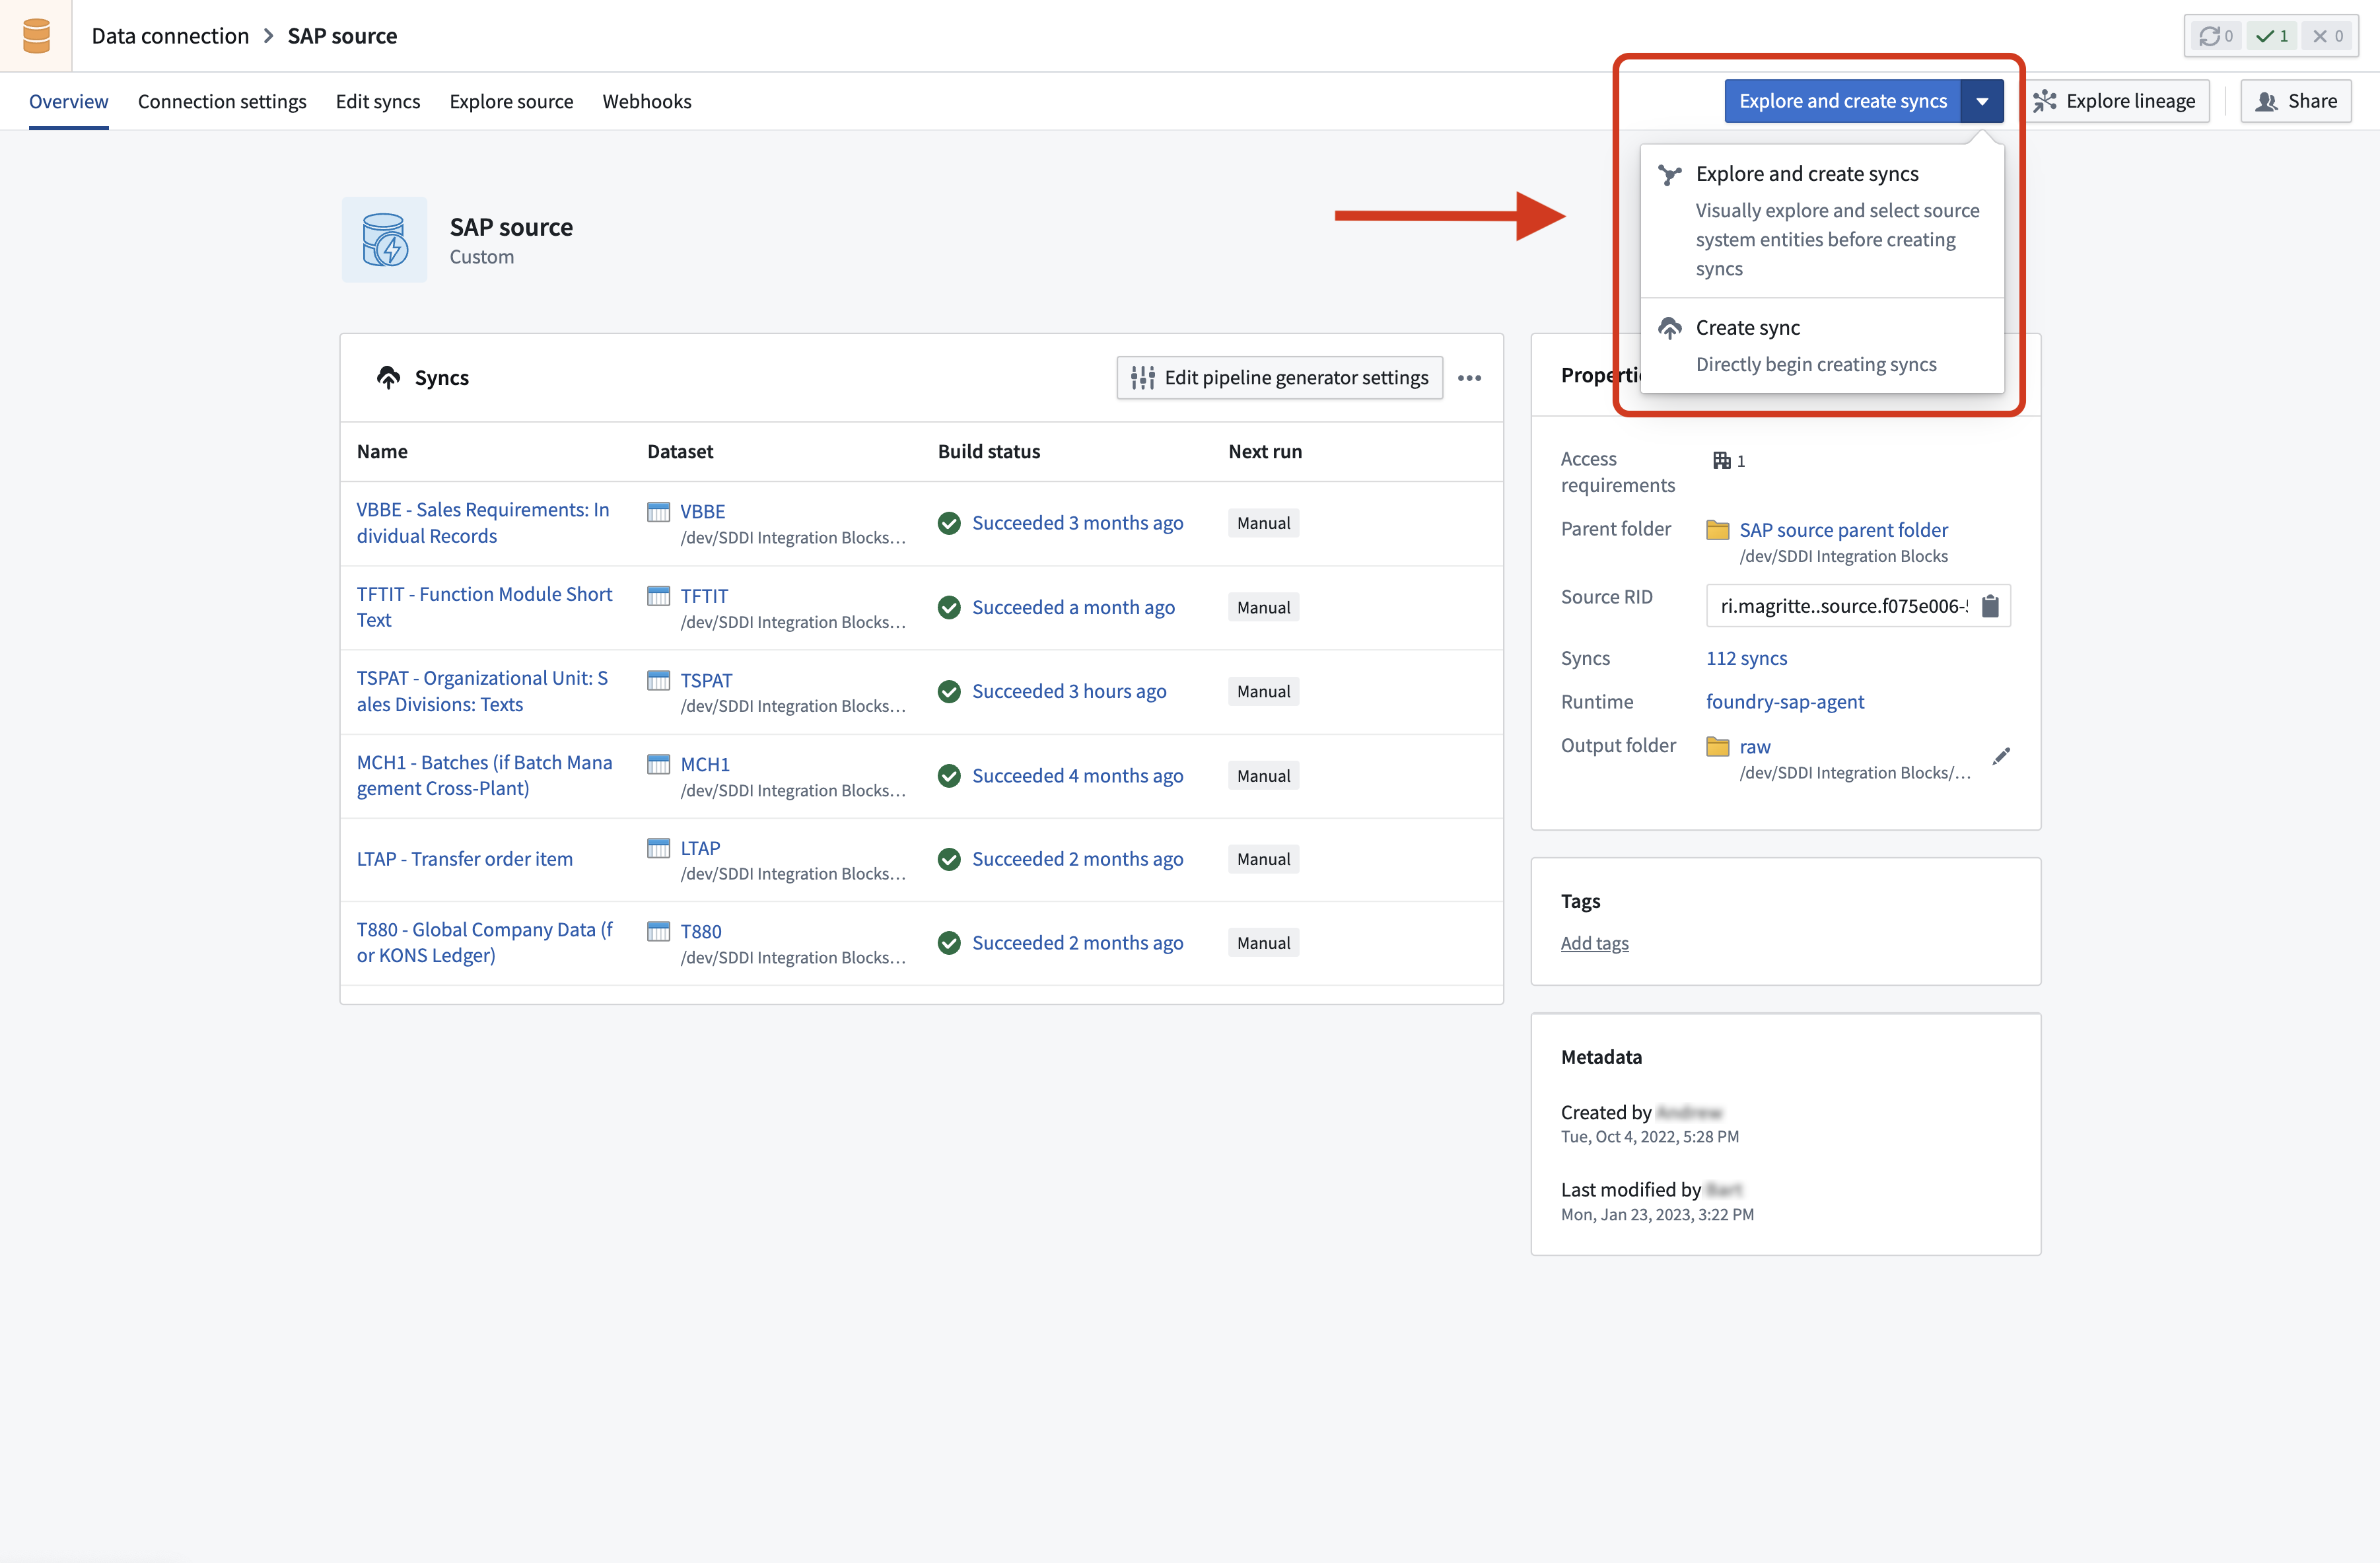
ソースに移動し、ソースを探索して同期を作成を選択します。
-
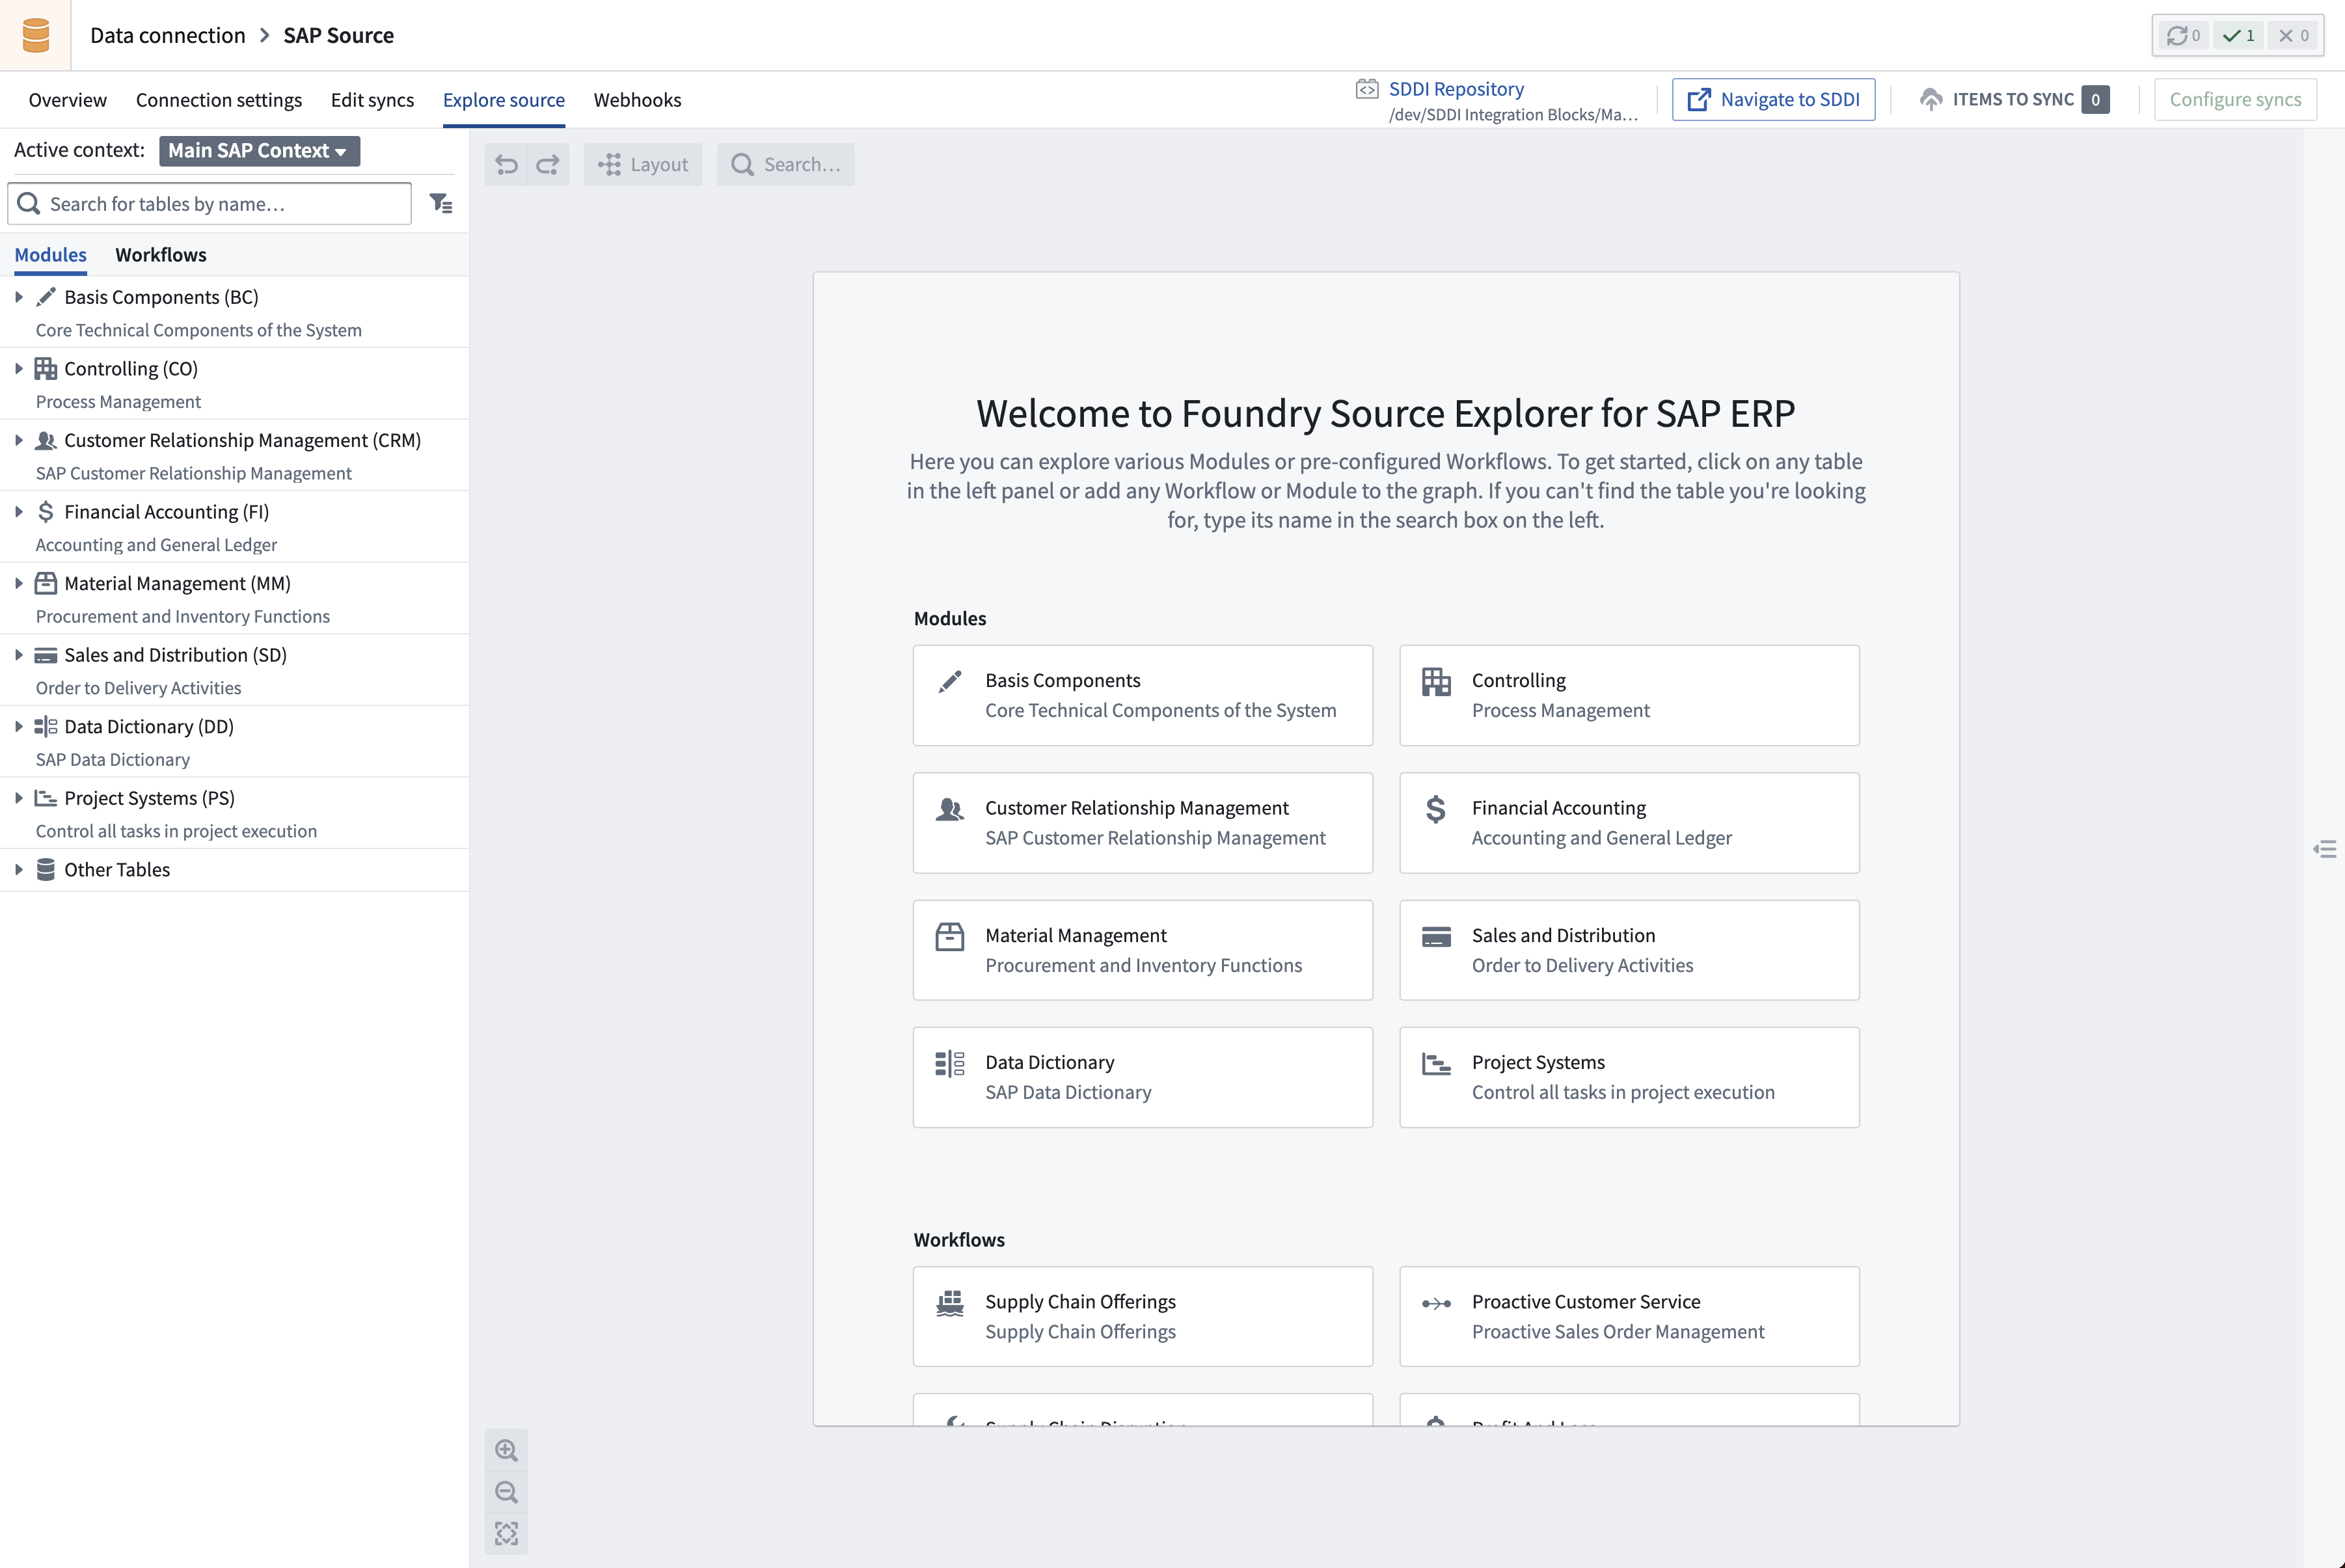
リモート接続および SLT 接続の場合は、適切なコンテキストを選択します。
-
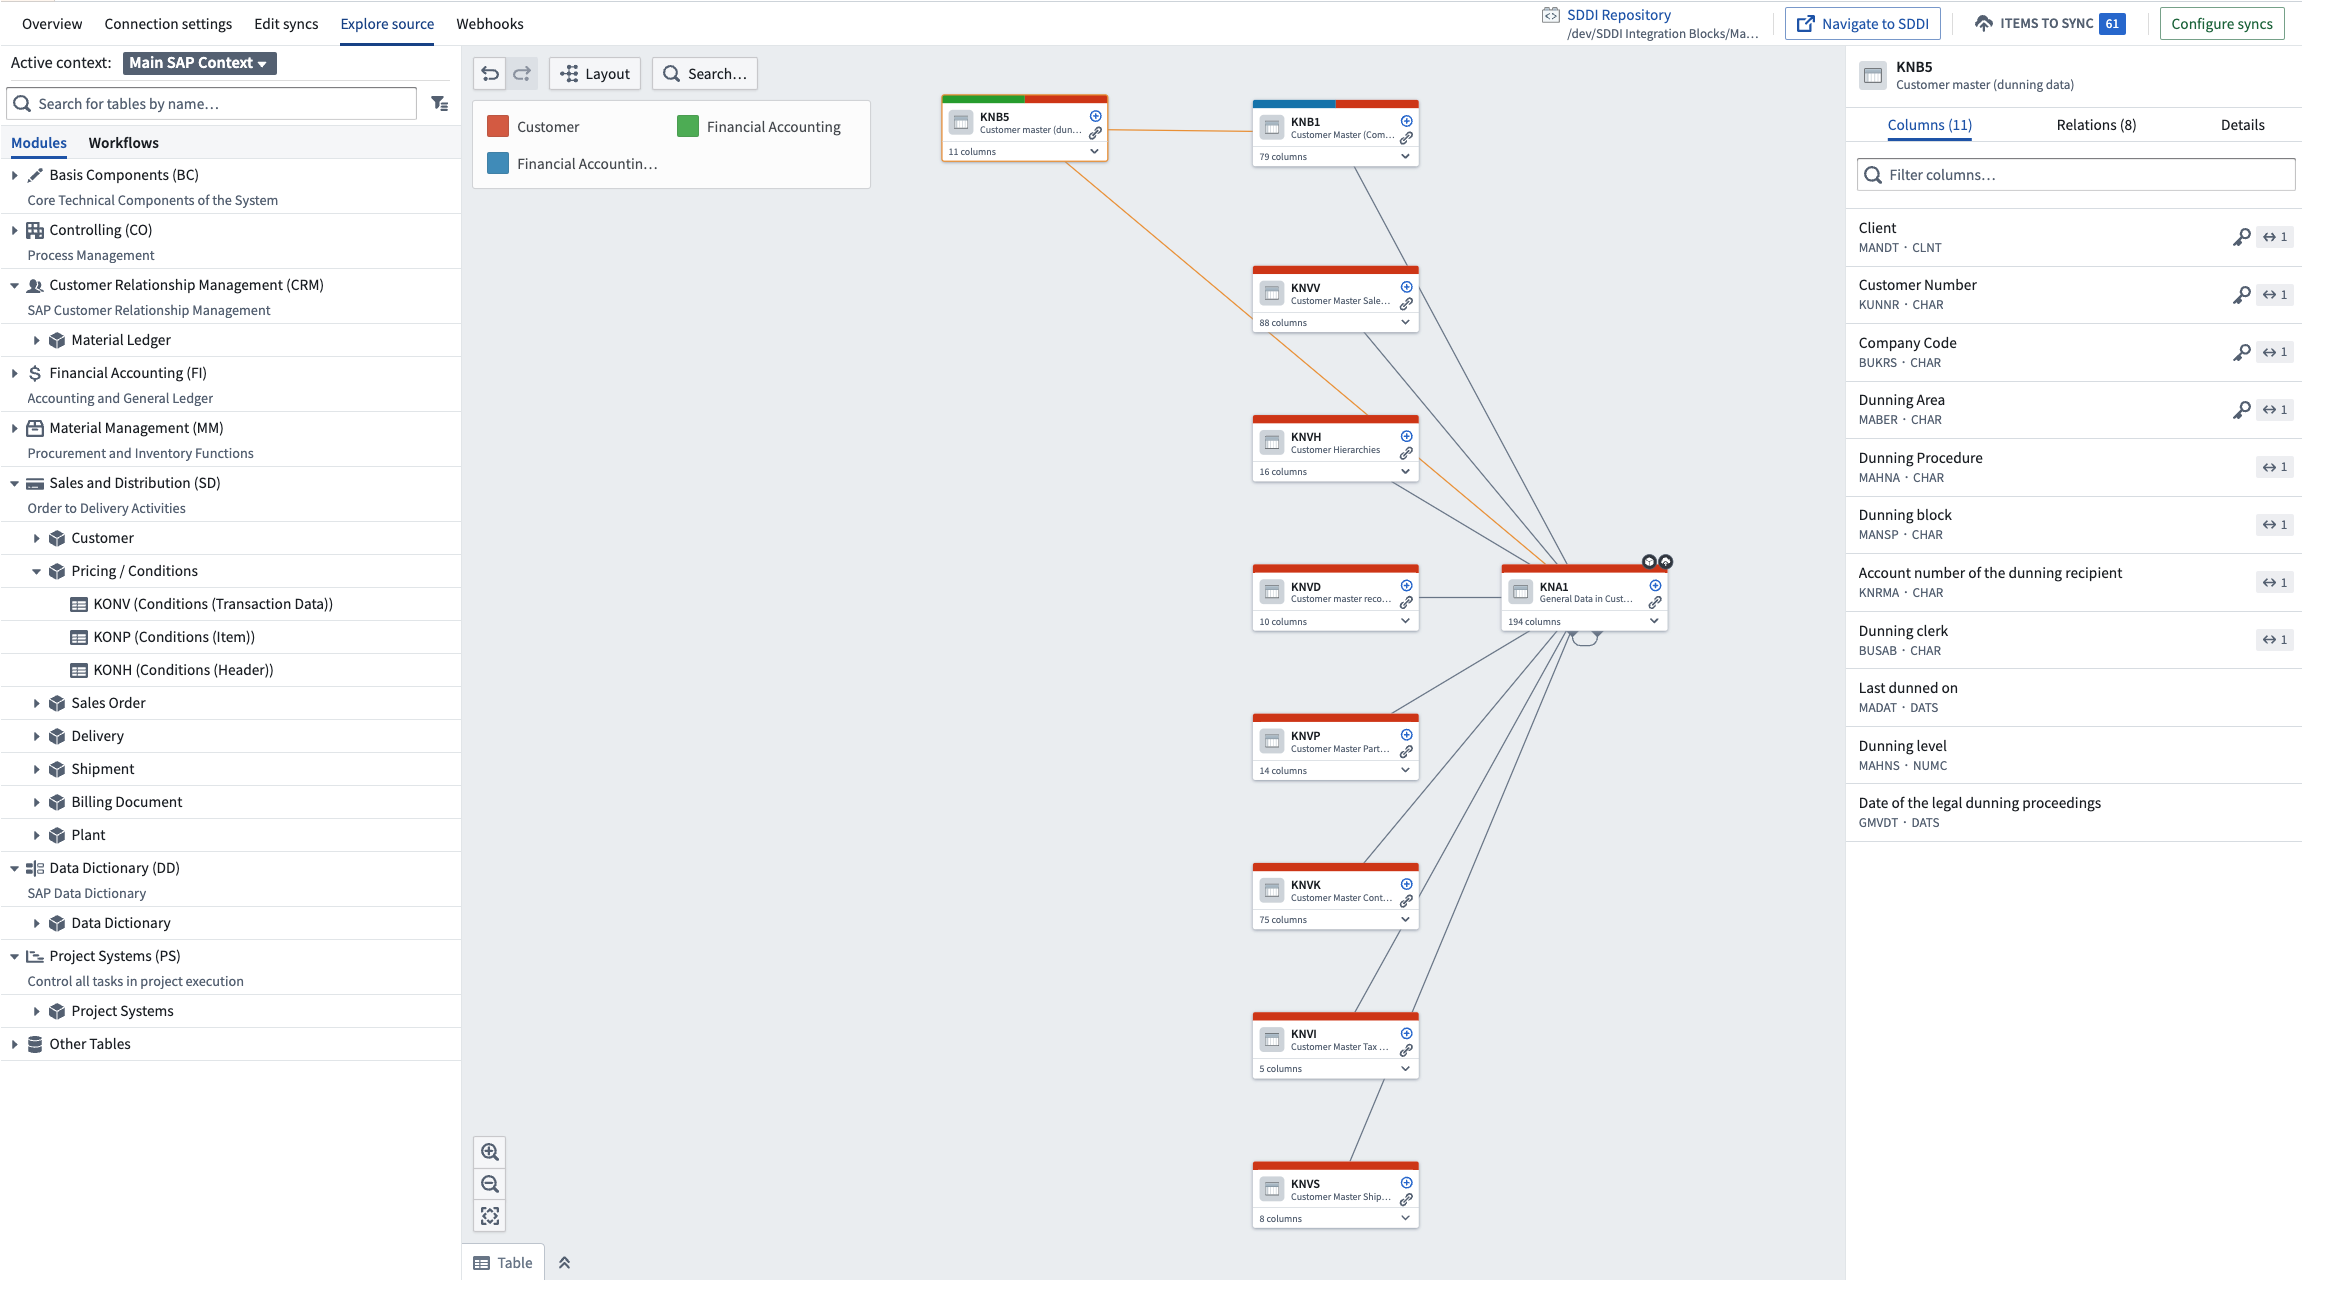
目的のテーブルまたはモジュールを選択し、グラフに追加します。
バッチ同期
同期を作成する
Foundry に抽出する SAP オブジェクトごとに同期を作成します。
同期設定 UI には、基本認証とアドバンスドの2つのモードがあります。アドバンスドタブでは同期定義全体が YAML として表示され、以下で説明する一部のオブジェクトタイプや設定パラメーターにはこのタブが必要です。基本認証の表示に戻ることもできますが、対応する UI がない YAML プロパティは表示されず、失われます。
- ソースの概要ページで、バッチ同期の横にある + 新規を選択します。
- 名前、対象データセット、スケジュールの標準設定を行います。
- トランザクションタイプを次のいずれかの選択肢に設定します。
- APPEND — インクリメンタル(差分)更新に使用します。詳細はインクリメンタル同期を参照してください。
- SNAPSHOT — フルロードに使用します。
- SAP オブジェクトタイプを選択します(以下の SAP オブジェクトタイプを参照)。
- SLT を使用する場合、またはリモートシステムに接続する場合は、コンテキストを選択します。コンテキストの詳細は、リモートエージェントをインストールするを参照してください。
- オブジェクト名を入力します。入力すると、選択した SAP オブジェクトタイプに基づいて、一致するオブジェクトが項目に候補として表示されます。
- インクリメンタル同期を設定する場合は、増分フィールドを指定します。
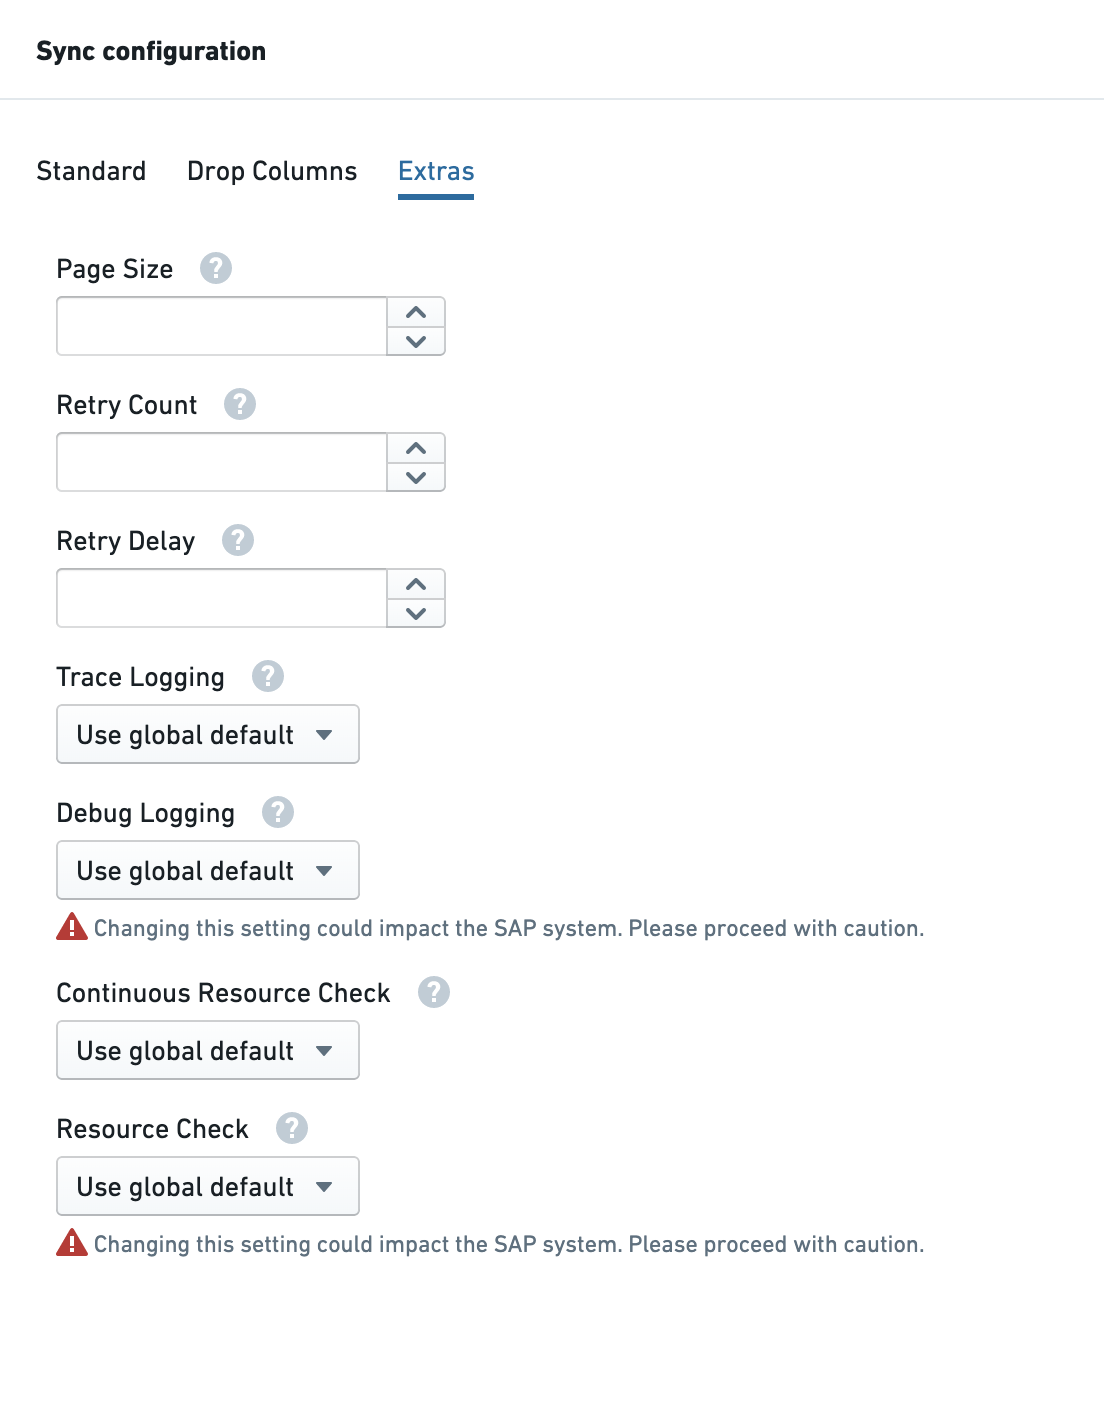
- 必要に応じて、追加設定タブで追加のパラメーターを設定します。
SAP オブジェクトタイプ
同期設定 UI の SAP オブジェクトタイプドロップダウンでは、次のオブジェクトタイプを利用できます。
| オブジェクトタイプ | 説明 |
|---|---|
| ERP テーブル | カスタムの Z* テーブルを含む、SAP ABAP データディクショナリ内の任意の ERP テーブルまたはビューからデータを抽出します。 |
| BW InfoProvider | BW InfoProvider(InfoCube、DataStore オブジェクト、または MultiProvider)からデータを抽出します。SAP BW のすべての権限コンセプトが継承されます。 |
| BW BEx クエリ | BW システムで BEx クエリを実行します。下記の BEx クエリの設定を参照してください。 |
| SLT | SLT Operational Delta Queue (ODQ) からデータを抽出します。SLT は、CDC メカニズムを組み込んだトリガーベースのレプリケーションツールです。コンテキストが必要です。 |
| BW コンテンツエクストラクター | ビジネスロジックと CDC メカニズムを組み込んだ、すぐに使用できる構造である ERP Business Content エクストラクターを実行します。デルタ抽出に対応するエクストラクターには APPEND を使用します。エクストラクターを設定するを参照してください。 |
| 関数 | ERP または BW システムで、リモート対応の関数または BAPI を実行します。下記の関数の設定を参照してください。 |
| ERP テーブルデータモデル | 主キー/外部キーモデルに基づいて、ERP テーブル間の関係を読み取ります。depth パラメーターを使用して、関係をたどる階層数を制御します。 |
| リモート ERP テーブル | リモート ERP システムの ERP テーブルからデータを抽出します。リモートシステムを識別するためのコンテキストが必要です。 |
| リモート BW InfoProvider | リモート BW システムの BW InfoProvider からデータを抽出します。コンテキストが必要です。 |
| リモート BW BEx クエリ | リモート BW システムで BEx クエリを実行します。コンテキストが必要です。 |
| リモート関数 | リモート ERP または BW システムで、リモート対応の関数を実行します。コンテキストが必要です。 |
| トランザクションコード | ABAP List Viewer (ALV) を使用して SAP レポートからデータを抽出します。詳細タブでのみ利用できます。 |
| HANA ビュー | SAP アプリケーション層で有効化された HANA ビューからデータを抽出します。詳細タブでのみ利用できます。 |
| CDS ビュー | ABAP CDS (Core Data Services) ビューからデータを抽出します。詳細タブでのみ利用できます。 |
リモートオブジェクトタイプには、リモートシステムを識別するコンテキストの値が必要です。リモート接続について詳しくはこちら。
BEx クエリの設定
BEx は、SAP BW InfoProvider 上に構築された多次元クエリフレームワークです。BEx クエリは標準の SAP BW アクセスメソッドを使用し、SAP BW のすべての権限コンセプトを継承します。BEx クエリは、InfoProvider ビューに適用されたビジネスロジックを表します。
BEx クエリに動的な列(キー数値を含む列に特性があり、すべてのキー数値がその特性値とともに繰り返されるもの)がある場合、出力が動的になります。Foundry は動的な列に対応していないため、それに合わせてクエリを調整してください。
オブジェクトタイプとして BW BEx クエリを選択すると、同期エディターに次のオプションを備えた専用の BEx クエリビルダーが表示されます。
| オプション | 説明 |
|---|---|
| 技術名を使用 | 技術名と、人が読みやすい(言語に依存する)列名を切り替えます。 |
| 列を削除 | 出力からキー特性を削除します。 |
| 自由特性 | BEx クエリで定義された自由特性を出力に追加します。 |
| フィルター | クエリの実行後にデータを絞り込みます(クエリ後フィルター)。 |
| BEx クエリ入力変数 | BEx クエリの入力変数にフィルター値を指定します。 |
BEx のページング設定については、同期パラメーターのセクションにある高度な YAML パラメーターを参照してください。
関数の設定
SAP 汎用モジュールは、SAP システムからのデータ抽出と SAP システムへのデータ書き戻しの両方を実行できます。コネクターでデータを抽出できるのは、テーブル形式の出力パラメーターが1つ以上ある関数のみです。
関数の結果を抽出するには、Foundry の技術ユーザーに次の権限ロールが必要です。
/PALANTIR/SERVICE_USER/PALANTIR/CONTENT_FUNCTION_ALL- 特定の関数を実行するために必要な権限ロールまたはオブジェクト
関数が複数の出力パラメーターを返す場合は、paramName パラメーターを使用して、Foundry データセットに書き込む出力を指定します。
Copied!1 2 3 4type: magritte-sap-source-adapter sapType: function obj: BAPI_USER_GETLIST paramName: USERLIST
入力パラメーターは inputParams を使用して設定できます。3種類の値に対応しています。
| 種類 | YAML 構文 |
|---|---|
| 単一の値 | PARAM_NAME: 'value' |
| 構造(辞書) | PARAM_NAME: '{"FIELD1": "value1", "FIELD2": "value2"}' |
| テーブル(辞書のリスト) | PARAM_NAME: '[{"FIELD1": "value1"}, {"FIELD1": "value2"}]' |
テーブル型の入力パラメーターを使用する例:
Copied!1 2 3 4 5 6type: magritte-sap-source-adapter sapType: function obj: EM_GET_NUMBER_OF_ENTRIES inputParams: IT_TABLES: '[{"TABNAME":"TSTC"}]' paramName: IT_TABLES
アドバンスドでのみ設定可能なオブジェクトタイプ
次のオブジェクトタイプはドロップダウンから選択できず、アドバンスドタブで設定する必要があります。
トランザクションコード
SAP レポートによって生成されたデータを抽出します。ABAP List Viewer (ALV) を使用するレポートにのみ対応しています。
トランザクションコード名による指定:
Copied!1 2 3type: magritte-sap-source-adapter sapType: tcode obj: ZTEST_ALV
プログラム名による指定:
Copied!1 2 3 4type: magritte-sap-source-adapter sapType: tcode obj: RSUSR200 programType: program
次の任意のパラメーターを同期 YAML に追加できます。
| パラメーター | 説明 |
|---|---|
filter | 選択画面の変数にユーザー入力を渡します。出力フィールドを任意に絞り込むものではありません。 |
selectionVariant | 定義済みの選択画面バリアントを渡します。filter と併用すると、対応するバリアントの値が filter の値で上書きされます。 |
outputVariant | プログラムのレイアウト名を渡します。SAP の選択画面でレイアウトパラメーターが定義されているプログラムでのみ利用できます。 |
ingestionType: spool | 取り込みの前に、レポート出力をプリンターキューに送信します。SAP の内部テーブルの上限を超える大規模なレポートに推奨します。設定すると、すべての列が String 型として取り込まれます。 |
HANA ビュー
SAP アプリケーション層で有効になっている HANA ビューからデータを抽出します。前提条件については、SAP から HANA ビューを取り込むを参照してください。
新しい統合には、SAP ERP コネクターを使用します。このコネクターでは、同期設定 UI で HANA ビューをオブジェクトタイプとして選択できます。
Copied!1 2 3type: magritte-sap-source-adapter sapType: hanaview obj: ZEXT_SBOOK
CDS ビュー
ABAP CDS (Core Data Services) ビューからデータを抽出します。ABAP CDS は、アプリケーションサーバーの中央データベース上でセマンティックデータモデルを定義します。
パラメーター化された CDS ビューからのデータ抽出には、現在対応していません。
API バージョン(SLT のみ)
SLT SAP オブジェクトタイプを使用するバッチ同期は、同期エディターの API バージョンカードで選択する次の2つの API のいずれかを通じてデータを抽出します。
- OData: SAP の OData による ODP ベースのデータ抽出 ↗を使用します。
PALODATAコンポーネントを含む SAP アドオンバージョン2.34 (SP34) 以降、および SAP_BASIS 7.50 SP09 以降が必要です。SP39 Fix Pack 4 以降を推奨します。アドバンスドタブでは、この選択はisOdata: trueとして表示されます。 - ODP: RFC 経由の SAP ODP Data Replication API (ODP-RFC) を使用します。
SAP Note 3255746 ↗ に記載されているとおり、SAP は ODP-RFC API へのアクセスを制限しています。未承認の ODP-RFC 呼び出しを拒否する SAP のセキュリティパッチが SAP システムに適用されると、ODP API を使用する SLT 同期は失敗します。これらの同期を OData に移行してください。
OData 同期にはコンテキストが必要です。増分フィールドとしては pointer のみに対応しており、filter などの一部のレガシー設定には対応していません。OData を使用して新しい SLT 同期を作成する場合、または既存の SLT 同期をそのまま移行する場合は、SAP SLT 同期に OData を使用するに沿って進めてください。このガイドには、SAP(カスタムソース)の設定要件も記載されています。
ほかの SAP オブジェクトタイプはこの設定を使用しません。
インクリメンタル(差分)同期
インクリメンタル同期は、同じテーブルから APPEND 形式のトランザクションを作成できる、状態を保持する同期です。インクリメンタル同期を有効にするには、トランザクションタイプを APPEND に設定します。
次のインクリメンタルの種類を利用できます。
| インクリメンタル(差分連携)の種類 | 説明 |
|---|---|
| 単一フィールド | 単一のフィールドの値が、すでにインポートされた最大値以上である行をインポートします。 |
| 複数フィールド | 単一フィールドと同じですが、複数のフィールドを OR 演算子で組み合わせます。「作成日時」と「最終更新日時」の両方のタイムスタンプフィールドが存在する場合に便利です。フィールドはカンマで区切ります。 |
| フィールドを連結 | 複数フィールドと同じですが、OR で組み合わせる代わりにフィールドを連結します。「最終更新日」と「最終更新時刻」のフィールドが別々に存在する場合に便利です。 |
| 変更文書テーブルを使用 | SAP の変更文書テーブル(CDHDR および CDPOS)の更新に基づいて行をインポートします。対象テーブルに単調増加するフィールドがない場合に便利です。一部のオブジェクトでは、挿入がキャプチャされない場合があります。 |
| ツインテーブルまたは twinjoin テーブルを使用 | 別の「ツイン」テーブル内のフィールドがインクリメンタル条件を満たすと、対象テーブルから行をインポートします。twinjoin テーブルを使用すると、複数のテーブルを結合したものを対象にできます。 |
次のテーブルは、オブジェクトタイプごとに対応しているインクリメンタルの種類を示しています。
| オブジェクトタイプ | 単一フィールド | 複数フィールド | フィールドを連結 | 変更文書テーブル | ツインテーブル | SAP 組み込み | レプリケーション | リクエストベース |
|---|---|---|---|---|---|---|---|---|
| テーブル | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ||
| リモートテーブル | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ||
| InfoProvider | ✓ | ✓ | ✓ | |||||
| リモート InfoProvider | ✓ | ✓ | ✓ | |||||
| SLT | ✓ | |||||||
| エクストラクター | ✓ |
BEx クエリと関数はインクリメンタル更新に対応していません。これらのオブジェクトタイプの同期は、すべて全件抽出になります。
インクリメンタルフィールドには、単調増加する値を使用することが理想的です。システムは「以上」の比較を使用し、特定の日付の途中で同期が実行された場合でもデータの欠落を防ぎます。その結果、Foundry データセットに重複する値が現れる可能性があるため、変換パイプラインの最初のステップで削除する必要があります。
テーブル型のインクリメンタル同期では、maxRowsPerSync 設定(詳細設定タブで設定)を使用して、1回の実行で返されるおおよその行数に上限を設定します。これは、ネットワーク障害などの断続的な問題により長時間の同期が中断される可能性がある場合に、大きなテーブルの初回同期を、障害に強い小規模な実行に分割するのに役立ちます。設定の詳細については、詳細 YAML パラメーターを参照してください。
ツインテーブルの設定
インクリメンタルツインテーブル設定では、ツインテーブルを指定します。インクリメンタルツインマッピング設定では、主要テーブルとツインテーブルの結合条件を定義します。
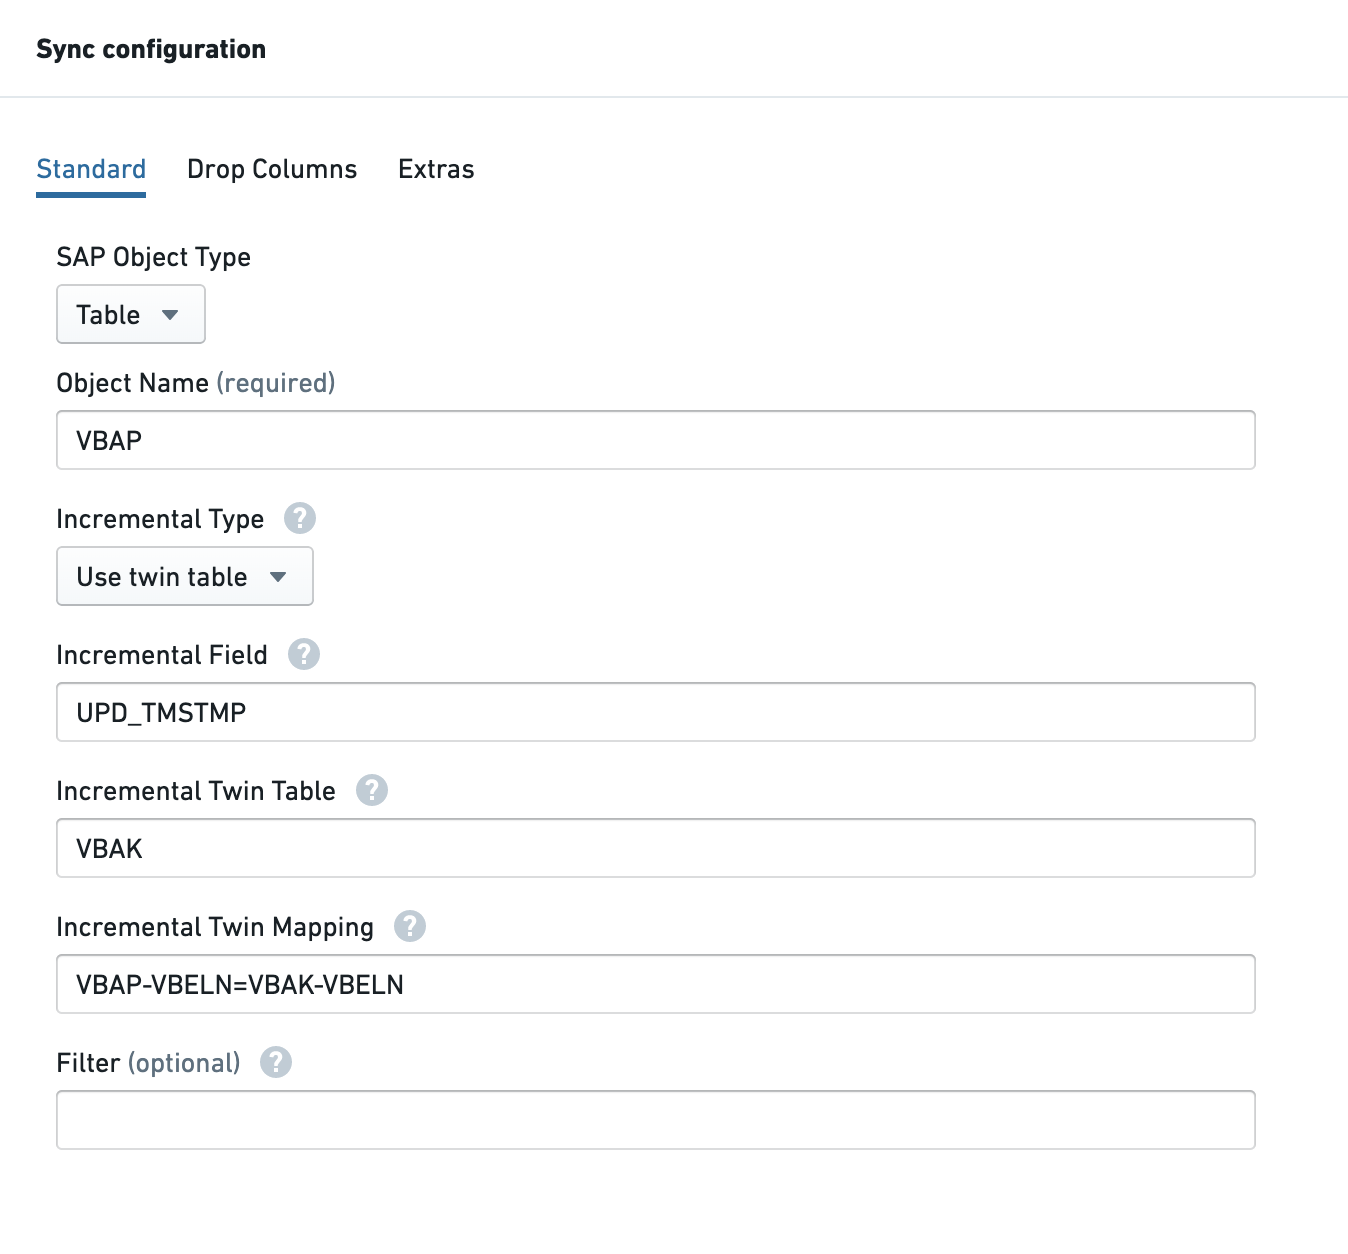
マッピング構文:
{PRIMARY_TABLE_NAME}-{FIELD_NAME}={TWIN_TABLE_NAME}-{FIELD_NAME}
複数の結合条件は、セミコロン(AND 演算子)で組み合わせることができます。
InfoProvider 向けのリクエストベースのインクリメンタル(差分連携)
SAP BW では、DSO と InfoCube はデータ転送プロセス (DTP) を使用して読み込まれます。各 DTP は読み込みリクエストを作成し、コネクターはこれらのリクエストを使用して変更されたデータを取得します。
この機能は、圧縮されていないリクエストにのみ対応しています。Foundry に読み込む前にリクエストを圧縮しないでください。読み込み前にリクエストを圧縮すると、同期が失敗し、初回の読み込みをやり直す必要があります。
詳細設定タブで設定します。
Copied!1 2 3 4type: magritte-sap-source-adapter sapType: infoprovider obj: <technical-name-of-infoprovider> incrementalType: REQUEST
インクリメンタル状態をリセットする
フルロードを強制的に実行し、インクリメンタル取り込みを再初期化するには、同期に任意のプロパティであるインクリメンタル状態のリセットを追加し、オンにします。Foundry はトランザクションタイプを SNAPSHOT に設定し、インクリメンタル設定をロックします。同期を1回実行してから、インクリメンタル状態のリセットをオフにすると、トランザクションタイプが APPEND に戻ります。
任意のプロパティであるインクリメンタル状態のリセットを利用できない場合は、代わりに詳細設定タブを使用します。
- 同期設定で詳細設定タブに切り替えます。
- YAML に
resetIncrementalState: trueを追加します。 - トランザクションタイプを SNAPSHOT に設定します(
incremental*パラメーターはそのまま保持します)。 - 同期を実行します。これにより完全なスナップショットが作成され、データセット内のすべてのファイルが置き換えられます。
- YAML から
resetIncrementalState: trueを削除します。 - トランザクションタイプを APPEND に戻します。
以降の同期では、通常どおりインクリメンタルな追加が再開されます。
同期パラメーター
次のパラメーターは、追加設定タブまたは詳細設定の YAML ビューで利用できます。
一般パラメーター
| パラメーター | 適用対象 | 説明 |
|---|---|---|
| 列を削除 | ERP テーブル、リモート ERP テーブル | 抽出前に、選択した列を除外します。パフォーマンスが向上し、機密フィールドや不要なフィールドの取り込みを防ぎます。 |
| タイムスタンプ | すべて | /PALANTIR/TIMESTAMP(同期の実行時刻)列と /PALANTIR/ROWNO(同期内のレコード順序)列を追加します。下流でレコードを重複排除する際に便利です。/PALANTIR/ROWNO は、SLT または CDPOS/CDHDR のインクリメンタルモードを使用する場合にのみ意味を持ち、値が大きいほど新しい変更を示します。 |
| ページサイズ | すべて | ページごとに返される行数です。デフォルトは50,000です。デフォルト未満の値を指定しても効果はありません。デフォルトを引き下げるには、SAP アドオンへのシステムコールが必要です。 |
| 再試行回数 | すべて | リソース不足によりリクエストが失敗した場合の再試行回数です。 |
| 再試行の待機時間 | すべて | 再試行の間隔(秒)。 |
| パラメーター名 | 関数 | 関数が複数の出力パラメーターを返す場合に、Foundry データセットに書き込む出力テーブルを選択します。 |
| 深さ | ERP テーブルデータモデル | たどるリレーションシップの階層数です。1次には 1、2次には 2 のように指定します。 |
| トレースログ | すべて | On に設定すると、この同期のトレースログが有効になります。 |
| 取得オプション | SLT | XML は圧縮データを使用して取得します(高速)。Direct は文字列として取得します。XML でデータ内容のエラーが発生する場合は、Direct を使用します。 |
| デバッグログ | すべて | デバッグログを有効にします。同期の実行中は SAP でバックグラウンドプロセスが起動するため、リソースを消耗する可能性があります。慎重に使用してください。 |
| 継続的なリソースチェック | すべて | すべてのページングリクエストをリソースチェックの対象にするか、最初のリクエストのみを対象にするかを制御します。 |
| リソースチェック | すべて | 無効にすると、すべてのリソースチェックが行われなくなります。SAP に過剰な負荷がかかる可能性があります。慎重に使用してください。 |
| フィルター | すべて | SAP フィールドの値と演算子を使用して、抽出したデータを絞り込みます。動的フィルターキーワードに対応しています。 |
| 詳細 YAML パラメーター | 場合による | maxRowsPerSync, bexSettings, ignoreUnexpectedValues, outputSettingsOverride. |
デバッグログ
デバッグログを有効にすると、同期中に実行されるバックグラウンドプロセスが SAP システムで開始されます。これによりリソースが消費され、ほかのユーザーに影響する可能性があります。慎重に使用してください。
この同期のデバッグログを有効にするには、オンに設定します。
継続的なリソースチェック
オンの場合、すべてのページングリクエストでリソースチェック(メモリー、CPU)が行われます。オフの場合、最初のページリクエストのみがチェックされます。詳細については、パフォーマンスパラメーターを参照してください。
リソースチェック
リソースチェックを無効にすると、利用可能なメモリー、CPU、プロセスに関係なく同期が実行されます。これにより、SAP システムに過剰な負荷がかかる可能性があります。慎重に使用してください。
この同期のすべてのリソースチェックを無効にするには、オフに設定します。
フィルター
SAP から抽出するデータを絞り込みます。すべてのフィールド名は、データディクショナリと一致する必要があります。
| 演算子 | 意味 |
|---|---|
, | OR |
; | AND |
: | 範囲内 |
= | 等しい |
!= | 等しくない |
>, >=, <, <= | 比較 |
* | ワイルドカード |
例:
- 価格が500から650の間:
PRICE=500:650 - 得意先が A、B、または C:
CUSTOMER=A,B,C - 価格が500から650の間、かつ得意先が A、B、または C:
PRICE=500:650;CUSTOMER=A,B,C - 品目が PAL、DIS、または SAP で始まる:
MATERIAL=PAL*,DIS*,SAP* - 日付が2019年8月9日以降(形式は YYYYMMDD):
DATE>=20190809
動的フィルター
動的フィルターは、特殊なキーワードと関数を使用して、より柔軟なフィルター式を作成します。アドオンバージョン SP26 以降で利用できます。
固定キーワード
| キーワード | 説明 |
|---|---|
[CURRENTYEAR] | 現在の年(YYYY 形式)。 |
[TODAY] | 今日の日付(YYYYMMDD 形式)。 |
[LASTDAYOFMONTH] | 今月の末日(YYYYMMDD 形式)。 |
[LASTDAYOFLASTMONTH] | 先月の末日(YYYYMMDD 形式)。 |
[FIRSTDAYOFMONTH] | 今月の初日(YYYYMMDD 形式)。 |
[FIRSTDAYOFLASTMONTH] | 先月の初日(YYYYMMDD 形式)。 |
日付計算関数
| 関数 | 説明 |
|---|---|
[ADDDAY] | 選択した日付に日数を足し合わせます。例:[ADDDAY(22102022,1)] → 23102022。 |
[ADDMONTH] | 選択した日付に月数を足し合わせます。 |
[ADDYEAR] | 選択した日付に年数を足し合わせます。 |
[GETMONTH] | 選択した日付の月を2桁の値(01–12)で返します。 |
[GETDAY] | 月内の日を2桁の値で返します。 |
[GETYEAR] | 選択した日付の年を返します。 |
関数は固定キーワードと直接組み合わせて使用することも、入れ子にして使用することもできます。
- 単一の関数:
[ADDDAY([TODAY], 1)] - 入れ子:
[GETDAY([ADDDAY([FIRSTDAYOFMONTH], -1)])]
例:
- 今日より後のレコード:
BUDAT>[TODAY] - 前月の末日より後のレコード:
BUDAT>[ADDDAY([FIRSTDAYOFMONTH], -1)]
詳細 YAML パラメーター
次のパラメーターには詳細設定タブが必要で、基本ビューに対応する設定はありません。
maxRowsPerSync(SLT およびテーブル型のインクリメンタル同期):1回の同期実行で返される行数に上限を設定します(概数)。非常に大きなテーブルの初回同期を小規模な実行に分割するのに役立ちます。
Copied!1maxRowsPerSync: 500000
bexSettings(BEx のみ):BEx クエリのページングを設定します。コネクターのバージョン SP22 以降で利用できます。
Copied!1 2 3bexSettings: bexPaging: true bexMemberLimit: 10
bexPaging:自動生成されたフィルターを使用したページングを有効にします。デフォルトはfalseです。bexMemberLimit:フィルター候補を選択するためのしきい値です。この値より多くのメンバーを持つ InfoObject は、フィルター生成の対象から除かれます。デフォルトは200です。最小値は2です。
-ignoreUnexpectedValues:同期が Unexpected value encountered in SAP data Failed to parse value XXX in field YYY で失敗する場合、日付または数値をパースできません。同期を続行し、パースできない値を null に設定するには、次のように設定します。
Copied!1ignoreUnexpectedValues: true
同期の終了時に、パース例外の概要を含む警告がログに記録されます。
この設定には、基本ビューに対応する設定がありません。基本ビューに戻すと、この設定は失われます。
-outputSettingsOverride:特定の同期について、ソースレベルの Parquet ファイルサイズ設定を上書きします。
Copied!1 2 3 4 5outputSettingsOverride: maxFileSize: type: rows rows: max: 10000
Copied!1 2 3 4 5outputSettingsOverride: maxFileSize: type: bytes bytes: approximateMax: 400MB
バイト単位で指定する最大サイズは概数であり、生成されるファイルサイズは多少小さくなったり大きくなったりする可能性があります。バイト値は、Parquet ライターのメモリー内バッファーサイズの少なくとも2倍である必要があります。このバッファーサイズのデフォルトは 128 MB です。
ストリーミング同期
SAP からのストリーミング同期は開発のベータ版段階にあり、お使いのエンロールメントでは利用できない場合があります。開発が進行している間は、機能が変更される可能性があります。
ストリーミング同期は、SAP SLT Replication Server 経由の接続でのみサポートされており、接続タイプとして SLT を明示的に設定したソースが必要です(上記のストリーミング同期を有効にするを参照)。
各ストリーミング同期は、SLT Replication Server 内に専用の Operational Delta Queue (ODQ) を作成し、購読します。Foundry はキューを定期的にポーリングします(デフォルトの間隔:1秒)。
- キューが空の場合、次のポーリングまで追加のリクエストは行われません。
- キュー内のレコードが50,000件以下の場合、同期的に消費されます。
- レコードが50,000件を超える場合、ページ単位で消費されます。
遅延を最小限に抑えるには、SLT Replication Server で利用可能なダイアログワークプロセス数を、少なくともアクティブなストリーミング同期の数と同じにする必要があります。
ストリーミング同期を作成する
-
SAP ソースを開きます。概要ページで、ストリーミング同期テーブルまで下にスクロールし、+ ストリーミング同期を作成を選択します。

-
ストリーミングする SAP テーブルの名前を入力します。
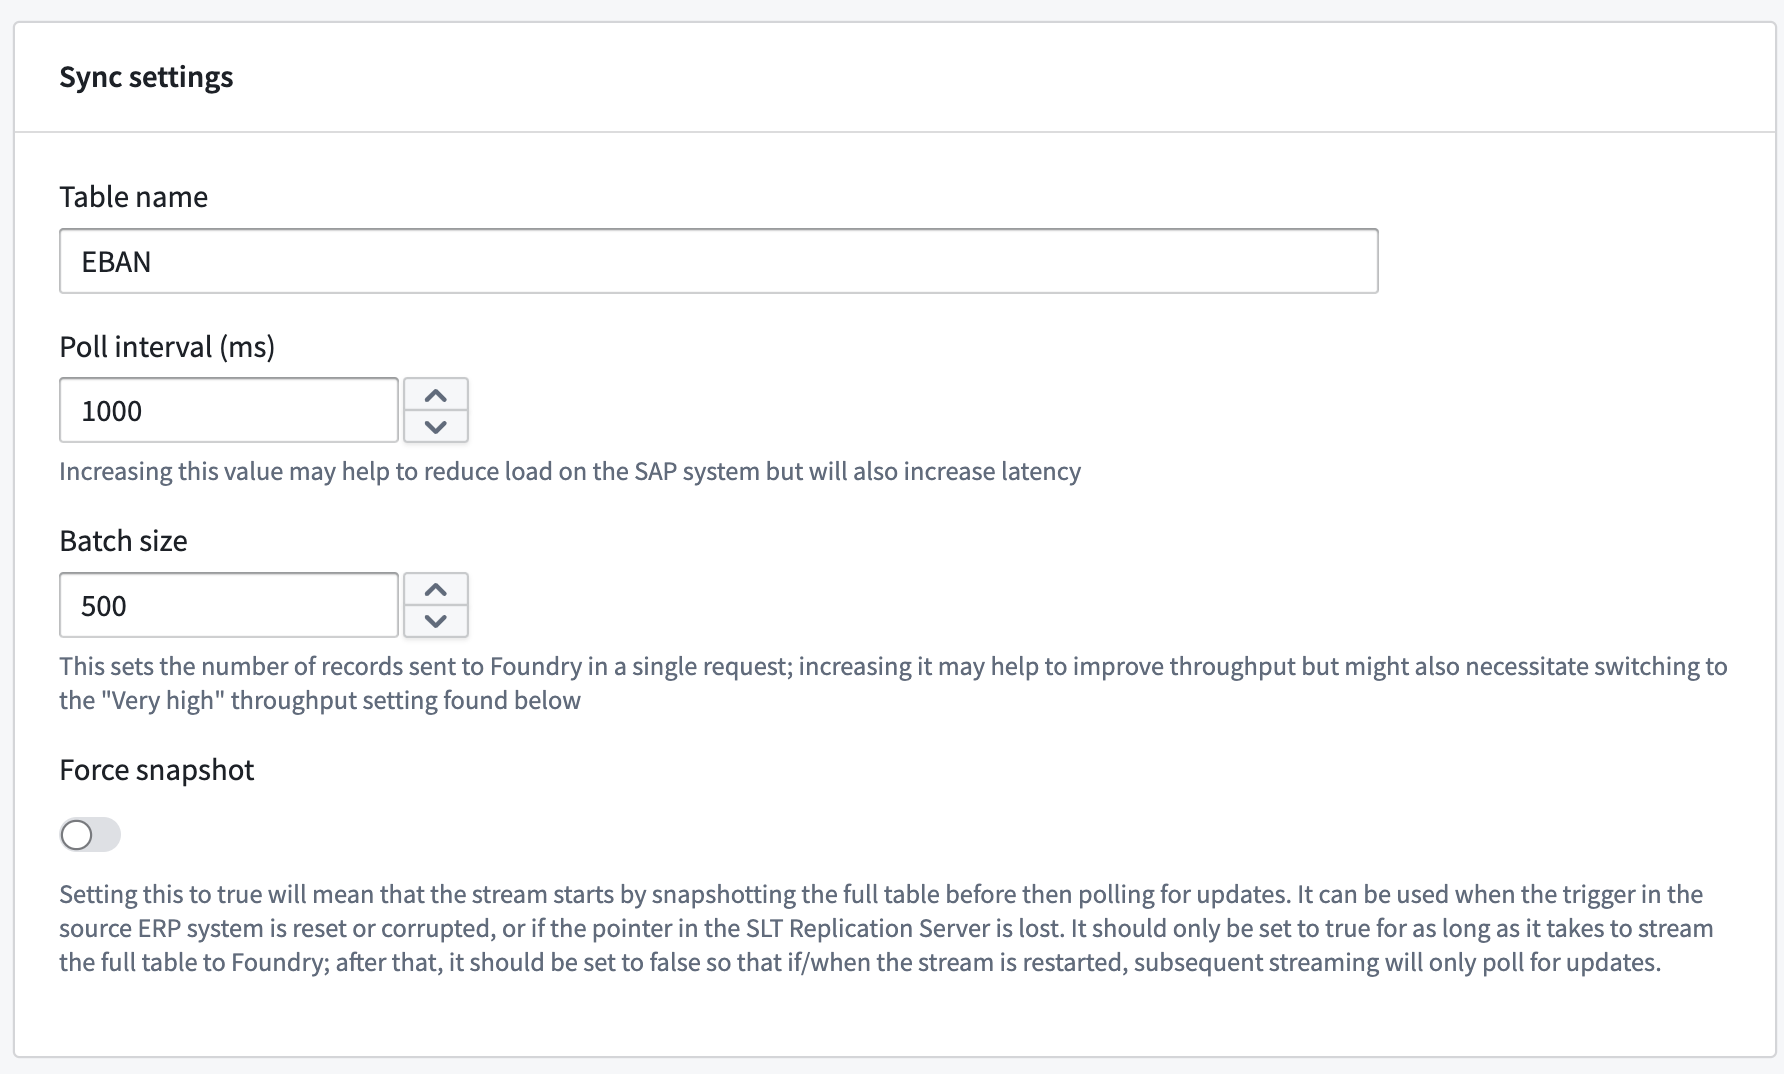
-
API バージョンで、OData を選択します。下記のストリーミング同期の API バージョンを参照してください。
-
出力ストリーミングデータセットの場所を選択します。
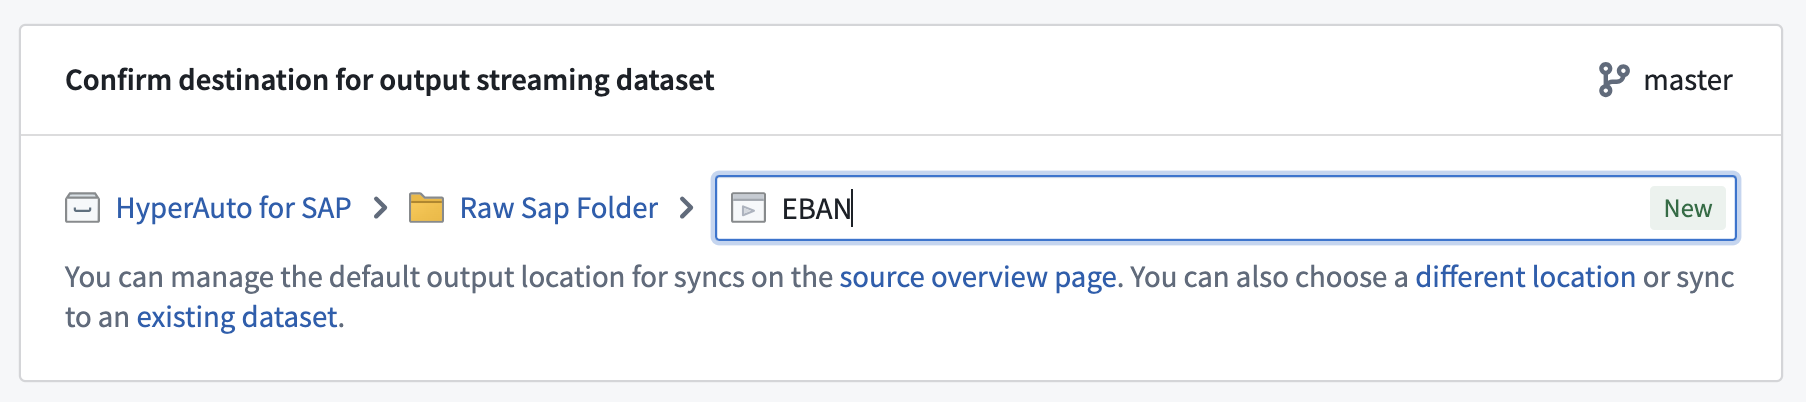
続行する前に、画面下部のプレビューペインの読み込みが完了していることを確認してください。ストリーミングデータセットのスキーマは、このプレビューから生成されます。場合によっては、プレビューにデータが表示されず、スキーマのみが表示されることがありますが、それで十分です。
-
ストリーミング同期を作成を選択します。ストリームをすぐに開始するか、作成後に手動で開始するかを選択できます。
Data Connection Agent または SAP システムのダウンタイム後にストリームが自動的に再起動するようにするには、ストリーミングデータセットに1分間隔の時間トリガーでスケジュールを設定します。
ストリーミング同期の API バージョン
ストリーミング同期では、OData または ODP API を使用できます。ストリーミング同期エディターの API バージョンカードで選択します。アドオンが OData をサポートしている場合、新しいストリームのデフォルトは OData です。OData API の SAP 側の前提条件は、バッチ同期と同じです。
ストリーミング同期エディターには、次の設定もあります。
- スナップショットの強制: 変更のポーリングを開始する前に、テーブル全体を初回ロードしてストリームを開始します。ストリームを ODP から OData に移行するとき、または SLT トリガーやポインターが失われたときに、この設定を1回使用し、その後オフにします。
- キュー登録のリセット: OData ストリームで利用できます。ストリーム自身の OData 購読をリセットします。別の同期が保持する購読を引き継ぐことはできません。この設定はオフのままにしてください。ストリームの実行中は、ポーリングリクエストのたびにこの設定が送信されるため、ストリームが繰り返し再初期化される可能性があります。ストリームを再初期化するには、代わりにスナップショットの強制を使用します。
スナップショットの強制をオンのままにすると、スケジュールによってトリガーされた再起動も含め、ストリームが再起動するたびにテーブル全体がフルロードされます。別の同期の購読との競合を解決するには、購読の競合を参照してください。既存のストリームを ODP から OData に移行するには、SAP SLT 同期に OData を使用するの手順に沿って進めてください。
スループットとパーティションキー
スループット設定を通常から非常に高いに切り替えると、パフォーマンスが向上する可能性がありますが、使用されるパーティション数が増えます。複数のパーティションを使用する場合、SAP の一意のレコード間の順序を保証するために、パーティションキーを設定する必要があります。これらのキーは、SAP 内のテーブルの主キーに対応させる必要があります。
Webhook
SAP Webhook を使用すると、Foundry から汎用モジュール(通常は BAPI(Business Application Programming Interface))を呼び出して、SAP にデータをライトバックできます。Webhook の設定方法の概要については、Webhook を参照してください。
SAP Webhook は、Foundry が管理するクラウドコンピューティング環境での Foundry ワーカー接続をサポートしています。SAP Webhook には、Data Connection Agent 経由で実行するのではなく、このランタイムを使用することを推奨します。Foundry ワーカーに設定済みの既存の SAP ソースは、移行なしで自動的にクラウド実行のメリットを享受できます。Data Connection Agent で実行されている SAP ソースでクラウド実行の Webhook を利用するには、Foundry ワーカーに切り替えてください。
Webhook のタスク本文は、Handlebars ↗ 構文で記述する JSON ドキュメントです。呼び出す SAP 汎用モジュールの名前を指定し、その入力を指定して、返す出力を選択します。
タスク本文のフィールド
| フィールド | 必須 | 種類 | 説明 |
|---|---|---|---|
function-name | はい | 文字列 | 呼び出す SAP 関数モジュールまたは BAPI です。たとえば、BAPI_SALESORDER_CHANGE です。 |
inputs | いいえ | オブジェクト、またはオブジェクトの配列 | 関数の入力パラメーターです。1件のレコードをライトバックするには1個のオブジェクトを指定し、1回の呼び出しで複数のレコードをライトバックするにはオブジェクトの配列を指定します。関数が入力を必要としない場合は省略します。 |
output | いいえ | 文字列、または文字列の配列 | 返す出力変数です。1個の変数名を指定するか、複数の変数を返すには名前の配列を指定します。 |
commit | いいえ | ブール値 | 変更をコミットするかどうかを指定します。省略するとコミットされます(デフォルト)。コミットを抑制するには false に設定します。標準 BAPI では、変更を保存するためにコミットが必要です。 |
parallel | いいえ | オブジェクト | 並列ライトバックを選択し、任意でその実行を調整します。複数のレコードをライトバックするを参照してください。 |
remote | いいえ | オブジェクト | リモート SAP システムを対象とします。システムを識別する context 文字列を含みます。例:{ "context": "<SAP_CONTEXT_NAME>" }。 |
api-version | いいえ | Integer | SAP アドオンの API バージョンです。デフォルトは 1 です。バージョン2の機能を使用するには 2 に設定します。SAP アドオンの互換性を参照してください。 |
単一のレコードをライトバックする
次の例では、BAPI_SALESORDER_CHANGE を呼び出して販売伝票の購入日を変更し、SAP の RETURN テーブルを返します。リモート SAP システムを対象にするには、システムコンテキストの名前を指定する remote ブロックを追加します。
Copied!1 2 3 4 5 6 7 8 9 10 11{ "function-name": "BAPI_SALESORDER_CHANGE", "inputs": { "SALESDOCUMENT": {{json sales-doc-id}}, "ORDER_HEADER_IN": { "PURCH_DATE": {{json purchase-date}} }, "ORDER_HEADER_INX": { "UPDATEFLAG": "U", "PURCH_DATE": "X" } }, "output": "RETURN", "remote": { "context": "<SAP_CONTEXT_NAME>" }, "api-version": 2 }
複数のレコードをライトバックする
一括および並列ライトバックは、OAuth 2.0 認証をサポートしていません。
1回の呼び出しで複数のレコードをライトバックするには、inputs にオブジェクトの配列を渡し、必要な変数を output に列挙します。任意の parallel ブロックを使用して実行を調整します。次の例では、BAPI_PR_CREATE で2件の購買依頼を作成し、2個の出力変数を返します。
Copied!1 2 3 4 5 6 7 8 9 10 11{ "function-name": "BAPI_PR_CREATE", "commit": true, "parallel": { "max-jobs": 2, "max-calls-per-job": 4 }, "inputs": [ { "PRHEADER": { "PR_TYPE": "NB" }, "PRITEM": [ { "MATERIAL": "100-100", "PLANT": "1100", "QUANTITY": "1" } ] }, { "PRHEADER": { "PR_TYPE": "NB" }, "PRITEM": [ { "MATERIAL": "100-200", "PLANT": "1100", "QUANTITY": "2" } ] } ], "output": ["NUMBER", "PRHEADEREXP"], "api-version": 2 }
Webhook の実行は SAP 側で並列化できます。inputs が複数のオブジェクトを含む配列の場合、または空であっても parallel ブロックを明示的に指定した場合に、自動的に並列化されます。任意の parallel ブロックを使用して実行を調整します。
max-jobs— 同時に実行するジョブの最大数です。max-calls-per-job— 各ジョブが処理するレコードの最大数です。
省略した設定には、SAP アドオンで定義された値が使用されます。デフォルトは3ジョブ、ジョブあたり4回の呼び出しです。
max-jobs をレコード数より大きく設定しても問題ありません。余分なジョブは使用されず、リソースが無駄になることはありません。
レスポンス
parallel ブロックのない単一のレコードの場合、レスポンスは要求した出力変数の数によって異なります。
出力変数が1個の単一のレコードでは、その変数の行のリストが返されます。
Copied!1 2 3[ { "NUMBER": "0010048439" } ]
出力変数が複数ある単一のレコードでは、変数名をキーとするオブジェクトが返されます。output["NUMBER"] のように、名前を指定して要素にアクセスします。
Copied!1 2 3 4{ "NUMBER": [ { "NUMBER": "0010048439" } ], "PRHEADEREXP": [ { "PREQ_NO": "0010048439", "PR_TYPE": "NB" } ] }
並列ライトバックでは、入力が1件だけの場合でも、入力レコードごとに1個の要素を持つ配列が返されます。次に例を示します。
Copied!1 2 3 4 5 6 7[ { "OUTPUT": { "NUMBER": [ { "NUMBER": "0010048439" } ], "PRHEADEREXP": [ { "PREQ_NO": "0010048439" } ] }, "ROWNO": 1, "MSG": [ { "MSGTYP": "S", "MSGTXT": "Purchase requisition 0010048439 created" } ] } ]
OUTPUTは、そのレコードの結果で、単一レコードのレスポンスと同じ形式です。ROWNOは、inputs配列内の対応するエントリーの位置(1から開始)です。これにより、各結果をその入力に対応付けられます。MSGは、そのレコードの SAP メッセージログです。各メッセージには、種類(MSGTYP:成功はS、エラーはE、警告はW、情報はI、中止はA)とテキスト(MSGTXT)があります。各レコードがそれぞれのメッセージを報告するため、どのレコードが成功し、どのレコードが失敗したかを確認できます。
HTTP レスポンスが失敗を示す場合、Webhook はエラーを返します。Webhook のレスポンスが成功を示していても、SAP の業務エラーが含まれることがあります。利用可能な場合は SAP の RETURN 出力を要求して内容を確認し、レコードごとの MSG エントリーをチェックして、要求した変更が成功したかどうかを判断します。
SAP アドオンの互換性
複数の出力変数と、一括および並列ライトバックを使用するには、api-version を 2 に設定します。バージョン 2 には、SAP アドオン 2.29.0 以降が必要です。api-version を省略すると、Webhook はバージョン 1 を使用します。このバージョンは、parallel ブロックなしで、単一の入力と単一の出力変数をサポートします。
バージョン 2 に切り替える際は、0 より大きい retries-per-request 設定を削除します。
関連ドキュメント
次のガイドでは、SAP 側と Foundry 側の両方で設定を行うワークフローについて説明します。
- SAP から長文テキストを抽出する:
STXLテーブルから長文テキストを解凍して取り込みます。 - カスタム権限とロール管理を設定する:SAP アドオンのカスタム権限ロールを設定します。
- エクストラクターを設定する:SAP BW Business Content のエクストラクターを設定します。
- SAP から HANA ビューを取り込む:HANA 外部ビューを公開して取り込みます。
- OAuth 2.0 を使用したユーザーに帰属する SAP ライトバック:SAP への名前付きユーザーによるライトバック用に OAuth 2.0 を設定します。