注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
データセット出力を追加する
Pipeline Builder でデータセット出力を追加すると、パイプライン統合を、加工済みのクリーンなデータを生成する方向に進められます。出力タイプの違いについて詳しくはこちら。
データセット出力を作成する
まず、グラフの右側にある出力パネルで、データセットタイプの横にある追加をクリックします。
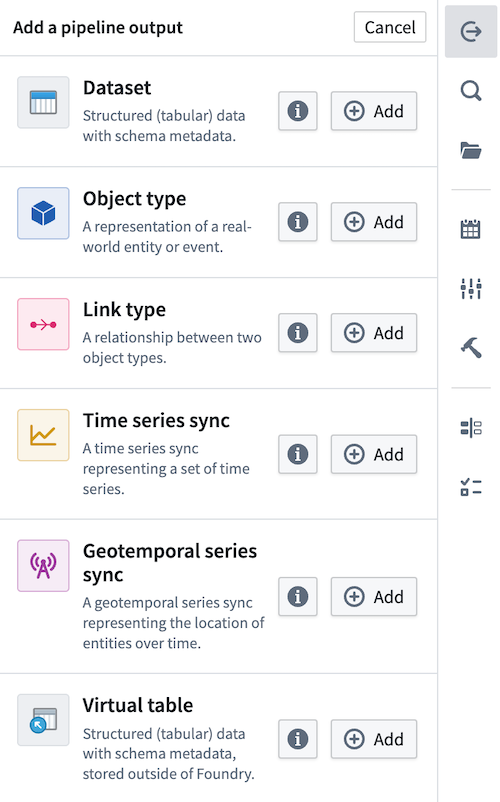
これで新しい出力データセットが作成されました。パイプラインの初回ビルド後、データセット出力はパイプラインと同じフォルダーに作成されます。たとえば、Demo Pipeline の Vendor データセット出力のファイルパスは、/Palantir/Pipeline Builder/Demo Pipeline/Vendor になります。
名前の項目をクリックして、出力データセットの名前を変更します。列を追加を選択して出力スキーマに列を手動で追加するか、データ加工ノードを接続し、更新されたスキーマを使用でその出力スキーマを使用します。
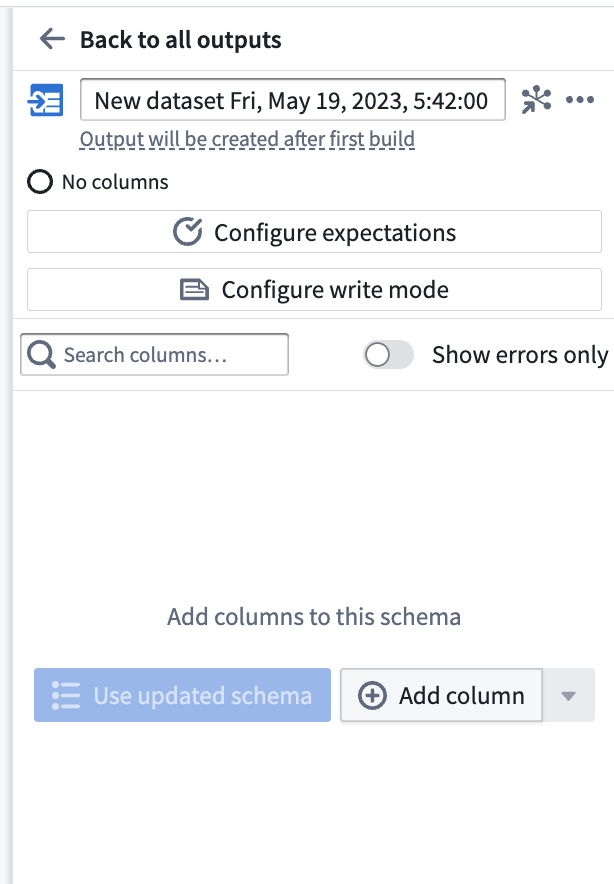
出力スキーマを追加したら、列を検索… 項目を使用して、データセット内の列をすばやく見つけられます。出力スキーマのエラーのみを表示するには、エラーのみ表示ボタンを切り替えます。
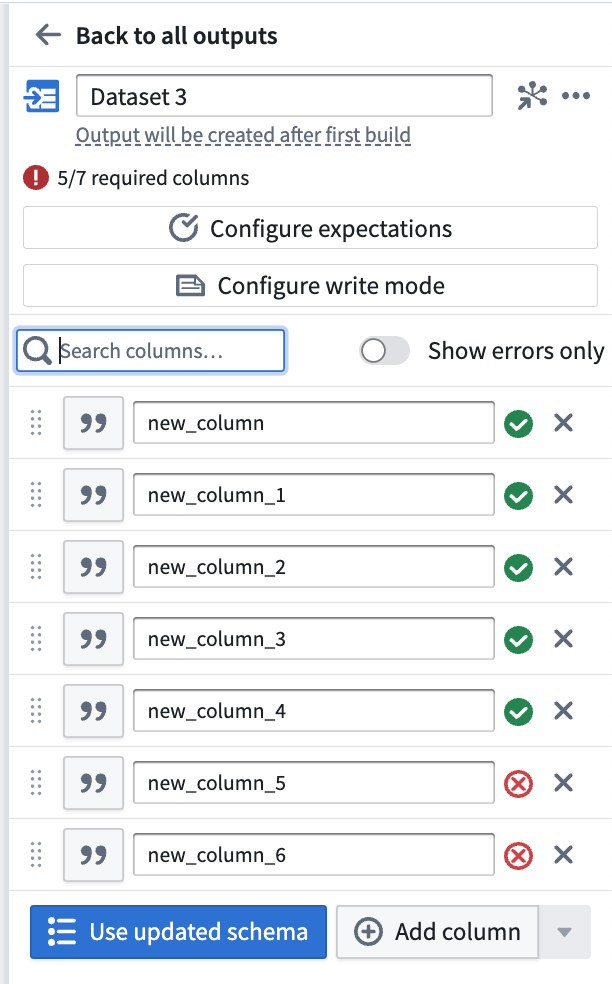
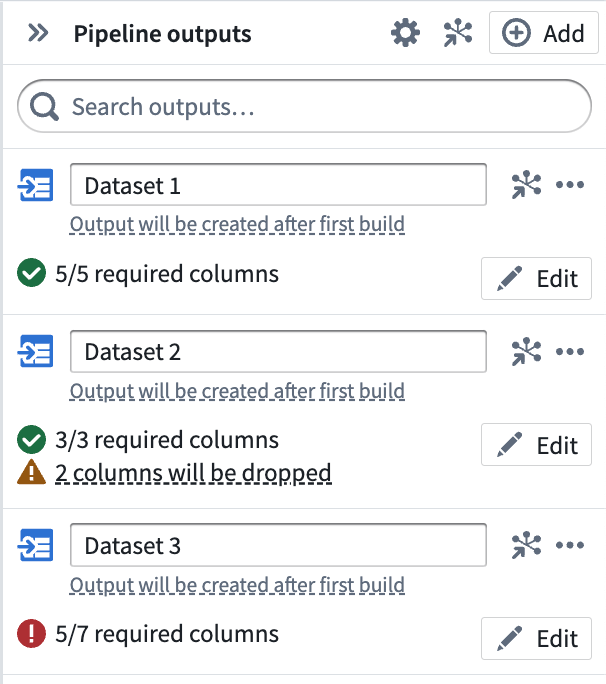
出力データセットを追加したら、すべての出力に戻るをクリックして、パイプラインのすべての出力の一覧を表示します。出力スキーマが入力データ加工ノードのスキーマと一致しているかどうかを含め、各出力のステータスをひと目で確認できます。以下の3つの出力は、出力スキーマが取りうるさまざまなステータスを示しています。
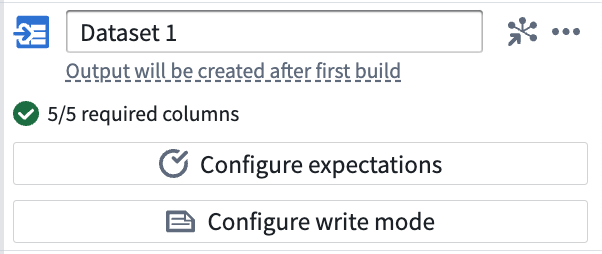
- データセット1には必須列が5/5列あり、入力データ加工ノードのすべての列が出力データセットにビルドされることを意味します。
- データセット2には必須列が3/3列あり、2列が削除されています。これは、入力データ加工ノードには5列ありますが、出力データセットには3列のみがビルドされることを意味します。入力データ加工ノードに不要な列がある場合には、この状態が望ましい場合があります。
- データセット3には必須列が5/7列あり、エラー状態です。不足している2列を入力データ加工ノードの列にマッピングするまで、パイプラインをデプロイできません。
編集をクリックすると、いつでも出力スキーマを更新できます。
データセットスキーマについては、データ統合で詳しくはこちら。
データセット出力に Media Reference 列を含めるには、メディアセットをパイプライン入力として追加し、その Media Reference 列を出力データに結合します。Pipeline Builder でのメディア加工について詳しくはこちら。
出力設定を構成する
スキーマ設定に加えて、各出力にはカスタマイズできるさまざまなデフォルト設定があります。
データが満たすべき条件を設定する
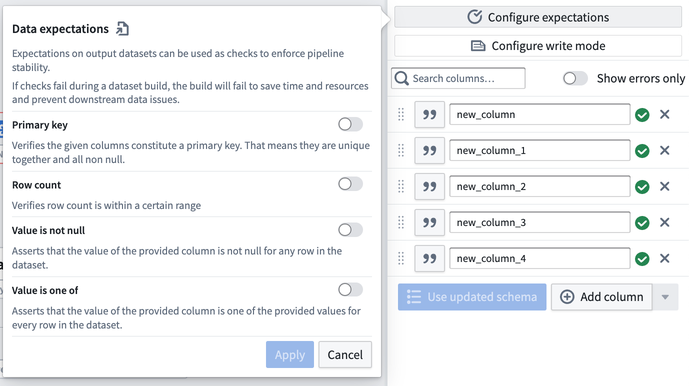
出力データセットにデータが満たすべき条件を追加して、パイプラインの安定性を確保します。パイプラインのビルド中にいずれかのチェックに失敗すると、ビルドに失敗します。
書き込みモードを設定する
今後のデプロイでデータセット出力にデータを追加する方法を定義します。
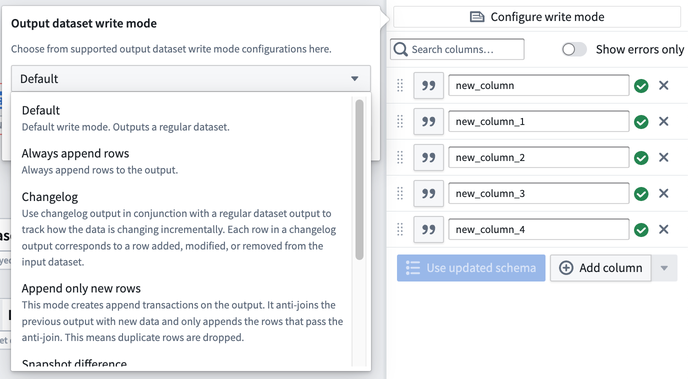
デフォルト:スナップショットとインクリメンタル(差分処理)の両方を含む、ほとんどのバッチパイプラインに推奨されます。デフォルトの書き込みモードでは、入力が1つ以上インクリメンタルとして指定されており、インクリメンタルとして指定されているすべての入力で、前回のビルド以降に APPEND または追加型の UPDATE トランザクションのみが行われている場合、結果を APPEND トランザクションとして出力します。それ以外の場合、デフォルトの書き込みモードは結果を SNAPSHOT トランザクションとして出力します。トランザクションタイプについて詳しくはこちら。
スナップショットの置換: 新しいデータを前回の出力とマージし、結果を SNAPSHOT トランザクションとして出力します。前回の出力に存在する主キーの行は削除され、新しい行に置き換えられます。現在のトランザクション内に重複する行がある場合、1行を除いてランダムに削除されるため、出力には主キーごとに1行のみが含まれます。
スナップショットの置換と削除:****スナップショットの置換に続いて、古いデータから行を選択的に削除する後段のフィルタリング処理を行うモードです。新しいデータを前回の出力とマージし、指定されたブール列 post_filtering_column に基づいて以前のトランザクションの行を削除する後段のフィルタリング処理を行ったうえで、結果を SNAPSHOT トランザクションとして出力します。post_filtering_column = TRUE の場合、前回の出力に存在する主キーの行は削除され、新しい行に置き換えられます。ただし、ある主キーについて、現在のトランザクション内に post_filtering_column = FALSE の行が存在する場合、古いデータの対応する行は除外されます。ただし、これによって post_filtering_column = TRUE の新しい行の保存が妨げられることはありません。現在のトランザクション内に post_filtering_column = TRUE の重複する行がある場合、1行を除いてランダムに削除されるため、出力には主キーごとに1行のみが含まれます。
変更履歴: すべてのレコードの完全な変更履歴を含む、一連の APPEND トランザクションを出力します。Object Storage v1 では、このように設定した変更履歴データセットを元データソースとして設定することで、オブジェクトタイプの同期パフォーマンスを最適化できます。変更履歴データセットについて詳しくはこちら。
新しい行のみを追加: 新たに検出された主キーを持つ行を新しい行と定義し、それらの行のみを出力に追加して、結果を APPEND トランザクションとして出力します。現在のトランザクション内に重複する行がある場合、1行がランダムに削除されます。前回の出力に存在する主キーを持つ行は削除されます。
直接変更履歴: 出力行を変更履歴として扱い、変更履歴の内容を完全に制御できます。変更履歴のメタデータは出力データセットに直接書き込まれます。各行には、主キー、タイムスタンプ、および削除を示すブール値を指定する必要があります。変更履歴データセットについて詳しくはこちら。
Object Storage v2 は、指定されたタイムスタンプ列を無視し、代わりにトランザクション ID を使用して、同じ主キーを持つ行の重複を排除します。
新しい行のみをスナップショット: 新たに検出された主キーを持つ行のみを出力に保持し、結果を SNAPSHOT トランザクションとして出力します。現在のトランザクション内に重複する行がある場合、それらは保持されます。それ以外の行はすべて削除されます。
常に行を追加: 結果を APPEND トランザクションとして出力します。
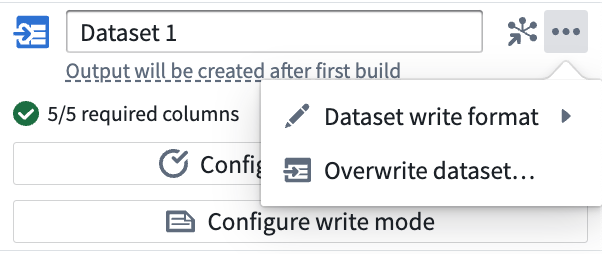
データセットの書き込み形式
データセットの出力ファイル形式は初回デプロイ後に変更でき、パイプラインの次回デプロイ時に適用されます。ファイル形式について詳しくはこちら。
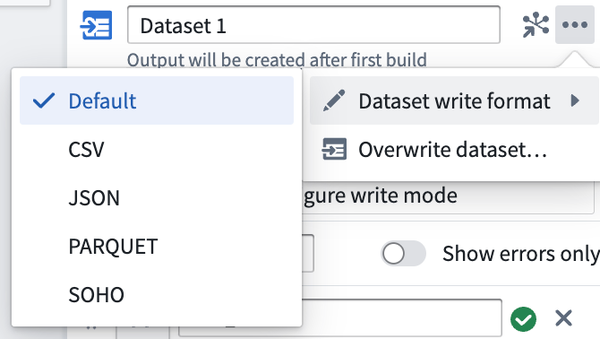
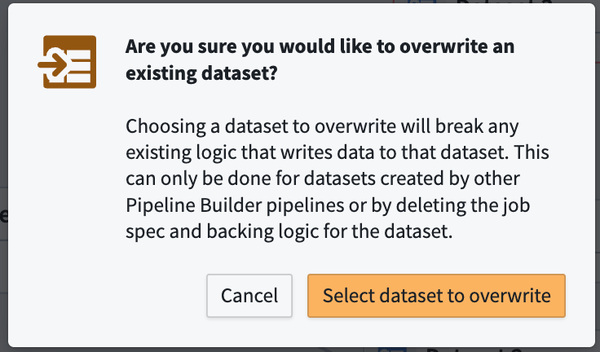
データセットを上書き
既存のデータセットの所有権を Pipeline Builder の新しい出力に付与する、1回限りのアクションです。このアクションには、Pipeline Builder 外での追加のアクションが必要になる場合があります。
データセット出力をビルドする
パイプラインにデータセット出力を追加したら、必ず変更を保存してください。データの加工とパイプラインのワークフローの定義が完了したら、パイプラインをデプロイしてデータセット出力をビルドする準備が整っています。パイプラインのデプロイ後、最終的なデータセット出力を、Ontology Manager でオントロジーを構築するための基盤として使用します。
パイプラインをデプロイする方法を参照してください。