注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
Foundry の Iceberg テーブル
Apache Iceberg ↗ は、広く採用されているオープンソースの仕様およびテーブル形式であり、Foundry ではテーブル形式のデータを表すための代替リソースタイプとして利用可能です。このセクションでは、Iceberg テーブルとは何か、Foundry でどのように実装されているか、そして Iceberg テーブルを使って構築する方法を説明します。
Iceberg とは
Apache Iceberg は、スケーラビリティ、パフォーマンス、幅広いエコシステムのサポートといった利点により、データおよび分析のコミュニティで広く普及しているオープンなテーブル形式を提供します。特に、Iceberg の形式とカタログ仕様が広く採用されていることで、最新のデータエコシステム間で多様な統合と相互運用が可能になっています。
Apache Iceberg プロジェクトには、Apache Iceberg 仕様 ↗ に加え、Spark ↗ や Flink ↗ など、Iceberg 仕様をサポートするエンジンコネクターのエコシステムが含まれています。
中核となるプロジェクト以外でも、この形式をサポートするコネクターやエンジンのエコシステムが拡大しています。PyIceberg ↗ は Python エコシステムへの接続手段を提供し、Trino ↗ や PrestoDB ↗ といったエンジンはネイティブにサポートしています。Databricks ↗ や Snowflake ↗ などのサードパーティープラットフォームは、この形式を基盤としたサービスを提供しています。
Foundry Iceberg REST カタログ
Apache Iceberg は Iceberg REST Catalog ↗ 仕様を定義しており、サービスが Iceberg REST カタログとして機能するために実装しなければならないエンドポイントと動作の概要を示しています。この仕様に準拠することで、サービスは Iceberg REST Catalog をサポートする、ますます多くのコンピューティングエンジンに対応できるようになります。
Foundry はこの Iceberg REST Catalog 仕様をネイティブに実装しているため、サードパーティーは Foundry の Iceberg カタログと統合して、Foundry の Iceberg テーブルを読み書きできます。また、Foundry は Databricks Unity Catalog ↗ などのサードパーティーの Iceberg REST カタログへの接続もサポートしています。サポートされているサードパーティーカタログについては、仮想テーブル:Iceberg カタログを参照してください。
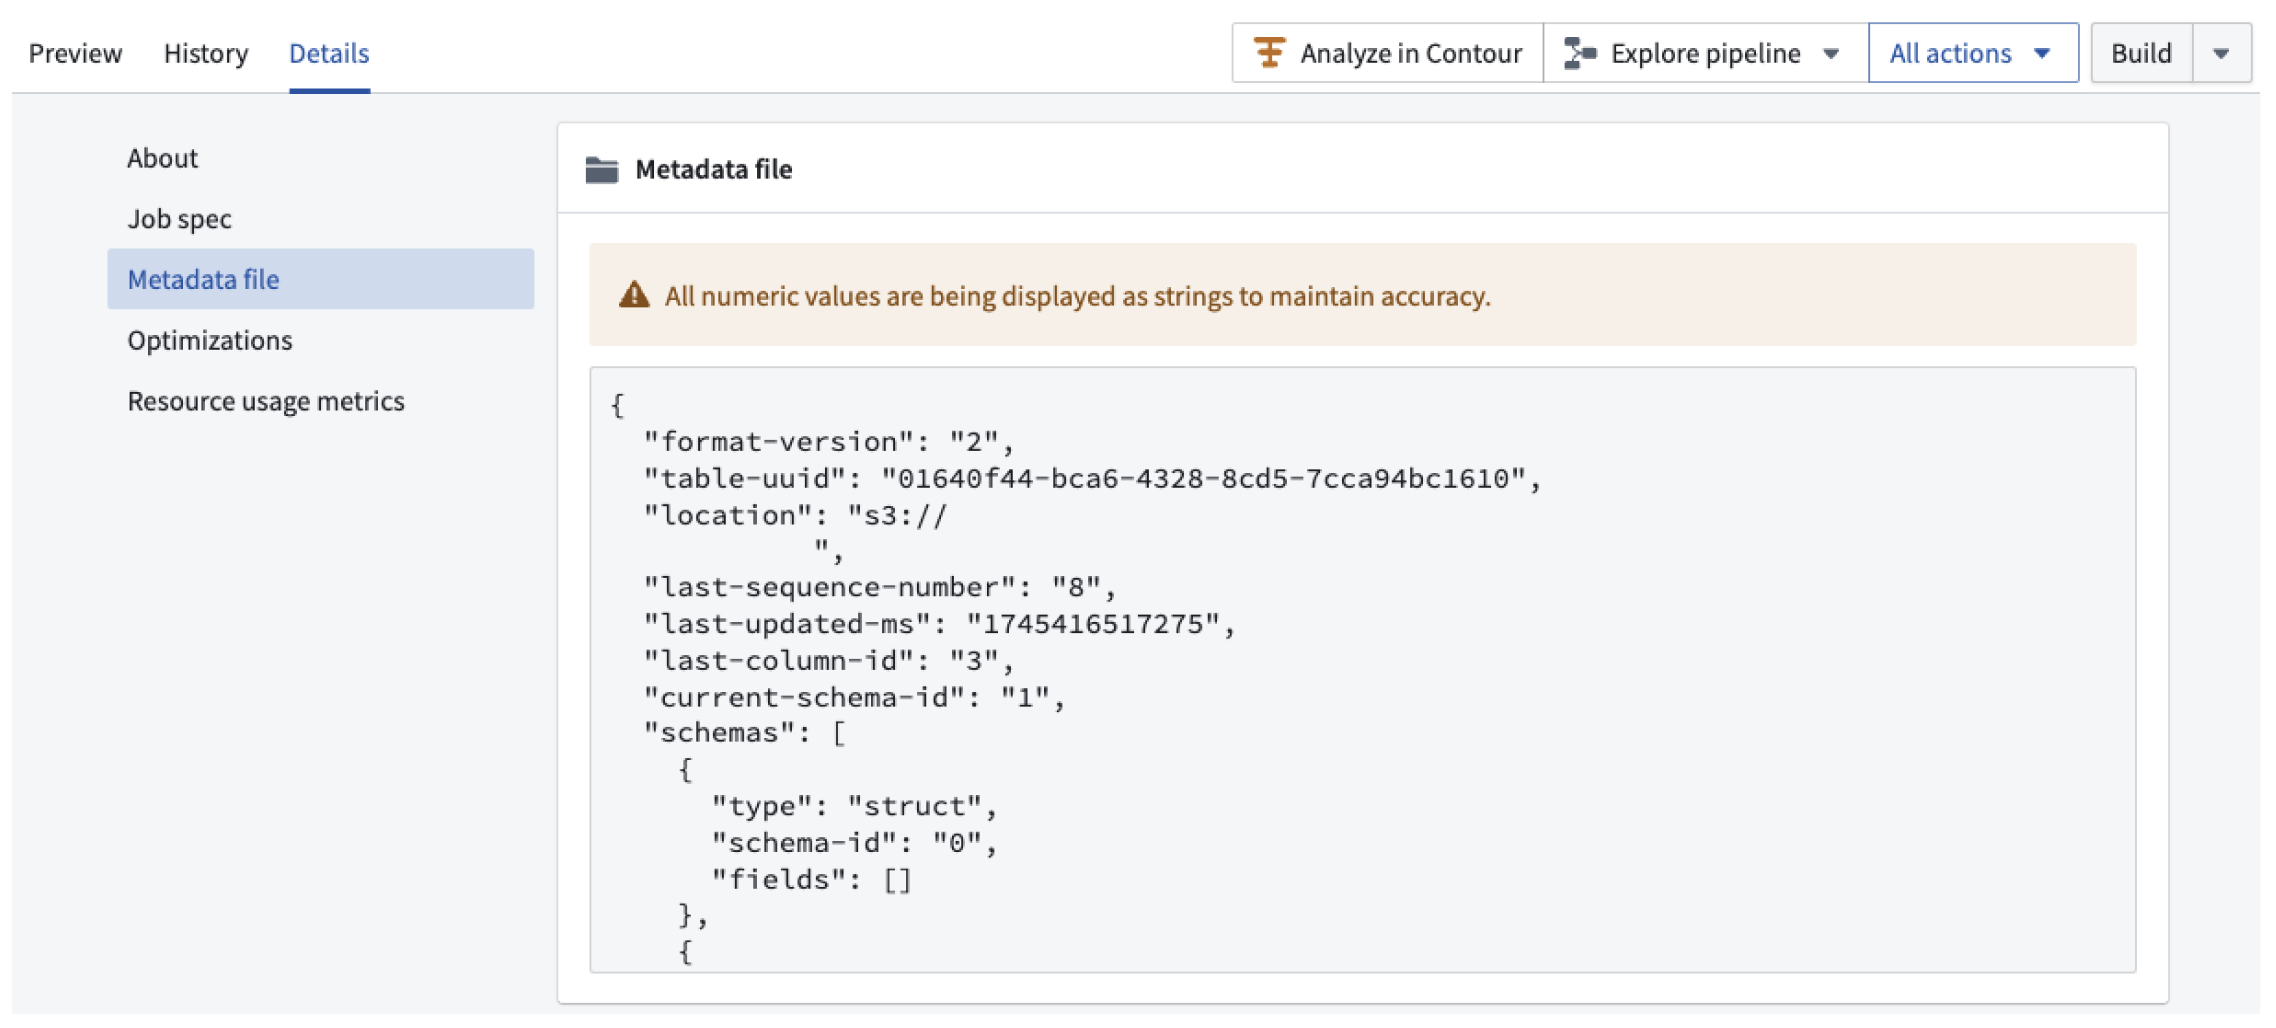
Foundry は、以下のスクリーンショットに示すように、データセットアプリケーションの詳細タブで、Iceberg カタログのメタデータを JSON ファイルとして明示的に公開しています。
マネージド Iceberg テーブルと仮想 Iceberg テーブル
Foundry は Iceberg を2つの形態で提供しています。
- マネージド Iceberg テーブルは、Foundry 独自の Iceberg カタログによって管理され、Foundry のマネージドストレージバケット、または顧客が用意する「持ち込み」バケットに保存できます。
- 仮想 Iceberg テーブルは、外部ストレージを元にしており、Glue、Horizon、Polaris、Unity などの外部カタログによって管理される仮想テーブルです。
Iceberg のストレージオプションについて詳しくはこちら。
Iceberg テーブルを検討すべき場合
Iceberg テーブルには、以下のような独自の利点があります。
- データのコンパクションを含む、ネイティブのメンテナンス手順によるテーブルレイアウトの最適化
DELETE、UPDATE、MERGE INTO操作などによる行の編集- 変更履歴に基づくインクリメンタル(差分処理)
- 外部エンジンおよびツールのエコシステムとの相互運用性
現時点では、Foundry データセットのすべての機能が Iceberg テーブルでサポートされているわけではありません。Foundry における Iceberg のサポートとカタログデータセットとの違いについては、Iceberg テーブルと Foundry データセットを参照してください。
はじめに
ストレージと暗号化を設定する。 Iceberg テーブルを作成する前に、管理者がテーブルデータの保存先と暗号化方法を設定します。まずストレージアーキテクチャの概要を参照して、Foundry マネージドストレージとバケットの持ち込みのどちらを使用するかを選択し、次に Control Panel で Iceberg の設定を行って、Iceberg を有効にし、エンロールメント全体のデフォルトまたはプロジェクトごとのオーバーライドを設定します。独自のバケットを使用する場合は、バケット持ち込みのセットアップガイドに沿って進めてください。
パイプラインを構築する。 Foundry の transforms-tables ライブラリは、Python トランスフォームから Iceberg テーブルを読み書きします。Python トランスフォームのページでは、Iceberg を使ったトランスフォームの記述方法を紹介しています。ビルドのたびにテーブルを書き直すのではなく、実行間の変更分のみを処理するには、変更履歴と CDCの使用を検討してください。Foundry の Pipeline Builder アプリケーションを使って Iceberg テーブルを読み書きすることもできます。
データを取り込み、メンテナンスする。 Data Connection の同期を使うと、外部システムから Iceberg テーブルにデータを直接同期できます。時間の経過とともに、テーブルに小さなファイルが蓄積したり、過去のスナップショットの数が増えたりすることがあります。テーブルを最適化するために、コンパクション、スナップショットの期限切れ処理、孤立ファイルのクリーンアップなどのメンテナンスタスクをスケジュールできます。
カタログの動作を理解する。 Foundry は、標準の Iceberg を、Foundry カタログ固有の注目すべき機能で拡張しています。トランザクションでは、更新がすべて適用されるか、まったく適用されないかのいずれかになる Foundry のセマンティクスを説明し、Iceberg のスナップショットの種類を Foundry のトランザクションタイプに対応付けています。ブランチでは、Foundry のビルドがスキーマ、並べ替え順序、パーティション仕様の変更に対してブランチの分離を実現する仕組みを説明しています。プロパティでは、Foundry 固有のテーブルプロパティとデフォルトを説明しています。
外部クライアントを接続する。 Foundry は Iceberg REST Catalog 仕様を実装しているため、Foundry 外部のエンジンからテーブルをクエリできます。どの外部クライアントにも、API トークンまたは OAuth2 を使った認証と、REST カタログのエンドポイントおよび基盤となるストレージバケットの両方へのネットワークアクセスの2つが必要です。具体的な手順を示した例については、ローカルの Jupyter® ノートブックを接続するおよび Foundry の Iceberg カタログを Snowflake に接続するを参照してください。