注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
ブランチ
ソフトウェア開発者は通常、バージョン管理システムを使ってコードベース内の作業を調整します。これにより、複数のエンジニアが同じコードに安全に変更を加えられます。
Foundry では、ソフトウェア開発者がコードを捉えるのと同じようにデータを捉えています。多くの人がほかの人の作業を妨げずに、同じデータに変更を加えたり、そのデータを操作したりできる仕組みが必要です。そこで、ソフトウェア開発のベストプラクティスをデータパイプラインの作成に適用し、バージョン管理システムで一般的なブランチという機能を活用しました。
大まかに言うと、ブランチを使うことで、本線から分岐して自分のブランチでデータを扱えます。変更内容に満足したら、その変更を自分のブランチから本線に戻せます。
ブランチのワークフロー
ブランチのワークフローを使って Foundry のデータパイプラインのコードを変更する方法は、次のとおりです。
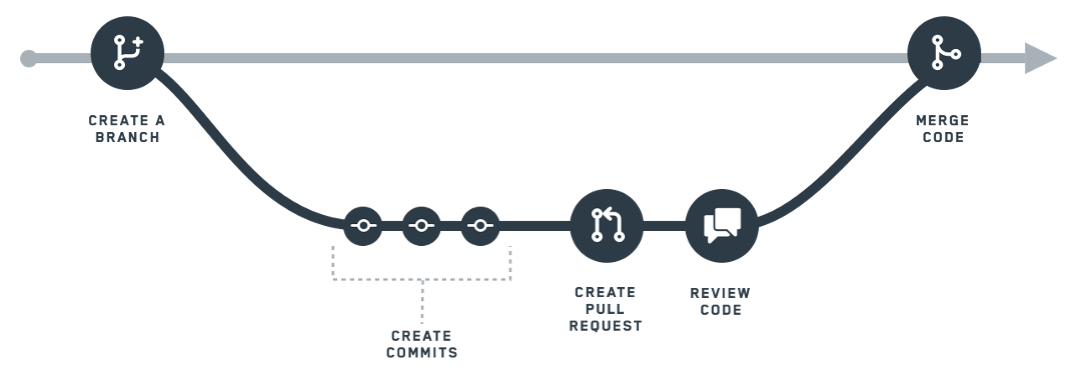
- ブランチを作成する。Foundry では、
masterブランチは主要なデータパイプラインを指します。独自の変更に取り組むには、自分のブランチを作成します。これにより、masterブランチへの影響を心配せずに、実験やアイデアの検証を行うための環境が作成されます。 - コミットを作成する。このブランチ内では、データ変換に変更を加えられます。追加や削除を含む変更は、コミットと呼ばれます。コミットは追跡されるため、このブランチで行ったすべての変更の履歴が明確に残ります。
- プルリクエストを作成する。独立した環境での作業が終わったら、変更を master ブランチに戻します。このプロセスを開始するには、プルリクエストを作成します。プルリクエストは、
masterデータパイプラインに対する変更を加えたことと、その変更のレビューと検証を依頼したいことをチームに伝えます。 - コードをレビューする。プルリクエストを作成すると、チームがコミットをレビューできるようになります。プルリクエストをレビューするプロセスやチームは、組織によって異なります。
Foundry のブランチ機能は、業界標準の Git に似たバージョン管理の仕組みを実装しています。そのため、Code Repositories アプリケーションは、ファイルの個々のブランチで作業する開発者がそれぞれ1人になるように設計されています。ほかのユーザーが個人用ブランチで作業している場合、変更が上書きされる可能性があります。これを避けるため、各自が別々のブランチで作業することを強く推奨します。
このページの以降のセクションでは、Foundry でのブランチの仕組みについて技術的な詳細を説明します。ブランチの実際の使い方を学ぶには、Pipeline Builder または Code Repositories でシンプルなバッチパイプラインを作成するチュートリアルに沿って進めてください。
ブランチの技術的な詳細
Foundry では、データのブランチ機能を、個々のデータセット内のブランチと、データセットのビルド時のブランチという2つの異なるレベルの機能で実装しています。
データセットのブランチ
データセットのページで説明したように、データセットには一連のトランザクションという形でバージョン履歴が保持されています。概念的には、データセットのブランチは Git のブランチに似ています。データセット、ブランチ、トランザクションは、それぞれ Git のリポジトリ、ブランチ、コミットに相当します。
Git のブランチと同様に、データセットのブランチは、そのブランチの最新のトランザクションを指すポインターにすぎません。そのため、ブランチはコミット時刻順に並んだ直線的なトランザクションの列として解釈できます。トランザクションをコミットしてブランチ上のデータセットを変更しても、ほかのすべてのブランチのトランザクションとビューは変わりません。Git とは異なり、データセットのブランチのマージはサポートされていません。
データセットの各ブランチには、ルートブランチでない限り、必ず1個の親ブランチがあります。実際には、Foundry のほとんどのデータセットには master という単一のルートブランチがあり、この単一のルートブランチから子ブランチが作成されます。
データセットのブランチに関連する、サポートされているすべての操作は次のとおりです。
- 新しいブランチを作成する。親ブランチもトランザクションもないルートブランチを作成できます。
- 子ブランチを作成する。別のブランチ、または任意のトランザクションから子ブランチを作成できます。新しいブランチは親ブランチと同じトランザクションを指します。その後、親ブランチと子ブランチの両方でトランザクションを開始でき、それぞれのトランザクションポインターは独立して移動します。
- ブランチで新しいトランザクションを開始する。トランザクションを開始し、ブランチのポインターを新しいトランザクションに移動します。
- ブランチを削除する。ブランチのポインターを削除しますが、ブランチ上のトランザクションは削除しません。以下の保証にある親ブランチについての注記を参照してください。
データセットのブランチに関する保証
Foundry は、データセットのブランチについて以下を保証します。
- ブランチごとにオープン中のトランザクションは1個。各ブランチに存在できるオープン中(開始されており、コミットも中止もされていない)のトランザクションは最大1個で、このトランザクションは常にそのブランチの最新のトランザクションです。そのため、ブランチが1個のデータセットに存在できるオープン中のトランザクションは最大1個です。ブランチがオープン中のトランザクションを指している場合、そのブランチから新しいブランチを作成できますが、そのトランザクションが閉じられるまでは、それ以上トランザクションを開始できません。
- すべてのブランチで、トランザクションは開始時刻とコミット時刻の順に並ぶ。この保証は、前述の制約によるものです。ただし、異なるブランチ上のトランザクション間の時間的な順序については保証されません。
- ルート以外のすべてのブランチには、必ず1個の親ブランチがある。「中間」のブランチ、つまり子ブランチを持つブランチが削除された場合、子ブランチの親は、削除されたブランチの親に変更されます(削除されたブランチがルートブランチだった場合は、親がなくなります)。この処理でトランザクションが並べ替えられることはありません。親の変更は、ブランチの祖先関係の記録を変更するだけです。
ビルドにおけるブランチ
データセットのブランチ機能は、データのバージョン管理の基盤となるセマンティクスを提供します。Foundry はデータセットのブランチ機能と Git のブランチ機能を組み合わせ、ロジックとデータの両方を同時にブランチ化できるようにします。これにより、データエンジニアはデータパイプラインの変更を本番環境に導入する前に、安全に試すことができます。
Git のロジックのブランチとデータセットのデータのブランチは、Foundry のビルドシステムを通じて紐付けられます。すべてのビルドはユーザーが指定したブランチで実行され、ビルド内のジョブはそのブランチ上のデータセットのみを変更します。そのため、ビルドのブランチを使うことで、ユーザーごとの変更を互いに分離できます。
Foundry のビルドは、ブランチに関して次の2つの主な機能を実行します。
- まず、適切なブランチからジョブ仕様(JobSpec)を収集し、ビルドグラフをコンパイルします。
- 次に、ユーザーが定義したビルドブランチとフォールバックブランチの順序に基づいて、ジョブの入力と出力を解決します。
ジョブグラフのコンパイル
Foundry でコードリポジトリのブランチにデータ変換を記述し、コードをコミットすると、ビルドシステムの適切なブランチに JobSpec が公開されます。そのブランチでビルドが実行されると、ビルドはこのブランチの JobSpec とその依存関係をたどり、実行するロジックを特定します。
通常、ビルドではブランチのフォールバックを指定します。これは、ビルドブランチに JobSpec が設定されていない場合に、どのブランチから JobSpec を取得するかを制御します。たとえば、フォールバックチェーンを develop --> master として develop でビルドを実行した場合、ある出力データセットに対して公開済みの JobSpec がなければ、代わりに master ブランチから JobSpec が読み取られます。
データセットのアイコンの色は、JobSpec とブランチに関する情報を示します。データセットのアイコンが灰色の場合、master ブランチに JobSpec が存在しないことを示します。データセットのアイコンが青色の場合、master ブランチに JobSpec が定義されています。
入力と出力の解決
ビルド内の JobSpec で出力として指定されたすべてのデータセットに対して、ビルドブランチ上でトランザクションが開かれます。このブランチがデータセットに存在しない場合は、フォールバックチェーンの最初のブランチから作成されます。フォールバックブランチが存在しない場合は、ルートブランチとして作成されます。ジョブの入力は、可能であればビルドブランチから読み取られますが、そうでない場合はフォールバックチェーン内で最初に存在するブランチが使われます。
例:ブランチでビルドする
この例では、各データセットがその前のデータセットから計算される、3個のデータセットからなるシンプルなパイプラインを使います。
Copied!1 2Dataset A ──(Job 1)──▶ Dataset B ──(Job 2)──▶ Dataset C (raw input)
データセット A は、変換ロジックのない生の入力です。コードリポジトリには、A から B を、B から C を計算するロジックが含まれています。最初は、3個のデータセットすべてに master ブランチだけが存在します。
- ブランチを作成します。 データエンジニアがコードリポジトリに
featureという名前のブランチを作成します。これにより、基盤となる Git リポジトリにのみブランチが作成されます。この時点では、どのデータセットにもfeatureブランチは存在しません。 - コードを変更してコミットします。 データエンジニアがデータセット B と C を生成するロジックを変更し、コードをコミットします。その後、リポジトリの CI チェックによって、データセット B と C の JobSpec が
featureブランチに公開されます。 featureでビルドを実行します。featureブランチは Git リポジトリのmasterブランチから作成されたため、このビルドのフォールバックチェーンはfeature --> masterです。ビルドはステップ2で公開された JobSpec を読み取り、データセット B とデータセット C に対してそれぞれ1個のジョブを開始し、それぞれのfeatureブランチでトランザクションを開きます。データセット C はデータセット B に依存しているため、ジョブは順番に実行されます。- ジョブ1(データセット B をビルド): データセット A には
featureブランチがないため、ビルドは入力としてデータセット A のmasterブランチにフォールバックします。出力はデータセット B の新しいfeatureブランチで開かれているトランザクションに書き込まれ、そのトランザクションがコミットされます。 - ジョブ2(データセット C をビルド): ジョブ1によってデータセット B に
featureブランチが作成されているため、フォールバックせずにそのブランチを入力として使います。出力はデータセット C のfeatureブランチで開かれているトランザクションに書き込まれ、そのトランザクションがコミットされます。
- ジョブ1(データセット B をビルド): データセット A には
- ビルドが成功します。 ビルド内のすべてのジョブが成功したため、ビルドは成功となります。
データセット B と C の feature ブランチには、新しいデータが含まれています。データセット A と、データセット B および C の master ブランチは変更されていません。
| データセット | 入力の読み取り元 | 出力の書き込み先 |
|---|---|---|
| A | ビルドされない(生の入力) | ビルドされない(生の入力) |
| B | master 上のデータセット A(フォールバック) | feature 上のデータセット B |
| C | feature 上のデータセット B | feature 上のデータセット C |
ビルドブランチに関する保証
Foundry のビルドは、ブランチについて次のことを保証します。
- ビルドの解決は、指定されたブランチのフォールバック順序が、関連するデータセットのブランチの祖先関係と整合する場合にのみ成功します。
- ビルドが、ビルドブランチ以外のデータセットブランチを変更することはありません。
- ビルドが、入力データセットにブランチを作成することはありません。