注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
Pipeline Builder
Pipeline Builder は、データ統合のための Foundry の主要なアプリケーションです。Pipeline Builder を使用して、生データソースを、さらなる分析に利用できるクリーンな出力に加工するデータ統合パイプラインを構築できます。
Pipeline Builder と堅牢なバックエンドモデルにより、コードを書くユーザーと書かないユーザーが、パイプラインのワークフローで共同作業できます。Pipeline Builder は、アーキテクチャの一部として Spark と Flink の両方を活用しながら、Palantir が開発したカスタムライブラリとサービスによってサポートされるさまざまな高度な機能を組み込んでいます。時間のかかるヘルスチェックを必要とするコードを記述する代わりに、Pipeline Builder は、各種プログラミング言語を、ポイントアンドクリックで操作できるシンプルな構築用インターフェースの背後に統合しています。このインターフェースを通じて、ユーザーはプログラミング言語の専門知識なしにデータ加工を適用できます。
Pipeline Builder は、ロジックの作成と実行の仲介役として機能するように特別に設計された、次世代のデータ加工バックエンドを使用します。ユーザーが構築したいパイプラインを定義すると、バックエンドがトランスフォームのコードを記述し、パイプラインの整合性をチェックします。リファクタリングのエラーを特定し、正常なビルドを確保するための解決策を提示します。バックエンドがロジックの作成と実行の中間層として機能するため、構築者はパイプラインをビルドする前にスキーマの問題を解決し、これまで計算やコードのチェックに費やしていた時間を節約できます。
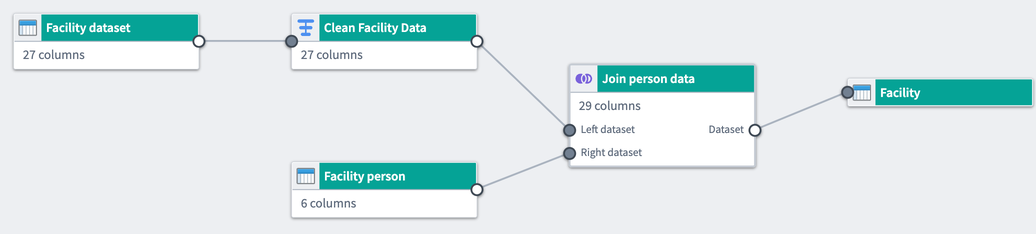
機能
Pipeline Builder には、パイプラインの作成、保守、制御を包括的に行うための機能が含まれています。
-
直感的なユーザーインターフェース: ユーザーはグラフおよびフォームベースのインターフェースを使用してパイプラインを記述します。これらのインターフェースは、結合キーや列のキャストの候補などのフィードバックを提供します。
-
型安全な関数: 関数は強く型付けされており、ビルド時ではなく、その場でエラーを検出できます。
-
厳格な出力チェック: 期待される出力チェックを満たさない場合は、下流で意図しない障害が発生するのを避けるため、ビルドが阻止されます。
-
ビルドパスの自動剪定: Pipeline Builder は、ビルド時の不要な計算を避けるため、出力に接続されていないデータ加工のパスを剪定します。
-
実装の詳細の抽象化: ユーザーは、エンドツーエンドのパイプラインと必要な出力の定義に集中できます。ビルド、同期、その他のオーケストレーションは、Pipeline Builder のバックエンドによって自動的に処理されます。
-
独立したパイプラインロジック: Pipeline Builder は、Spark、Flink、Azure インスタンスなど、さまざまなロジック実行エンジンに接続できます。
-
再利用性: サブグラフを使用して、パイプラインロジックを再利用可能なブロックとして抽出し、再利用できます。
-
完全なバージョン管理: ユーザーは、パイプラインのドラフトを別途作成したり、1つのパイプラインで共同作業したり、以前のバージョンに戻したりできます。
-
メディア処理のデータ加工: ユーザーは、パイプライン内でメディアセットをデータ加工の入力として渡すことができます。
-
大規模言語モデル (LLM): LLM と AIP を使用してデータを加工できます。LLM 評価スイートを使用して、デプロイ前に LLM のデータ加工をテストできます。
-
トレーニング済みモデル: 機械学習モデルをインポートして、パイプライン内で予測を生成できます。
-
Model Studio 統合: Model Studio でトレーニングアクションを使用して、データセットを Model Studio で直接開き、モデルをトレーニングできます。
-
地理空間データの加工: Pipeline Builder を使用して、さまざまな形式の地理空間データを読み込み、加工し、生成できます。
-
高速パイプライン: DataFusion を活用した高速なバッチおよびインクリメンタル(差分処理)パイプラインを構築できます。これにより、特に通常15分未満で実行されるパイプラインの実行速度が大幅に向上します。高速パイプラインを作成する方法を参照してください。
-
ストリーミング機能: Pipeline Builder では、リアルタイムの低遅延で実行されるパイプラインを記述できます。この機能は、すべての Foundry 環境で利用できるわけではありません。ワークフローでストリーミングパイプラインが必要な場合は、Palantir の担当者にお問い合わせください。
-
外部パイプライン: 外部パイプラインを使用して、Databricks や Snowflake などの外部システムに計算をプッシュダウンできます。外部パイプラインでは、計算を実行するソースと同じソースの仮想テーブルを入力および出力に使用する必要があります。
ワークフロー
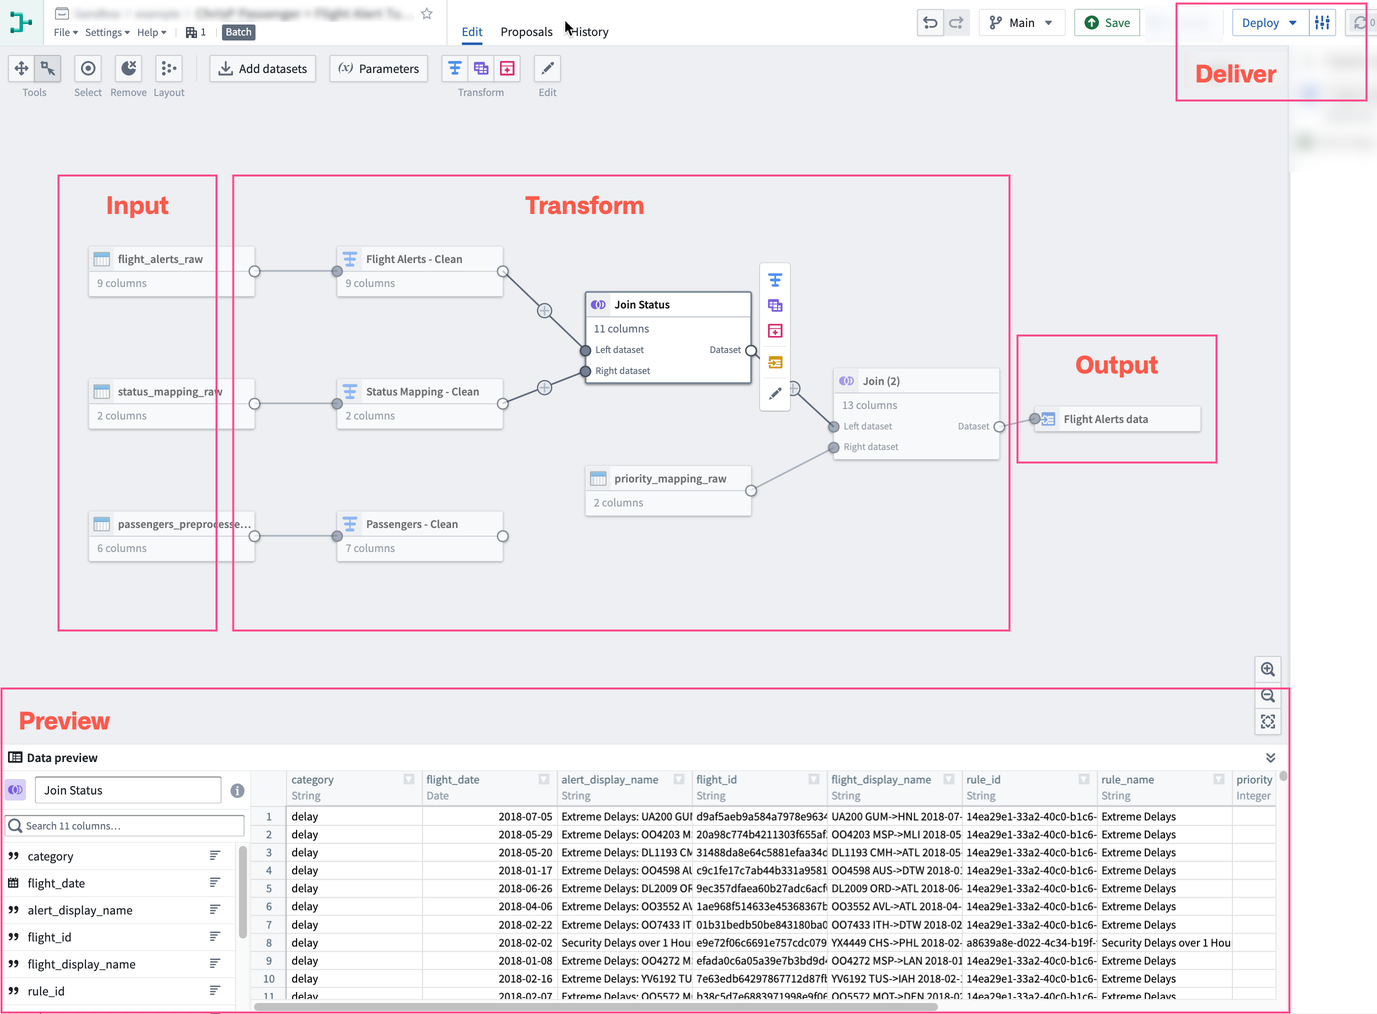
Pipeline Builder は、データのインポートから正常なビルドの提供まで、次のステップで構成されるワークフローに従います。
- インプット: 新しいデータソースまたは追加のデータセットを追加します。
- データ加工: 必要な出力に向けてデータを加工、結合、または和集合にします。
- プレビュー: データ加工を適用した後、出力をプレビューします。
- 提供: パイプラインが完成したら、パイプラインの出力をビルドします。
- 出力: パイプラインにオブジェクトタイプ、リンクタイプ、またはデータセットの出力を追加します。
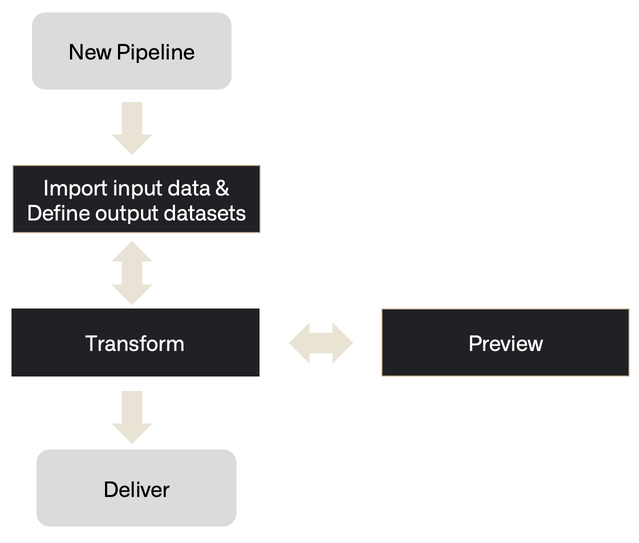
Pipeline Builder のグラフで可視化すると、これらのステップは次のように表せます。
シンプルなバッチパイプラインを作成する方法や外部パイプラインを作成する方法を参照するか、Pipeline Builder でのパイプラインの構築と管理に関する基本概念の詳しい説明を参照してください。非構造化テキストを埋め込みとセマンティック検索に使用できるように準備するには、Chunk string ボードでテキストをチャンク化する方法を参照してください。作業の迅速化、パフォーマンスの向上、パイプラインの整理に関するガイダンスについては、Pipeline Builder のヒントとコツを参照してください。ガイド付きコースで最初のパイプラインを構築するには、learn.palantir.com の「Deep dive: Building your first pipeline」コース ↗を受講してください。