注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
Transforms Excel Parser
Foundry では、Microsoft Excel ファイルを含むスキーマレスデータセットから表形式のデータを抽出する方法が多数あります。Pipeline Builder、openpyxl ↗ などのオープンソースライブラリを使用する Python のファイルベースのトランスフォーム、Apache POI ↗ などのオープンソースライブラリを使用する Java のファイルベースのトランスフォームなどが利用できます。
これらの方法に加えて、Palantir は transforms-excel-parser というライブラリを提供しています。このライブラリは、適切なデフォルト動作を備えた Apache POI のラッパーで、transforms-java リポジトリで最小限の設定で簡単に使用できます。
このライブラリが提供する便利な機能や動作には、次のようなものがあります。
- スキーマが部分的に重複しているものの一貫していないファイルを含む入力データセットを処理し、テーブルのヘッダーからスキーマを推論します。
- ファイルをメモリーに読み込むのは1回だけで、複数のシート(または同じシート内の異なるテーブル)からデータを抽出し、結果を複数の出力データセットに書き込みます。
- 非表形式の「フォーム形式」のシート(データがラベルの上、下、または隣に配置されているシート)からのフィールド抽出を定義するための Fluent API を提供します。
- 「zip bomb」の誤検出や「最大バイト配列サイズ」の超過による失敗など、Apache POI でよく発生する問題を解消する適切なグローバルパラメーターを設定します。
ParseResultクラスのerrorDataframe()メソッドにより、フェイルファストとフェイルセーフの両方の動作をサポートします。このメソッドの結果は、実行時に確認してジョブを失敗させることも、別の出力に書き込んで非同期で確認することもできます。- インクリメンタル(差分処理)パイプライン向けの適切な設定オプションとユーティリティ関数を提供し、インクリメンタルバッチ間でスキーマが一貫しない場合など、よくあるエッジケースに対応します。
信頼できる唯一の情報源として使用するワークフローや非構造化 Excel ファイルについては、スプレッドシートメディアセットを参照してください。
セットアップ
1. transforms-excel-parser-bundle が利用可能か確認し、取得元リポジトリとして追加する
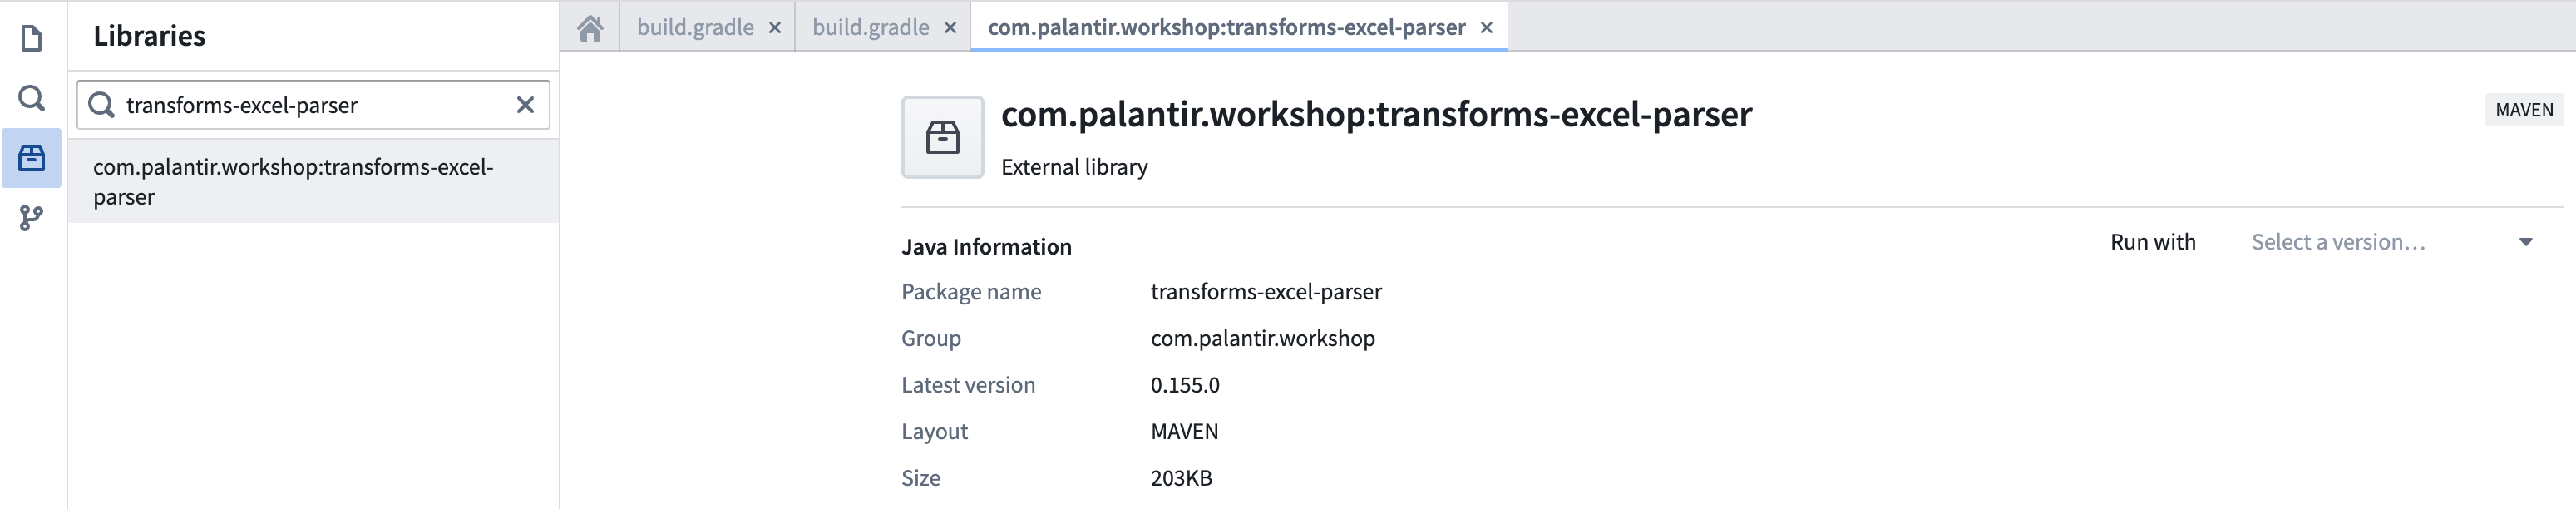
リポジトリの Maven ライブラリパネルで transforms-excel-parser を検索します。
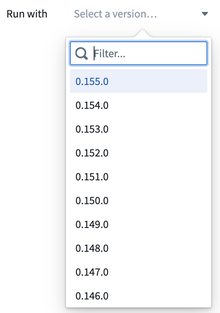
利用可能な最新バージョンを選択します。
追加の取得元リポジトリとして transforms-excel-parser-bundle をインポートするためのダイアログが表示されます。「ライブラリを追加」を選択します。
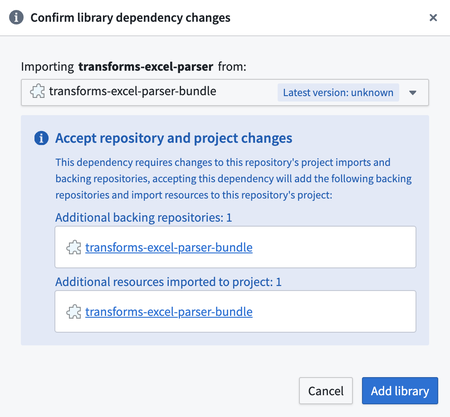
ドロップダウンの選択肢として、transforms-excel-parser-bundle に加えて eddie-spark-module-bundle や ri.eddie.artifacts.repository.bundles が表示される場合があります。
名前に eddie を含む取得元リポジトリは、Pipeline Builder アプリケーション専用です。そのため、これらは適切な選択肢ではなく、使用すると将来問題が発生する可能性があります。
選択肢に transforms-excel-parser-bundle が表示されない場合は、Palantir の担当者にインストールを依頼してください。
2. build.gradle に依存関係を追加する
transforms-java/build.gradle は隠しファイルのため、表示するには隠しファイルを表示の設定を有効にする必要があります。
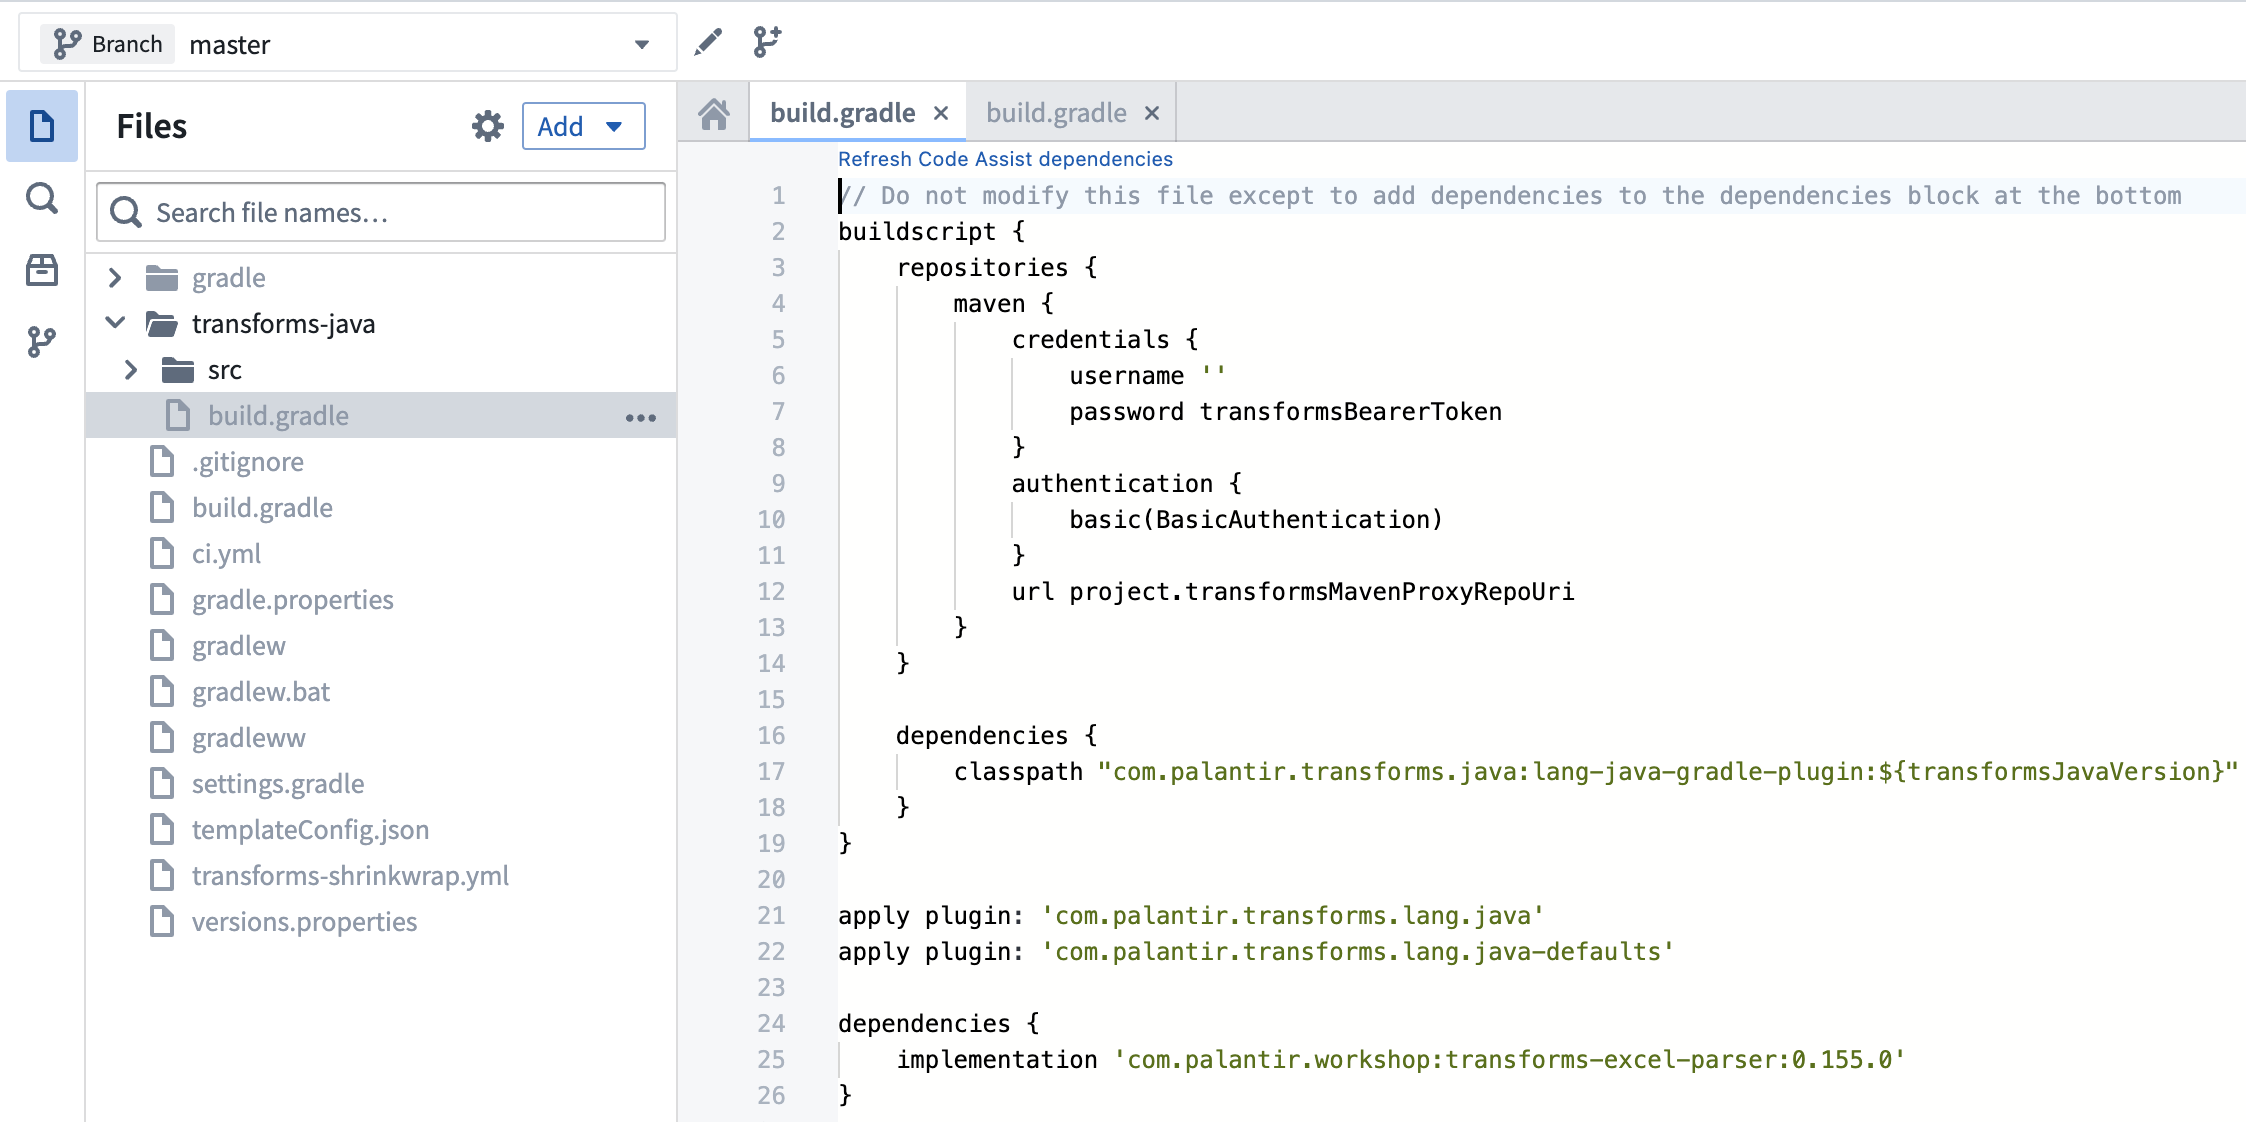
以下のように、利用可能な最新バージョンを transforms-java/build.gradle ファイルに追加します。
API ドキュメント
詳細な API ドキュメントを確認するには、javadoc アーカイブをダウンロードして展開し、含まれている HTML ファイルを Web ブラウザーで表示します。
javadoc を読む際は、まず com/palantir/transforms/excel/package-summary.html を参照することを推奨します。
既知の問題と注意事項
サポートされているファイル形式
現在、次のファイル形式がサポートされています。
- xls
- xlt
- xltm
- xltx
- xlsx
- xlsm
xlsb ファイルは現在サポートされていません。
Code Assist プレビューの不安定性
Code Assist プレビューを実行すると、ワークスペースの起動後の初回実行には成功するものの、2回目の実行には以下のようなエラーで失敗する問題が発生する場合があります。
java.lang.ClassCastException: class com.palantir.transforms.excel.KeyedParsedRecord cannot be cast to class com.palantir.transforms.excel.KeyedParsedRecord (com.palantir.transforms.excel.KeyedParsedRecord is in unnamed module of loader java.net.URLClassLoader @5a5d825a; com.palantir.transforms.excel.KeyedParsedRecord is in unnamed module of loader java.net.URLClassLoader @53dafc50)
この問題は Code Assist のプレビュー機能にのみ発生し、ビルド時の問題にはつながりません。 ブラウザーウィンドウを更新すれば、Code Assist ワークスペース全体を再ビルドせずに、再びプレビューできるはずです。
メモリー要件
Apache POI ライブラリはメモリー消費量が多いことで知られており、比較的小さな Excel ファイルでも、開くとかなりのメモリーを使用する場合があります。そのため、トランスフォームのデフォルトの Spark プロファイル設定では、メモリー内のオブジェクトを保持するために必要なタスクあたりのメモリーが不足することがよくあります。メモリー不足により、次の問題が発生する場合があります。
- トランスフォームジョブに、
Spark module '{module_rid}' died while job '{job_rid}' was using itのようなエラーで失敗します。 - トランスフォームジョブが長時間停滞し、成功も失敗もしません。
ジョブが停滞しているかを判断する大まかな目安は、1個のファイルの処理に10分を超える時間がかかるかどうかです。十分なメモリーがあれば、非常に大きな Excel ファイルでも約8分で処理できます。ただし、1個の Spark タスクで複数の入力ファイルを処理できるため、この基準を適用するのは必ずしも容易ではありません。
メモリー不足の症状がジョブの失敗であっても停滞であっても、EXECUTOR_MEMORY_LARGE と EXECUTOR_CORES_EXTRA_SMALL など、タスクあたりのメモリーを増やせる Spark プロファイルの組み合わせに切り替えて問題を解消することを推奨します。
使用例
単純な表形式の Excel ファイル
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52package myproject.datasets; import com.palantir.transforms.excel.ParseResult; import com.palantir.transforms.excel.Parser; import com.palantir.transforms.excel.TransformsExcelParser; import com.palantir.transforms.excel.table.SimpleHeaderExtractor; import com.palantir.transforms.excel.table.TableParser; import com.palantir.transforms.lang.java.api.Compute; import com.palantir.transforms.lang.java.api.FoundryInput; import com.palantir.transforms.lang.java.api.FoundryOutput; import com.palantir.transforms.lang.java.api.Input; import com.palantir.transforms.lang.java.api.Output; import java.util.Optional; import org.apache.spark.sql.Dataset; import org.apache.spark.sql.Row; public final class SimpleTabularExcel { @Compute public void myComputeFunction( @Input("<input_dataset_rid>") FoundryInput myInput, @Output("<output_dataset_rid>") FoundryOutput myOutput, @Output("<error_output_dataset_rid>") FoundryOutput errorOutput ) { // 適切に設定した SimpleHeaderExtractor を使用して TableParser を作成します // この例では、ファイルのヘッダーは2行目にあります。 // ヘッダーが1行目にある場合は、 // デフォルト値が0なので rowsToSkip を指定する必要はなく、実際には // その場合、単に TableParser.builder().build() とすることもできます。 Parser tableParser = TableParser.builder() .headerExtractor( SimpleHeaderExtractor.builder().rowsToSkip(1).build()) .build(); // TableParser を使用して TransformsExcelParser を作成します TransformsExcelParser transformsParser = TransformsExcelParser.of(tableParser); // 入力をパースします ParseResult result = transformsParser.parse(myInput.asFiles().getFileSystem().filesAsDataset()); // パースしたデータを取得します。入力に行がなかった場合、 // またはエラーが発生した場合は空になることがあります Optional<Dataset<Row>> maybeDf = result.singleResult(); // パースしたデータが空でなければ、出力データセットに書き込みます maybeDf.ifPresent(df -> myOutput.getDataFrameWriter(df).write()); // エラー情報をエラー出力に書き込みます errorOutput.getDataFrameWriter(result.errorDataframe()).write(); } }
複雑な複数行のヘッダーを持つ表形式の Excel ファイル
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50package myproject.datasets; import com.palantir.transforms.excel.ParseResult; import com.palantir.transforms.excel.Parser; import com.palantir.transforms.excel.TransformsExcelParser; import com.palantir.transforms.excel.table.MultilayerMergedHeaderExtractor; import com.palantir.transforms.excel.table.TableParser; import com.palantir.transforms.lang.java.api.Compute; import com.palantir.transforms.lang.java.api.FoundryInput; import com.palantir.transforms.lang.java.api.FoundryOutput; import com.palantir.transforms.lang.java.api.Input; import com.palantir.transforms.lang.java.api.Output; import java.util.Optional; import org.apache.spark.sql.Dataset; import org.apache.spark.sql.Row; public final class ComplexHeaderExcel { @Compute public void myComputeFunction( @Input("<input_dataset_rid>") FoundryInput myInput, @Output("<output_dataset_rid>") FoundryOutput myOutput, @Output("<error_output_dataset_rid>") FoundryOutput errorOutput ) { // MultilayerMergedHeaderExtractor を使用して TableParser を作成します Parser tableParser = TableParser.builder() .headerExtractor(MultilayerMergedHeaderExtractor.builder() .topLeftCellName("A1") .bottomRightCellName("D2") .build()) .build(); // TableParser を使用して TransformsExcelParser を作成します TransformsExcelParser transformsParser = TransformsExcelParser.of(tableParser); // 入力をパースします ParseResult result = transformsParser.parse(myInput.asFiles().getFileSystem().filesAsDataset()); // パースしたデータを取得します。入力に行がなかった場合、 // またはエラーが発生した場合は空になることがあります Optional<Dataset<Row>> maybeDf = result.singleResult(); // パースしたデータが空でなければ、出力データセットに書き込みます maybeDf.ifPresent(df -> myOutput.getDataFrameWriter(df).write()); // エラー情報をエラー出力に書き込みます errorOutput.getDataFrameWriter(result.errorDataframe()).write(); } }
フォームを含む Excel ファイル
この例では、複数の FormParser インスタンスを登録しますが、FormParser と TableParser のインスタンスを組み合わせて登録することもできます。これは、表形式の要素を含む複雑なフォームでよく使われるパターンです(同じシート内でも、複数のシートにまたがる場合でも使用できます)。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71package myproject.datasets; import com.palantir.transforms.excel.TransformsExcelParser; import com.palantir.transforms.excel.ParseResult; import com.palantir.transforms.excel.Parser; import com.palantir.transforms.excel.form.FieldSpec; import com.palantir.transforms.excel.form.FormParser; import com.palantir.transforms.excel.form.Location; import com.palantir.transforms.excel.form.cellvalue.AdjacentCellAssertion; import com.palantir.transforms.excel.form.cellvalue.CellValue; import com.palantir.transforms.excel.functions.RegexSubstringMatchingSheetSelector; import com.palantir.transforms.lang.java.api.Compute; import com.palantir.transforms.lang.java.api.FoundryInput; import com.palantir.transforms.lang.java.api.FoundryOutput; import com.palantir.transforms.lang.java.api.Input; import com.palantir.transforms.lang.java.api.Output; public final class FormStyleExcel { private static final String FORM_A_KEY = "FORM_A"; private static final String FORM_B_KEY = "FORM_B"; @Compute public void myComputeFunction( @Input("<input_dataset_rid") FoundryInput myInput, @Output("<form_a_output_dataset_rid>") FoundryOutput formAOutput, @Output("<form_b_output_dataset_rid>") FoundryOutput formBOutput, @Output("<error_output_dataset_rid>") FoundryOutput errorOutput) { // フォーム A のパーサー設定 Parser formAParser = FormParser.builder() .sheetSelector(new RegexSubstringMatchingSheetSelector("Form_A")) .addFieldSpecs(createFieldSpec("form_a_field_1", "B1")) .addFieldSpecs(createFieldSpec("form_a_field_2", "B2")) .build(); // フォーム B のパーサー設定 Parser formBParser = FormParser.builder() .sheetSelector(new RegexSubstringMatchingSheetSelector("Form_B")) .addFieldSpecs(createFieldSpec("form_b_field_1", "B1")) .addFieldSpecs(createFieldSpec("form_b_field_2", "B2")) .build(); // フォーム A とフォーム B の両方のパーサーを使用する TransformsExcelParser TransformsExcelParser transformsParser = TransformsExcelParser.builder() .putKeyToParser(FORM_A_KEY, formAParser) .putKeyToParser(FORM_B_KEY, formBParser) .build(); // 入力をパースします ParseResult result = transformsParser.parse(myInput.asFiles().getFileSystem().filesAsDataset()); // パースしたデータを出力データセットに書き込みます result.dataframeForKey(FORM_A_KEY) .ifPresent(df -> formAOutput.getDataFrameWriter(df).write()); result.dataframeForKey(FORM_B_KEY) .ifPresent(df -> formBOutput.getDataFrameWriter(df).write()); // エラー情報をエラー出力に書き込みます errorOutput.getDataFrameWriter(result.errorDataframe()).write(); } // 適切なアサーションを持つ FieldSpec を簡潔に作成するためのヘルパーメソッド private static FieldSpec createFieldSpec(String fieldName, String cellLocation) { return FieldSpec.of( fieldName, CellValue.builder() .addAssertions(AdjacentCellAssertion.left(1, fieldName)) .location(Location.of(cellLocation)) .build()); } }
複数の出力を伴うインクリメンタル処理
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69package myproject.datasets; import com.palantir.transforms.excel.ParseResult; import com.palantir.transforms.excel.Parser; import com.palantir.transforms.excel.TransformsExcelParser; import com.palantir.transforms.excel.functions.RegexSubstringMatchingSheetSelector; import com.palantir.transforms.excel.table.CaseNormalizationOption; import com.palantir.transforms.excel.table.SimpleHeaderExtractor; import com.palantir.transforms.excel.table.TableParser; import com.palantir.transforms.excel.utils.IncrementalUtils; import com.palantir.transforms.lang.java.api.*; public final class IncrementalTransform { @Compute public void myComputeFunction( @Input("<input_dataset_rid>") FoundryInput myInput, @Output("<sheet_1_output_dataset_rid>") FoundryOutput sheet1Output, @Output("<sheet_2_output_dataset_rid>") FoundryOutput sheet2Output) { // パーサーを定義します // CONVERT_TO_LOWERCASE または CONVERT_TO_UPPERCASE のいずれかを // CaseNormalizationOption に指定することは、インクリメンタル(差分処理)では特に重要です。 // インクリメンタルバッチ間で入力ファイルの大文字と小文字の使い方が // 一貫していないことによる、気づきにくい問題を避けるためです。 Parser sheet1Parser = TableParser.builder() .headerExtractor(SimpleHeaderExtractor.builder() .caseNormalizationOption(CaseNormalizationOption.CONVERT_TO_LOWERCASE).build()) .sheetSelector(new RegexSubstringMatchingSheetSelector("Sheet1")).build(); Parser sheet2Parser = TableParser.builder() .headerExtractor(SimpleHeaderExtractor.builder() .caseNormalizationOption(CaseNormalizationOption.CONVERT_TO_LOWERCASE).build()) .sheetSelector(new RegexSubstringMatchingSheetSelector("Sheet2")).build(); TransformsExcelParser transformsParser = TransformsExcelParser.builder().putKeyToParser("Sheet1", sheet1Parser) .putKeyToParser("Sheet2", sheet2Parser).build(); // データをパースします FoundryFiles foundryFiles = myInput.asFiles(); ParseResult result = transformsParser.parse(foundryFiles.getFileSystem(ReadRange.UNPROCESSED).filesAsDataset()); // エラーを確認し、即座に失敗させます // 特にインクリメンタル処理では、エラーのデータフレームを別の出力に書き込み、 // 非同期で確認するよりも、 // 即座に失敗させるほうがよい場合がよくあります。即座に失敗させることができず、 // 「エラーのデータフレームを別の出力に書き込む」方法を採用する場合は、 // ① パースエラーがあったファイルを入力データセットに再アップロードするか、 // ② 出力データセットのいずれかで手動のダミートランザクションを実行して、 // このトランスフォームの SNAPSHOT ビルドを強制する必要があることに注意してください。 // これにより、パースエラーがあったファイルの // 再処理をトリガーします。 if (result.errorDataframe().count() > 0) { throw new RuntimeException("Errors: " + result.errorDataframe().collectAsList().toString()); } // 可能な場合は APPEND トランザクションで、パースしたデータを出力にインクリメンタルに書き込みます // そうでない場合は、マージして置き換える SNAPSHOT トランザクションで書き込みます // 以下の実装は、指定されたファイルのインクリメンタルバッチで一部の // パーサーがデータを見つけられないことは通常であり、想定される動作であると仮定しています。そうでない // 場合は、一部のデータフレームが存在せず、 // 入力に未処理ファイルが1個以上あったときに例外を発生させることを検討してください。 // 結果が存在しないからといって、必ずしもエラーのデータフレームに // エラーが存在するとは限りません(たとえば、SheetSelector が空の // シートのコレクションを返しても、エラーとは見なされません)。 FilesModificationType filesModificationType = foundryFiles.modificationType(); result.dataframeForKey("Sheet1").ifPresent( dataframe -> IncrementalUtils.writeAppendingIfPossible(filesModificationType, dataframe, sheet1Output)); result.dataframeForKey("Sheet2").ifPresent( dataframe -> IncrementalUtils.writeAppendingIfPossible(filesModificationType, dataframe, sheet2Output)); } }
カスタムインターフェース実装
TableParser および FormParser ビルダーの設定メソッドの多くは、sheetSelector や headerExtractor など、引数のシグネチャでクラスではなくインターフェースを指定しています。そのため、RegexSubstringMatchingSheetSelector、SimpleHeaderExtractor、MultilayerMergedHeaderExtractor などの組み込み実装では不十分な場合に、カスタム実装を定義できます。また、これらのインターフェースの多くはメソッドが1個しかないため、このようにカスタム実装を定義する際は、通常 Java のラムダ式 ↗を使用できます。
たとえば、組み込みの MultilayerMergedHeaderExtractor では、左上と右下のセル名を静的に指定する必要があります。しかし、ヘッダーが始まる前の空の行数が、入力ファイル間で一貫していない場合があります。以下の例では、ヘッダーの開始位置を動的に特定し、その情報を使用して MultilayerMergedHeaderExtractor のローカルインスタンスを定義してから、そのローカルの MultilayerMergedHeaderExtractor の extractHeader メソッドを呼び出した結果を返す、HeaderExtractor インターフェースのカスタム実装を定義する方法を示します。
HeaderExtractor およびその他のインターフェースの詳細な定義については、API ドキュメントを参照してください。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86package myproject.datasets; import com.palantir.transforms.excel.ParseResult; import com.palantir.transforms.excel.Parser; import com.palantir.transforms.excel.TransformsExcelParser; import com.palantir.transforms.excel.table.HeaderExtractor; import com.palantir.transforms.excel.table.MultilayerMergedHeaderExtractor; import com.palantir.transforms.excel.table.TableParser; import com.palantir.transforms.excel.utils.WorkbookUtils; import com.palantir.transforms.lang.java.api.*; import org.apache.poi.ss.usermodel.Cell; import org.apache.poi.ss.usermodel.Row; import org.apache.poi.ss.usermodel.Sheet; import org.apache.poi.ss.util.CellReference; import org.apache.spark.sql.Dataset; import java.util.Optional; public class CustomHeaderExtractorUsageExample { private static Optional<String> getFirstCellValue(Sheet sheet, int rowIndex) { Row row = sheet.getRow(rowIndex); if (row == null) { return Optional.empty(); } Cell cell = row.getCell(0); if (cell == null) { return Optional.empty(); } String value = WorkbookUtils.getValueAsString(cell); if (value == null) { return Optional.empty(); } return Optional.of(value); } @Compute public void myComputeFunction( @Input("<input_dataset_rid>>") FoundryInput myInput, @Output("<output_dataset_rid>") FoundryOutput myOutput, @Output("<error_output_dataset_rid>") FoundryOutput errorOutput ) { HeaderExtractor headerExtractor = sheet -> { int rowsInSheet = sheet.getLastRowNum(); Integer firstHeaderRow = null; for (int currentRowIndex = 0; currentRowIndex < rowsInSheet; currentRowIndex += 1) { Optional<String> firstCellValue = getFirstCellValue(sheet, currentRowIndex); // 最初のセルの値が文字列 "record_id" である最初の行を探すことで、 // ヘッダーの開始位置を常に特定できると仮定します。 if (firstCellValue.isPresent() && firstCellValue.get().equals("record_id")) { firstHeaderRow = currentRowIndex; break; } } if (firstHeaderRow == null) { return Optional.empty(); } // ヘッダーの高さは常に2行であると仮定します。この仮定が // 成り立たない場合は、ファイルごとに高さの特定を試みる // 追加のロジックを実装することもできます。 int lastHeaderRow = firstHeaderRow + 1; return MultilayerMergedHeaderExtractor .builder() .topLeftCellName(new CellReference(firstHeaderRow, 0).formatAsString()) // ヘッダーの幅は常に5列であると仮定します(CellReference の // コンストラクターのインデックスは0始まりです)。この仮定が成り立たない場合は、 // ファイルごとに幅の特定を試みる追加のロジックを実装することもできます。 .bottomRightCellName(new CellReference(lastHeaderRow, 4).formatAsString()) .build() .extractHeader(sheet); }; Parser tableParser = TableParser.builder() .headerExtractor(headerExtractor) .build(); TransformsExcelParser transformsParser = TransformsExcelParser.of(tableParser); ParseResult result = transformsParser.parse(myInput.asFiles().getFileSystem().filesAsDataset()); Optional<Dataset<org.apache.spark.sql.Row>> maybeDf = result.singleResult(); maybeDf.ifPresent(df -> myOutput.getDataFrameWriter(df).write()); errorOutput.getDataFrameWriter(result.errorDataframe()).write(); } }