注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
監査ログ
監査ログは、Foundry で行われたすべての操作の包括的な記録を提供します。これにより、セキュリティチームは脅威の検出、インシデントの調査、コンプライアンスの確保、プラットフォーム全体での説明責任の維持を行えます。監査ログは、プラットフォーム内でユーザーが行ったすべての操作の要点をまとめた記録と考えることができます。多くの場合、詳細さと精度のバランスを取る必要があります。過度に詳細なログは、より多くの情報を含む一方で、内容の把握が難しくなることがあります。
監査ログに記録される内容
Foundry の監査ログには、セキュリティ調査やコンプライアンスレビューで重要となる次の問いに答えるために十分な情報が含まれています。
- 誰が操作を行ったか(ユーザーの ID、セッション、またはサービスアカウント)。
- 何の操作が行われたか(種類と意図による分類)。
- いつ操作が行われたか(時系列分析のための正確なタイムスタンプ)。
- どこで操作が行われたか(関係するリソースとシステム)。
監査ログには、氏名やメールアドレスなどの個人を特定できる情報 (PII) を含む、ユーザーに関するコンテキスト情報や、その他の機密性を持つ可能性のある利用データが含まれることがあります。そのため、監査ログの内容は機密情報として扱い、セキュリティ上必要な資格を持つ担当者のみが閲覧する必要があります。
監査ログを保持することは、プライバシーに関するベストプラクティスです。説明責任を果たせるワークフローには、誰が、何を、いつ行ったかを追跡できる記録が必要だからです。監査データ自体も機密性を持つ可能性があるため、監視ワークフローを設計する際は、利用目的に基づく最小権限のアクセスを適用し、プライバシーと市民的自由の実践を確認してください。
監査ログ(および関連する詳細情報)は、通常、顧客が所有するセキュリティ監視専用のシステム(「セキュリティ情報およびイベント管理」、つまり SIEM ソリューション)が利用可能であれば、そのシステムで取り込み、分析する必要があります。そのようなシステムが用意されていない場合でも、Foundry 自体に十分な柔軟性があるため、一部の軽量な SIEM 固有のワークフローをプラットフォーム内で直接実行できます。
このドキュメントでは、Foundry の監査ログへのアクセス、取り込み、分析の方法を説明します。
- 監査ログの配信:ログを SIEM に取り込む方法、または分析のために Foundry にエクスポートする方法。
- 監査スキーマ:フィールドの定義や保証事項を含む、監査ログの構造と内容。
audit.2からaudit.3への移行:既存のaudit.2の分析を新しいaudit.3スキーマに移行するためのガイダンス。
ほかにも、次のドキュメントを利用できます。
- カテゴリーに基づくクエリパターンについての監査ログのカテゴリーのドキュメント。
- 分析のベストプラクティスを含むセキュリティ監査ログの監視に関するドキュメント。
- SIEM 統合向けの
list-log-filesおよびget-log-file-content監査 API のドキュメント。
以下で紹介する仕組みを使用して、ご自身の監査ログを取り込み、監視することを強く推奨します。現在、新しい監査ログのアーカイブを audit.2 から audit.3 へ完全に移行する作業を進めているため、継続性を維持するには、すべての監査ログ分析で、新しく改善された audit.3 スキーマのログを使用する必要があります。Audit.3 ログは、SIEM で利用するために API 経由で取得することも、プラットフォーム内で分析するために Foundry にエクスポートすることもできます。追加のガイダンスについては、監査ログの監視に関するドキュメントを確認してください。
監査ログの配信
Foundry は、多様なセキュリティインフラストラクチャと SIEM の要件を満たすために、監査ログを配信する柔軟な仕組みを提供します。選択する配信方法は、組織の既存のセキュリティツールと分析ワークフローによって異なります。
配信方法を比較する
Audit.3 ログ(すべての新規実装に推奨):
Audit.3 スキーマログは、セキュリティ運用において大きな利点をもたらします。
- 低遅延: イベント発生から約15分以内に利用可能になり、タイムリーな脅威検知を実現します。
- API による直接アクセス: Foundry を仲介することなく、公開 API を通じて外部 SIEM に直接取り込めます。
- 構造化されたカテゴリー: 標準化されたカテゴリーの使用が強制されるため、自動分析で予測可能な構造を利用できます。
- 将来の変更への対応: Foundry の新しい機能では既存のカテゴリーが自動的に使用されるため、監視クエリを更新する必要がありません。
Audit.3 ログは、API を通じて SIEM で利用するか、必要に応じて Foundry データセットへの監査ログのエクスポートを通じて利用できます。
Audit.2 ログ(レガシー、履歴分析専用):
過去の audit.2 スキーマログは、約24時間以内に集約、圧縮され、環境に応じたログアーカイブストレージ(たとえば S3 バケット)に移動されます。これらのログには、次の特徴があります。
- 分析する前に Foundry データセットへエクスポートする必要があります。
- 外部 SIEM への API による直接取り込みをサポートしていません。
- カテゴリーの使用が任意であり、構造に一貫性がありません。
audit.3への移行前の期間の履歴分析にのみ使用してください。
Foundry は、Foundry への監査ログのエクスポートを通じて、アーカイブストレージから audit.2 ログを顧客に配信できます。
監査ログを SIEM に直接取り込む
外部 SIEM は、Palantir の監査 API エンドポイントである list-log-files と get-log-file-content を使用して、ストレージから audit.3 ログを直接取り込めます。これらのエンドポイントを使用するために、監査ログのエクスポート用データセットを作成する必要はありません。この方法には次の利点があるため、専用のセキュリティオペレーションセンターと確立された SIEM プラットフォームを持つ組織に適しています。
- 遅延を最小限に抑制: 15分以内に SIEM でログを利用できるため、脅威を迅速に検知して対応できます。
- ネイティブ統合: 既存のセキュリティツールやアラートワークフローにログが直接送られます。
- 仲介が不要: 最初に Foundry を経由してログを送る必要がなくなり、アーキテクチャが簡素化されます。また、Foundry 自体にエクスポートして分析しない場合は、監査ログのストレージやコンピューティングにかかる可能性のあるコストを削減できます。
- 標準プロトコル: 主要な SIEM プラットフォームの大半と統合できる、使い慣れた API パターンを使用します。
SIEM への取り込みは、過去の audit.2 ログと比べた audit.3 ログの利点です。audit.2 ログには、外部 SIEM による直接取り込みを可能にする公開 API がありません(audit.2 ログは、まず Foundry データセットにエクスポートし、そこから SIEM にエクスポートする必要があります)。
SIEM への取り込みのためのページネーションとポーリング
list-log-files エンドポイントは、トークンベースのページネーションを使用します。nextPageToken フィールドは、新しいログファイルが利用できないことを示すために data フィールドが空または省略されている場合でも、レスポンスに常に含まれます。
新しい監査ログを継続的にポーリングするには、次のステップに従います。
startDateと、任意でendDateを指定して、最初のリクエストを送信します。- レスポンスの
nextPageTokenを保存します。 - 以降のリクエストでは、保存した
nextPageTokenを指定して、前回の続きから再開します。前回のリクエスト以降に生成された新しいログファイルが返されます。 dataフィールドが空の場合、新しいログはまだありませんが、nextPageTokenは引き続き有効であるため、次のポーリングサイクル用に保存してください。
この設計により、SIEM 統合では、ログの取りこぼしや重複受信なしに任意の頻度でポーリングできます。endDate パラメーターを省略すると、エンドポイントは常に利用可能な最新のログを返すため、終了時点を定めずに継続的にポーリングする場合に適しています。
API アクセスの認証
監査 API エンドポイントにアクセスするには、SIEM のリクエストを認証する必要があります。一般的な推奨順に、次の方法を推奨します。ただし、最適な選択肢は、求めるセキュリティモデルによって異なります。
各 API リクエストに Authorization: Bearer <access_token> を含めます。
Control Panel で、ログを取得する組織の組織権限を開きます。トークンを使用するユーザーに、組織の監査ログを含むデータセットを作成ワークフローを含む既存のロールまたはカスタムロールを割り当てるよう、管理者に依頼してください。サービスアカウントを使用している場合、このロールが必要なのは、アプリケーション用に生成されたサービスユーザーです。
Developer Console アプリケーション(後述)の場合、監査ログの読み取りアクセスを設定し、api:audit-read OAuth スコープをリクエストすることに加えて、このロールの割り当てが必要です。これらの設定によって組織権限が付与されるわけではありません。この要件は、組織が1つだけのエンロールメントにも適用されます。
詳細については、権限のドキュメントを確認してください。
Developer Console を通じたサードパーティアプリケーション(推奨):
最も安全で保守しやすい方法は、Developer Console アプリケーションで、適切な監査ログ権限を持つサードパーティアプリケーションを作成することです。Developer Console では、オントロジー SDK と OAuth を使用して公開 API と通信するアプリケーションを作成、管理できます。
この方法には、次の利点があります。
- 監査ログへのアクセスに特化したスコープ付き権限。
- OAuth2 クライアント資格情報フローによるセキュリティの向上。
- 資格情報のローテーションと管理の簡素化。
- どのアプリケーションがログにアクセスしているかを示す明確な監査証跡。
セットアップ手順については、Developer Console のドキュメントとサードパーティアプリケーションのドキュメントを確認してください。
クライアント資格情報グラントでアプリケーションのクライアントIDとクライアントシークレットを使用し、api:audit-read スコープを持つアクセストークンをリクエストします。
OAuth2 クライアント資格情報:
Developer Console アプリケーションを使用できない場合、OAuth2 クライアント資格情報を使用すると、SIEM への自動取り込みに適した、プログラムによる安全な認証が可能です。
ユーザートークン(非推奨):
管理者ユーザートークンには次の制約があるため、本番環境の SIEM 統合では使用を避けてください。
- 個々のユーザーアカウントに紐づいており、運用上の依存関係が生じます。
- 必要以上に広い権限を持つ場合があります。
- サービスを中断せずにローテーションすることが困難です。
- 自動化システムで使用すると、監査証跡が不明確になります。
Foundry への監査ログのエクスポート
audit.2 と audit.3 のログはどちらも、Control Panel の監査ログツールを使用して、組織ごとに Foundry データセットへ直接エクスポートできます。この方法は、現在 SIEM ツールを使用していないものの、監査ログを分析する必要がある組織に適しています。
監査ログデータが Foundry データセットに取り込まれると、Foundry で直接分析できます。Pipeline Builder はプロトタイピングや基本的な簡易分析に使用でき、Code Repositories は膨大なデータ規模に対応できるため、長期的な分析に使用できます。監査ログデータセットは、事前に絞り込まないと Contour で効果的に分析するには大きすぎる場合があります。パイプラインを構築せずにエクスポート済みの audit.3 ログを検索して確認するには、Audit Explorer を使用します。Data Connection を使用して、Foundry から外部の SIEM にエクスポートすることもできます(監査ログ分析の最終的な宛先が SIEM の場合、audit.3 ログは公開 API を通じて直接取得する必要があります)。
エクスポート権限
監査ログをエクスポートするには、対象組織に対する audit-export:orchestrate-v3 操作権限(audit.3 用)が必要です。この権限は、Control Panel の組織権限タブで設定できる組織管理者ロールによって付与できます。詳細については、組織の権限のドキュメントを確認してください。
エクスポートのセットアップ
Foundry データセットへの監査ログのエクスポートを設定するには、次のステップに従います。
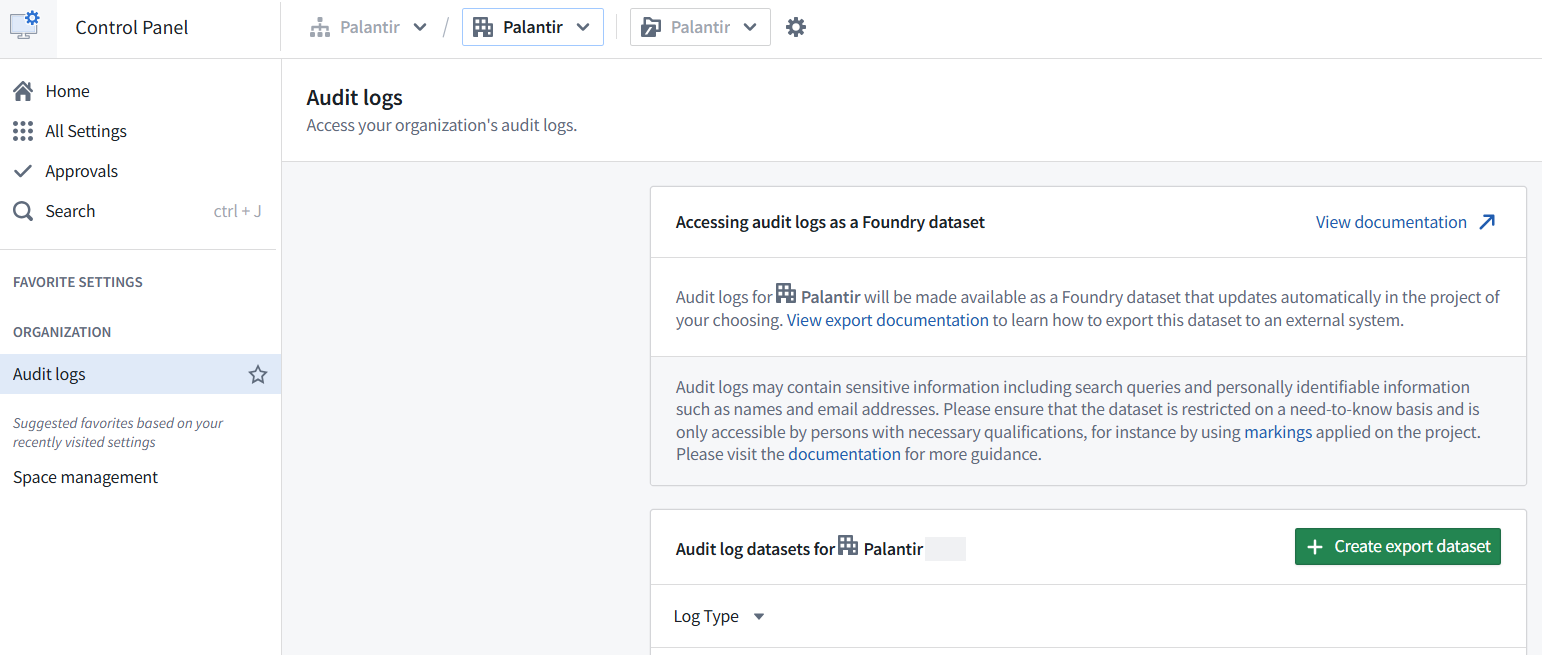
- Control Panel に移動します。
- 上部のツールバーで、ドロップダウンメニューから該当する組織が選択されていることを確認します。
- 左側のサイドバーで検索を選択し、監査ログを検索して選択します。
- エクスポートデータセットを作成を選択します。
- ログの種類を選択します。現在の監査ログの新しいスキーマを使用する場合は audit.3 を選択し、
audit.3スキーマへのアップグレード前の過去の監査ログを分析する必要がある場合は audit.2 を選択します。audit.2からaudit.3に移行する際は、重要な制限事項を確認してください。 - この監査ログデータセットを Foundry に保存するためのエクスポート先と名前を選択します。
- マーキング を使用して、機密性の高い監査ログデータセットへのアクセスを制限し、PII や検索クエリなどの機密性を持つ可能性のある使用状況の詳細を閲覧できる、業務上知る必要がある適格なプラットフォーム管理者を指定します。デフォルトでは、監査ログデータセットには上記で選択した組織のマーキングがつきます。詳細については、組織のマーキングのドキュメントを確認してください。
- 必要に応じて、開始日フィルターを有効にして、このデータセットを指定日以降に発生したイベントに限定します。
- 必要に応じて、データセット固有の保持ポリシーを有効にして、このエクスポートデータセットでログを保持する日数を制限します(最大730日)。保持ポリシーは、ログエントリ自体のタイムスタンプではなく、ログがエクスポートデータセットに追加された際のトランザクションのタイムスタンプに基づきます。該当するトランザクションが削除対象としてマークされてから、削除されるまでに最大7日かかる場合があります。実際の動作を次の2つの例で説明します。
- 例1:
- 開始日:2025-01-01
- 保持ポリシー:90日
- この場合、エクスポートデータセットには最初に2025年1月1日以降のログが含まれます。データセットの作成から90日後に保持ポリシーが適用され、最初にデータセットに含まれていた2025年1月初め以降のすべてのログではなく、過去90日間に追加されたログのみが保持されます。実際には、90日後に古いログが削除されると、データセットのサイズが大幅に減少します。
- 例2:
- 開始日:30日前
- 保持ポリシー:90日
- このシナリオでは、エクスポートデータセットは過去30日間のログから始まります。新しいログが追加されるにつれてデータセットは増大し、最新90日分のデータを常に保持するようになります。90日より前のトランザクションで追加されたログは、保持ポリシーに従って削除されます。
- 例1:
- データセットの作成に伴うセキュリティ上の影響と、監査ログのエクスポートデータセットに適用する設定を理解したことを了承し、エクスポートを作成を選択します。
エクスポートデータセットを更新または無効にする
エクスポートデータセットの更新:
- 大規模な環境では、
audit.2データセットのビルドにより、最初の数時間(またはそれ以上)に空の APPEND トランザクションが生成される場合があります。これは、パイプラインが監査ログの未処理分をすべて処理する際の想定された動作です。audit.3データセットの新しいエクスポートでは、この遅延は発生しません。 - 新しいログは、定期的にエクスポートデータセットに追加されます。1回の追加で取得されるログデータは、
audit.3データセットでは最大100 GiB(かつ10,000ファイル)、audit.2データセットでは最大10 GiB です。このような大量の追加が必要になるのは、通常、監査ログデータセットが最初に作成されたときのみです。 - 監査ログの各追加処理の実行時間は、監査ログデータセットに追加される新しいログの量に正比例します。
- エクスポートデータセットのビルドを制御するスケジュールは、audit-export サービスによって管理され、ユーザーには表示されません。
Audit.3エクスポートデータセットは、スキーマ内のdate列を Hive パーティション列として使用します。つまり、date列は通常のデータ列ではなくパーティションキーとして機能するため、クエリ時のデータの表示方法に影響します。たとえば、date値は日時型ではなく日付型の形式になります。Hive パーティション分割の主な利点は、アドホック分析で、タイムスタンプではなくdateで先に絞り込むと、Spark や通常のビルドでの参照が大幅に高速化されることです。
エクスポートデータセットの無効化:
Control Panel の監査ログアプリケーションから、監査ログのエクスポートデータセットを無効にできます。
- 該当する組織を選択し、監査ログページを開きます。
- エクスポートデータセットを見つけ、そのオプションメニューを開いてエクスポートを一時停止を選択すると、エクスポートが無効になります。
- 同じメニューからエクスポートを再開を選択すると、無効にしたエクスポートデータセットをいつでも再開できます。
監査スキーマ
Palantir 製品が生成するログは、すべて構造化ログです。つまり、ログは特定のスキーマに従っており、下流システムはそのスキーマに基づいて分析やアラートを自動化できます。
Palantir の監査ログは現在、従来の audit.2 スキーマと、改善された新しいスキーマである audit.3 の両方で配信されています。新しいイベントの Audit.2 ログはまもなくエクスポートできなくなり、このスキーマで利用可能なのは過去のログのみになります。新しいイベントはすべて、audit.3 スキーマでのみエクスポート可能になります。
audit.2 と audit.3 のどちらのスキーマでも、監査ログはログを生成する製品によって異なります。これは、製品ごとに扱うドメインが異なり、記述する必要がある事項も異なるためです。後述するように、この違いは audit.2 でより顕著です。
製品固有の情報は、主に audit.3 ログの requestFields と resultFields(または audit.2 ログの request_params と result_params)に記録されます。これらのフィールドの内容は、ログを記録する製品と記録されるイベントの両方に応じて形式が変わります。
監査ログのカテゴリー
Palantir のログでは、製品固有の知識がほとんどなくてもログを理解しやすくするために、監査ログのカテゴリーという概念を使用しています。カテゴリーを使うと、セキュリティアナリストは、サービス固有の何百ものイベント名を把握する必要がなくなり、ログを生成した製品や機能に関係なく、データの読み込み、権限の変更、認証の試行といった大まかな操作に注目できます。この抽象化により、アナリストは実装の詳細を理解することなく、Foundry のすべてのサービスで機能する監視クエリを作成できます。たとえば、dataExport で絞り込むと、データのエクスポートに使用された製品に関係なく、すべてのデータエクスポートイベントを抽出できます。
監査ログのカテゴリーを使用すると、監査ログは監査可能なイベントの和集合として記述されます。監査ログのカテゴリーは基本概念に基づいており、それらの概念に対する操作を記述するカテゴリーに分類されています。たとえば、次のようなものがあります。
| カテゴリー | 説明 | ユースケースの例 |
|---|---|---|
authenticationCheck | トークンの検証など、プログラムまたは手動による認証イベントを通じて認証ステータスを確認します。 | クレデンシャルスタッフィングを示唆するトークン検証のパターンを検出します。 |
dataCreate | それまで存在しなかった新しいデータエントリーがプラットフォームに追加されたことを示します。このイベントがデータの取り込み先のサービスで記録された場合、別のサービスでは dataPromote として反映されることがあります。 | データ作成のパターンを追跡し、ガバナンスポリシーを適用します。 |
dataDelete | 削除の粒度に関係なく、データの削除に関連します。 | 重要なリソースや保護されたリソースの削除についてアラートを発します。 |
dataExport | プラットフォームからのデータのエクスポートです。Palantir 外部のシステムへのエクスポートや CSV ファイルのダウンロードなど、プラットフォームからデータをダウンロードする場合に使用します。別の Palantir システムにデータをエクスポートした場合は、dataPromote category. を使用します。 | 大量のエクスポート、機密データのエクスポート、または営業時間外のエクスポートについてアラートを発します。 |
dataImport | プラットフォームへのインポートです。dataPromote とは異なり、dataImport はプラットフォームの外部から取り込まれるデータのみを指します。つまり、あるサービスの dataImport が、別のサービスでは dataPromote として表示されることがあります。 | 悪意のあるファイルのアップロードやポリシー違反を監視します。 |
dataLoad | ユーザーに返すデータの読み込みを指します。バックエンドのみで行われる読み込みには、internal を使用します。 | 通常のアクセスパターンのベースラインを確立し、異常な大量データアクセスを検出します。 |
tokenGeneration | 新しいトークンの生成につながる操作です。 | 大量データアクセスの準備を示す可能性がある、通常とは異なるトークン作成を検出します。 |
userLogin | ユーザーのログインイベントです。 | ログイン試行の失敗、通常とは異なるログイン時刻、または地理的な異常を監視します。 |
userLogout | ユーザーのログアウトイベントです。 | セッションの継続時間を追跡し、異常に長いセッションを特定します。 |
監査ログのカテゴリーにもバージョンの変更があり、audit.2 ログでの緩やかな形式から、audit.3 ログでのより厳格で豊富な形式に移行しました。audit.3 では、各ログにカテゴリーを1つ以上指定する必要があり、各カテゴリーで、どのリクエストフィールドと結果フィールドが含まれるかが厳密に定義されるため、自動分析の信頼性が大幅に向上します。
利用可能なカテゴリーとフィールドの仕様の詳細な一覧については、監査ログのカテゴリーのドキュメントを参照してください。また、カテゴリーの使用に関する追加のガイダンスについては、セキュリティ監査ログの監視のドキュメントも参照してください。
監査ログの帰属
監査ログは、環境ごとに1つのログアーカイブに書き込まれます。監査ログが配信パイプラインで処理される際に、ユーザーIDフィールド(以下のスキーマの uid と otherUids)が抽出され、ユーザーが対応する組織に対応付けられます。
特定の組織に対して実行される監査ログのエクスポートは、その組織に帰属する監査ログに限定されます。サービスユーザー(人間ではないユーザー)のみが実行した操作は、通常、どの組織にも帰属しません。これらのユーザーは組織のメンバーではないためです。ただし、クライアント資格情報による認可を使用するサードパーティアプリケーションのサービスユーザーで、登録した組織のみが使用する場合は例外で、その組織に帰属する監査ログが生成されます。
Audit.3 ログ
新しいログのエクスポートや分析には、audit.2 ログではなく audit.3 ログを使用してください。
Audit.3 ログは、audit.2 ログに比べて多くの利点を持つ新しいログスキーマに基づいています。新しいスキーマと関連する配信パイプラインが監査ログの利用者にもたらす主な利点は、次のとおりです。
- 配信の高速化: 24時間を超える可能性があった遅延が15分以下に短縮され、ほぼリアルタイムでの脅威検出が可能になります。
- 構造化されたカテゴリー: 必須の、文書化されたカテゴリーによって、分析のための予測可能な構造が提供されます。これにより、ログの内容について推論する際に、個々の製品を理解する必要性が減ります。特に、分析の対象がワークフロー全体に及ぶ場合(たとえば
dataExport)に役立ちます。 - トップレベルのフィールドの強化:
productなどの新しいフィールドにより、製品名での絞り込みが容易になります。単一製品の使用状況に分析対象を絞るために、複雑なイベント名マッピングフィルターを使用する必要がなくなります。 - API への直接アクセス: 公開 API が利用可能になり、Foundry を仲介させることなく、監査ログを外部の SIEM に取り込めます。
- コンテキストの充実: 配信時に抽出された、ユーザー、リソース、関係についての追加のコンテキスト情報を利用でき、下流での分析が容易になります。
スキーマの保証事項
Audit.3 ログは、次の保証事項を念頭に置いて生成されます。
- 明示的なカテゴリー定義: 各監査カテゴリーは、適用対象となる値や項目を明示的に定義します。たとえば、
dataLoadは、読み込まれるリソースを正確に記述します。 - カテゴリーの和集合: 各ログは、監査カテゴリーの和集合として厳密に生成されます。つまり、ログには自由形式のデータが含まれず、予測可能な構造が保証されます。
- 主要情報の昇格: 監査ログ内の特定の重要な情報は、
audit.3スキーマのトップレベルに昇格されます。たとえば、名前付きリソースはすべて、リクエストと結果のフィールド内だけでなく、トップレベルにも存在します。
これらの保証事項により、どのログについても、(1)そのログを作成した監査可能なイベントと、(2)そのログに含まれる正確なフィールドを特定できます。これらの保証事項は製品に依存しないため、セキュリティアナリストは、すべての Foundry サービスで機能する監視クエリを作成できます。
Audit.3 スキーマリファレンス
audit.3 ログスキーマを以下に示します。
| フィールド | データ型 | 説明 |
|---|---|---|
categories | set<string> | この監査イベントによって生成されたすべての監査カテゴリー。 |
entities | list<any> | このログのリクエストと結果のフィールドに存在するすべてのエンティティ(リソースなど)。 |
environment | optional<string> | このログを生成した環境。 |
eventId | uuid | 監査可能なイベントの一意の識別子。同じイベントに属するログ行をグループ化するために使用できます。たとえば、大きなバイナリレスポンスが利用者にストリーミングされる場合、その開始時と終了時に出力される行には、同じ eventId が記録されます。 |
host | string | このログを生成したホスト。 |
logEntryId | uuid | この監査ログ行の一意の識別子。システム内のほかのログ行と重複しません。Foundry への取り込み中に一部のログ行が重複し、同じ logEntryId を持つ行が複数存在する場合があります。同じ logEntryId を持つ行は重複しているため、無視できます。 |
name | string | 監査イベントの名前。通常は、すべて大文字のスネークケースで (product name)_(endpoint name) という構造に従います。例:DATA_PROXY_SERVICE_GENERATED_GET_DATASET_AS_CSV2。 |
orgId | optional<string> | 利用可能な場合、uid が所属する組織。 |
origin | optional<string> | ベストエフォートで特定された、発信元マシンの識別子。たとえば、IP アドレス、Kubernetes のノード識別子、または同様のものです。この値は偽装される可能性があります。 |
origins | list<string> | リクエストヘッダーによって特定された、ネットワークリクエストの発信元。この値は偽装される可能性があります。 ユーザーが開始したリクエストの監査ログを特定するには、 origins が空でない監査ログに絞り込みます。origins が空の監査ログは、ユーザーが開始したリクエストを処理する際に Palantir のバックエンドが行った、サービスが開始したリクエストに対応します。origins が空でない監査ログの categories に apiGatewayRequest が含まれている場合、関連するリクエストは API ゲートウェイによって処理されています。ユーザーが開始したリクエストを処理するために API ゲートウェイが行ったリクエストの監査ログを見つけるには、同じ traceId を持ち、userAgent がこの監査ログの service で始まるログに絞り込みます。 |
product | string | このログを生成した製品。 |
producerType | AuditProducer | この監査ログがどのように生成されたか。たとえば、バックエンド(SERVER)またはフロントエンド(CLIENT)から生成されたかを示します。 |
productVersion | string | このログを生成した製品のバージョン。 |
requestFields | map<string, any> | メソッドの呼び出し時に判明しているパラメーター。 リクエストと結果のフィールド内のエントリーは、上記で定義した categories フィールドによって異なります。 |
result | AuditResult | リクエストが成功したかどうか、または失敗の種類を示します。たとえば、ERROR または UNAUTHORIZED です。 |
resultFields | map<string, any> | メソッド内で導出された情報。通常は戻り値の一部です。 |
sequenceId | optional<integer> | 同じ eventId を共有するイベントの順序をベストエフォートで示すフィールド。 |
service | optional<string> | このログを生成したサービス。 |
sid | optional<SessionId> | 利用可能な場合、セッションID。 |
sourceOrigin | optional<string> | TCP スタックによって特定された、ネットワークリクエストの発信元。 |
stack | optional<string> | このログが生成されたスタック。 |
time | datetime | RFC3339Nano 形式の UTC 日時文字列。例:2025-11-13T23:20:24.180Z。 |
tokenId | optional<TokenId> | 利用可能な場合、API トークンID。 |
traceId | optional<TraceId> | 利用可能な場合、Zipkin の Trace ID。 |
uid | optional<UserId> | 利用可能な場合、ユーザーID。最も下流の呼び出し元です。 |
userAgent | optional<string> | このログの発生元となったユーザーのユーザーエージェント。 |
users | set<ContextualizedUser> | この監査ログに存在するすべてのユーザー。ContextualizedUser:フィールド:
|
現在の audit.3 パイプラインでは、uid フィールドのみが設定されます。userName、firstName、lastName、realm の各フィールドは設定されず、groups は常に空です。これらのフィールドを設定するには、IDプロバイダーに対するリアルタイムの参照が必要ですが、これは audit.3 パイプラインの低遅延設計と両立しません。監査ログにユーザープロフィール情報を追加するには、Foundry パイプラインの下流でユーザーディレクトリデータを参照してください。
特定のアプリケーションを分析する際には、通常、不変の product スキーマフィールドを使用して監査ログを絞り込むことを推奨します。service フィールドは、同じ製品の異なるインスタンスを区別して絞り込めるため、利用者にとって役立つ場合があります。特定のインシデントをより詳細に理解するうえで有用な可能性があります。
Audit.2 ログ
audit.2 ログは、新しい audit.3 ログの記録が開始される前の期間を分析する場合にのみ使用してください。audit.2 スキーマのログとして新しいイベントをアーカイブする機能はまもなく非推奨になるため、audit.2 から audit.3 に移行する際は、重要な制限事項を参照してください。Audit.2 ログでは、リクエストパラメーターや結果パラメーターの形式について、製品間での保証はありません。そのため、監査ログについての推論は、通常、製品ごとに行う必要があります。
Audit.2 ログには、検索を絞り込むのに役立つ監査カテゴリーが含まれる場合があります。ただし、このカテゴリーにはそれ以上の情報は含まれておらず、監査ログの残りの内容を規定するものでもありません。また、audit.2 ログに監査カテゴリーが含まれることは保証されません。カテゴリーが存在する場合は、request_params 内の _category または _categories フィールドに含まれます。
audit.2 ログのエクスポートデータセットのスキーマを以下に示します。
| フィールド | データ型 | 説明 |
|---|---|---|
filename | .log.gz | ログアーカイブ内の圧縮ファイルの名前。 |
ip | string | ベストエフォートで特定された送信元 IP アドレス。 |
name | string | PUT_FILE などの監査イベントの名前。 |
request_params | map<string, any> | メソッドの呼び出し時点で判明しているパラメーター。 |
result | AuditResult | イベントの結果(成功、失敗など)。 |
result_params | map<string, any> | メソッド内で導出された情報。通常は戻り値の一部です。 |
sid | optional<SessionId> | セッションID(利用可能な場合)。 |
time | datetime | RFC3339Nano 形式の UTC 日時文字列。例:2025-11-13T23:20:24.180Z。 |
token_id | optional<TokenId> | API トークンID(利用可能な場合)。 |
trace_id | optional<TraceId> | Zipkin Trace ID(利用可能な場合)。 |
type | string | 監査スキーマのバージョンを指定します:"audit.2" |
uid | optional<UserId> | ユーザーID(利用可能な場合)。最も下流の呼び出し元です。 |
audit.2 から audit.3 に移行する
現在、セキュリティ監視やコンプライアンスのために audit.2 ログを使用している組織は、分析を audit.3 スキーマに移行する必要があります。このセクションでは、audit.3 の改善点を活用できるように、監査ログのワークフローを移行するためのガイダンスを提供します。
audit.2 と audit.3 の差異
audit.3 スキーマは、単なるバージョン更新ではなく、audit.2 からの根本的なアーキテクチャ変更です。移行に影響する主な差異について、以下のセクションで説明します。
フィールド名と構造の変更
audit.2のrequest_paramsとresult_paramsは、audit.3ではそれぞれrequestFieldsとresultFieldsという名前になっています。requestFieldsとresultFieldsの内容は、通常、audit.2の対応するフィールド(request_paramsとresult_params)とはまったく異なります。audit.2のrequest_paramsにあった情報が、audit.3ではresultFieldsに含まれる場合や、その逆の場合があります。audit.3で特定の情報を探す際は、必ずrequestFieldsとresultFieldsの両方を確認してください。- トップレベルの
typeフィールドは、ログを生成したスキーマが"audit.2"と"audit.3"のどちらであるかを示します。
イベント名の変更
- イベント名(
nameフィールド)はスキーマ間で異なる場合があり、パース処理が特定のイベント名に依存していると、不一致が生じる可能性があります。 - audit.3 のイベント名は、より標準化されており、通常は「製品名_エンドポイント名」という構造で、すべて大文字のスネークケースになっています。例:
DATA_PROXY_SERVICE_GENERATED_GET_DATASET_AS_CSV2。 audit.2とaudit.3のすべてのイベント名が直接1対1で対応しているわけではありませんが、ほとんどのaudit.2ログのイベント名は、audit.3に容易に対応付けられます。- 推奨アプローチ: 今後のクエリでは、特定のイベント名ではなく監査カテゴリーを使用します。カテゴリーは、両方のスキーマにわたって一貫した抽象化を提供するためです(ただし、
audit.2でのカテゴリーの使用は任意です)。
新しい機能
audit.3には、標準化された値の使用が強制される、トップレベルのcategoriesフィールドがあります。audit.3では、product、service、entities、usersなどの新しいフィールドを利用でき、絞り込みが容易になります。audit.3で利用可能なusersフィールドには、ログエントリに関連付けられたすべてのユーザーのユーザーIDが含まれます。追加のユーザープロフィールフィールド(userName、firstName、lastName、groups、realm)はスキーマで定義されていますが、現在は値が格納されません。必要に応じて、下流でこれらの情報を補完してください。
重要な制限事項
- 過去のデータのバックフィルなし:
Audit.3は、有効化された後に発生したイベントのみを記録します。過去のイベントは、audit.2ログスキーマにのみ保持されます。
一般提供に向けた準備として2025年11月24日から25日にかけて実施されたインフラストラクチャの更新により、一部のエンロールメントでは、audit.3 ログを利用できない期間が約3時間発生した可能性があります。この期間の分析要件を満たすために、代替として audit.2 ログを使用し、2025年12月4日以降の分析については audit.3 に完全に移行することを推奨します。
- 並列ログ出力期間: 移行期間中は両方のスキーマでログが出力されるため、完全に切り替える前に検証できます。
移行パス
audit.2 ログに基づく既存の分析がある場合、移行方法は現在どこで分析を行っているかによって異なります。以下から分析方法に該当するセクションを選び、そのステップに沿って進めてください。
外部 SIEM を使用している場合
Foundry のエクスポートデータセットを引き続き使用するのではなく、API から直接取り込む方法に移行することを強く推奨します。この方法には、次の利点があります。
- 大幅な低遅延化:
audit.2では24時間以上かかるのに対し、約15分以下です。 - よりシンプルなアーキテクチャ: Foundry を中継する必要がなくなり、遅延や障害が発生する箇所を減らせます。
- ネイティブな SIEM 統合: 完全なログが既存のセキュリティツールに直接流れ込みます。
移行ステップ:
list-log-filesおよびget-log-file-content監査 API エンドポイントから取り込むように SIEM を設定します。- 新しい
audit.3スキーマ構造を処理できるようにパースルールを更新します(以下のセクションを参照)。 - 可能な場合はイベント名ではなくカテゴリーを使用するように、検知ルールを更新します。
- 検証期間中は、既存の
audit.2の取り込みと並列で実行します。 - アラートと検知のワークフローを十分にテストします。
- 検証が完了したら、
audit.2の Foundry エクスポートと SIEM への取り込みを廃止します。
Foundry でログを分析している場合
- エクスポートのセットアップ手順に従い、Control Panel で新しい
audit.3エクスポートデータセットを作成します。 - 移行期間中は、既存の
audit.2エクスポートデータセットの実行を継続します。 - 新しい Global Branch を作成し、PR をまとめて移行を実施します(必要に応じて、複数のコードリポジトリにまたがる PR をまとめます)。
- Data Lineage アプリケーションで、Foundry 内の
audit.2データの下流での使用状況を表示し、どの分析が非推奨で、どの分析を移行する必要があるかを把握します。 - 以下のリファクタリングのステップに従い、分析を更新します。
カテゴリーベースの分析パターンを特定する
イベント名ごとに分析を移行するのではなく、個々の製品のイベント名の代わりに、標準化された監査カテゴリーを使用するように分析をリファクタリングします。
従来のアプローチ(audit.2):
Copied!1 2 3 4# 変更に弱い:変更される可能性のある特定のイベント名に依存します export_events = audit_logs.filter( col("name").isin(["EXPORT_DATASET", "DOWNLOAD_FILE", "CREATE_EXTERNAL_CONNECTION"]) )
新しいアプローチ(audit.3):
Copied!1 2 3 4# 変更に強い: 標準化されたカテゴリーを使用します export_events = audit_logs.filter( col("categories").contains("dataExport") )
このカテゴリーベースのアプローチには、いくつかの利点があります。
- 将来の変更に対応: 今後リリースされる新しいエクスポート機能では、
dataExportカテゴリーが使用されます。 - 網羅的: すべてのイベント名を列挙することなく、すべてのエクスポートの仕組みを捕捉できます。
- 製品横断: すべての Foundry サービスで一貫して機能します。
移行期間中に検証する
並列ログ出力期間中は、次の作業を行います。
audit.2とaudit.3の両方のデータソースに対して、分析を並列で実行します。- 出力を比較して、
audit.3の分析が期待されるイベントを捕捉していることを確認します。 - カテゴリーベースのフィルターが、イベント名のフィルターと同等以上の範囲をカバーしていることを確認します。
- SIEM ユーザーの場合:
audit.3データに対してアラートが正しく発報されることを検証します。
切り替えを完了する
audit.3 の分析が同等以上の範囲をカバーしていることを検証したら、次の作業を行います。
- 下流のすべての利用先を、
audit.3API またはデータセットを使用するように切り替えます。 - Control Panel の監査ログアプリケーションから、
audit.2エクスポートデータセットを無効にします(Foundry エクスポートを使用している場合)。手順については、エクスポートデータセットの無効化を参照してください。 - SIEM から
audit.2の取り込みを削除します(外部 SIEM を使用している場合)。 - 新しい
audit.2ログの生成を停止した後も、過去のaudit.2ログには引き続きアクセスできます。過去にさかのぼる分析や調査では、audit.2(過去)とaudit.3(現在)のログをそれぞれ別々にクエリする必要があります。詳細については、重要な制限事項を参照してください。
移行時によくある課題
課題:イベント名がない
audit.2 の一部のイベント名には、audit.3 で直接対応するものがない場合があります。これは通常、次の場合に発生します。
- イベントが非推奨になったか、新しいエンドポイントに置き換えられた場合。
- イベントの有用性が低く、意図的に
audit.3に移植されなかった場合。
解決策
- 現在の
audit.2ログで、そのイベントが引き続き発行されていることを確認します。 - 発行されている場合は、
audit.2ログのtraceIdフィールドを使用して、audit.3データセット内で関連する可能性のある監査ログを探します。 - 対応するものが見つからない場合は、Palantir サポートチームにお問い合わせください。
課題:ネストされたリクエスト/結果フィールドを展開する
requestFields と resultFields の構造は、複雑で製品固有の場合があり、audit.2 と audit.3 で異なります。
解決策
- 分析で
audit.2のrequest_paramsまたはresult_paramsを展開しており、この粒度の詳細が分析で重要な場合は、audit.3の新しいフィールド構造に合わせて、このロジックをリファクタリングする必要があります。audit.2と比べて、情報がリクエストフィールドと結果フィールドの間で移動している可能性があるため、audit.3では必ずrequestFieldsとresultFieldsの両方を確認してください。 - 監査カテゴリーのドキュメントを使用して、各カテゴリーで保証されるフィールドを把握します。
- 可能な場合は、リクエスト/結果フィールドをパースするよりも、最上位のフィールド(
entities、users、categoriesなど)を優先します。 - フィールドがない場合や予期しないフィールドがある場合にも適切に対処できる、堅牢なパースロジックを作成します。
課題:切り替え日をまたぐ継続性
過去の audit.2 データと現在の audit.3 データの両方にまたがる期間を分析する必要があります。詳細については、重要な制限事項を参照してください。
解決策
- SIEM での分析の場合:移行中は並列で取り込みを維持し、その後は SIEM の履歴データ保持機能を利用して
audit.2ログを保持します。 - Foundry での分析の場合:
audit.2とaudit.3のデータセットを縦結合する統合ビューを作成します。 - 必要に応じて
typeフィールドを使用し、スキーマ固有のパースロジックを適用します(たとえば、絞り込みにはaudit.3ではカテゴリーを、audit.2では name/result_params を使用します)。 - スキーマの違いにより、一部のメトリクスでは完全な継続性を確保できない場合があります。
その他のリソース
- カテゴリーに基づくクエリパターンについては、監査ログのカテゴリーのドキュメントを参照してください。
- 分析のベストプラクティスについては、セキュリティ監査ログを監視するドキュメントを参照してください。
- Foundry でエクスポートされた
audit.3ログを検索して確認するには、Audit Explorer のドキュメントを参照してください。 - SIEM 統合の詳細については、
list-log-filesおよびget-log-file-contentの監査 API ドキュメントを参照してください。 - 製品固有の移行について質問がある場合は、Palantir サポートチームにお問い合わせください。