注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
機密情報区分ベースのアクセス制御
機密情報区分ベースのアクセス制御は、Foundry ではデフォルトで有効になっていません。機密情報区分マーキングは機関によって異なる場合があるため、Palantir 環境ごとに異なる設定にすることができます。機密情報区分マーキングの設定には、Palantir の関与が必要です。
機密情報区分ベースのアクセス制御(CBAC)は、政府の機密情報を保護するために使用される強制アクセス制御です。機密情報区分マーキングとも呼ばれる CBAC マーキングは、情報にアクセスするユーザーに特定の機密情報区分マーキングを要求することで、アクセスを制限します。
機密情報区分マーキングへのアクセスは、Palantir プラットフォーム外で行われるセキュリティクリアランスのプロセスと関連する場合があります。強制アクセス制御全般と同様に、機密情報区分マーキングは、リソースに適用される任意のロールや必須マーキングなどのほかのアクセス要件と組み合わせることができます。
機密情報区分マーキングの主な特性
機密情報区分マーキングに固有の、注目すべき特性が3つあります。
- 階層: 機密情報区分マーキングの一般的なユースケースは、機密性が階層的に定義されている機密情報へのアクセスを制限することです。たとえば、Secret 以下のマーキングがついた機密データにのみアクセス資格を持つユーザーグループがあるとします。別のユーザーグループは、Top Secret 以下のマーキングがついた機密情報へのアクセス資格を持つことができ、その情報には Secret のデータも含まれます。
- 機密情報区分マーキングの論理和要素: 機密情報区分以外のマーキングは論理積として機能し、ユーザーがアクセスするには、リソースに適用されているすべてのマーキングを持つ必要があります。機密情報区分マーキングには論理和の構成要素を含めることができ、その構成要素に含まれるグループのいずれかに属するユーザーは、CBAC のアクセス条件を満たすことができます。これは一般に、異なる組織や国の間での共有など、開示可能範囲を定義するために使用されます。たとえば、
country Aまたはcountry Bのいずれかのユーザーは、機密情報区分マーキングの論理和要素を満たすことができます(下記を参照)。 - 機密情報区分マーキングの遍在性: CBAC の強制アクセス制御を使用する環境では、すべてのプロジェクトにプロジェクトの機密情報区分を設定する必要があります。さらに、すべてのデータセットにデータの機密情報区分が必要となるため、生データセット(入力のないデータセット)にはファイルの機密情報区分が必要です。
主要な概念
機密情報区分マーキング
機密情報区分マーキングはカテゴリーごとに設定されます。たとえば、あるカテゴリーではデータの種類を定義し、別のカテゴリーではそのデータの配布方法(つまり共有方法)を記述できます。
機密情報区分には、複数の機密情報区分マーキングを設定できます。また、異なるカテゴリーの機密情報区分マーキングで構成することもできます。機密情報区分マーキングの有効な組み合わせを定めるルールは、Palantir が設定し、プラットフォームで適用できます。
論理積と論理和の機密情報区分マーキングカテゴリー
機密情報区分マーキングカテゴリーを特徴づける機能として、論理和(OR)の動作をサポートできます。カテゴリーが論理積(AND)の場合、機密情報区分が設定されたデータにアクセスするには、そのカテゴリーで使用されているすべての機密情報区分マーキングへのアクセス権が必要です。カテゴリーが論理和の場合、そのカテゴリーのいずれか1個のマーキングへのアクセス権があれば、マーキングがついた機密情報区分付きデータへのアクセスが認められます。
機密情報区分全体の構成要素は、論理積で結合されます。つまり、機密情報区分に複数のカテゴリーの機密情報区分マーキングが含まれる場合、データにアクセスするには、機密情報区分マーキングの各カテゴリーに含まれるすべての構成要素の要件を満たす必要があります。
カテゴリーが1個、機密情報区分マーキングが2個のシンプルな設定を考えてみます。次のシンプルな設定には、Martha Washington(mwashington)と John Adams(jadams)の2人のユーザーがいます。
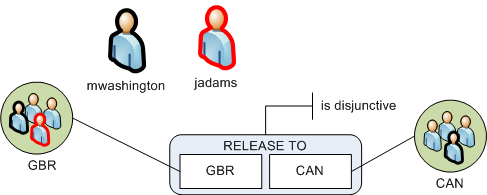
ユーザー mwashington は、GBR と CAN の両方の機密情報区分マーキンググループに属しています。ユーザー jadams は、GBR グループのみに属しています。共有先カテゴリーは論理和であるため、ユーザーには1個以上のマーキングへのアクセス権が必要です。論理和のカテゴリーでは、機密情報区分マーキングのうち1個のマーキングへのアクセス権があるユーザーは、同じカテゴリーのほかのマーキングもついているデータを閲覧できます。つまり、GBR、CAN の機密情報区分が設定されたデータは、mwashington と jadams のどちらも閲覧できます。両方のユーザーが、これらのマーキングのうち1個以上へのアクセス権を持っているためです。
上の例では、単独のカテゴリーを取り上げました。実際には、機密情報区分マーキングに複数のカテゴリーのマーキングを含めることができます。
ファイルとデータの機密情報区分
ファイルの機密情報区分は、ユーザーがファイルを発見するために満たす必要がある機密情報区分です。この制限は、プロジェクトの機密情報区分や、プロジェクトまたはファイルの必須マーキングなど、ほかの要件に加えて適用されます。
データの機密情報区分は、データセットなど、特定の種類のファイルに適用されます。データの機密情報区分とは、ユーザーがファイル内のデータを閲覧するために満たす必要がある機密情報区分です。ユーザーはファイル内のデータを閲覧するためにデータの機密情報区分の要件を満たす必要がありますが、データセットの存在を発見し、そのメタデータ(名前、説明、スキーマなど)を閲覧できるかどうかには影響しません。データの機密情報区分は直接編集できません。代わりに、次の情報を組み合わせて形成されます。
- リソースのファイルの機密情報区分(設定されている場合)。
- すべての上流のデータ依存関係のデータの機密情報区分。
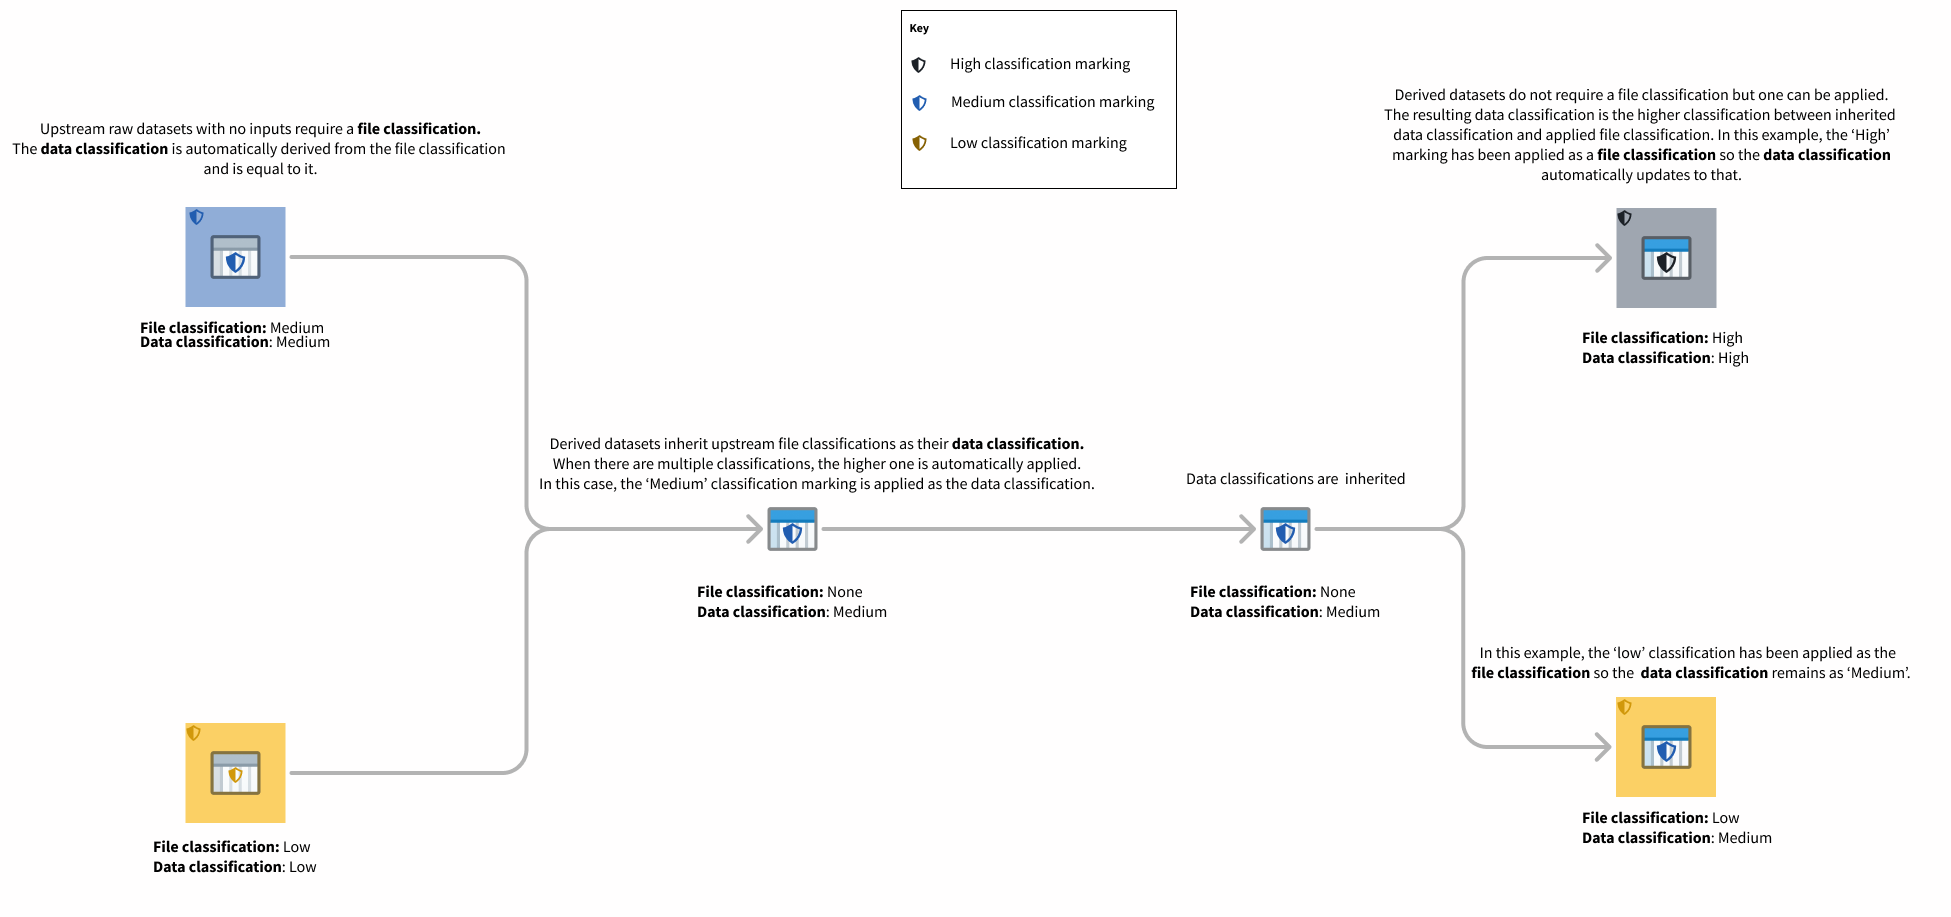
つまり、データの機密情報区分は常に、ファイルの機密情報区分およびすべての上流のデータ依存関係のデータの機密情報区分と同等か、それ以上に厳格です。
ファイル、データ、プロジェクトの機密情報区分は、適用されるほかのアクセス要件とともに Palantir プラットフォーム上に表示されます。自動的に継承されるデータの機密情報区分とは異なり、ファイルの機密情報区分は、以下に示すようにリソースのサイドバーで編集できます。
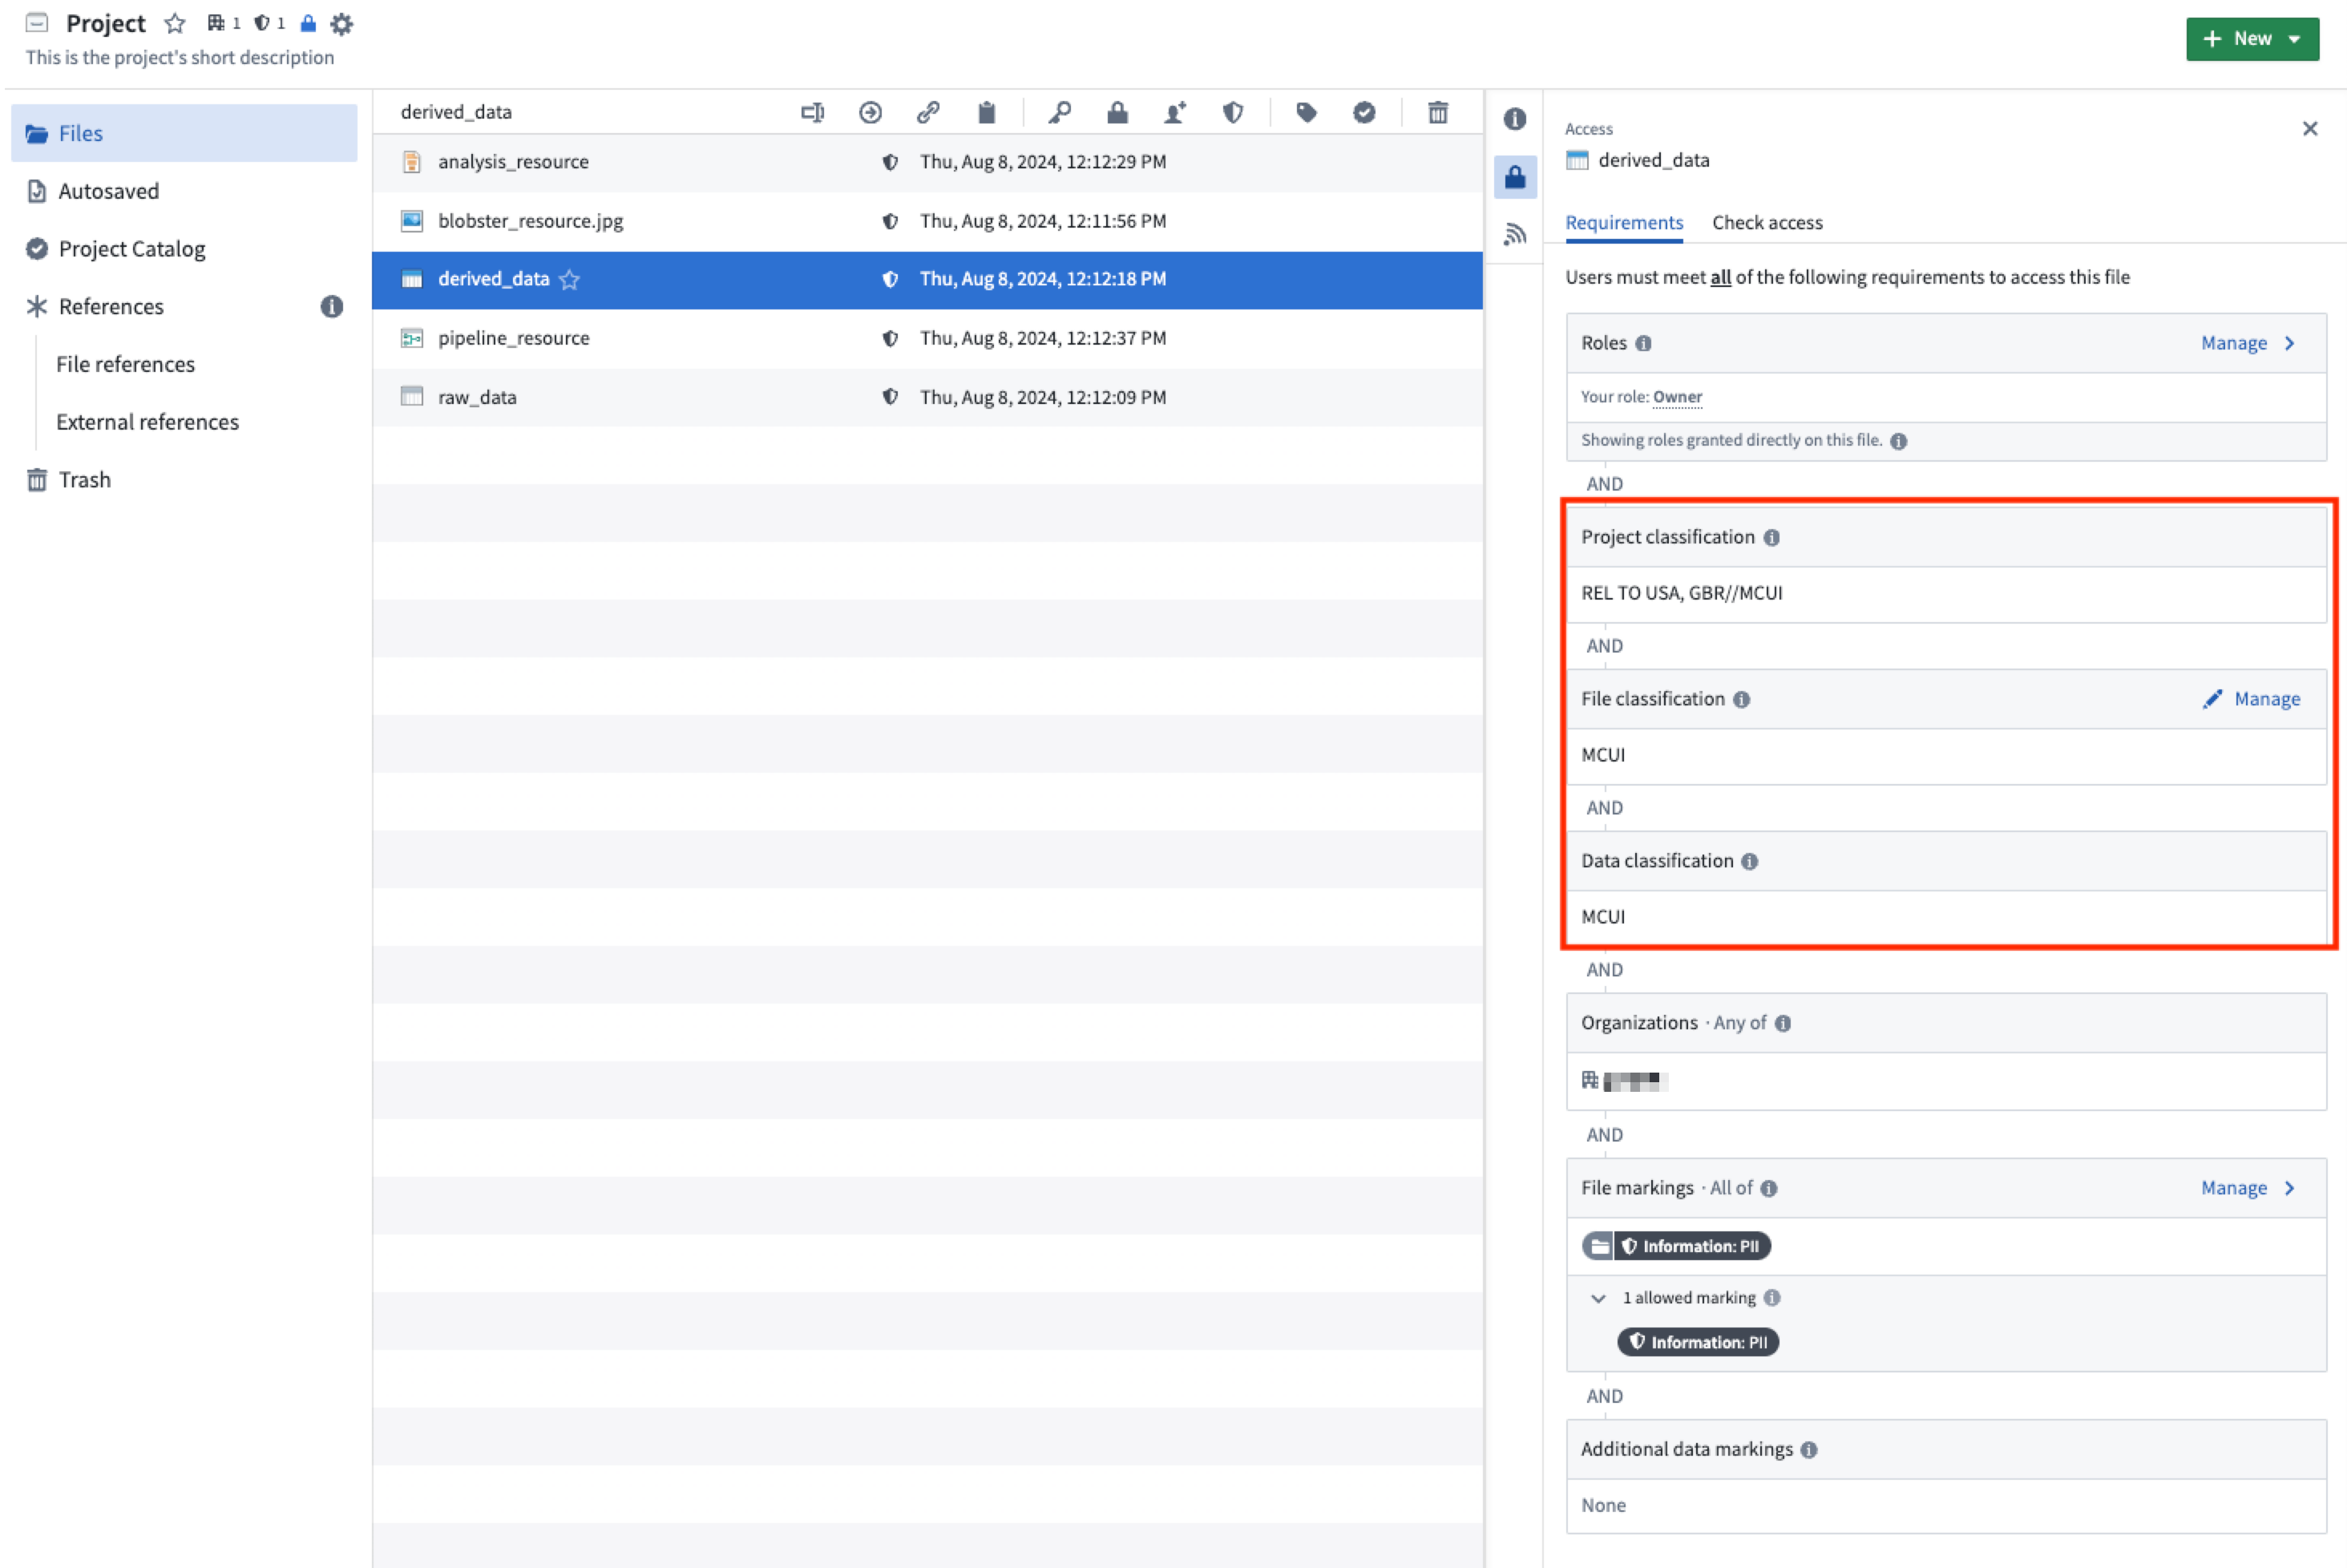
入力となる上流データセットがない、派生ではない新しいデータセットを作成する場合、作成するユーザーはファイルの機密情報区分を設定する必要があります。
プロジェクトの機密情報区分
プロジェクトの機密情報区分は、プロジェクトを発見し、その中のリソースにアクセスできるユーザーを制御します。リソースにアクセスするには、ユーザーはそのリソースのプロジェクトの機密情報区分、およびリソースのファイルとデータの機密情報区分の要件を満たす必要があります。機密情報区分マーキングを使用する環境では、すべてのプロジェクトにプロジェクトの機密情報区分が必要です。プロジェクトの作成時に機密情報区分を選択する必要があり、更新はできますが、削除はできません。
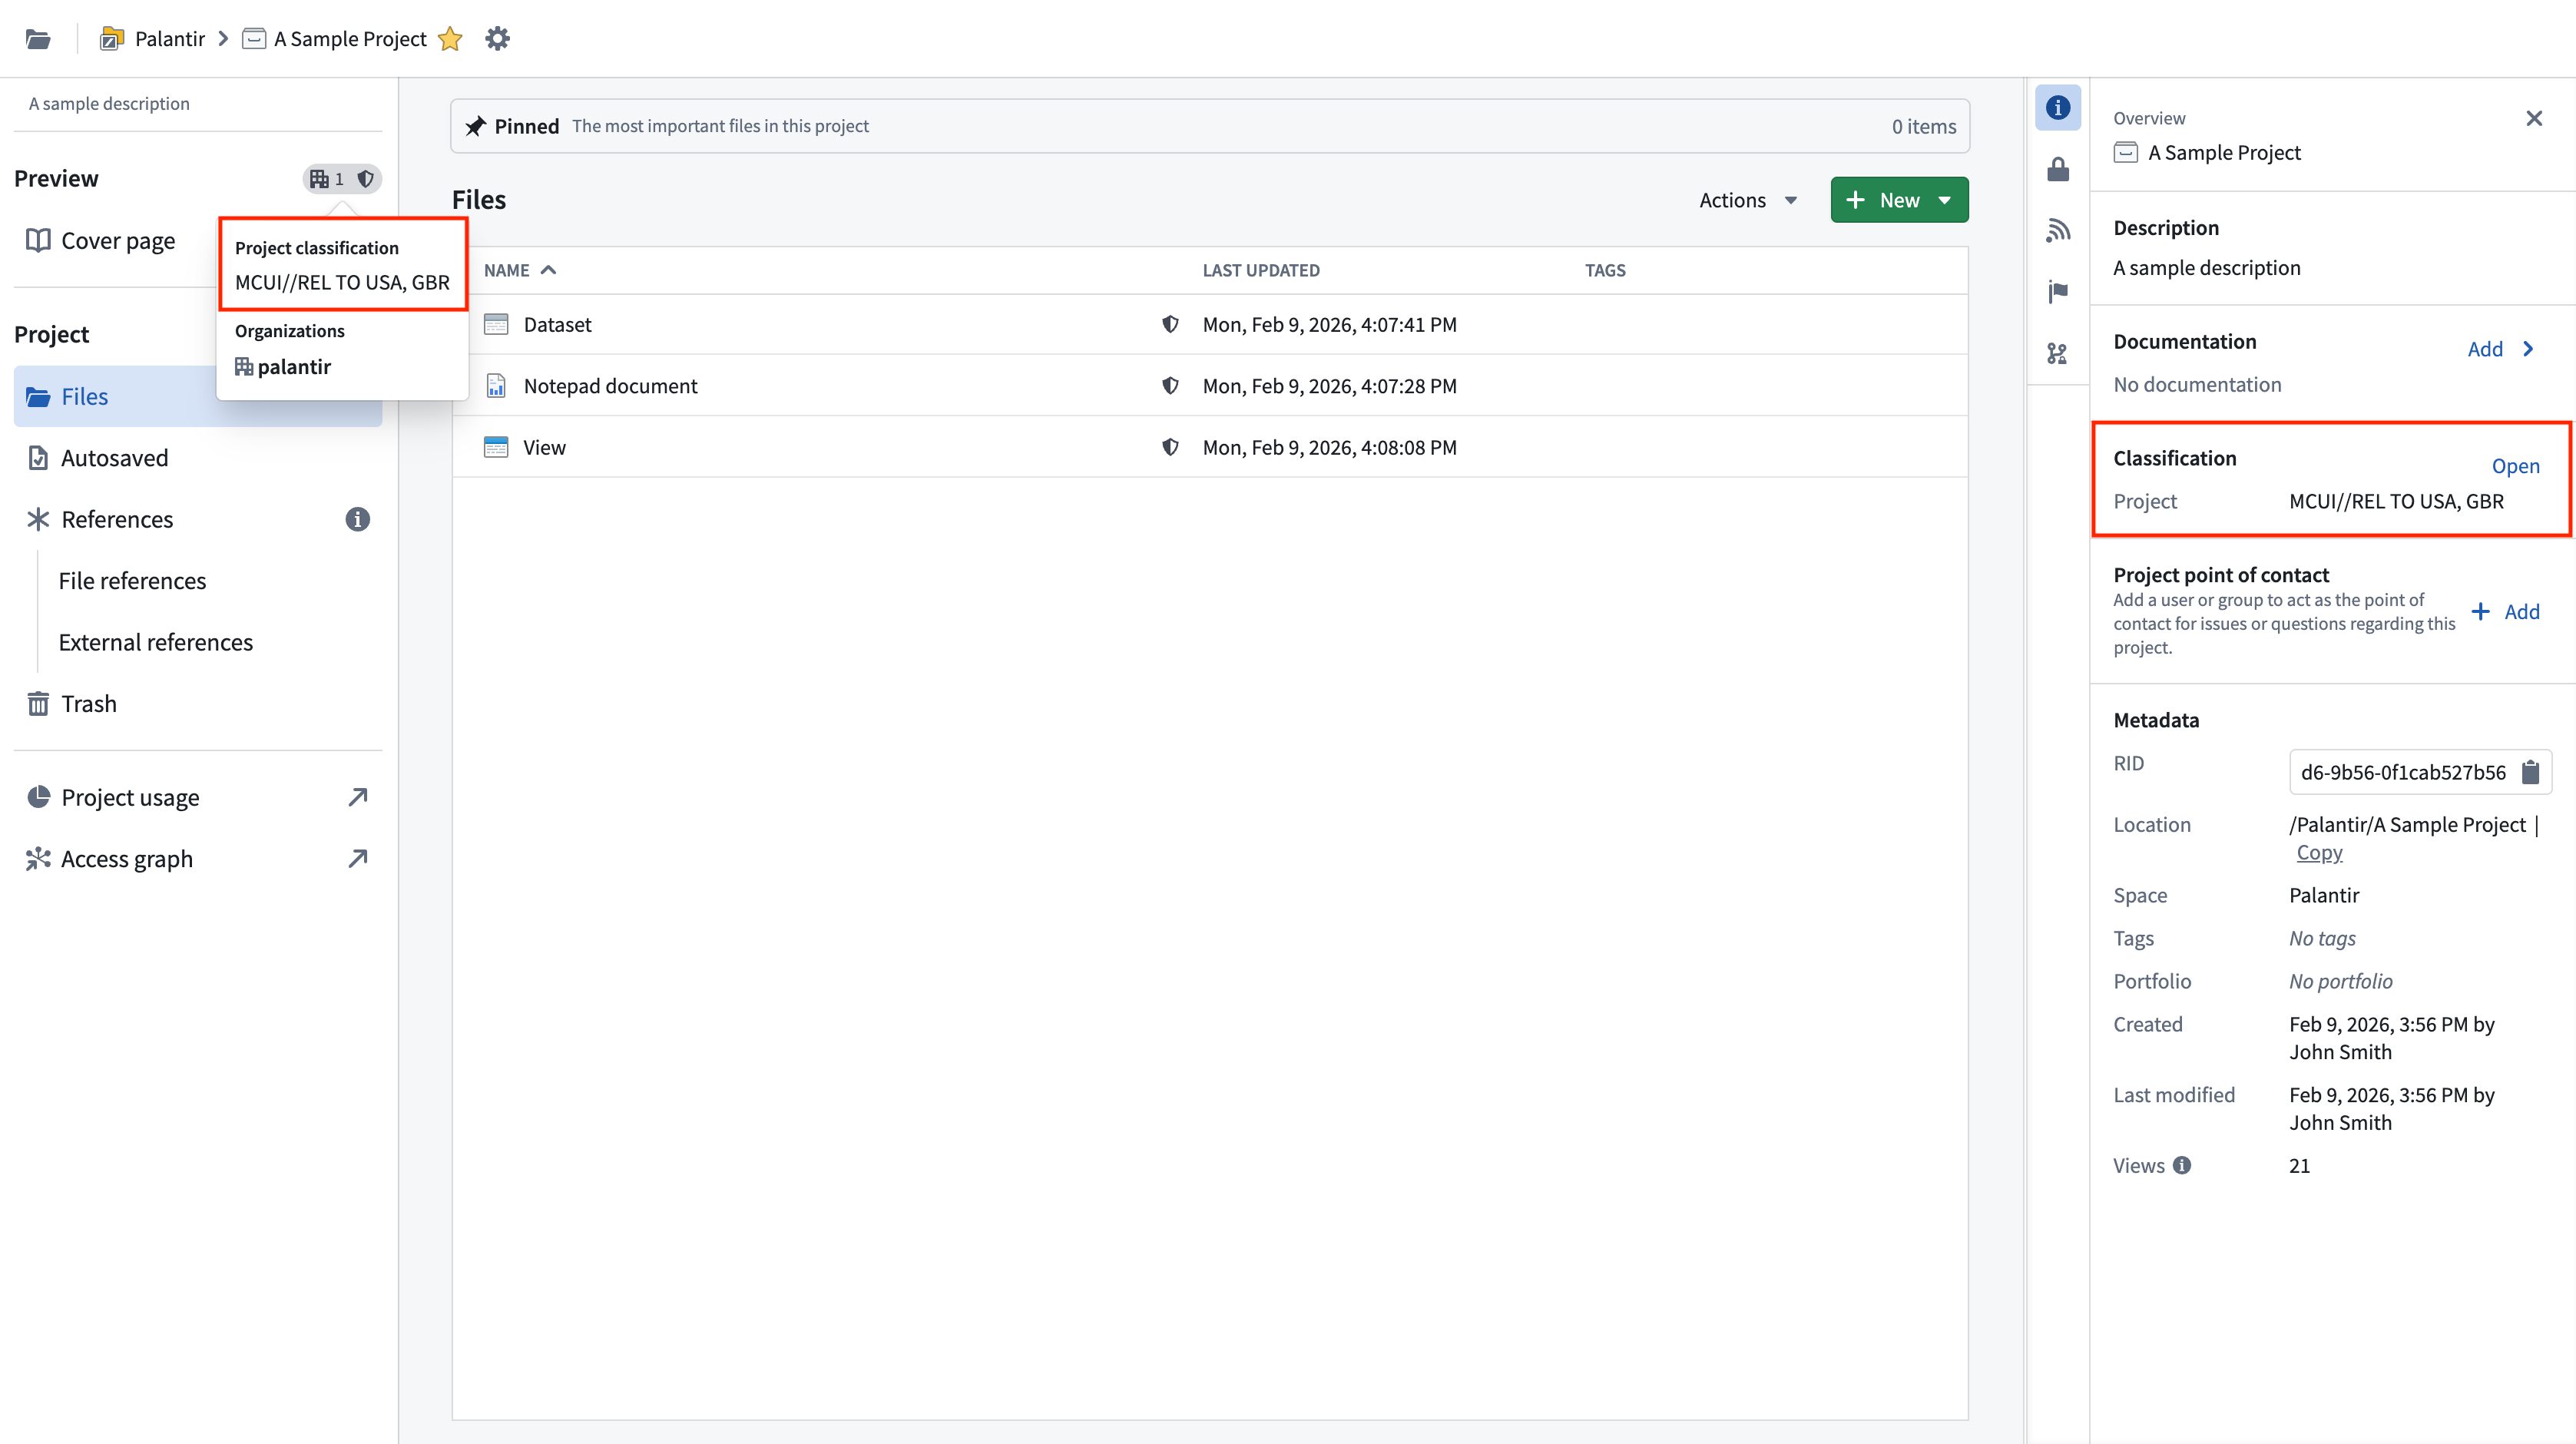
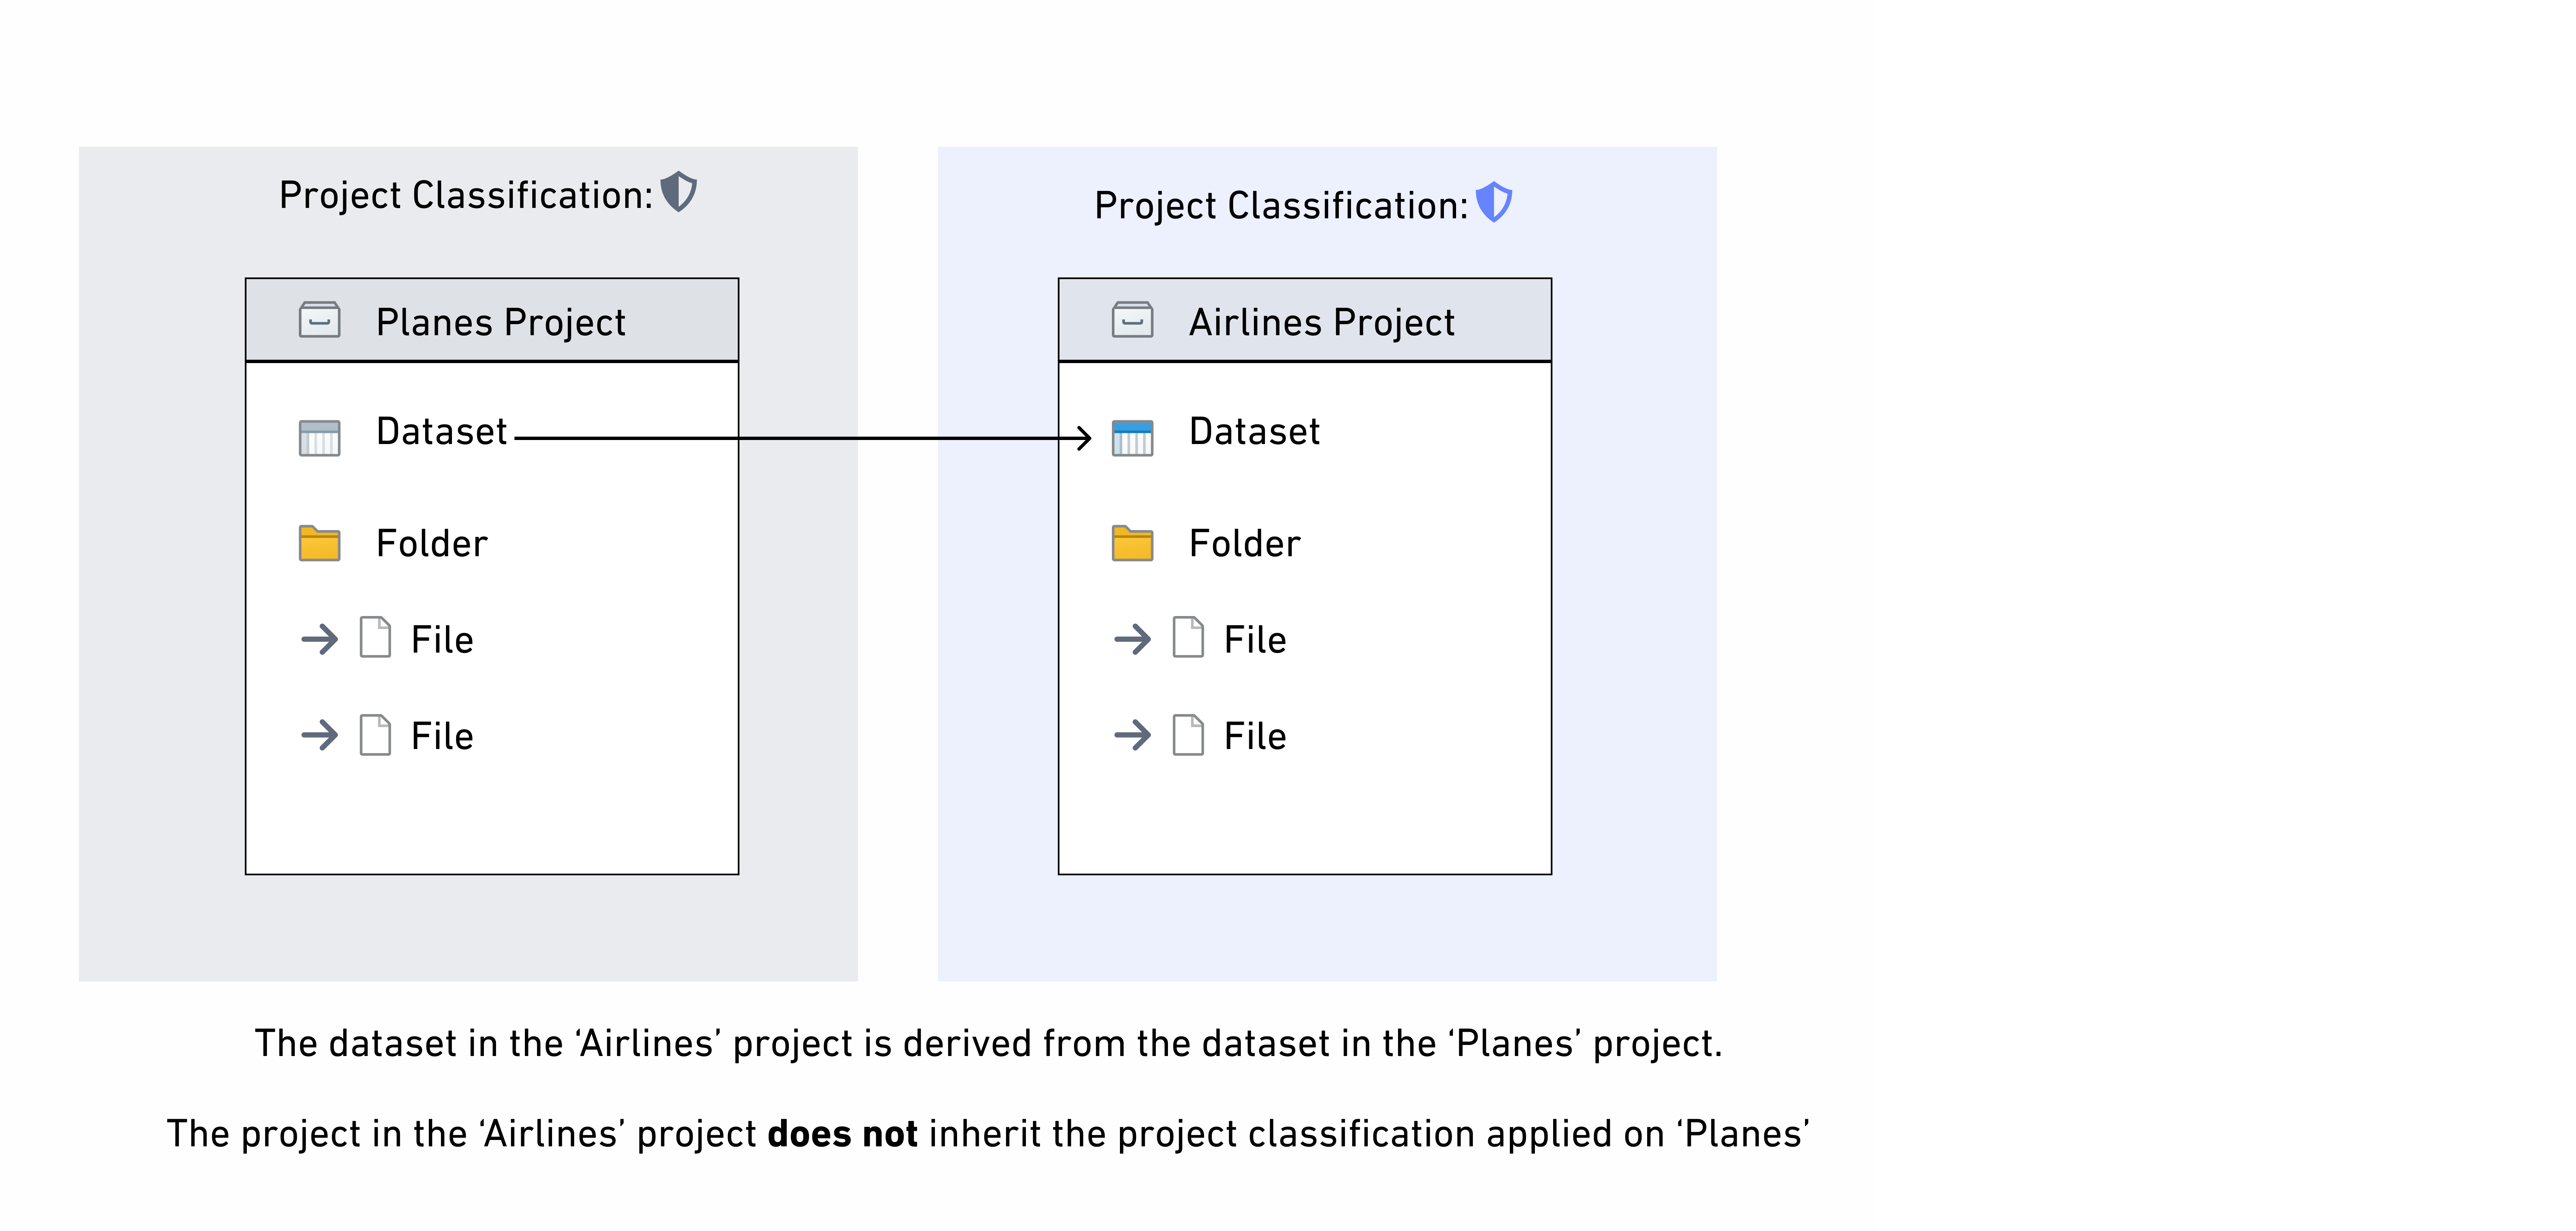
プロジェクトの機密情報区分は、プロジェクト内のデータセットのデータの機密情報区分には影響しないため、データ依存関係に沿って継承されません。ほかのプロジェクトに下流の派生データセットがある場合、データの機密情報区分のみが継承されます。これは、下流データセットに継承されるプロジェクトのマーキングの動作とは異なります。
プロジェクトの最大機密情報区分
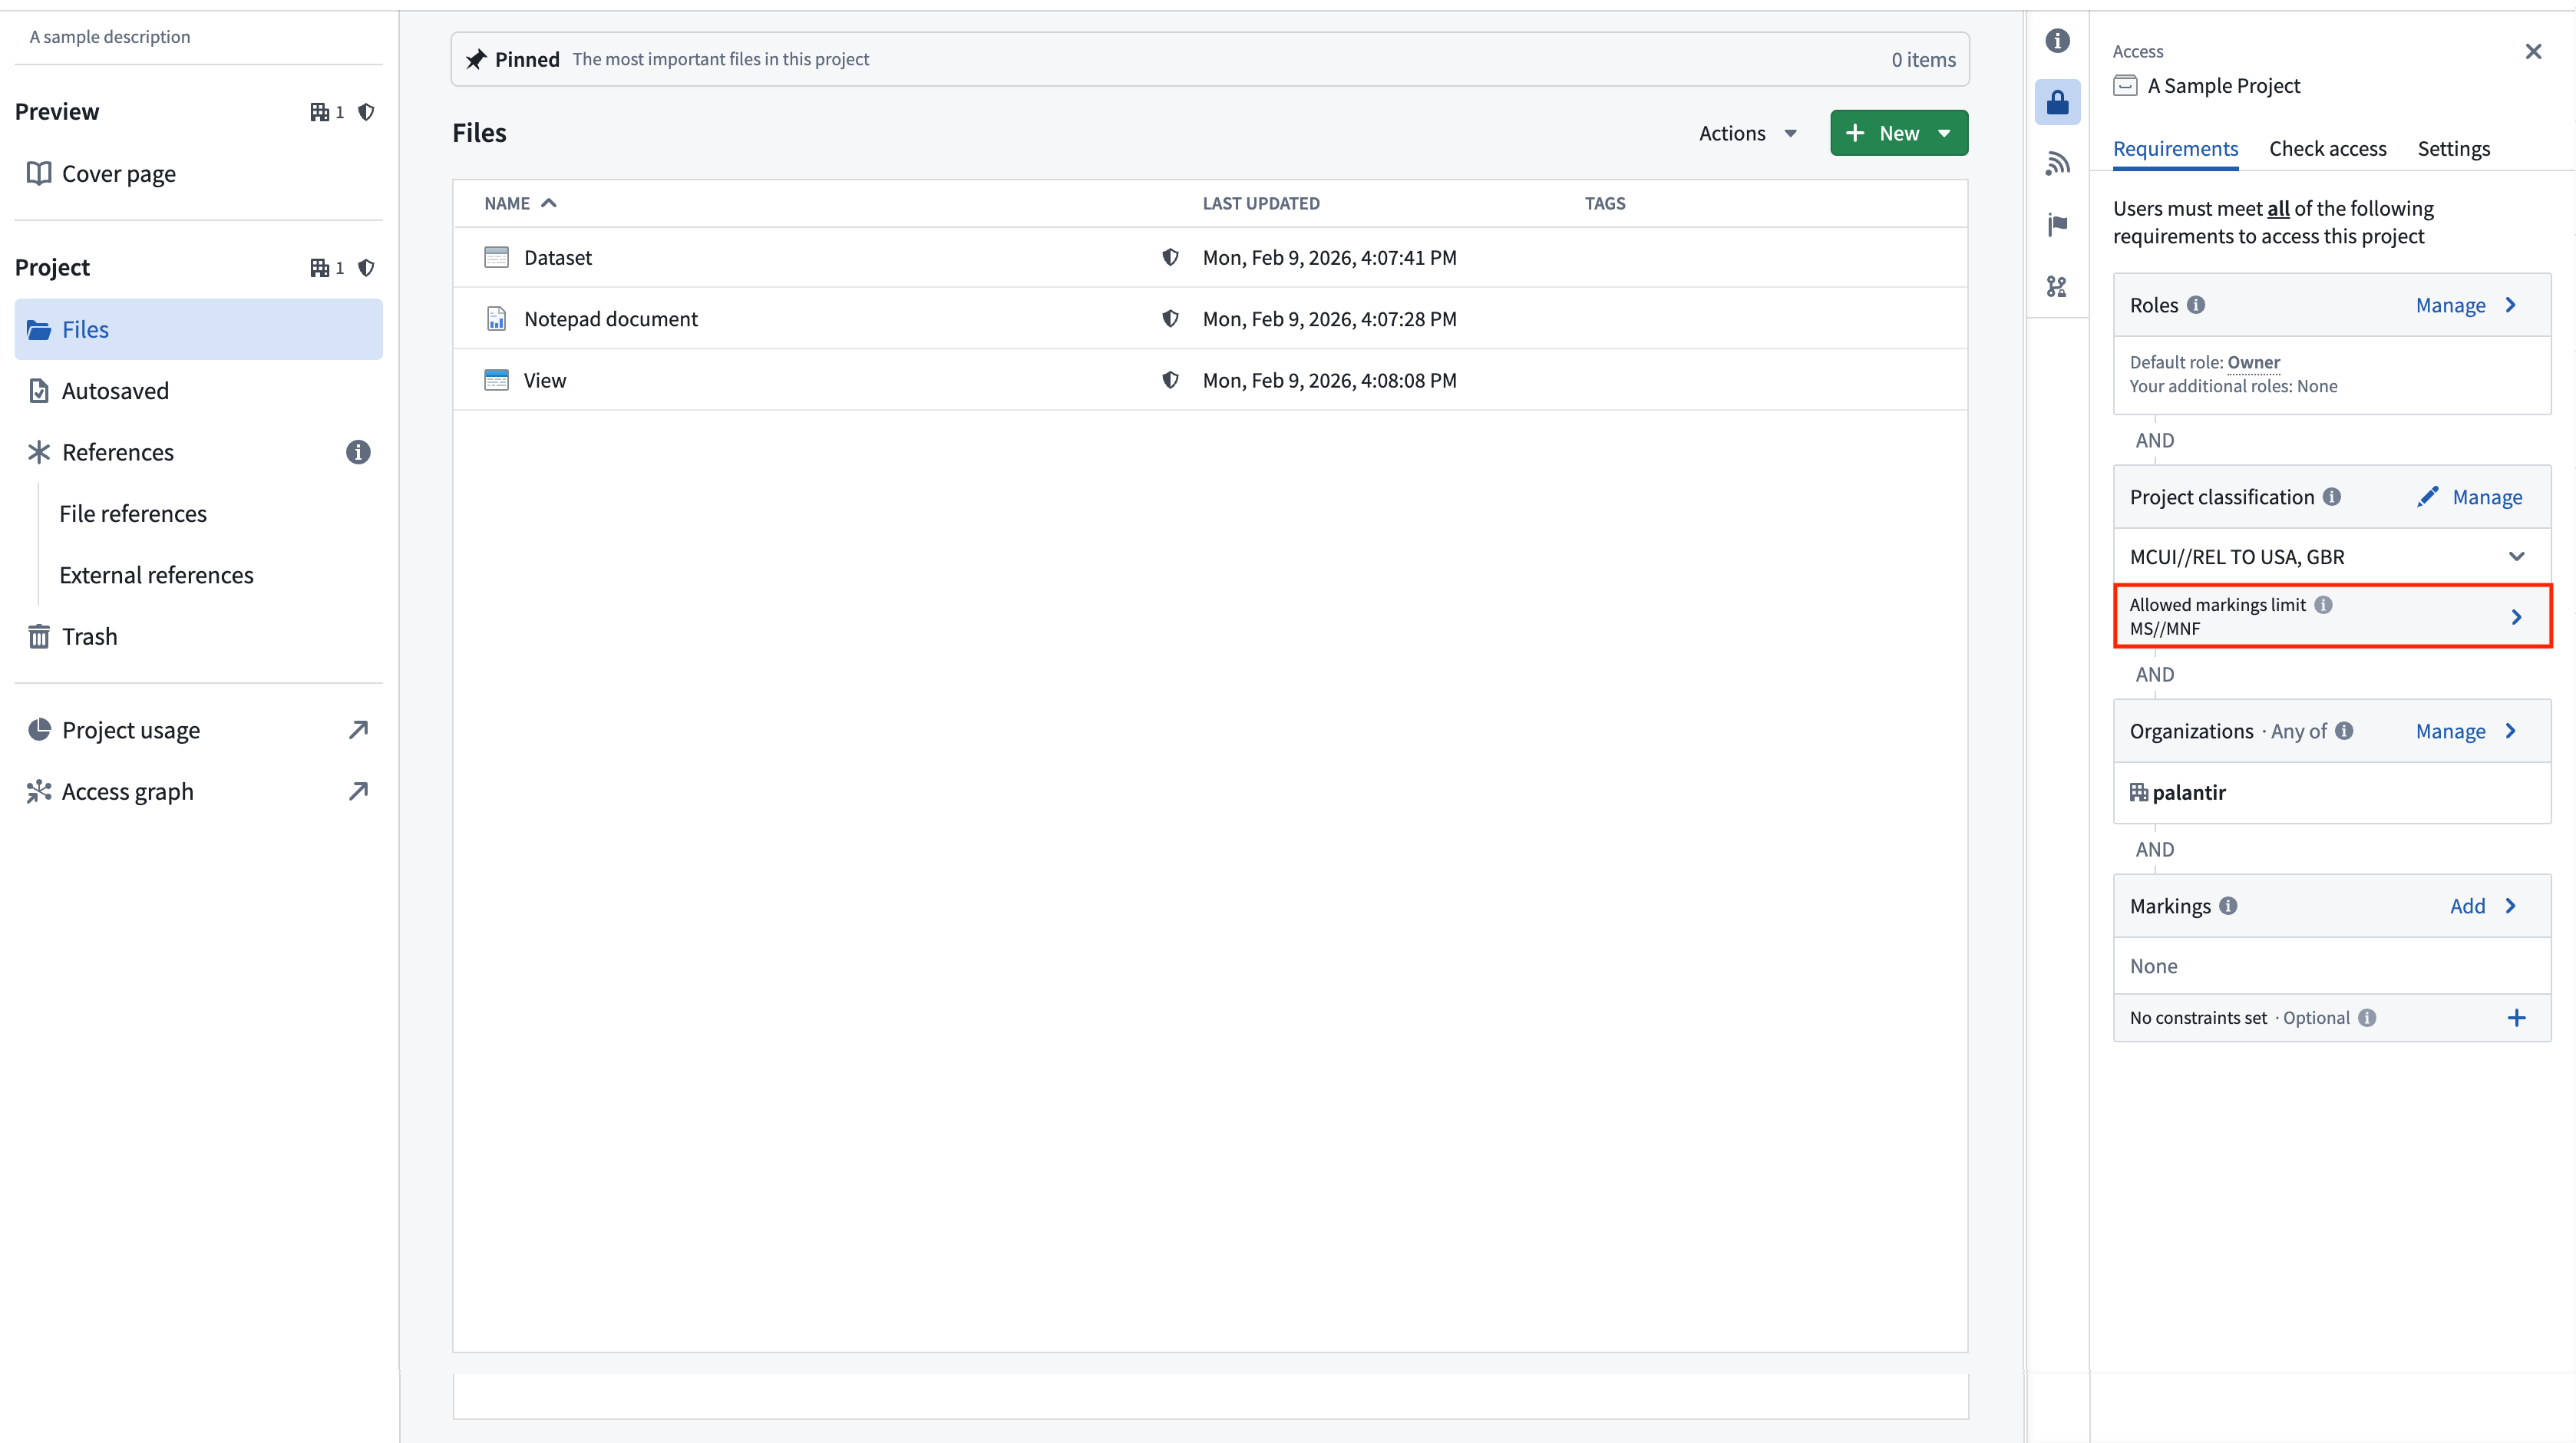
プロジェクトの最大機密情報区分は、プロジェクト内のすべてのリソースに対する最大機密情報区分を指定します。プロジェクトの最大機密情報区分は、「許可されるマーキングの上限」とも呼ばれます。データまたはファイルの機密情報区分が高いリソースは、それより低い最大機密情報区分を持つプロジェクト内に作成したり、そのプロジェクトに移動したりすることはできません。プロジェクトの最大機密情報区分以下の機密情報区分を持つリソースは、そのプロジェクト内に存在できますが、プロジェクト全体の機密情報区分の要件を満たすユーザーのみがこれらのリソースを閲覧できます。
プロジェクトの最大機密情報区分は、プロジェクト作成時にはデフォルトでプロジェクトの機密情報区分と同じになりますが、プロジェクトの機密情報区分とは独立して編集または削除できます。
オブジェクトタイプやリンクタイプをプロジェクトに追加するには、プロジェクトの最大機密情報区分の削除が必要になる場合があります。ただし、オブジェクトタイプやリンクタイプがプロジェクト内にある場合、ファイルの機密情報区分が設定されていないと実体化に失敗します。
別のプロジェクトにある上流データセットに、より高い機密情報区分がファイルの機密情報区分として適用され、それが対象プロジェクト内のデータセットにデータマーキングとして継承されると、そのデータマーキングはプロジェクトの最大機密情報区分に違反します。この場合、データは引き続き、より高い機密情報区分によって保護されますが、警告が表示され、違反が解消されるまで、そのデータセットもプロジェクト内の下流リソースもビルドできなくなります。この違反は、上流データセットの機密情報区分を修正し、その上流データセットを入力から外してデータセットを再ビルドするか、プロジェクトの最大機密情報区分を更新することで解消できます。これは、プロジェクト制約違反と同じ動作です。