注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
一致条件を作成する
Sensitive Data Scanner には組み込み一致条件が用意されています。また、Sensitive Data Scanner で使用する独自のカスタム一致条件も定義できます。
組み込み一致条件
Sensitive Data Scanner は、社会保障番号、メールアドレス、電話番号など、一般的な種類の個人識別情報(PII)を検出するための組み込み一致条件を幅広く提供しています。右側のサイドバーで矢印を選択して組み込み一致条件セクションを展開すると、これらの条件を確認できます。
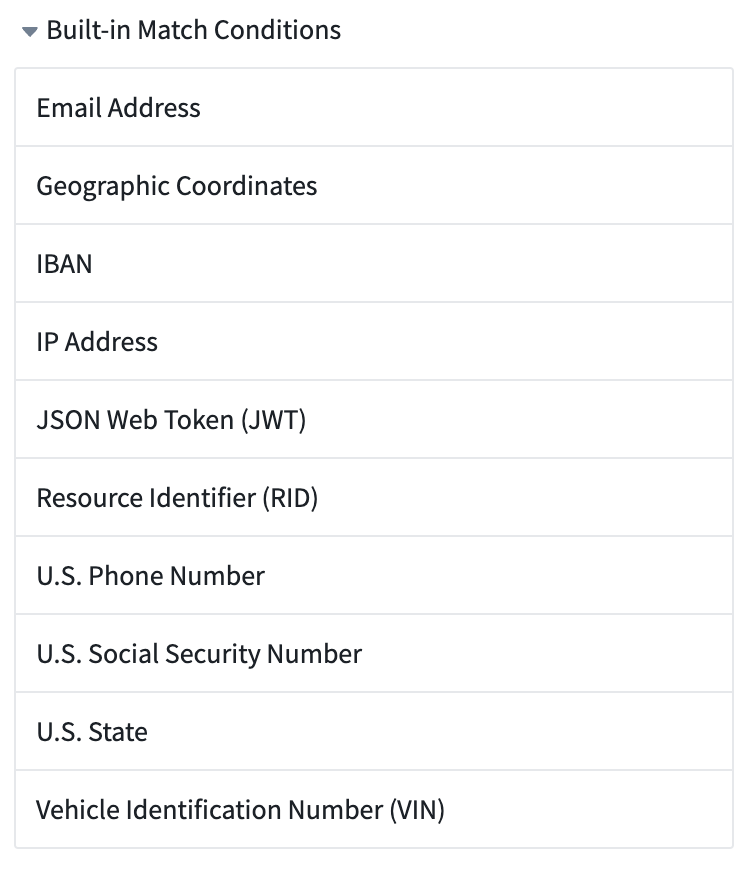
組み込み一致条件は、一般的な種類の個人データを検出するように設計されています。ただし、その有効性はデータの構造や形式によって異なります。これらの条件がお使いのデータ固有の基準に合っていることを確認し、必要に応じてカスタム条件を作成してください。さらに質問がある場合は、データ保護責任者にご相談ください。
カスタム一致条件を作成する
スペースのカスタム一致条件を作成するには、次の2つの方法ではじめられます。
- Sensitive Data Scanner のランディングページから。
- 機密データスキャンの作成中に。
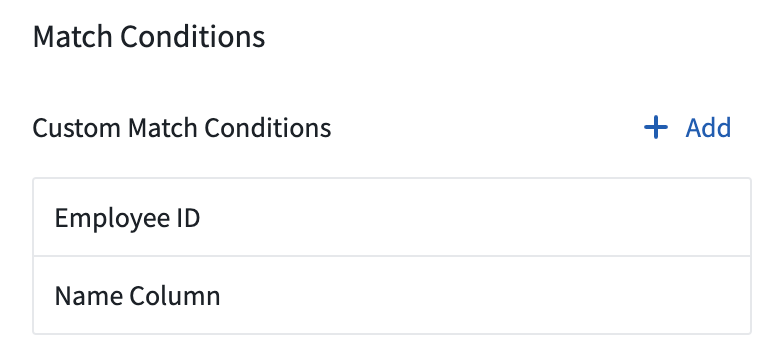
ランディングページでは、一致条件のサイドバーに表示されているカスタム一致条件の上にある追加を選択します。
機密データスキャンの作成中には、一致条件を選択ページで新規一致条件を作成を選択することで、新しい一致条件を作成し、そのままスキャンで使用することもできます。
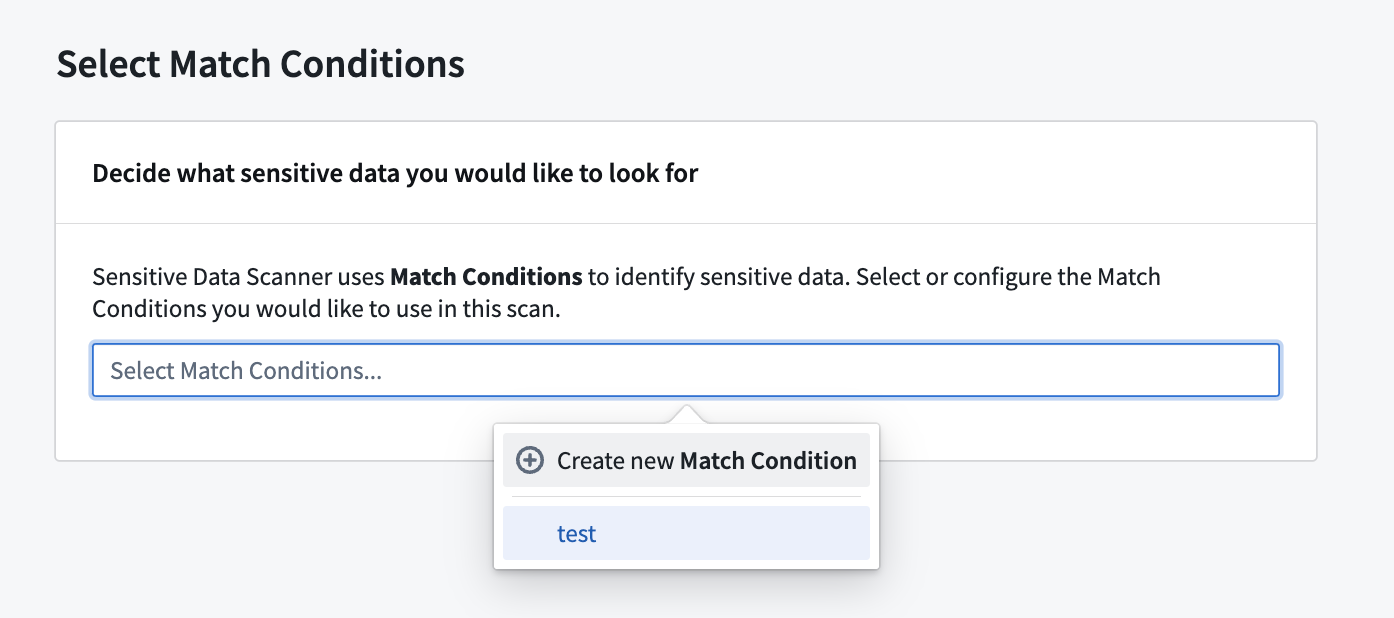
どちらの方法でも、同じ一致条件の作成プロセスが開きます。そこから、正規表現(正規表現)の一致条件、言語モデルの一致条件、または重複(値の重複)の一致条件のいずれを作成するか選択できます。
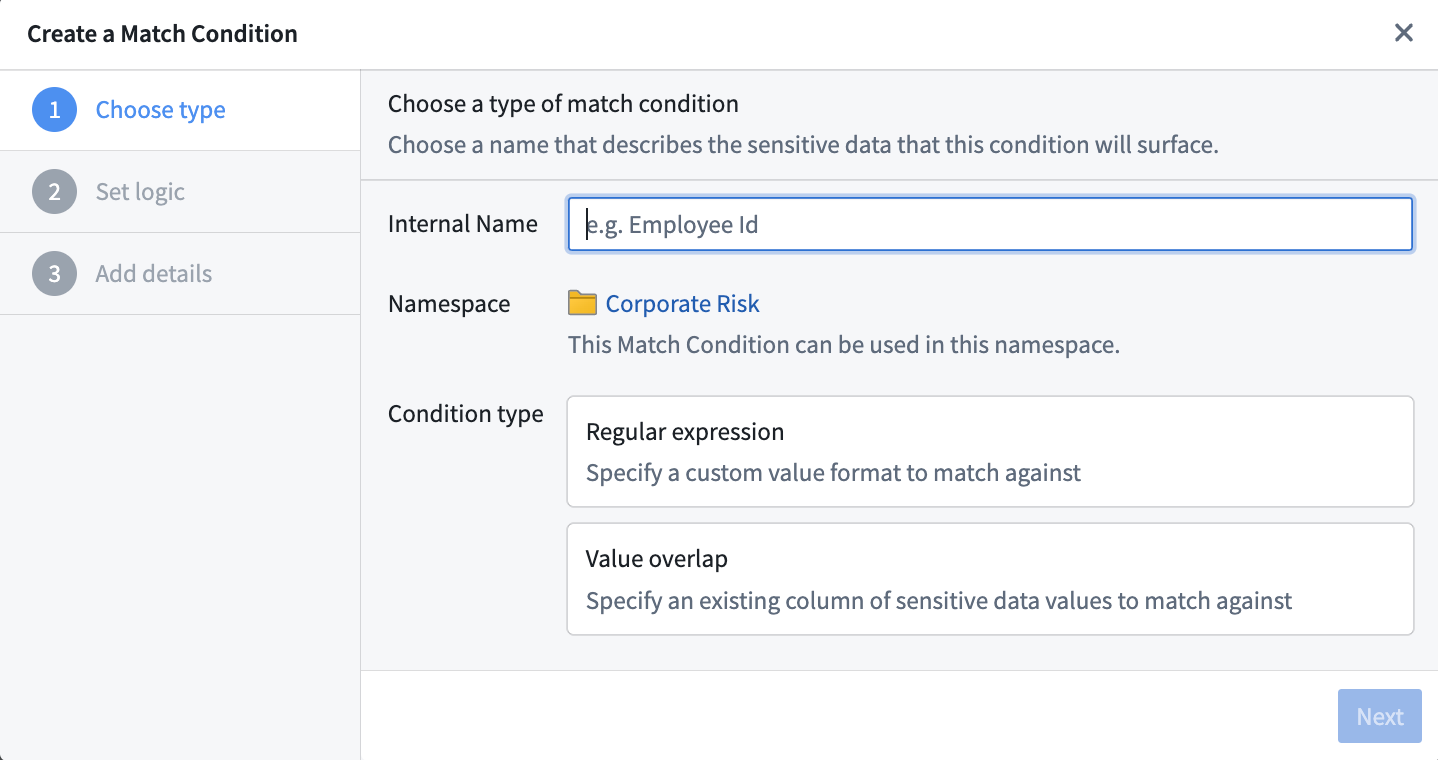
正規表現の一致条件を作成する
正規表現(regex)の一致条件を作成する際には、コンテンツの正規表現と列名の正規表現という2種類の正規表現オプションを指定できます。
- コンテンツの正規表現: Sensitive Data Scanner がデータセットのコンテンツ(データセットの列名ではありません)と照合する正規表現です。
- 列名の正規表現: Sensitive Data Scanner がデータセットの列名(コンテンツ自体ではありません)と照合する正規表現です。
Sensitive Data Scanner では、この2つの正規表現オプションを組み合わせて、条件をより具体的に指定できます。
- コンテンツの正規表現に一致する場合に、データセットを強調表示します。
- 列名の正規表現に一致する場合に、データセットを強調表示します。
- コンテンツと列名の正規表現の両方に一致する場合に、データセットを強調表示します。
- コンテンツまたは列名の正規表現のいずれかに一致する場合に、データセットを強調表示します。
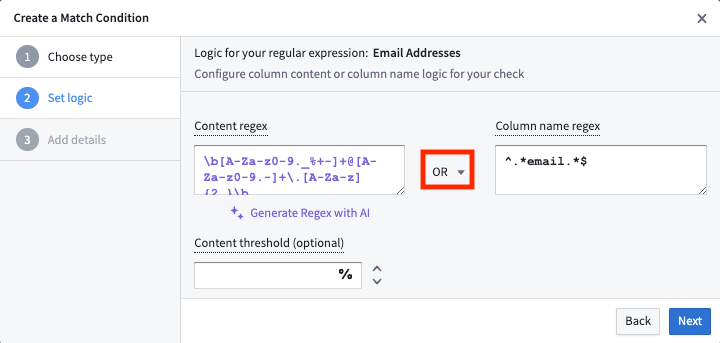
コンテンツの正規表現には、任意のコンテンツしきい値項目があり、0より大きく100以下の数値を指定できます。このコンテンツしきい値は、データセットを一致として強調表示するために、そのデータセットの特定の列でコンテンツの正規表現に一致しなければならないセルの割合です。コンテンツしきい値の項目は任意です。値が指定されていない場合、コンテンツの正規表現に一致するセルが1つ以上あれば、Sensitive Data Scanner はそのデータセットを一致として強調表示します。
AIP による正規表現の生成
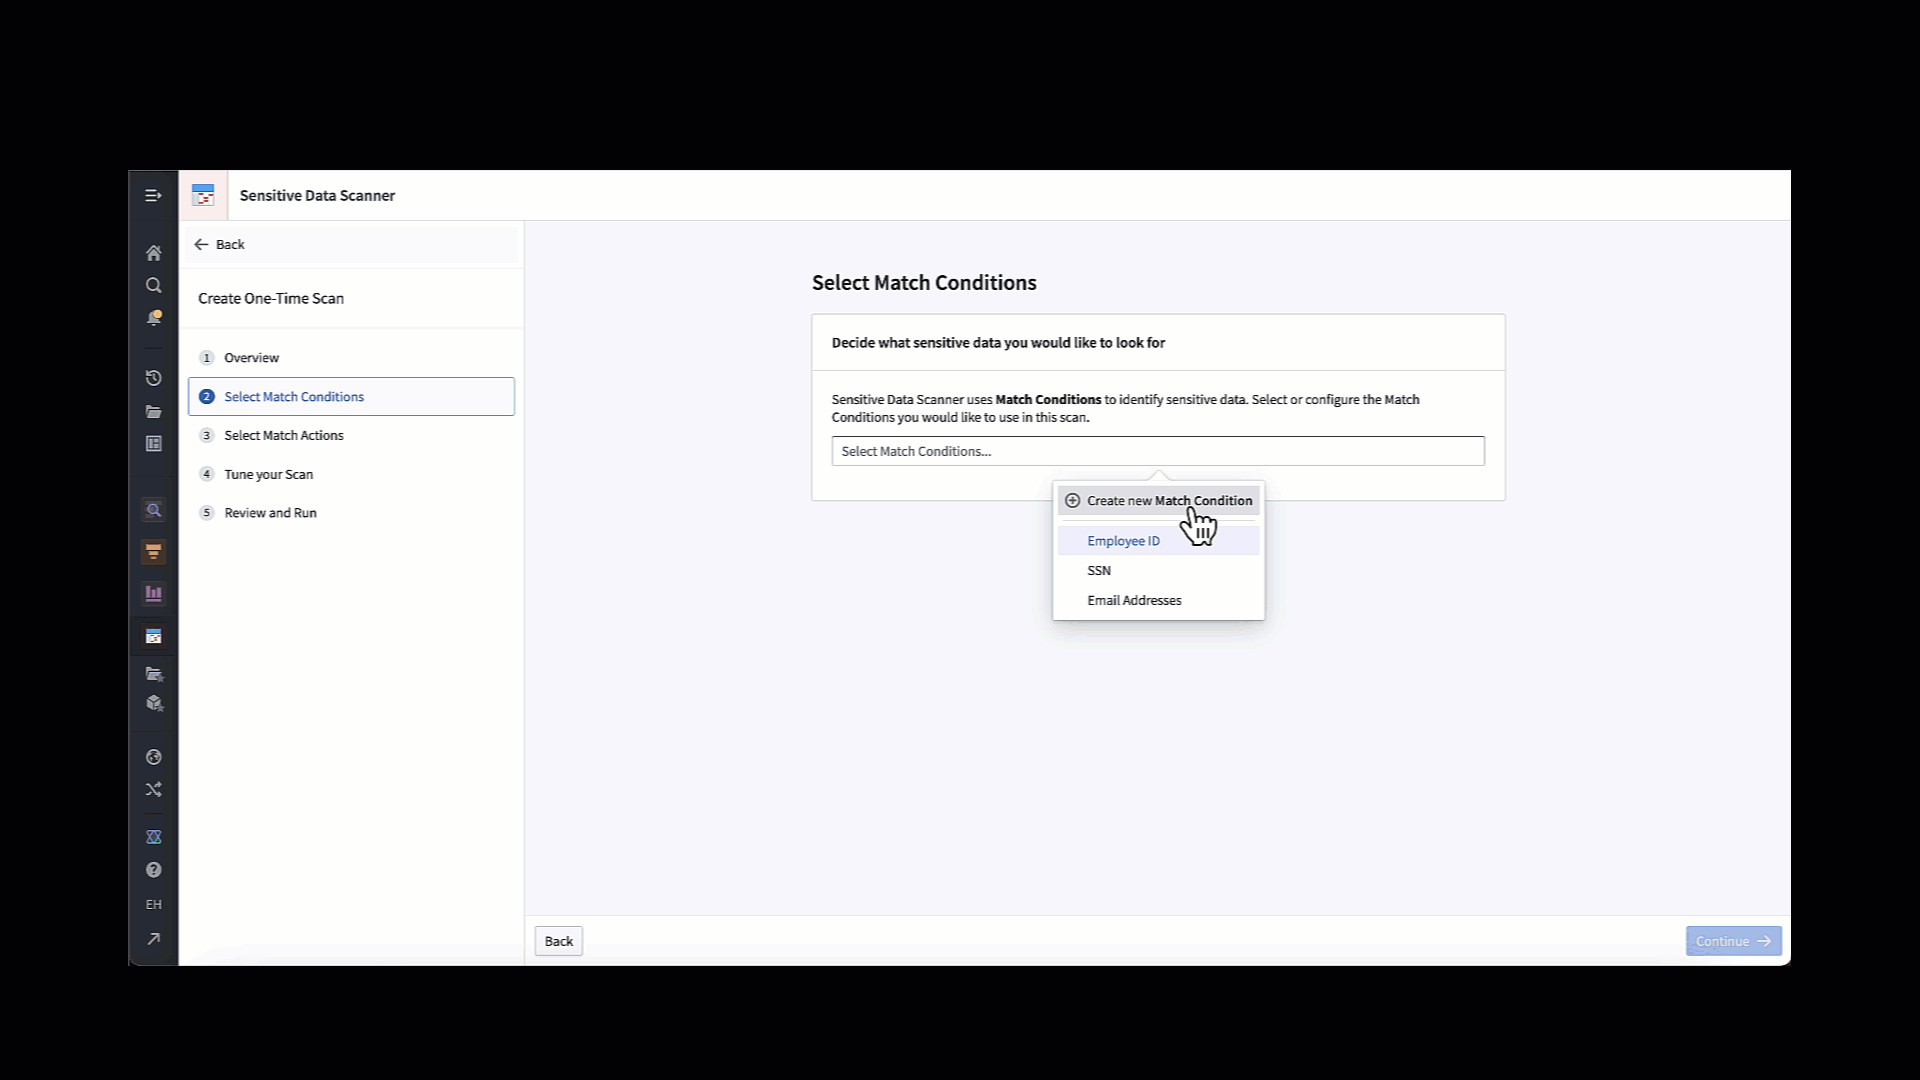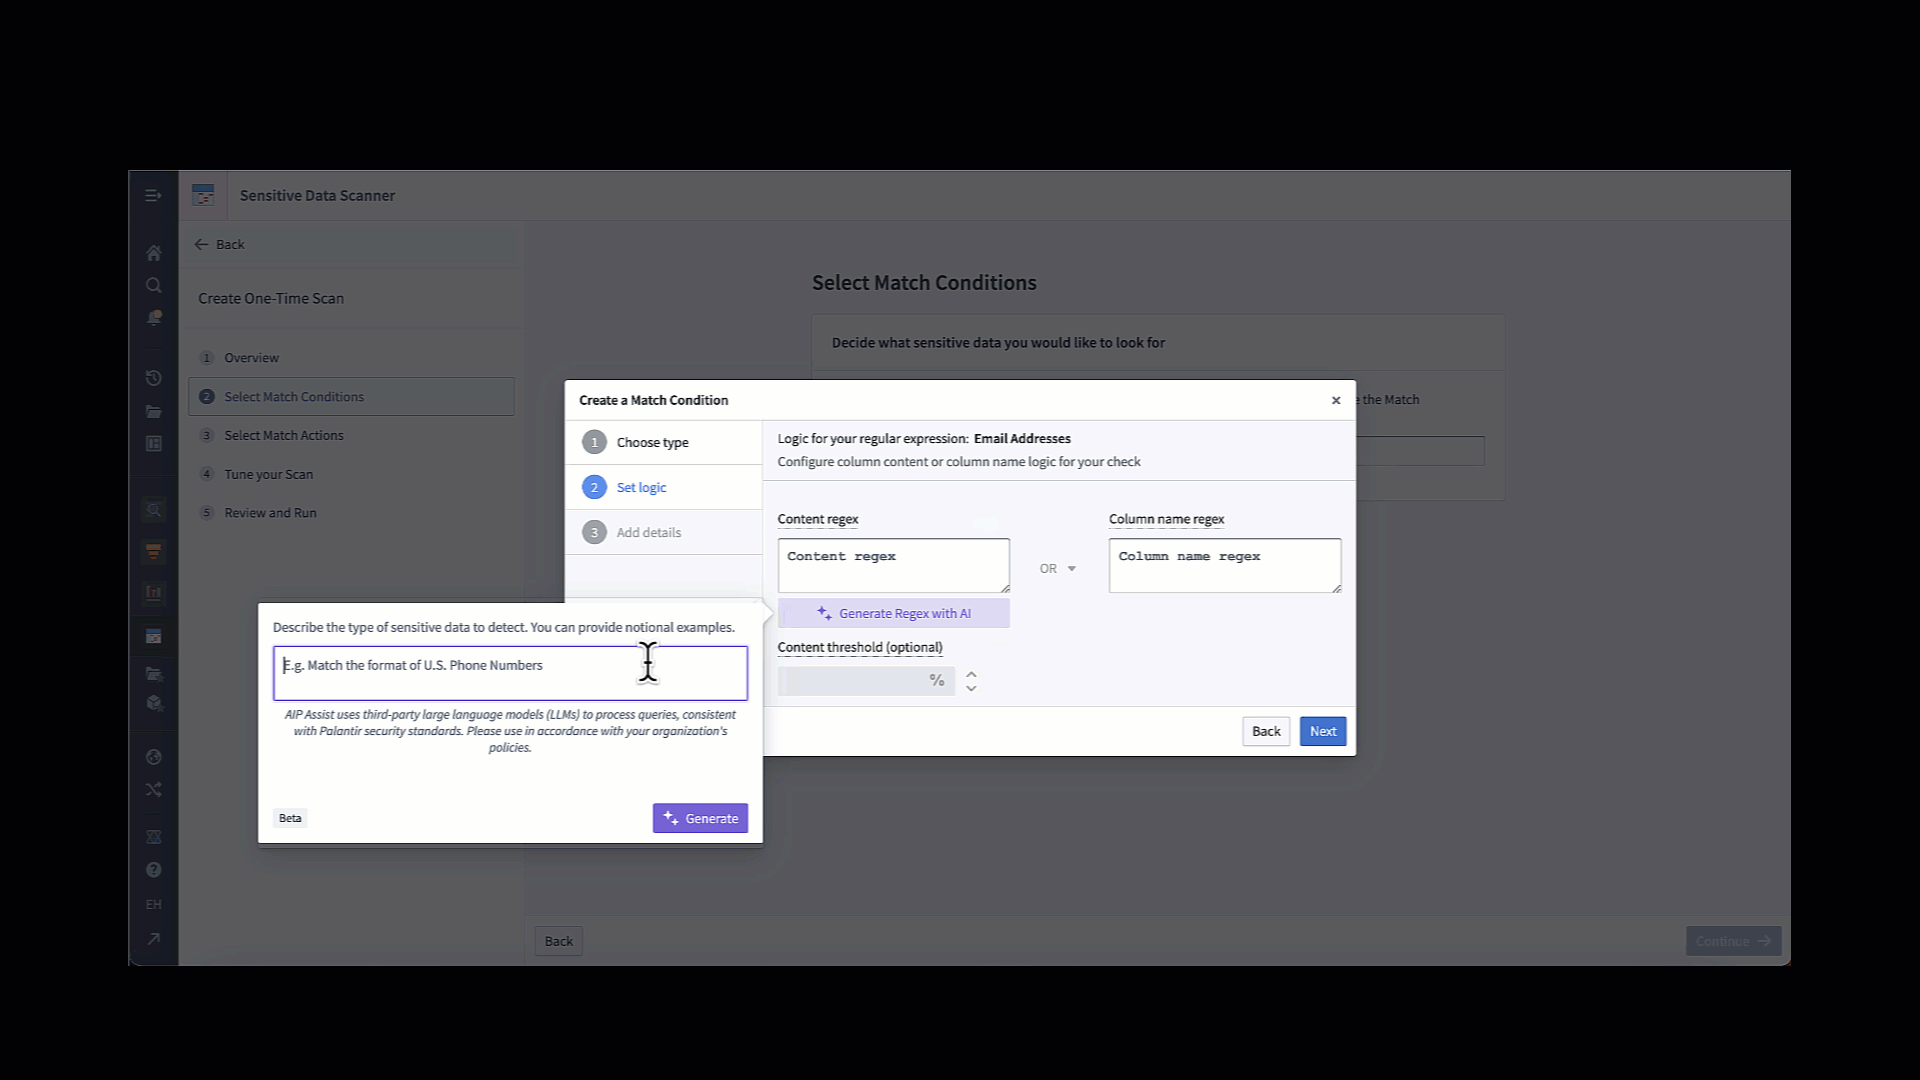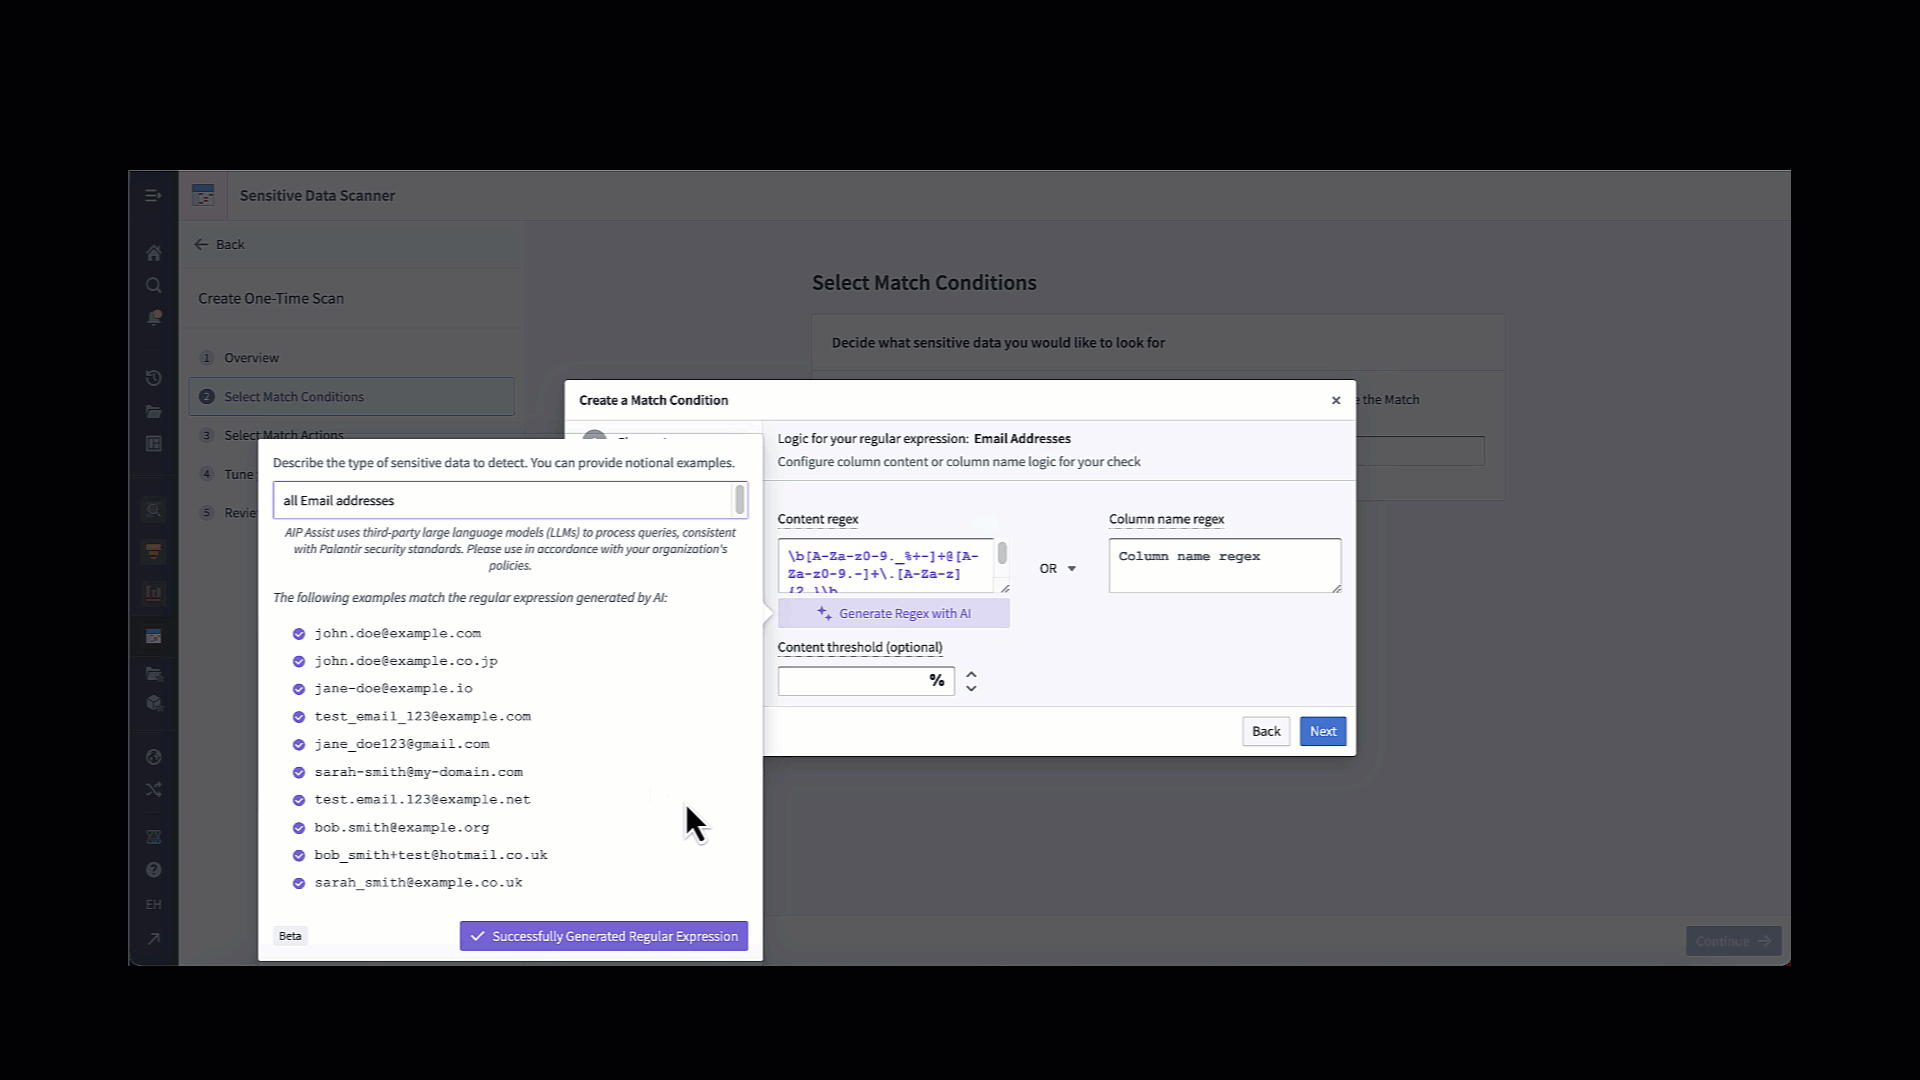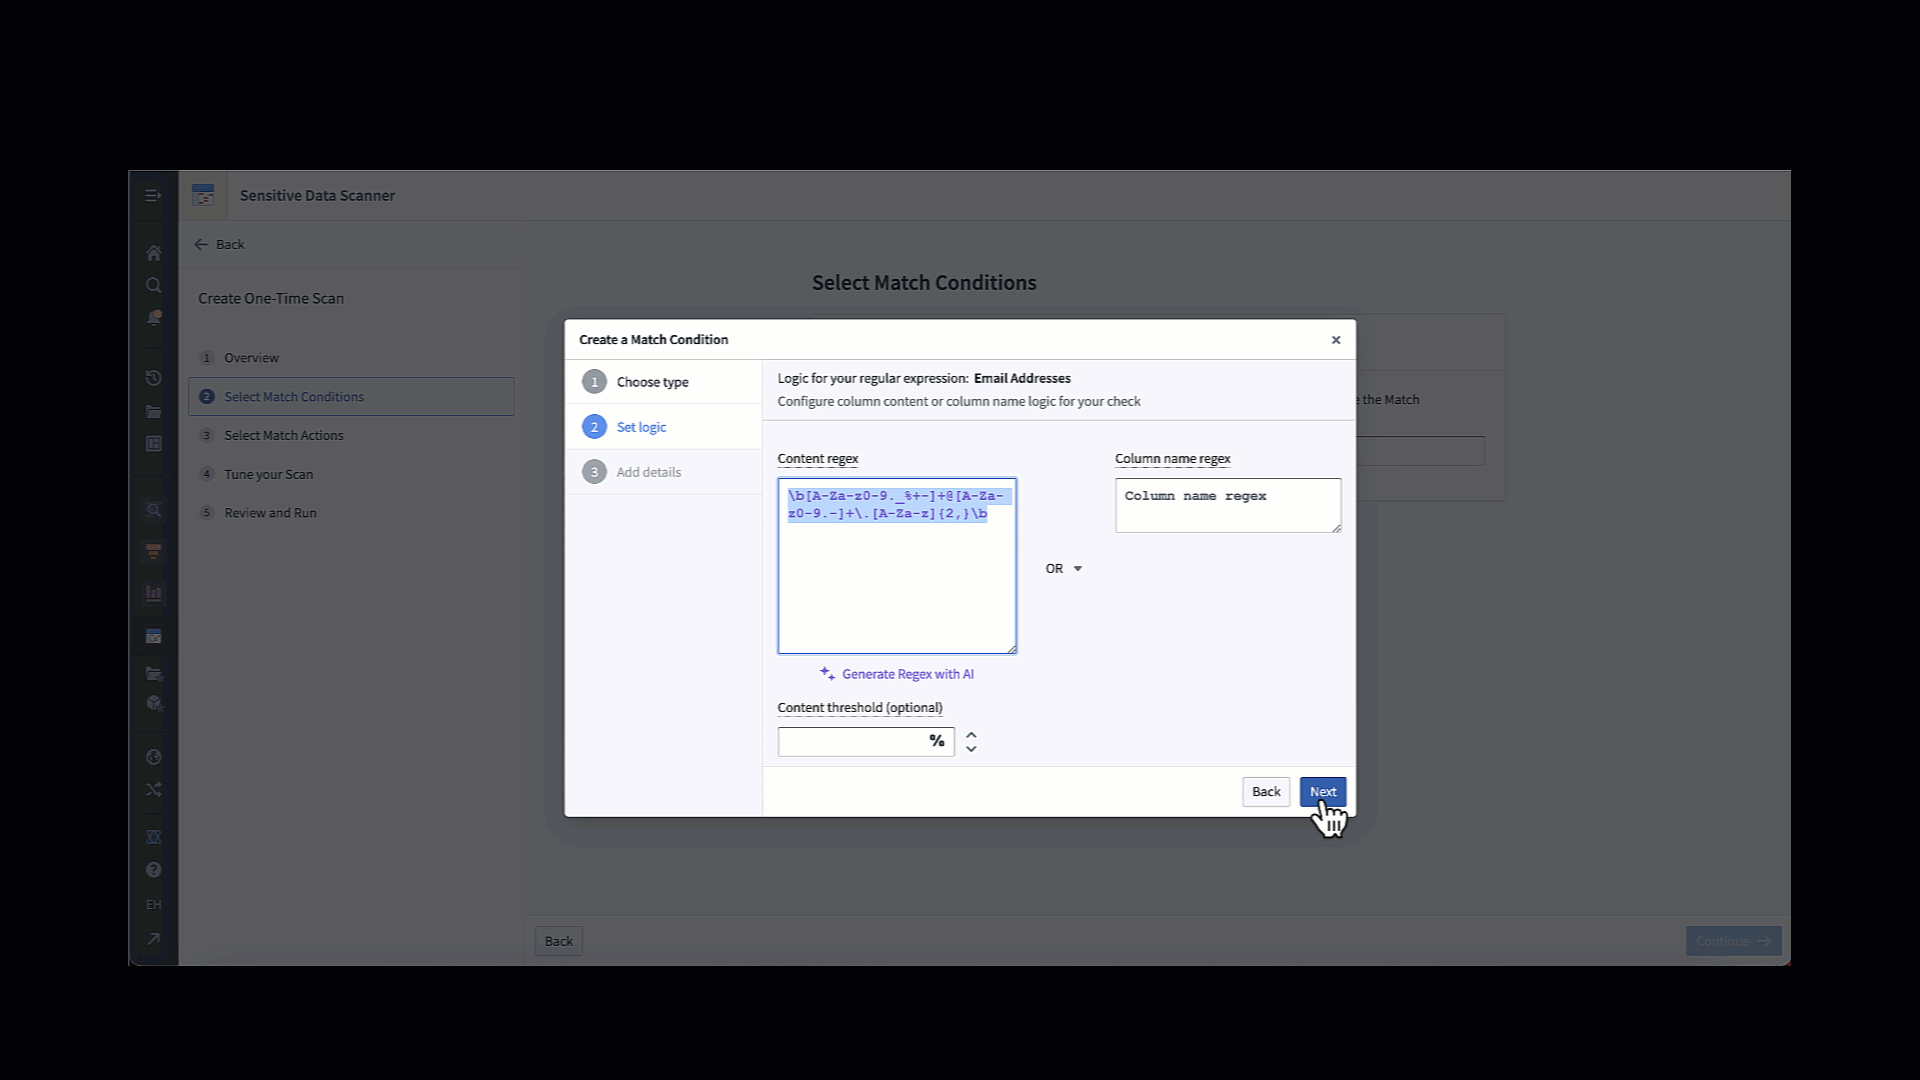
Foundry のエンロールメントで AIP が有効になっている場合は、AI の支援を受けてコンテンツの正規表現を指定することもできます。これには、AI で正規表現を生成ボタンを使用します。このボタンを選択すると、検出する機密データの種類(たとえば「すべてのメールアドレス」)の説明を入力するためのプロンプトが表示されます。提案された正規表現に一致する例が表示され、アプリケーションで使用する正規表現が生成されます。以下の図は、このプロセスを示しています。
言語モデルの一致条件を作成する
言語モデルの一致条件は、LLM を使用して、スキャンしたデータが自然言語のプロンプトに一致するかどうかを分類します。正規表現や固定の値リストでは表現しにくい機密データに役立ちます。
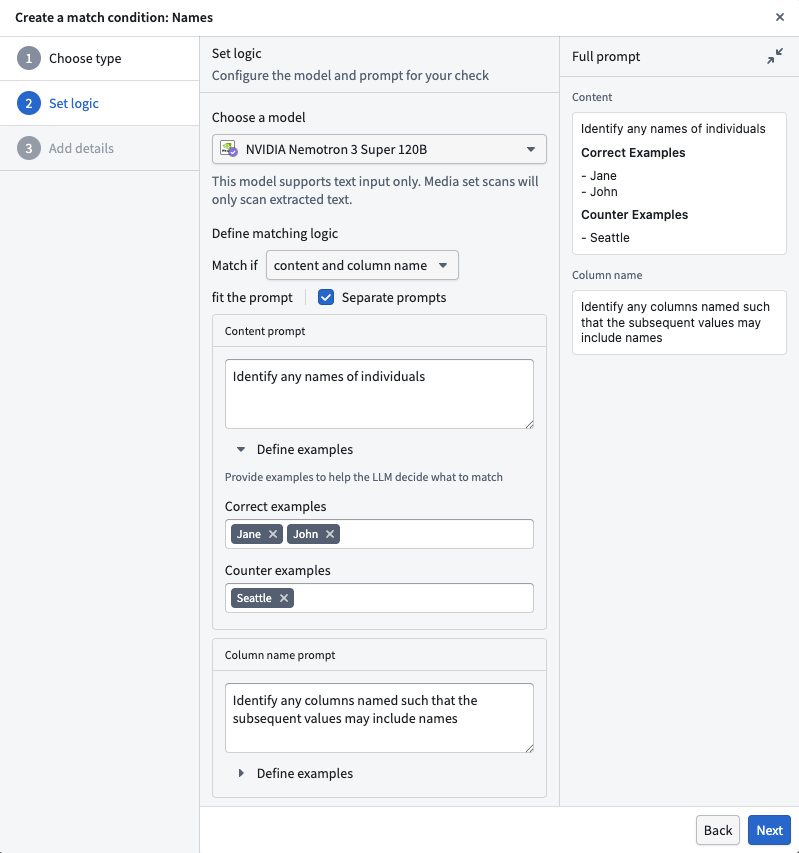
言語モデルの一致条件を作成するには、条件の種類として言語モデルを選択し、モデルを選択して、一致判定のロジックを定義します。条件で評価する対象を、次のように設定できます。
- コンテンツ(列内のデータ値)
- 列名
- コンテンツと列名(両方が一致する必要があります)
- コンテンツまたは列名(いずれかが一致すれば条件を満たします)
モデルが検出すべき機密データを説明するプロンプトを記述します。コンテンツと列名の両方を評価する場合は、両方のチェックで同じプロンプトを使用することも、別々のプロンプトを定義することもできます。また、正例と反例を追加して、モデルが検出対象とすべきものとすべきでないものを明確にすることもできます。一致条件を保存する前に、プロンプト全体のプレビューを確認します。
スキャンで言語モデルの一致条件を使用すると、LLM の使用量はスキャン対象の各リソースに帰属します。言語モデルの一致条件ですべての行を評価するスキャンは、時間とコストがかかる可能性があるため、網羅的なスキャンが不要な場合は、行のサブセットを使用することを検討してください。
重複の一致条件を作成する
重複の一致条件は、正規表現では表現できない機密データを探す際に役立ちます。たとえば、名前に一致するコンテンツの正規表現を作成するのは難しいことがありますが、列名の正規表現を作成するだけで十分な場合もあります。ただし、スキャンで検出したい機密データを網羅したリストを含むデータセットがすでにある場合は、重複の一致条件が役立ちます。
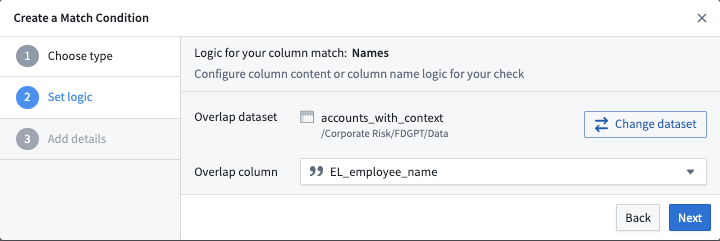
以下のスクリーンショットは、特定の列を選択する方法の例です。この例では、accounts_with_context データセットの EL_employee_name 列が、ほかのデータと照合する重複列として設定されています。重複列のいずれかのセルが別のデータセットのいずれかのセルと一致すると、その別のデータセットが、この一致条件に一致するものとして強調表示されます。