注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
データ基盤を保護する
Foundry の全体的な目標は、組織内の客観的な現実を表す標準的なビューを提供することです。この現実を表すための最初のステップは、データ基盤を構築し、権限を設定することです。データ基盤を保護する方法を説明するために、Sky Industries という架空の航空機メーカーを例に説明します。ここでは、Sky Industries の開発者として、フライト、滑走路、空港、アラート、ルート、乗客の生データを統合し、オントロジーで使用できるように準備してから、Sky Industries の組織全体で利用可能にします。
プロジェクトを作成する
データ基盤を設計するうえで重要なのは、将来の拡張や保守を容易にするために、本番データパイプラインにどのようなプロジェクトを作成する必要があるかを決めることです。この例では、推奨されるプロジェクト構成を使用し、それぞれ異なる目的を持つ3個のプロジェクトを用意します。
- Flight Control System [Datasource]: このプロジェクトでは、Bureau of Transportation Statistics (BTS) から生データを取り込み、クレンジングします。
- Flight Delays [Transform]: Flight Control System [Datasource] プロジェクトからデータセットをインポートし、加工して再利用可能なデータセットを作成します。
- Aviation [Ontology]: Flight Delays [Transform] プロジェクトからデータセットをインポートし、加工して組織内の個別のオブジェクトを表します。
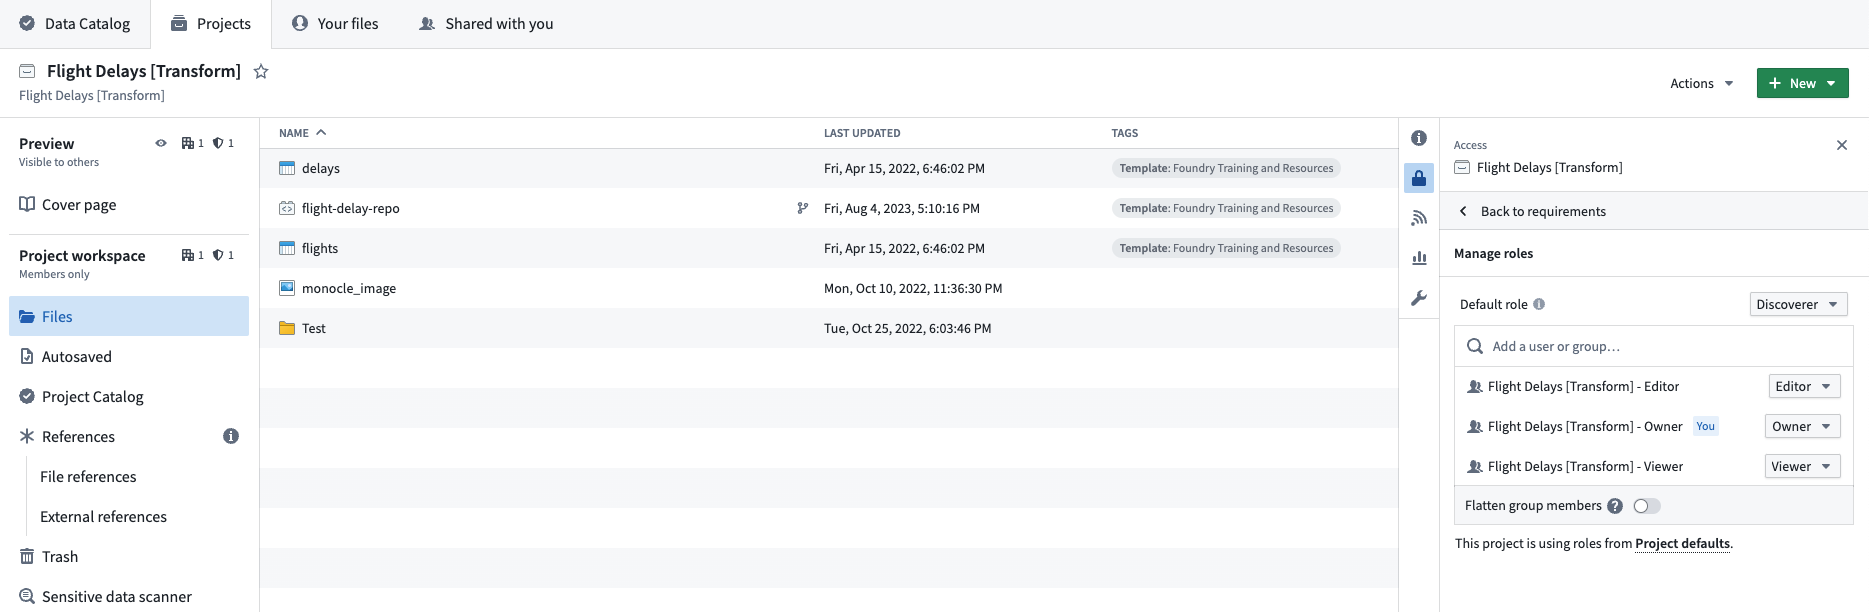
Foundry インスタンスによっては、プロジェクトとグループの両方、またはいずれかを同時に作成できます。目標は、プロジェクトごとに3個のグループを用意し、それぞれをデフォルトロール(たとえば、閲覧者)にマッピングすることです。組織内のほかのユーザーがすべてのプロジェクトを発見可能にするため、プロジェクトのデフォルトロールを発見者に設定し、プロジェクトにはマーキングを適用しません。また、各プロジェクトに、トランスフォームを配置するコードリポジトリを作成します。以下は、Flight Delays [Transform] プロジェクトの最終的な設定です。
プロジェクト参照
パイプラインを構築するプロジェクトができたので、Foundry を使用してビジネスロジックの作成を開始できます。ベストプラクティスの詳細については、データ統合のドキュメントを確認してください。
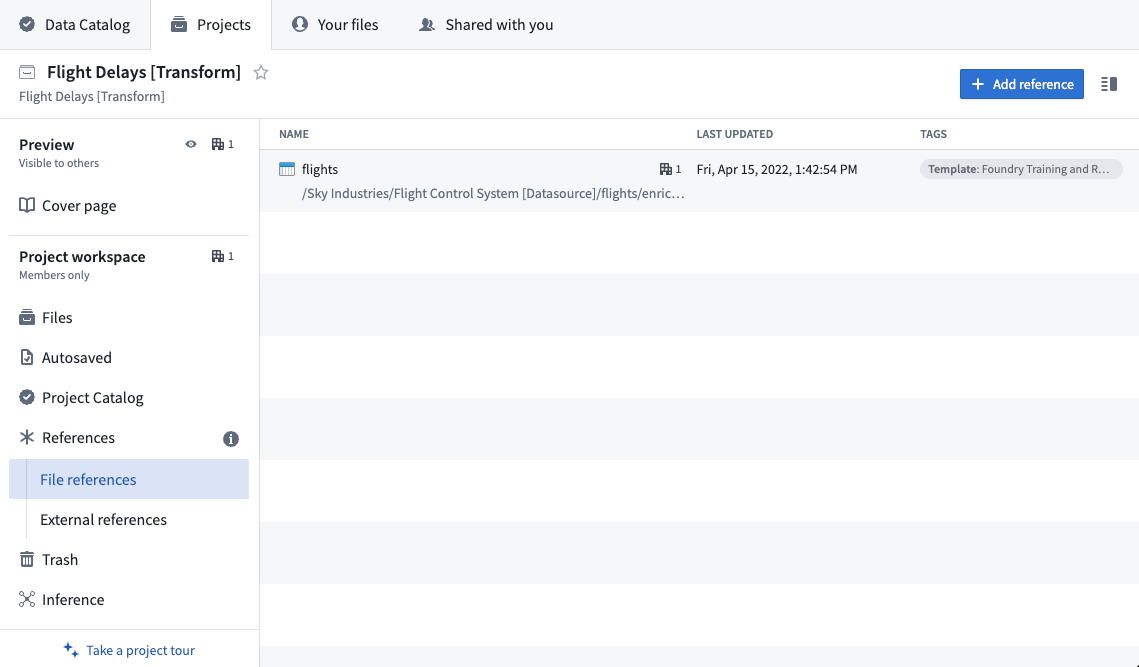
別のプロジェクトのデータを使用するには、まず現在のプロジェクトにそのデータへの参照を作成する必要があります。参照を作成すると、そのデータセットをビルドで使用できるようになり、プロジェクト内の誰でも、ソースプロジェクト自体へのアクセス権がなくても、そのデータを使うトランスフォームを作成できるようになります。
以下は、Flight Control System [Datasource] プロジェクト内の flights データセットへのプロジェクト参照を、Flight Delays [Transform] プロジェクトに追加したときの表示です。
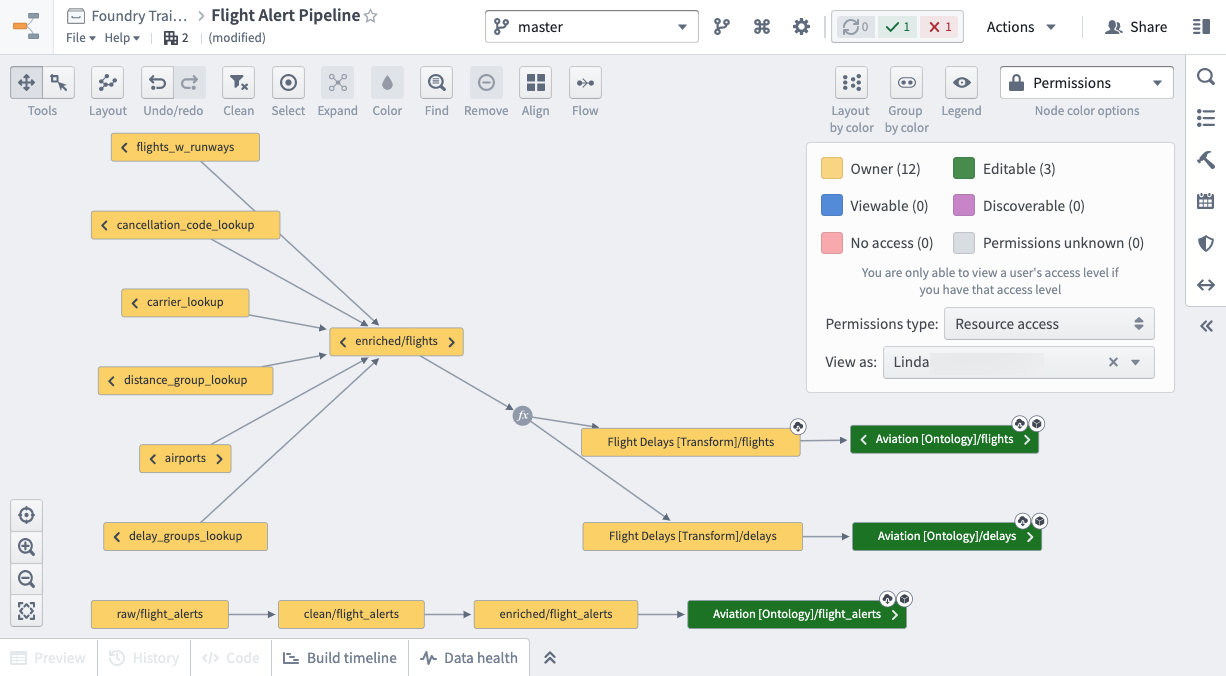
すべてのトランスフォームを記述した後の、最終的な本番パイプラインは以下のようになります。
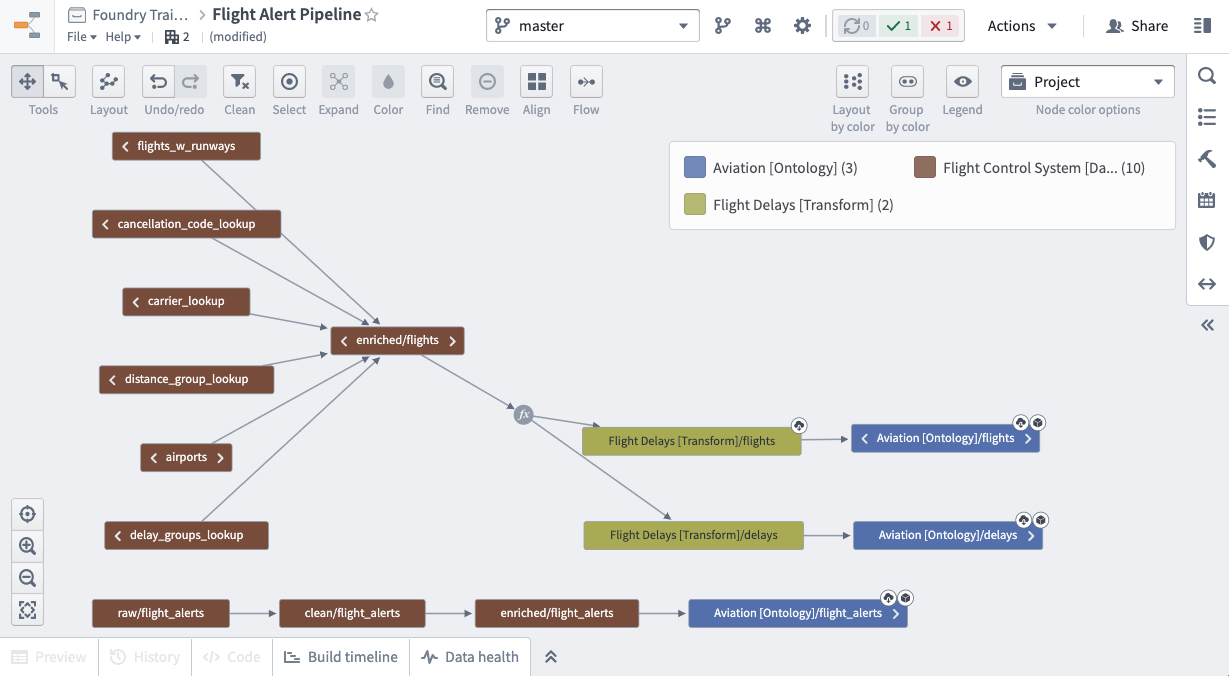
このパイプラインは3個のプロジェクトにまたがるため、プロジェクトごとに個別のロールでユーザーにアクセス権を付与できます。
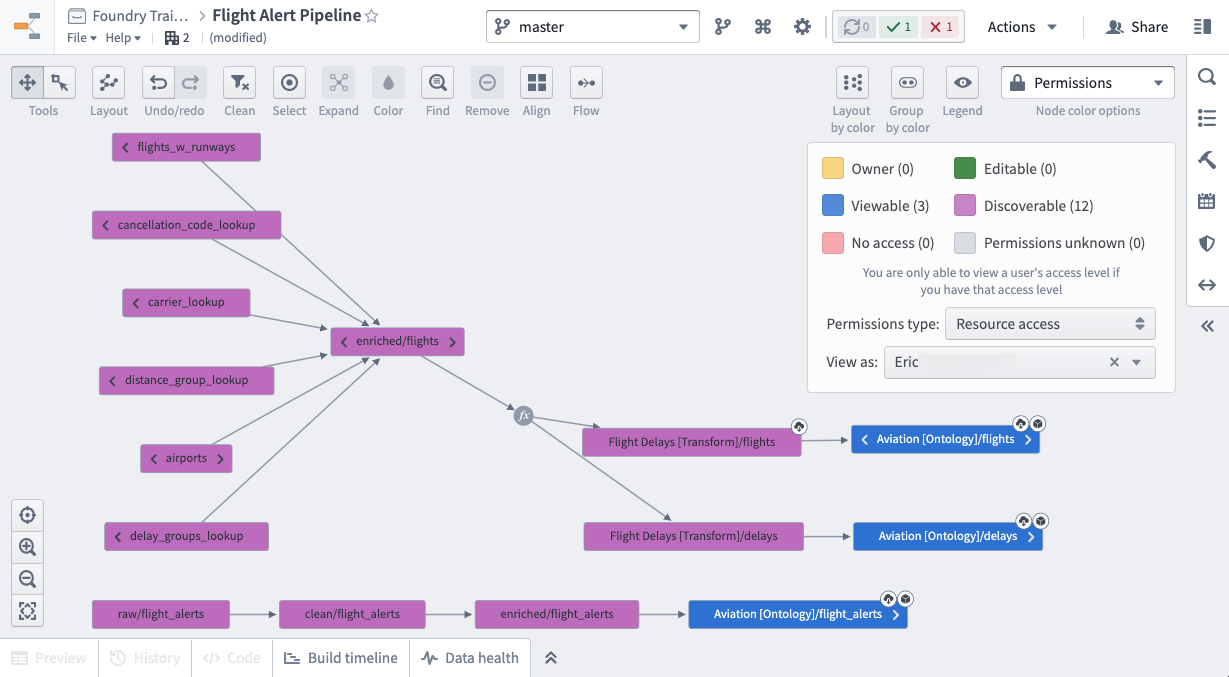
たとえば、最初の業務ユーザーである Eric を Aviation [Ontology] - Viewer グループに追加すると、Aviation [Ontology] プロジェクトに対する閲覧者のアクセス権が付与されます。デフォルトロールは発見者なので、このユーザーが Flight Control System [Datasource] および Flight Delays [Transform] プロジェクトに対して持つアクセス権は発見者のみですが、Aviation [Ontology] プロジェクトに対しては閲覧者のアクセス権を持ちます。Datasource プロジェクトに対して発見者のアクセス権を持つことは、Ontology プロジェクト内のデータのような下流データへのアクセス権の付与を妨げません。
以下は、Eric のリソースへのアクセス権の表示です。
Eric の同僚である Linda は、本番パイプラインの保守を担当します。そのため、Linda を3個すべてのプロジェクトの対応する所有者グループと編集者グループに追加します。パイプラインを個別のプロジェクトとグループに分割すると、長期的な保守が最も容易になります。
データを共有する
同僚とデータやリソースを共有する際は、適切なプロジェクトグループに追加し、プロジェクト全体で一貫したアクセス権を付与することを推奨します。この方法は、リソースを直接共有するよりもわかりやすく、管理も容易です。適切なプロジェクトグループへの所属を通じて適切なロールを付与するだけでなく、マーキングや組織への所属など、ほかのアクセス要件が満たされていることも確認する必要があります。詳細については、権限の確認セクションを確認してください。