注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
フィルターカード
フィルターカードを使うと、分析パス内のオブジェクトタイプのすべてのプロパティを対象にキーワード検索を実行できます。
利用可能な検索とフィルターの種類を以下に示します。
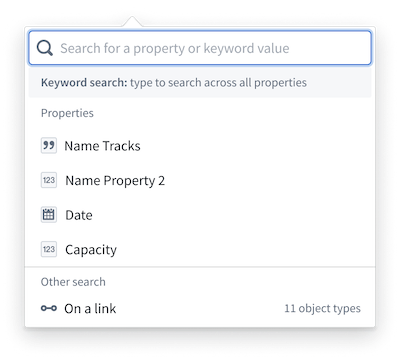
キーワード検索: 検索バーに直接入力して Enter を押すと、分析内のすべてのデータを対象に特定の値を検索できます。
プロパティ検索: プロパティを入力するか、ドロップダウンメニューから選択して、フィルターカードでさらに条件を指定します。各プロパティのデフォルトの検索種類は完全一致(等しい)ですが、プロパティタイプに応じて別のパラメーターに変更できます。たとえば、フィルターを Project Start Date is May 15, 2023 から Project Start Date is between Jan 1, 2023 and Dec 31, 2024 に変更できます。
リンクされたプロパティで絞り込む: リンクされたオブジェクトタイプに移動せずに、そのオブジェクトタイプのプロパティで絞り込みます。フィルタープロパティのドロップダウンメニューの下部にあるリンクでの選択肢を選択し、分析内の1つまたはすべてのオブジェクトタイプにリンクされたオブジェクトタイプを選びます。次に、分析内のオブジェクトタイプのうち、選択したリンク先のオブジェクトタイプにリンクされているもの、またはリンクされていないもののどちらのプロパティを検索するかを選択します。
特殊なプロパティタイプ
ベクトル、先頭ワイルドカード、正規表現のプロパティなどの追加のプロパティタイプは、分析内に存在する場合にフィルターカードの下部に表示されます。正規表現で検索可能なプロパティと構文の詳細については、検索構文のドキュメントを参照してください。
先頭ワイルドカード
先頭ワイルドカード検索では、指定した語句で終わる値を検索できます。たとえば、*smith というクエリは、Goldsmith や Blacksmith などの値に一致します。
文字列プロパティで先頭ワイルドカード検索を有効にするには、次の手順を実行します。
- Ontology Manager でオブジェクトタイプを開き、設定する文字列プロパティを選択します。
- プロパティの先頭のワイルドカードを有効にするレンダリングヒントを有効にします。
- 先頭ワイルドカードが機能するためには検索可能レンダリングヒントも必要なため、有効になっていることを確認します。
- 変更を保存し、オブジェクトタイプの元データソースを Object Storage v1 (Phonograph) に再インデックスします。次に再インデックスがトリガーされるまで待つか、データソースタブから手動で開始できます。
利用可能なレンダリングヒントの全一覧については、レンダリングヒントを参照してください。
先頭と末尾のワイルドカードを組み合わせた形式(*term*)はサポートされていません。先頭ワイルドカード(*term)または末尾ワイルドカード(term*)のいずれかを使用できますが、両方を同時に使用することはできません。文字列の部分一致が必要な場合は、Contour または Workshop のフィルターリストの正規表現モードの使用を検討してください。
検索の一致
検索クエリを入力すると、トークンと呼ばれる個々の単位に分割されます。たとえば、The Quick Brown Fox は the、quick、brown、fox の4個のトークンに分割されます。トークン化では大文字と小文字は区別されません。
アンダースコアとピリオドは区切り文字ではなく、トークンの一部として扱われます。たとえば、banana_pudding は単一のトークンとして保存されるため、ワイルドカードを使用しない限り、banana のクエリは banana_pudding に一致しません。一方、標準アナライザーでは、ハイフンはトークンの区切り文字として扱われます。well-known のような値は、2個のトークン(well と known)に分割されます。ハイフンでつながれた語句や、書式化された識別子(UUID など)を検索する際、これはよく混乱の原因になります。クエリは1個のつながった語句としてではなく、個別のトークンに分割され、それぞれが独立して照合されるためです。
アナライザーの動作、アナライザーの種類、およびプラットフォーム全体でのテキスト検索の仕組みについて詳しくは、テキスト検索についてを参照してください。
検索の種類
-
次と等しい: 解析されていないテキストとの完全一致を指定します。たとえば、
The Quick Brown FoxはThe Quick Brown Foxにのみ一致します。 -
次で始まる: 小文字に変換した検索語の末尾に
*を追加し、解析されていない生のフィールド値と照合します。 -
次を含む: 最後のトークンに部分一致を使用します。クエリ内のすべてのトークンは、最後のトークンを除き、対象フィールドと完全一致で照合されます。最後のトークンは接頭辞として照合されます。これにより、最後の単語をすべて入力する前に結果が表示されます。
例:検索語
The Quick Brown Fは、the、quick、brownを完全一致で含み、fで始まる任意の単語を接頭辞一致で含むレコードを検索します。the brown fox reached the quick rabbitを含むレコードは、すべてのトークンが存在し、foxがfの接頭辞一致を満たすため、返されます。一方、the fox quickly jumped over the brown fenceには一致しません。fenceはfの接頭辞一致を満たしますが、quicklyはquickとの完全一致とは見なされないため、トークンquickが存在しません。
一致を評価する際、トークンの順序は考慮されません。すべてのトークンが対象フィールドに存在する必要がありますが、どの位置に出現してもかまいません。この検索動作は、テキストベースのプロパティにのみ適用されます。 -
次のいずれかの単語を含む: マルチマッチフィルターを使用します。検索トークンが、指定されたプロパティの値に含まれるいずれかのトークンと完全一致すると、オブジェクトは一致します。
例:検索語
The Quick Brown Foxの場合、theORquickORbrownORfoxをクエリします。
この検索で一致する値:brown vehicle、fox hole、the quick fox ran through the forest
この検索で一致しない値:brownie、foxtrot、Many foxes move quickly -
次のフレーズを含む: 入力されたとおりの順序でトークンが連続して出現することを要求するフレーズフィルターを使用します。
例:The Quick Brown Foxのクエリは、4個のトークンが正しい順序で連続して出現するため、The quick brown fox is climbing the treeに一致します。
この検索で一致しない値:The Quick brown foxy bear: トークンfoxが独立した単語として存在しません。the brown rabbit met the quick fox near the river: トークンは存在しますが、正しい順序ではありません。the quick smart and fast brown fox: トークンの間に別の単語が出現します。
-
指定の間隔内で語句に一致: 入力したすべての語句が、互いに指定の単語数以内の間隔で出現するレコードに一致します。語句が近くにある必要はあるものの、隣接している必要はない近接検索に便利です。
次のコントロールで検索を設定します。- 語句: 検索する語句を1個以上入力します。入力する、コンマで区切る、またはリストを貼り付けることで語句を追加します。各語句は完全一致のフレーズとして照合されるため、複数の単語からなる語句も分割されません。
- 最大間隔: 語句の間に出現できる最大単語数を設定します。
- 語句を順序どおりに照合: このオプションを有効にすると、語句が入力した順序で出現することも要求されます。無効にすると、語句はどの順序で出現してもかまいません。
例:
語句が
theとfoxで、最大間隔が2単語の場合:
この検索で一致する値:the quick brown fox— 語句theとfoxの間には2個の単語(quick brown)があり、最大間隔以内です。
この検索で一致しない値:the quick brown lazy fox— 語句の間には3個の単語(quick brown lazy)があり、最大間隔を超えています。
この条件に一致するレコードを除外するには、句を反転して「指定の間隔内で語句に一致しない」にします。
よくある落とし穴
- 単語の一部を検索してもトークンとの完全一致にはなりません: デフォルトの検索の種類である「次と等しい」では、
appのクエリはapplicationに一致しません。標準アナライザーがapplicationを単一のトークンとしてインデックス化し、appはそのトークンと完全一致しないためです。クエリの語句で始まる単語を含む値に一致させるには(appをapplicationに一致させる場合など)、「次を含む」の検索の種類を使用します。クエリの最後のトークンを接頭辞として扱い、ワイルドカード検索を実行します。単語の途中にある文字列に一致させる場合(application内のcatなど)、標準の検索の種類ではどれも一致しません。正規表現を有効にしたプロパティに対して、.*cat.*のような正規表現パターンを使用する必要があります。 - ワイルドカードクエリは解析されません: ワイルドカード検索(
Quick*など)を使用すると、クエリ文字列はアナライザーで処理されず、インデックス化済みのトークンと1文字ずつ比較されます。そのため、クエリの大文字と小文字は、インデックス化済みの小文字の形式と一致する必要があります。また、インデックス化済みの各トークンは単一の単語であるため、複数の単語からなるワイルドカードクエリは一致しません。 - 先頭のワイルドカードにはレンダリングヒントが必要です: 先頭のワイルドカード検索(
*term)は、Ontology Manager で [先頭のワイルドカードを有効にする] のレンダリングヒントが有効になっている文字列プロパティでのみ利用可能です。このレンダリングヒントがない場合、先頭にワイルドカードを含むクエリは結果を返しません。