注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
ウィンドウ関数
PostgreSQL ドキュメント ↗では、ウィンドウ関数を次のように定義しています。
ウィンドウ関数は、現在の行と何らかの関係があるテーブルの行に対して計算を実行します。これは、集計関数で実行できる計算と同様のものです。ただし、通常の集計関数とは異なり、ウィンドウ関数を使用しても、行が1つの出力行にグループ化されることはありません。行はそれぞれの属性を保持します。内部では、ウィンドウ関数はクエリ結果の現在の行だけでなく、ほかの行にもアクセスできます。
このドキュメントでは、Contour の式で使用できるウィンドウ関数の一部について、その構文を説明します。ウィンドウ関数の背景について詳しくは、次の追加リソースを参照してください。
- ウィンドウ関数(PostgreSQL ドキュメント)↗
- SQL ウィンドウ関数(Mode Analytics チュートリアル)↗
- SQL ウィンドウ関数入門(Apache Drill)↗
- 分析関数(Oracle ドキュメント)↗
基本構文
ウィンドウ関数の最も基本的な構成は、次のようになります。
<function> OVER <some window>
ここで、関数はサポートされている集計関数のいずれかであり、ウィンドウはテーブル内の行のサブセットです。
() を使用すると、ウィンドウを省略できます。この場合、関数はテーブル内のすべての行に適用されます。
次の例では、date 列の最大値をすべての行に追加します。
MAX("date") OVER ()
PARTITION BY
ウィンドウの定義の前に、任意の PARTITION BY 句を追加することもできます。PARTITION BY は、指定した列の値に基づいて、ウィンドウ内の行をグループ化します。その後、集計関数が各パーティションに個別に適用されます。
たとえば、人物のレコードを含むテーブルで、次の式は男性と女性の総数をそれぞれ計算し、各行の性別の値に対応する件数をその行に追加します。
COUNT("person_id") OVER (PARTITION BY "gender")
ORDER BY
ウィンドウを定義する式では、ウィンドウの境界と、テーブル内の行の並べ替え方法を指定する必要があります。この部分式は、次のように簡略化できます。
<how to sort table> ROWS BETWEEN <start location> AND <end location>
ここで「テーブルの並べ替え方法」は、(1)並べ替えに使用する列と、(2)昇順または降順のどちらで並べ替えるかを表します。
ウィンドウの境界(「開始位置」と「終了位置」)を指定するには、次の選択肢があります。
UNBOUNDED PRECEDING:テーブルの先頭から現在の行まで。n PRECEDING(例:2 PRECEDING):現在の行の n 行前から現在の行まで。CURRENT ROWn FOLLOWING(例:5 FOLLOWING):現在の行から n 行後まで。UNBOUNDED FOLLOWING:現在の行からテーブルの末尾まで。
次のテーブル例には、上記の選択肢それぞれのラベルが付けられています。
FIRST_NAME |
------------
Adam       |<-- UNBOUNDED PRECEDING
...        |
Alison     |
Amanda     |
Jack       |
Jasmine    |
Jonathan   | <-- 1 PRECEDING
Leonard    | <-- CURRENT ROW
Mary       | <-- 1 FOLLOWING
Tracey     |
...        |
Zoe        | <-- UNBOUNDED FOLLOWING
(ソース:blog.jooq.org ↗)
販売レコードを含むテーブルがある場合、次の式を使用して、直近5件の販売の平均金額を求めることができます。
AVG("sale_value") OVER (ORDER BY "date_of_sale" ASC
    ROWS BETWEEN 4 PRECEDING AND CURRENT ROW)
「直近5件の販売」がウィンドウです。OVER の後の部分式は、テーブルを日付で並べ替えてから、各行について、前の4行と現在の行にわたる平均を計算します。
構文の組み合わせ
次の複雑な例では、上記の構文をすべて組み合わせています。 この式は、製品カテゴリーでグループ化し、現在の販売までの累積販売件数を表示します。
COUNT("sale_id") OVER (PARTITION BY "product_category"
    ORDER BY "date_of_sale" ASC
    ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW)
項目はパーティションごとに並べ替えられます。つまり、まずテーブルがパーティションに分割され、次に各パーティション内で行が並べ替えられます。
その他の例
購入した項目を記録するテーブルがあるとします。次のウィンドウ関数を使用して、購入金額の累計を表す新しい列を導出できます。
SUM("item_cost") OVER (ORDER BY "purchase_date" ASC
    RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW )
カテゴリーでグループ化した累計を計算するには、パーティションを追加します。
SUM(“item_cost”) OVER (PARTITION BY “category”
    ORDER BY “purchase_date” ASC
    RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW)
これにより、「category」列で行がパーティションに分割され、各カテゴリー内の行が購入日で並べ替えられ、そのカテゴリーに属するすべての項目の費用の累計が計算されます。
隕石データを使用した例
隕石落下データセットを使用して、次の例を試すことができます。このデータセットは、The Meteoritical Society のデータを NASA Data Portal ↗ 経由で提供したものです。
この式は、各分類で最大の隕石を計算します。
MAX("mass") OVER (PARTITION BY "class" )
上記のウィンドウ関数を使用して、新しい列 max_size_by_class を導出すると、次のようになります。
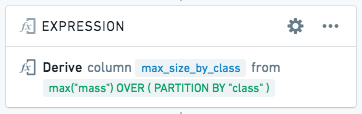
…結果のテーブルは次のようになります。
| name | class | mass | max_size_by_class |
|---|---|---|---|
| Jiddat al Harasis 450 | H3.7-5 | 217.741 | 3879 |
| Ramlat as Sahmah 422 | H3.7-5 | 3879 | 3879 |
| … | |||
| Beni Semguine | H5-an | 18 | 33.9 |
| Miller Range 07273 | H5-an | 33.9 | 33.9 |
| … | |||
| Allan Hills 88102 | Howardite | 8.33 | 40000 |
| Allan Hills 88135 | Howardite | 4.75 | 40000 |
| … | |||
| Yamato 81020 | CO3.0 | 270.34 | 3912 |
| Northwest Africa 2918 | CO3.0 | 237 | 3912 |
隕石の分類ごとに、時間の経過に沿った質量の累積合計(累計)を計算するには、次の式を使用します。
Copied!1 2 3 4SUM("mass") OVER (PARTITION BY "class" ORDER BY "year" ASC ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW )
この式は、隕石の分類でテーブルをパーティションに分割し、各パーティションを日付で並べ替えます。次に、各行について、mass 列の現在の行と、それ以前のすべての行の合計を計算し、その合計を現在の行の新しい列として追加します。
隕石の分類ごとに、質量の総合計(累計ではなく)を計算するには、次の式を使用します。
Copied!1SUM("mass") OVER (PARTITION BY "class")
この集計は単独では役に立たないかもしれませんが、式を拡張すると、より興味深い統計を計算できます。つまり、この隕石の質量が、その分類の総質量の何パーセントを占めるかを求められます。
Copied!1"mass" / (SUM("mass") OVER (PARTITION BY "class")) * 100
各分類で見つかった隕石の総数(件数)を計算するには、次の式を使用します。
Copied!1COUNT("id") OVER (PARTITION BY "class")
非決定性
ウィンドウ関数で ROW_NUMBER、FIRST、LAST、ARRAY_AGG、または ARRAY_AGG_DISTINCT を使用する場合は、非決定性に注意してください。列 A でパーティションに分割し、列 B で並べ替えているとします。列 A の値が同じ行の中に、列 B の値も同じ行が複数ある場合、これらのウィンドウ関数の結果は非決定論的になる可能性があります。つまり、同じ入力データとロジックでも、異なる結果が生成される可能性があります。