注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
式ボードの使用
Contour には、ヒストグラムやチャートなどの視覚的なツールに加えて、豊富な式言語を使える式ボードがあります。データから新しい列を作成したり、複雑な絞り込みや集計を実行したりできます。Contour の式言語は、SparkSQL の関数を多数取り入れた独自の言語です。
式内の列名は大文字と小文字を区別します。また、列名は二重引用符で囲んでも、囲まなくても記述できます。たとえば、year("birthdate_col") は year(birthdate_col) と同じです。このドキュメントでは、表記を統一するため、列名を二重引用符で囲んで記述しています。
式ボードの追加
次の概要に示すように、ツールバーから Contour 分析に式ボードを追加できます。

この例では、米国運輸統計局のオープンソースデータを使用しています。
式ボードの設定
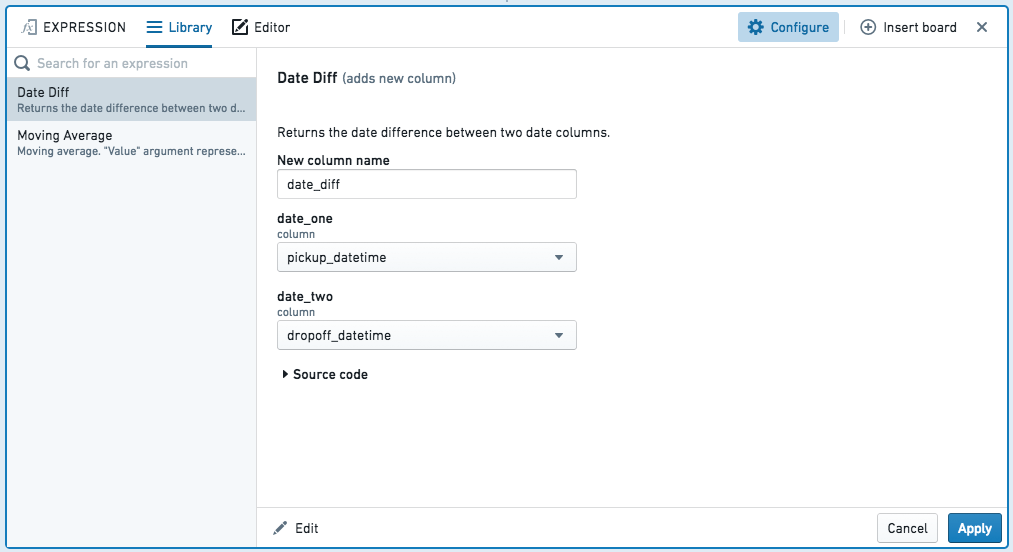
式ボードには、保存済みの式のライブラリーとエディターの2つのモードがあります。
ライブラリー
ライブラリーでは、自分やほかのユーザーが記述した式を、引数を指定して再利用できます。
エディター
エディターでは、次の4つのカテゴリーの式を記述できます。
- 新しい列の追加
- 列の置換
- フィルター
- 集計
式言語のクイックリファレンスを表示するには、? アイコンを選択します。入力すると、候補の関数がドロップダウンに表示されます。リストから関数を選択するか、Enter キーを使って挿入します。
新しい列の追加
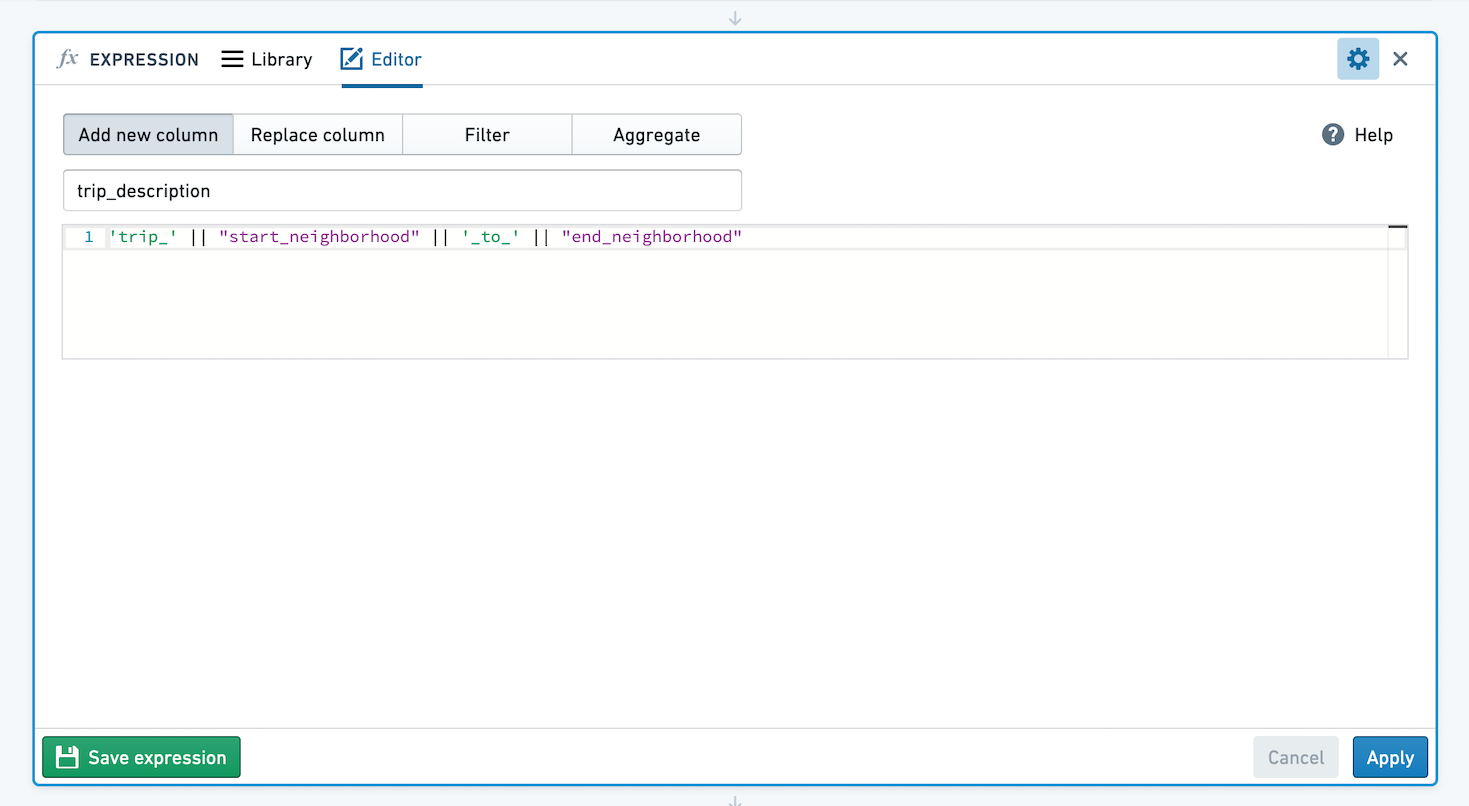
新しい列の名前と、その列を作成する式を入力します。たとえば、year("birthdate_col") を使って生年月日から年を抽出して新しい列を作成したり、ほかの列の値を連結してタクシーの乗車に関する説明の文字列を含む列を作成したりできます。
列の置換
置換する列と、置換に使用する式を選択します。
式によるデータの絞り込み
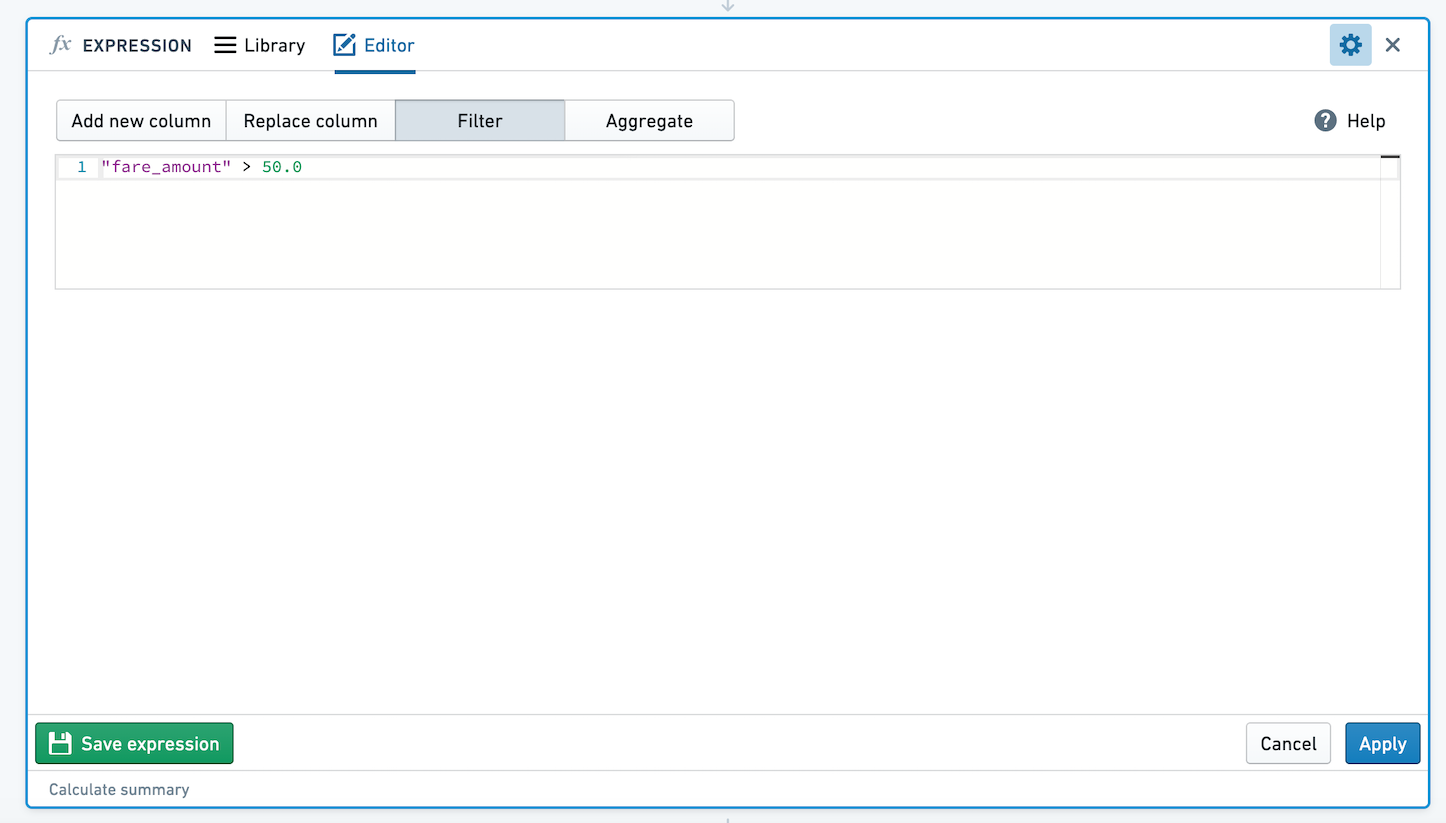
評価結果がブール値になる式を入力して、フィルター条件を定義します。式の評価結果が true になるすべての行にデータが絞り込まれます。たとえば、year("birthdate_col") == 1981 を使って1981年生まれの人だけに絞り込んだり、タクシーの乗車記録のテーブルを運賃が $50 を超える乗車だけに絞り込んだりできます。
SparkSQL の制約により、フィルター式ではウィンドウ関数(OVER 構文)を使用できません。後述するように、新しい列の作成には使用できます。
次のセクションでは、Contour で使用できるフィルター式の例を紹介します。
よく使う例
列と固定値の比較
"taxi_fare" < 25.0
"birth_date" == '1776-07-04'
式ボードのエディターでは、null = null の結果は true になります。これは、null = null の結果が null になる SparkSQL とは異なります。
等しくない演算子による絞り込み
league_id が「NHL」に等しくないすべての行に絞り込みます。
league_id != 'NHL'
2列の比較
"age" < "average_age"
チップの割合(チップを運賃で割った値)が average_tip_percentage 以上の行に絞り込みます。
("tip" / "fare") >= "average_tip_percentage"
null を含む行の削除
category が null ではないすべての行に絞り込みます。
not isnull("category")
特殊文字による列の分割
categories 列を | で分割します。| は特殊文字の一例であるため、リテラルとして扱うにはエスケープする必要があります。
SPLIT("categories", '\|')
LIKE によるパターンの検索
SQL LIKE 演算子 ↗ を使用して、列の値でパターンを検索します。
A で終わるすべての国名に一致させます。
"country_name" LIKE '%a'
複数条件による絞り込み
AND または OR を使って、2つ以上のフィルター式を組み合わせます。
("start_borough" == 'Queens') AND ("end_borough" == 'Queens')
"department" is 'sales' OR "department" is 'r&d'
最小値または最大値の行の検索
データ分析でよく行う作業の1つに、パーティション内で、ある列の値が最小または最大となる行を見つけることがあります。たとえば、患者の記録を含むデータセットから、各患者が最初に来院した日付を見つけたい場合があります。2つの式を使って、これらの行を見つけることができます。
SparkSQL はフィルター式でのウィンドウ関数に対応していないため、すべての処理をフィルター式で行うのではなく、まず新しい列を作成してから、その列で絞り込む必要があります。
まず、パーティション内の最小値または最大値を求める新しい列を作成します。次の例では、各タクシー(メダリオン番号で識別)の直近の乗車を特定し、ウィンドウ関数(OVER)を使って新しい列 most_recent_ride を作成します。
max("pickup_datetime") OVER (PARTITION BY "medallion")
次に、各行の乗車日の値と、そのパーティションの最大値を比較するフィルター式を追加します。
"pickup_datetime" == "most_recent_ride"
式によるデータの集計
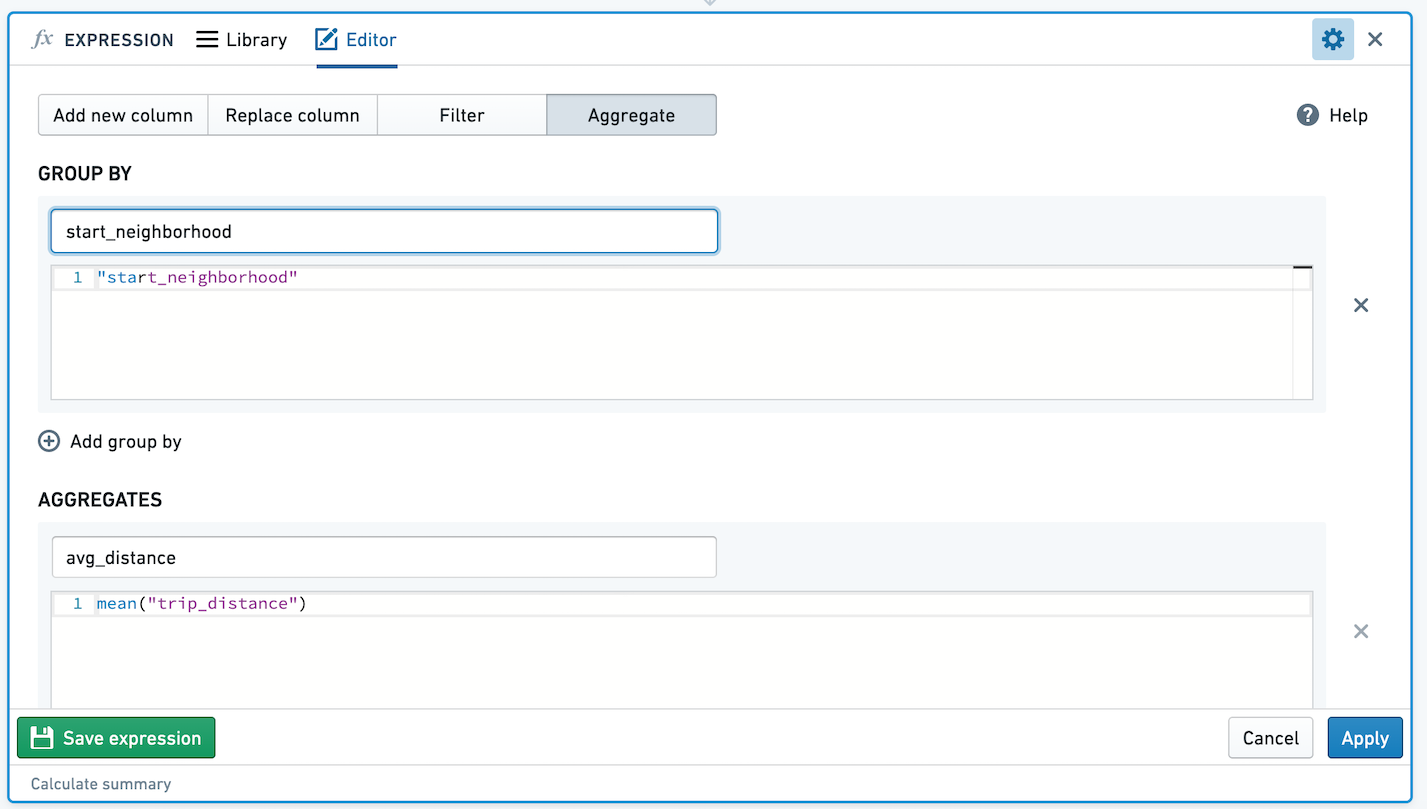
このモードでは、グループ化の式と集計式を使ってデータを集計できます。グループ化の式は0個、1個、または複数個、集計式は1個または複数個を指定できます。グループ化の式と集計式にはそれぞれ名前を付ける必要があり、結果のテーブルには、式ごとに1列で構成される新しいスキーマが適用されます。
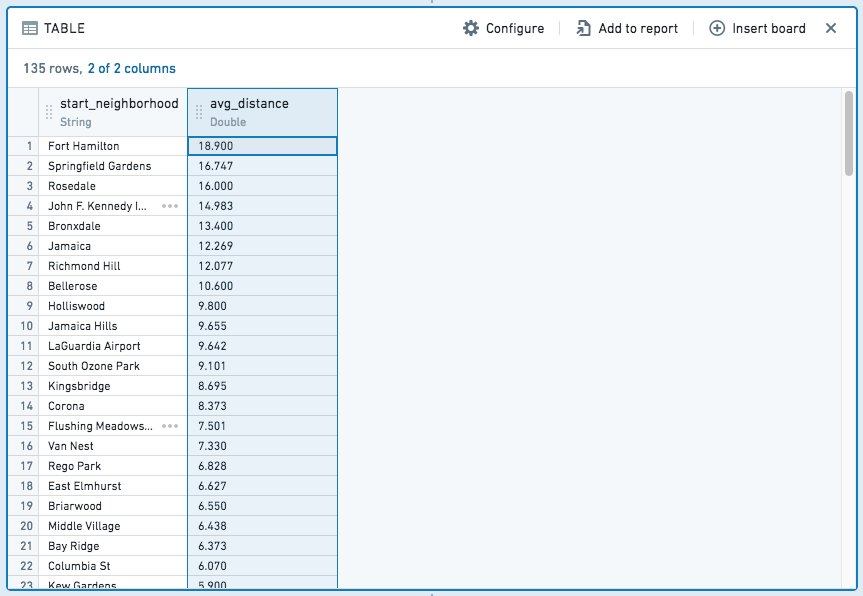
たとえば、出発地区ごとにタクシーの平均乗車距離を集計する次の式を指定した場合、
結果のテーブルは次のようになります。
列の追加やフィルターの式とは異なり、集計式では、集計とグループ化のパーティションごとの列を含むまったく新しいテーブルが作成されます。
たとえば、次のような仮のデータセットがあるとします。
| id | name | sport | birthday | number_of_gold_medals |
|---|---|---|---|---|
| 1 | Jane | 水泳 | 6/29/1985 | 6 |
| 2 | John | 体操 | 2/19/1971 | 3 |
| 3 | Mike | 水泳 | 3/23/1971 | 7 |
| 4 | Michelle | 体操 | 9/12/1971 | 5 |
獲得した金メダルの総数を知りたい場合は、次の式を使用します。

これにより、次のテーブルが作成されます。
| sum |
|---|
| 21 |
生年と競技ごとに、獲得した金メダルの総数と平均数を知りたい場合は、次の式を使用します。

これにより、次のテーブルが作成されます。
| birth_year | sport | sum | average |
|---|---|---|---|
| 1971 | 水泳 | 7 | 7 |
| 1971 | 体操 | 8 | 4 |
| 1985 | 水泳 | 6 | 6 |
集計によって作成された新しいテーブルを分析する場合は、集計済みデータに切り替えることができます。
保存済みの式
Contour では、式を保存して分析やパス間でロジックを簡単に再利用し、ほかのユーザーと共有できます。列 room_type の値が Private room の場合は True、それ以外の場合は False を値とする新しい列を作成する式を作ったとします。このロジックをほかのユーザーが使えるように、式を保存します。
式ボードの左下にある式を保存をクリックします。
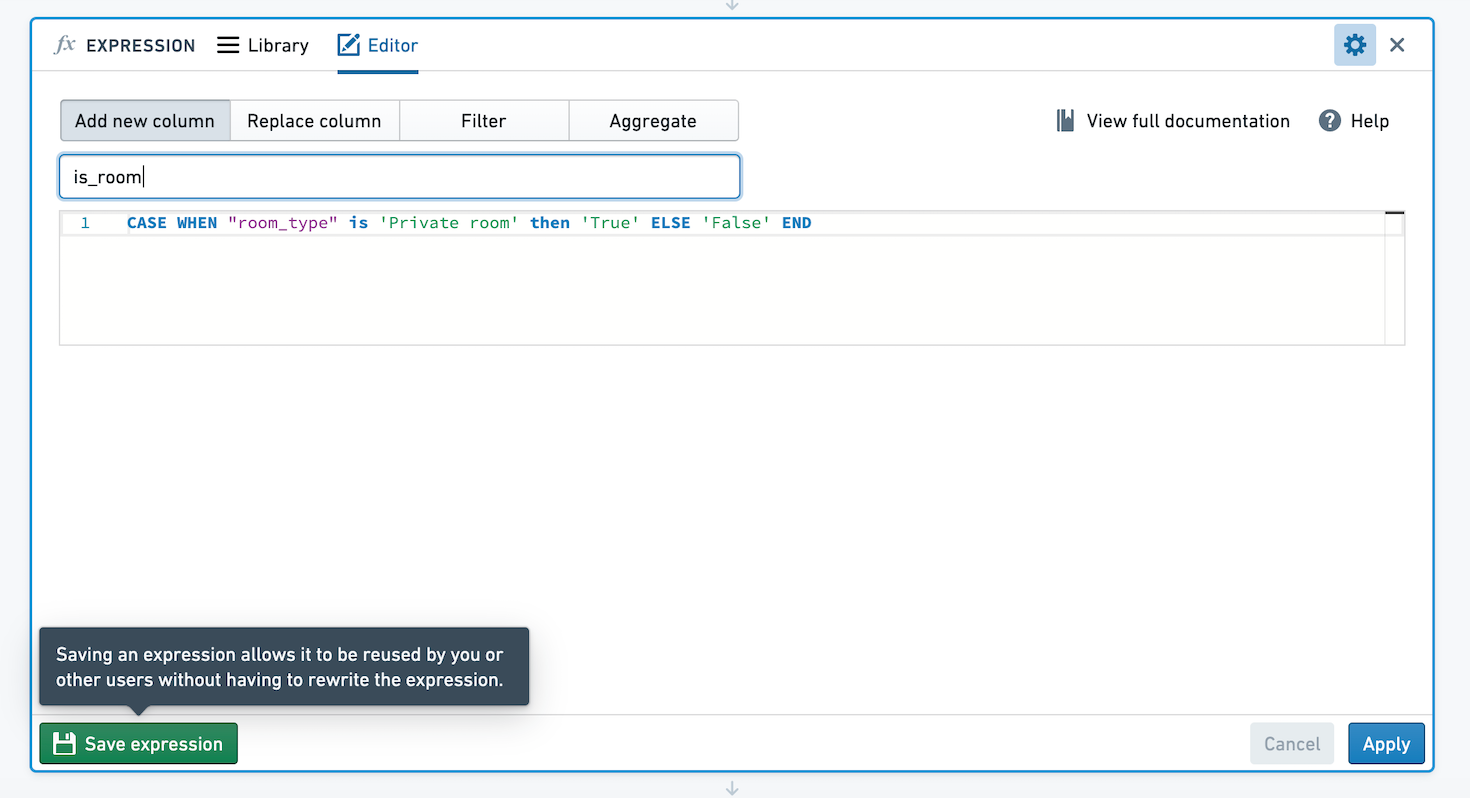
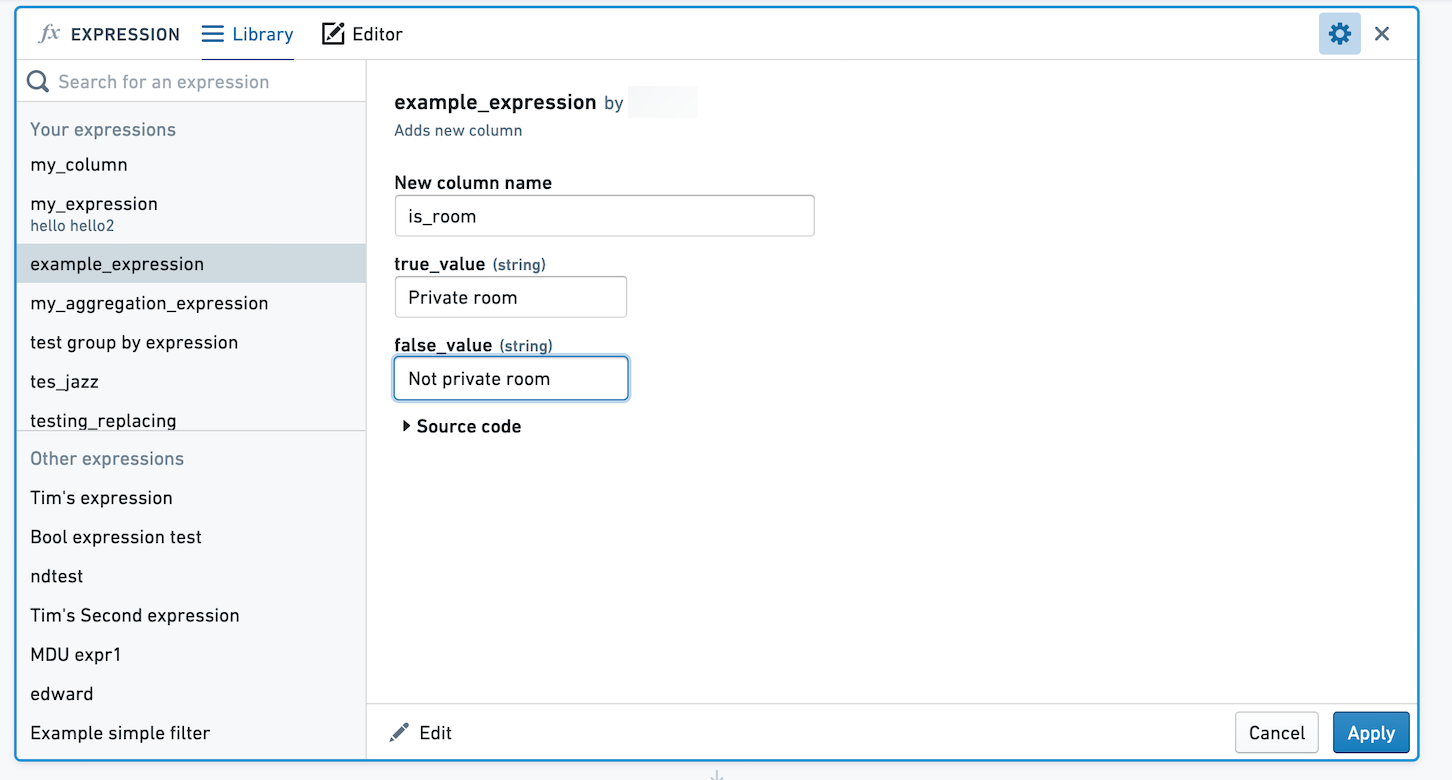
式は引数なしで保存することも、値を選択して式の引数として定義することもできます。引数なしで保存すると、適用時に式のロジックは定義したとおりに維持されます。引数を定義すると、ユーザーは引数に異なる値を選択できるようになります。以下の画像では、True と False の値をパラメーター化できます。
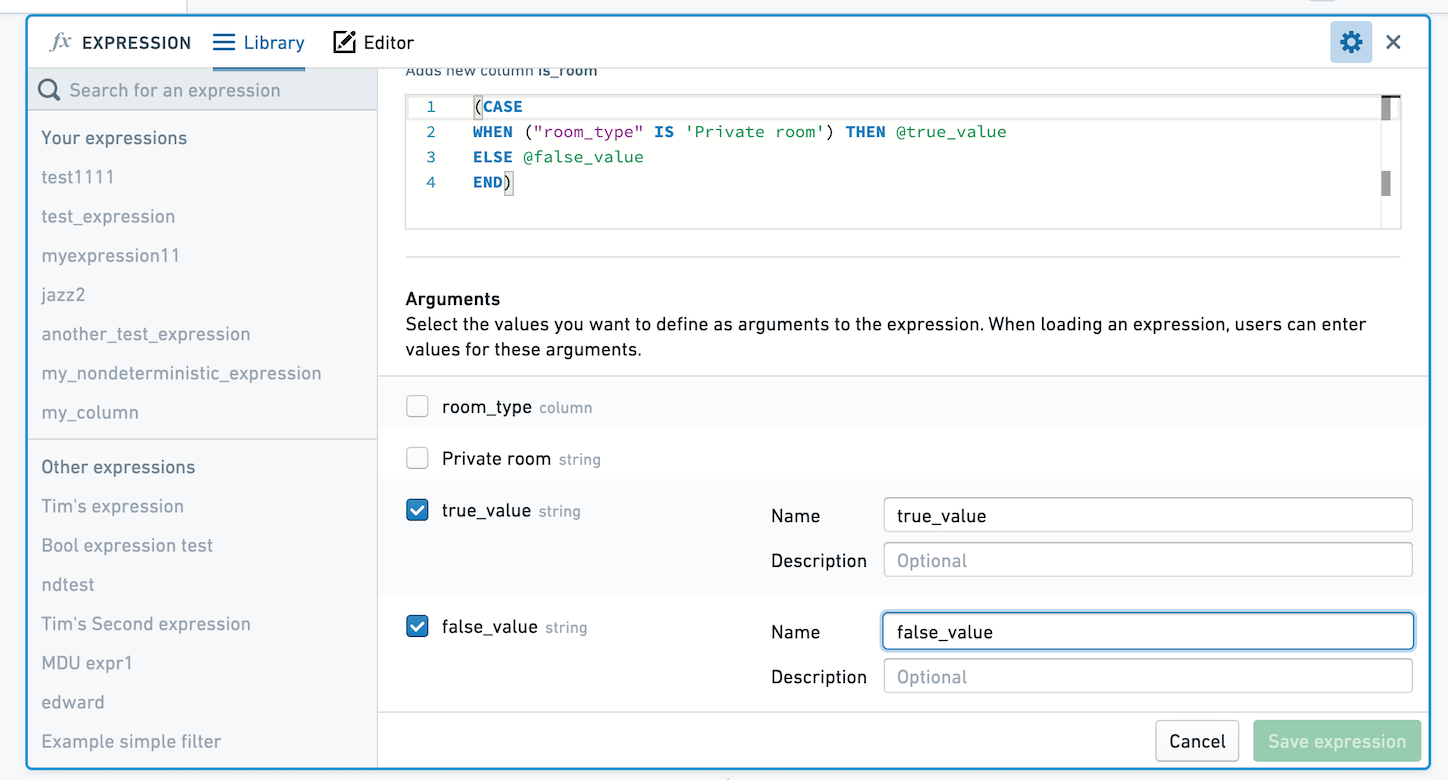
自分またはほかのユーザーがこの式を選択して適用すると、true_value と false_value の値を選択するダイアログが表示されます。ここでは、これらの値を Private room と Not private room. に対応付けています。
保存済みの集計式
集計式は、0個以上のグループ化条件に基づいてデータを集計するために使います。グループ化条件を指定せずに集計式を保存すると、その式のユーザーは、任意の数の列をグループ化条件として選択できるようになります。
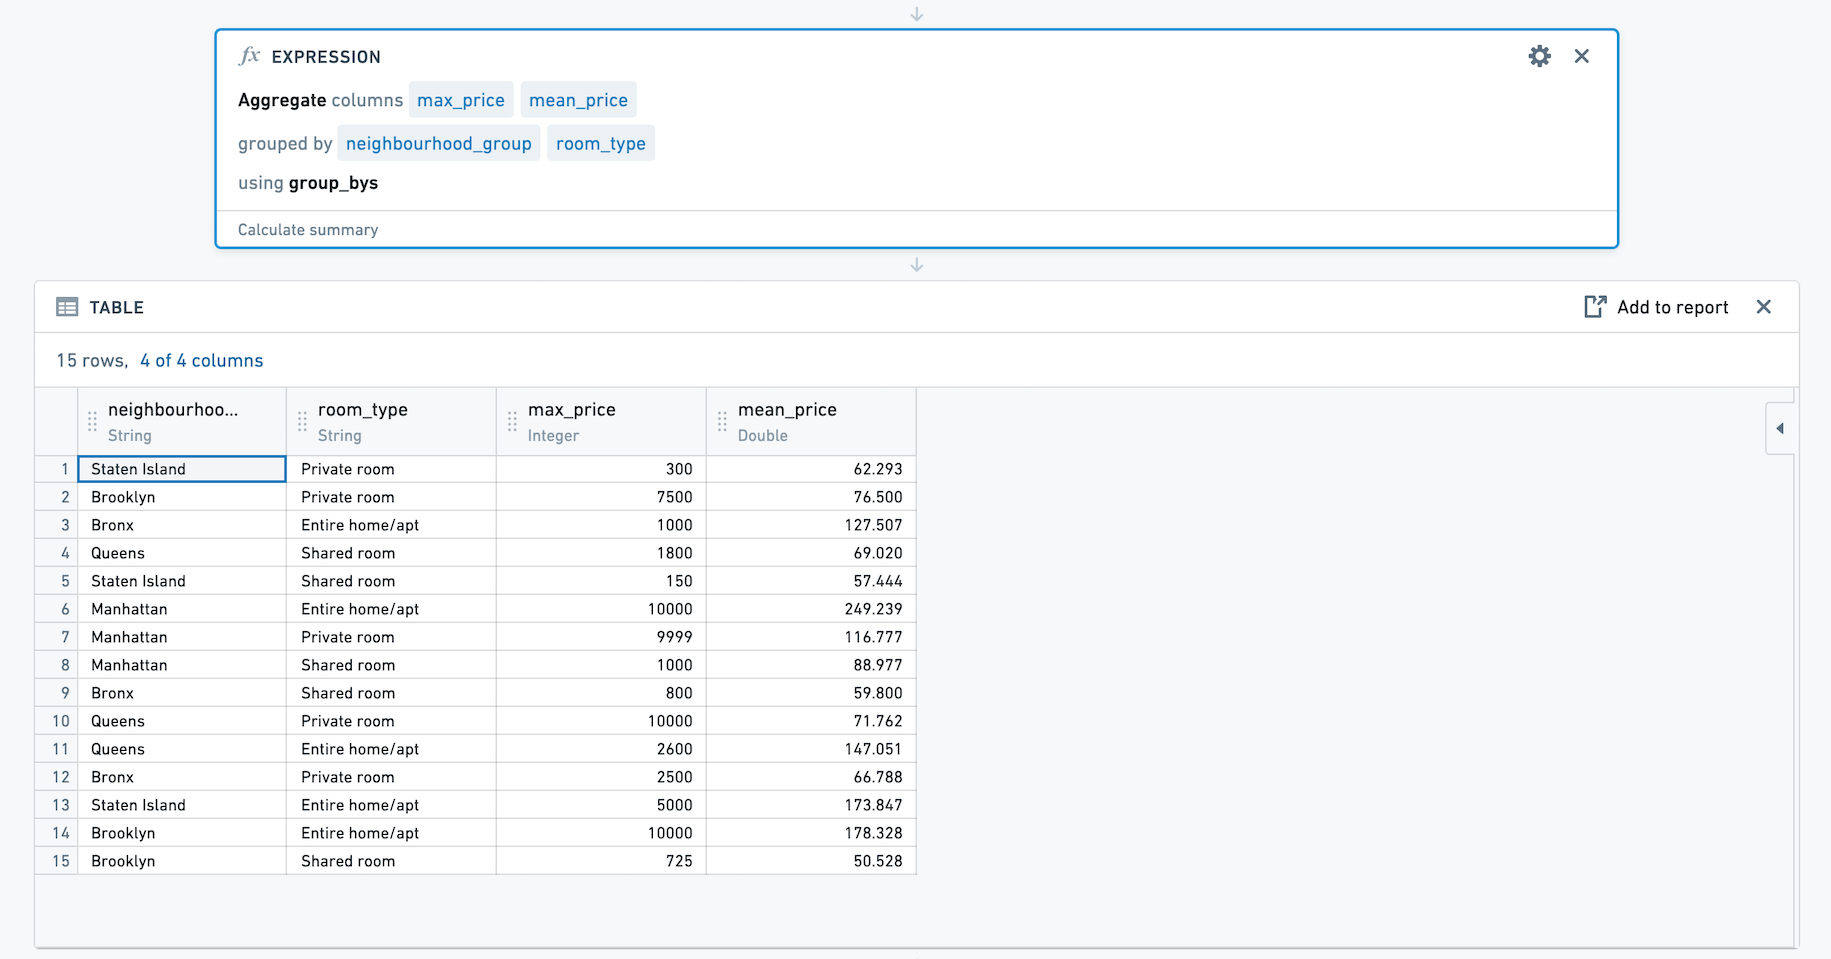
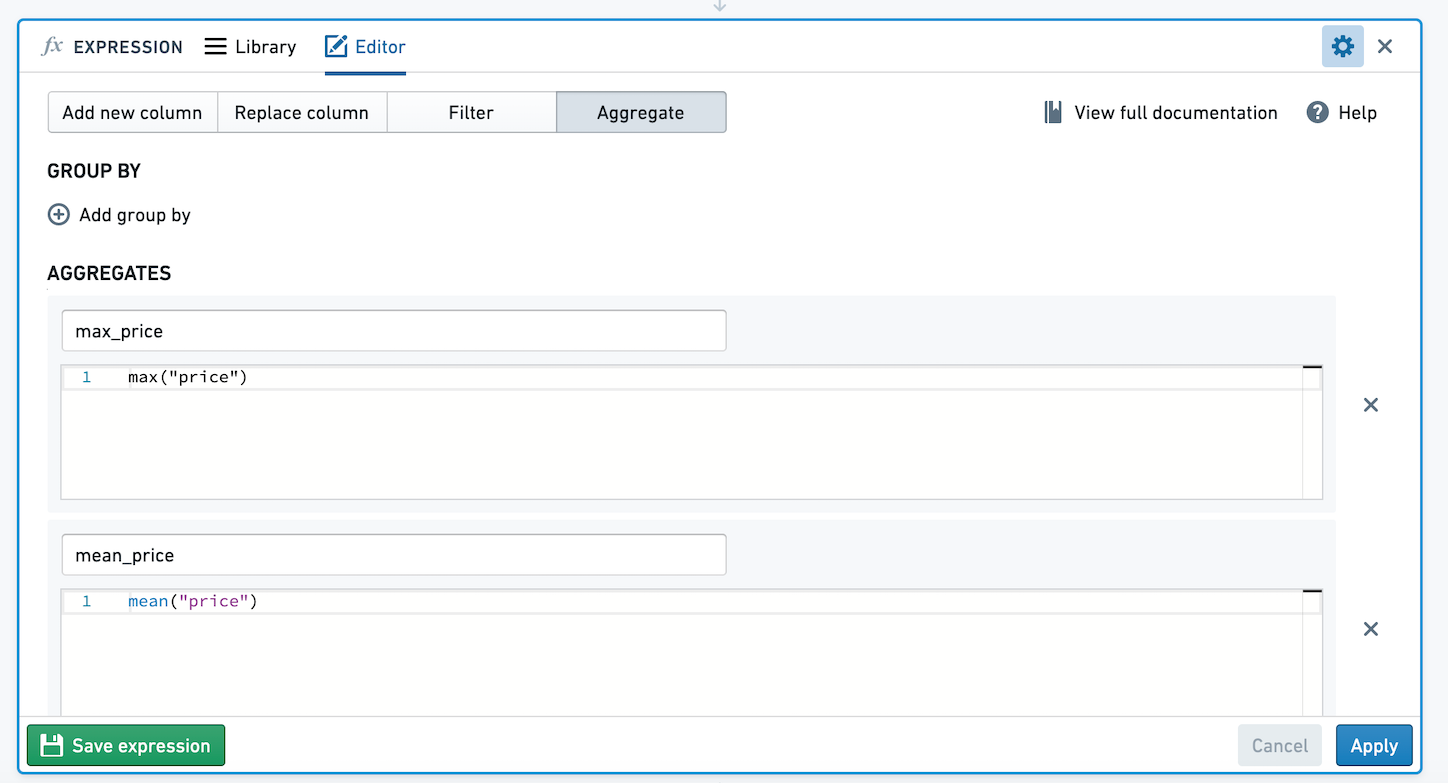
たとえば、以下の集計式では、Inside Airbnb ↗ のオープンソースデータを使用し、グループ化条件を指定せずに2つの集計を行っています。これらの集計では、price の平均と最大値を計算します。この集計式を保存します。
この式を使用すると、列セレクターが表示されます。複数の列でグループ化することを選択できます。ここでは、neighbourhood_group と room_type の組み合わせごとに、price の平均と最大値を計算します。
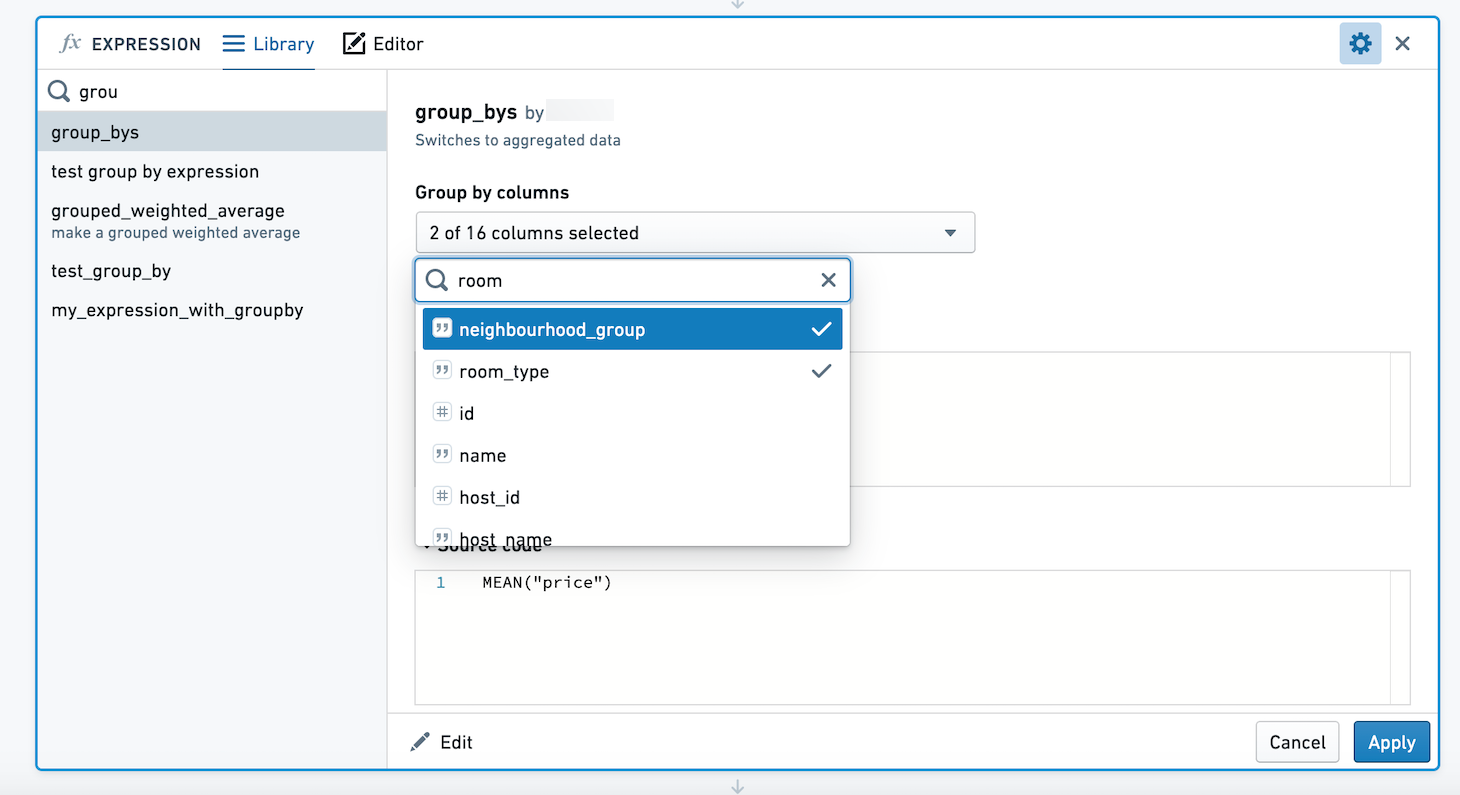
結果には、neighbourhood_group、room_type、max_price、mean_price. の4列が含まれます。