注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
Funnel バッチパイプライン
Funnel バッチパイプラインは、Foundry データソースとユーザーによる編集の両方からのデータを、バッチ方式で OSv2 に効率的にインデックス化するための内部ジョブパイプラインです。これにより、オントロジー内のデータとメタデータを最新の状態に保ちます。
Funnel バッチパイプラインの構成要素
Funnel バッチパイプラインは、一連の Foundry ビルドジョブで構成されます。
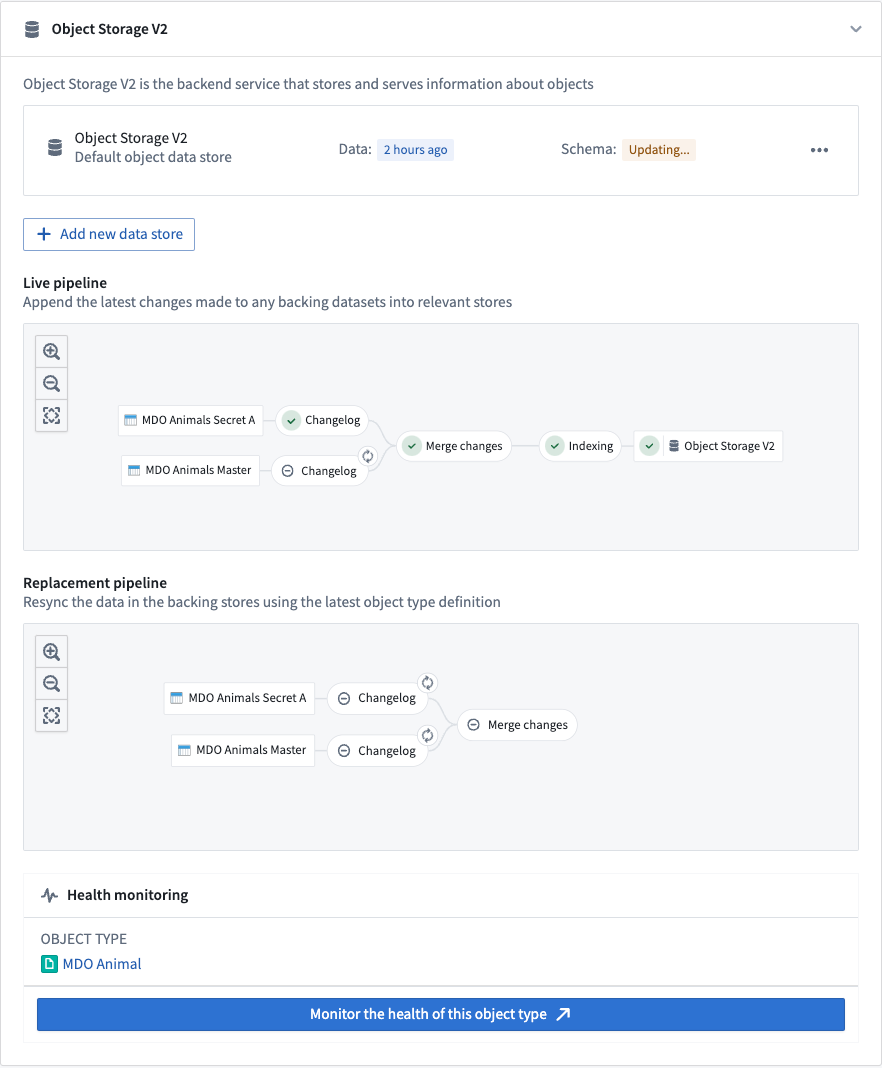
以下のスクリーンショットは、Funnel バッチパイプラインの例を示しています。
変更履歴
変更履歴ジョブでは、データソースが新しいデータやトランザクションを受け取ると、Funnel がすべてのデータソースのデータ差分を自動的に計算し、Funnel パイプライン内に中間の変更履歴データセットを作成します。変更履歴データセットは、各トランザクションのデータ差分を含む APPEND トランザクションを受け取り、インクリメンタル(差分処理)計算のセマンティクスを実現します。これらの変更履歴データセットは Funnel が所有および管理するため、ユーザーはアクセスできません。
変更のマージ
変更のマージジョブでは、変更履歴ステップで作成されたすべての変更履歴データセットと、アクションによる直近のユーザー編集を、オブジェクトタイプの主キーで結合します。これにより、すべての変更をマージして別のデータセットに保存します。これらのマージ済みデータセットは Funnel が所有および管理するため、ユーザーはアクセスできません。
インデックス化
変更がマージされると、Funnel はオブジェクトデータベースごとにインデックス化ジョブを開始し、すべての変更がマージされた最終データセットの全行を、そのオブジェクトタイプに設定されているオブジェクトデータベースに対応する形式に変換します。たとえば、標準の OSv2 データベースの場合、前のステップで変更をマージしたデータセットの全行がインデックスファイルに変換されます。これらのファイルは、別のインデックスデータセットに保存されます。これらのインデックスデータセットは Funnel が所有および管理するため、ユーザーはアクセスできません。
ハイドレーション
インデックス化ジョブが完了すると、オブジェクトデータベースは、インデックス化済みのデータに対してクエリを実行できるように準備する必要があります。OSv2 を例にすると、この準備ステップでは、データセットから OSv2 データベースの検索ノードのディスクにインデックスファイルをダウンロードします。ハイドレーションと呼ばれるこのプロセスは、この例の Funnel バッチパイプラインでオブジェクトタイプのデータを更新する最後のステップです。
ハイドレーションジョブの進行状況は、以下のスクリーンショットに示すように、Ontology Manager アプリケーションに表示されます。
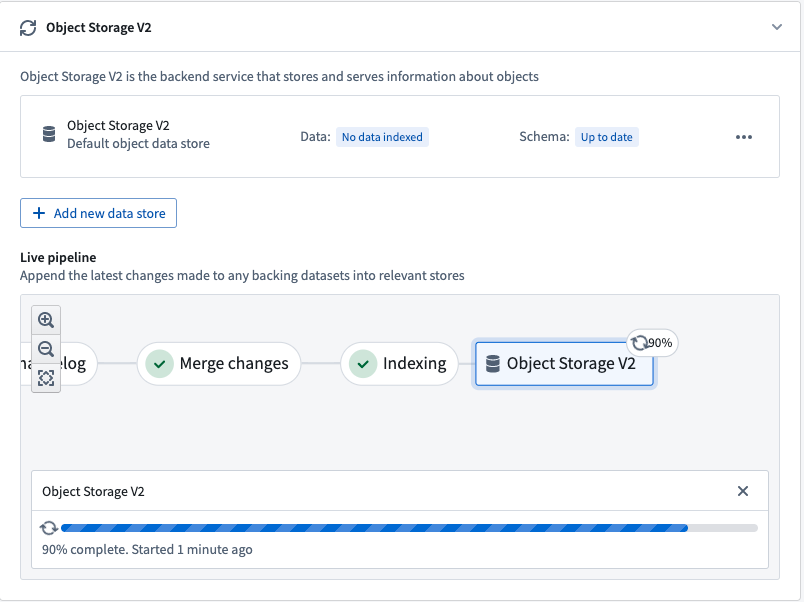
これらのステップが完了すると、オブジェクトタイプは使用可能になり、Foundry の外部または内部のほかのサービスからクエリを実行できます。
ライブおよび置き換え用 Funnel パイプライン
オブジェクトタイプのデータまたはスキーマが更新されるときは、2つの独立した Funnel パイプラインが関与します。以下のスクリーンショットは、この2つの Funnel パイプラインを示しています。
ライブパイプライン
Funnel のライブパイプラインは、Foundry データソースからの新しいデータで本番環境のオブジェクトタイプを更新します。ライブパイプラインは、対応するデータソースが更新されるたびに実行されます。また、オブジェクトに対するユーザーの編集が検出された場合は、元データセットが明示的に更新されているかどうかにかかわらず、6時間ごとに実行されます。これにより、インデックス化における変更のマージステップで、ユーザーによる編集が Funnel 所有のデータセットに保存されます。
ユーザーによる編集は、オブジェクトデータベースのインデックスに即座に適用されます。6時間ごとの定期的なジョブ実行により、組み込みの制御機構がこのデータを Foundry に永続的に保存します。
置き換え用パイプライン
オブジェクトタイプのスキーマが変更され、以前のパイプラインのスキーマが最新ではなくなった場合は、オブジェクトタイプの更新をオーケストレーションするために、新しい置き換え用パイプラインをプロビジョニングする必要があります。スキーマの変更には、オブジェクトタイプへの新しいプロパティタイプの追加、既存のプロパティタイプの変更、オブジェクトタイプの入力データソースの別のデータソースへの置き換えなどがあります。
ライブパイプラインが通常の頻度で実行され続ける一方で、Funnel は、ユーザーに提供されるライブデータに影響を与えることなく、バックグラウンドで置き換え用パイプラインをオーケストレーションします。置き換え用パイプラインの初回の実行が成功すると、ライブパイプラインは破棄され、置き換え用パイプラインに置き換えられます。それに伴い、オブジェクトタイプのスキーマとデータが更新されます。
Funnel が置き換え用パイプラインをプロビジョニングする最も一般的な理由はスキーマの変更ですが、さまざまなヒューリスティクスに基づき、パフォーマンス上の理由で置き換え用パイプラインを自動的にプロビジョニングすることもあります。
インクリメンタルおよび完全再インデックス化
以下のドキュメントは、標準の Object Storage v2 データストアに固有のものです。Object Storage v1 (Phonograph) のインデックス化の動作については、OSv1 のドキュメントを参照してください。
インクリメンタル(差分処理)インデックス化(デフォルト)
標準の Object Storage v2 データストアは、データソースの新しいトランザクションごとにデータの差異を自動的に計算し、新しいデータ更新のみをインクリメンタルにインデックス化します。Funnel パイプラインは、すべてのオブジェクトタイプに対してデフォルトでインクリメンタルインデックス化を使用します。インクリメンタルインデックス化により、すべてのデータを再度インデックス化する場合よりも Funnel パイプラインを高速に実行できます。
たとえば、100行のデータソースに基づく、100個のオブジェクトを持つオブジェクトタイプがあるとします。新しいデータ更新でそのうち10行が変更された場合、Funnel バッチパイプラインは、入力データソースのトランザクションの種類にかかわらず100個すべてのオブジェクトを再インデックス化するのではなく、変更された10行のみを含む新しい APPEND トランザクションを変更履歴データセットに作成します。
インクリメンタルデータセットのインクリメンタルインデックス化
Object Storage v2 は、インクリメンタルデータセットに基づくオブジェクトタイプを同期する際に、「最新のトランザクションを優先する」方式を使用します。データセットに同じ主キーを持つ行が複数ある場合、最新のトランザクションに含まれる行のデータがオントロジーに反映されます。単一のトランザクション内で主キーを重複させることはできません。この動作は、ユーザーによる編集とデータソース更新の競合の処理方法とは関係ありません。
APPEND トランザクションを通じて行の更新を受け取るインクリメンタルデータセットを考えます。これは通常、変更履歴データセットと呼ばれます。同じデータの新しいバージョンは、値が更新され、主キーは同じままの新しい行として表され、1回のトランザクションでデータセットに追加されます。is_deleted という名前の列は、デフォルトでは削除列として扱われません。削除列を使用するには、その列を識別するレガシー Object Storage v1 変更履歴メタデータをデータソースのスキーマに含める必要があります。
Object Storage v2 は、変更履歴データセットを次のように同期します。
- 主キーが複数のトランザクションに出現する場合、最新のトランザクションの行が保持されます。
- 各トランザクションに含められる行は、主キーごとに最大1行です。
- 削除列は、レガシー Object Storage v1 変更履歴メタデータで宣言されている場合にのみ適用されます。
各トランザクションに含まれる行を主キーごとに最大1行にするために、変更履歴データセットに対してインクリメンタルウィンドウトランスフォームを実行する必要があると考えられます。
Copied!1 2 3 4 5 6from pyspark.sql.window import Window from pyspark.sql import functions as F ordering_window = Window().partitionBy('primary_key').orderBy(F.col('ordering').desc()) df = df.withColumn('rank', F.row_number().over(ordering_window)) df = df.filter((F.col('rank') == 1) & ~F.col('is_deleted'))
Iceberg テーブルデータソース
OSv2 オブジェクトタイプのデータソースとして使用する Iceberg テーブルでは、現在の内容全体で、オブジェクトの主キーごとに最大1行しか含めることができません。Iceberg は、行を追加する際にこの要件を強制しません。
行を追加すると、データセットと Iceberg テーブルのどちらでも既存の行は保持されます。インクリメンタルデータセットの場合、OSv2 は主キーごとに最新のトランザクションの行を使用して、インデックス化されるオブジェクトにデータを設定します。主キーが重複する行を追加してオブジェクトを更新する方法は、Iceberg テーブルデータソースではサポートされていません。
Iceberg テーブルに基づくオブジェクトタイプは、主キーの重複をサポートしていません。重複が存在していてもインクリメンタルインデックス化は成功したように見える場合がありますが、重複する主キーが1つでも残っていると完全再インデックス化は失敗します。また、重複する行の1つを削除すると、同じ主キーを持つ別の行がテーブルに残っていても、オブジェクトがインデックスから削除される場合があります。
主キーの一意性を維持するには、新しい主キーの行のみを追加し、既存の行の変更には UPDATE または MERGE INTO を使用します。
データセットデータソースを Iceberg テーブルに移行する前に、パイプラインがテーブルの現在の内容全体で主キーの一意性を維持していることを確認してください。既存の主キーを持つ行を追加してオブジェクトを更新するパイプラインの場合は、テーブルの現在の内容全体で主キーの一意性を維持するようになるまで、データセットデータソースを引き続き使用してください。
ビューのインクリメンタルインデックス化
データセットビューには、インクリメンタルインデックス化に関する制限があります。ビューは基になるデータ構造を抽象化するため、Funnel はコストを削減するためにインクリメンタルビルドの使用を試みます。ただし、次の制限が適用されます。
- 削除列を持つビューは、Funnel がどの行が削除されたかを判断できないため、常に完全再インデックス化されます。
- 重複排除列の値がトランザクションの順序と矛盾する場合、インクリメンタルビルドによって一貫性のない結果が生じる場合があります。Funnel は「最後の編集を優先する」方式を使用します。重複排除列の値が大きい行であっても、インクリメンタルウィンドウの範囲外にある場合は無視されます。これを回避するには、削除列を追加して完全再インデックス化をトリガーするか、重複排除列の値がトランザクションごとに必ず増加するようにしてください。
- 基になるデータセットの最新ビューから削除する保持ポリシーにより古いデータが削除されると、予期しない結果が生じる場合があります。このような場合、完全再インデックス化によって正しい結果が生成されます。
完全再インデックス化(特殊なケース)
Funnel パイプラインは、次の場合にバッチインデックス化(すべてのオブジェクトを再インデックス化)を使用します。
- 同じトランザクションで入力データソースの行の一定割合を超える行が変更された場合、変更履歴を計算してインクリメンタルにインデックス化するよりも、再インデックス化のほうが計算コストを抑えられ、高速になる場合があります。デフォルトのしきい値は、同じトランザクションで行の80%が変更された場合に設定されています。
- オブジェクトタイプのスキーマに対する特定の変更で、Funnel 置換パイプラインが必要になる場合。このパイプラインは、まったく新しい Funnel パイプライン(OSv2 インデックスを含む)をバックグラウンドで作成します。
- ユーザーが Ontology Manager から完全再インデックス化をトリガーした場合。
Funnel パイプラインを監視する
Funnel パイプラインは複数のビルドジョブで構成されています。監視ビューでは、監視ルールを作成することで、Funnel パイプラインの特定のジョブの正常性を追跡できます。
Ontology Manager でこのオブジェクトタイプのヘルスを監視を選択すると、監視ビューを作成できます。次のスクリーンショットに示すように、Data Health アプリケーションの監視ビュータブに移動します。
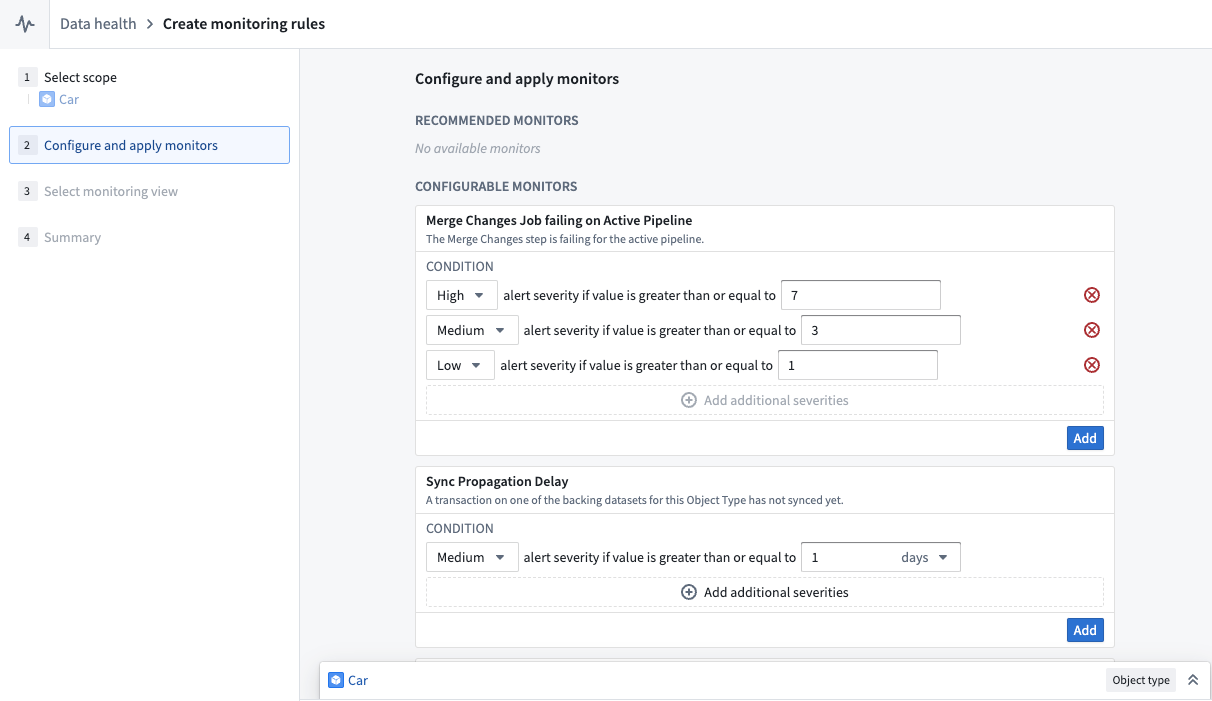
監視ビュータブから、ライブパイプラインと置換パイプラインの両方でジョブを監視するルールを作成できます。また、同期伝播遅延ルールを追加すると、オブジェクトデータベースのインデックス化済みデータの鮮度がルールで定義したしきい値を超えたときに通知を受け取れます。
一方、Object Storage v1 (Phonograph) は、オントロジーリソースの同期を監視するためにヘルスチェックを使用します。OSv1 ではオブジェクトタイプの同期ジョブは1個のみで、これらのヘルスチェックを同期ジョブに直接定義できます。
パイプラインをデバッグする
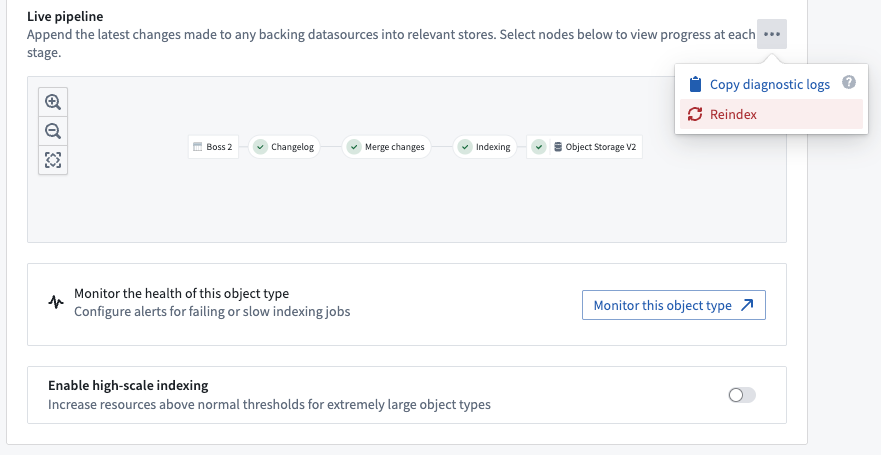
Foundry のビルドジョブは、さまざまな理由で失敗する場合があります。オブジェクトタイプの元データソースに対する閲覧権限を持つユーザーは、オブジェクトタイプのデータソースタブにあるライブパイプラインダッシュボードから、パイプラインのエラーを確認できます。パイプライングラフで失敗したジョブを選択し、次のスクリーンショットに示すように失敗したジョブを選択します。
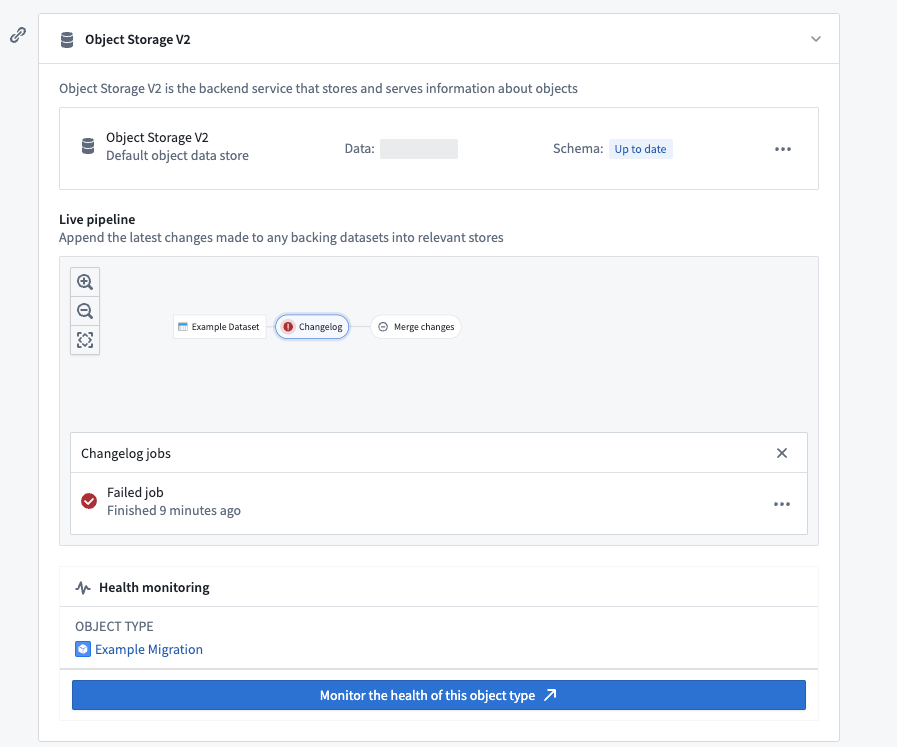
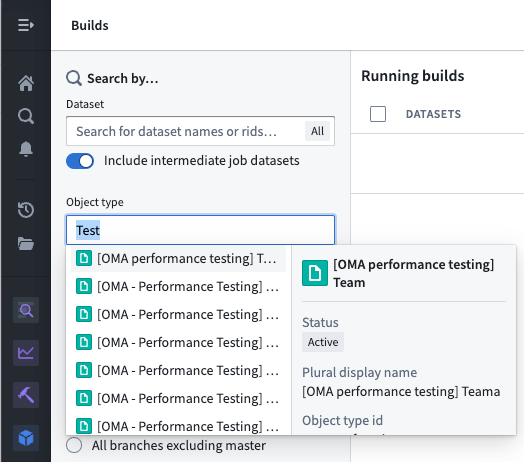
または、Builds アプリケーションに移動し、左側のパネルの検索フィルターでオブジェクトタイプによる絞り込みを行うことで、特定のオブジェクトタイプのすべてのビルドジョブを一覧表示できます。