注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
Object Set Service の制限
Object Set Service (OSS) は、オントロジーのオブジェクトに対するクエリと取得を担うサービスです。OSS は、パフォーマンスとスケールのバランスを取るために階層型の実行戦略を使用し、クエリのサイズと複雑さに基づいて最適な方法を自動的に選択します。
このページでは、OSS がさまざまなサイズのクエリを処理する方法と、オブジェクトセットを扱う際に把握しておくべき制限について説明します。
クエリ実行戦略
OSS は階層型の実行戦略を使用し、クエリを処理する最適な方法を自動的に選択します。
-
ストレージ層へのプッシュダウン: 単純なクエリでは、OSS は操作をストレージ層に直接プッシュダウンし、インデックス化済みのデータ構造を活用します。これは最も高速な実行経路であり、コンピューティングのオーバーヘッドを最小限に抑えます。
-
インメモリー実行: より複雑な操作を含むクエリでは、OSS は一定の容量までデータをメモリーに読み込み、高速に処理します。これは中規模のクエリに最適です。
-
Spark ベースの実行: インメモリー容量を超える大規模なクエリでは、OSS は Spark ベースの分散コンピューティングに自動的にフォールバックします。これにより、遅延とコンピューティング使用量が増加する代わりに、はるかに大きなオブジェクトセットを処理できます。
これらの実行戦略の切り替えは、次の複数の要因に基づいて自動的に行われます。
- オブジェクトセットのサイズ: セットが大きくなると Spark 実行が開始されます
- 利用可能なコンピューティングリソース: OSS はパフォーマンスとリソース使用率のバランスを取ります
OSS は、1つの複雑なクエリ内で、実行段階ごとに異なる実行戦略を使用する場合があります。それぞれの方法のしきい値と制限を理解することで、効率的なクエリを設計し、パフォーマンス特性を把握できます。
Object Storage v2 における OSS の実行フロー
次の図は、OSS がクエリに基づいて適切な実行戦略を選択する方法を示しています。この判断プロセスは、各段階の複雑さに応じて、1つのクエリ内で複数回実行される場合があります。
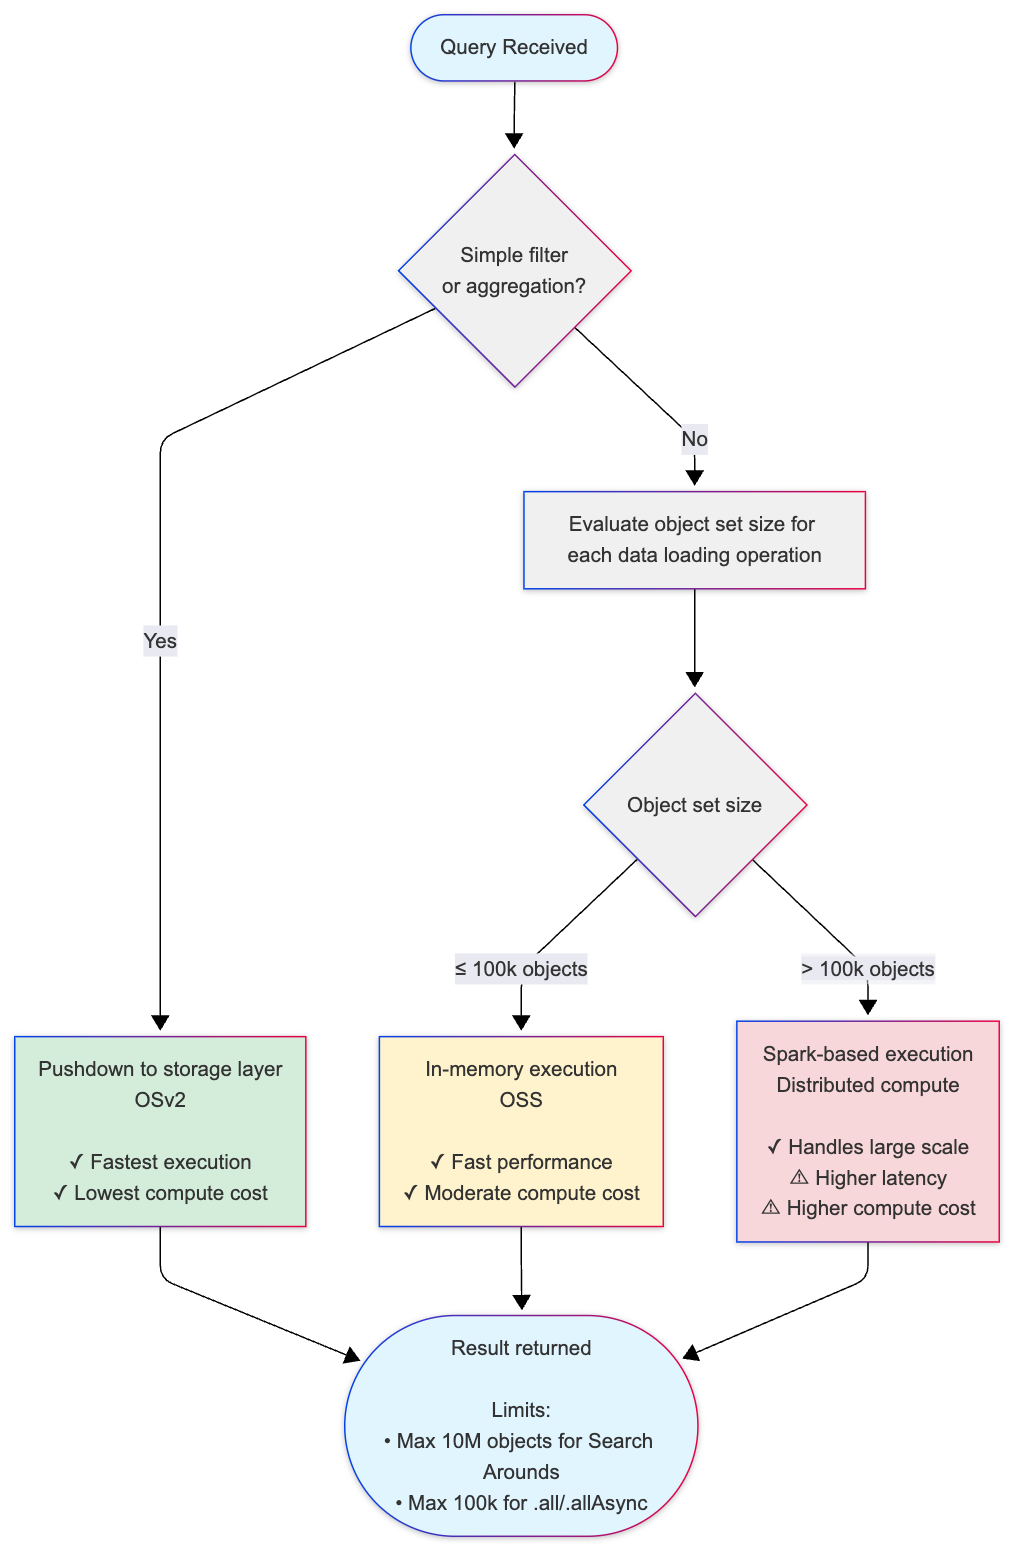
主なしきい値:
- 100,000個のオブジェクト(デフォルトのしきい値): 関連検索と派生プロパティで、インメモリー実行から Spark ベースの実行に切り替えるしきい値です。
- 内部ページネーションのしきい値: いずれかのデータ読み込みステップで Object Storage v2 から25ページを超えるデータが必要な場合、OSS は Spark にフォールバックします。
- 10,000,000個のオブジェクト(デフォルトのしきい値): 関連検索操作の結果セットの最大サイズです(リーフ制限)。
- 100,000個のオブジェクト(デフォルトのしきい値):
.all()または.allAsync()を使用してメモリーに読み込めるオブジェクトの最大数です(オントロジー SDK の制限。getAllObjectsAPI では、より多くのオブジェクトを読み込めます)。
実行戦略の比較
| 戦略 | 使用条件 | パフォーマンス | コンピューティングコスト | ユースケース |
|---|---|---|---|---|
| ストレージへのプッシュダウン | 単純なフィルターと集計 | 最速 | 最低 | インデックス化済みの参照で解決できる基本的なクエリ |
| インメモリー実行 | オブジェクトセットが100,000個以下 | 高速 | 中程度 | ほとんどの関連検索、中規模のクエリ |
| Spark ベースの実行 | オブジェクトセットが100,000個超 | 低速(遅延が大きい) | 高い | 大規模な関連検索、複雑な複数ステップのクエリ |
オブジェクトセットのサイズ制限
OSS は、ストレージバックエンドと操作タイプに応じて異なるサイズ制限を適用します。これらの制限により、システムの安定性と予測可能なパフォーマンスを確保します。
Object Storage v1 (Phonograph) [廃止予定]
Object Storage v1 (Phonograph) は開発ライフサイクルの廃止予定段階にあり、2026年6月30日を過ぎると利用できなくなります。Object Storage v2 にオブジェクトタイプとリンクタイプを移行してください。
Object Storage v1 には次の制限があります。
- メモリーへのオブジェクトの読み込み:Functions on Objects の
.all()または.allAsync()メソッドを使用して読み込めるオブジェクトは、最大 100,000個です。 - 関連検索操作: オブジェクトセット A からオブジェクトセット B への関連検索を実行する場合、結果セット(オブジェクトセット B)は 100,000個のオブジェクトを超えることはできません。
これらの制限は、Object Storage v1 のすべての操作に適用されます。より大きなクエリに対して、Spark ベースの実行への自動フォールバックは行われません。
Object Storage v2
Object Storage v2 は、ハイブリッド実行モデルによって、より高い柔軟性とスケールを提供します。
- インメモリー実行: デフォルトでは、OSS は最大 100,000個のオブジェクトを含むオブジェクトセットのクエリをインメモリーで処理します。
- Spark ベースの実行: 関連検索操作の対象が 100,000個のオブジェクトを超える場合、OSS は Spark ベースの分散コンピューティングに自動的に移行します。
- 関連検索の結果制限: 関連検索操作の結果セット(単一のデータソースから読み込まれる「リーフ」オブジェクトセット)は、個々の関連検索操作ごとに 10,000,000個のオブジェクトを超えることはできません。さらに、クエリ実行中に読み込まれるすべてのデータセットに含まれるオブジェクトの合計数は、30,000,000個を超えることはできません。
- メモリーへのオブジェクトの読み込み(オントロジー SDK の制限): オントロジー SDK の
.all()または.allAsync()メソッドを使用してオブジェクトを読み込む場合、メモリーの枯渇と関数のタイムアウトを防ぐため、最大数は 100,000個のオブジェクトです。getAllObjectsAPI エンドポイントを使用すると、より多くのオブジェクトを読み込めます。
Functions on Objects で10,000個を超えるオブジェクトを読み込むと、関数のロジックの複雑さによっては実行がタイムアウトする場合があります。ページネーションや絞り込みを使用して、オブジェクトセットのサイズを小さくすることを検討してください。
ページネーションとメモリー制限
OSS は、ページ分割された読み取りリクエストにメモリー制限を適用します。そのため、まだオブジェクトが残っていても、ページに含まれるオブジェクト数がリクエストしたページサイズより少なくなる場合があります。件数の少ないページを結果セットの終わりと解釈しないでください。トークンが空になるまで、返されたページトークンを使用してページのリクエストを続けてください。
loadObjects エンドポイントは非推奨です。StaticObjectSetV2 を使用するページングエンドポイントに移行してください。loadObjects はリクエストされたすべてのオブジェクトを返す必要があるため、部分的な結果を返すことはできません。リクエストされたオブジェクトを読み込むとメモリー制限を超える場合、エンドポイントは ObjectSet:ResultSizeLimitExceeded エラーを返します。
関連検索の結果セットを理解する
関連検索操作を実行してオブジェクト間のリンク関係をたどる場合、OSS は専用の結合操作を使用して関連するオブジェクトを効率的に見つけます。
たとえば、顧客オブジェクトのセットから、リンク関係を通じて関連するすべての注文オブジェクトを検索する場合は、次のようになります。
- 開始セットは顧客オブジェクトです(検索元のオブジェクト)
- 結果セットはその顧客にリンクされた注文オブジェクトです(検索先のオブジェクト)
OSS は左セミ結合を使用して関連検索操作を実装しており、開始セットのデータを重複させずに、一致するリンクを持つ結果セットのオブジェクトだけを返します。10,000,000個のオブジェクトという制限は、この結果セット、つまりリンク関係をたどった後に返される重複のないオブジェクトの総数に適用されます。
OSS の制限内で作業するためのベストプラクティス
最適なパフォーマンスを確保し、サイズ制限に達しないようにするには、次の方法を使用します。
-
早い段階で絞り込む: 結合を実行したり、オブジェクトをメモリーに読み込んだりする前に、フィルターを適用してオブジェクトセットのサイズを縮小します。OSS はインデックス化済みのデータ構造を活用して、フィルターを適用したクエリを効率化します。
-
インデックスを活用できない操作を避ける: 派生プロパティや計算された SQL 列に対する絞り込み、集計、並べ替えなどの操作では、すべての行を評価する必要があり、内部インデックスを使用できません。これらの操作は高速なプッシュダウン経路を使用せず、オブジェクトセットが小さい場合でも、メモリー内実行や Spark 実行を引き起こす可能性があります。たとえば、2026年5月に発生したすべての注文を絞り込む場合は、
(MONTH FROM order_date) = 'May' AND (YEAR FROM order_date) = '2026'の使用を避けます。代わりに、範囲フィルターorder_date > '2026-05-01' && order_date < '2026-06-01'を使用します。 -
ページネーションを使用する: Functions on Objects で大規模なオブジェクトセットを扱う場合は、すべてのオブジェクトを一度に読み込むのではなく、ページネーションパターンを使用してオブジェクトをバッチ単位で処理します。
-
オブジェクトセットのサイズを監視する: 関連検索などの負荷の高い操作を実行する前に、集計クエリを使用してオブジェクトセットのサイズを把握します。関連検索操作は計算負荷が高いため、OSS はこれらのサイズ制限を適用しています。
-
データモデルを最適化する: サイズ制限に頻繁に達する場合は、従来のデータモデリングの原則に従ってオントロジーを再構成することを検討します。関連データをオブジェクトプロパティに統合してオントロジーを非正規化すると、負荷の高い関連検索操作の必要性を減らし、クエリを効率化できます。また、より対象を絞ったオブジェクトタイプやリンク関係を作成することで、結果セットが自然に小さくなるようにすることもできます。
-
コンピューティングコストを考慮する: Spark ベースの実行は、メモリー内実行よりも多くのコンピューティングリソースを使用します。Spark へのフォールバックを引き起こすクエリは、追加のコンピューティング秒を消費します。
OSS はサイズ推定を使用して、クエリを実行するかどうかを判断します。推定サイズが制限を大幅に超えている場合(2倍超)、正確な閾値に達する前にクエリが失敗する可能性があります。これは、負荷の高い正確な件数のカウント操作を避けるためのパフォーマンス最適化です。
関連リソース
- オントロジーのアーキテクチャ:Object Set Service およびオントロジーバックエンドのその他のコンポーネントについて、詳しくはこちら。
- オントロジークエリのコンピューティング使用量:さまざまなクエリパターンがコンピューティング使用量にどのように影響するかを理解します。
- Functions on Objects:オブジェクトセットを扱う効率的な関数の記述方法を学びます。
- オブジェクトセット API リファレンス (TSv1):オブジェクトセットを扱うための詳細な API ドキュメントです。