注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
Pipeline Builder で Python 関数を使用する
Pipeline Builder は、Java と Python の両方のユーザー定義関数 (UDF) をサポートしています。このページでは Python UDF について説明します。代わりに Java を使用する場合は、Java UDF について詳しくはこちらをご覧ください。
前提条件
このガイドは、Python 関数をすでに作成して公開していることを前提としています。チュートリアルについては、Python 関数の入門ドキュメントを参照してください。
アーキテクチャ
Python 関数は、Pipeline Builder パイプライン内でサイドカーコンテナとして実行されます。そのため、関数をデプロイする必要はなく、パイプラインの規模に応じて動的にスケーリングします。埋め込み関数は、Pipeline Builder のほかのデータ加工と同様にプレビューできます。
Python 関数によるデータ処理の仕組み
Pipeline Builder で Python 関数をユーザー定義関数 (UDF) として使用すると、関数は行ごとに1回実行されます。Pipeline Builder は、テーブル全体、pandas DataFrame、または Spark DataFrame を関数に渡しません。代わりに、1列以上の入力列を関数のパラメーターにマッピングすると、Pipeline Builder がすべての行に対して関数を呼び出し、その行のセルの値をパラメーターの引数として渡します。
関数が返す値は出力テーブルの新しい列に格納され、行ごとに1個の値が生成されます。このため、Python UDF は DataFrame ではなく、str、int、float、bool、datetime などのスカラー(単一値)のデータ型を返します。戻り値として使用できる DataFrame 型はありません。Pipeline Builder が各行の戻り値から組み立てる列が、結果の表形式の出力そのものです。
次の例では、2列を入力として受け取り、行ごとに1個の str 値を返します。Pipeline Builder はその値を新しい列に書き込みます。
Copied!1 2 3 4 5from functions.api import function @function def full_name(first_name: str, last_name: str) -> str: return f"{first_name} {last_name}"
データ加工を設定する際に、first_name と last_name のパラメーターを対応する入力列にマッピングします。データ加工が実行されると、Pipeline Builder は行ごとに full_name を評価し、返された文字列を新しい出力列に書き込みます。
サポートされている入力と出力のデータ型、および対応する Python のデータ型の全一覧については、データ型リファレンスを参照してください。このリファレンスに記載されているオントロジーのデータ型は、Pipeline Builder では利用できません。これらのデータ型を受け取る、または返す関数はインポートできず、利用可能な関数の一覧にも表示されません。
構造体を返す
単一の関数から関連する複数の値を返すには、スカラーの代わりにカスタム型(構造体)を返します。Pipeline Builder は、返された値を、カスタム型の属性ごとに1個のフィールドを持つ単一の構造体列として追加します。その後、構造体フィールドを取得データ加工を使用して、個々のフィールドを抽出できます。
Copied!1 2 3 4 5 6 7 8 9 10 11 12from dataclasses import dataclass from functions.api import function, Double @dataclass class Stats: total: Double average: Double @function def compute_stats(a: Double, b: Double) -> Stats: total = a + b return Stats(total=total, average=total / 2)
Pipeline Builder パイプラインで関数を使用する
Pipeline Builder は、大規模言語モデル (LLM) を呼び出す UDF に対応していません。パイプラインで LLM を使用するには、代わりに LLM を使用ノードを設定します。
次のステップに沿って、パイプラインで Python 関数を準備して設定します。
- Python 関数を使用する Pipeline Builder パイプラインを開きます。
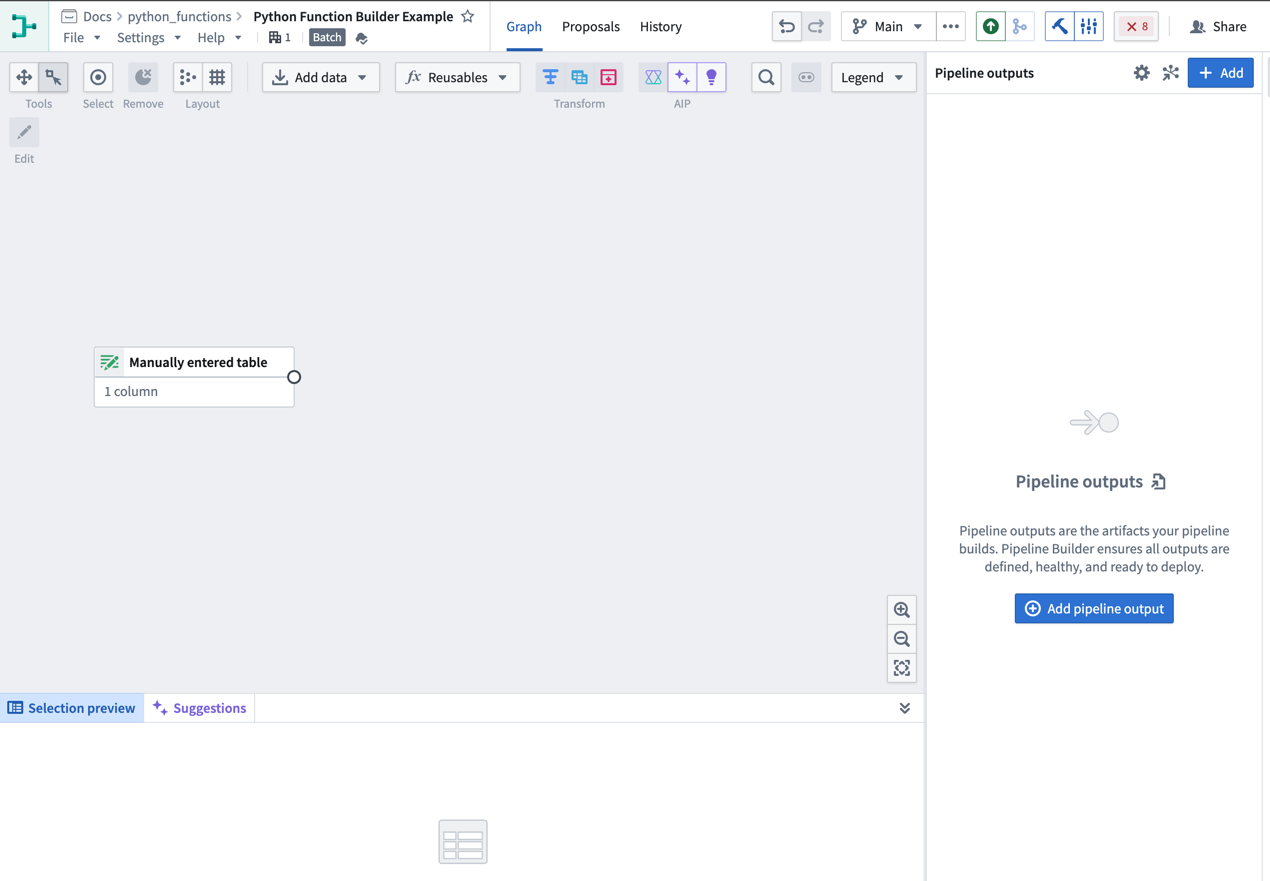
- 次の2つの方法のいずれかで、UDF を Pipeline Builder にインポートします。
- グラフ表示から:
- パイプライングラフの上部で変数・関数を選択し、次にユーザー定義関数を選択します。
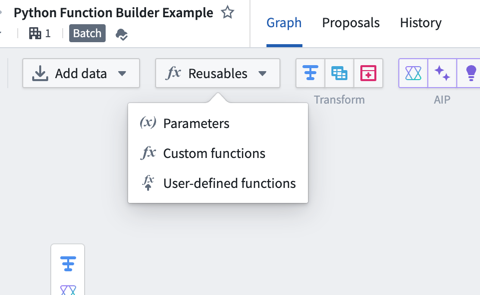
2. UDF をインポートを選択し、利用可能な関数から使用する関数を検索します 3. 関数名の横にある追加を選択します。関数にインポートされましたタグが表示されます。
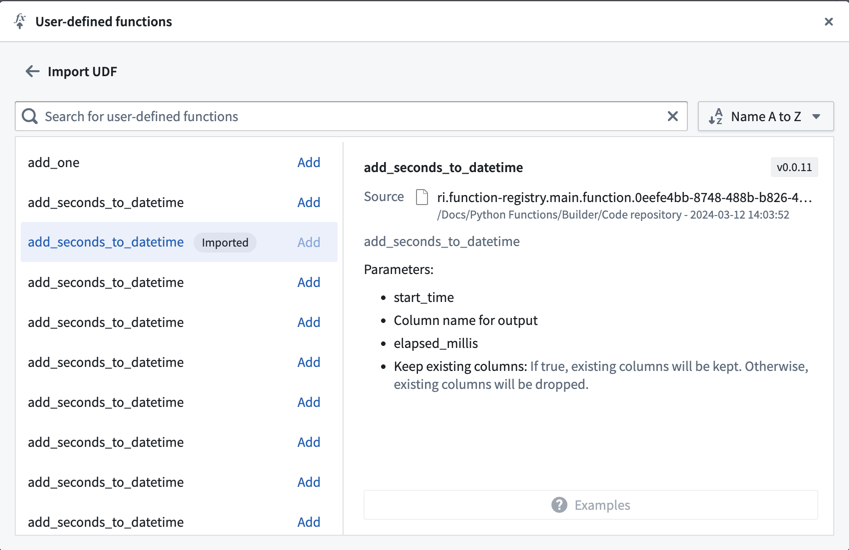
4. インポートダイアログを閉じ、Pipeline Builder グラフで関数を使用する場所のデータ加工を選択します。 5. データ加工の一覧の左側にある UDF(ユーザー定義関数) タブを選択して、インポートした関数を表示します。
- パイプライングラフの上部で変数・関数を選択し、次にユーザー定義関数を選択します。
- データ加工ピッカーを使用する:
- Pipeline Builder グラフでデータ加工を選択します。
- インポートする UDF の名前を入力します。
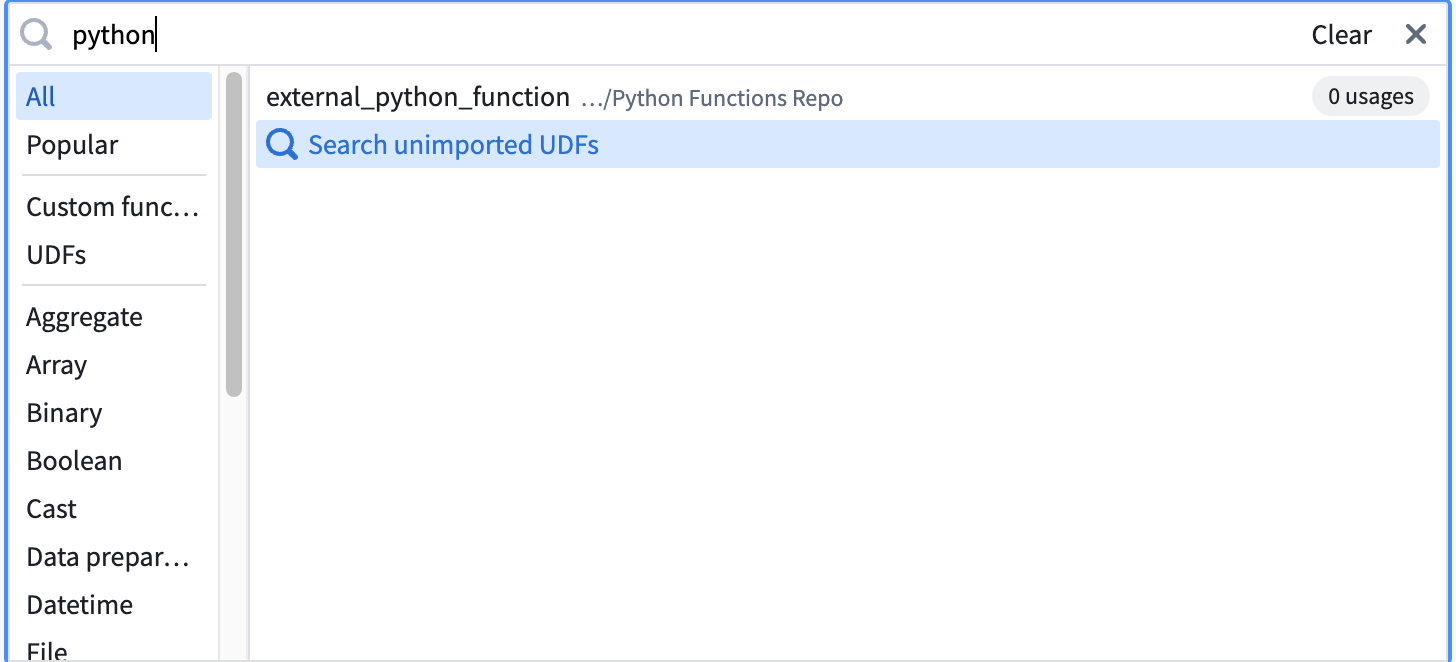
3. インポートされていない UDF を検索を選択します。 4. 目的の UDF にカーソルを合わせ、インポートを選択します。
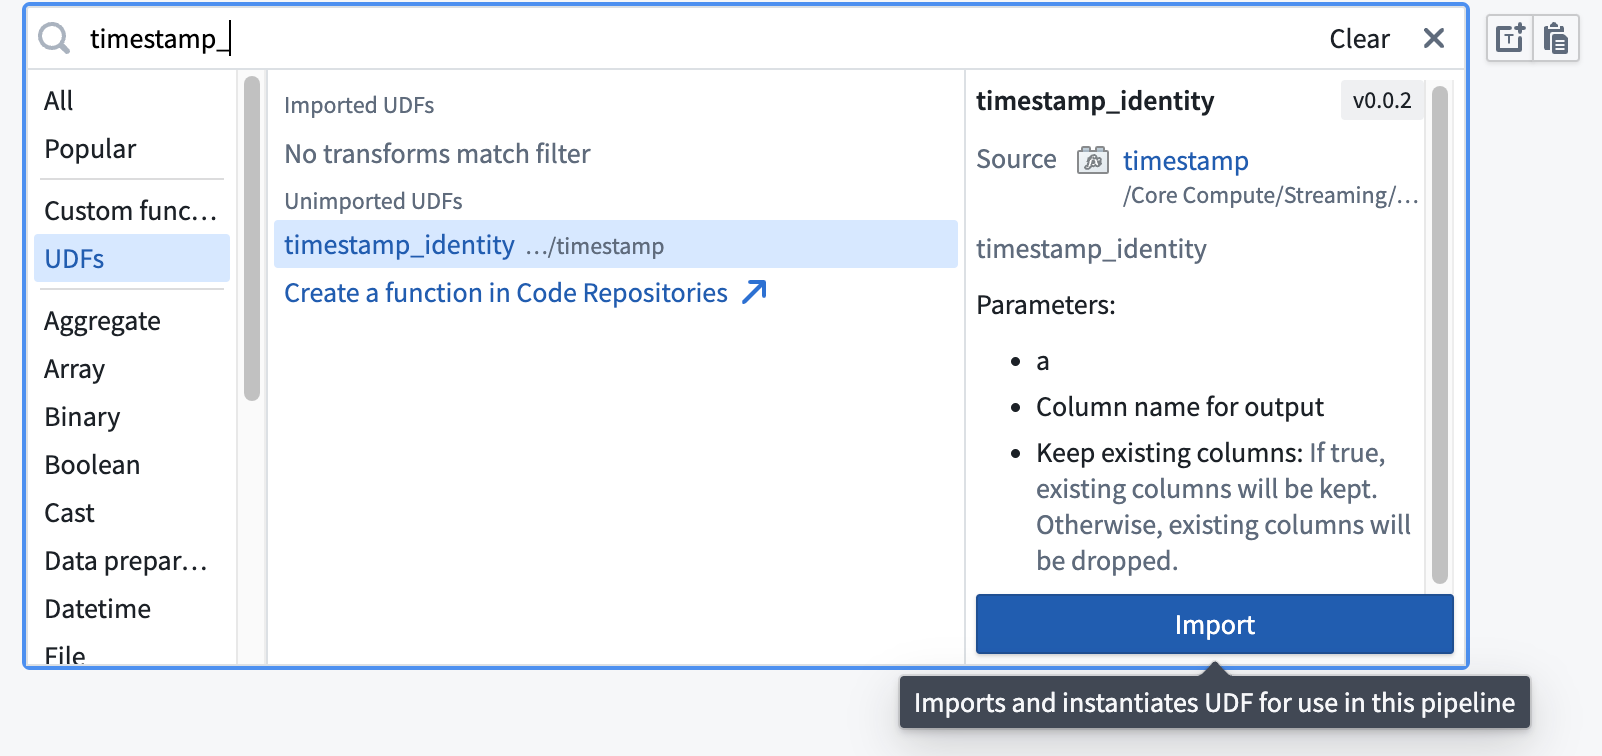
- グラフ表示から:
- 入力列とパラメーターを指定してデータ加工の定義を入力し、適用を選択します。
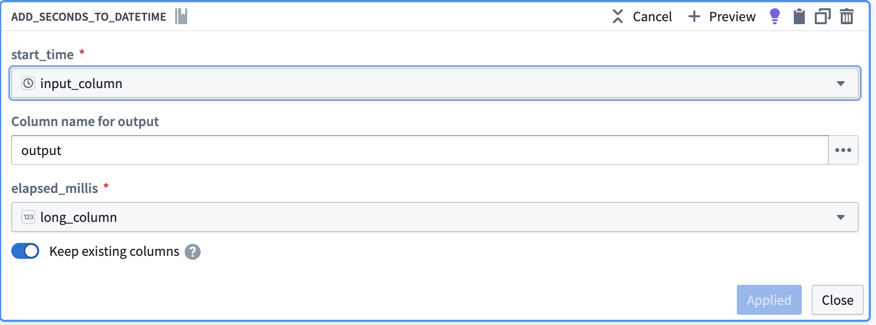
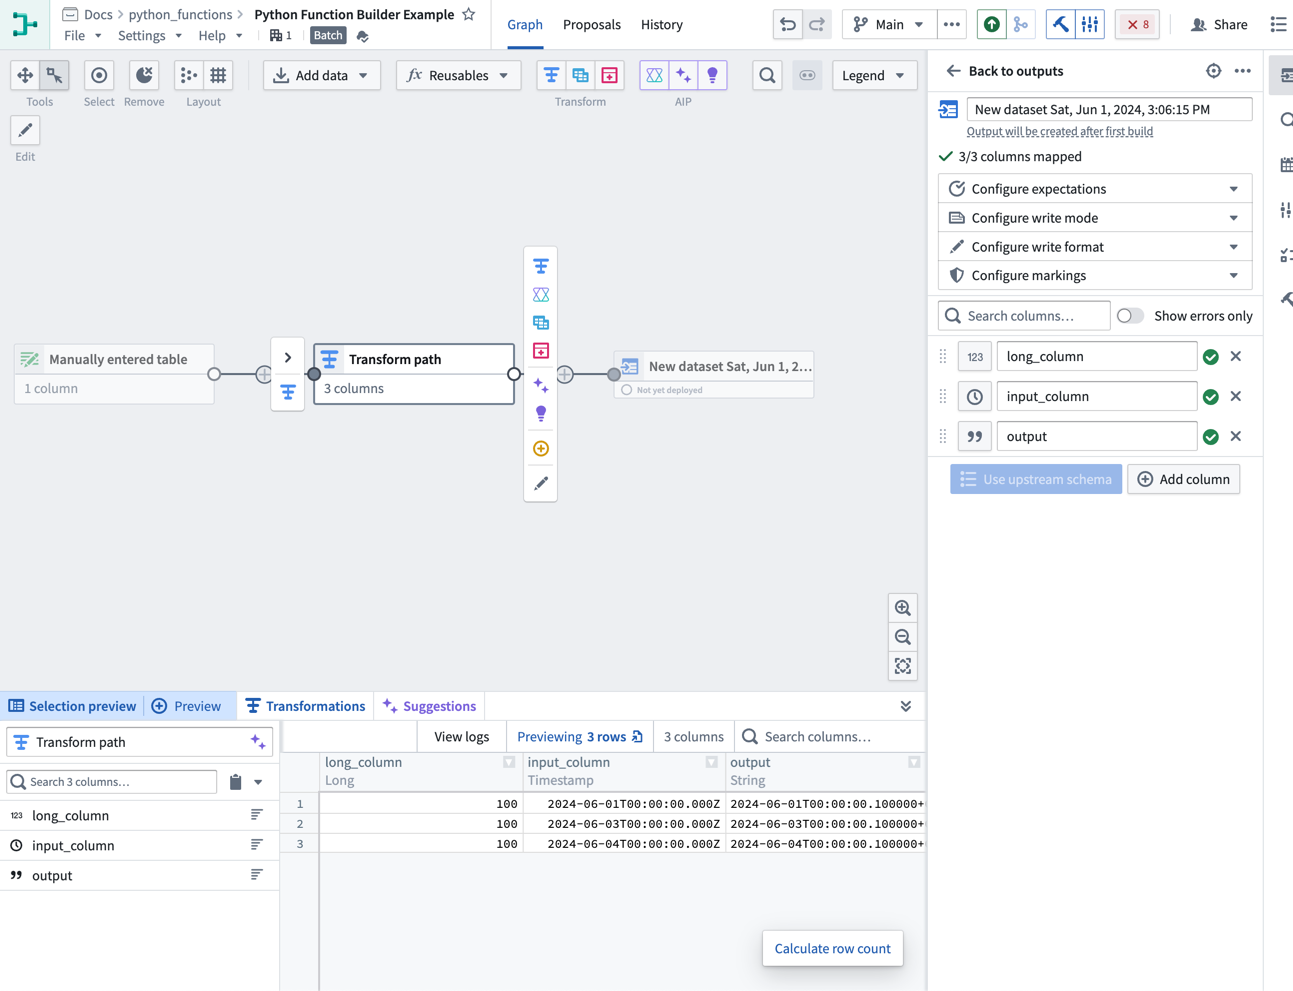
これで Pipeline Builder グラフに Python 関数が表示され、関数の出力をプレビューできます。
Pipeline Builder での外部 API 呼び出し
Pipeline Builder から外部システムに API 呼び出しを行うには、外部システムにアクセスできる Python 関数を公開できます。これにより、外部システムと通信するロジックを記述し、パイプラインの一部として使用できます。
Pipeline Builder でユーザー定義関数 (UDF) として使用するには、関数で使用するすべてのソースを、パイプラインにインポートできるように設定する必要があります。この設定を行うには、Data Connection でソースに移動し、接続設定 > コードインポート設定タブを開きます。
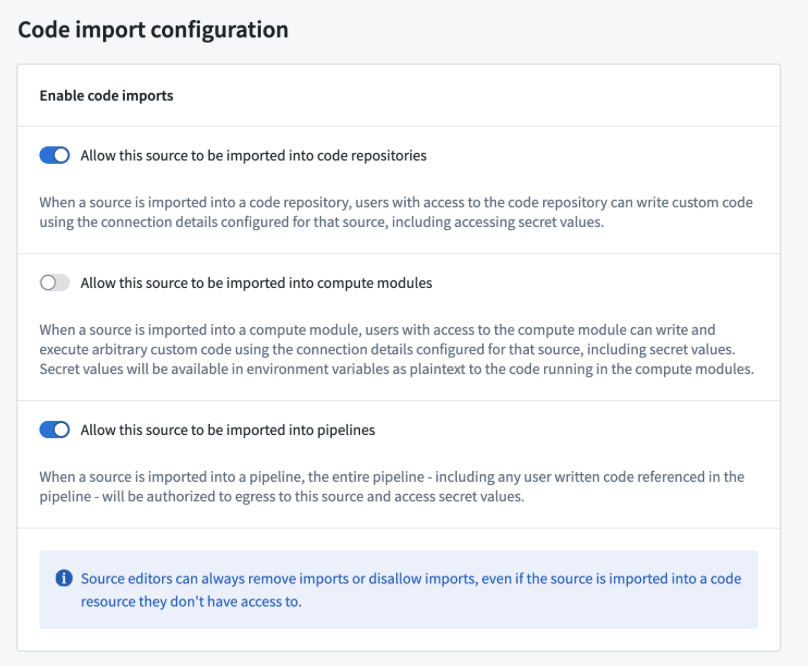
ソースでこのオプションを有効にし、Python 関数を公開すると、ほかの Python 関数と同じ方法でパイプラインで使用できます。
Pipeline Builder でのオントロジーへのアクセス
Pipeline Builder UDF は、FoundryClient() またはオントロジー SDK (OSDK) を介したオントロジーへの直接アクセスに対応していません。UDF で FoundryClient() をインスタンス化してオントロジーにアクセスすると、EnvironmentNotConfigured エラーが返されます。この制限は、データのマーキングが解除されたり、ビルド間でデータが漏洩したりすることを防ぐためのものです。
Pipeline Builder UDF からオントロジーデータにアクセスするには、次の方法を検討してください。
- 外部ソースを使用する: オントロジークエリを実行する Python 関数用の外部ソースを作成し、そのソースを Pipeline Builder UDF にインポートします。これにより、UDF のコンテキストでオントロジーに直接クエリを実行することによる認証や権限の問題を回避できます。ソースを設定するには、Data Connection でそのソースに移動し、上記の説明に従って接続設定 > コードインポート設定を有効にします。
- オントロジーの元となるデータセットを結合する: ユースケースで許容される場合は、関連するオントロジーの元データを別のデータセットとして維持し、パイプラインに結合します。これにより、オントロジー API の呼び出しを回避し、重複排除や存在チェックを実行できます。