注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
Jupyter® ノートブック内で Palantir 提供の言語モデルを使用する
Palantir は、Jupyter® ノートブック内で使用できる言語モデルと埋め込みモデルを提供しています。これらのモデルは、palantir_models ライブラリーを通じて使用できます。このライブラリーは、モデルを操作するためのバインディングを備えたクラスを提供します。
前提条件
Palantir 提供の言語モデルを使用するには、まずエンロールメントで AIP を有効にする必要があります。
Code Workspaces での Palantir 提供モデルのセットアップ
ノートブックに言語モデルのサポートを追加するには、Code Workspace の左側にあるパッケージ検索パネルを開きます。palantir_models を検索し、最新を選択します。これにより、インストールコマンドがクリップボードにコピーされます。このコマンドを空のセルに貼り付けて実行できます。
Palantir 提供のモデルをノートブックに追加する
ノートブックに言語モデルを追加するには、Code Workspace の左側にあるモデルパネルを開きます。まだモデルをインポートしていない場合は、Palantir 提供のモデルをインポートをクリックします。すでにモデルをインポートしている場合は、パネル上部の + アイコンを選択して、追加のモデルをインポートできます。
パネルには、利用可能なモデルの検索可能な一覧が表示されます。モデルは、チャット補完モデルと埋め込みモデルの2つのカテゴリーに分かれています。目的のモデルを選択して、Code Workspace にインポートします。
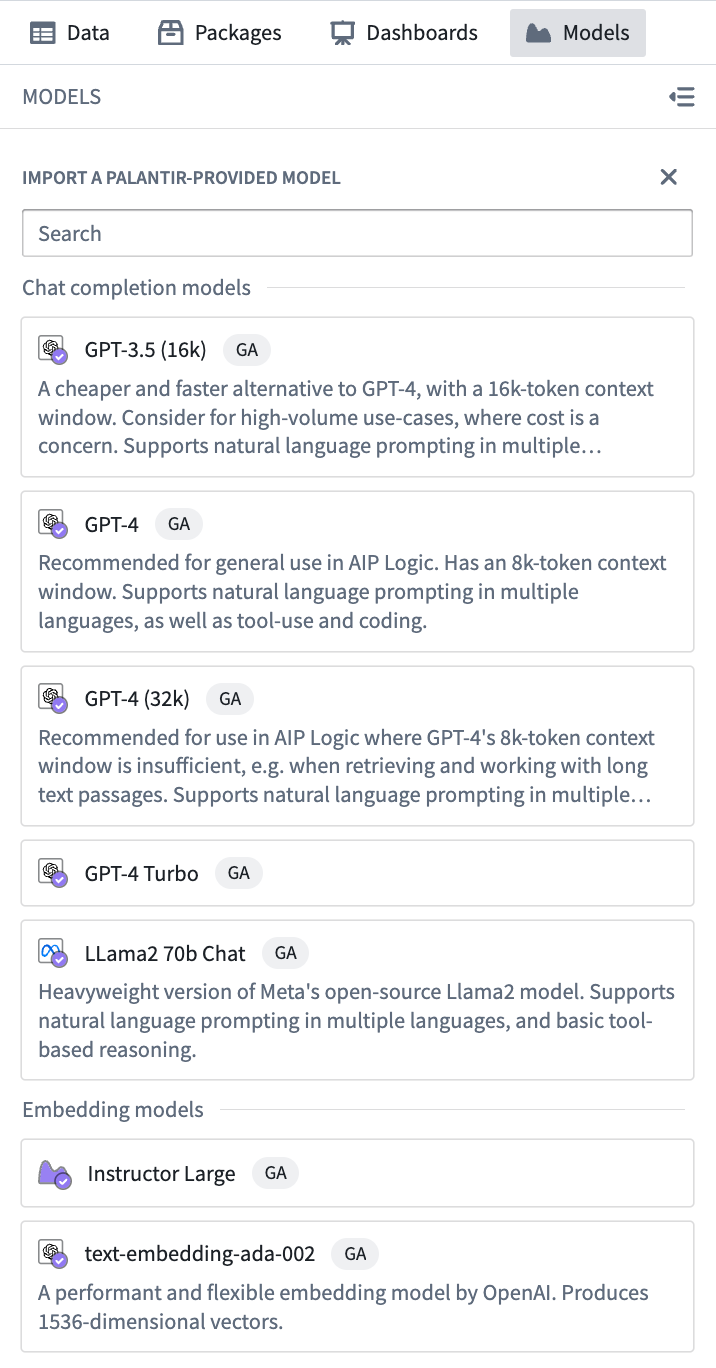
利用可能なモデルは顧客によって異なる場合があります。詳しくは、Palantir の担当者にお問い合わせください。
インポート後、モデルはモデルパネルに表示されます。モデルパネルでモデルを選択すると、そのモデルの基本的な機能を示すコードスニペットが表示されます。
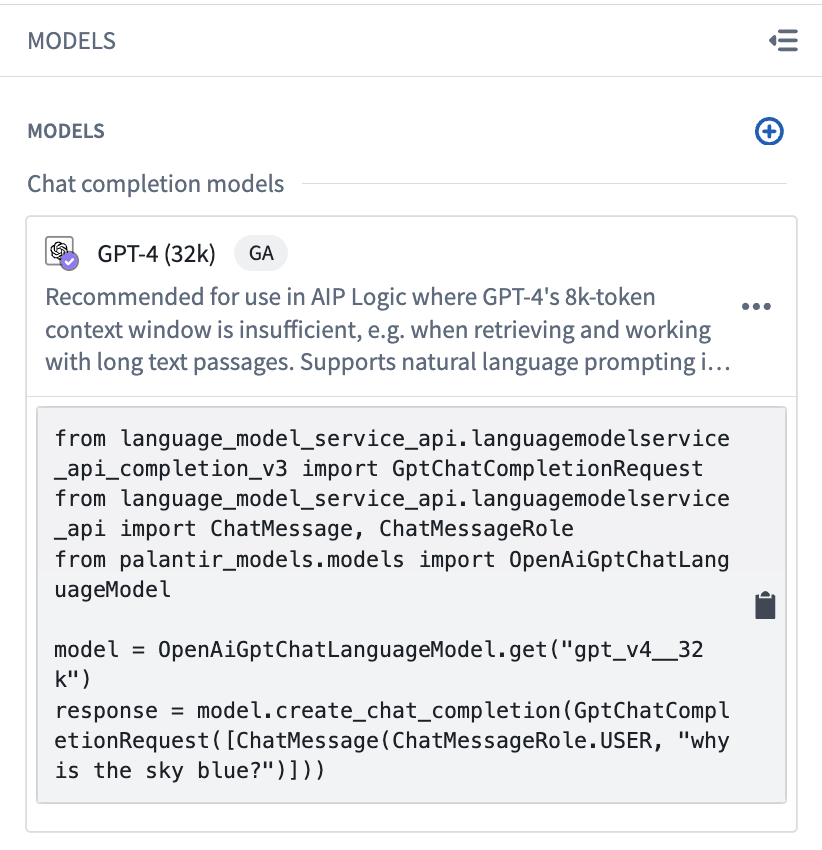
モデルの使用をはじめるには、スニペットをクリックしてコードをコピーし、ノートブックの任意のセルに貼り付けます。
言語モデルを使用して補完を生成する
この例では、OpenAI のモデルを使用して質問に回答します。すでにモデルをインポートしている場合は、以下のコードスニペットを任意のセルにコピーして進めることができます。
Copied!1 2 3 4 5 6from language_model_service_api.languagemodelservice_api_completion_v3 import GptChatCompletionRequest from language_model_service_api.languagemodelservice_api import ChatMessage, ChatMessageRole from palantir_models.models import OpenAiGptChatLanguageModel model = OpenAiGptChatLanguageModel.get("gpt_v4") response = model.create_chat_completion(GptChatCompletionRequest([ChatMessage(ChatMessageRole.USER, "why is the sky blue?")]))
埋め込み
Palantir は、生成言語モデルに加えて、埋め込みモデルも提供しています。次の例では、埋め込みモデルを使用して単語のリストに対する埋め込みを計算し、埋め込みをプロットして可視化する方法を示します。以下の各コードブロックは、それぞれ別のセルとして扱ってください。
まず、この例に必要な依存関係を追加します。
Copied!1!mamba install -y "palantir_models>=0.1795.0" matplotlib numpy scikit-learn
次に、モデルパネルで埋め込みモデルをインポートしていることを確認してください。この例では、OpenAI の text-embedding-ada-002 モデルを使用します。
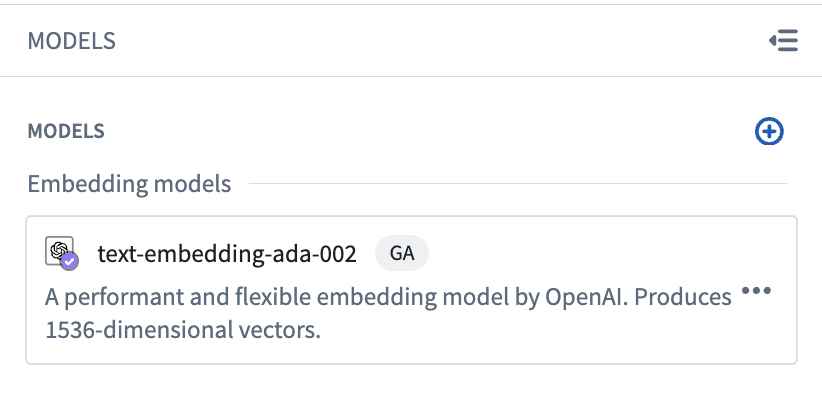
目的の埋め込みを生成するには、モデルのスニペットをコピーし、以下のように変更します。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14from language_model_service_api.languagemodelservice_api_embeddings_v3 import GenericEmbeddingsRequest from palantir_models.models import GenericEmbeddingModel fruits = [ "apple", "banana", "orange", "melon", "kiwi", "pear", "grape", "strawberry", "lemon", "lime", "blueberry", "berry", "mango", "watermelon" ] animals = [ "dog", "cat", "cow", "eagle", "mouse", "horse", "squirrel", "lion", "deer", "goose", "chicken", "pig" ] words = fruits + animals model = GenericEmbeddingModel.get("text-embedding-ada-002") embeddings = model.create_embeddings(GenericEmbeddingsRequest(inputs=words)).embeddings
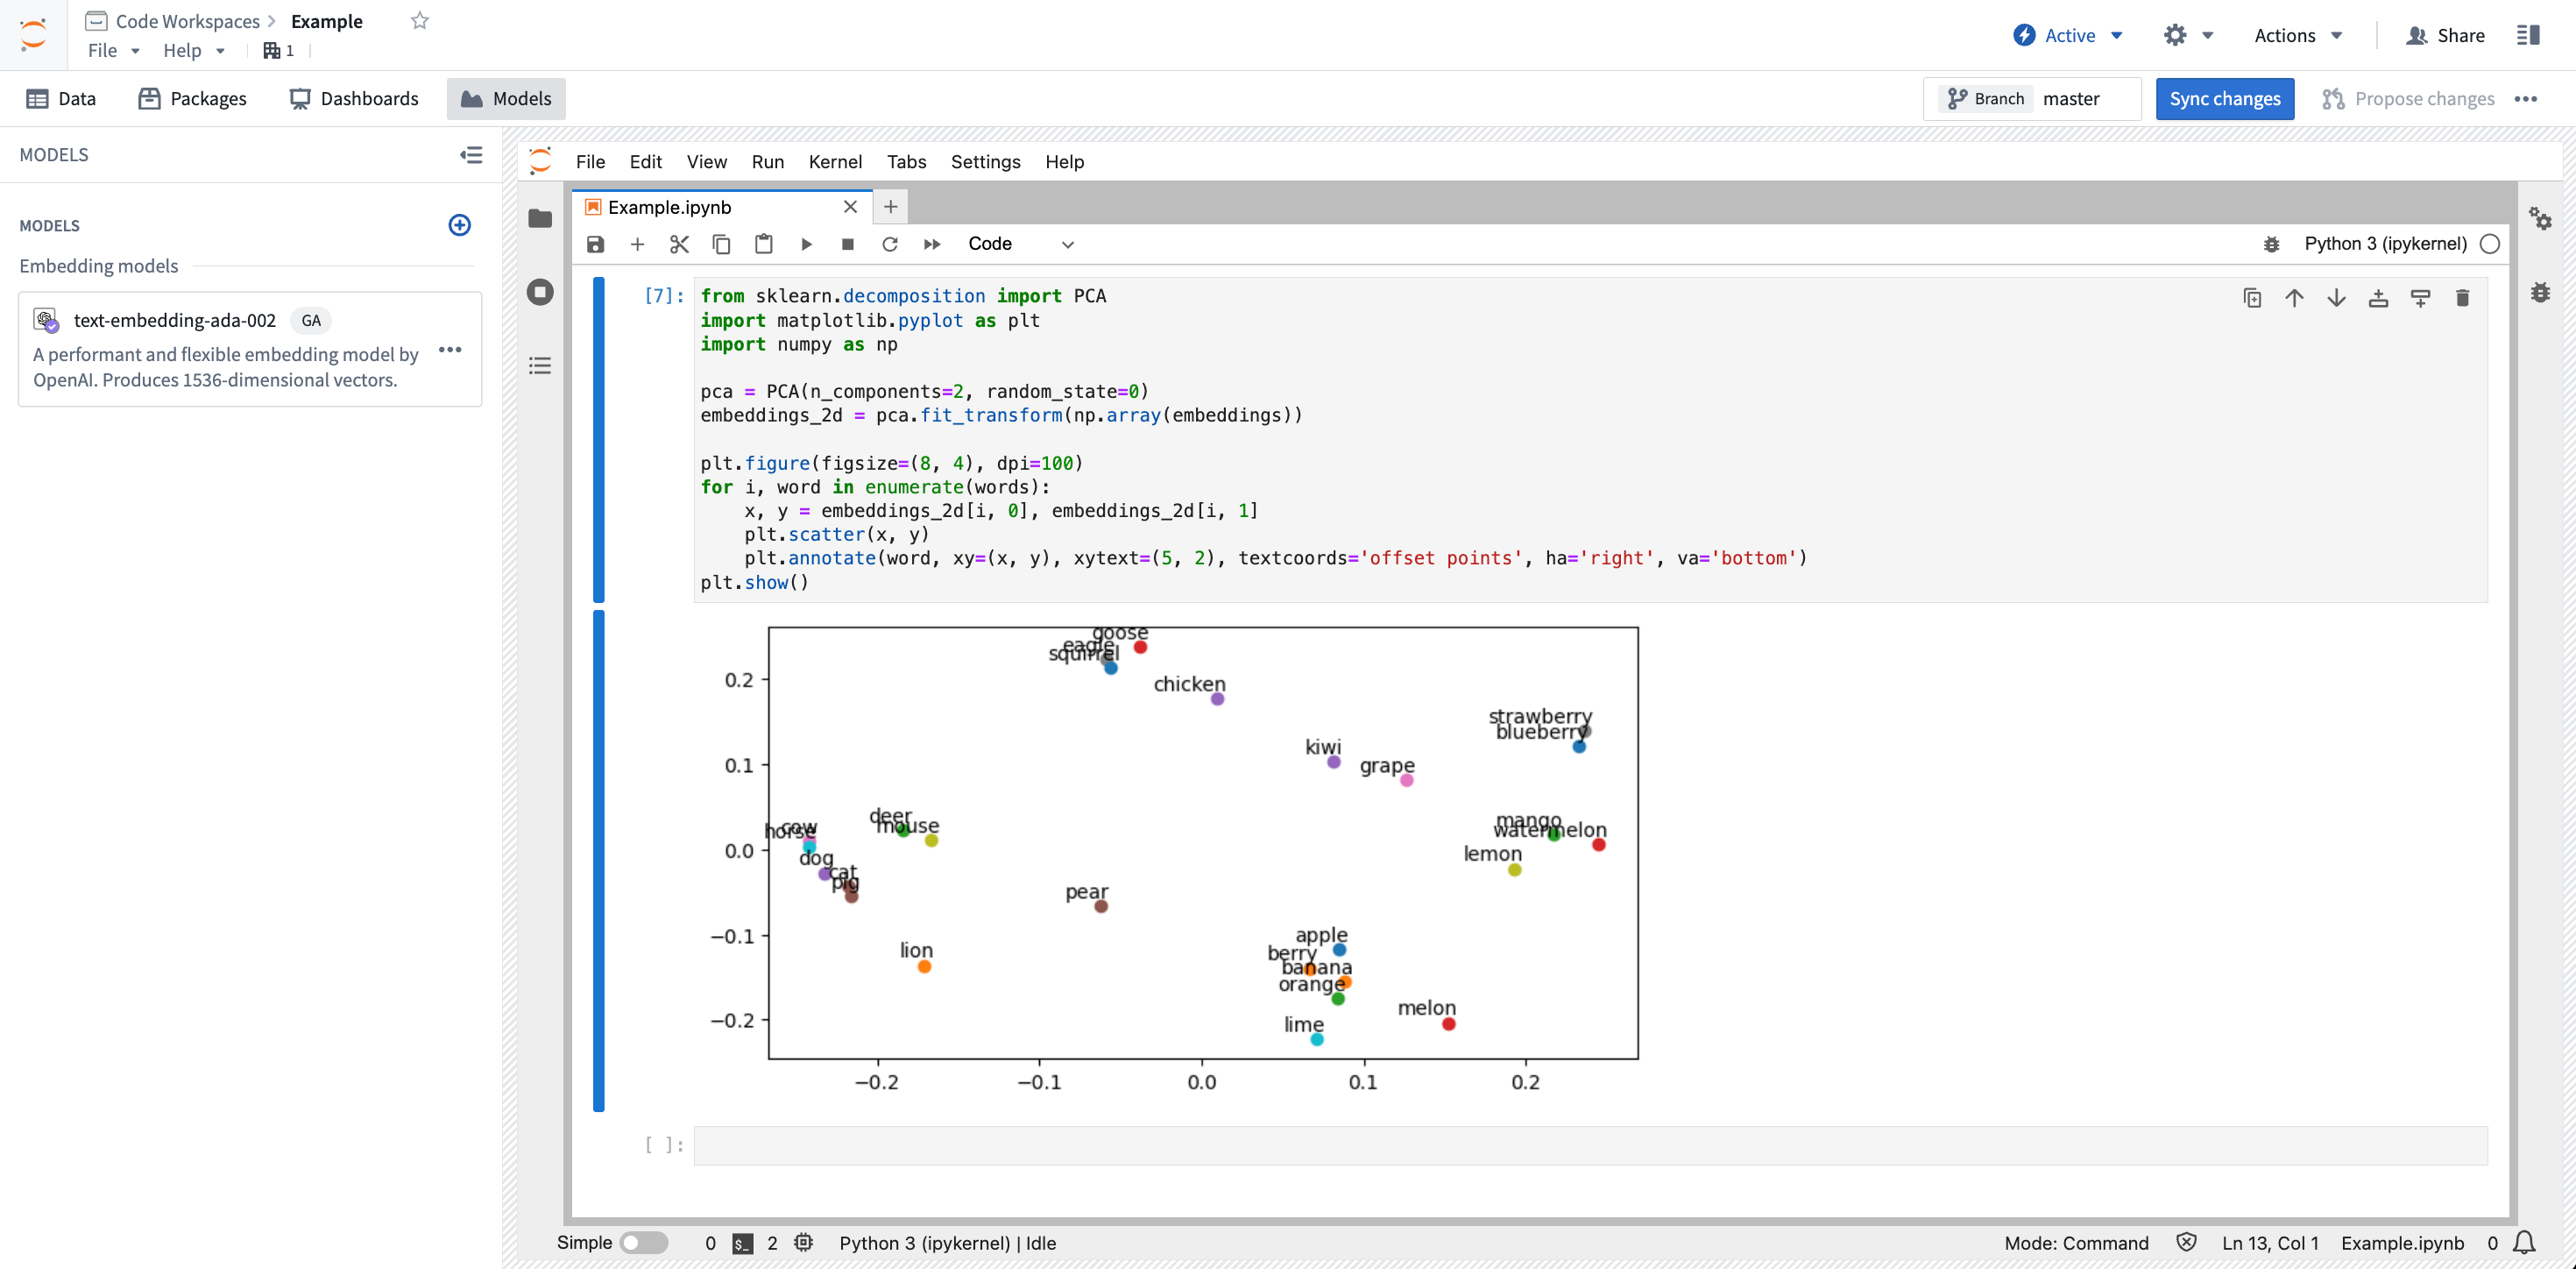
最後に、scikit-learn と Matplotlib を使用して埋め込みを可視化できます。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13from sklearn.decomposition import PCA import matplotlib.pyplot as plt import numpy as np pca = PCA(n_components=2, random_state=0) embeddings_2d = pca.fit_transform(np.array(embeddings)) plt.figure(figsize=(8, 4), dpi=100) for i, word in enumerate(words): x, y = embeddings_2d[i, 0], embeddings_2d[i, 1] plt.scatter(x, y) plt.annotate(word, xy=(x, y), xytext=(5, 2), textcoords='offset points', ha='right', va='bottom') plt.show()
ノートブックを実行すると、埋め込みのグラフが表示されます。
Jupyter®、JupyterLab®、および Jupyter® のロゴは、NumFOCUS の商標または登録商標です。
記載されているすべての第三者の商標(ロゴおよびアイコンを含む)は、それぞれの所有者に帰属します。提携または推奨を示唆するものではありません。