注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
実行モード
関数実行モードとパイプライン実行モードの比較
| 関数モード | パイプラインモジュール |
|---|---|
| Compute Module を使って、ロジックを関数としてホストします。これらの関数は、Workshop などのアプリケーションや、オントロジー SDK を使う Developer Console など、Foundry 全体で使用できます。 | ストリーミングやリアルタイムメディアのユースケース向けに、Foundry の入力を読み取り、Foundry の出力に書き込みます。このモジュールには、指定したアクセス権を持つジョブトークンが渡されます。 |
| Compute Module の関数を使って Foundry アプリケーションを動作させます。 | Foundry のリソース権限システムを使用します。 |
| 別の関数から Compute Module の関数を実行します。 | Data Lineage アプリケーションで Foundry 全体のデータ来歴を確認できます。 |
関数モードの権限
プラットフォーム権限なし: オントロジー SDK やプラットフォーム API を使用するためのアクセス権は付与されません。 アプリケーションの権限: アプリケーションは、ユーザーの権限に依存せず、サービスユーザーの権限を使用します。
パイプラインモードの権限
Foundry のジョブトークンが Compute Module にアタッチされます。ジョブトークンのスコープは入力および出力リソースに限定され、データの取得に使用できます。
関数実行モード
関数モードでは、Compute Module を使ってロジックをホストし、Workshop アプリケーションやオントロジー SDK 経由など、Foundry 全体で使用できます。任意の言語でロジックを定義して記述し、関数として登録して、プラットフォーム内の関数呼び出しでこのロジックを実行できます。
関数モードでは、次の2つの権限モードを使用できます。
- プラットフォーム権限なし: アプリケーションには、プラットフォーム API やオントロジー SDK へのアクセス権が付与されません。Foundry とやり取りする必要のないロジックを実行する場合は、このモードを使用します。このモードでも、外部システムへのエグレスを設定できます。詳細については、ソースを参照してください。
- アプリケーションの権限: アプリケーションは、対応するサービスユーザーを使用して、プラットフォーム API およびオントロジー SDK にアクセスするための権限を決定します。権限は Compute Module のユーザーにかかわらず同じままです。アプリケーション全体の権限で Foundry とやり取りする必要のあるロジックを実行する場合は、このモードを使用します。
アプリケーションの権限を使用する
一部のエンロールメントでは、アプリケーションの権限を利用できない場合があります。
サービスユーザーを作成する
- Compute Module の設定ページに移動します。
- 実行モードで、アプリケーションの権限を持つ関数モジュールを選択します。
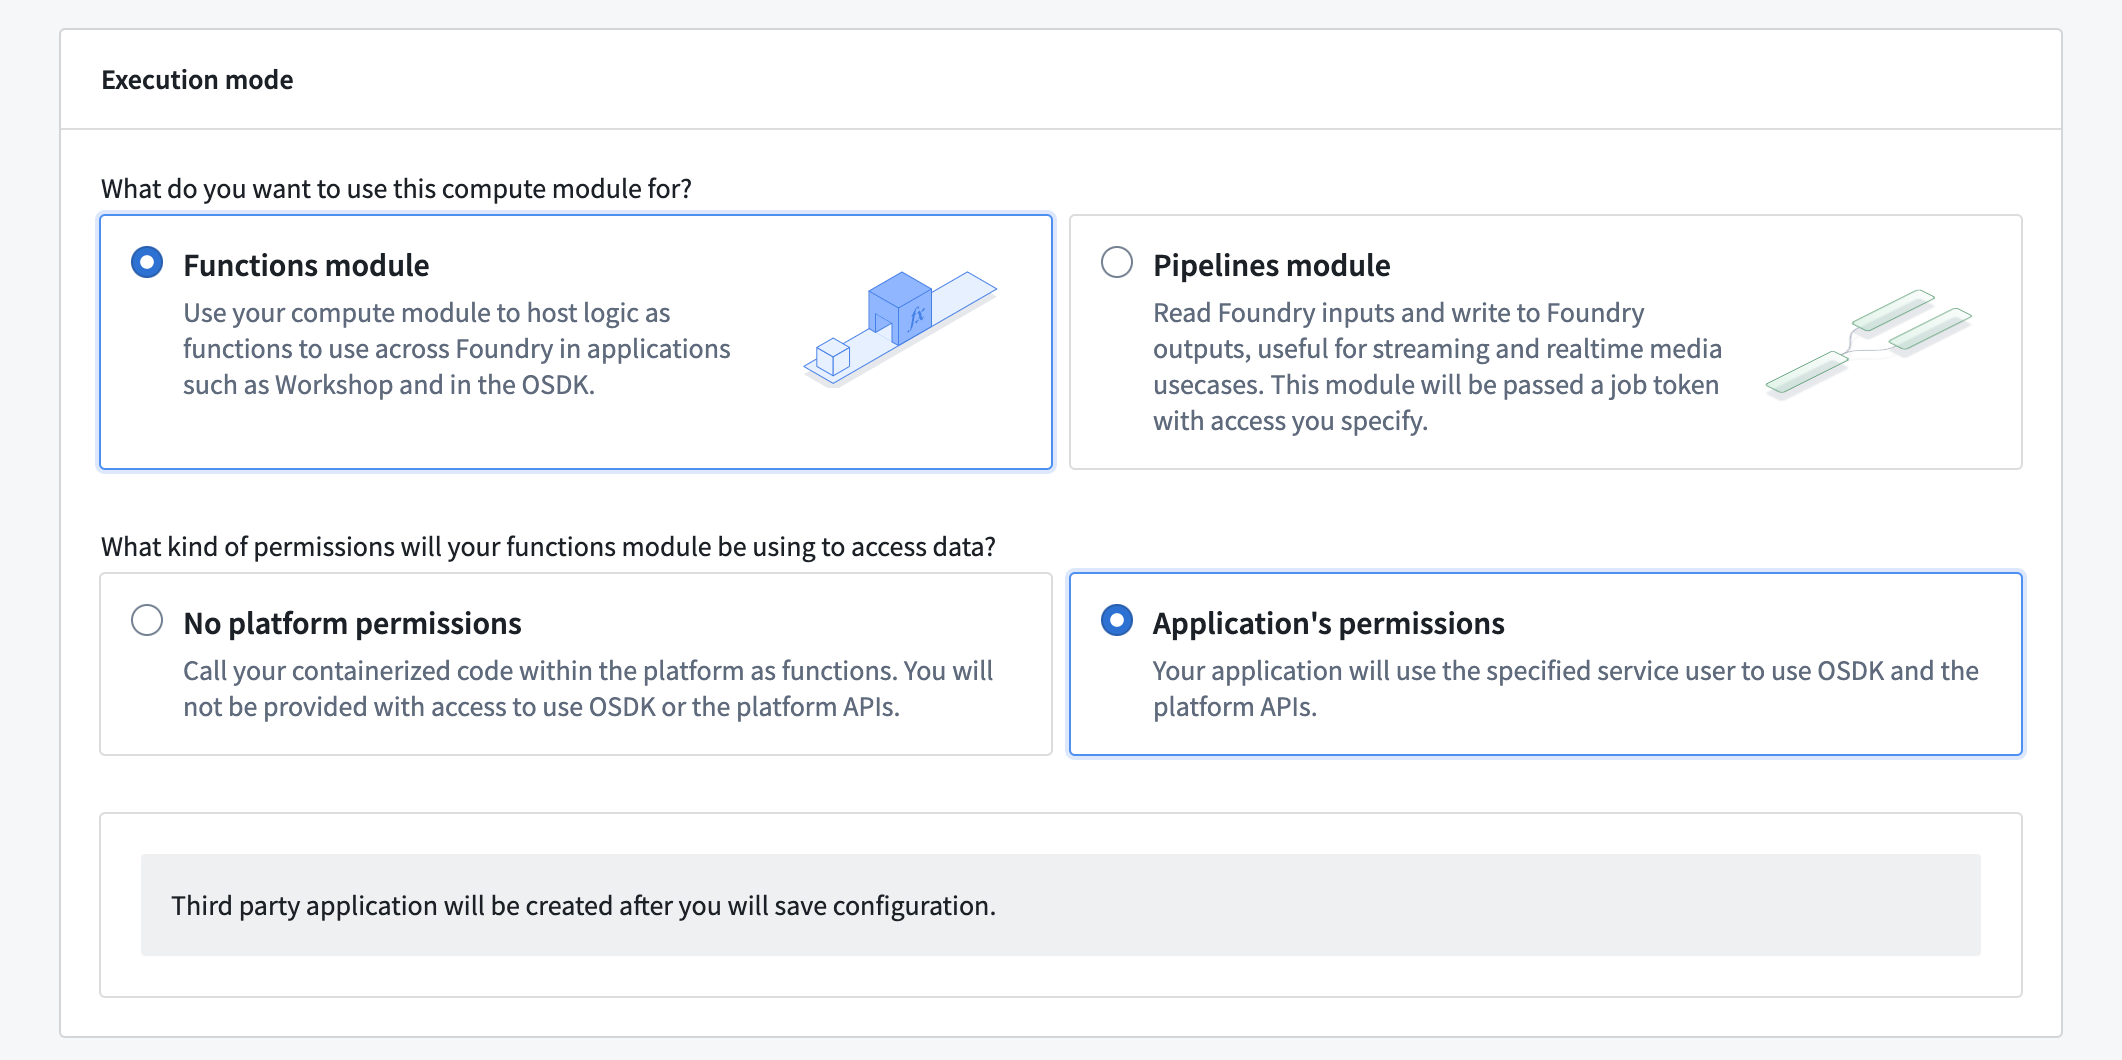
- Compute Module の設定を保存します。これにより、Compute Module 用のサードパーティアプリケーションが自動的に作成され、そのクライアントIDとサービスユーザー名が表示されます。
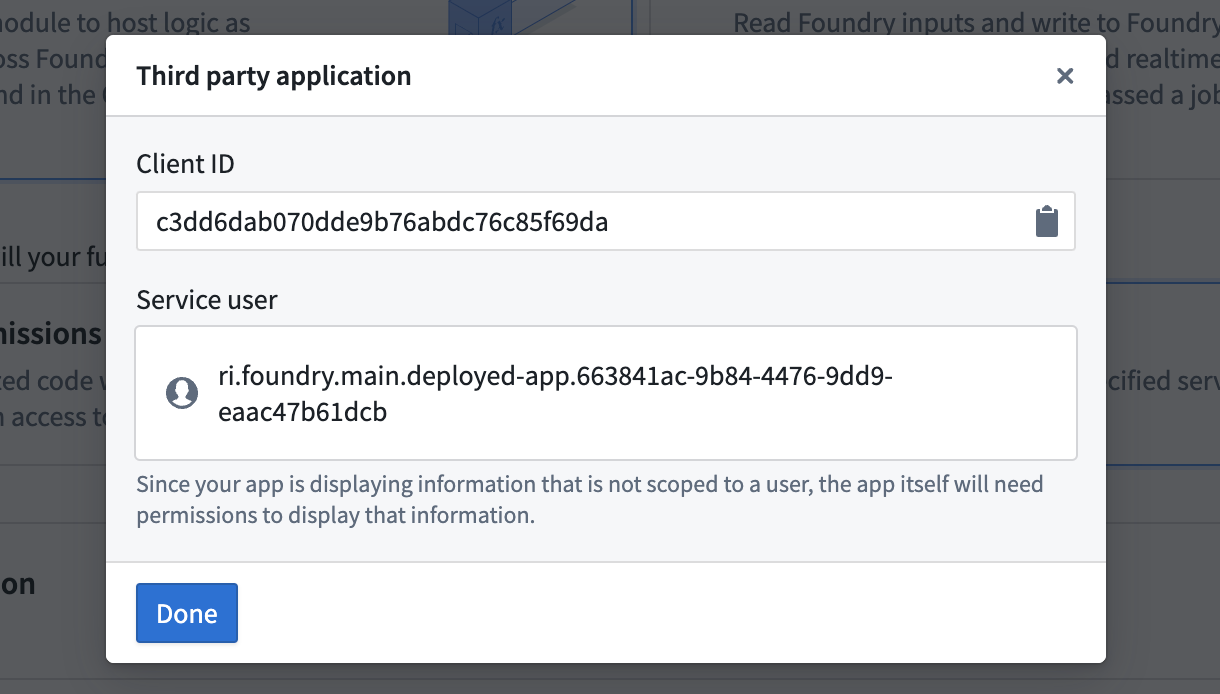 4. [任意]Control Panel のサードパーティーのアプリケーション(Third party applications) セクションで、必要に応じてサービスユーザーを設定します。たとえば、アクセスできるマーキングを特定のものに制限できます。
この手順を実行できるのは、組織内で OAuth 2.0 クライアントを管理する権限を持つユーザーのみです。詳細については、サードパーティアプリケーションのドキュメントを参照してください。
Compute Module でサービスユーザーを使用する
-
Foundry 環境の URL へのアクセスを許可するネットワークポリシーを持つソースを追加します。
-
クライアントIDとシークレットを、必要な権限を持つアクセストークンと交換します。
app.py で Compute Module の SDK を使用する場合:
Copied!1 2 3from compute_modules.auth import oauth access_token = oauth("yourenrollment.palantirfoundry.com", ["api:datasets-read", "api:datasets-write"])
Compute Module の SDK を使用しない場合:
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17import requests import os token_response = requests.post("https://yourenrollment.palantirfoundry.com/multipass/api/oauth2/token", data={ "grant_type": "client_credentials", "client_id": os.environ["CLIENT_ID"], "client_secret": os.environ["CLIENT_SECRET"], "scope": "api:datasets-read api:datasets-write" }, headers={ "Content-Type": "application/x-www-form-urlencoded", }, verify=os.environ["DEFAULT_CA_PATH"] ) access_token = token_response.json()["access_token"]
- 付与されたトークンを使用して Foundry API を呼び出します。
app.py 内:
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15import requests import os DATASET_ID = "ri.foundry.main.dataset.7bc5a955-5de4-4c5f-9370-248c5517187b" dataset_response = requests.get( f"https://yourenrollment.palantirfoundry.com/api/v1/datasets/{DATASET_ID}", headers={ "Authorization": f"Bearer {access_token}" }, verify=os.environ["DEFAULT_CA_PATH"] ) dataset_name = dataset_response.json()["name"] print(f"Dataset name is {dataset_name}")
オントロジー SDK の統合やデータセットへのアクセスなど、認証パターンの詳細については、Python SDK、Java SDK、TypeScript SDK のガイドを参照してください。
パイプライン実行モード
パイプラインモードで実行される Compute Module は、高いデータセキュリティと来歴管理を必要とするデータパイプラインワークフローでの計算を支援するように設計されています。パイプラインモードでは、Foundry の入力を受け取り、ユーザーが指定した計算を実行した後、出力を生成します。このプロセス全体は、Foundry のビルドシステムで定められたプロトコルとワークフローに厳密に従います。
ユーザーがクエリを送信して Compute Module と直接やり取りする関数モードとは異なり、入力と出力、およびそれらの権限は Foundry のビルドシステムによって管理されます。これにより、計算プロセスに関わるすべてのデータが体系的に追跡されます。すべての入力と出力がビルドシステムを経由することを必須とすることで、モジュールは高い水準のデータ整合性とトレーサビリティを維持します。これは、Foundry のデータ来歴管理とセキュリティにとって不可欠です。
来歴管理の要件により、パイプラインモードの Compute Module は非対話型であり、ユーザーは Compute Module に直接クエリを送信できません。そのため、Compute Module は、実行状態になった後にビルドシステムから自動的に渡される入力に対してのみ計算を実行します。ビルドシステムは、Compute Module の出力からの情報の流れも管理します。パイプラインモードで実行される Compute Module のコンテナ内で、入力と出力を操作するためのインターフェースが提供されています。
つまり、パイプラインモードではデータセキュリティと来歴管理が強制されます。次の条件に当てはまる場合は、パイプラインモードを選択してください。
- 対象のデータの機密性が高く、来歴管理やマーキング管理などに厳密に従う必要がある。
- データリネージを追跡したい。
入力と出力を追加する
パイプラインモードの Compute Module は、Foundry のビルドシステムで定められた来歴管理とセキュリティモデルに厳密に従います。デフォルトでは、Compute Module には Foundry リソースを操作する権限がありません。ユーザーは Foundry リソースを入力および出力として明示的に追加する必要があります。追加したリソースに対する権限は、その後に付与されます。
- パイプラインモードの設定詳細で、入力または出力リソースの追加を選択します。
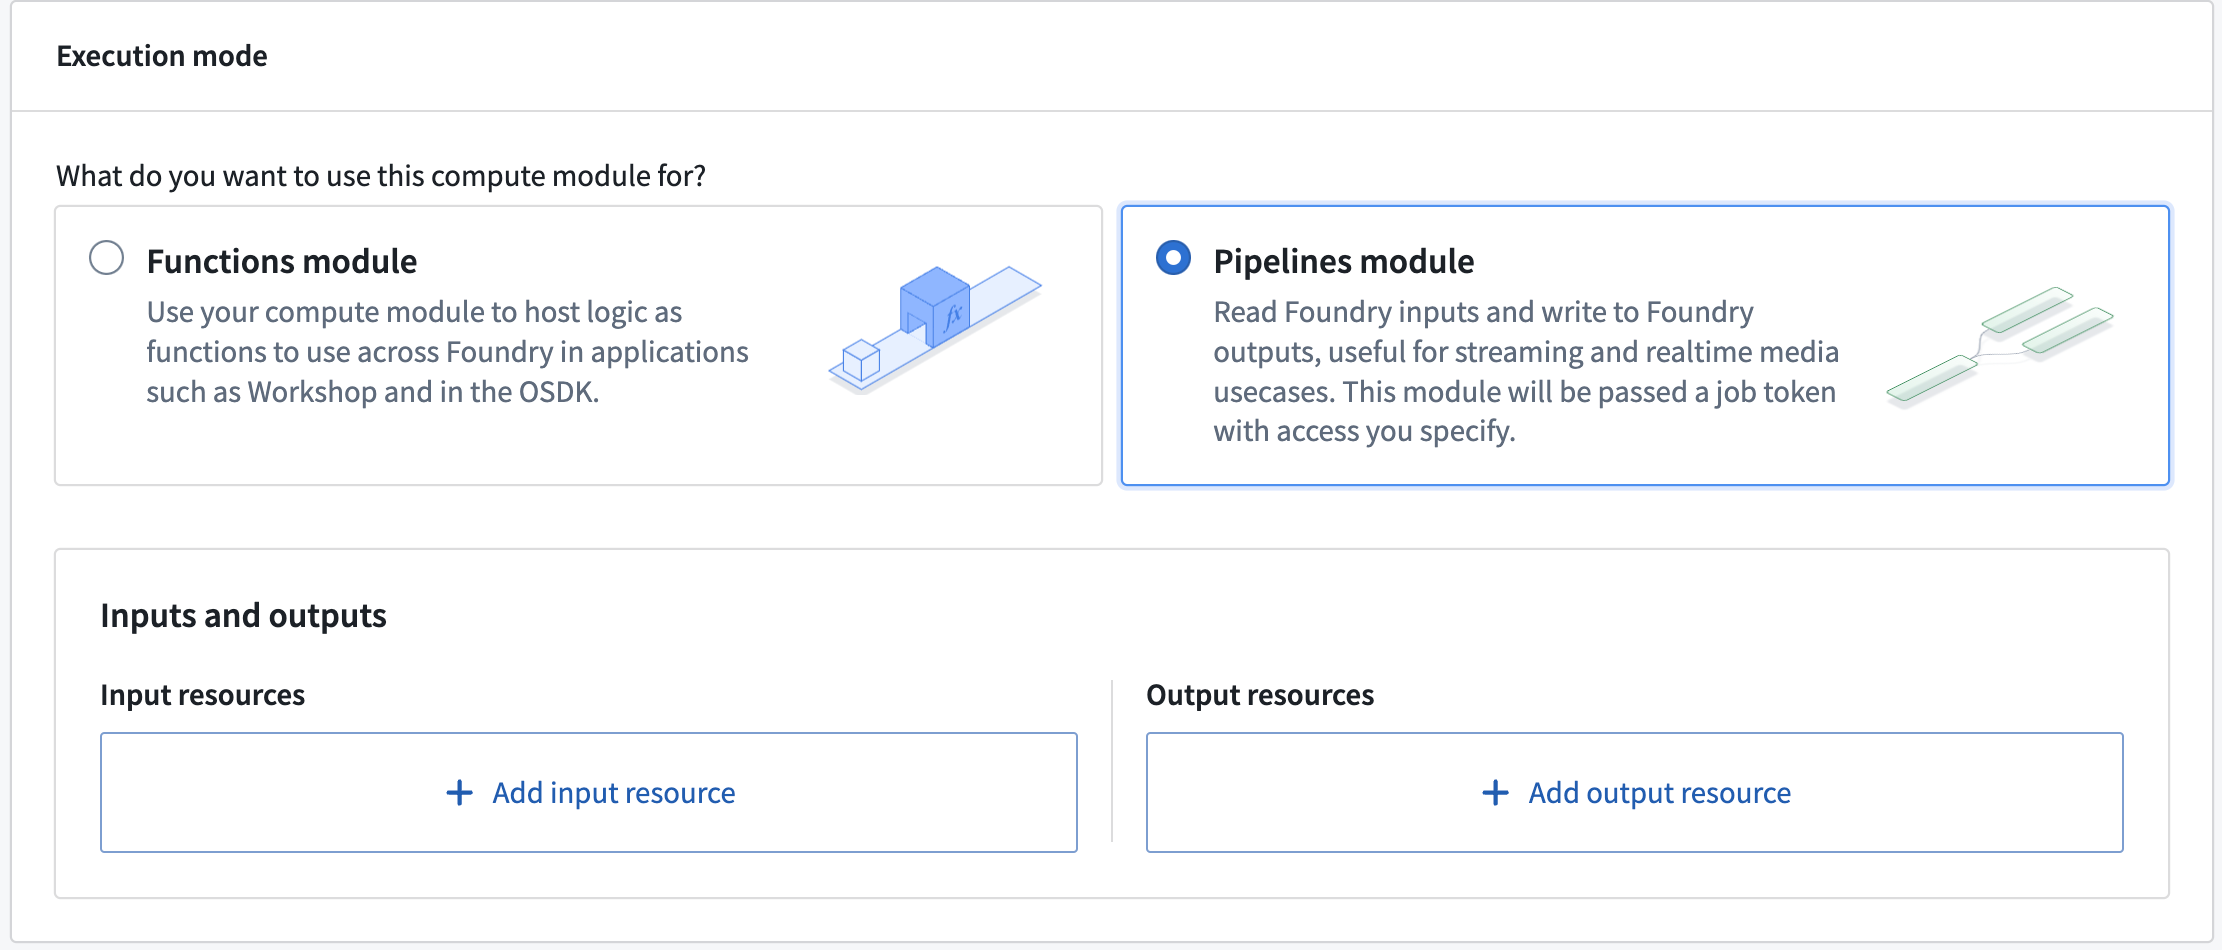
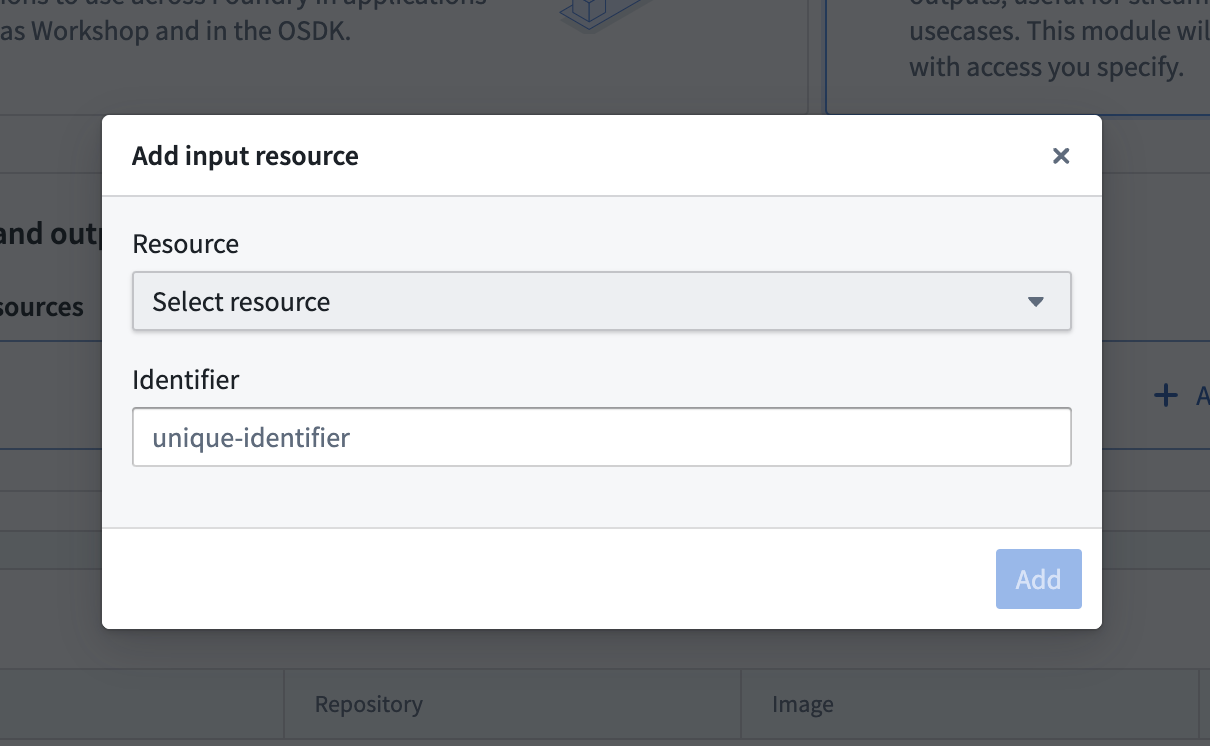
- ドロップダウンメニューからリソースを選択し、一意の識別子を付けます。この識別子は、コンテナ内でリソース情報を取得するために使用されます。リソースは Compute Module と同じプロジェクトに属している必要があります。現在サポートされている入力と出力は、Foundry データセット、ストリーミングデータセット、メディアセットです。
Compute Module 内で入力と出力を操作する
- Bearer トークンがコンテナ内のファイルにマウントされ、そのファイル名が BUILD2_TOKEN 環境変数に格納されます。このトークンには入力と出力に対する権限が付与され、入力と出力にアクセスする唯一の手段となります。
app.py 内:
with open(os.environ['BUILD2_TOKEN']) as f:
    bearer_token = f.read()
- 入力と出力の一意の識別子とその情報を対応付けたマップが、コンテナ内のファイルにマウントされ、そのファイル名が RESOURCE_ALIAS_MAP 環境変数に格納されます。設定で付けた一意の識別子を使用して、リソース情報を取得できます。リソース情報は RID とブランチのタプルです(ブランチは none の場合があります)。
app.py 内:
with open(os.environ['RESOURCE_ALIAS_MAP']) as f:
    resource_alias_map = json.load(f)

input_info = resource_alias_map['identifier you put in the config']
output_info = resource_alias_map['identifier you put in the config']

# リソース情報の構造
# {
#     'rid': rid
#     'branch': branch (can be none)
# }

input_rid = input_info['rid']
input_branch = input_info['branch'] or "master"
output_rid = output_info['rid']
output_branch = output_info['branch'] or "master"
- これで、トークンとリソース情報を使用して入力と出力を操作できます。たとえば、入力がストリームデータセットの場合、stream-proxy サービスにリクエストを送信することで最新のレコードを取得できます。
app.py 内:
FOUNDRY_URL = "yourenrollment.palantirfoundry.com"
url = f"https://{FOUNDRY_URL}/stream-proxy/api/streams/{input_rid}/branches/{input_branch}/records"
response = requests.get(url, headers={"Authorization": f"Bearer {bearer_token}"})
API を使用してデータセットファイルにアクセスする
入力が Foundry データセットの場合、Bearer トークンとリソース情報を使用してファイルを一覧表示し、取得できます。次の例では、データセット内のすべてのファイルを一覧表示し、特定のファイルの内容を取得する方法を示します。
app.py 内:
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16FOUNDRY_URL = "yourenrollment.palantirfoundry.com" # データセット内のすべてのファイルを一覧表示します params = { "pageSize": 100, "includeOpenExclusiveTransaction": "false", "excludeHiddenFiles": "false", } url = f"https://{FOUNDRY_URL}/foundry-catalog/api/catalog/datasets/{input_rid}/views2/master/files" response = requests.get(url, params=params, headers={"Authorization": f"Bearer {bearer_token}"}) # 特定のファイルの内容を取得します file_name = "example.csv" url = f"https://{FOUNDRY_URL}/foundry-data-proxy/api/dataproxy/datasets/{input_rid}/views/master/{file_name}" response = requests.get(url, headers={"Authorization": f"Bearer {bearer_token}"}) dataset_content = response.json()
Compute Module のコンテナ内から Foundry の URL にアクセスするには、Foundry 環境の URL へのアクセスを許可するネットワークポリシーを持つソースを追加する必要があります。
データ来歴と観測可能性
パイプラインモードには、Foundry のビルドシステムによるデータ来歴と観測可能性の機能が組み込まれています。すべての入力と出力がビルドシステムを経由するため、すべてのデータ変換が追跡され、Data Lineage アプリケーションに表示されます。これにより、パイプラインを通じたデータの流れを追跡し、任意の出力の出所を監査できます。
パイプラインの実行中、ビルドシステムは出力データセットでトランザクションを開始します。これらのトランザクションは自動的に管理され、パイプラインが正常に完了するとコミットされます。
その他の考慮事項
- スケーリング: Compute Module にクエリが送信されないため、オートスケーラーによって最終的にレプリカ数が0にスケールダウンされる場合があります。Compute Module を常時実行状態に保つには、スケーリング設定で最小レプリカ数を1以上に設定します。
- Compute Module クライアント: Compute Module にクエリが送信されないため、Compute Module クライアントを実装する必要はありません。詳しくは、Compute Module クライアントのドキュメントを参照してください。