注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
はじめに
Compute Modules をはじめるには、お好みの開発環境を使用できます。数分で Compute Module を作成してデプロイし、Foundry でテストできます。
Foundry でフォルダーを選び、+ 新規 > Compute Modules を選択します。次に、ダイアログのステップに従って、Compute Module を利用する空の関数またはパイプラインからはじめます。実行モードに応じた次のステップについては、以下のドキュメントに沿って進めてください。また、よりスムーズに進めるには、Compute Module 内のドキュメントタブを選択し、プラットフォーム内のガイダンスに沿って進めてください。
Compute Module を利用した関数を構築する
Compute Modules は、オープンソース SDK を通じて複数の言語をサポートしています。以下のリンク先にある各 SDK ガイドには、詳細な API ドキュメント、認証パターン、型システム、コード例が含まれています。チームとユースケースに最適な言語を選択します。
- Python:オープンソースの Python ライブラリ ↗ を使用します。Python SDK ガイドでは、
@functionデコレーター、型付き関数、ストリーミング、認証、OSDK の統合、ログ記録について説明しています。 - Java:
com.palantir.computemodules:lib依存関係を指定して、オープンソースの Java ライブラリ ↗ を使用します。Java SDK ガイドでは、ComputeModuleビルダー、型定義、認証、OSDK の統合、ログ記録について説明しています。 - Node.js:オープンソースの TypeScript ライブラリ ↗ を使用します。TypeScript/Node.js SDK ガイドでは、関数の登録、TypeBox のスキーマ定義、ストリーミング、SLS ログ記録について説明しています。
独自のクライアントを作成する場合や、SDK が対応していない別の言語で Compute Module を実装する場合は、カスタム Compute Module クライアントの実装方法に関するドキュメントをご覧ください。
前提条件:
- Docker Desktop をインストールします
- 次のいずれかをインストールします。
- Python 3.9 以降
- Java 21 以降
- Node.js 22 以降
Compute Module をローカルで記述する
- まず、Compute Module 用の新しいディレクトリを作成します。
- ディレクトリ内に
Dockerfileという名前のファイルを作成します。 - 以下をコピーして
Dockerfileに貼り付けます。
Copied!1 2 3 4 5 6 7 8 9 10# Foundry のリソースキューに応じてプラットフォームを変更します FROM --platform=linux/amd64 python:3.12 COPY requirements.txt . RUN pip install -r requirements.txt COPY src . # Foundry で Compute Modules を実行するには、USER は root 以外の数値である必要があります USER 5000 CMD ["python", "app.py"]
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15# ビルドステージ FROM --platform=linux/amd64 gradle:jdk21 AS build COPY . /home/gradle/src WORKDIR /home/gradle/src RUN gradle shadowJar --no-daemon # 実行ステージ FROM --platform=linux/amd64 eclipse-temurin:21-jre-alpine RUN mkdir /app COPY --from=build /home/gradle/src/build/libs/*.jar /app/app.jar # Foundry で Compute Modules を実行するには、USER は root 以外の数値である必要があります USER 5000 CMD ["java", "-jar", "/app/app.jar"]
Copied!1 2 3 4 5 6 7 8 9 10 11# Foundry のリソースキューに応じてプラットフォームを変更します FROM --platform=linux/amd64 node:22-alpine WORKDIR /app COPY package.json package-lock.json ./ RUN npm ci --production COPY src . # Foundry で Compute Modules を実行するには、USER は root 以外の数値である必要があります USER 5000 CMD ["node", "index.js"]
- 使用する言語の依存関係ファイルを作成します。
Copied!1 2# requirements.txt foundry-compute-modules
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19// build.gradle plugins { id 'java' id 'com.gradleup.shadow' version '9.4.1' } repositories { mavenCentral() } dependencies { implementation 'com.palantir.computemodules:lib:0.6.0' } jar { manifest { attributes 'Main-Class': 'com.example.App' } }
Copied!1 2 3 4 5 6 7{ "name": "my-compute-module", "version": "1.0.0", "dependencies": { "@palantir/compute-module": "^0.2.12" } }
- アプリケーションコード用のディレクトリ構造を作成します。
Copied!1 2 3 4 5MyComputeModule ├── Dockerfile ├── requirements.txt └── src └── app.py
Copied!1 2 3 4 5 6 7 8 9MyComputeModule ├── Dockerfile ├── build.gradle └── src └── main └── java └── com └── example └── App.java
Copied!1 2 3 4 5MyComputeModule ├── Dockerfile ├── package.json └── src └── index.js
- アプリケーションファイル内に、以下のコードをコピーして貼り付けます。
Copied!1 2 3 4 5 6 7 8 9from compute_modules.annotations import function @function def add(context, event): return str(event['x'] + event['y']) @function def hello(context, event): return 'Hello' + event['name']
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25package com.example; import com.palantir.computemodules.ComputeModule; import com.palantir.computemodules.functions.Context; public class App { public static void main(String[] args) { ComputeModule.builder() .add(App::add, AddEvent.class, Integer.class, "add") .add(App::hello, HelloEvent.class, String.class, "hello") .build() .start(); } record AddEvent(int x, int y) {} record HelloEvent(String name) {} static Integer add(Context context, AddEvent event) { return event.x() + event.y(); } static String hello(Context context, HelloEvent event) { return "Hello, " + event.name(); } }
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13const { ComputeModule } = require("@palantir/compute-module"); const computeModule = new ComputeModule(); computeModule.register("add", (context, event) => { return String(event.x + event.y); }); computeModule.register("hello", (context, event) => { return "Hello" + event.name; }); computeModule.start();
本番環境で使用する場合は、上記の型なしの Python の例ではなく、Python SDK で型付きの入力と出力を使用することを検討してください。これにより、自動スキーマ推論と関数の登録が可能になります。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19from dataclasses import dataclass from typing import TypedDict from compute_modules.annotations import function class HelloInput(TypedDict): planet: str @dataclass class AddPayload: x: int y: int @function def hello(context, event: HelloInput) -> str: return "Hello " + event["planet"] + "!" @function def add(context, event: AddPayload) -> int: return event.x + event.y
対応している型のパターンの詳細については、関数スキーマの自動推論に関するドキュメントをご覧ください。同じドキュメントで、型推論を追加し、Compute Module 関数を関数レジストリに自動登録する方法も説明しています。
関数コードを理解する
Compute Module 関数を使用する場合、関数は常にイベントオブジェクトとコンテキストオブジェクトの2個のパラメーターを受け取ります。
コンテキストオブジェクト: 関数で必要になる可能性のあるメタデータと資格情報を含むオブジェクトパラメーターです。ユーザートークン、ソースの資格情報、その他の必要なデータなどが含まれます。たとえば、関数で OSDK を呼び出してオントロジーオブジェクトを取得する必要がある場合、コンテキストオブジェクトには、ユーザーがそのオントロジーオブジェクトにアクセスするために必要なトークンが含まれます。
イベントオブジェクト: 関数が処理するデータを含むオブジェクトパラメーターです。add 関数の x と y、hello 関数の name など、関数に渡されるすべてのパラメーターが含まれます。Python では dict、Java では JSON ノードオブジェクト、Node.js ではプレーンな JavaScript オブジェクトです。イベントオブジェクトまたは戻り値のオブジェクトに静的型付けを使用する場合、ライブラリは代わりに、ペイロードまたは結果をその静的型付きオブジェクトに変換します。詳細は、関数スキーマの自動推論に関するドキュメントで説明しています。
関数の結果: この2個のパラメーターに加え、関数は JSON BLOB として転送される結果を返すため、結果を JSON にシリアライズできることを確認してください。
最初のコンテナを作成する
これで、Docker イメージの保存に使用するアーティファクトリポジトリを使って、コードを Foundry に公開できます。
- コードを Foundry に公開するためのアーティファクトリポジトリを作成または選択します。そのためには、Compute Module のドキュメントタブに移動します。次に、この外部ドキュメントページに対応するプラットフォーム内のドキュメントセクションであるコンピューティングモジュールを利用した関数を構築する > 最初のコンテナを作成を探します。そこで、リポジトリを作成または選択できます。
- 次のページで、ドロップダウンメニューから DOCKER に公開を選択し、ページの手順に従ってコードをプッシュします。
- Compute Module の設定タブで、コンテナを追加を選択します。次に、アーティファクトリポジトリとプッシュしたイメージを選択します。
- 設定を変更を選択して編集内容を保存します。
- 設定が更新されると、概要ページから Compute Module を起動し、下部のクエリパネルを使用してテストし、ログを表示できます。
Code Repositories を使用して構築する
ローカルでの開発に代わる方法として、Code Repositories を使用し、Foundry プラットフォーム内で Python Compute Module を直接構築できます。この方法では、バージョン管理、依存関係管理、コンテナイメージの公開機能が組み込まれた、統合開発環境を利用できます。
前提条件
- 関数実行モードとその設定を理解していること。
- Code Repositories に関する知識があること。
Python Compute Module のコードリポジトリを作成する
- Foundry でフォルダーに移動し、+ 新規 > Code Repository を選択します。
- リポジトリの種類として Python Compute Modules を選択します。
- リポジトリ名を入力し、作成するを選択します。
コードリポジトリには、src/ ディレクトリやデフォルトの設定ファイルなど、Compute Module に必要なプロジェクト構造があらかじめ設定されます。
コードリポジトリで関数を記述する
src/ ディレクトリ内の app.py ファイルを開き、@function デコレーターを使用して関数を定義します。
Copied!1 2 3 4 5 6 7 8 9from compute_modules.annotations import function @function def add(context, event): return str(event['x'] + event['y']) @function def hello(context, event): return 'Hello ' + event['name']
スキーマの自動推論を可能にする型付きの入力と出力には、関数スキーマの自動推論のドキュメントで説明されているように、TypedDict 型または dataclass 型を使用します。
Python ライブラリを追加する
Compute Module のコードリポジトリに Python ライブラリを追加するには、次の2つの方法があります。
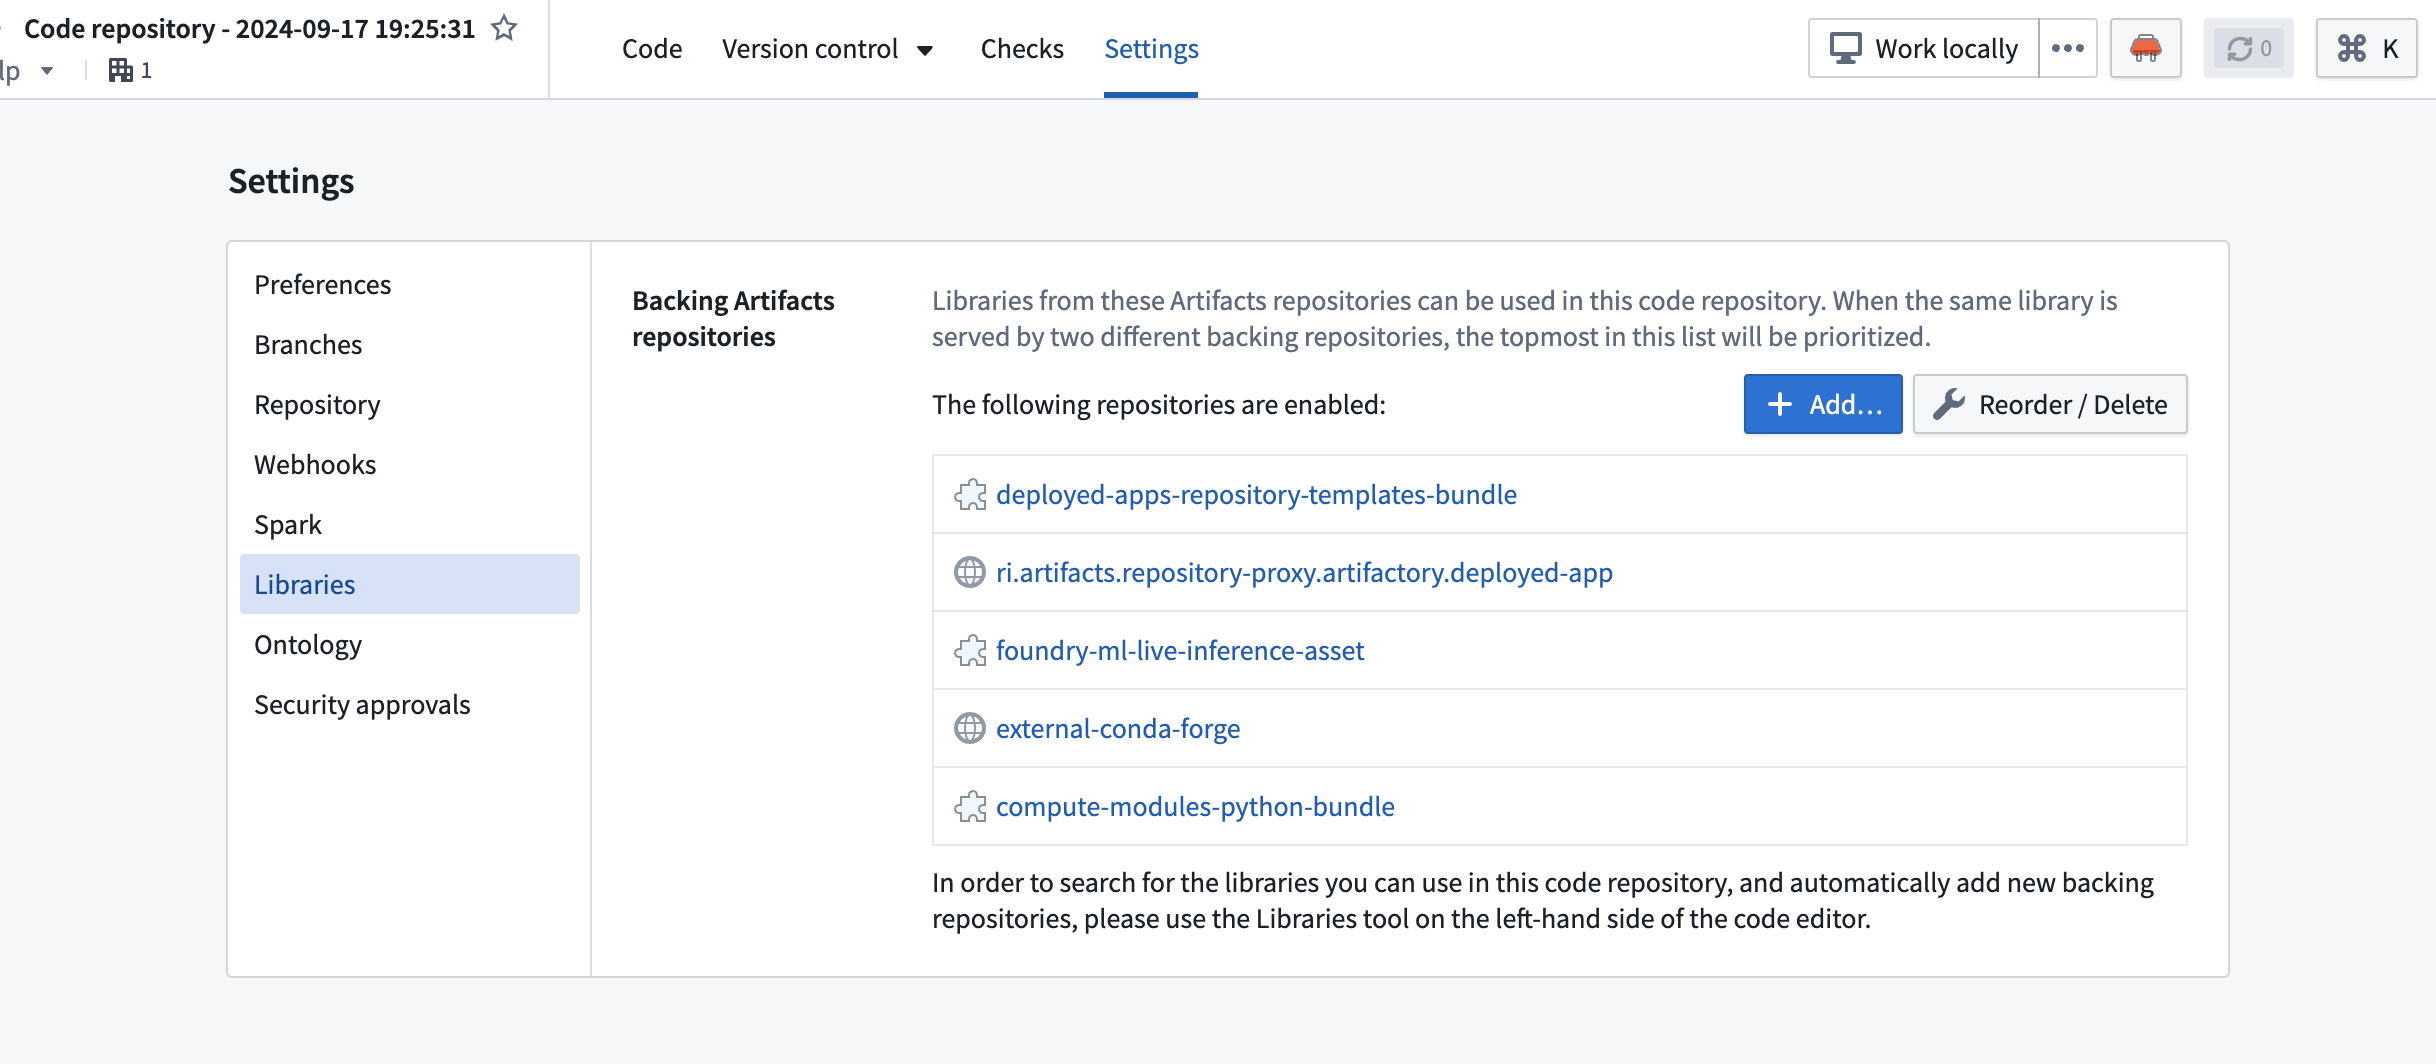
- 設定パネルを使用する: コードリポジトリの設定 > ライブラリに移動し、必要なライブラリを追加します。
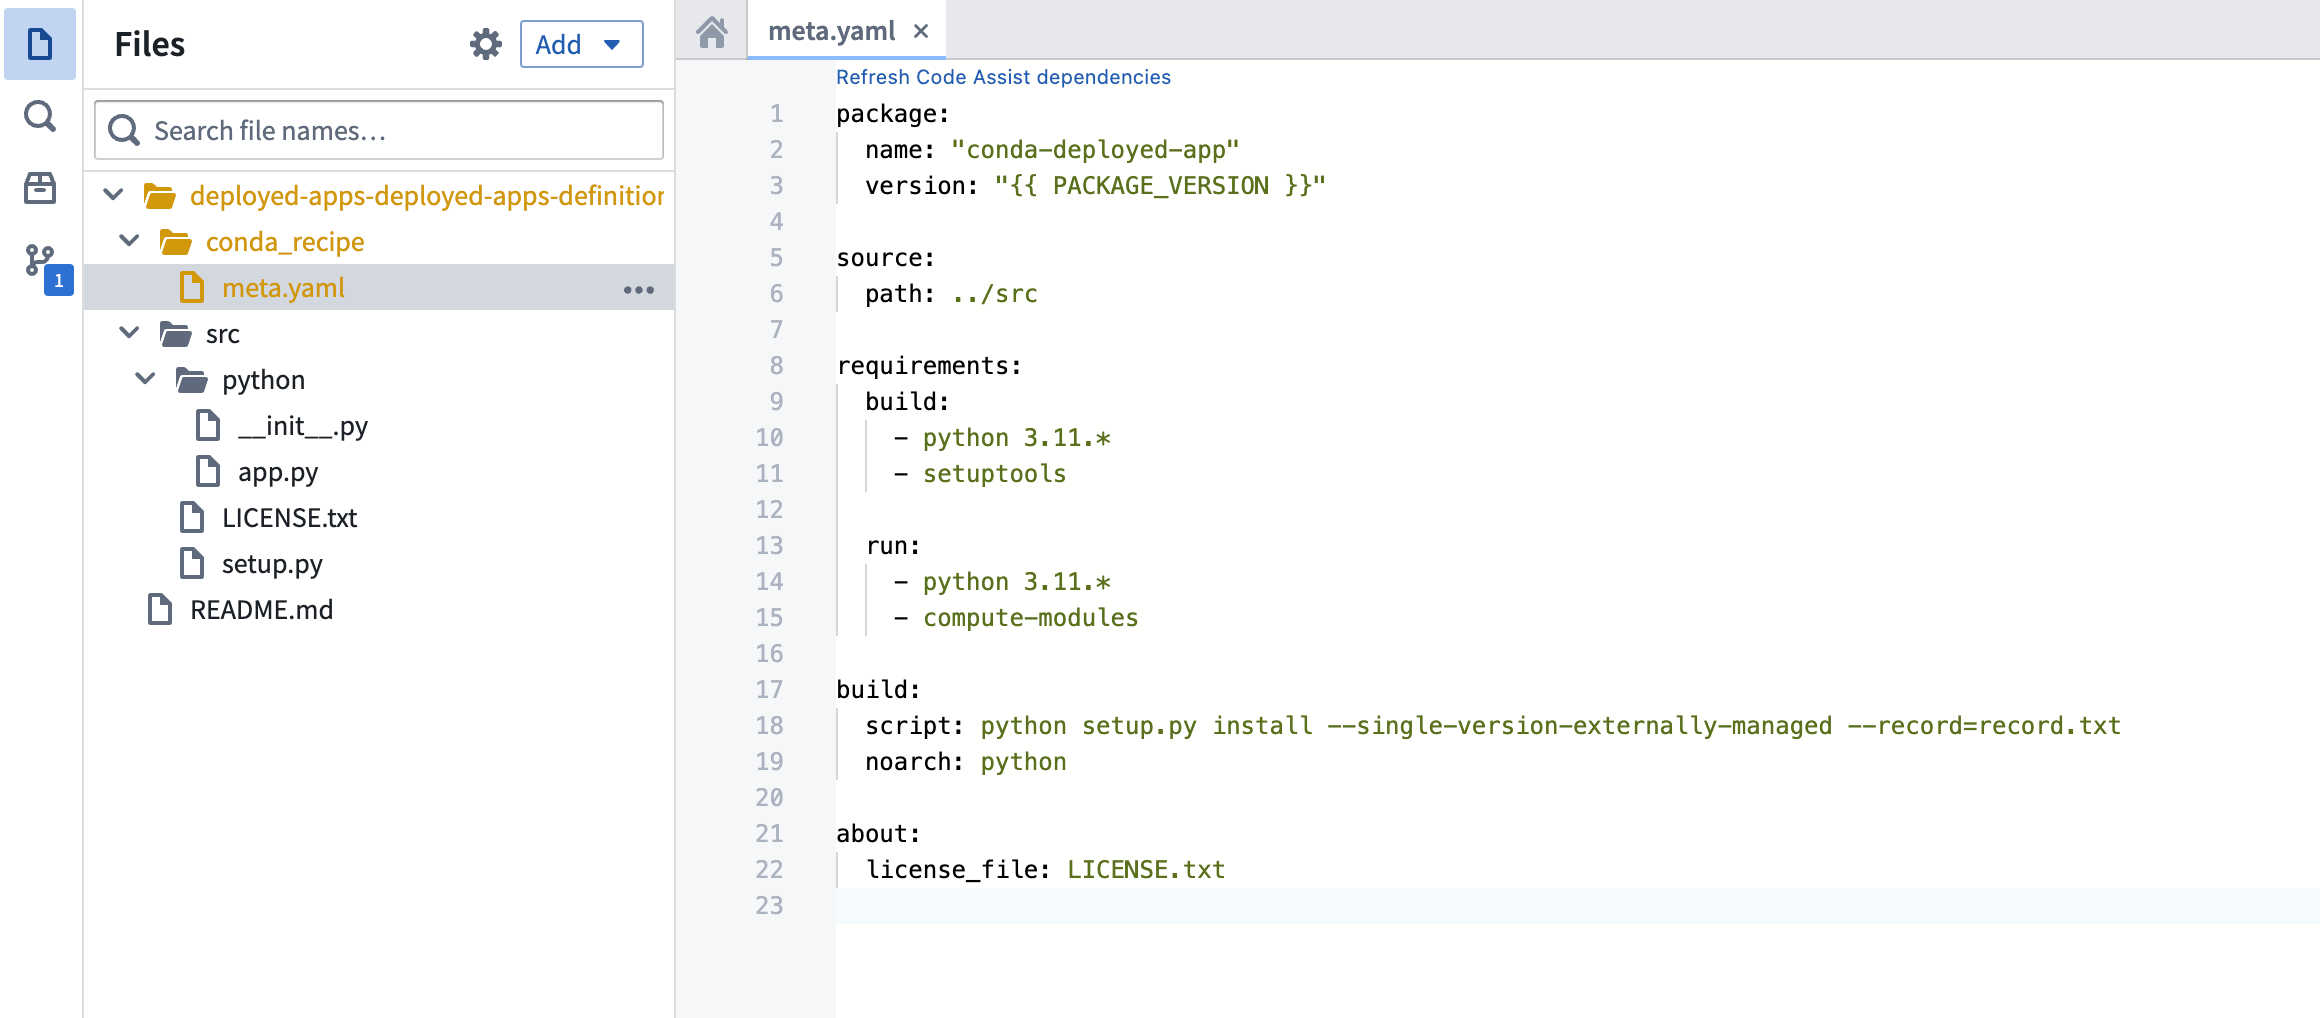
- **
meta.yamlを使用する:**リポジトリのルートにあるmeta.yaml設定ファイルに依存関係を直接追加します。
バージョンにタグを付ける
コードの準備ができたら、コードリポジトリでバージョンにタグを付けてイメージを作成します。
- リポジトリのツールバーからタグ付けするを選択します。
- バージョン番号(例:
0.0.1)を入力します。 - タグを選択してバージョンを作成します。
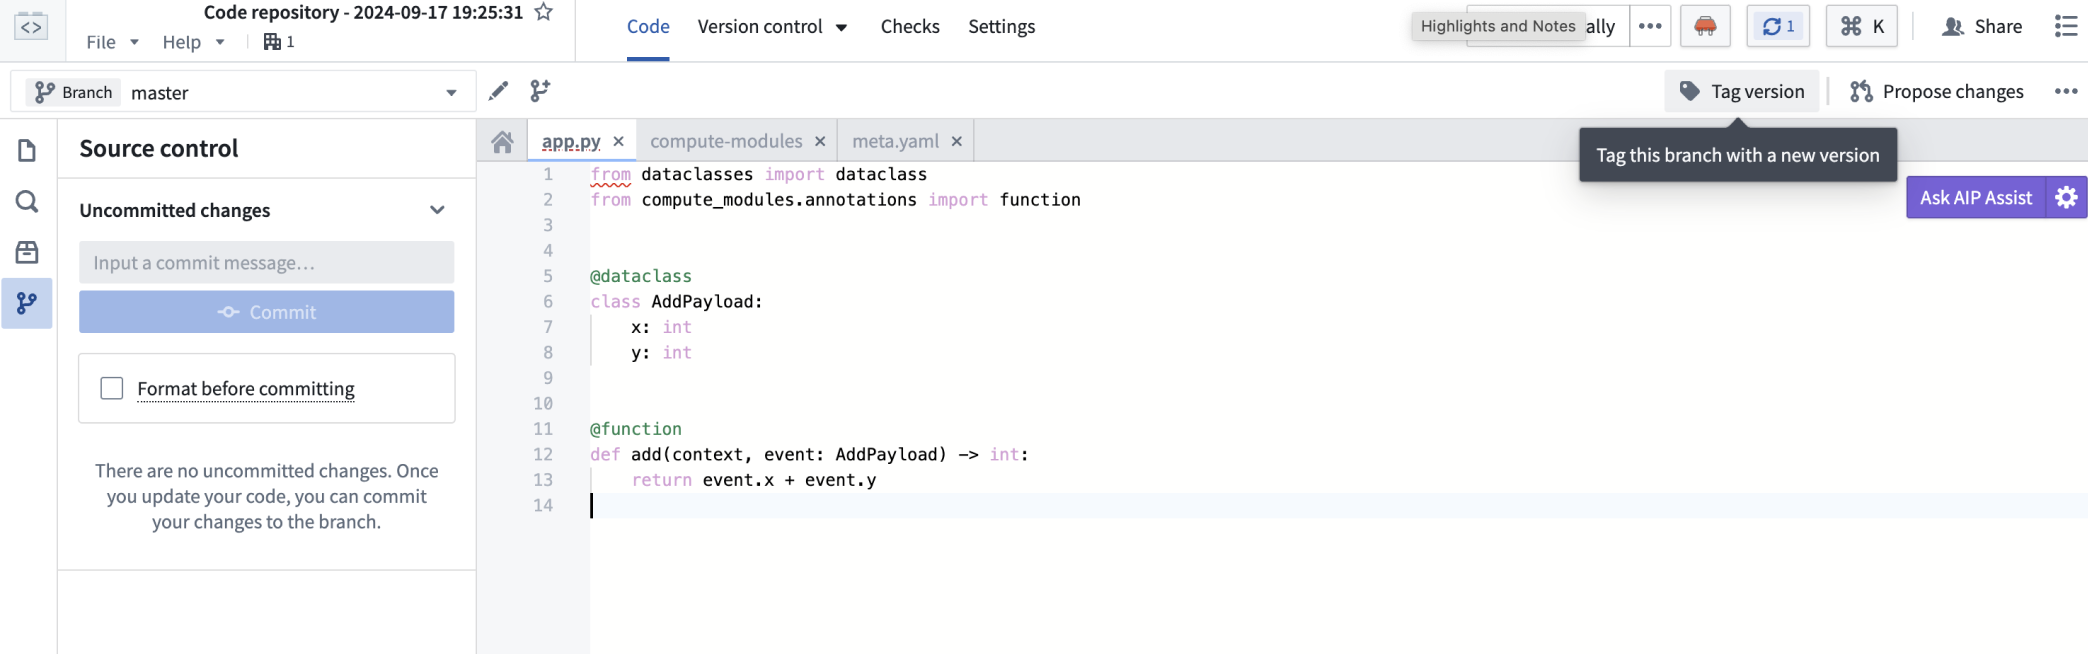
これにより、Compute Module にリンクできるコンテナイメージが作成されます。
イメージを Compute Module にリンクする
- Compute Module の設定タブに移動します。
- コンテナを追加を選択します。
- コードリポジトリと、作成したタグ付きバージョンを選択します。
- 設定を変更を選択して編集内容を保存します。
関数をインポートする
Compute Module が実行状態になると、関数をインポートできます。
- Compute Module アプリケーションの関数タブに移動します。
- インポートを選択して、実行中の Compute Module から検出された関数の一覧を表示します。
- 登録する関数を選択し、インポートを確定します。
これで、Workshop や Slate アプリケーションを含め、Foundry プラットフォーム全体で関数を使用できるようになります。
Compute Module を利用したパイプラインを構築する
Compute Module は、コンテナ化された環境で、データパイプラインの入力と出力をつなぐコネクターとして動作できます。この例では、ストリーミングデータセットを Compute Module の入力と出力とするシンプルなユースケースを構築し、入力データを2倍にして出力データセットに書き込む関数を定義します。架空のデータを使用して、動作するデータパイプラインをシミュレーションします。
前提条件
- パイプライン実行モードとその設定を理解していること。
- 入力ストリームと出力ストリームを設定していること。
- Docker Desktop をインストールしていること。
- Python 3.9 以降をインストールしていること
ローカルマシンに Compute Module を記述する
- Compute Module 用の新しいディレクトリを作成します。
- そのディレクトリに
Dockerfileという名前のファイルを作成します。 - 次の内容を
Dockerfileにコピーして貼り付けます。
# Foundry のリソースキューに応じてプラットフォームを変更します
FROM --platform=linux/amd64 python:3.12

COPY requirements.txt .
RUN pip install -r requirements.txt
COPY src .

# Foundry で Compute Modules を実行するには、USER は root 以外の数値である必要があります
USER 5000
CMD ["python", "app.py"]
requirements.txtという名前の新しいファイルを作成します。このファイルに Python アプリケーションの依存関係を記述します。例:
requests == 2.31.0
srcという名前の新しいサブディレクトリを作成します。ここに Python アプリケーションを配置します。srcディレクトリ内に、app.pyという名前のファイルを作成します。- この時点で、ディレクトリは次のようになります。
MyComputeModule
├── Dockerfile
├── requirements.txt
└── src
    └── app.py
- 次のコードを
app.pyに追加します。この完全な例では、入力ストリームから読み込み、値を2倍にして出力ストリームに書き込む処理を、60秒ごとに繰り返します。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44import os import json import time import requests # 入力と出力にアクセスするための Bearer トークンを読み込みます with open(os.environ['BUILD2_TOKEN']) as f: bearer_token = f.read() # 入力と出力のリソース情報を読み込みます with open(os.environ['RESOURCE_ALIAS_MAP']) as f: resource_alias_map = json.load(f) input_info = resource_alias_map['identifier you put in the config'] output_info = resource_alias_map['identifier you put in the config'] input_rid = input_info['rid'] input_branch = input_info['branch'] or "master" output_rid = output_info['rid'] output_branch = output_info['branch'] or "master" FOUNDRY_URL = "yourenrollment.palantirfoundry.com" def get_stream_latest_records(): url = f"https://{FOUNDRY_URL}/stream-proxy/api/streams/{input_rid}/branches/{input_branch}/records" response = requests.get(url, headers={"Authorization": f"Bearer {bearer_token}"}) return response.json() def process_record(record): # 入力ストリームのスキーマは 'x': Integer と仮定します x = record['value']['x'] # 出力ストリームのスキーマは 'twice_x': Integer と仮定します return {'twice_x': x * 2} def put_record_to_stream(record): url = f"https://{FOUNDRY_URL}/stream-proxy/api/streams/{output_rid}/branches/{output_branch}/jsonRecord" requests.post(url, json=record, headers={"Authorization": f"Bearer {bearer_token}"}) # パイプラインを自律的に実行します while True: records = get_stream_latest_records() processed_records = list(map(process_record, records)) [put_record_to_stream(record) for record in processed_records] time.sleep(60)
Compute Module をデプロイする
- Docker イメージをビルドし、アーティファクトリポジトリに公開します。
- 最後に、該当するコンテナイメージを選択してから、パイプライン実行モードを使用して Compute Module をデプロイします。
これで、出力データセットにライブでストリーミングされる結果を表示できます。
パイプラインのコードを理解する
入力と出力を操作するために、Bearer トークンと入出力情報が提供されます。
これらを使用して、入力と出力を操作し、計算を実行するコードを記述できます。コードスニペットは、2個のストリームデータセットをパイプラインでつなぐ簡単な例です。
- Bearer トークンと入力情報を使用して
stream-proxyサービスを呼び出し、入力ストリームデータセットから最新のレコードを読み取ります。 - 次に、計算を実行します(上の例では、データを2倍にします)。データ形式は、入力データによって異なります。
- 続いて、Bearer トークンと出力情報を使用して、結果を出力ストリームデータセットに書き込みます。
- 最後に、パイプラインモードの Compute Module にはクエリを実行できないため、コンテナ起動時に実行されるスクリプトの末尾で、コードがパイプラインを自律的に実行します。
最初のコンテナを作成する
これで、Docker イメージの保存先となるアーティファクトリポジトリを使用して、コードを Foundry に公開できます。
- コードを Foundry に公開するためのアーティファクトリポジトリを作成または選択します。これを行うには、Compute Module のドキュメントタブに移動します。次に、この外部ドキュメントページに対応するプラットフォーム内のドキュメントセクション、コンピューティングモジュールを利用した関数を構築する > 最初のコンテナを作成を見つけます。そこで、リポジトリを作成または選択できます。
- 次のページで、ドロップダウンメニューから DOCKER に公開を選択し、ページの手順に沿ってコードをプッシュします。
- Compute Module の設定タブで、コンテナを追加を選択します。次に、アーティファクトリポジトリとプッシュしたイメージを選択します。
- 設定を変更を選択して編集内容を保存します。
- 設定が更新されたら、概要ページから Compute Module を起動し、下部のクエリパネルでテストして、ログを表示できます。