注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
LLM キャパシティ管理
LLM キャパシティは業界全体で限られたリソースであり、すべてのプロバイダー(Azure、OpenAI、AWS Bedrock、Google Cloud Vertex など)は、アカウントごとに利用可能な最大キャパシティを制限しています。そのため、Palantir AIP も LLM プロバイダーが設けた市場全体の制約に従います。業界全体で標準的に使用される測定単位は、1分あたりのトークン数(TPM)と1分あたりのリクエスト数(RPM)です。
エンロールメントのキャパシティとレート制限
Palantir はエンロールメントごとに一定の最大キャパシティを設定しており、これを「エンロールメントレベルのレート制限」と呼びます。このキャパシティはモデルごとに TPM と RPM で測定され、GPT、Claude、Gemini、Llama、Mixtral など、エンロールメントで有効になっているすべてのプロバイダーのすべてのモデルが対象です。このように、各モデルには個別の独立したキャパシティがあり、ほかのモデルの使用量による影響を受けません。
AIP の LLM キャパシティは3つのレベルで管理されます。エンロールメントレベルの制限が全体の上限を設定し、プロジェクトのレート制限が各プロジェクトで使用できるキャパシティを制御し、ユーザーのレート制限がプロジェクトに帰属しないトラフィックにおける個々のユーザーの使用量を制御します。
デフォルトでは、すべての顧客に中ティアが適用されます。このティアには、数百人のユーザーや、たとえば数百万件のドキュメントを含む大規模なデータセットを使用する場合でも、プロトタイプを作成していくつかのユースケースに拡大するのに十分なキャパシティがあります。
また、追加のキャパシティが必要な場合、AIP ではエンロールメントのキャパシティを中ティアから大ティアまたは XL ティアにアップグレードするオプションを用意しています。エンロールメントのレート制限に常に達していて AIP の利用を拡大できない場合や、パイプラインの処理量またはユーザーの総数が増える見込みがある場合は、Palantir サポートにお問い合わせください。
エンロールメントの制限は、現在、Resource Management アプリケーションの AIP レート制限タブにエンロールメントのティアとともに表示されます。

AIP は、エンロールメントのティア、特に XL ティアで、大規模なワークフローを構築するのに十分なキャパシティを提供します。これらのティアは、LLM を大規模に使用する数百の Palantir 顧客に十分なキャパシティを提供してきました。また、これらの上限は引き続き引き上げています。
モデルおよびティアごとのエンロールメントのレート制限の詳細については、LLM エンロールメントのレート制限を参照してください。
AIP の使用量と制限
エンロールメント管理者は、Resource Management アプリケーションの AIP の使用量と制限ページに移動して、次の操作を行えます。
-
使用状況を表示:エンロールメント内のすべてのプロジェクトとリソースについて、Palantir が提供するすべてのモデルの LLM トークンとリクエストの使用量を表示します。
-
レート制限を管理:エンロールメントのプロジェクトとユーザーのレート制限を管理します。
- プロジェクトのレート制限: 特定のプロジェクト内のすべてのリソースが毎分使用できる TPM と RPM の合計の最大割合を、モデルごとに設定します。
- ユーザーのレート制限: 1人のユーザーが毎分使用できる最大 TPM と RPM を、モデルごとに設定します。
使用状況を表示する
使用状況を表示タブでは、エンロールメント内のすべてのプロジェクト、リソース、ユーザーについて、Palantir が提供するすべてのモデルの LLM トークンとリクエストの使用量を確認できます。管理者はこの表示を使用して、LLM キャパシティをより適切に管理し、レート制限に対応できます。
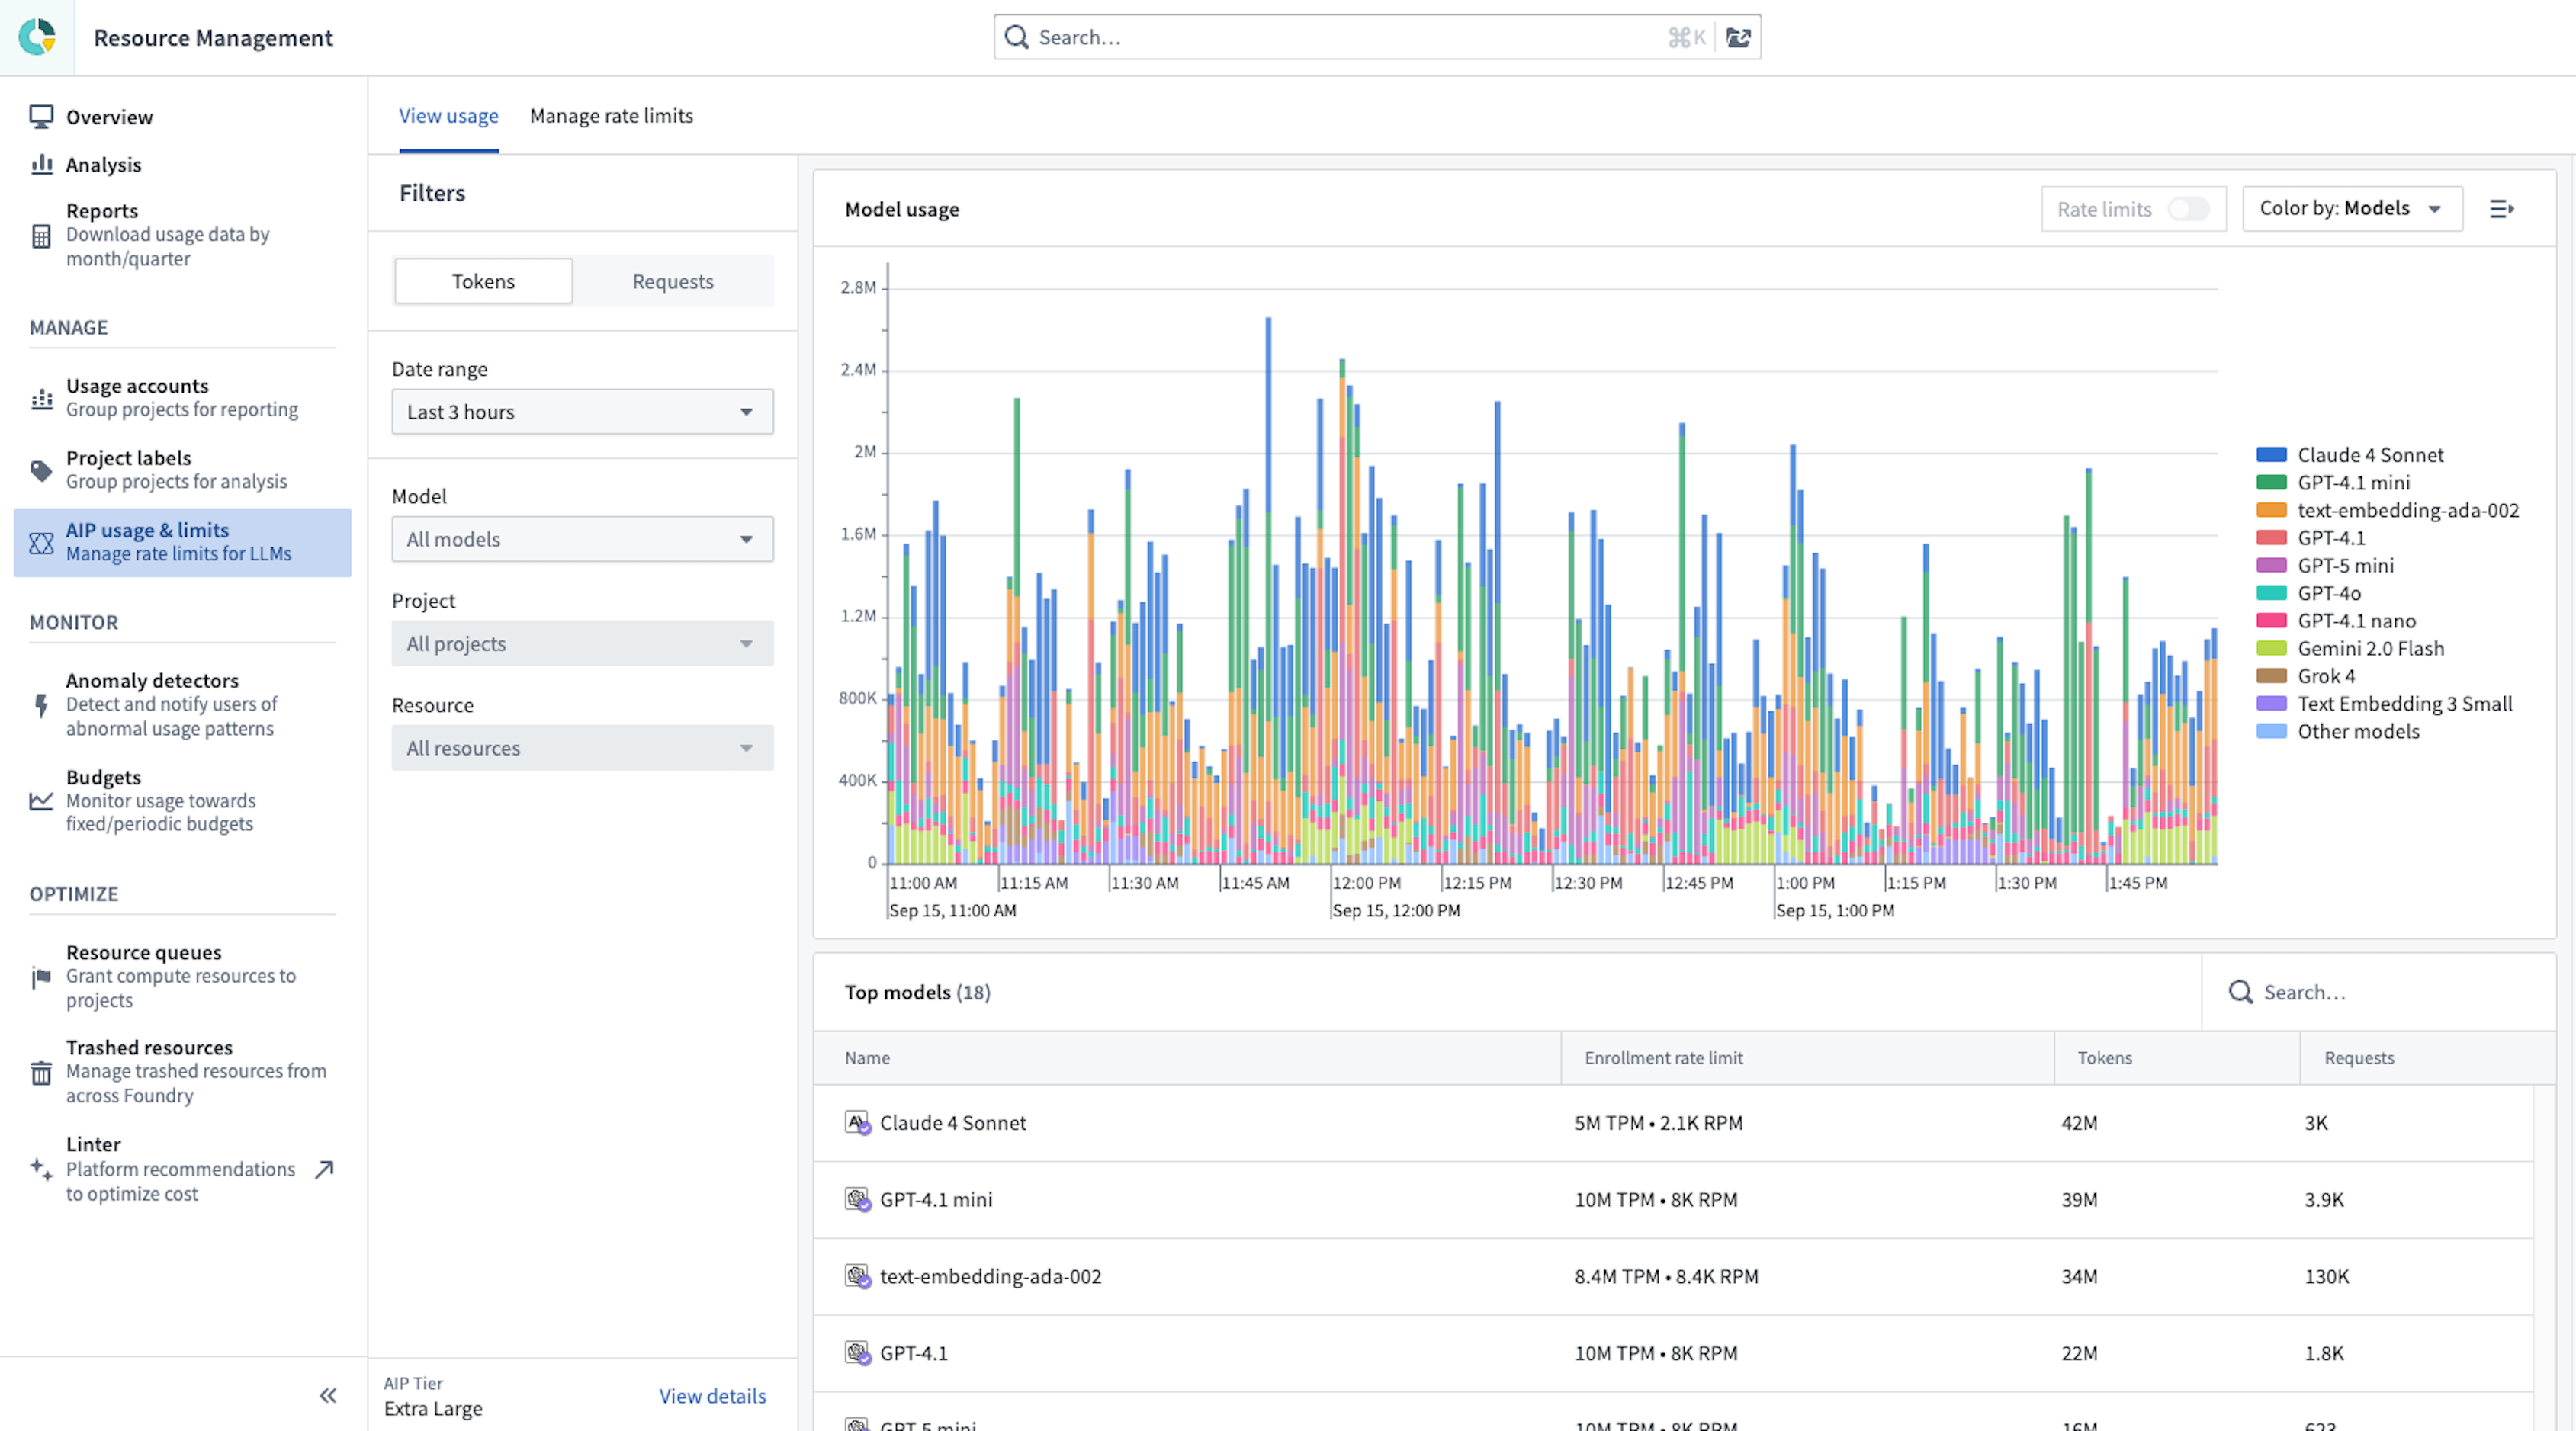
この表示では、次の操作を行えます。
- すべてのモデルにわたる集計使用量と、個々のモデルごとの使用量の内訳を表示します。
- LLM キャパシティは1分あたりのトークン数(TPM)と1分あたりのリクエスト数(RPM)のレベルで管理されるため、1分あたりのトークンとリクエストの使用量を追跡します。
- キャパシティはモデルごとに個別に管理されるため、一度に1個のモデルにドリルダウンします。
- 前述のとおり、LLM キャパシティにはエンロールメントレベルの制限と各プロジェクトのプロジェクトレベルの制限があるため、エンロールメントの使用量の概要を表示し、プロジェクトレベルの使用量を拡大表示します。
- 各モデルのユーザーに帰属する使用量の合計を表示します。
- レート制限のしきい値を表示します。右上のトグルを使用すると、破線が表示され、プロジェクトまたはエンロールメントの制限に達する時点を視覚的に確認できます。制限はモデルおよびプロジェクトによって異なります。エンロールメントまたはプロジェクトの制限と、特定のプロジェクトおよびエンロールメント全体の総キャパシティの80%を上限とする「バッチ制限」の2本のレート制限線が表示されます。詳細については、後述のインタラクティブなクエリを優先するを参照してください。
- 2週間分のデータを、特定の期間に分単位まで絞り込みます。ユーザーは、左サイドバーの日付範囲フィルターを使用するか、チャート上でドラッグアンドドロップする期間フィルターを使用して、特定の期間にドリルダウンできます。期間が6時間未満の場合、チャートにはプロジェクト別(エンロールメントレベル)またはリソース別(プロジェクトレベル)の内訳が表示されます。
- 使用量の概要をテーブルで表示します。チャートの下にあるテーブルには、プロジェクトごと(単一のプロジェクトに絞り込んだ場合はリソースごと)のトークンとリクエストの集計が表示されます。すべてのフィルター(期間、モデル、適用されている場合はプロジェクトフィルター)がテーブルに反映されます。
この表示は、LLM 使用量のコスト管理向けには最適化されていません。分析タブで AIP が有効なエンロールメントの LLM コストを確認する方法をご覧ください。
AIP の使用量に基づいて対処する
エンロールメントレベルまたはプロジェクトレベルのレート制限に達している場合は、次のいずれかの対処を検討できます。
- プロジェクトの制限を調整して、エンロールメントのキャパシティを使い切る可能性のある特定のリソースまたはプロジェクトの使用量に上限を設けます。
- インタラクティブな使用を追跡して、パイプラインによってレート制限を受けていないことを確認します。レート制限を受けている場合は、これらのパイプラインをプロジェクトレベルで制限するか、制限を引き上げた別のプロジェクトにリソースを移動できます。
- ビルドを1日の異なる時間帯にスケジュールし、大規模なビルドは週末にスケジュールします。可能な限り、大規模なビルドを複数同時に実行することを避け、定期的なビルドは時間帯や頻度を変えてスケジュールし、重複を避けます。
- エンロールメントで現在利用しておらず、そのため十分なキャパシティがある別のモデルにワークフローを切り替えます。
- より大きいティアへのアップグレードを依頼します。
レート制限を管理する
LLM リクエストは、次の2つの方法のいずれかで帰属先が決まります。これらは相互に排他的であり、すべてのリクエストには、必ずどちらか一方の種類の制限が適用されます。
- プロジェクトに帰属するリクエストには、エンロールメントの制限と該当するプロジェクトの制限が適用されます。これは、設定済みのプロジェクトリソースからリクエストが発生するワークフロー(たとえば、Pipeline Builder パイプライン、AIP Logic、Automate、Chatbot Studio、Workshop アプリケーション)に該当します。ユーザーごとの制限は、これらのリクエストには適用されません。
- ユーザーに帰属するリクエストには、エンロールメントの制限と、呼び出し元ユーザーに対するユーザーごとの制限が適用されます。これは、プロジェクトリソースではなく、ユーザーのセッションから直接リクエストが発生するワークフロー(たとえば、AI FDE、AIP Assist、AIP Analyst、Pipeline Builder の Explain や Generate などのネイティブアシスタント機能、および Foundry が提供するモデルに接続する Continue (VS Code) や Claude Code などの IDE 統合)に該当します。

プロジェクトのレート制限を管理する
Resource Management の AIP の使用量と制限ページにあるレート制限を管理タブでは、管理者は、AIP で大規模なユースケースに取り組む場合に本番ユースケースでの LLM 使用量を最大化するとともに、試験的なプロジェクトがエンロールメント全体の容量を使い切ることを制限または禁止するよう、柔軟に設定できます。エンロールメント管理者は、モデルごとに、特定のプロジェクト内のすべてのリソースが合計で毎分使用できる TPM と RPM の最大割合を設定できます。
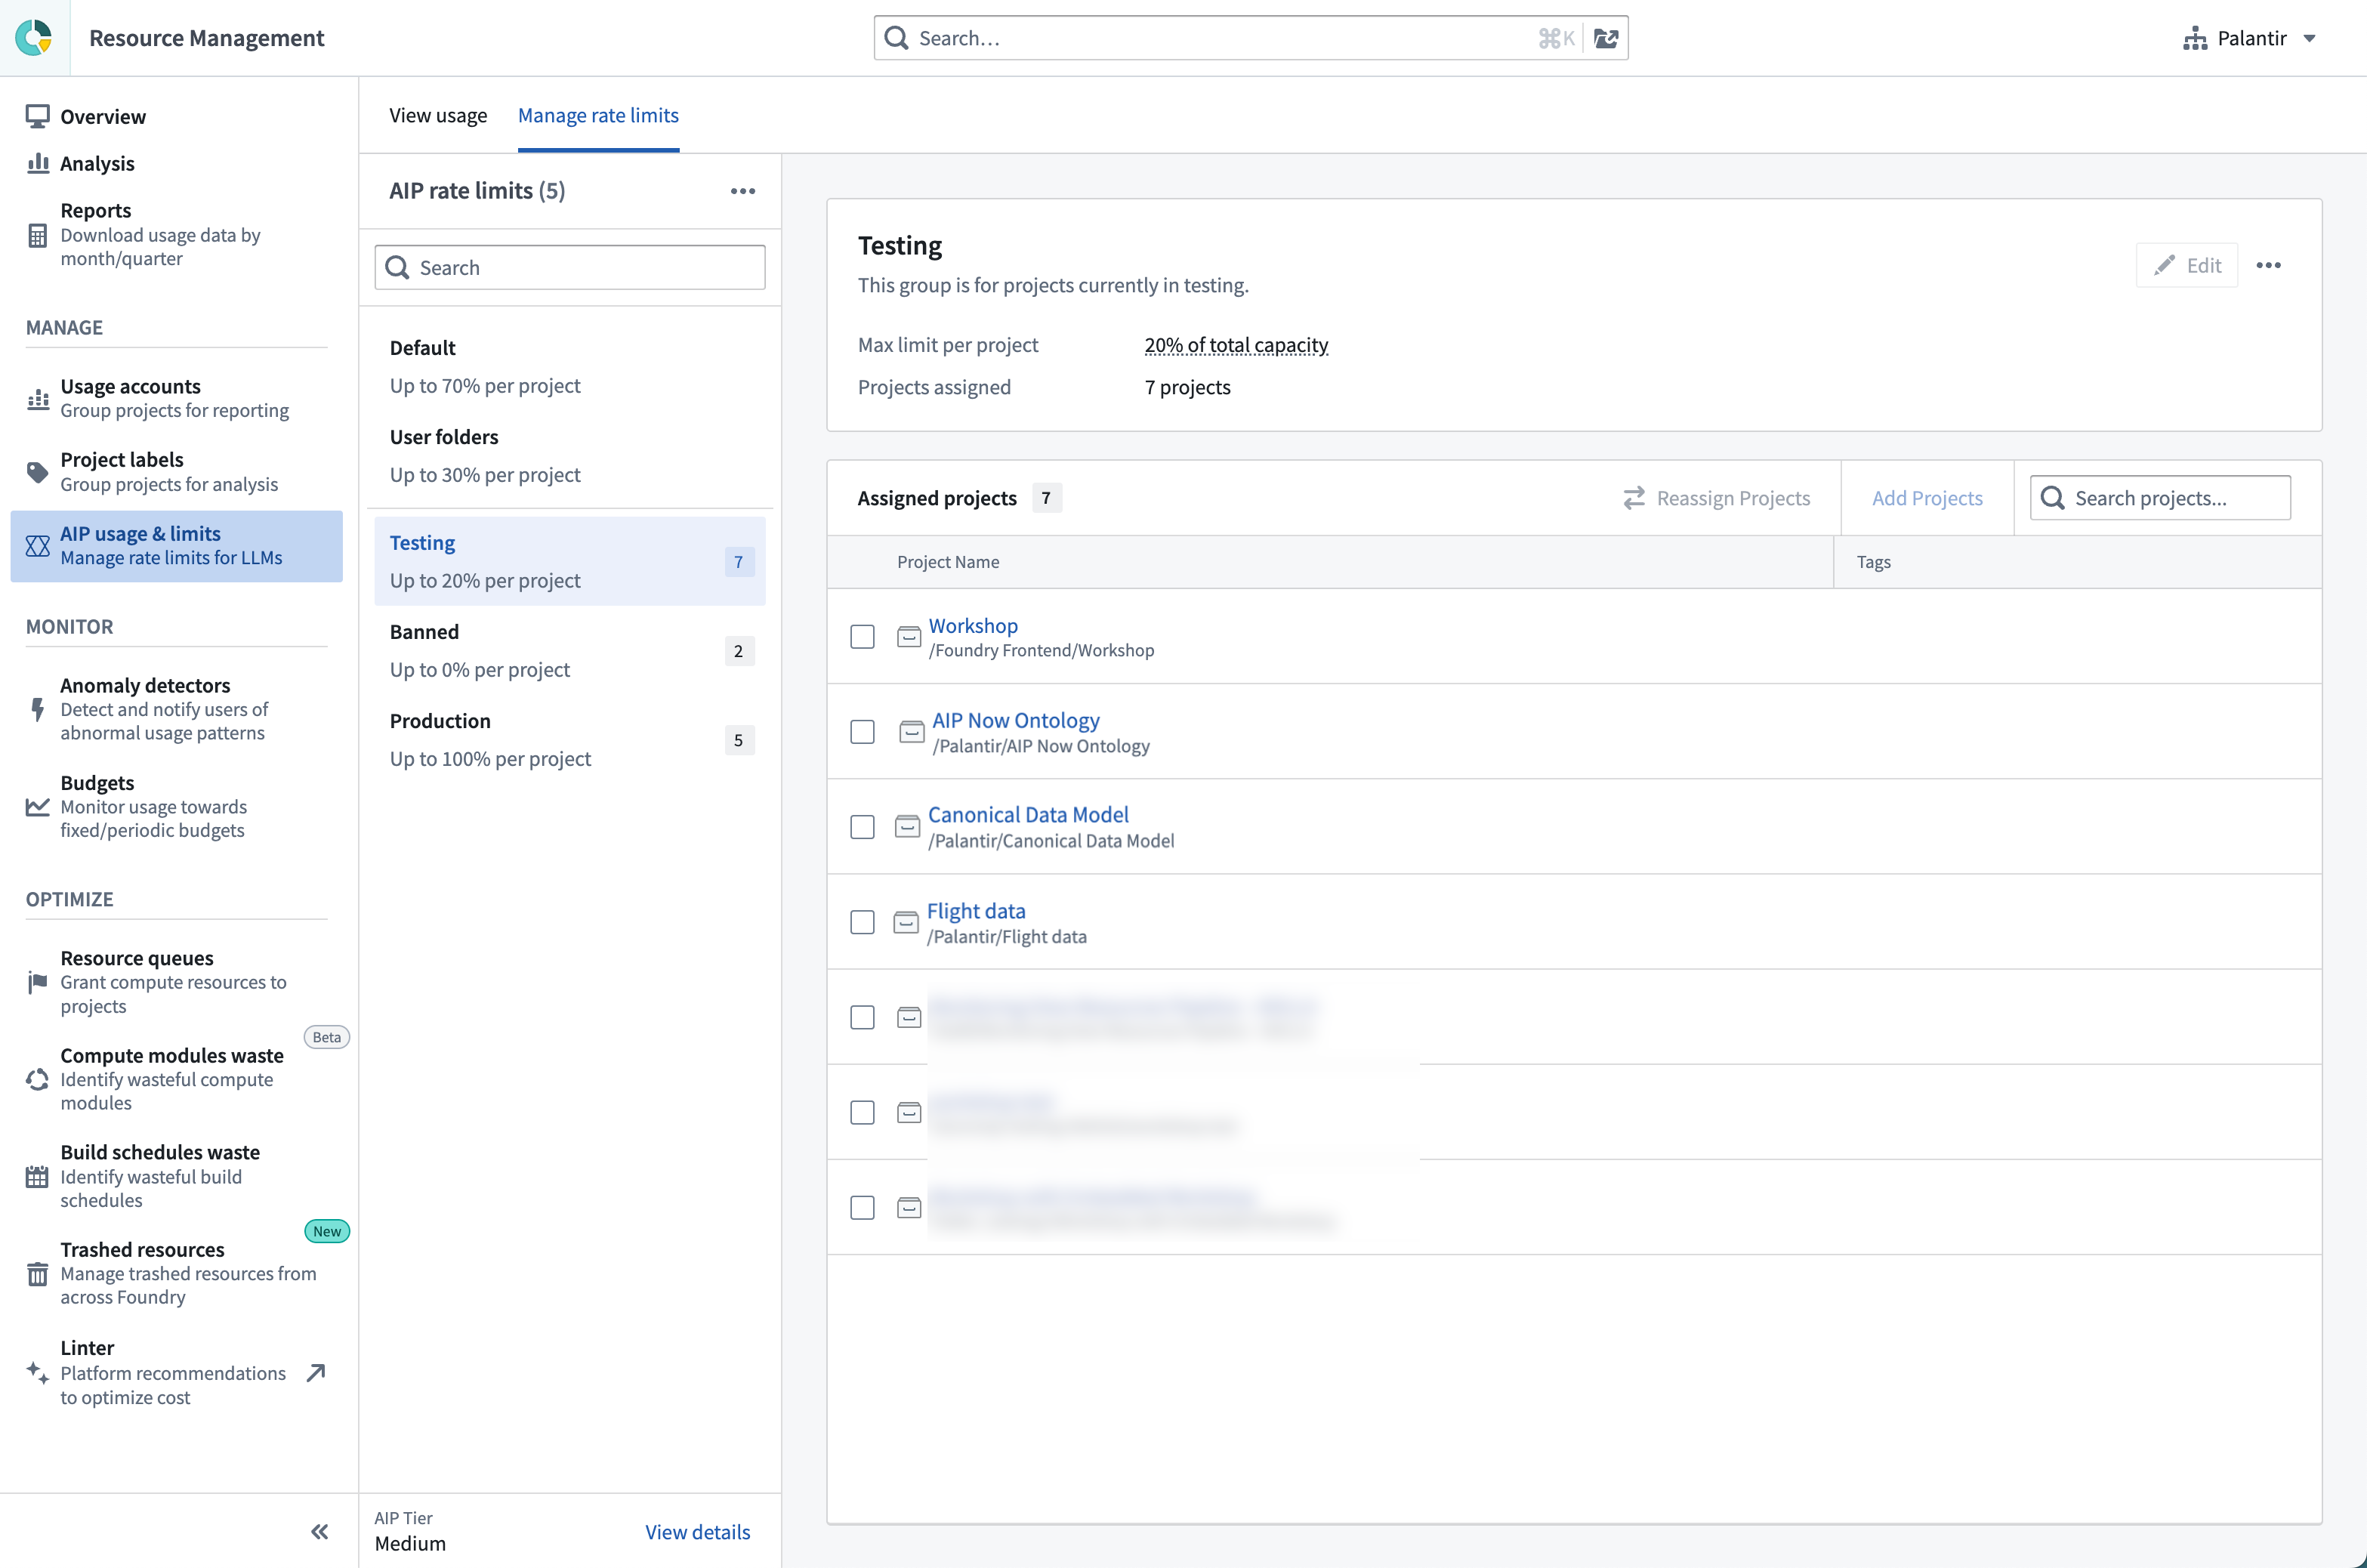
デフォルトでは、すべてのプロジェクトに、使用できる範囲を定める特定の制限が割り当てられます。管理者は、プロジェクトの制限を追加で作成し、それぞれの制限に含めるプロジェクトと、使用できるエンロールメント容量の割合を定義できます。
モデルのオーバーライド
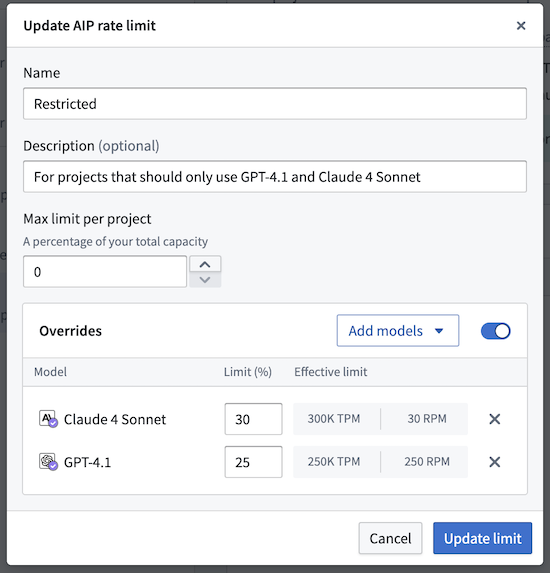
各プロジェクトの制限内で、モデル固有のオーバーライドを設定し、モデルレベルで容量の割り当てをさらに制御できます。モデルのオーバーライドを使用すると、個々のモデルに異なる割合の制限を設定し、プロジェクトの基本制限をオーバーライドできます。これらのオーバーライドは、そのプロジェクトの制限に含まれるプロジェクトにのみ適用されます(デフォルトの制限の場合は、手動で作成されたほかのプロジェクトの制限に割り当てられていないすべてのプロジェクトに適用されます)。
モデルのオーバーライドにより、容量をより細かく管理し、モデルの「許可リスト」を作成できます。プロジェクトの基本制限を0%に設定し、承認されたモデルにのみ特定の割合を指定したモデルのオーバーライドを追加できます。また、特定のモデルのオーバーライドの制限割合を0%に設定することで、そのモデルの使用を明示的に禁止することもできます。
たとえば、次の手順では、プロジェクトの制限に含まれるプロジェクトで、Claude Sonnet 4 と GPT-4.1 のみを使用できるように制限する方法を説明します。
- プロジェクトの基本制限を0%に設定します。
- Claude Sonnet 4 のモデルのオーバーライドを30%で追加します。
- GPT-4.1 のモデルのオーバーライドを25%で追加します。
このプロジェクトの制限に含まれるすべてのプロジェクトのユーザーは、割り当てられた容量制限の範囲内で、指定されたモデルにのみアクセスできるようになります。
ユーザーレート制限
ユーザーごとのレート制限は、ユーザーに帰属するリクエストに対して、1人のユーザーが利用できる容量を制御します。これにより、対話型ワークフローを通じて1人のユーザーがモデルのエンロールメント容量全体を使い切ることを防ぎます。
ユーザーレート制限は、Resource Management の AIP の使用量と制限ページにあるレート制限を管理タブで管理します。エンロールメント管理者は、ユーザーごとのデフォルト制限を表示し、ユーザーグループのオーバーライドを作成し、モデルごとのオーバーライドを設定できます。

ユーザーごとのデフォルト制限
各モデルのユーザーごとのデフォルト制限は、Resource Management のユーザーレート制限タブ、またはエンロールメントのレート制限テーブルのユーザーごとの制限列に表示されます。これらのデフォルトは Palantir が設定し、管理者がユーザーレート制限タブでオーバーライドしない限り、すべてのユーザーに適用されます。 各モデルのユーザーごとのデフォルト制限は、Resource Management のユーザーレート制限タブ、またはエンロールメントのレート制限テーブルのユーザーごとの制限列に表示されます。これらのデフォルトは Palantir が設定し、管理者がユーザーレート制限タブでオーバーライドしない限り、すべてのユーザーに適用されます。
Palantir のデフォルトのユーザーレート制限を使用することを推奨します。これらは、(a) 1人のユーザーによってエンロールメントの制限が使い切られるのを防ぐことと、(b) ユーザーが Foundry の最新の AIP ツールを効果的に活用して生産性を最大限に高められるようにすることのバランスを考慮して定義されています。管理者がすべてのモデルに新しいカスタム制限を設定する場合は、新しいモデルがリリースされるたびにその制限を見直し、意図せずユーザーを制限していないことを確認する必要があります。
ユーザーごとのオーバーライド
エンロールメント管理者は、ユーザーごとのデフォルトをオーバーライドし、特定のユーザーグループに属する特定のユーザーに、異なるユーザーごとの制限を付与できます。これは、エンロールメント全体の容量ティアを引き上げずに、パワーユーザー、対話型アプリケーションを支えるサービスアカウント、またはユーザーに帰属するワークフローで継続的に高いスループットを必要とするチームに対応する場合に役立ちます。また、本番ワークフローで使用する特定のモデルの容量が、ユーザーによって誤って使い切られないように保護する手段でもあります。
ユーザーごとのオーバーライドは、次の2つの方法のいずれかで指定できます。
- エンロールメント制限に対する割合: エンロールメントレベルのレート制限に対する割合を表す、1から100までの値です。たとえば、あるモデルのエンロールメント制限が400万 TPM で、管理者が25%のオーバーライドを設定した場合、そのオーバーライドの対象となるユーザーには100万 TPM の実効制限が適用されます。
- TPM と RPM の絶対値: 1分あたりのトークン数と1分あたりのリクエスト数を明示的に指定します。割合に基づく方法では目的の制限に合わない場合に、管理者が制限を正確に制御できます。
オーバーライドを設定すると、公開済みのユーザーごとのデフォルトが置き換えられます。デフォルトと組み合わされることも、デフォルトが下限として適用されることもありません。
モデルのユーザーごとの制限を50,000 TPM または10 RPM 未満に設定すると、対象ユーザーが一部の AIP 機能を使用できなくなる可能性があります。設定した制限がこれらの推奨最小値を下回ると、オーバーライドフォームに警告が表示されます。ネイティブの AIP 機能へのアクセスを維持するため、ユーザーごとの制限を0 TPM または0 RPM に設定することは現在サポートされていません。
オーバーライドのレベル
ユーザーごとのオーバーライドは3つのレベルで設定でき、より具体的な設定が優先して適用されます。
- ユーザーごとのデフォルトオーバーライド: エンロールメント内のすべてのユーザーに、すべてのモデルで適用される単一の割合です。これが新しい基準となり、Palantir が公開したモデルごとのデフォルトを置き換えます。
- モデルごとのオーバーライド: デフォルトに加えて、1個以上の特定のモデルに異なる割合または絶対値の制限を設定します。モデルごとのオーバーライドにより、管理者はカタログ全体の制限を変更せずに、個々のモデルのユーザーごとの制限を引き上げたり引き下げたりできます。
- ユーザーグループのオーバーライド: 1個以上の Foundry ユーザーグループを対象とするオーバーライドです。ユーザーグループのオーバーライドでは、独自のデフォルトの割合と、任意で独自のモデルごとのオーバーライド(割合または絶対値)を定義します。ユーザーがオーバーライドの対象グループに属する場合、エンロールメント全体のユーザーごとのデフォルトではなく、そのグループの設定が使用されます。
どのレベルにもオーバーライドが設定されていない場合は、そのモデルの公開済みのユーザーごとのデフォルトが使用されます。

ユーザーグループのオーバーライドが決まる仕組み
ユーザーグループのオーバーライドは、名前を付けた Foundry ユーザーグループの集合に適用されます。各オーバーライドには名前があり、説明、デフォルトの割合、モデルごとの制限を任意で設定できます。ユーザーがオーバーライドに記載されたグループのいずれかに属する場合、そのオーバーライドがユーザーに適用されます。
ユーザーが複数のオーバーライドの対象となるグループに属する場合、そのユーザーとモデルには、それらのオーバーライドから算出される最も高い制限が適用されます。これにより、オーバーライドによる制限の引き上げは累積的で予測可能になります。あるグループを通じてユーザーに高い制限を付与しても、そのユーザーがより低い設定の別のグループに属していることによって、知らないうちに取り消されることはありません。たとえば、デフォルトのユーザー制限が40%のエンロールメントを考えます。ユーザー A は、異なる2つのユーザー制限オーバーライドの対象となる2個のグループに属しており、一方のユーザー制限はエンロールメント容量の10%、もう一方は35%と定義されています。ユーザー A のユーザー制限は、オーバーライドの中で最も高い35%になります。
ユーザーグループのオーバーライドを削除すると、対象グループのメンバーにはエンロールメント全体のユーザーごとの設定が適用されるようになります。エンロールメントに独自のユーザーごとの設定がない場合は、公開済みのユーザーごとのデフォルトが適用されます。
AIP の予約済み容量
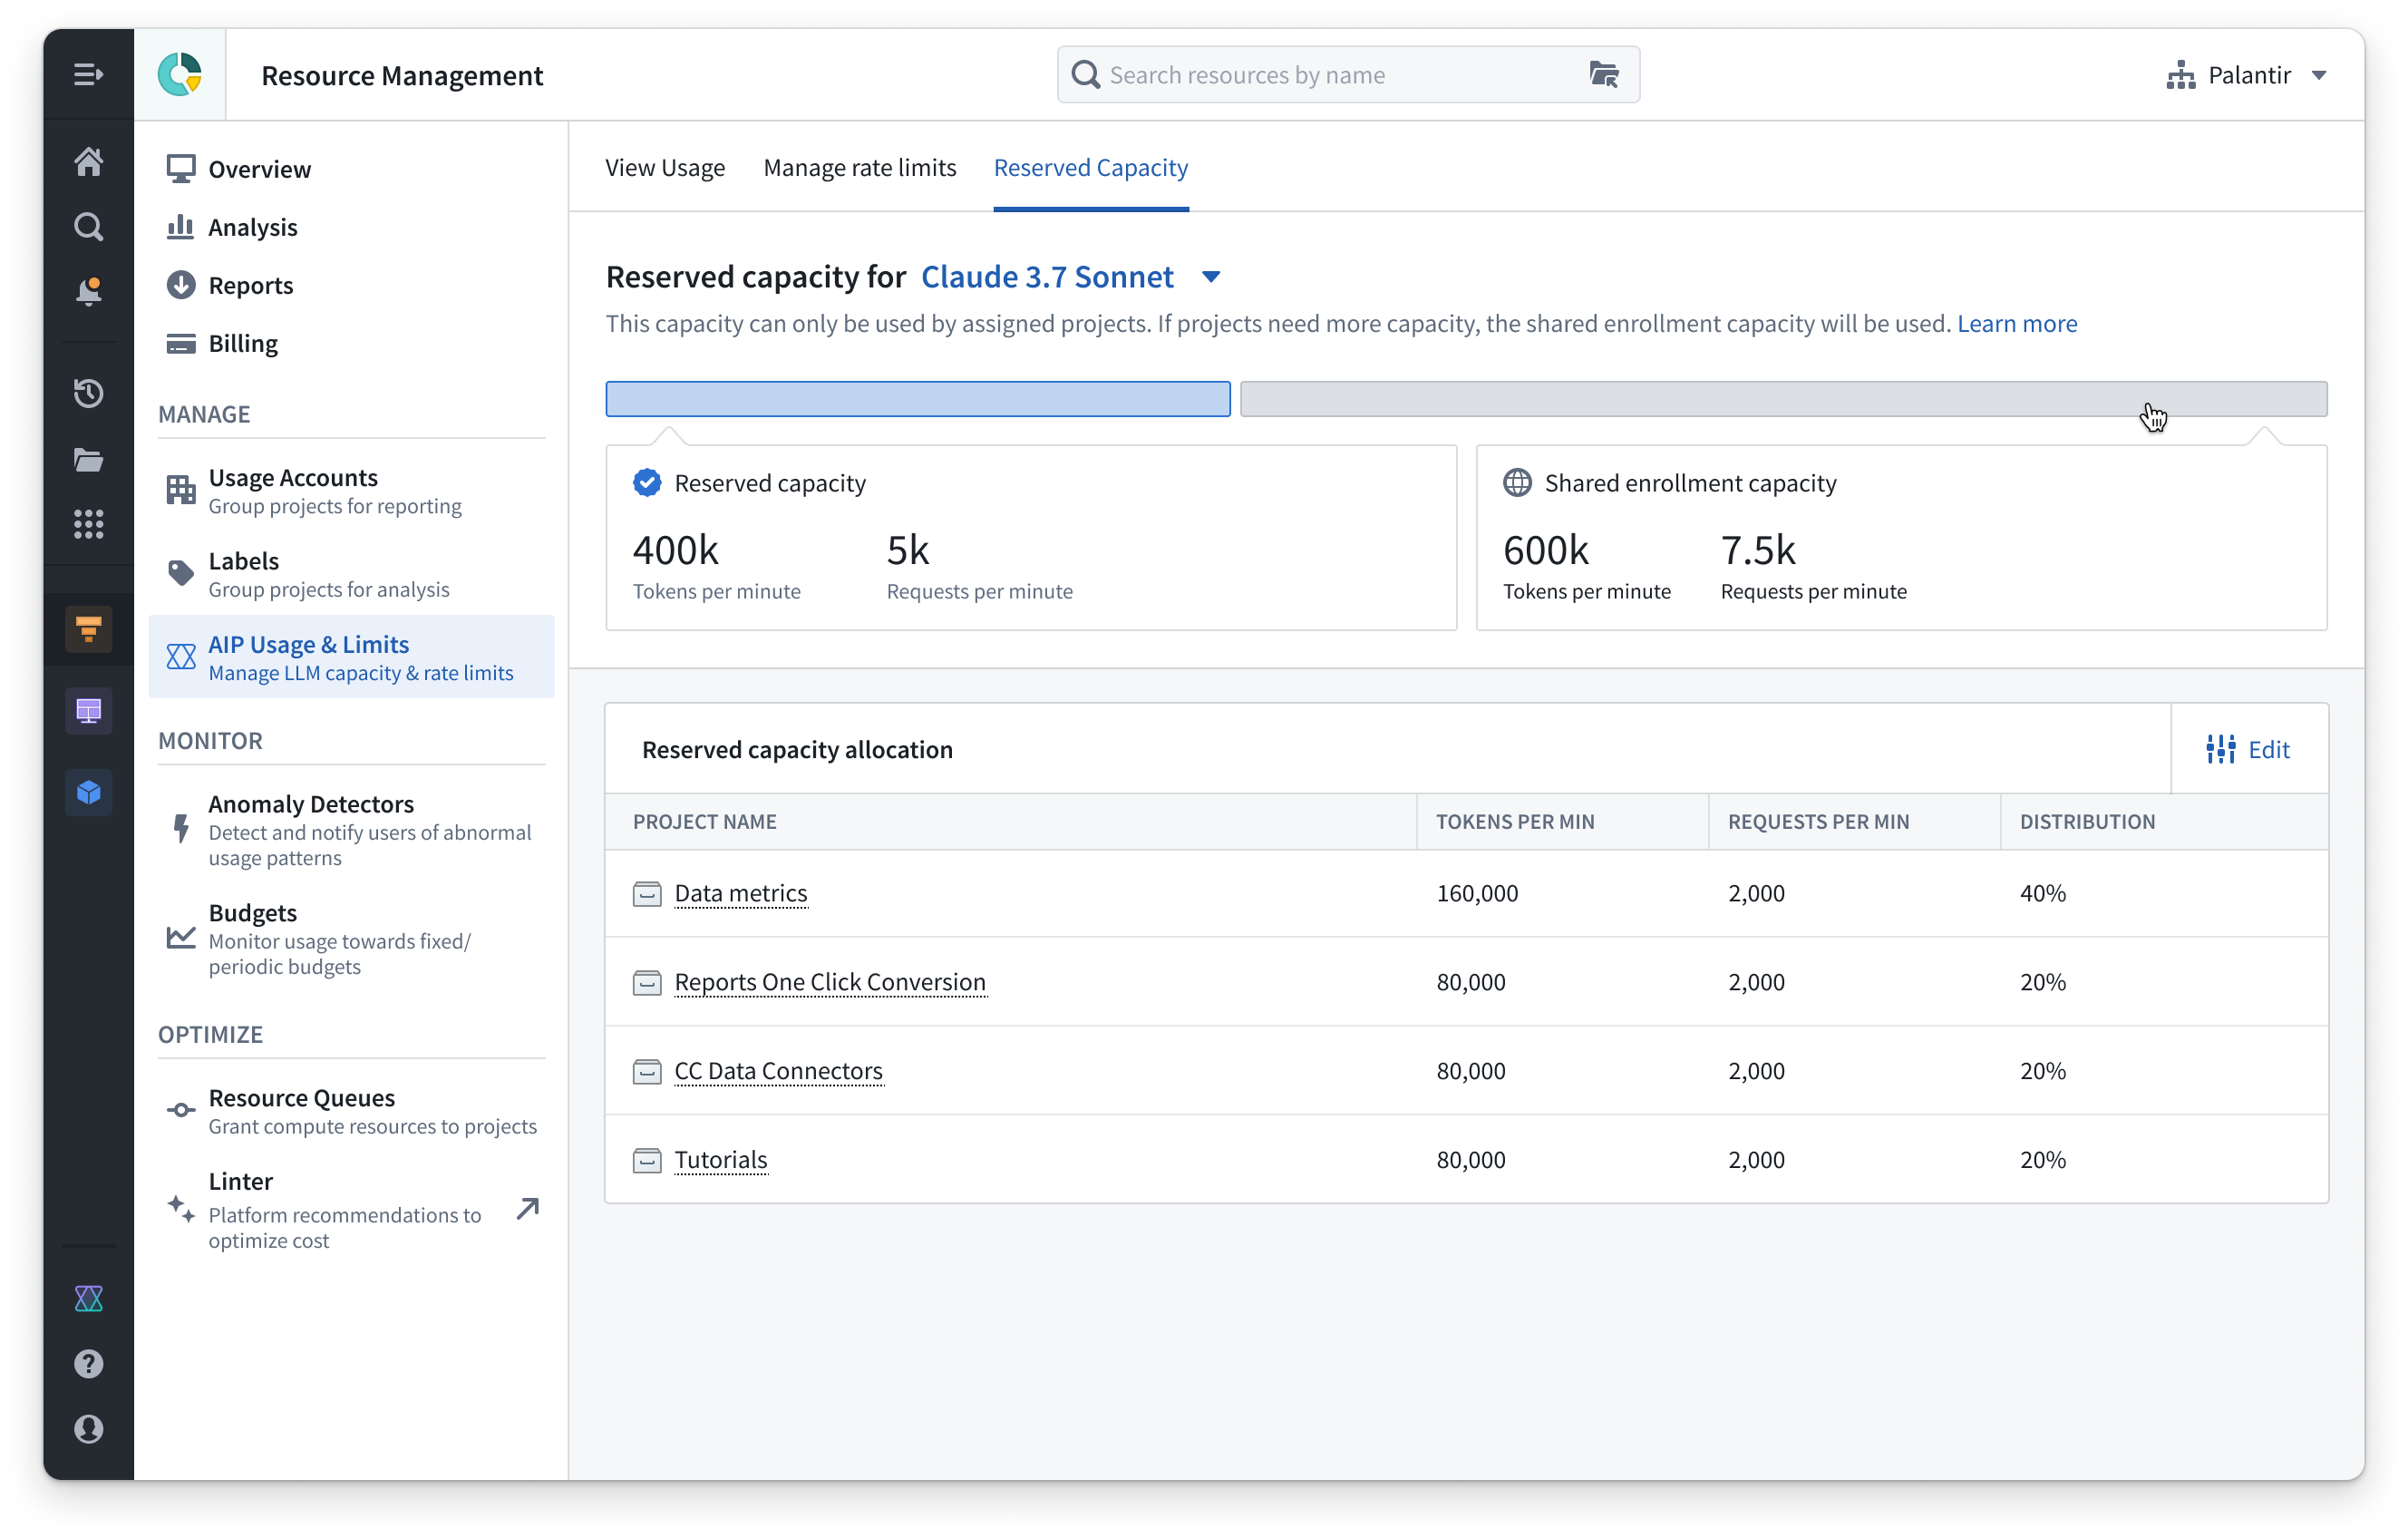
予約済み容量は、Resource Management の AIP LLM 容量管理ツールです。予約済み容量は、モデルで利用可能な1分あたりのトークン数 (TPM) と1分あたりのリクエスト数 (RPM) の一定の割合を保証します。プロジェクトのレート制限、エンロールメントの制限、または同じプールを使用するほかのリソースとの競合によって処理が制限されてはならない、重要な本番ワークフローに使用します。
主な機能
- 予約済み容量は、モデルで利用可能な総容量から特定の量の TPM と RPM を予約することで、モデル単位で設定します。
- 予約済み容量の合計に対する割合をプロジェクトに割り当てることで、最も重要なリソースを優先し、組織の要件に合わせて LLM の割り当てをカスタマイズできます。
- 予約済み容量を使い切ると、割り当て先のプロジェクトは、既存のプロジェクトおよびエンロールメントの制限が適用される共有容量に自動的にフォールバックします。
利用可能なモデルとコスト
予約済み容量はすべてのモデルで利用可能です。モデルの総容量の最大50%を予約できます。その後、総容量が減少した場合も、新しい総容量の最大95%を上限として、予約した容量は維持されます。
昨年の AIP のパフォーマンスに基づくと、予約済み容量は99.9%の稼働率を確保するのに十分でした。容量が100%利用可能であることは保証できませんが、昨年の使用パターンに基づくと、LLM リクエストの失敗の99%超は、エンロールメントおよびプロジェクトのレート制限が原因でした。これらの問題は、予約済み容量ツールを使用して対処し、解決できます。
予約済み容量というサービス自体に追加コストはかかりません。AIP でのほかのすべての LLM 使用と同様に、追加コストは追加のトークン使用量に応じて発生します。今後、新しいユースケースや特定のモデルについては、この方針が変更される可能性があります。この方針が変更された場合でも、既存のワークフローに対して予約済み容量の使用料金を遡って請求することはありません。これらのワークフローには、引き続き追加のトークン使用量に基づく料金のみが発生します。
リソース管理管理者権限を持つユーザーは、モデルの容量を予約し、特定のプロジェクトに配分できます。
使用例
予約済み容量の使用について理解を深めるために、次の例を考えてみます。
- エンロールメントには、あるモデルについて100万 TPM の容量があります。本番アプリケーションを含むプロジェクトでは、そのアプリケーションのデフォルトの上限はエンロールメント容量の70%、つまり70万 TPM です。
- この本番アプリケーションの容量を増やすには、プロジェクトのレート制限を引き上げることで、アプリケーションを含むプロジェクトの容量をエンロールメント容量の100%、つまり100万 TPM に増やせます。
- アプリケーションの上限はエンロールメントの上限の100%になりましたが、このアプリケーションは引き続き、共有容量をめぐってほかのリソースと競合しています。競合するリソースは、Resource Management アプリケーションの AIP の使用量と制限セクションにある使用状況を表示タブで確認できます。そのうえで、競合するリソースのスケジュールをずらすか、リソースを別のモデルに移行できます。
- スケジュールとモデルの使用を最適化した後も、この本番アプリケーションに必要な容量を確実に確保するには、予約済み容量を使用できます。利用可能な100万 TPM のうち25万 TPM を予約し、75万 TPM を共有容量として残すとします。
- この予約済み容量を、本番アプリケーションなどの重要なリソースに割り当てられます。アプリケーションは、まず予約済みの25万 TPM を使用します。その容量を使い切ると、75万 TPM の共有容量を使用し、そこでほかのリソースと競合します。エンロールメントの合計は100万 TPM のままです。25万 TPM はこのアプリケーション専用に予約され、残りの75万 TPM はすべてのリソースで共有されます。
AIP エンロールメントの LLM コストの可視化
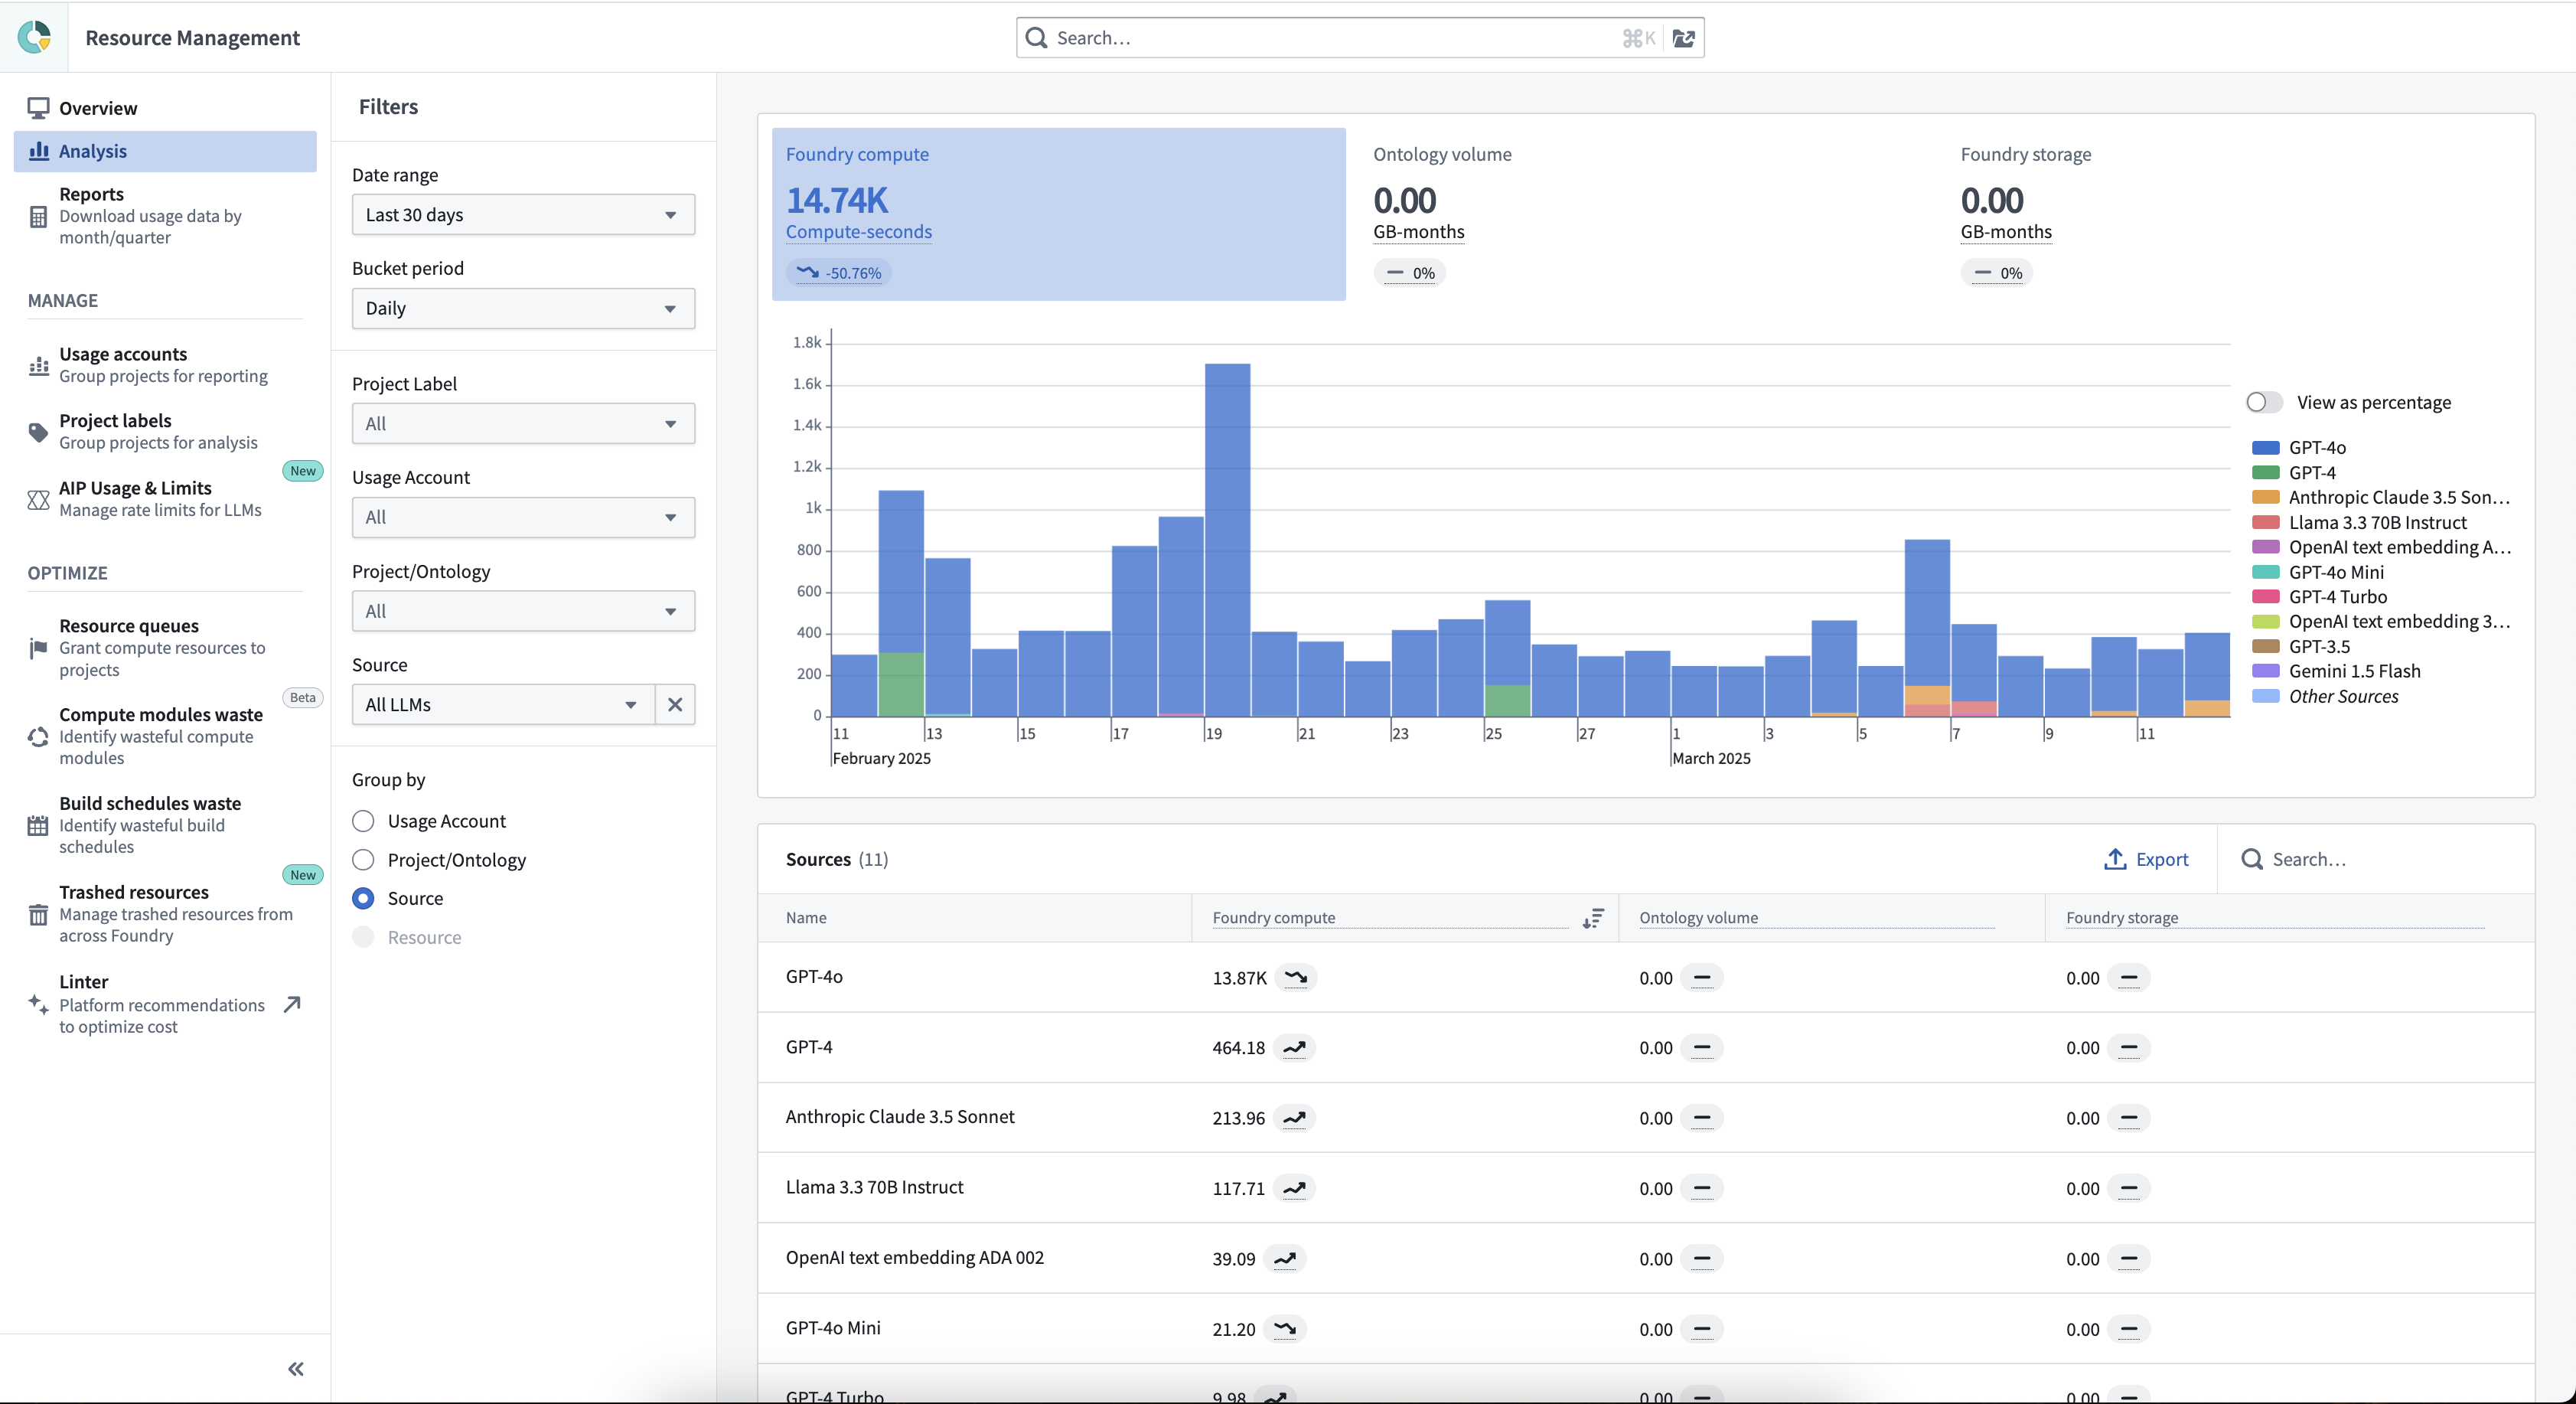
分析ページを使用して、AIP が有効なエンロールメントの LLM 使用コストを表示します。
分析ページで、リソースでフィルタリング: すべての LLM とソースでグループ化を選択します。これにより、モデル別に分類された日次の LLM コストのチャートが生成されます。
インタラクティブなクエリを優先する
一般に、AIP はバッチリクエストを伴うパイプラインよりも、インタラクティブなリクエストを優先します。インタラクティブなクエリは、ユーザーが LLM と行うリアルタイムのインタラクションとして定義されます。たとえば、Workshop、Chatbot Studio、AIP Logic の LLM ボードでのプレビュー、Pipeline Builder の LLM ノードでのプレビューが該当します。バッチクエリは、ユーザーが即時のレスポンスを期待せずに送信する大量のリクエストとして定義されます。たとえば、Transforms パイプライン、Pipeline Builder、Automate(ロジック用)が該当します。
現在、この原則により、エンロールメントおよびプロジェクト単位の容量の20%が、常にインタラクティブなクエリ用に予約されることが保証されています。つまり、あるモデルの容量が100,000 TPM の場合、どの1分間でもパイプラインに使用できるのは最大80,000 TPM のみであり、インタラクティブなクエリには少なくとも20,000 TPM(最大100,000 TPM)が利用可能です。
FAQ
プロジェクトレベルとユーザーレベルのレート制限の想定される使用例は何ですか?
次の例を考えてみます。
- エンロールメントで本番運用中の AIP ユースケースは1つだけなので、そのユースケースを含むプロジェクトを「本番」制限の配下に移動し、エンロールメントの上限の最大100%を利用できるようにします。
- この本番ユースケースに加えて、テスト段階にある2つ目のユースケースも考慮する必要があります。このテスト段階のユースケースは、本番用の使用量をすべて占有することなくテストを実行できる必要があります。このユースケースは、容量の最大30%を利用できる「テスト」制限に追加できます。テスト用の容量が常に一定量確保されるように、「本番」制限を90%に引き下げます。
- 前述のユースケースに加えて、本番運用のユースケースをもう1つ追加します。ただし、GPT-5 を使用していた最初のユースケースとは異なり、このユースケースは Claude Sonnet 4.6 を使用します。この新しいユースケースは、最初の本番ユースケースと同じ「本番」制限に問題なく追加できます。
- 同じエンロールメントで、特定のユーザーが LLM を試せるようにしたいと考えています。エンロールメント管理者は、容量の最大20%を利用できる「実験」制限に2個のプロジェクトを追加します。
- テスト用プロジェクトと2個の試験的プロジェクトは、技術的には合計で容量の最大70%を消費できますが、過去のデータによると、実際の使用量は通常これを下回ります。
- 最後に、このエンロールメントでは、1人のユーザーが本番ユースケースの容量を占有しないようにしたいと考えています。管理者は、GPT-5 と Claude Sonnet 4.6 のデフォルトのユーザーレート制限をオーバーライドしてエンロールメント容量の10%に設定する一方、Claude Opus 4.6 と GPT-5.4 の容量を増やします。また、ユーザーの個人フォルダの容量を0%に設定し(個人フォルダでの構築を控え、共同作業を促すため)、Control Panel の AIP 設定で、指定したユーザーに LLM ビルダー権限を付与します。
制限カテゴリー内のプロジェクトとユーザーで割合を共有するのではなく、各プロジェクトに割合が適用されるのはなぜですか?
- 複数のプロジェクトとリソースが同じ100%の容量を共有できる理由は、数百の顧客にわたる1年以上の過去の LLM 使用パターンに基づくと、ほとんどのプロジェクトとリソースは LLM を呼び出さないためです。そのため、複数のリソースが同じ100%の容量を共有できます。
- 制限カテゴリー内のすべてのプロジェクトで同じ使用割合を共有すると、使用量に厳格な上限が適用されることになります。しかし、既存の使用状況に基づくと、99.9%のケースではその必要性は認められません。複数のリソースが同じ1分間に最大容量を使用することは非常にまれであり、そのような場合でも、リクエストは成功するまで再試行されます。
AIP の使用量に制限があるのはなぜですか?
-
まず、プロバイダーによって、TPM、RPM、およびリージョンごとの利用可能性に大きな違いがあります。AIP はすべてのプロバイダーの容量を活用していますが、Palantir は各クラウドサービスプロバイダーが課す制限を回避できません。
-
さらに、Palantir が顧客に提供する LLM 容量には、ほとんどのプロバイダーの一般的なサービスと比較して、高水準のコンプライアンス要件が課されています。Palantir は、ゼロデータ保持(ZDR)と、特定のリージョンへのデータルーティングの制御(地理的制限)を保証しています。
-
Azure OpenAI、AWS Bedrock、GCP Vertex、Palantir がホストするモデルをはじめとするほとんどのプロバイダーは、いずれも地理的制限をサポートしていますが、地理的に制限されたリクエストに対して保証される LLM 容量はより少なくなります。OpenAI direct、Anthropic direct、xAI などのその他のプロバイダーは、モデルを提供するリージョンがより少なくなっています。
- Control Panel の AIP 設定で有効にするモデルプロバイダーが多いほど、付与される容量が増えます。
- 使用量が多い顧客には、容量の多い上位ティアへのアップグレードを提供しています。
- 地理的制限のない AIP の顧客は、より大きな容量プールを利用できます。
- 一部のモデルは、特定のリージョンではまだ広く利用可能になっていません。Palantir が早期アクセスできる場合もありますが、常に可能なわけではありません。
- バッチ API など、一部の機能はまだ利用できません。バッチ API は24時間以内に数十億トークンを処理できますが、その期間データを保存する必要があるため、Palantir のコンプライアンス要件を満たしません。
-
前述のとおり、中規模から XL までのティアで、大規模な本番ワークフローに十分対応できます。ティアを変更するには、Palantir サポートにお問い合わせください。
容量の問題を解決するうえで最大の障害は何ですか?
- 容量の問題の最大の原因は、地理的制限です。エンロールメントに地理的制限が適用されており、法的な観点からその制限を解除できる場合は、担当の Palantir チームと連携して解除してください。
- 新しいモデルは、初期段階では容量が限られていることがよくあります。
- 数百万件を大きく超える項目を処理する大規模なパイプラインでは、容量の問題の解決がはるかに難しくなります。