注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
移行手順:foundry_ml [廃止予定] から palantir_models へ
このページでは、foundry_ml で構築したモデルを palantir_models フレームワークに移行するためのベストプラクティスと手順を説明します。まず、考慮すべきガイダンスを紹介し、その後に移行の例を示します。この例では、Code Repositories で foundry_ml を使ってモデルを構築するコードを示し、そのコードを palantir_models を使って書き換える方法を説明します。
ベストプラクティス
次のセクションでは、移行の実施方法と考慮事項に関するガイダンスを示します。
移行方法
移行後のモデルは、次の方法で構築できます。
- 新しいコードリポジトリまたは Jupyter® コードワークスペースでモデルを構築する、または
- 既存のコードリポジトリを編集してモデルを構築する。
どちらの方法にも利点があり、最適な方法は状況によって異なりますが、いくつか留意すべき点があります。
- 元のモデルを Code Workbooks で構築した場合は、新しいコードリポジトリまたは Jupyter® コードワークスペースで構築する必要があります。この2つの製品は
palantir_modelsをサポートしています。 - 別のリポジトリやワークスペースにモデルをインポートするには、その Python 依存関係もインポートする必要があり、環境の競合が発生する可能性があるため、通常はモデルを構築したコードリポジトリまたはコードワークスペースで推論に使用する方が簡単です。
新しいコードリポジトリを使ってモデルを構築する方法については、次の例を確認してください。
モデリングリポジトリをそのまま移行する方法
既存のモデリングリポジトリを保持し、同じリポジトリ内で foundry_ml から palantir_models に移行するには、次の手順に沿って進めます。
foundry_mlを参照するコードをすべてコメントアウトするか削除します。- ライブラリサイドバーから
foundry_mlライブラリを削除します。 - リポジトリを最新の設定にアップグレードします。
- 実行時用および Build 時用メニューで推奨を選択するか、
conda_recipe/meta.yamlファイルを直接編集して、buildおよびrunの両方のブロックにある既存の Python 依存関係をpython >=3.11.*(必要な場合は3.10.*)に更新し、Python をバージョン3.10以降にアップグレードします。Python 3.9 は、専用の移行キャンペーンの一環として2025年10月に非推奨となります。 - ライブラリサイドバーから
palantir_modelsの推奨バージョンをインストールします。必要な取得元リポジトリがインポートされないため、meta.yamlを直接編集してインストールしないでください。
モデルアダプターを作成する際に、モデルトレーニングまたはモデルアダプターライブラリではなく、パイプラインタイプの既存リポジトリを使用する場合は、リポジトリをアップグレードしない限り、最新のモデリング機能を利用できません。モデルで直接デプロイをサポートするには、このアップグレードが必要です。
Code Repositories で foundry_ml を使って構築したモデルの移行
以下は、Code Repositories で foundry_ml から palantir_models に移行する例です。
次のスニペットは、foundry_ml を使用するように作成された scikit-learn の線形回帰モデルを示しています。このモデルを palantir_models に移行します。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28from transforms.api import transform, Input, Output from foundry_ml import Model, Stage from sklearn.linear_model import LinearRegression from sklearn.pipeline import Pipeline from sklearn.preprocessing import StandardScaler @transform( training_data_input=Input("<YOUR_PROJECT_PATH>/data/housing_train_data"), model_output=Output("<YOUR_PROJECT_PATH>/models/linear_regression_foundry_ml"), ) def create_model(training_data_input, model_output): training_df = training_data_input.pandas() numeric_features = ['median_income', 'housing_median_age', 'total_rooms'] pipeline = Pipeline([ ("scaler", StandardScaler()), ("regressor", LinearRegression())]) X_train = training_df[numeric_features] y_train = training_df['median_house_value'] pipeline.fit(X_train, y_train) model = Model(Stage(pipeline["scaler"], output_column_name="features"), Stage(pipeline["regressor"])) model.save(model_output)
上記のコードを foundry_ml から palantir_models に移行するには、以下の手順に沿って進めます。
ステップ1:モデルトレーニングテンプレートで新しいコードリポジトリを開く
Palantir プラットフォームは、機械学習向けのテンプレート化されたリポジトリとして、モデルトレーニングテンプレートを提供しています。Code Repositories でこのテンプレートにアクセスするには、まず何を構築していますか? と尋ねられたら、モデルを選択します。
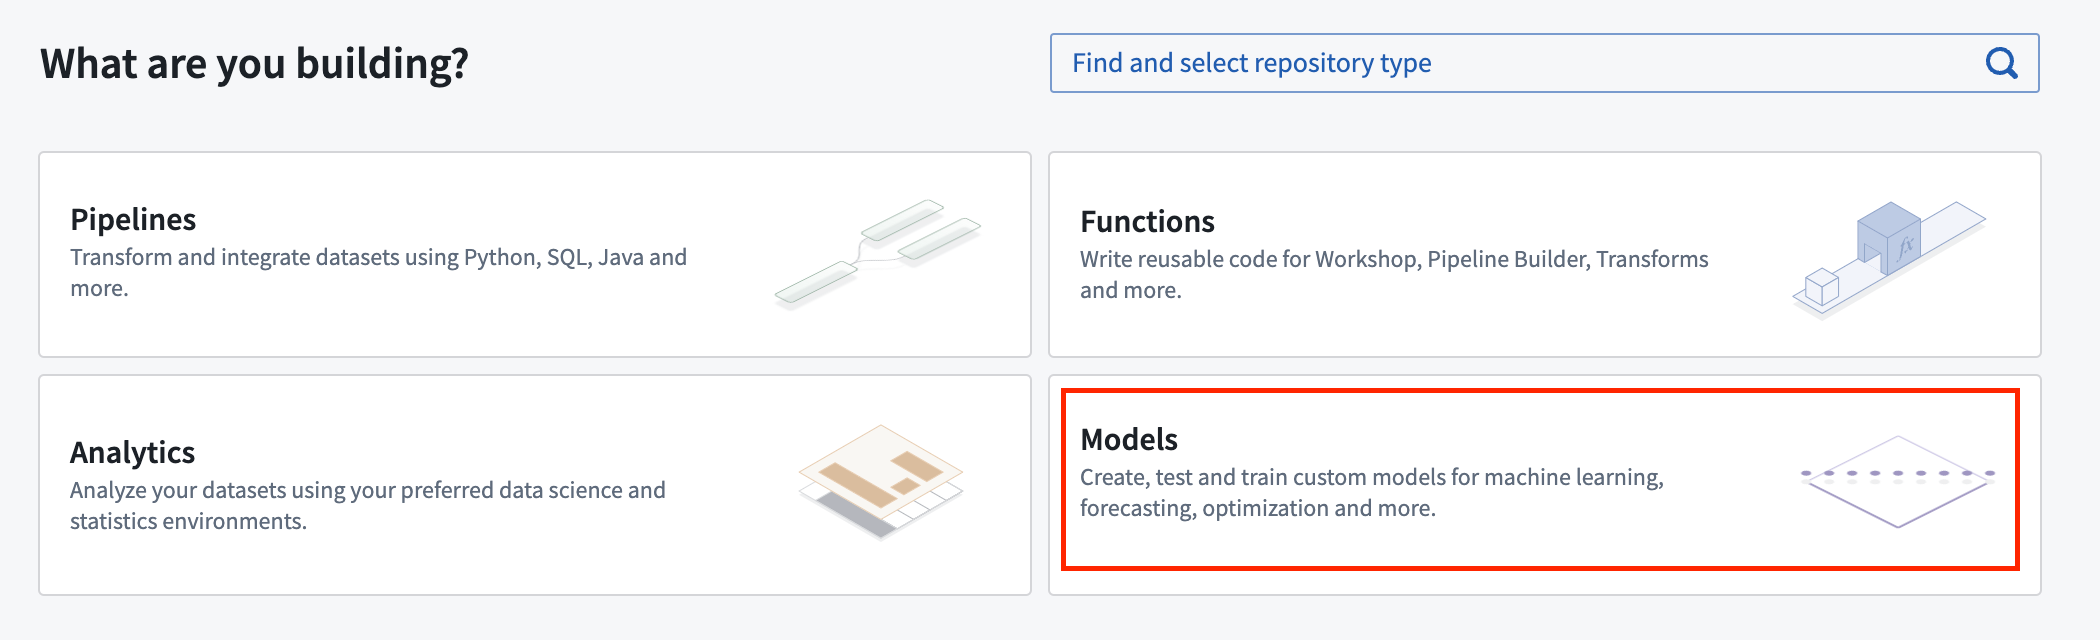
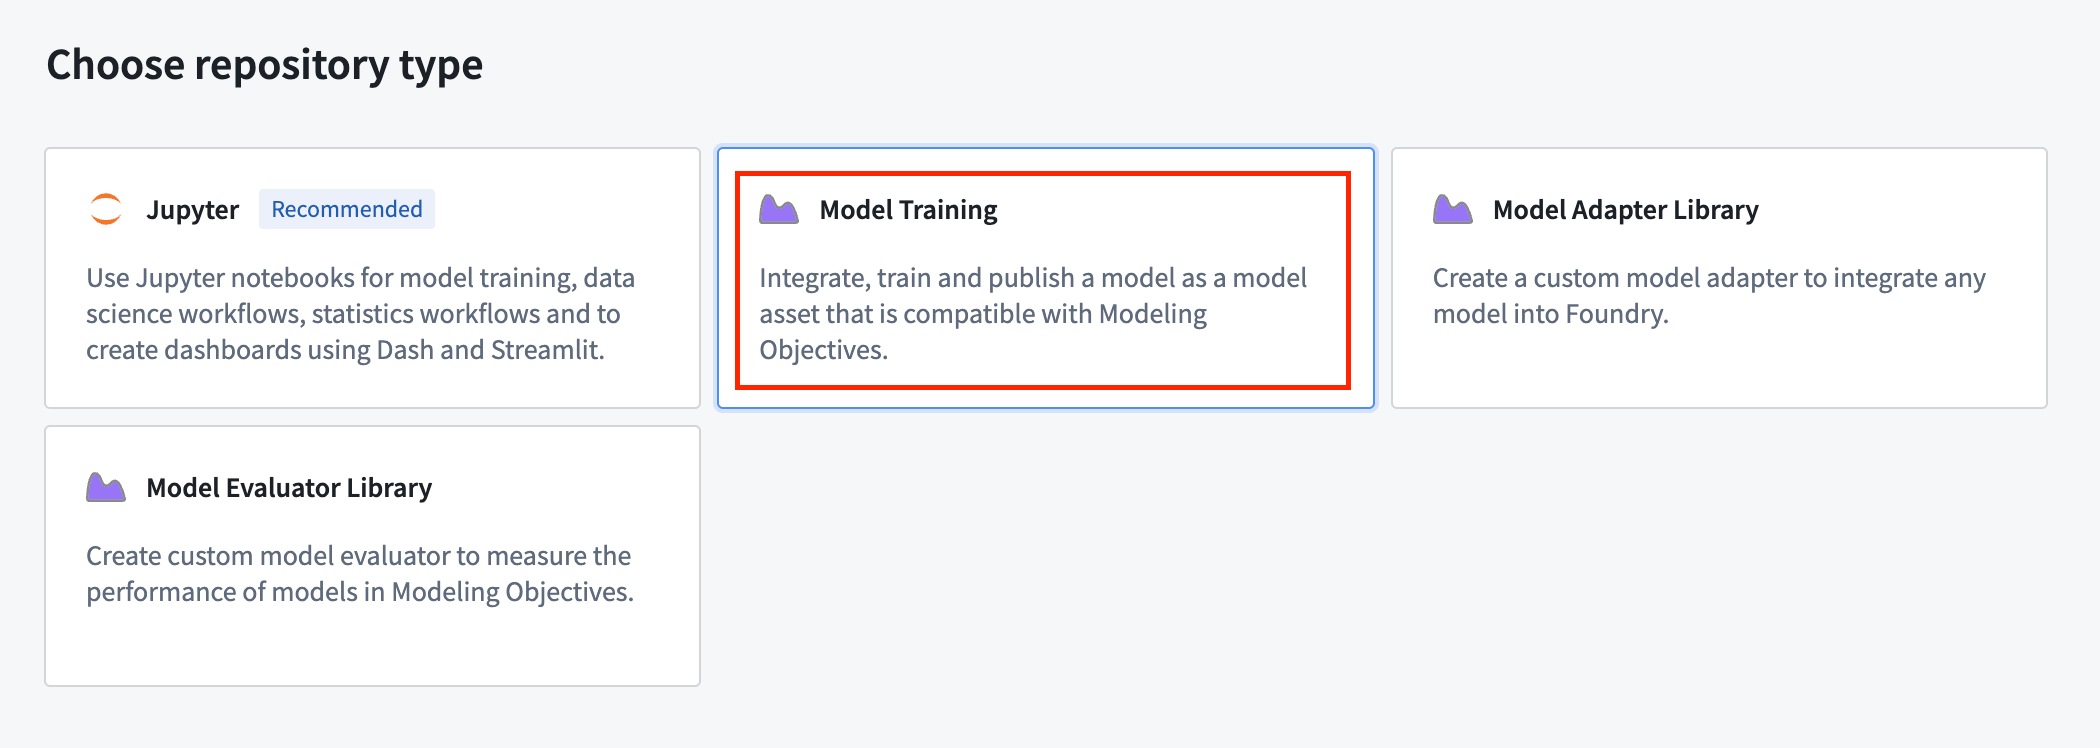
リポジトリタイプとしてモデル訓練を選択します。
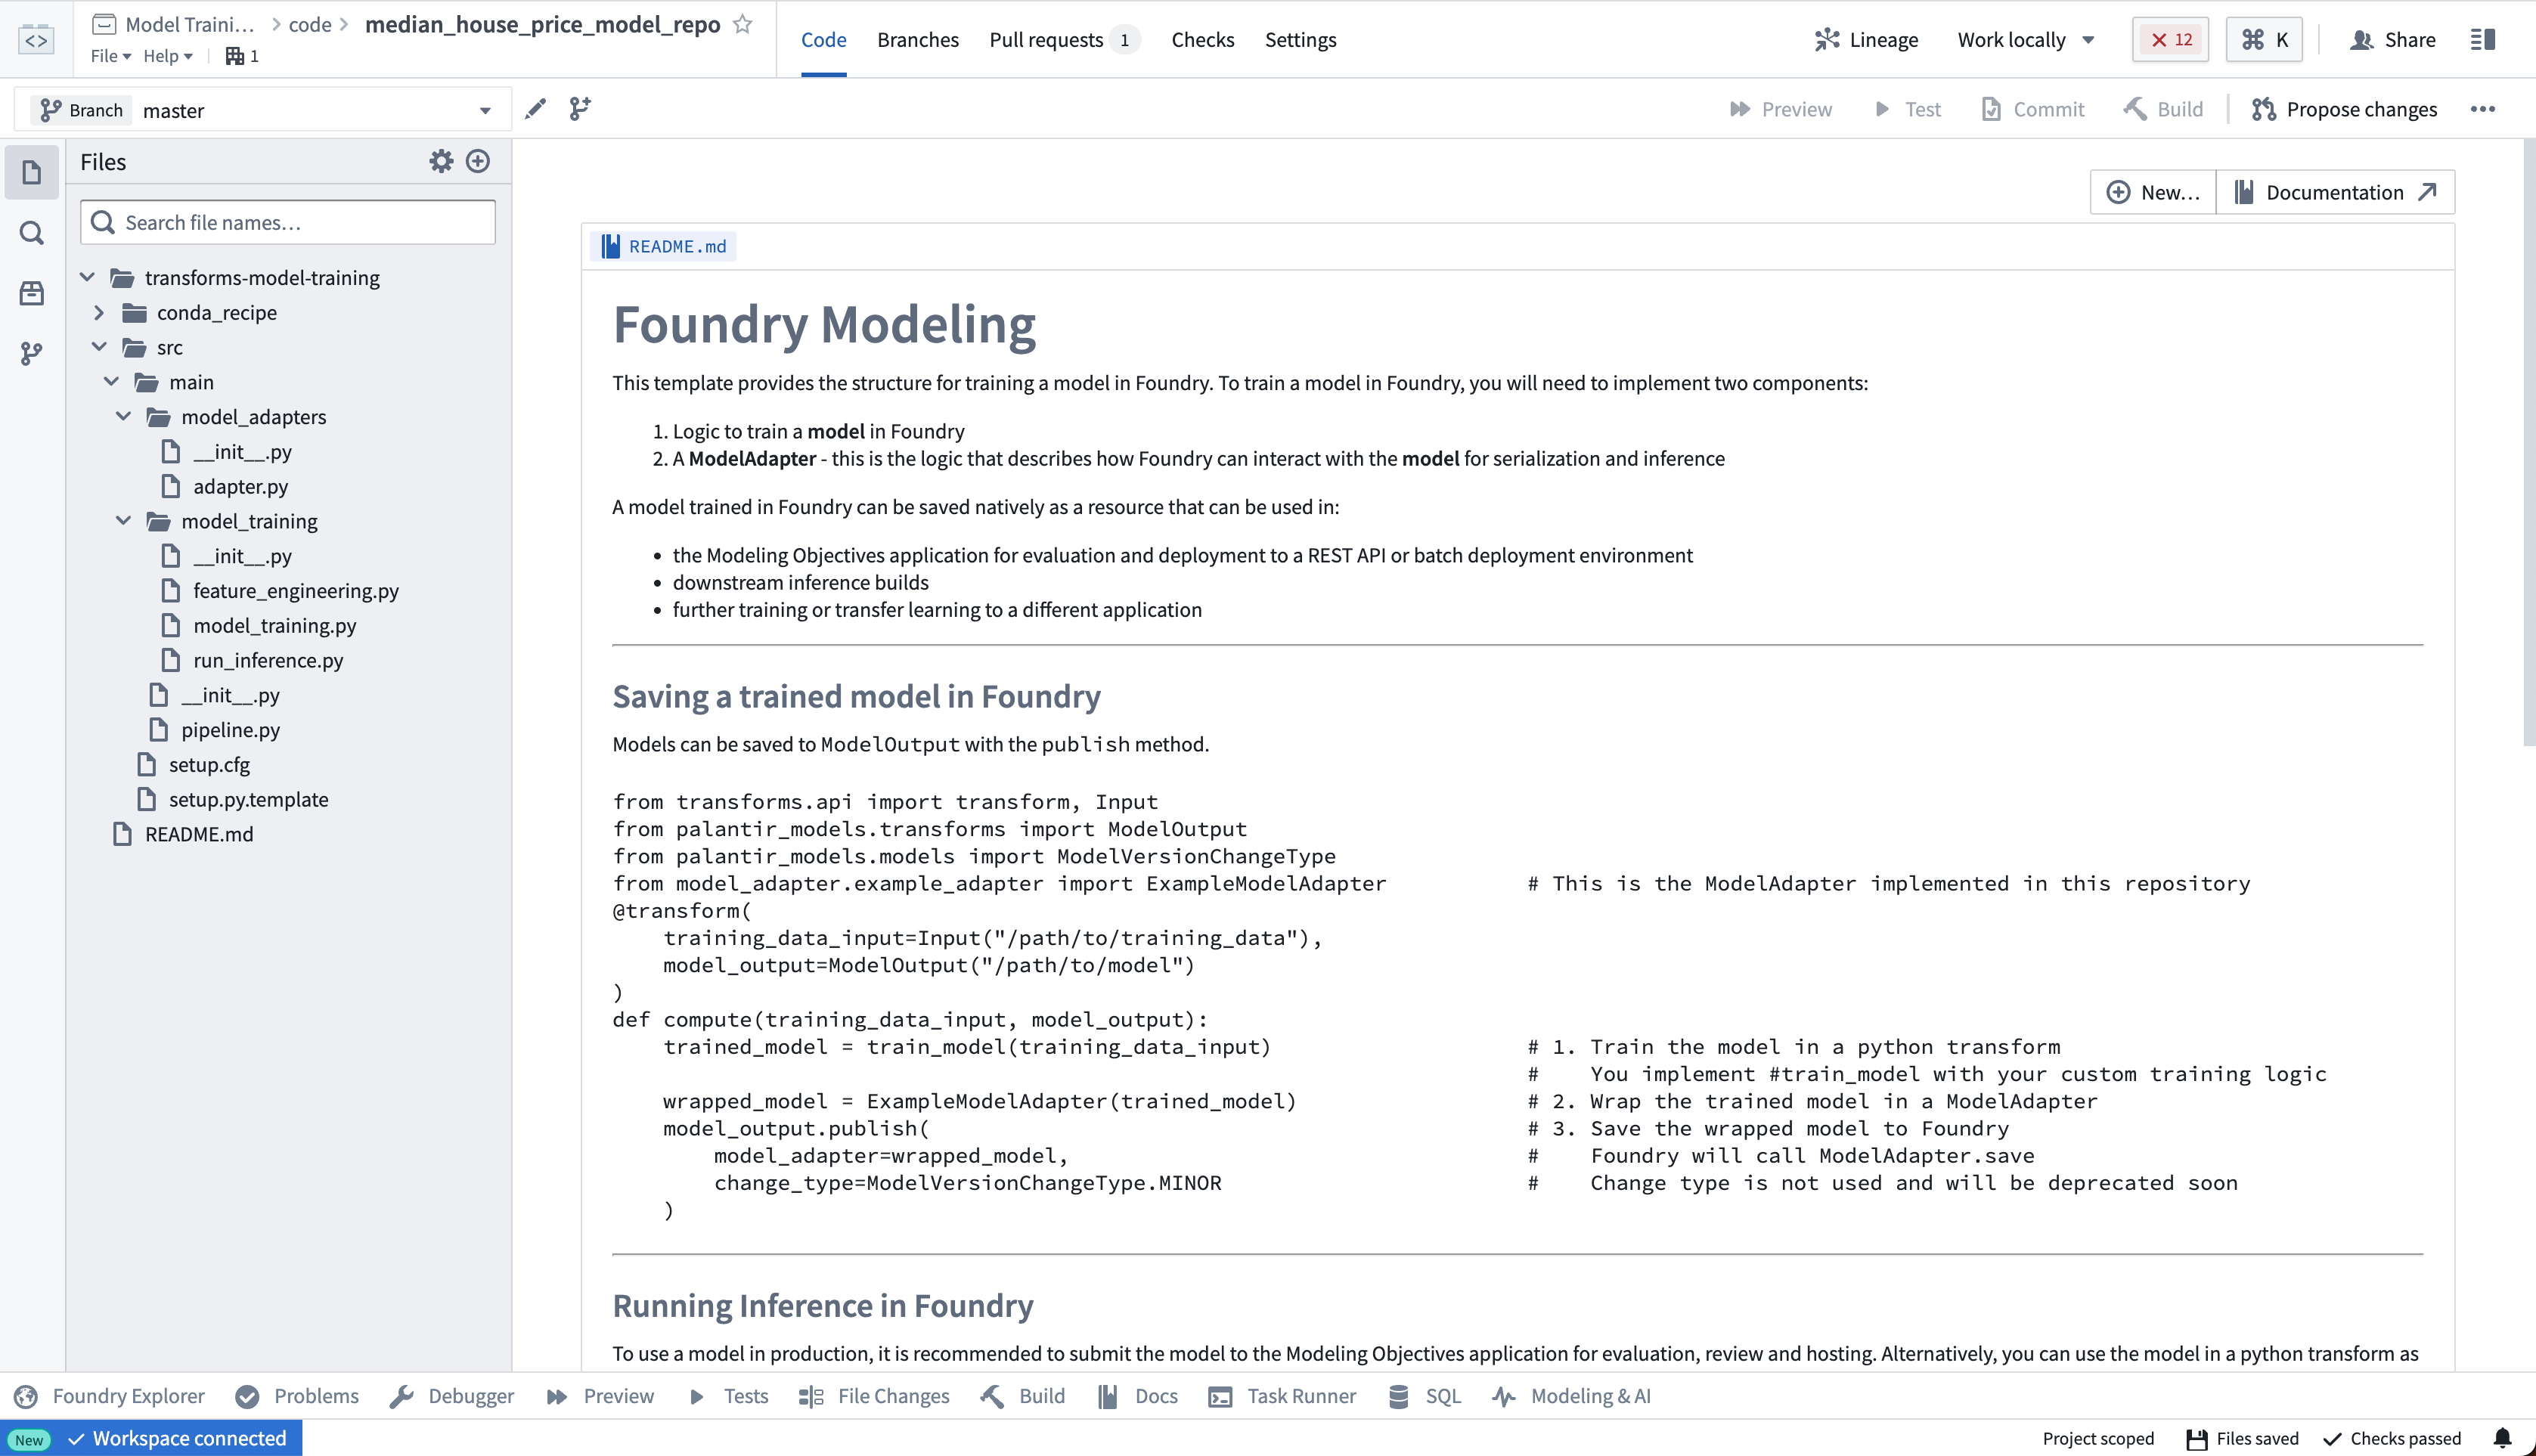
モデルトレーニングテンプレートには、このチュートリアルで調整して使用するサンプル構成が含まれています。左側のファイルを展開すると、サンプルプロジェクトを確認できます。
ステップ2:モデルアダプターを作成する
モデルアダプターは、Foundry のすべてのモデルに標準インターフェースを提供します。この標準インターフェースにより、すべてのモデルを本番アプリケーションですぐに使用できます。Palantir プラットフォームは、モデルとその Python 依存関係を読み込み、モデルと通信し、その API を公開するためのインフラストラクチャを処理します。
これを実現するには、この通信レイヤーとして機能する ModelAdapter クラスのインスタンスを作成する必要があります。
実装する関数は3個あります。
- モデルの保存と読み込み: モデルを再利用するには、モデルの保存方法と読み込み方法を定義する必要があります。Palantir はシリアル化(保存)のデフォルトの方法を多数提供しており、より複雑な場合にはカスタムシリアル化のロジックを実装できます。
- API: モデルの API を定義し、モデルが必要とする入力データの種類を Palantir プラットフォームに伝えます。
- 予測: モデルにデータを渡すために Palantir プラットフォームから呼び出されます。ここで入力データをモデルに渡し、推論(予測)を生成できます。
model_adapters/adapter.py ファイルを開き、モデルアダプターを作成します。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25import palantir_models as pm from palantir_models.serializers import DillSerializer class SklearnRegressionAdapter(pm.ModelAdapter): @pm.auto_serialize( model=DillSerializer() ) def __init__(self, model): self.model = model @classmethod def api(cls): columns = [ ('median_income', float), ('housing_median_age', float), ('total_rooms', float) ] return {'df_in': pm.Pandas(columns=columns)}, \ {'df_out': pm.Pandas(columns=columns + [('prediction', float)])} def predict(self, df_in): df_in['prediction'] = self.model.predict(df_in[['median_income', 'housing_median_age', 'total_rooms']]) return df_in
モデルアダプターのロジックの詳細については、モデルアダプターを作成するを参照してください。
ステップ3:モデルのトレーニングロジックを記述する
以下の例では、train_model 関数に foundry_ml のトレーニングロジックの例が変更されずに含まれています。compute 関数はモデルをモデルアダプターでラップし、モデルを公開します。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49from transforms.api import transform, Input, lightweight from palantir_models.transforms import ModelOutput from main.model_adapters.adapter import SklearnRegressionAdapter from sklearn.linear_model import LinearRegression from sklearn.pipeline import Pipeline from sklearn.preprocessing import StandardScaler def train_model(training_df): """トレーニングロジックは元の foundry_ml の例から変更されていません。""" numeric_features = ['median_income', 'housing_median_age', 'total_rooms'] pipeline = Pipeline([ ("scaler", StandardScaler()), ("regressor", LinearRegression())] ) X_train = training_df[numeric_features] y_train = training_df['median_house_value'] pipeline.fit(X_train, y_train) return pipeline # モデルが Spark 入力をネイティブにサポートしている場合を除き、lightweight デコレーターを使用します # (つまり、Spark ML を使用している場合を除きます)。このデコレーターを使用しないと、入力データはまず Spark に読み込まれ、 # モデルで使用するために Pandas への変換が必要になります。この処理は低速で、 # 大量のメモリーを消費します。 # Lightweight には foundry-transforms-lib-python パッケージが必要で、 # リポジトリが最新の状態である必要があります。 # https://palantir.com/docs/foundry/code-repositories/repository-upgrades @lightweight() @transform( training_data_input=Input("<YOUR_PROJECT_PATH>/data/housing_train_data"), model_output=ModelOutput("<YOUR_PROJECT_PATH>/models/linear_regression_model"), ) def compute(training_data_input, model_output): training_df = training_data_input.pandas() # モデルをトレーニングします model = train_model(training_df) # モデルをモデルアダプターでラップします foundry_model = SklearnRegressionAdapter(model) # モデルを公開します model_output.publish(model_adapter=foundry_model)
リポジトリ内の model_training/model_training.py ファイルを開き、モデル用の compute 関数を作成します。モデルの機械学習ロジックを train_model 関数にコピーします。トレーニングデータセットとモデルを正しく指すようにパスを更新します。右上の Build を選択してコードを実行します。
ステップ4:モデルの推論ロジックを記述する
リポジトリ内の model_training/run_inference.py ファイルを開き、モデルの推論ロジックを作成します。モデルとテストデータセットを正しく指すようにパスを更新します。右上の Build を選択してコードを実行します。
モデルが定義されていないトランスフォームリポジトリ内でそのモデルを実行するには、ModelInput で use_sidecar = True を設定します。これにより、モデルアダプターとその依存関係が自動的にインポートされ、依存関係の競合を防ぐために別の環境で実行されます。この機能は、palantir_models バージョン 0.2010.0以降で、非 Spark トランスフォーム(@lightweight または @transform.using デコレーターを使用するもの)に対して利用可能です。詳細については、ModelInput クラスのリファレンスを確認してください。
use_sidecar が True に設定されていない場合は、モデルアダプターとその依存関係を現在のコードリポジトリにインポートするか、そのリポジトリ内で定義する必要があります。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16from transforms.api import transform, Input, Output, lightweight from palantir_models.transforms import ModelInput # Lightweight には foundry-transforms-lib-python パッケージが必要で、 # リポジトリが最新の状態である必要があります。 # https://palantir.com/docs/foundry/code-repositories/repository-upgrades @lightweight() @transform( testing_data_input=Input("<YOUR_PROJECT_PATH>/data/housing_test_data"), model_input=ModelInput("<YOUR_PROJECT_PATH>/models/linear_regression_model_asset"), predictions_output=Output("<YOUR_PROJECT_PATH>/data/housing_testing_data_inferences") ) def compute(testing_data_input, model_input, predictions_output): inference_outputs = model_input.transform(testing_data_input) predictions_output.write_pandas(inference_outputs.df_out)
上記の手順に沿って進めると、Code Repositories 内の既存の foundry_ml モデルを palantir_models に移行できます。
MetricSets を使用するモデルを移行する
可能な場合は、MetricSets を実験に置き換えることを推奨します。ただし、実験は現在画像メトリクスをサポートしていますが、MetricSets とは異なり、チャートメトリクスはまだサポートしていない点に注意してください。palantir_models でビルドしたモデルのモデルページには MetricSets が表示されませんが、モデルに対して MetricSets を書き込み、Modeling Objectives でメトリクスを表示することは引き続き可能です。
これを行うには、Code Repositories でモデルを作成し、環境に foundry_ml_metrics ライブラリを追加します。以下は、MetricSet を palantir_models と併用する方法の例です。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26import uuid from transforms.api import transform, Input, Output from palantir_models.transforms import ModelInput from foundry_ml_metrics import MetricSet # 環境に foundry_ml_metrics を追加します @transform( evaluation_data_input=Input("path_to_input"), model_input=ModelInput("path_to_model"), metric_set_output=Output("path_to_output"), ) def compute(training_data_input, model_input, metric_set_output): metric_set = MetricSet( # モデルのバージョン識別子の「hash」部分を渡します。たとえば、次の場合は、 # ri.models.main.model-version.6c0f17a8-ad73-46a4-b86e-8d0a13327ef2, # 6c0f17a8-ad73-46a4-b86e-8d0a13327ef2 のみを渡します。 model=uuid.UUID( # ModelInput クラスの model_version_rid プロパティは、 # palantir_models のバージョンが 0.1602.0 以上の場合にのみ利用可能です。 model_input.model_version_rid.replace("ri.models.main.model-version.", "") ), input_data=evaluation_data_input ) metric_set.add(name='Accuracy', value=0.8) metric_set.add(name='F1', value=0.95) metric_set.save(metric_set_output)
次に、Modeling Objectives の評価設定で、evaluation_data_input データセットを評価用データセットとして設定します。すると、Modeling Objectives の評価表示で、そのデータセットの下にメトリクスが表示されます。