注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
トランスフォームでの ModelInput
ModelInput クラスを使用すると、Python トランスフォーム内でモデルを読み込んで使用でき、データパイプラインにモデル推論ロジックを簡単に組み込めます。コードワークスペースでのモデルの使用については、Jupyter® Code Workspaces の ModelInput クラスの詳細を参照してください。
クラス定義
Copied!1 2 3 4 5 6 7 8from palantir_models.transforms import ModelInput ModelInput( alias, # (文字列)読み込むモデルのパスまたは RID model_version=None, # (任意)特定のモデルバージョンの RID use_sidecar=False, # (任意)別のコンテナでモデルを実行します sidecar_resources=None # (任意)サイドカーのリソース設定 )
パラメーター
| パラメーター | データ型 | 説明 | バージョン / 注記 | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
alias | str | 読み込み元のモデルリソースのパスまたはリソース ID (RID)。 | |||||||||||||
model_version | Optional[str] | 使用する特定のモデルバージョンの RID またはセマンティックバージョン。値を指定しない場合は、最新バージョンが使用されます。 | |||||||||||||
use_sidecar | Optional[bool] | True の場合、モデルアダプターとトランスフォーム環境の間で依存関係の競合が発生しないように、別のコンテナでモデルを実行します。 | palantir_models バージョン 0.1673.0 で導入 | ||||||||||||
sidecar_resources | Optional[Dict[str, Union[float, int]]] | サイドカーコンテナのリソース設定。このパラメーターは、use_sidecar が True に設定されている場合にのみ使用できます。次のオプションをサポートします。
| palantir_models バージョン 0.1673.0 で導入 |
例
以下のコードスニペットは、トランスフォームでのモデルの使用方法を示しています。これらの例では、モデルのアダプターの API に、1個の Pandas 入力と、output_df という名前の1個の Pandas 出力 DataFrame が指定されていることを前提としています。モデルアダプターの transform メソッドは、指定された predict メソッドを利用し、TransformInput/LightweightInput インスタンスである data_in を、モデルアダプターの API が期待するテーブル形式の入力(Spark または Pandas の DataFrame)に自動的に変換します。
軽量トランスフォームでのモデル推論(推奨)
Spark での分散推論を必要としないユースケースでは、軽量トランスフォーム(@transform.using のデフォルト)を使用し、モデルをサイドカーコンテナとして実行することを推奨します。モデルのサイドカーについて、詳しくはこちら(下記)。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23from transforms.api import Input, Output, transform, LightweightInput, LightweightOutput from palantir_models import ModelAdapter from palantir_models.transforms import ModelInput # @transform.using で use_sidecar=True を使用するには、palantir_models バージョン 0.2010.0 以降が必要です。 @transform.using( data_in=Input("path/to/input"), model_input=ModelInput( "path/to/my/model", use_sidecar=True # モデルをサイドカーコンテナとして実行します ), out=Output('path/to/output'), ) def my_transform(data_in: LightweightInput, model_input: ModelAdapter, out: LightweightOutput) -> None: # モデルの API には1個の Pandas 入力と、 # `df_out` という名前の1個の pandas 出力があると仮定します。 inference_results = model_input.transform(data_in) predictions = inference_results.df_out # または、predict メソッドを # Pandas DataFrame インスタンスに対して直接使用することもできます。 # predictions = model_input.predict(data_in.pandas()) out.write_pandas(predictions)
Spark トランスフォームでの分散推論
DistributedInferenceWrapper を使用すると、モデルが Spark ジョブの各エグゼキューターに分散されます。Spark での分散推論について、詳しくはこちら(下記)。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15from transforms.api import transform, Input, Output, configure from palantir_models.transforms import ModelInput, DistributedInferenceWrapper @transform.spark.using( input_df=Input("ri.foundry.main.dataset.3cd098b3-aae0-455a-9383-4eec810e0ac0"), model_input=ModelInput("ri.models.main.model.5b758039-370c-4cfc-835e-5bd3f213454c"), output=Output("ri.foundry.main.dataset.c0a3edbc-c917-4f20-88f1-d797ebf27cb2"), ) def compute(ctx, input_df, model_input, output): model_input = DistributedInferenceWrapper(model_input, ctx, 'auto') # DistributedInferenceWrapper で .predict を使用し、Spark DataFrame を渡します # データを pandas としてモデルに渡す処理を行い、Spark DataFrame を返します predictions = model_input.predict(input_df.dataframe()) # 出力を Spark DataFrame として書き込みます output.write_dataframe(predictions)
使用上の注意
サイドカーコンテナを使用しない場合にアダプターコードをインポートする
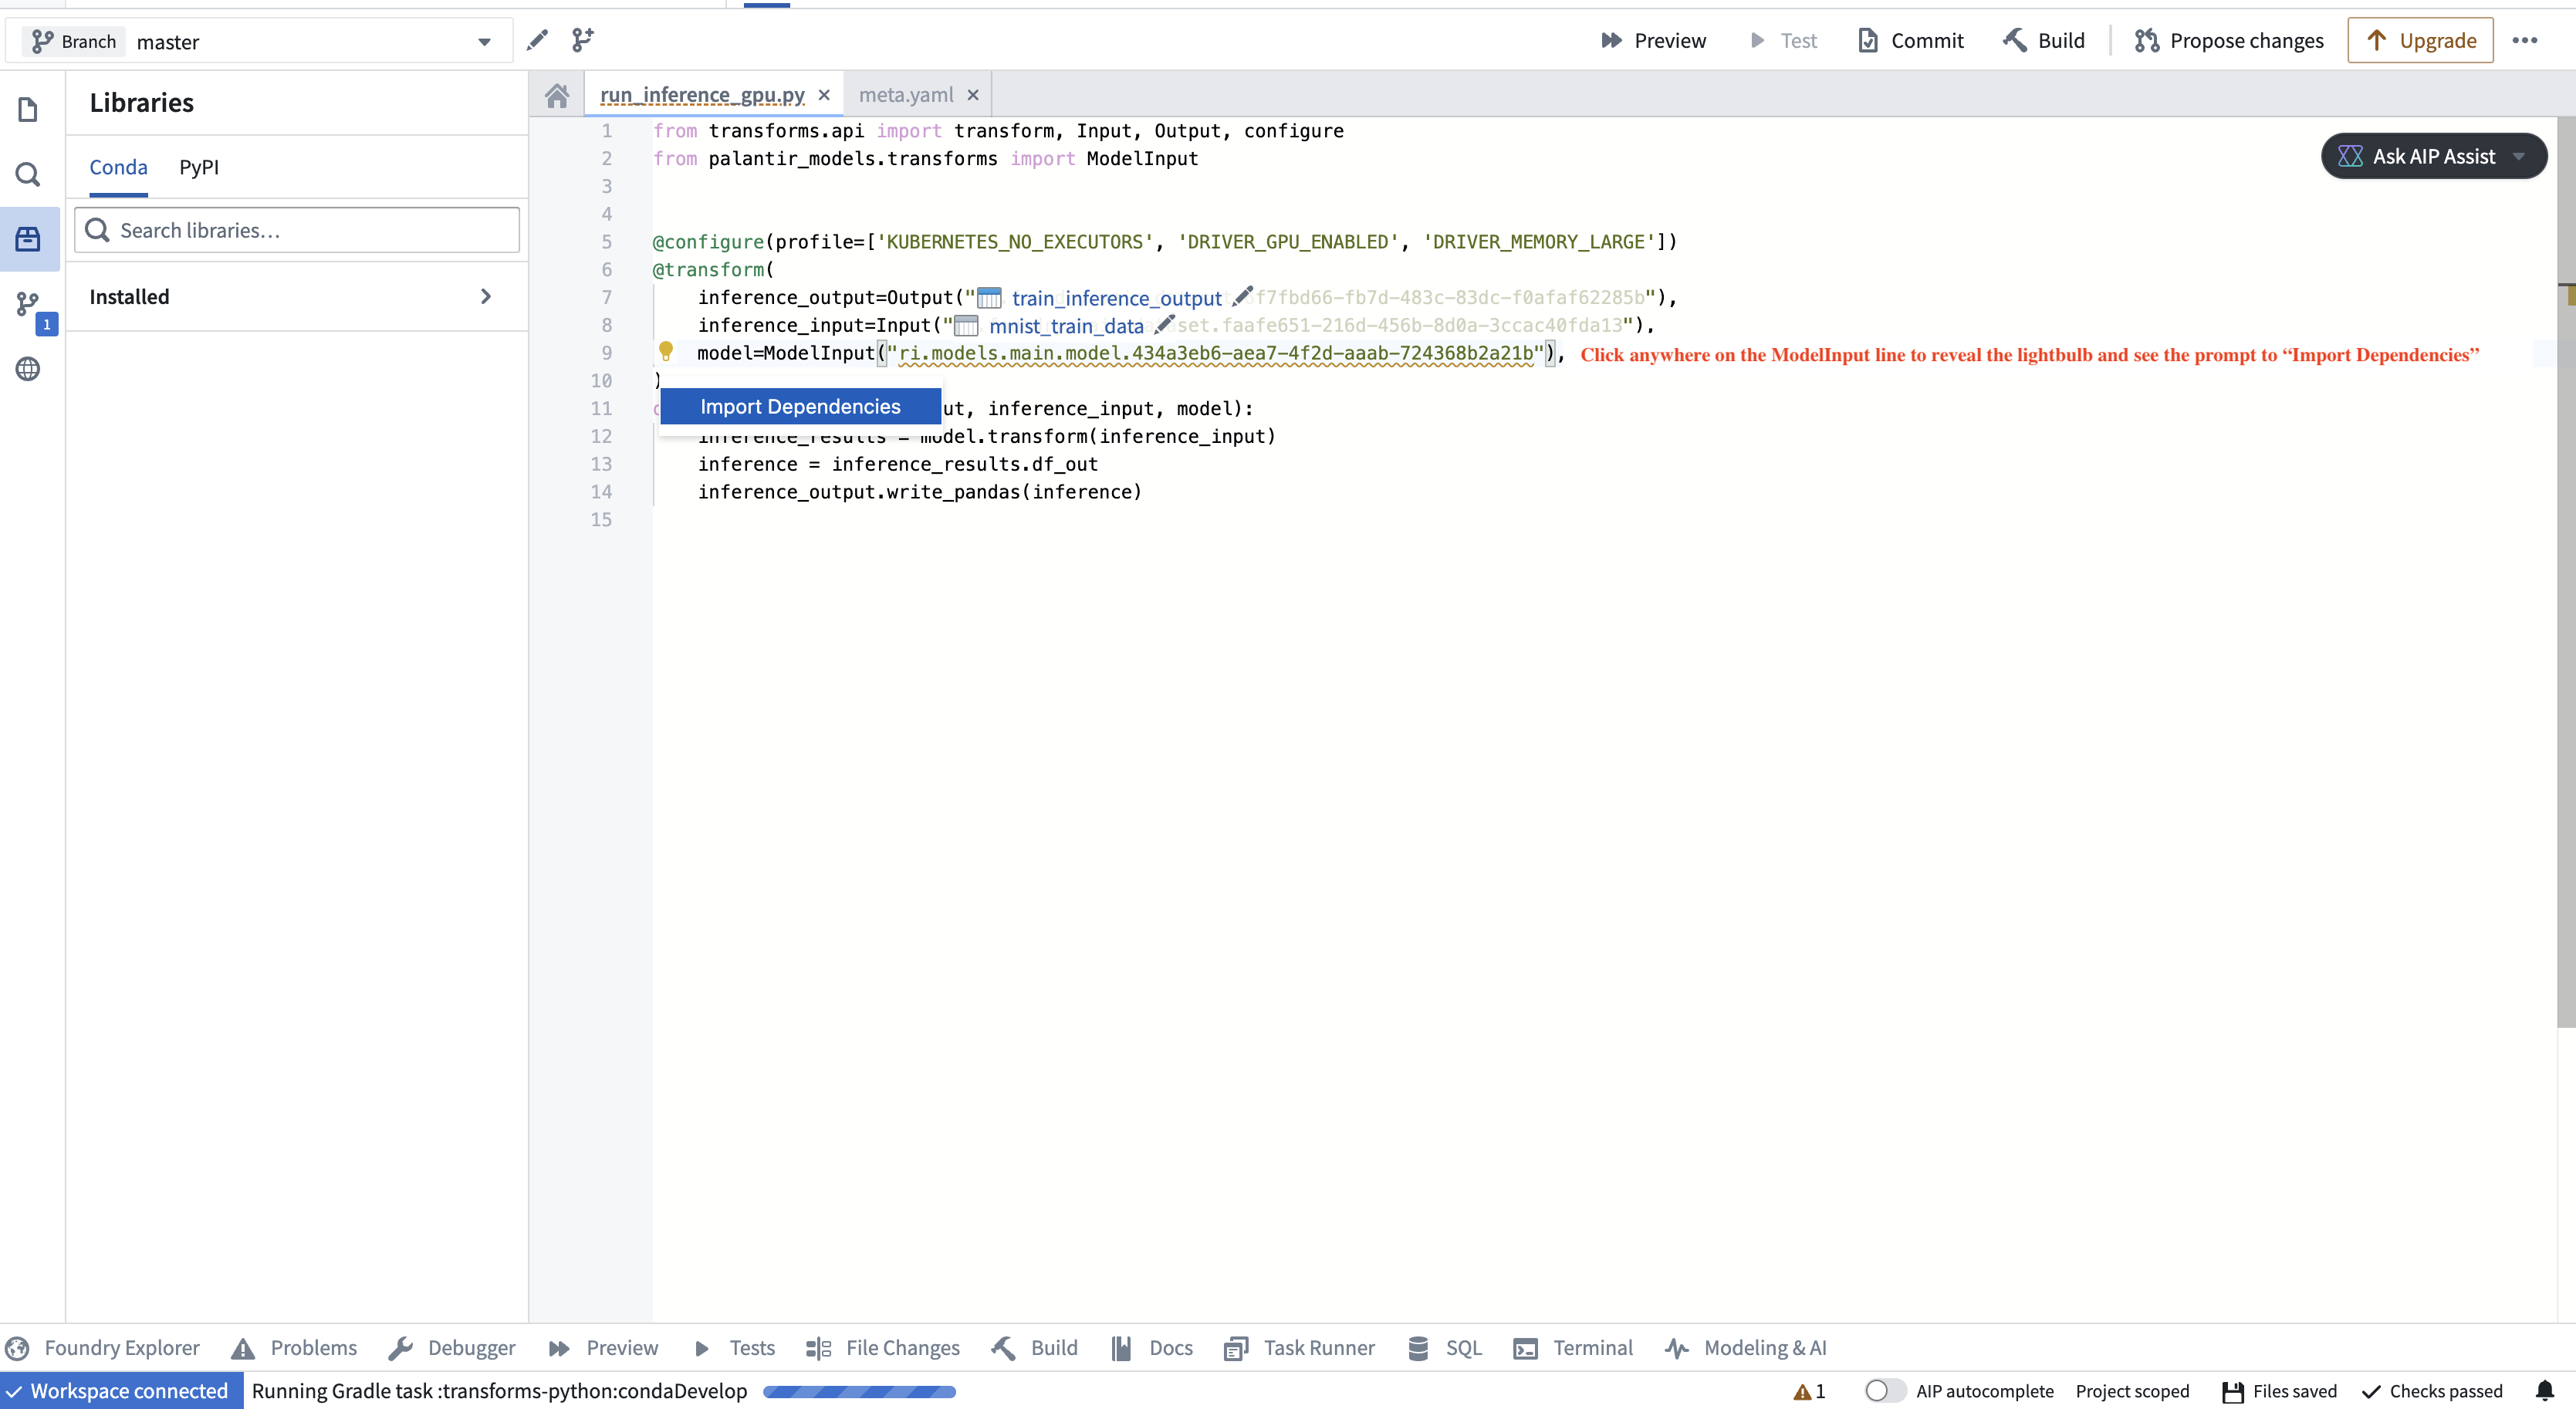
モデルアダプタークラスをインスタンス化するには、環境からモデルアダプターコードにアクセスできる必要があります。特に、モデルが別のリポジトリで作成された場合は、モデルとともに Python ライブラリとしてパッケージ化されたアダプターコードを、使用するリポジトリに依存関係としてインポートする必要があります。以下のスクリーンショットに示すように、アプリケーションにインポートを促すプロンプトが表示されます。
バージョンを指定する
model_version パラメーターを使用して、特定のモデルバージョンを指定できます。意図しないモデルや問題のあるモデルが本番環境に導入されるのを防ぐのに役立つため、モデルが定期的に再トレーニングされない場合は特に推奨します。モデルバージョンを指定しない場合、デフォルトではビルドのブランチで利用可能な最新のモデルが使用されます。
バージョンを指定しない場合、トランスフォームを実行するたびに、モデル入力の最新のモデルファイルが自動的に取得されます。ただし、モデルが使用先のリポジトリの外部で生成された場合、リポジトリ内のアダプターライブラリのバージョン(そのバージョン用に作成したアダプターロジックと、その Python の依存関係を含む)は自動的に更新されません。ライブラリのバージョンを更新するには、リポジトリのライブラリサイドバーで適切なアダプターバージョンを選択し、すべてのチェックに合格することを確認する必要があります。各モデルバージョンに対応するアダプターバージョンは、モデルのページの推論設定で確認できます。
このワークフローがニーズに合わない場合は、モデルを作成したリポジトリ内でそのモデルを使用するか、以下で説明するように use_sidecar を True に設定することを検討してください。
モデルをサイドカーコンテナとして実行する
モデル推論のほとんどのユースケースでは、モデルをサイドカーコンテナで実行すること(use_sidecar=True)を推奨します。
モデルをサイドカーとして実行する主な利点は、モデルの生成に使用したものと完全に同じバージョンのライブラリが、そのモデルでの推論にも使用されることです。一方、リポジトリのユーザーインターフェースのプロンプトに従ってアダプターコードをインポートすると、アダプターコードとリポジトリの制約を統合した新しい環境の依存関係解決が行われます。その結果、異なるバージョンのライブラリが使用される場合があります。
また、サイドカーコンテナを使用してモデルを実行すると、使用するモデルバージョンに対応するアダプターコードがサイドカーに自動的に読み込まれるため、ユーザーがリポジトリ内で依存関係を手動で更新し、チェックを実行する必要はありません。
サイドカーを使用する場合、コードを追加で変更することなく、predict() リクエストがサイドカーコンテナに自動的にルーティングされます。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23from transforms.api import Input, Output, transform, LightweightInput, LightweightOutput from palantir_models import ModelAdapter from palantir_models.transforms import ModelInput # @transform.using で use_sidecar=True を使用するには、palantir_models バージョン 0.2010.0 以降が必要です。 @transform.using( data_in=Input("path/to/input"), model_input=ModelInput( "path/to/my/model", use_sidecar=True ), out=Output('path/to/output'), ) def my_transform(data_in: LightweightInput, model_input: ModelAdapter, out: LightweightOutput) -> None: # モデルの API には1個の Pandas 入力と、 # `df_out` という名前の1個の pandas 出力があると仮定します。 inference_results = model_input.transform(data_in) predictions = inference_results.df_out # または、predict メソッドを # Pandas DataFrame インスタンスに対して直接使用することもできます。 # predictions = model_input.predict(data_in.pandas()) out.write_pandas(predictions)
サイドカーのリソースを指定する
以下の例では、ドライバーおよびエグゼキューターとともにサイドカーをプロビジョニングし、それぞれに1個の GPU、2個の CPU、4 GB のメモリーを割り当てます。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21from transforms.api import Input, Output, transform, LightweightInput, LightweightOutput from palantir_models import ModelAdapter from palantir_models.transforms import ModelInput # @transform.using で use_sidecar=True を使用するには、palantir_models バージョン 0.2010.0 以降が必要です。 @transform.using( data_in=Input("path/to/input"), model_input=ModelInput( "path/to/my/model", use_sidecar=True, sidecar_resources={ "cpus": 2.0, "memory_gb": 4.0, "gpus": 1 } ), out=Output('path/to/output'), ) def my_transform(data_in: LightweightInput, model_input: ModelAdapter, out: LightweightOutput) -> None: ...
Spark エグゼキューターを使用した分散推論
Spark エグゼキューターを使用して、分散モデル推論を実行できます。この方法は、計算負荷の高いモデルや大規模なデータセットを扱うバッチ推論に有効で、ほぼ線形のスケーラビリティを実現できます。
以下のコードスニペットは、既存のモデルを分散推論用にラップする方法を示しています。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15from transforms.api import transform, Input, Output, configure from palantir_models.transforms import ModelInput, DistributedInferenceWrapper @transform.spark.using( input_df=Input("ri.foundry.main.dataset.3cd098b3-aae0-455a-9383-4eec810e0ac0"), model_input=ModelInput("ri.models.main.model.5b758039-370c-4cfc-835e-5bd3f213454c"), output=Output("ri.foundry.main.dataset.c0a3edbc-c917-4f20-88f1-d797ebf27cb2"), ) def compute(ctx, input_df, model_input, output): model_input = DistributedInferenceWrapper(model_input, ctx, 'auto') # DistributedInferenceWrapper で .predict を使用し、Spark DataFrame を渡します # データを pandas としてモデルに渡す処理を行い、Spark DataFrame を返します predictions = model_input.predict(input_df.dataframe()) # 出力を Spark DataFrame として書き込みます output.write_dataframe(predictions)
予測の生成に複数の入力行が必要なモデルには、DistributedInferenceWrapper を使用しないでください。このようなモデルの例として、推論に履歴データを必要とする時系列モデルがあります。DistributedInferenceWrapper は、Spark 標準のパーティション分割を使用して各エグゼキューターに行のサブセットを送信するため、予測に必要なすべての行(たとえば、特定の時系列のすべての行)が同じパーティションの一部としてモデルに送信される保証はありません。これにより、複数の行を受け取るモデルでは入力データが不完全になり、誤った予測につながる可能性があります。
DistributedInferenceWrapper クラスは、以下のパラメーターで初期化されます。
| パラメーター | データ型 | 説明 | 注記 |
|---|---|---|---|
model | ModelAdapter | ラップするモデルアダプターのインスタンス。通常は、ModelInput から提供される model_input です。 | |
ctx | TransformContext | Spark セッション情報へのアクセスに使用するトランスフォームのコンテキスト。通常は、トランスフォーム関数の ctx 引数です。 | |
num_partitions | Union[Literal["auto"], int] | Spark DataFrame に使用するパーティション数。'auto' の場合、Spark エグゼキューター数に合わせて設定されます。メモリー不足 (OOM) エラーが発生する場合は、この値を増やしてみてください。 | デフォルト:'auto' |
max_rows_per_chunk | int | Spark は、モデルに送信する前に各パーティションをチャンクに分割します。このパラメーターは、チャンクごとに許容される最大行数を設定します。チャンクあたりの行数を増やすと、オーバーヘッドは減りますが、メモリー使用量は増えます。 | デフォルト:1,000,000 |
使用上の注意:
- Spark プロファイルでエグゼキューター数を設定できます。
- 分散ラッパーは Spark のユーザー定義関数 (UDF) を使用します。
- 渡す DataFrame は Spark DataFrame である必要があります。ラップされた predict 呼び出しも Spark DataFrame を返します。
- モデルアダプターの API には、1個の pandas DataFrame 入力と1個の pandas DataFrame 出力が必要で、入力パラメーターの数は任意です。
use_sidecarパラメーター(上記で説明)の使用はサポートされていますが、任意です。