注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
モデルを自動的に評価する
モデリングプロジェクトが成熟し、規模が拡大して運用段階に入るにつれて、現在および新しいモデルの登録を体系的に評価、比較することが重要になります。モデルの登録は、適切に維持管理された代表的なデータを使用し、明確に定義されたメトリクスに照らして一貫した方法で評価する必要があります。
モデリング目標を設定すると、その目標に登録されたすべてのモデルの推論パイプラインとメトリクスパイプラインを自動的に生成し、体系的なテストおよび評価(T&E)計画をソフトウェアで実装できます。
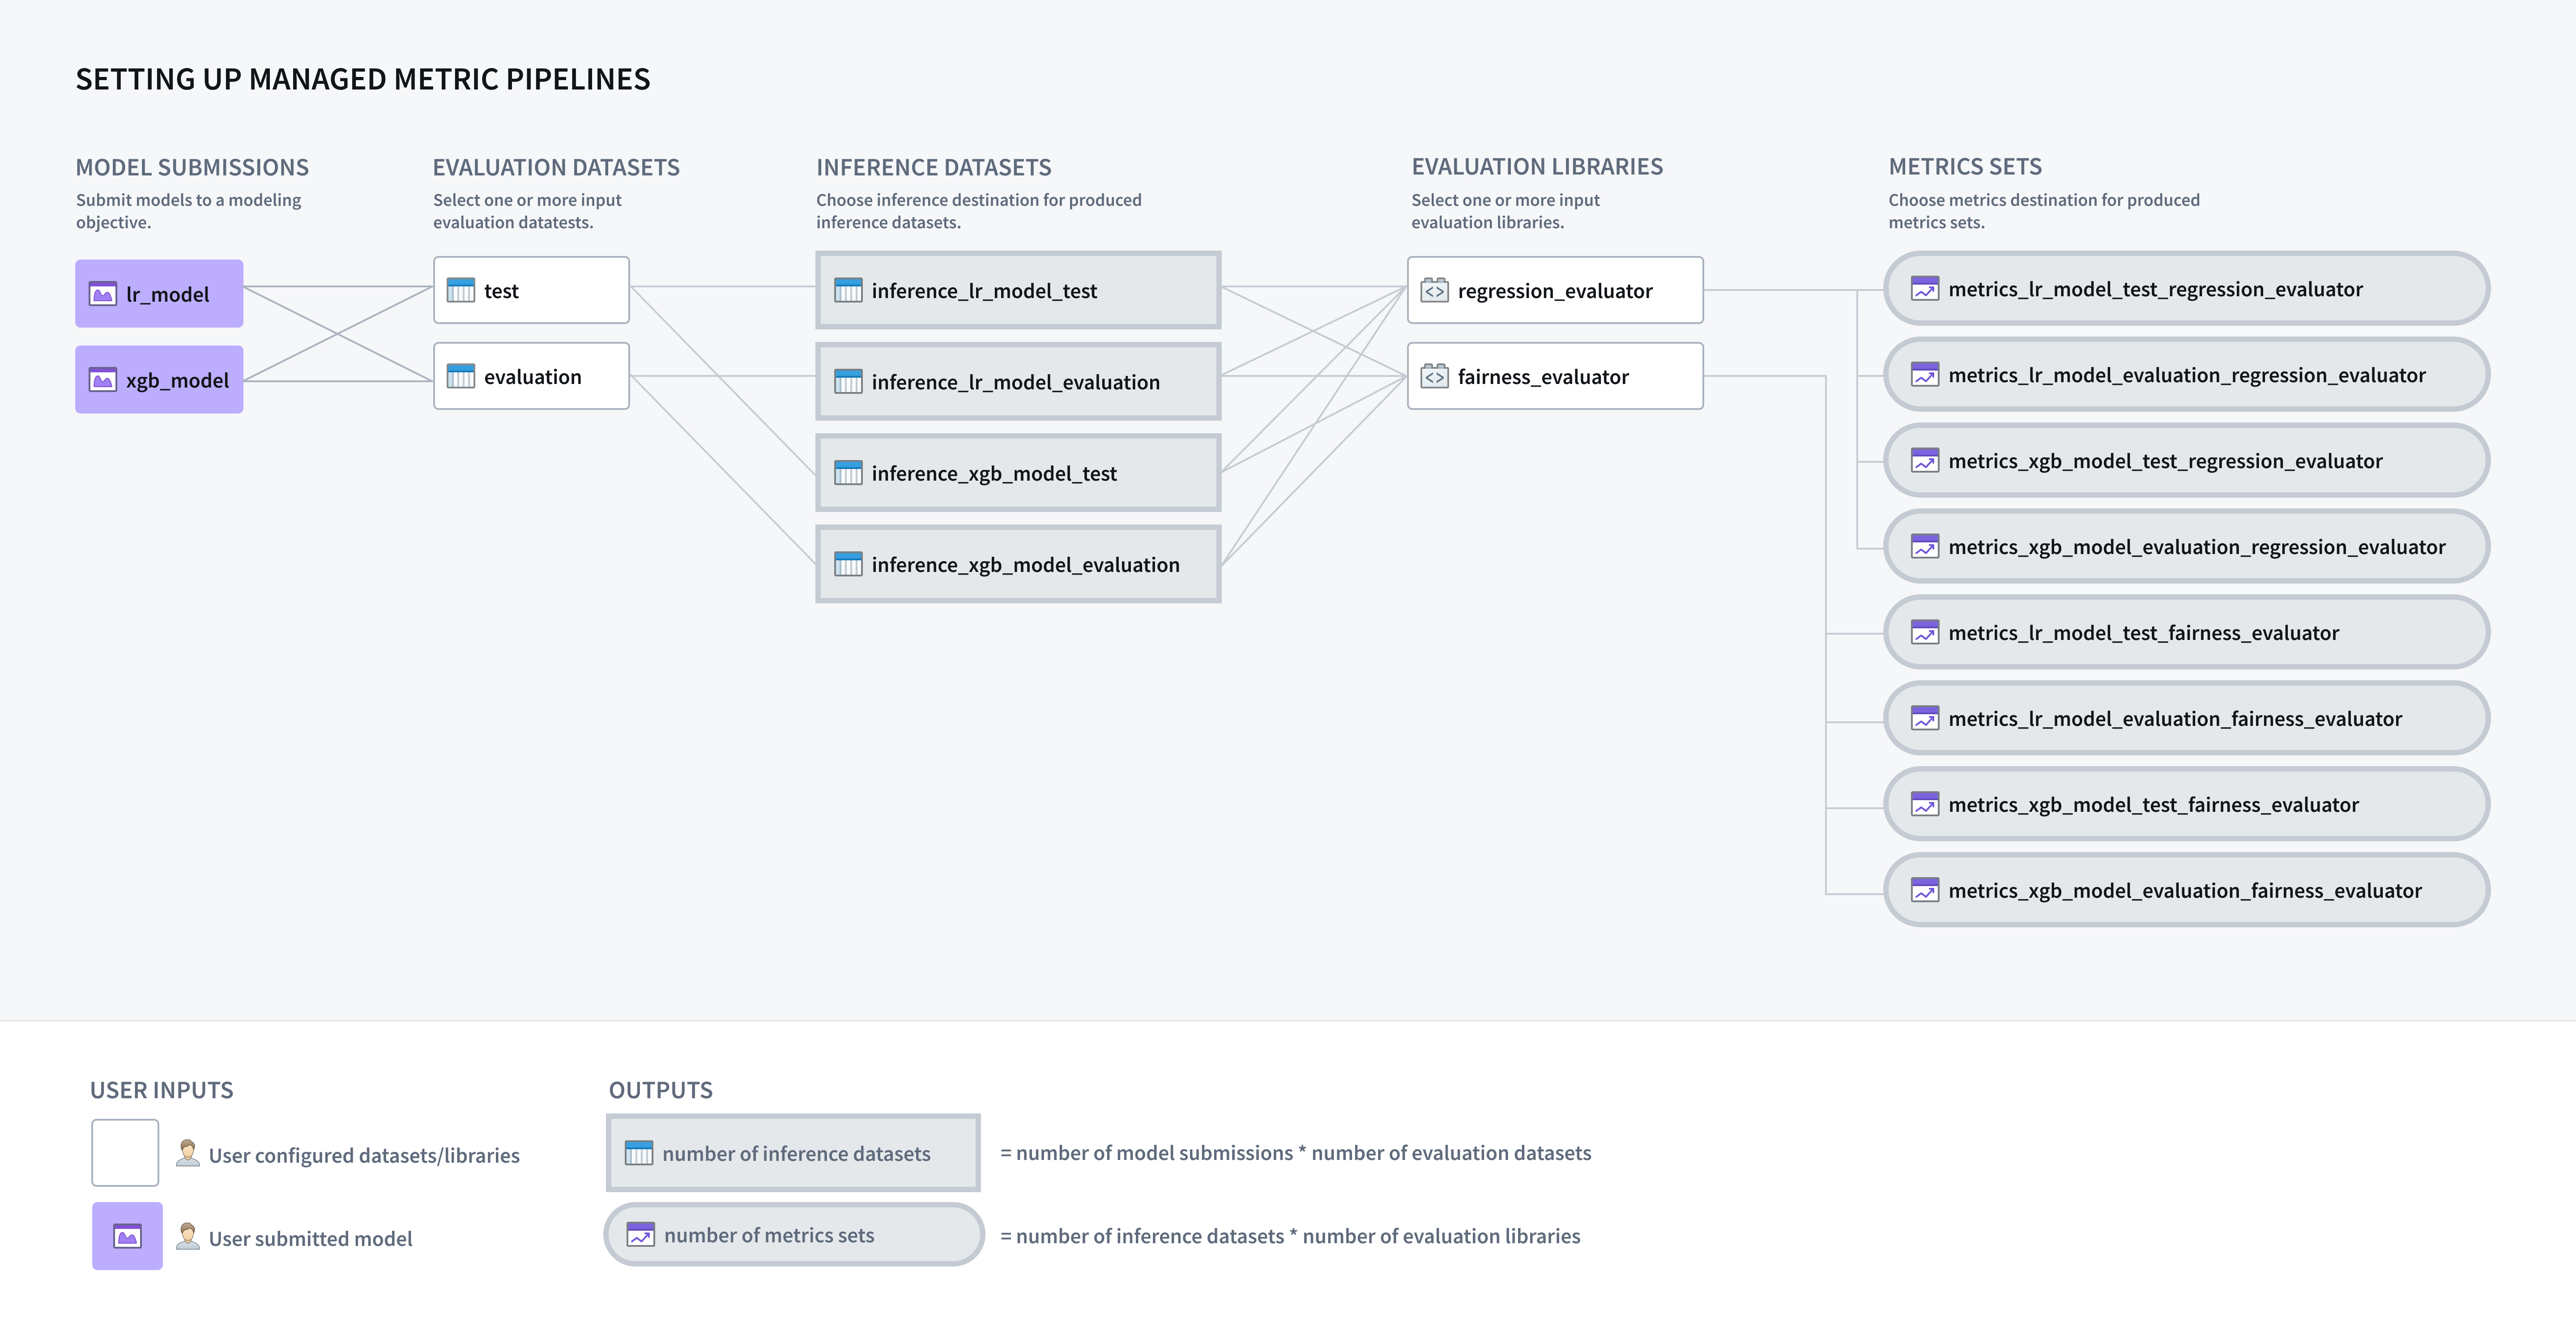
モデル評価を設定する
モデルの自動評価を有効にするには、まずモデリング目標に登録されたモデルをどのように評価するかを、そのモデリング目標で設定する必要があります。
パイプライン管理を有効にする
モデリング目標でモデルの自動評価を設定する最初のステップは、推論とメトリクスの生成を有効にすることです。Modeling Objectives のホームページから評価ダッシュボードの設定を選択します。モデル評価をすでに設定している場合は、評価ダッシュボードから評価設定を編集を選択します。
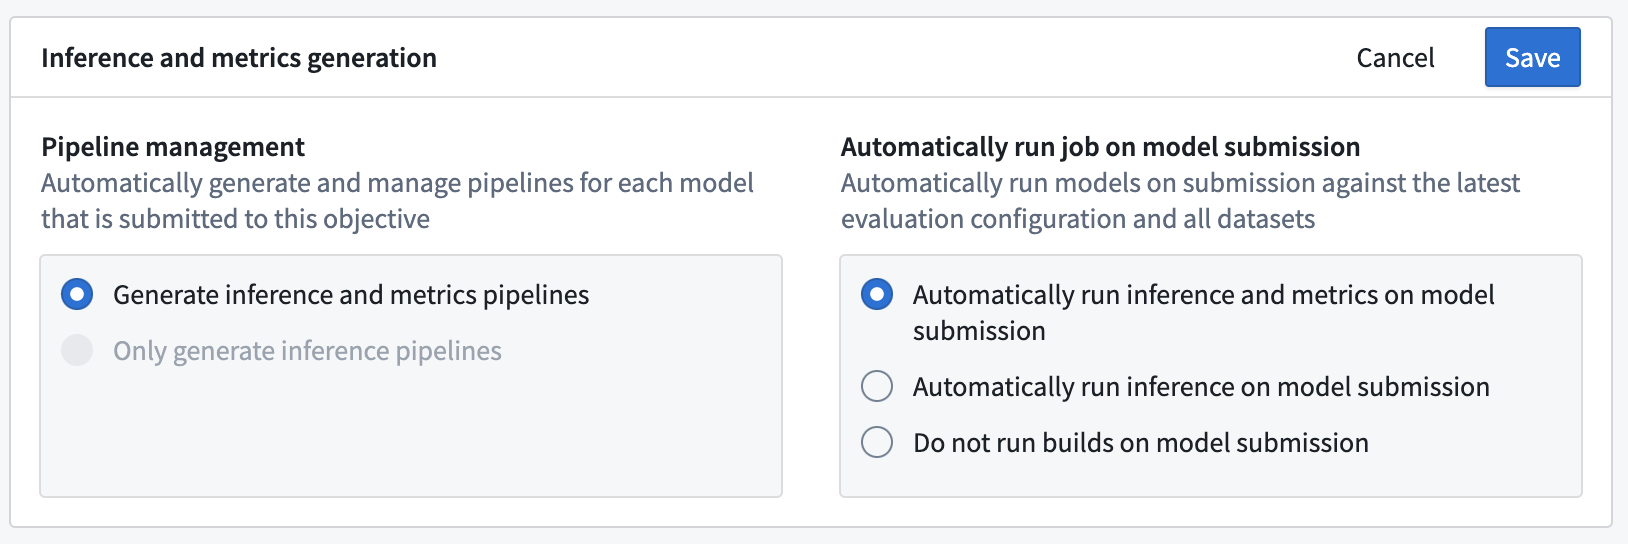
評価ダッシュボードの設定表示では、推論パイプラインとメトリクスパイプラインを自動的に生成するか、推論パイプラインのみを生成するかを選択できます。選択内容に応じて、既存のすべてのモデルの登録と、モデリング目標への新しいモデルの登録に対して、推論データセットとメトリクスデータセットが生成されます。
モデルの自動推論または自動評価を設定する
次に、新しいモデルが登録されたときに、推論データセット、または推論データセットとメトリクスデータセットを自動的にビルドするかどうかを選択できます。推論データセットとメトリクスデータセットを自動的にビルドすることで、モデリングプロジェクトで使用が検討されるすべてのモデルを一貫した方法で評価できます。
推論パイプラインとメトリクスパイプラインは、モデルの登録時にのみビルドされます。既存のモデルの登録については、評価ダッシュボードの評価を構築ボタンから手動でビルドを開始する必要があります。
保存をクリックして、推論とメトリクスの生成設定を保存します。
評価用データセットを追加する
評価用データセットとは、モデリング目標内でモデルを評価するために使用する Foundry データセットです。推論パイプラインを自動的に生成するようモデリング目標が設定されている場合、モデルの登録と評価用データセットの組み合わせごとに1個の推論データセットが生成されます。各評価用データセットは、評価に関連する内容を含み、慎重に維持管理する必要があります。これには、精選された検証用またはテスト用のデータセット、本番環境の観測、ユーザーフィードバックの事例、主要なテストケース、仮想シナリオを表すデータなどが含まれる場合があります。評価用データセットには、モデルが推論を実行するために必要なデータセットのフィールドまたはファイルが含まれている必要があります。
評価用データセットは、サイズ、更新頻度、権限がそれぞれ異なる場合があります。これらのデータセットを分けて保持することで、計算されるメトリクスの更新頻度と権限設定をより細かく制御できます。
モデリング目標内では、権限が完全に適用されます。適切なアクセス権がないユーザーは、モデル、評価用データセット、評価ライブラリ、メトリクスを閲覧できません。
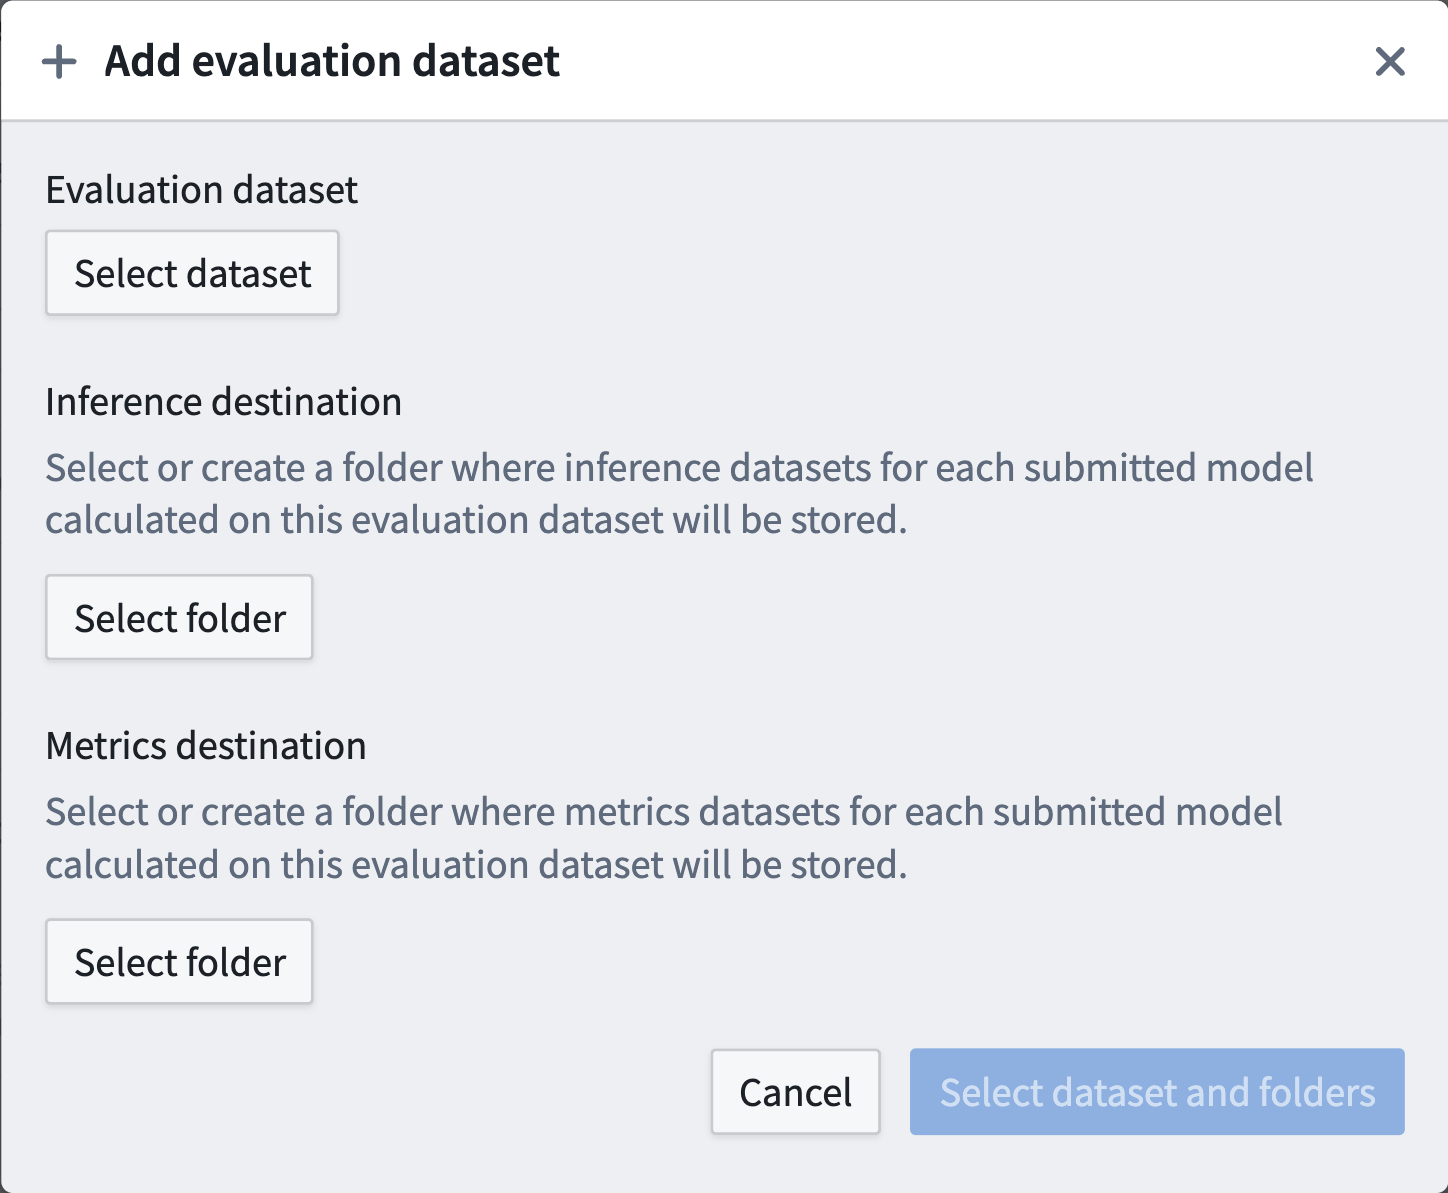
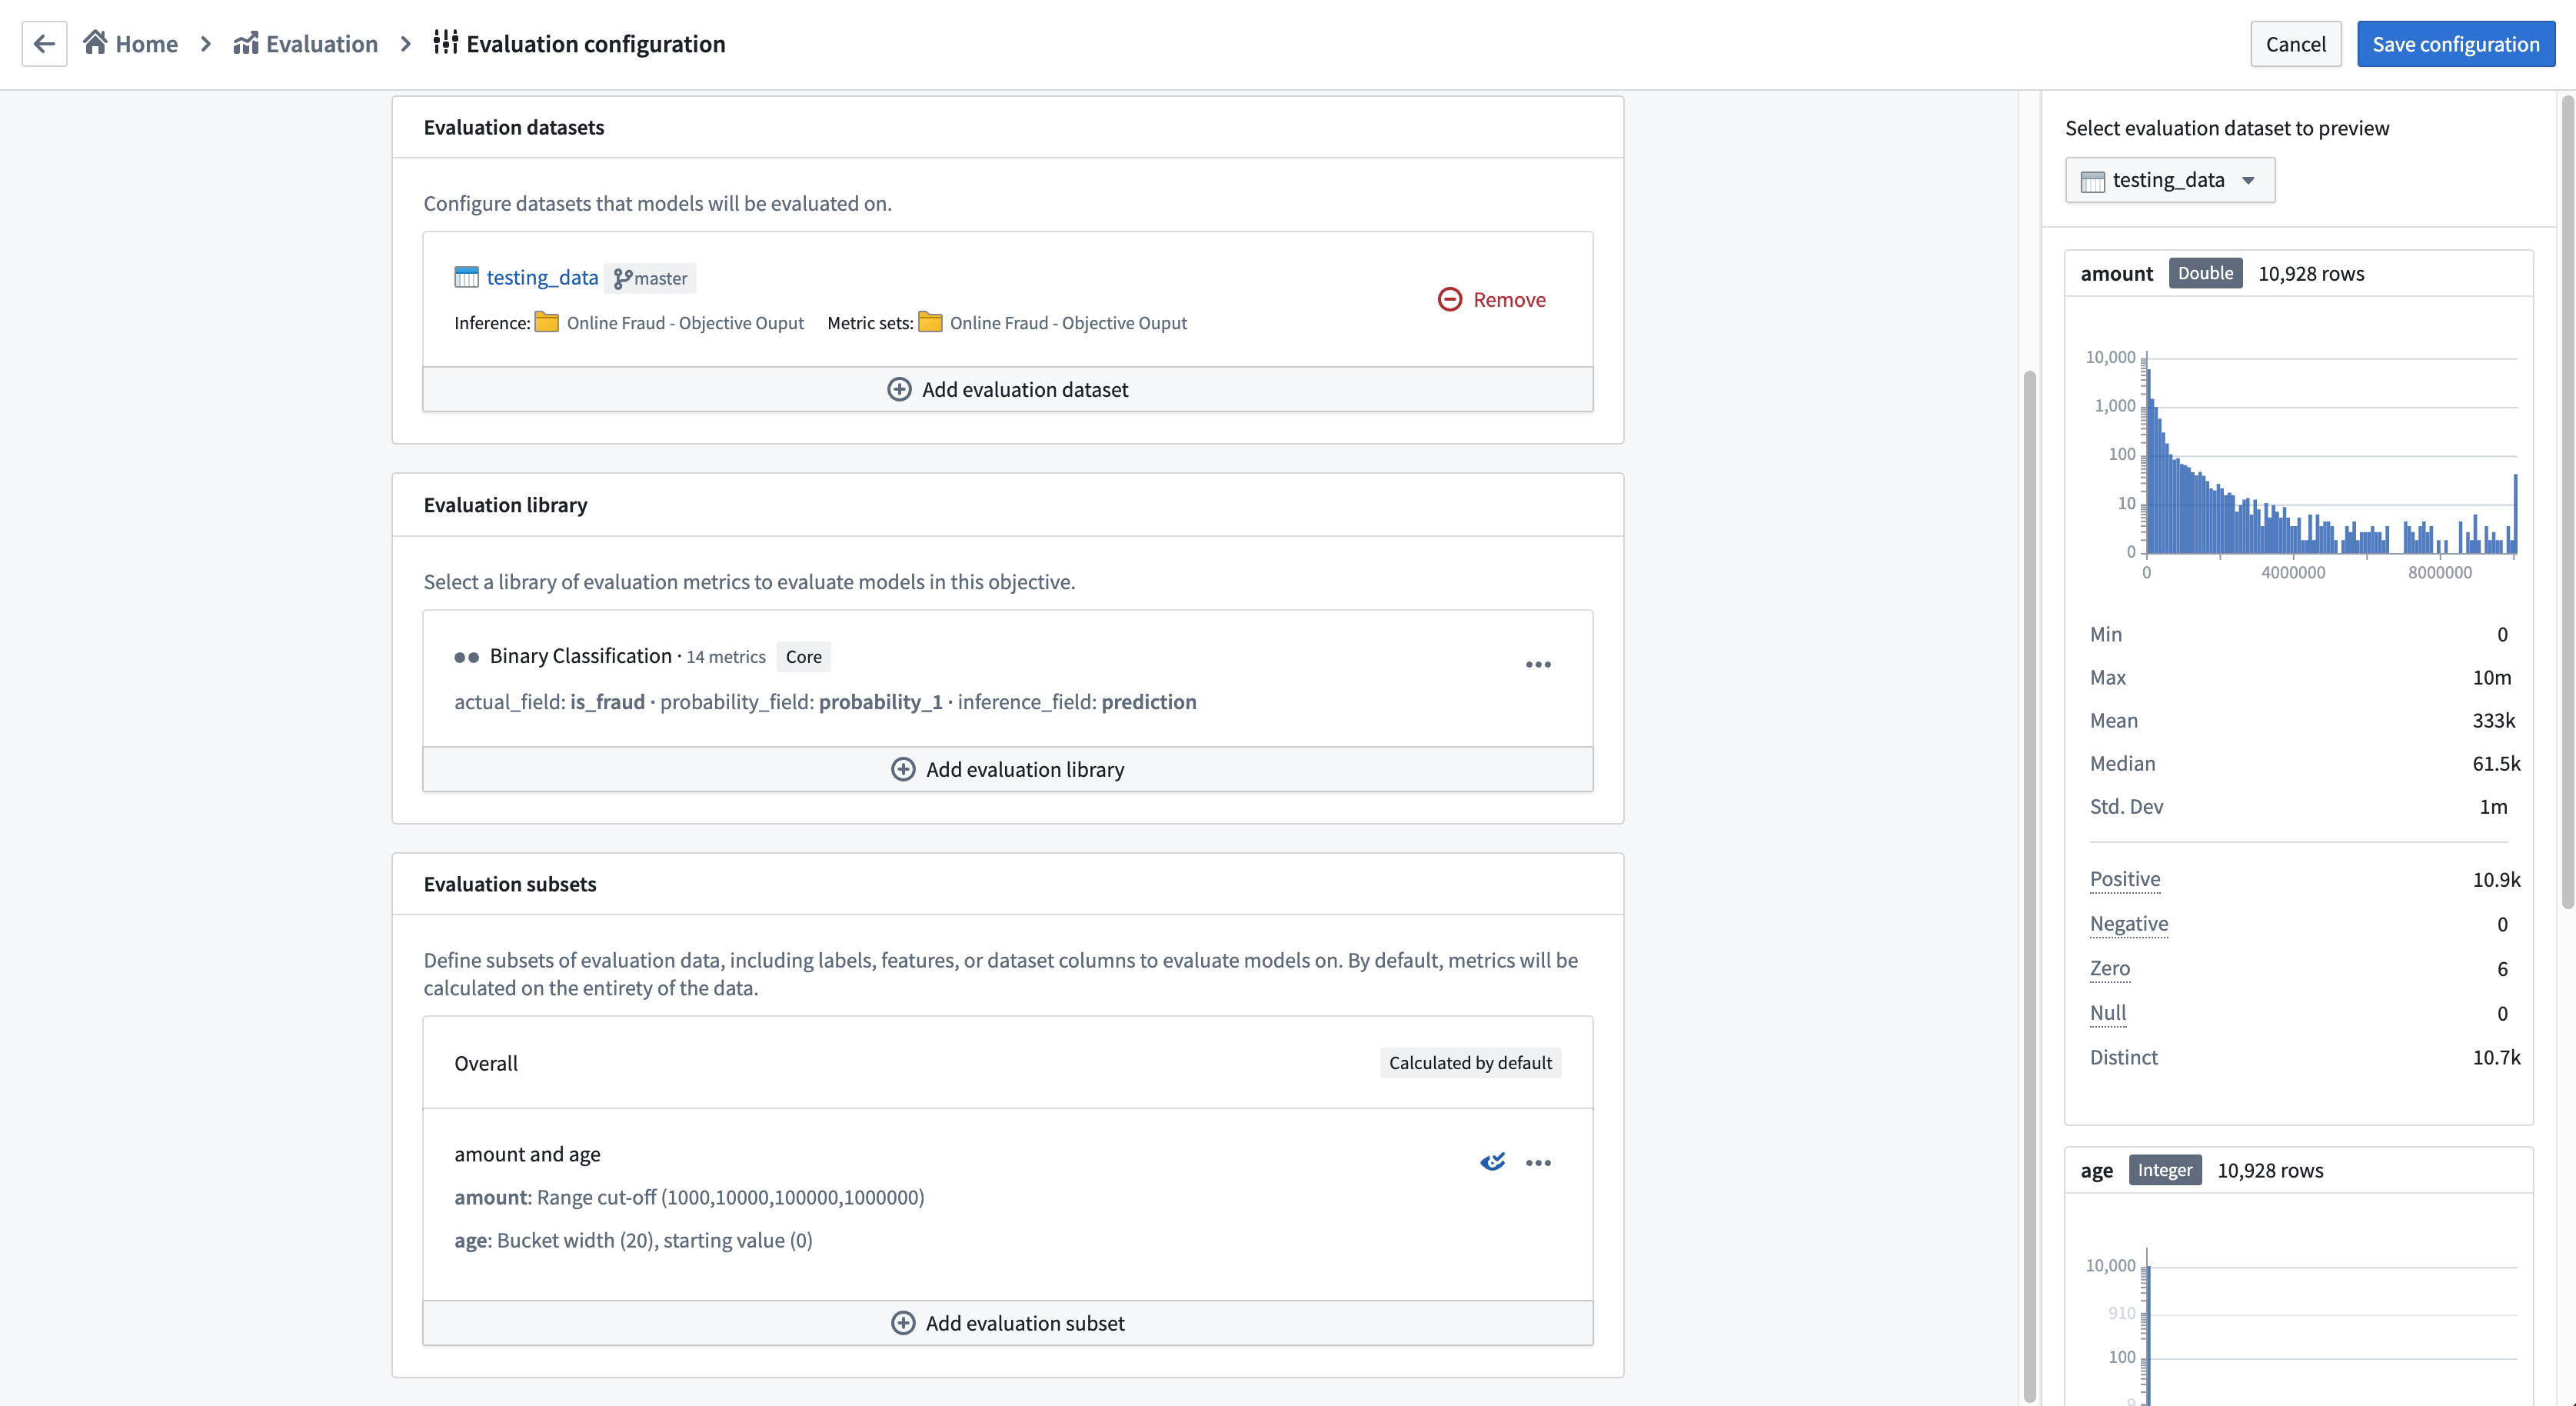
評価用データセットを設定するには、評価用データセットを追加を選択します。ポップアップで、次の項目を設定できます。
- 評価用データセット。
- この評価用データセットの推論データセットを生成する Foundry フォルダー。
- この評価用データセットのメトリクスデータセットを生成する Foundry フォルダー。
Foundry フォルダーは新しいフォルダーでも既存のフォルダーでもよく、評価用データセットごとに異なるフォルダーを指定する必要はありません。通常は、モデリング目標ごとに1個の出力フォルダーを使用することを推奨しますが、特定のユースケースに合わせて設定できます。
評価用データセットと目標自体は、推論とメトリクスの保存先と同じ Foundry プロジェクト内に配置するか、参照としてその Foundry プロジェクトに追加する必要があります。
Modeling Objectives でのモデルの自動評価は、単一の表形式データセットを入力とするモデルにのみ対応しています。
評価ライブラリを設定する
メトリクスパイプラインと推論パイプラインを生成するようモデリング目標を設定した場合、次のステップは評価ライブラリを設定することです。評価ライブラリとは、モデル評価ツールを生成する、Foundry で公開済みの Python パッケージです。Foundry には、二値分類と回帰用のデフォルトのモデル評価ツールが用意されており、カスタムモデル評価ツールを作成することもできます。評価ライブラリは、モデルの性能、公平性、頑健性、およびその他のメトリクスを測定するために使用されます。
評価ライブラリを設定すると、設定済みの推論データセットごとに、メトリクスセットを含むデータセットが1個生成されます。
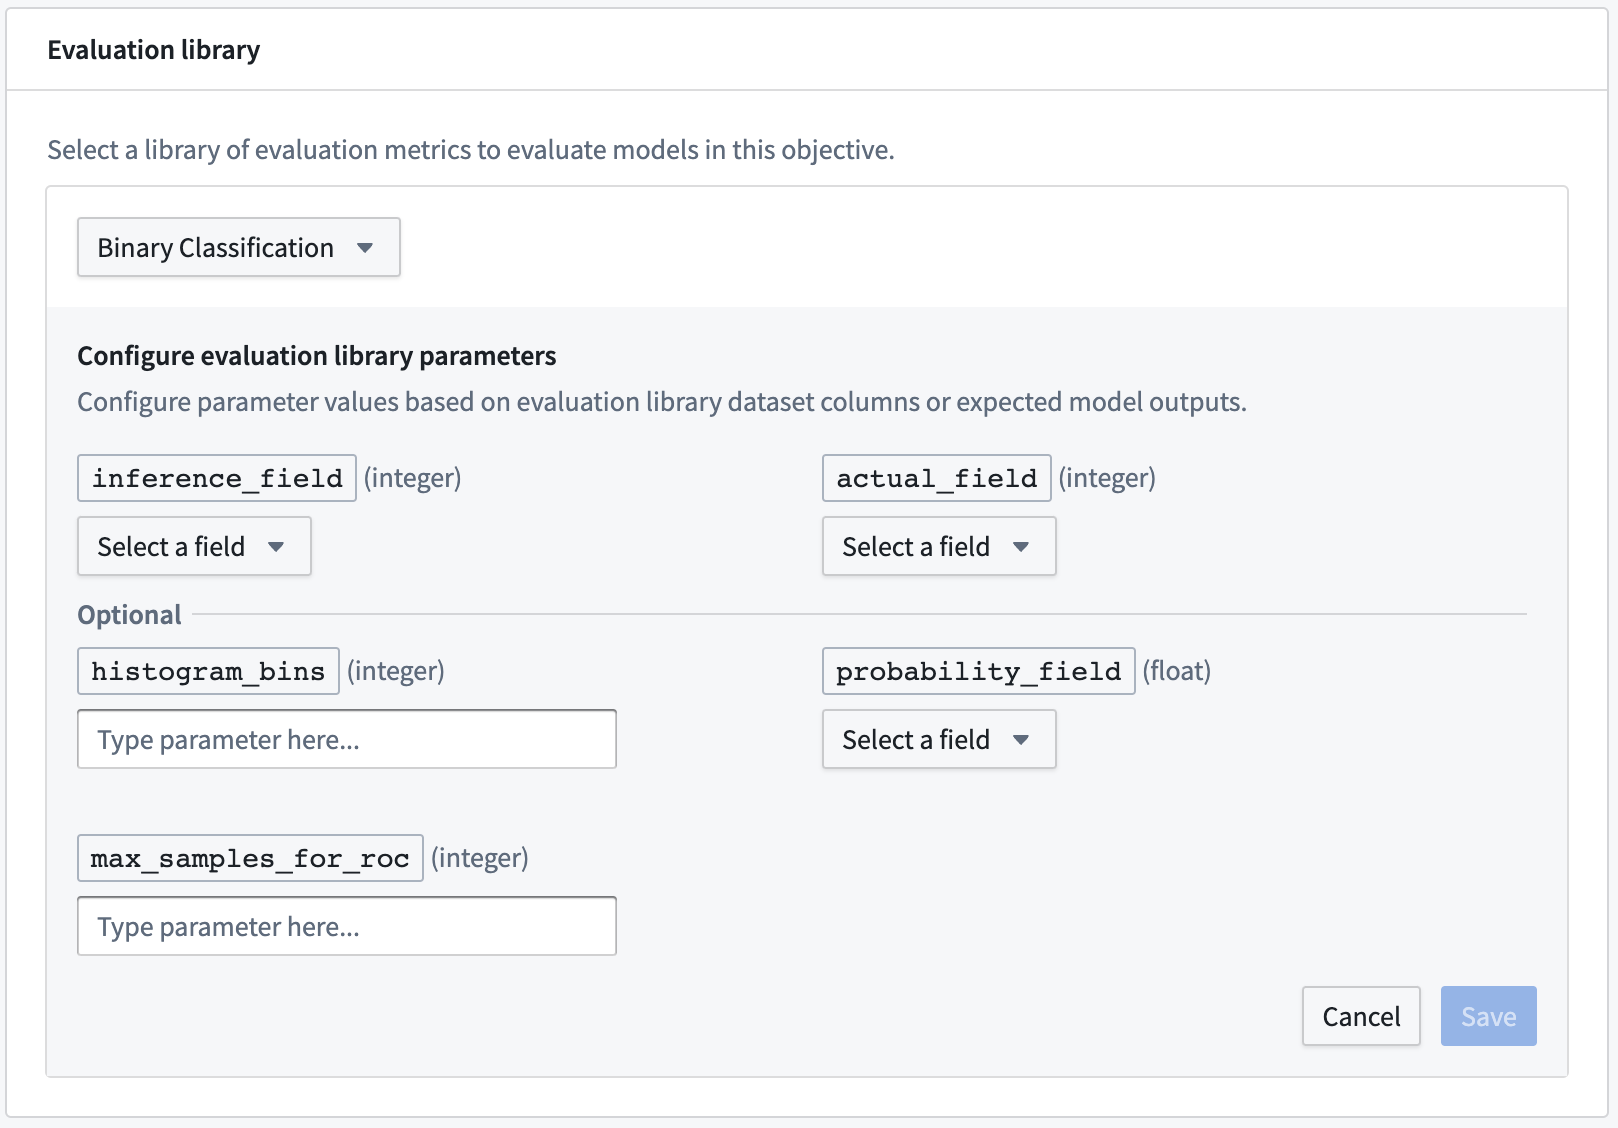
評価ライブラリを設定するには、評価ライブラリを選択をクリックして評価ライブラリを選択し、そのモデル評価ツールで期待されるフィールドを設定します。列を入力とする種類の場合、モデリング目標は、いずれかの評価用データセットで利用可能な列を候補として提示します。また、ドロップダウンの候補に表示されない場合や、モデルトランスフォームによって生成されることがわかっている場合は、期待されるモデル出力を追加して、モデルの登録によって生成されると期待される列を指定することもできます。
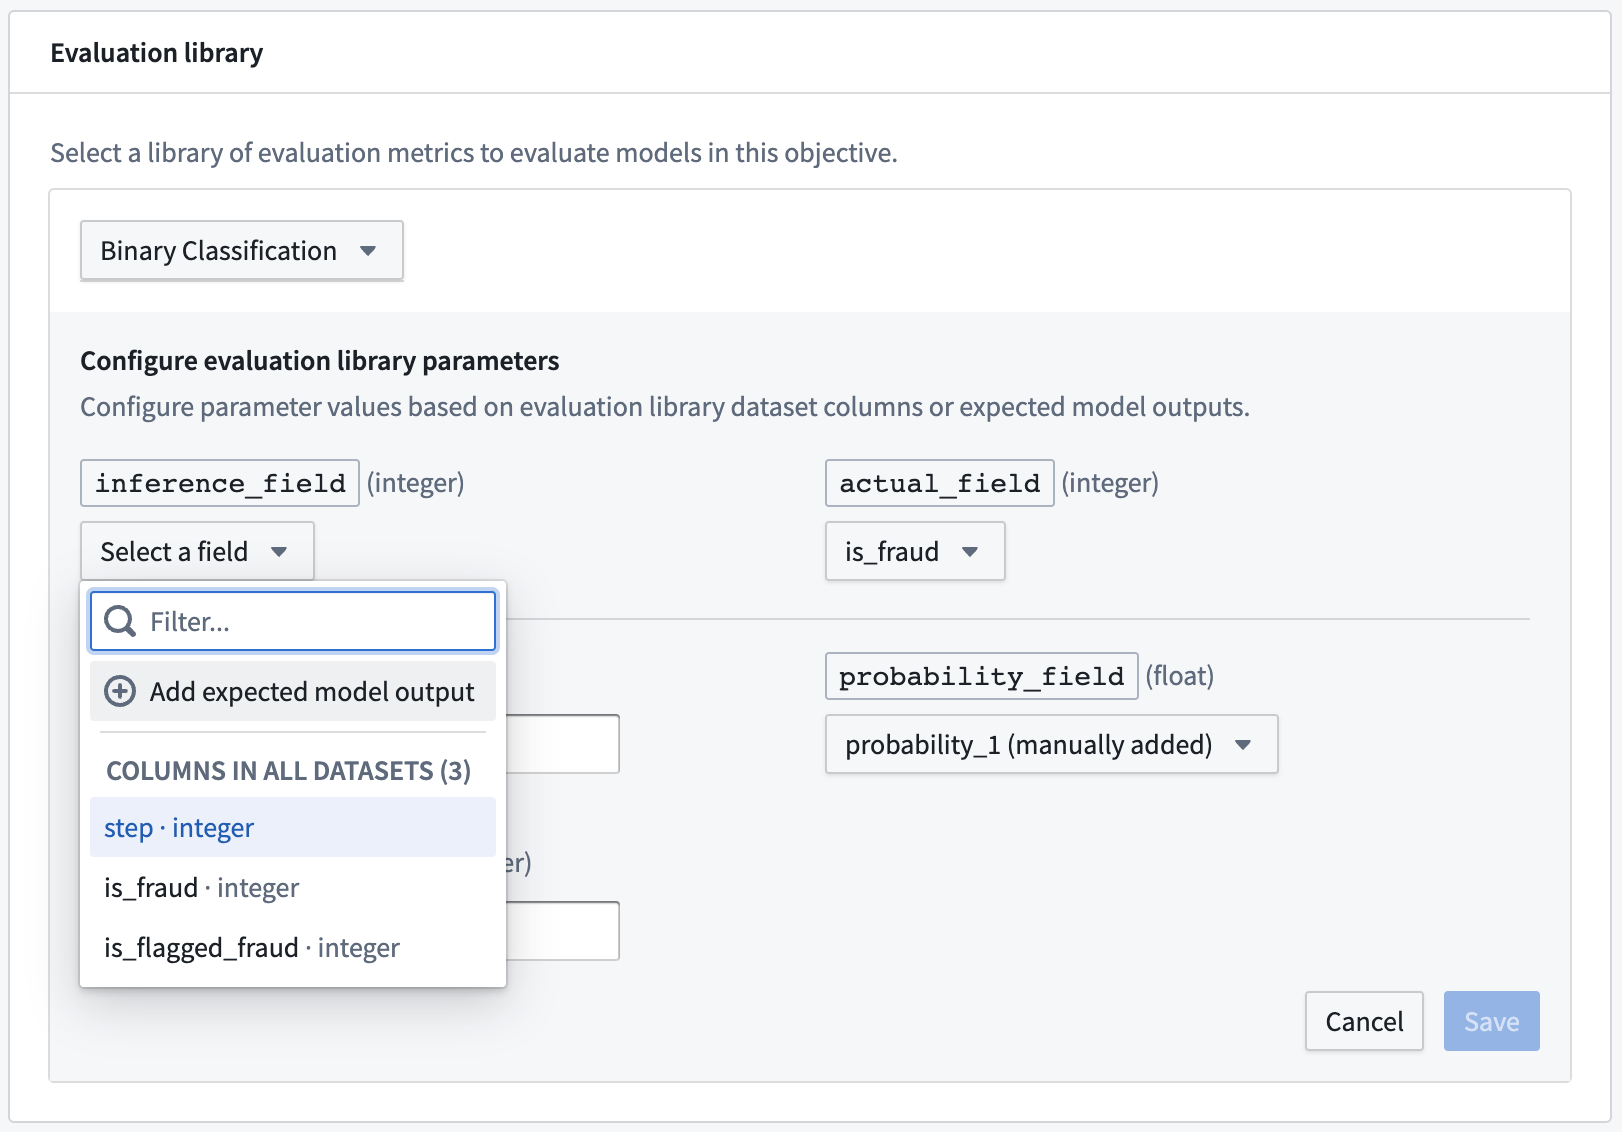
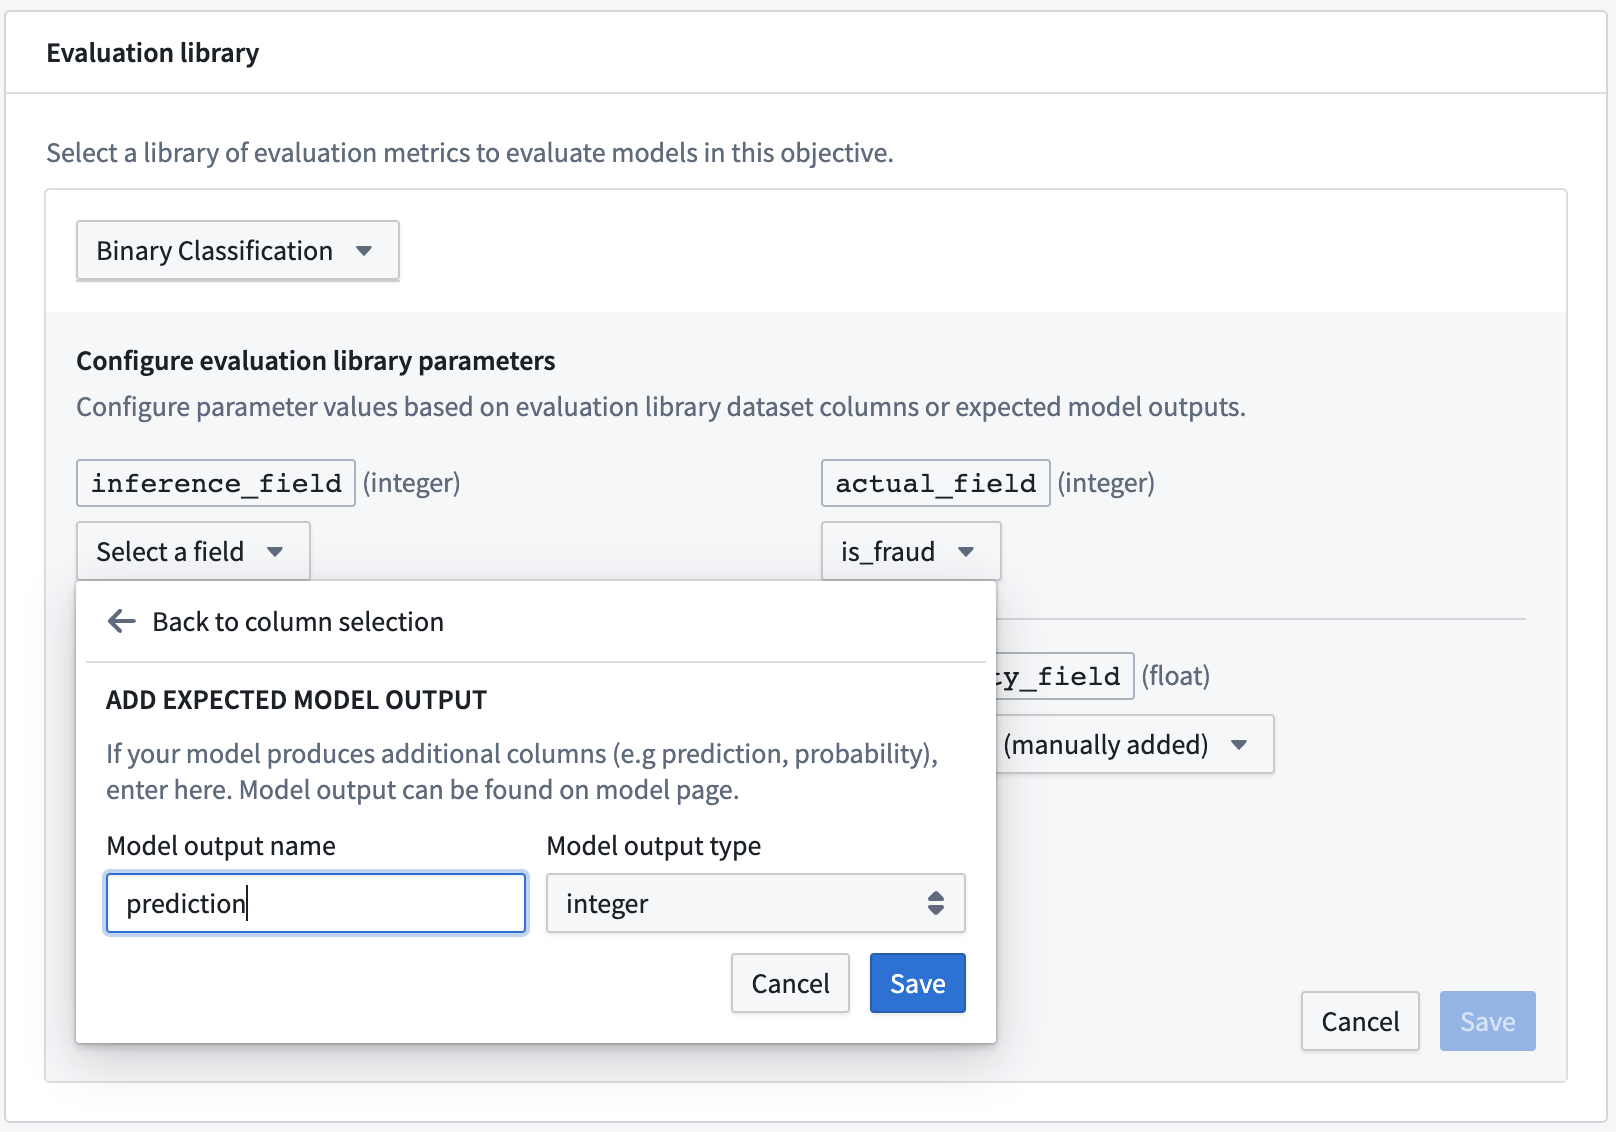
期待されるモデル出力で最も一般的な種類は、予測出力(多くの場合 prediction という名前)、確率出力(多くの場合 probability_1 という名前)、信頼度スコアです。
評価サブセットを設定する
モデルの自動評価を設定する際の任意のステップとして、評価ライブラリがメトリクスを生成する対象となる評価サブセットを定義できます。評価サブセットは、評価データセット内のデータの一部であり、そのサブセットに対してメトリクスが個別に生成されます。評価サブセットのメトリクスは、評価ダッシュボードで個別に分析できます。
評価サブセットは、入力データの特定のグループに対するモデルの性能を理解するのに役立ちます。そのため、モデルの解釈可能性、説明可能性、および保護対象となり得る属性グループ間の公平性の向上に利用できます。評価サブセットは評価データセットの任意の列に対して生成できるため、モデルの特徴量やモデルの予測など、モデル変換の入力または出力に対して生成する必要はありません。
各評価データセットの全体、つまりすべての行に対するメトリクスは、常に「全体」サブセットで生成されます。さらに細かいサブセットに対してメトリクスを自動生成するための評価サブセットの設定は任意です。
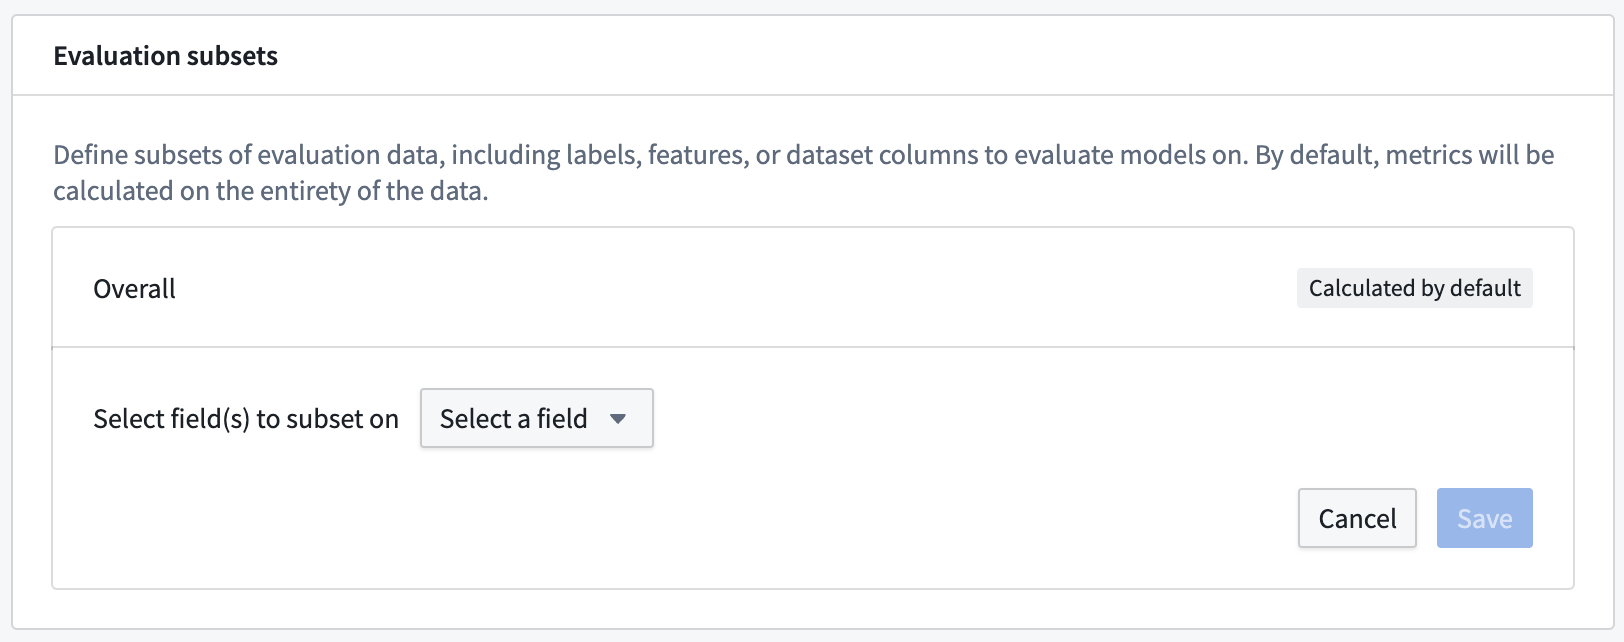
評価サブセットを設定するには、評価サブセットを追加をクリックし、サブセットの作成対象となる評価データセットの列または期待されるモデル出力を選択します。
機密情報区分バケット
評価サブセットでデータ型が string のフィールドを選択すると、評価パイプラインのビルド時に、評価ライブラリ内の一意の文字列値ごとに個別のサブセットが生成されます。
定量バケット
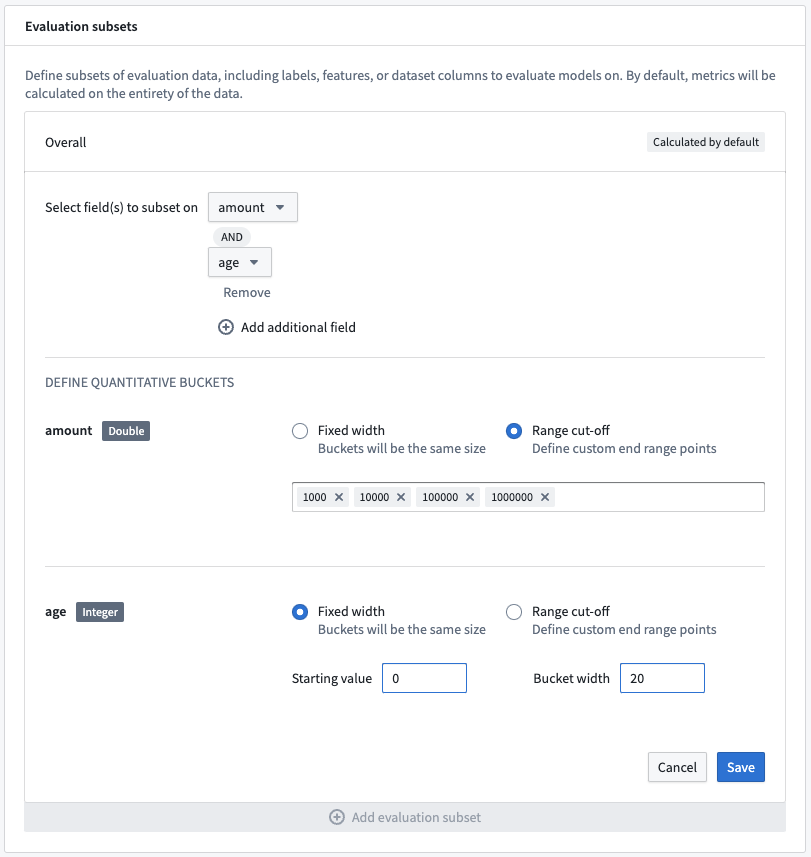
評価サブセットで数値データ型のフィールドを選択すると、サブセットの生成に使用する定量バケット化の方式を選択できます。バケットは固定幅にするか、特定の範囲の境界値を指定して定義できます。どちらのバケット化方式でも、バケットの範囲は次のように定義されます。
- 下限値を含み、下限値以上となります。
- 上限値を含まず、上限値未満となります。
固定幅バケットの場合は、開始値とバケット幅の両方を指定する必要があります。選択したフィールドの全範囲にわたり、開始値から正方向と負方向の両方に、バケット幅ごとに個別のサブセットが生成されます。
範囲の境界値を指定すると、指定したすべての値の間を範囲とするサブセットが生成されます。選択したフィールドの全範囲をカバーしていない場合、列の最小値から最小の境界値までと、最大の境界値から列の最大値までの2個の追加バケットが生成されることがあります。
個々のサブセットは、すべての評価データセットとライブラリを使用して評価されます。そのため、大量のサブセットを生成すると、モデル評価のビルド時間が大幅に長くなる場合があります。
複数フィールドのサブセット
複数のフィールドの組み合わせを表すサブセットを生成できます。複数のフィールドで追加フィールドを追加をクリックし、1つのサブセットに組み合わせる列または期待されるモデル出力を選択します。これにより、フィールド間のバケットの組み合わせごとにサブセットが作成されます。
定量バケット化の方式は、サブセットのフィールドごとに個別に定義できます。
評価サブセットのプレビューを確認する
評価サブセットを設定すると、ページの右側に評価データセットのプレビューが表示されます。このプレビューは、設定したすべての評価データセットで利用可能であり、評価設定によって生成される評価サブセットの数を確認するために使用できます。
評価設定を保存する
ページの右上にある設定の保存をクリックすると、評価設定が保存され、評価ダッシュボードに戻ります。