注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
入力
Model Studio は、トレーニングジョブの入力として Foundry データセットを受け付けます。各トレーナーは、受け取ることを想定するデータセットの種類を定義します。
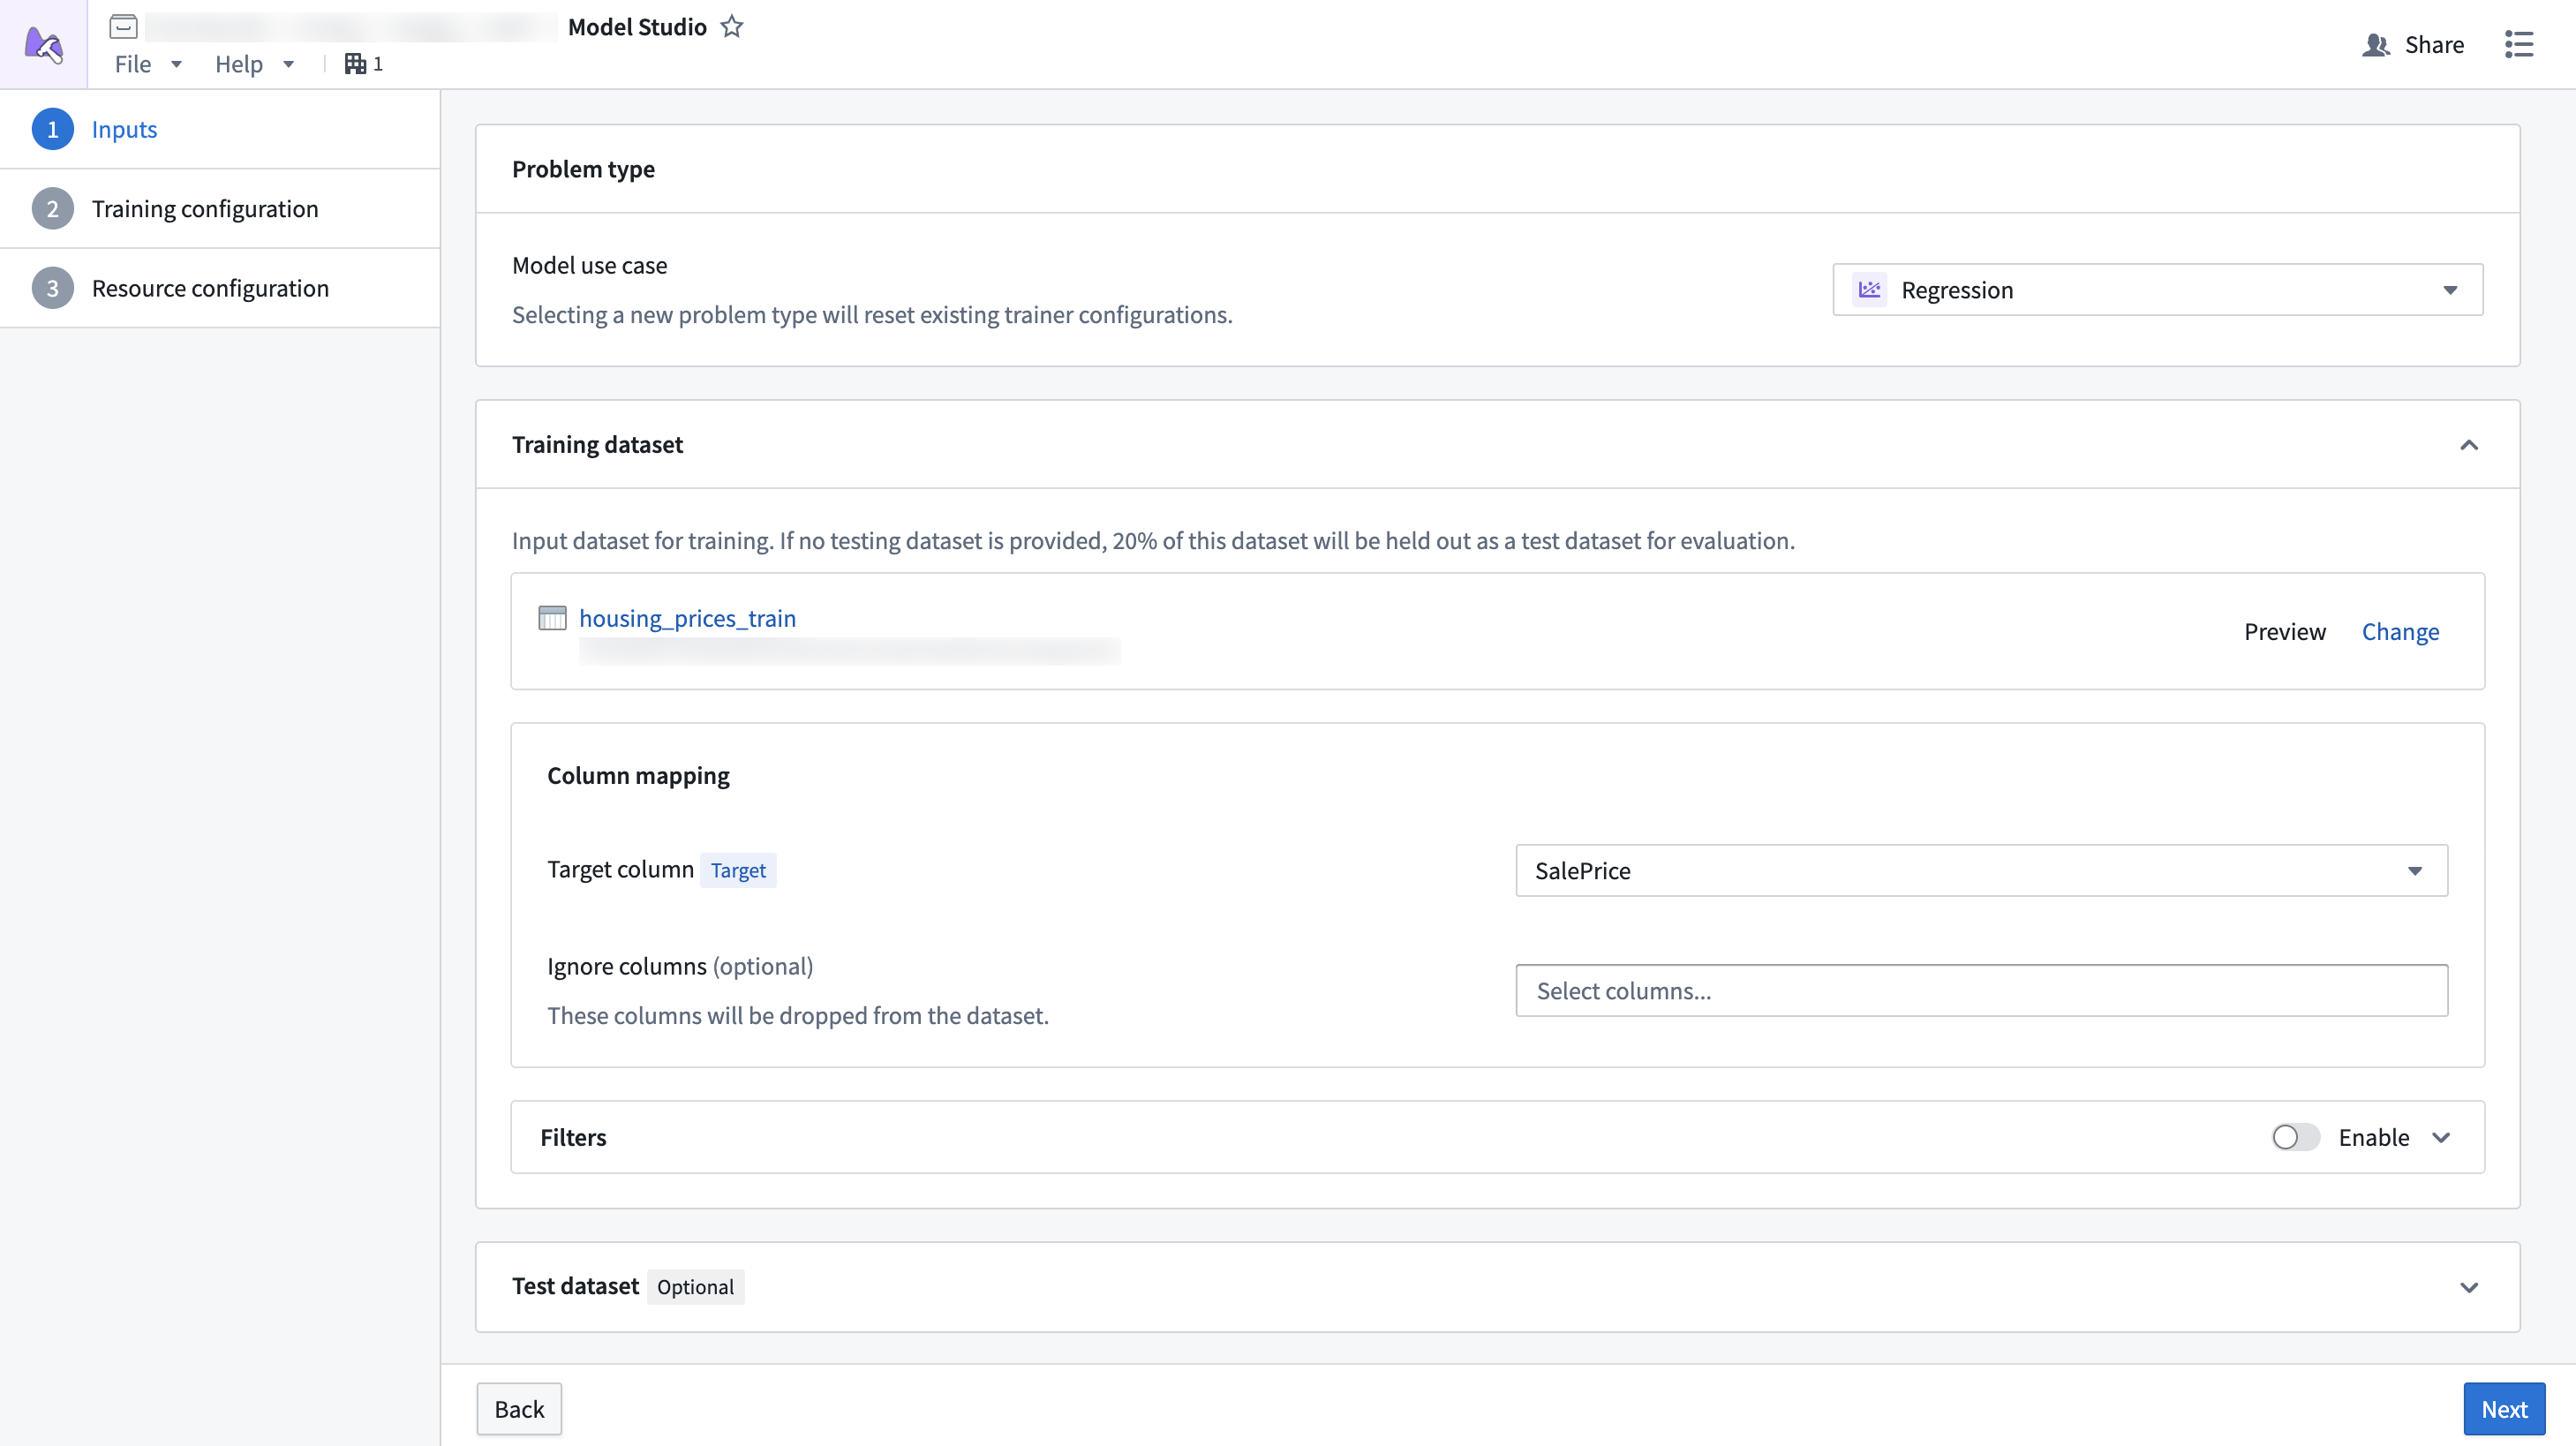
データセットのマッピング
設定ウィザードのデータセット設定ページにある各カードは、入力をマッピングできる特定のデータセットを表します。必須のデータセットもあれば、任意のデータセットもあります。たとえば、トレーニングジョブではデータの20%をテスト用データセットとして分割するため、テスト用データセットは通常、任意です。
また、トレーナーがどの列が重要かを認識できるように、データセットの列を特定の列タイプにマッピングする必要があります。たとえば、時系列予測トレーナーでは、対象列1列、タイムスタンプ列1列、および任意の item_id 列が必要であると定義されている場合があります。各列マッピングでは、列を選択できるようにするために満たす必要がある、列のデータ型に関する特定の要件が定義されています。
データセットの列を無視することもできます。無視された列は、トレーニング中にデータセットから削除されます。
プレビュー
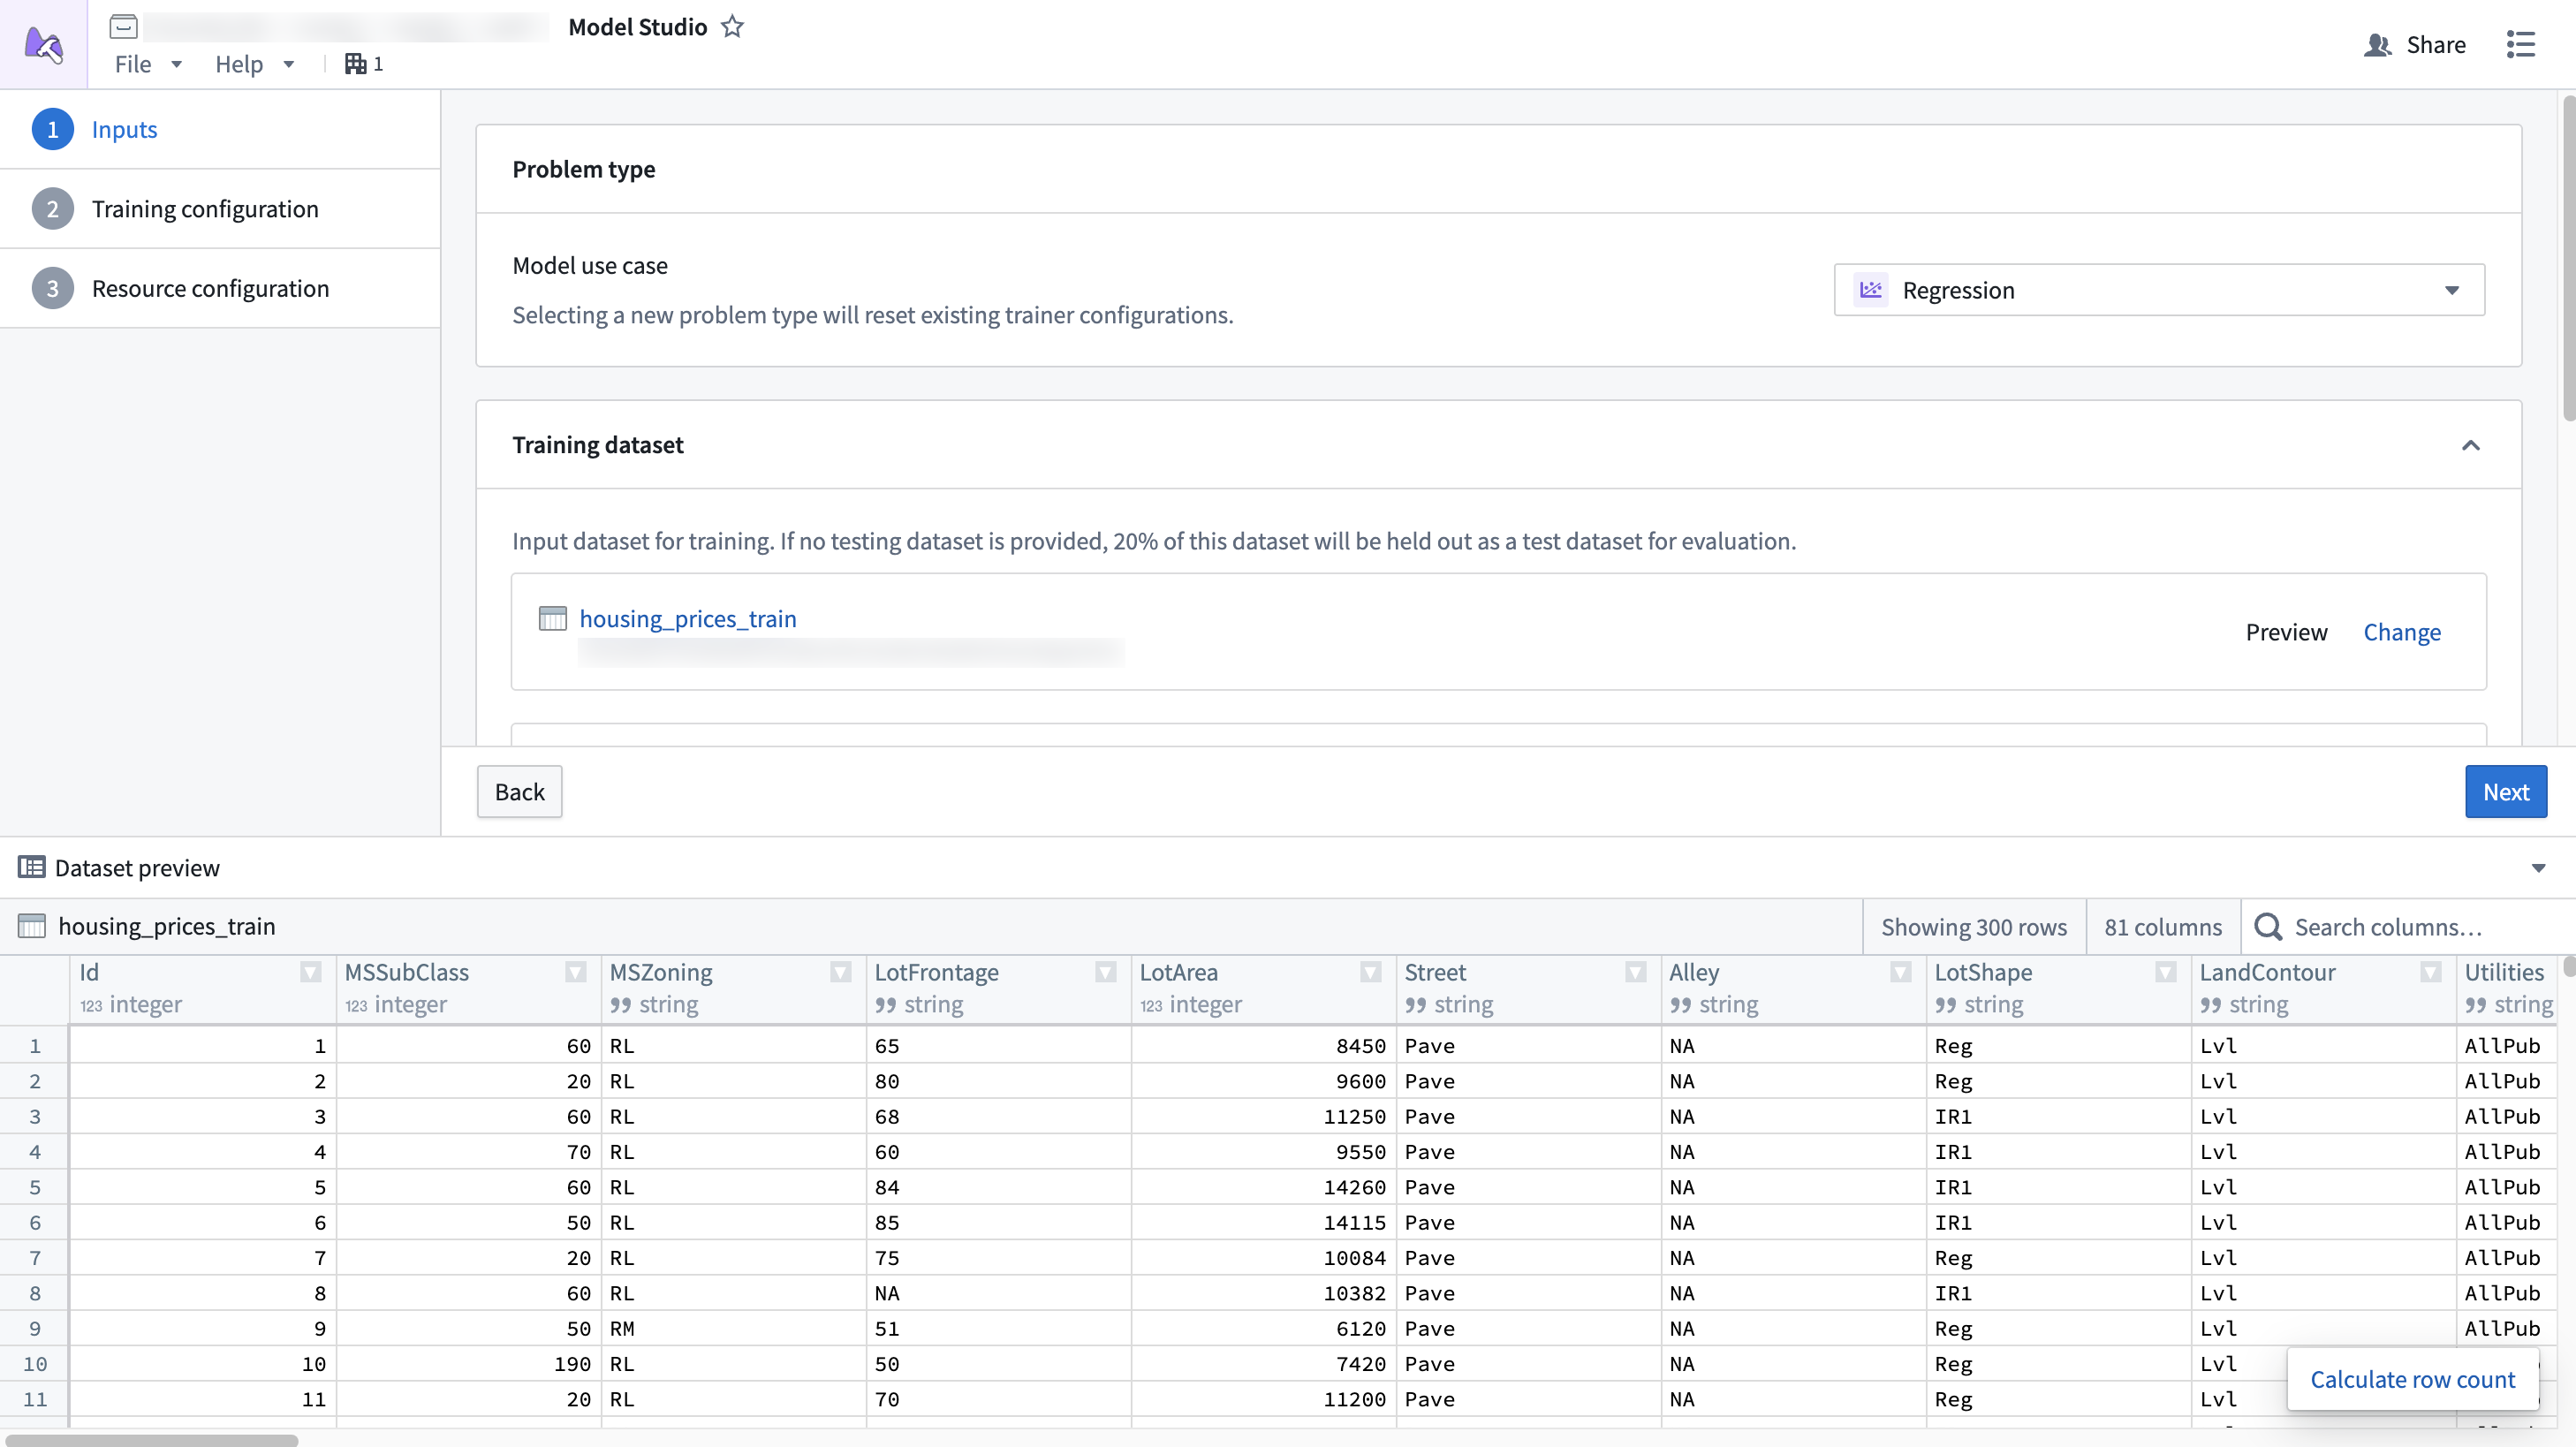
選択したデータセットをプレビューすることもできます。プレビューウィンドウでは、入力を設定しながらデータセットを確認し、さまざまな列の統計情報を表示できます。
フィルタリング
Parquet ↗ 以外のデータセットに適用されるフィルターは、プッシュダウンフィルタリングをサポートしていません。メモリー不足エラーを防ぐため、設定でより多くのメモリーを割り当てる必要がある場合があります。
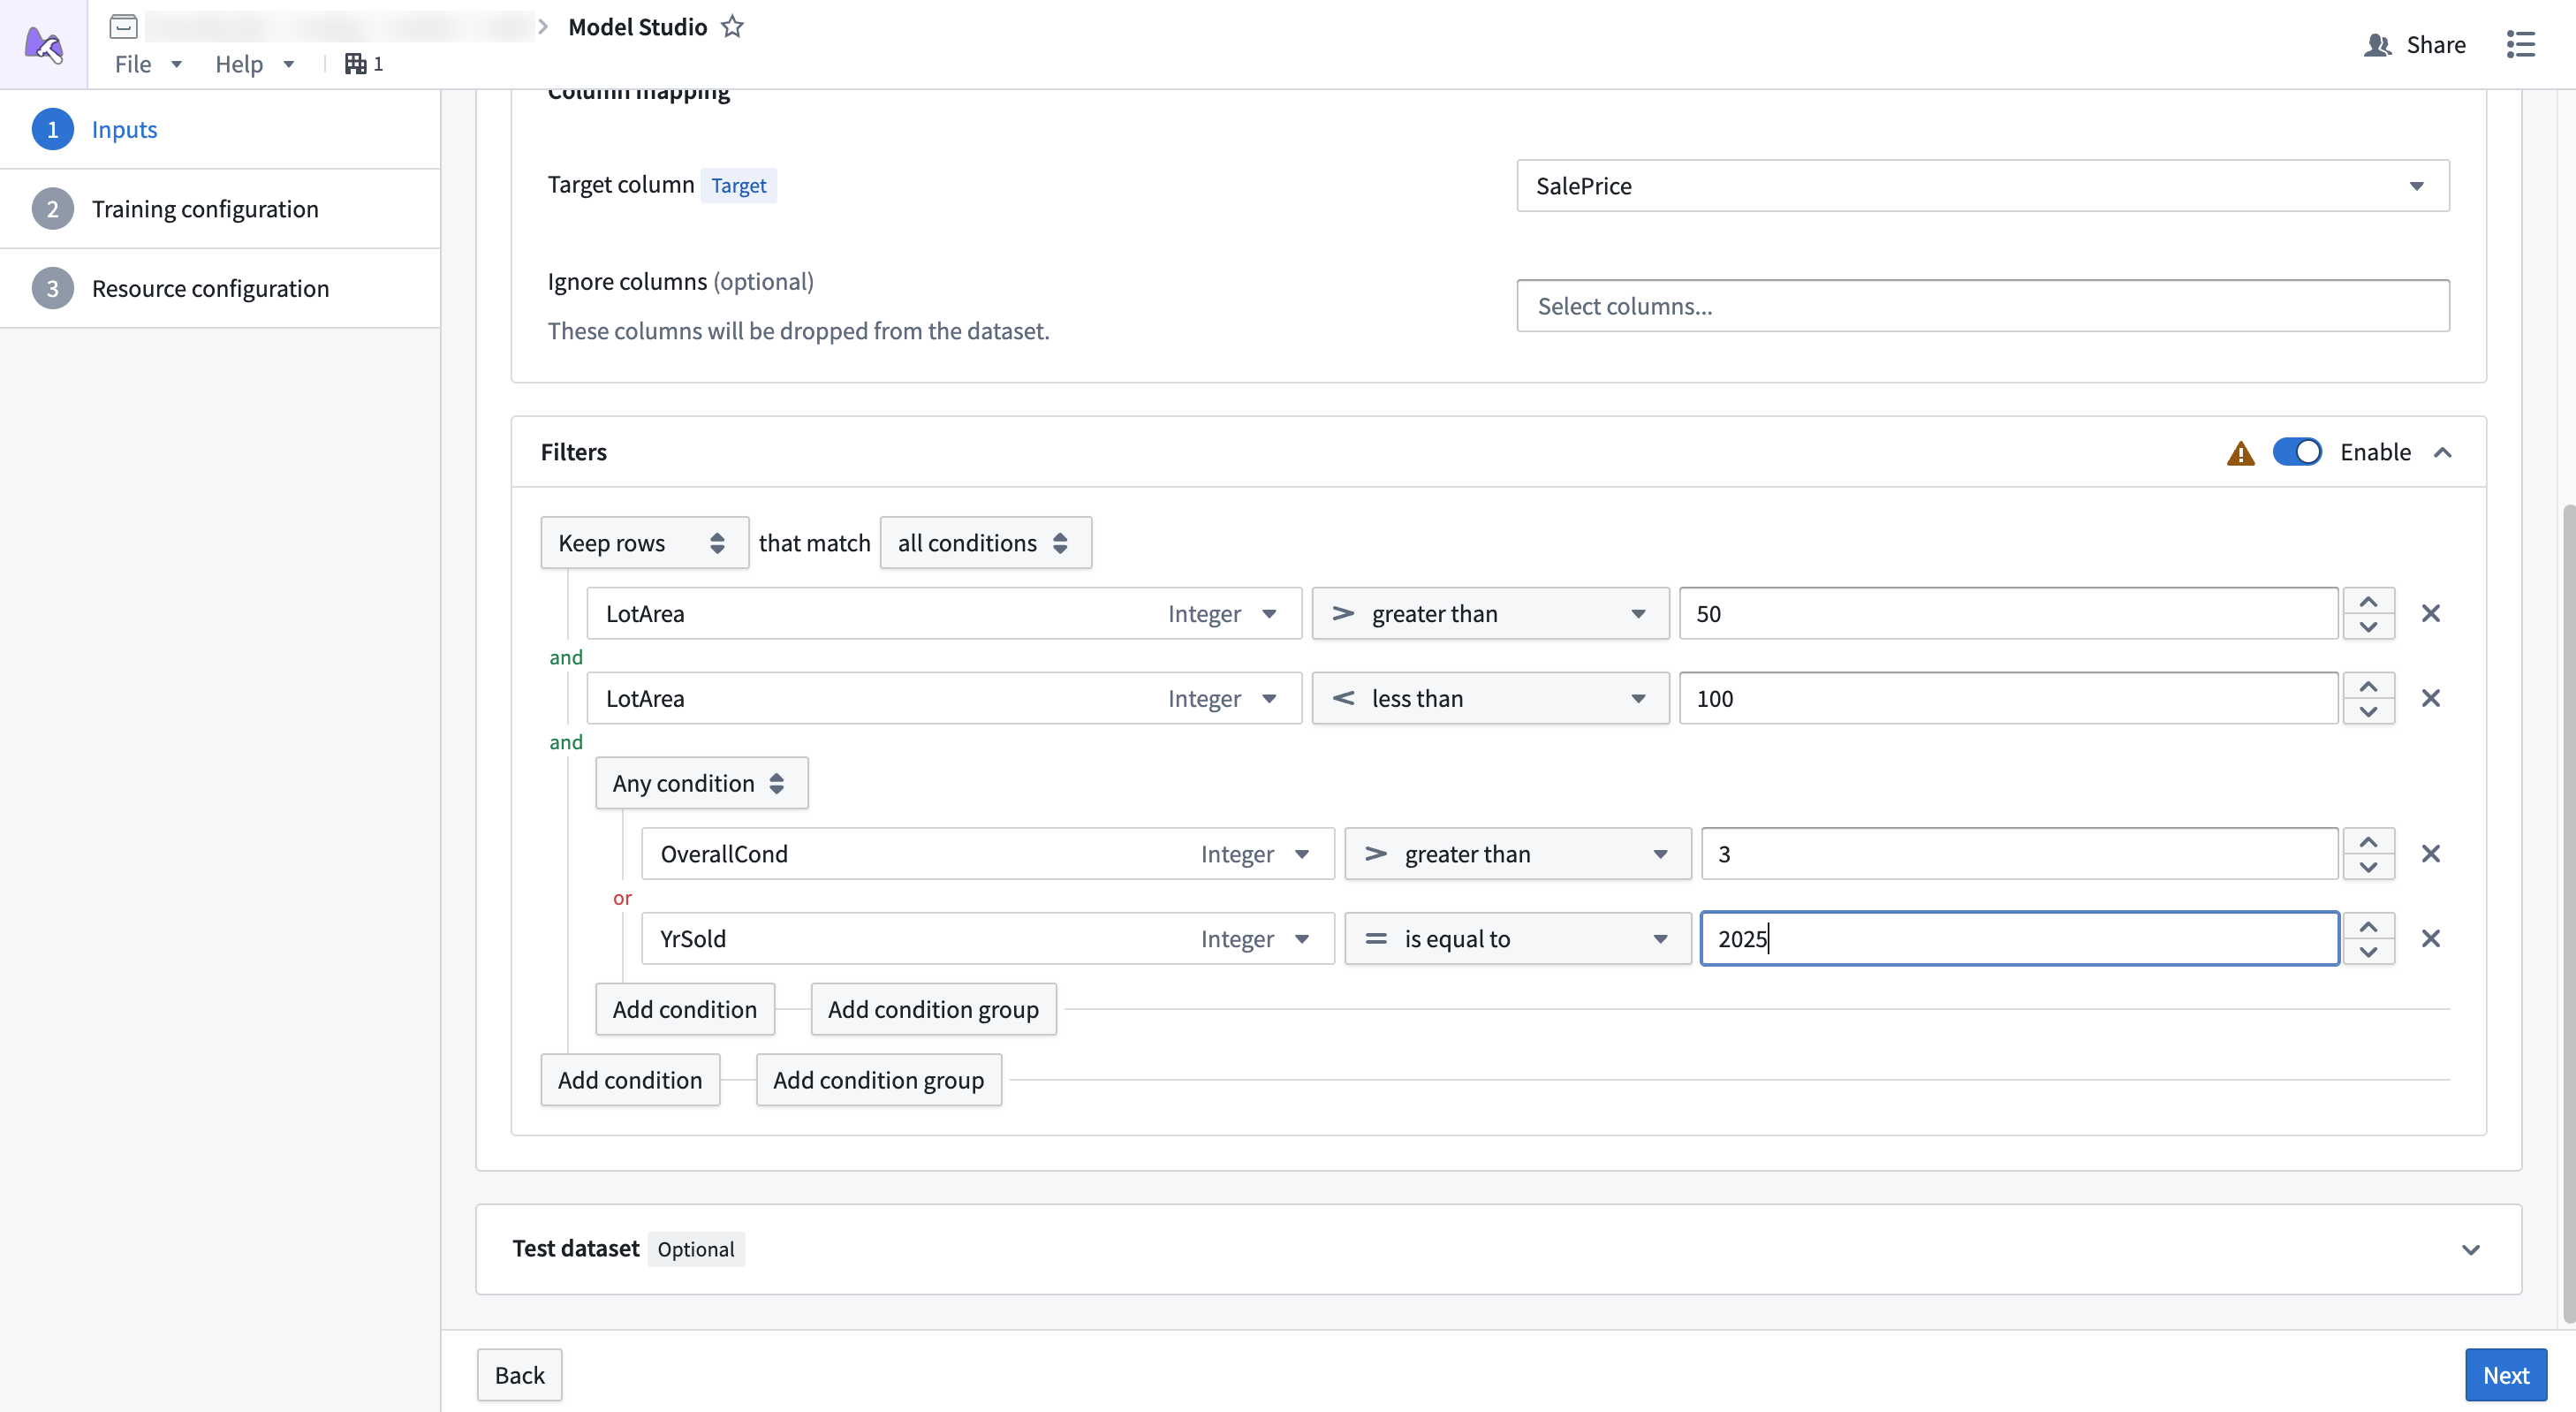
データセットのフィルタリングでは、指定した条件に一致する行をデータセットから削除できます。これは、データセットに多数の null 値がある場合や、特定の条件に一致する一部の行を無視したい場合に有効な方法です。
プッシュダウンフィルタリングは、Parquet ↗ データセットで利用可能なフィルタリング方法です。ジョブ中にデータがダウンロードされる前にフィルターを適用できます。これにより、ジョブで使用するメモリーの総量を削減できます。Pipeline Builder の出力など、Foundry 内で生成されたデータセットは通常、プッシュダウンフィルタリングをサポートしますが、CSV などのアップロードされたデータセットはサポートしません。